深度学习训练三要素:Epoch、Batch Size与Iterations的完全指南
在深度学习模型训练中,Epoch(轮次)、Batch Size(批次大小)和迭代次数是三个相互关联的核心超参数,它们共同决定了模型的训练效率、收敛性和最终性能。本文将用最清晰的结构解析这些概念的定义、作用及相互关系,并提供实用的调参指南。
一、核心概念解析
1. Epoch(训练轮次)
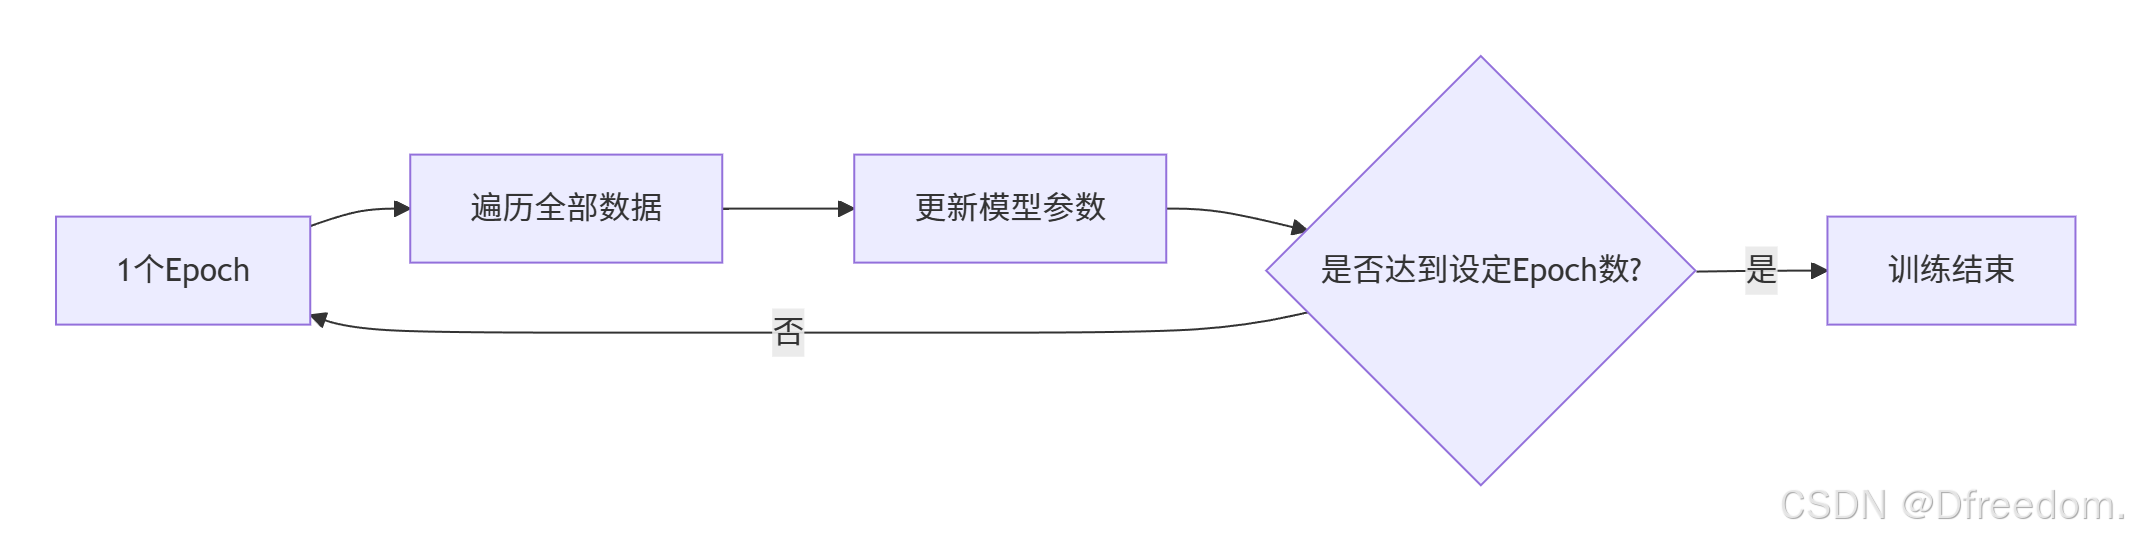
定义:一个Epoch代表模型完整遍历整个训练数据集一次的过程。例如,训练集有1000个样本,1个Epoch即模型处理这1000个样本一次。
关键特性:
-
学习次数:衡量模型对数据的学习遍数
-
平衡点:通常需要50-100个Epoch使模型充分学习,过多会导致过拟合
-
资源消耗:Epoch增加会线性延长训练时间
可视化指南:
2. Batch Size(批次大小)
定义:每次参数更新时使用的样本数量。例如Batch Size=100表示每次用100个样本计算梯度。
影响矩阵:
|
Batch Size |
优点 |
缺点 |
|---|---|---|
|
小 (16-32) |
梯度噪声大,可能提升泛化能力 |
计算开销大,收敛慢 |
|
中 (64-128) |
平衡稳定性和随机性 |
需精细调参 |
|
大 (256+) |
计算效率高,梯度稳定 |
易陷局部最优,显存需求高 |
经验法则:
-
常用2的幂次(32/64/128)优化硬件效率
-
显存有限时选16-32,分布式训练可用512+
3. Iterations(迭代次数)
定义:完成一次参数更新的步骤,处理一个Batch的数据。
计算公式:
迭代次数/Epoch = 总样本数 / Batch Size
总迭代次数 = Epoch数 × (总样本数 / Batch Size)
示例:
-
数据集:1000样本
-
Batch Size=100 → 10次迭代/Epoch
-
训练3个Epoch → 总迭代次数=30次
二、参数间的协同效应
1. 层级关系

2. 动态联动
-
Batch Size↑ → 迭代次数↓ → 可能需要更多Epoch
-
学习率调整:Batch Size扩大k倍,学习率应乘以√k(线性缩放规则)
-
早停法:通过验证集监控避免无效Epoch
3. 训练流程全景
-
数据按Batch Size分块
-
每Iteration处理一个Batch并更新参数
-
重复直至完成一个Epoch
-
循环多个Epoch直至收敛
三、实用调参策略
1. 黄金组合示例
# PyTorch配置示例
batch_size = 64       # 平衡显存与效率
base_lr = 1e-3        # 基础学习率
epochs = 50           # 适中轮次

# 学习率调度器(余弦退火)
scheduler = CosineAnnealingLR(optimizer, T_max=epochs, eta_min=1e-5)
2. 问题排查指南
|
问题现象 |
可能原因 |
解决方案 |
|---|---|---|
|
训练初期剧烈震荡 |
学习率过高/Batch Size过小 |
降低学习率或增大Batch Size |
|
后期收敛缓慢 |
学习率未衰减 |
添加学习率调度器 |
|
验证集性能下降 |
Epoch过多 |
启用早停法 |
3. 分阶段调整建议
-
初始阶段:
-
Batch Size=32/64(根据显存)
-
学习率=1e-3(CV任务常用)
-
Epoch=20(基准测试)
-
-
优化阶段:
-
按线性规则调整Batch Size与学习率
-
通过验证曲线确定最佳Epoch数
-
添加正则化(如Dropout)防止过拟合
-
四、总结与核心要点
-
Epoch是宏观训练单位,需足够多使模型收敛,但需防止过拟合
-
Batch Size影响梯度稳定性与硬件效率,常取32-256之间
-
迭代次数由Batch Size和Epoch共同决定,是微观更新步骤
-
三者需系统化调优,遵循"单变量优先、联动调整、动态验证"原则
训练比喻:
- Epoch → 完整复习一遍课本
- Batch Size → 每次做题的数量
- Iteration → 做完一组题对答案
通过理解这些超参数的相互作用,可以更高效地训练深度学习模型,平衡训练速度与模型性能。实际应用中,建议从小规模实验开始,逐步扩展至完整训练。
扩展阅读:使用学习率查找器(LR Finder)可以科学确定学习率初始值

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 8
 0
- 0


 已为社区贡献13条内容

所有评论(0)