典型的深度学习模型训练与评估流程
·
深度学习正在改变我们的生活,从图像识别到自然语言处理,无一不涉及深度神经网络的应用。对于初学者而言,理解一个模型从 训练到评估的完整流程非常重要。
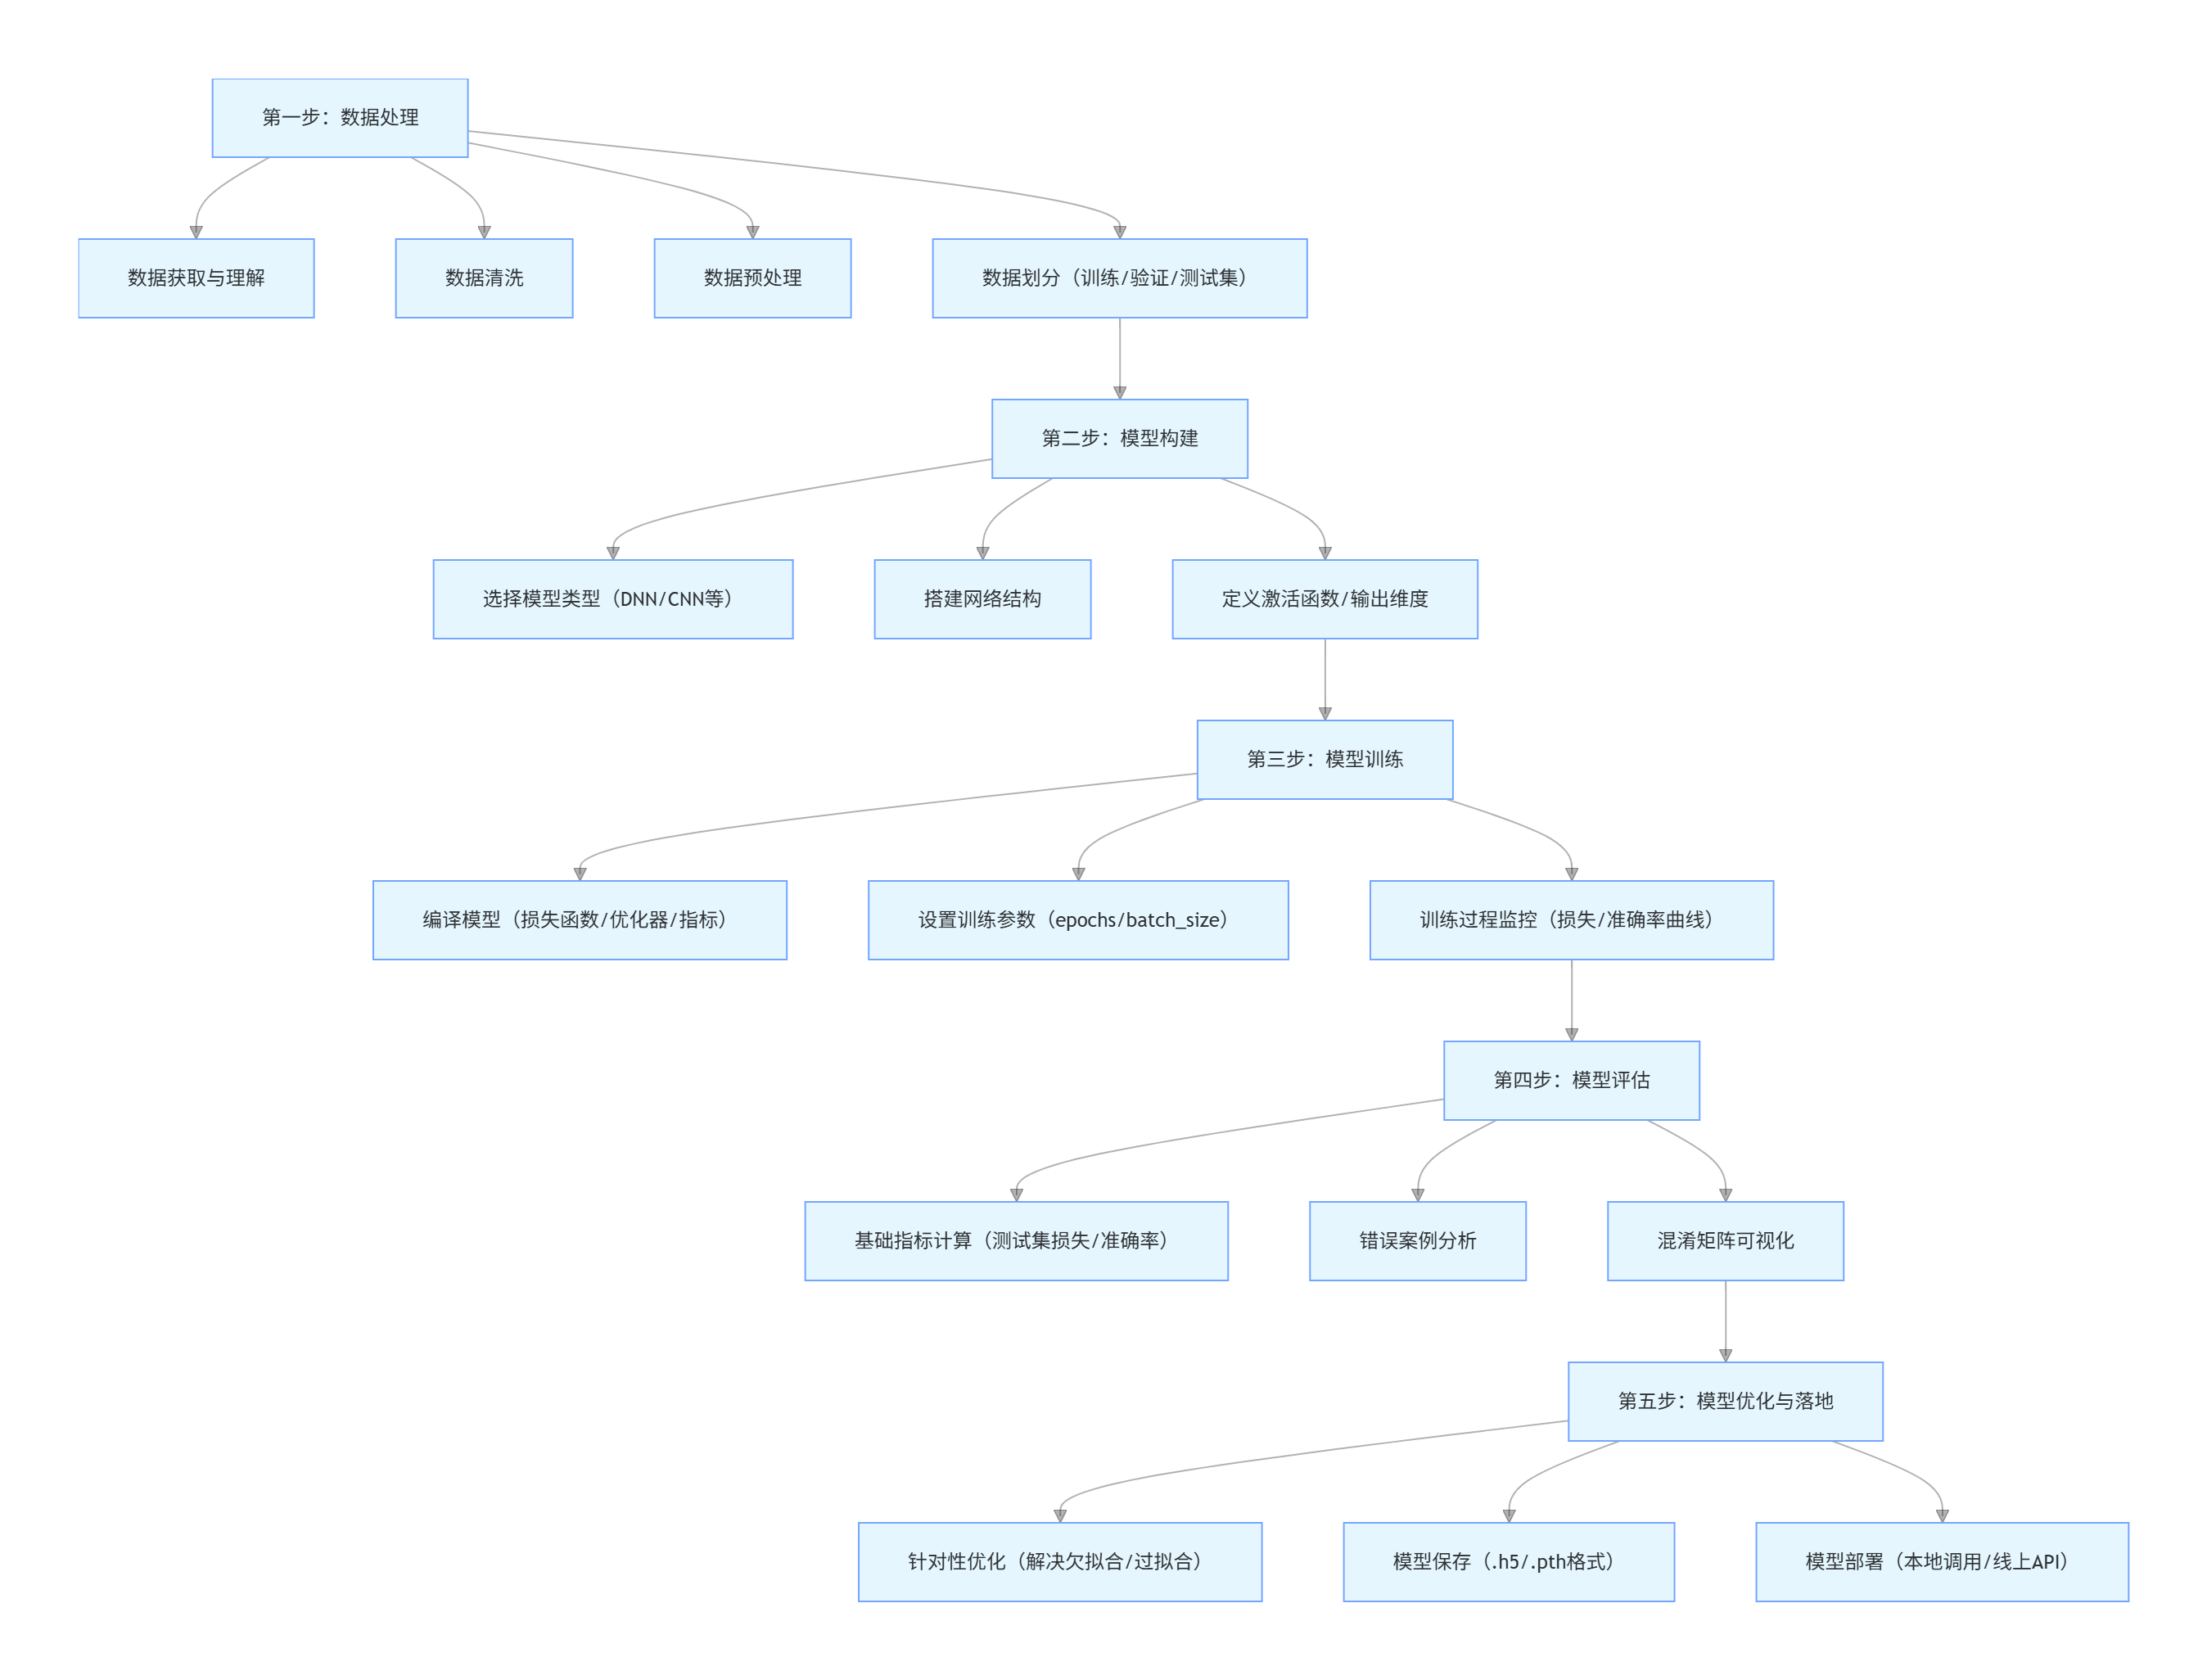
🔹 流程总览
一个深度学习项目通常沿着这个流程顺序进行,每个阶段都至关重要。
1️⃣ 数据准备
| 步骤 | 说明 | 技巧 |
|---|---|---|
| 数据收集 | 获取图像、文本、传感器等数据 | 确保数据与任务匹配 |
| 数据清洗 | 处理缺失值、异常值 | 去除脏数据,保证一致性 |
| 数据划分 | 训练集 70~80%,验证集 10~15%,测试集 10~15% | 保证验证集/测试集互不泄露 |
| 数据预处理 | 归一化/标准化,数据增强(旋转、翻转、裁剪) | 提高训练效率和泛化能力 |
💡 数据是深度学习的基础,质量直接影响模型效果。
2️⃣ 模型选择与搭建
| 类型 | 适用任务 | 框架示例 |
|---|---|---|
| CNN / ResNet | 图像分类、检测 | PyTorch, TensorFlow |
| RNN / LSTM / Transformer | 文本序列任务 | PyTorch, TensorFlow |
| 多模态网络 | 图像+文本、视频+音频 | PyTorch, TensorFlow |
⚡ 注意:
- 搭建模型时注意参数初始化、激活函数选择。
- 使用预训练模型可快速提升性能。
3️⃣ 定义损失函数与优化器
| 任务类型 | 常用损失函数 | 优化器 |
|---|---|---|
| 回归 | 均方误差 (MSE) | SGD, Adam |
| 分类 | 交叉熵 (Cross Entropy) | Adam, RMSprop |
| 对比/生成任务 | 对比损失、GAN 损失 | Adam |
💡 小提示:学习率 lr 是关键参数,过大可能发散,过小训练缓慢。
4️⃣ 模型训练
训练过程可以分为四步:
- 前向传播:输入 → 网络 → 输出
- 计算损失:预测值 vs 真实值
- 反向传播:计算梯度
- 参数更新:优化器更新参数
迭代概念:
- Batch Size:每次训练多少样本
- Epoch:整个训练集训练一次
训练的核心步骤:
for epoch in range(num_epochs):
    for batch in dataloader:
        # 1. 前向传播
        outputs = model(inputs)

        # 2. 计算损失
        loss = criterion(outputs, labels)

        # 3. 反向传播
        optimizer.zero_grad()
        loss.backward()

        # 4. 更新参数
        optimizer.step()
⚡ 小技巧:
- 使用 GPU 可大幅加速训练
- 记录训练/验证损失曲线,及时发现过拟合
5️⃣ 模型评估与验证
| 阶段 | 指标示例 |
|---|---|
| 验证集调参 | 验证损失、准确率、F1 等 |
| 测试集最终评估 | Accuracy, Precision, Recall, F1, MSE, MAE |
💡 建议:
- 验证集用于超参数调整,测试集用于最终性能评估
- 可视化混淆矩阵帮助分析错误类型
6️⃣ 模型保存与部署
-
模型保存:
- PyTorch:
torch.save(model.state_dict(), "model.pth") - TensorFlow/Keras:
model.save("model.h5")
- PyTorch:
-
模型加载:
- PyTorch:
model.load_state_dict(torch.load("model.pth")) - Keras:
model = tf.keras.models.load_model("model.h5")
- PyTorch:
-
部署与推理:
- 本地推理:适合小规模应用。
- 云端部署 / API 服务:适合大规模应用。
⚡ 小技巧:
- 模型可部署在本地小应用或云端大规模服务
- 保持训练/部署环境一致,避免版本问题
7️⃣ 常见问题与解决方案
| 问题 | 现象 | 解决方案 |
|---|---|---|
| 过拟合 | 训练集高,验证集低 | 数据增强、正则化、Dropout |
| 欠拟合 | 训练集低,验证集低 | 增加模型复杂度或训练时间 |
| 梯度消失/爆炸 | 学习停滞或发散 | 调整 lr,ReLU 激活,BatchNorm |
| 训练时间过长 | GPU 利用不足 | 使用 GPU/TPU、调整 batch size |
🔹 总结
深度学习的精髓在于“数据 + 模型 + 优化”,多实践、多观察训练曲线,是快速成长的关键。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 29
 0
- 0


 已为社区贡献1条内容

所有评论(0)