机器学习模型构建全指南:从数据到部署的实战详解
目录
构建有效的机器学习模型是一门科学,也是一门艺术。
本文将详细解析机器学习模型构建的六个核心步骤,并分享每个阶段的关键技术、实用方法和最佳实践。无论你是机器学习初学者还是希望系统化知识体系的从业者,这篇指南都能为你提供有价值的参考。
🤖 机器学习工作流概览
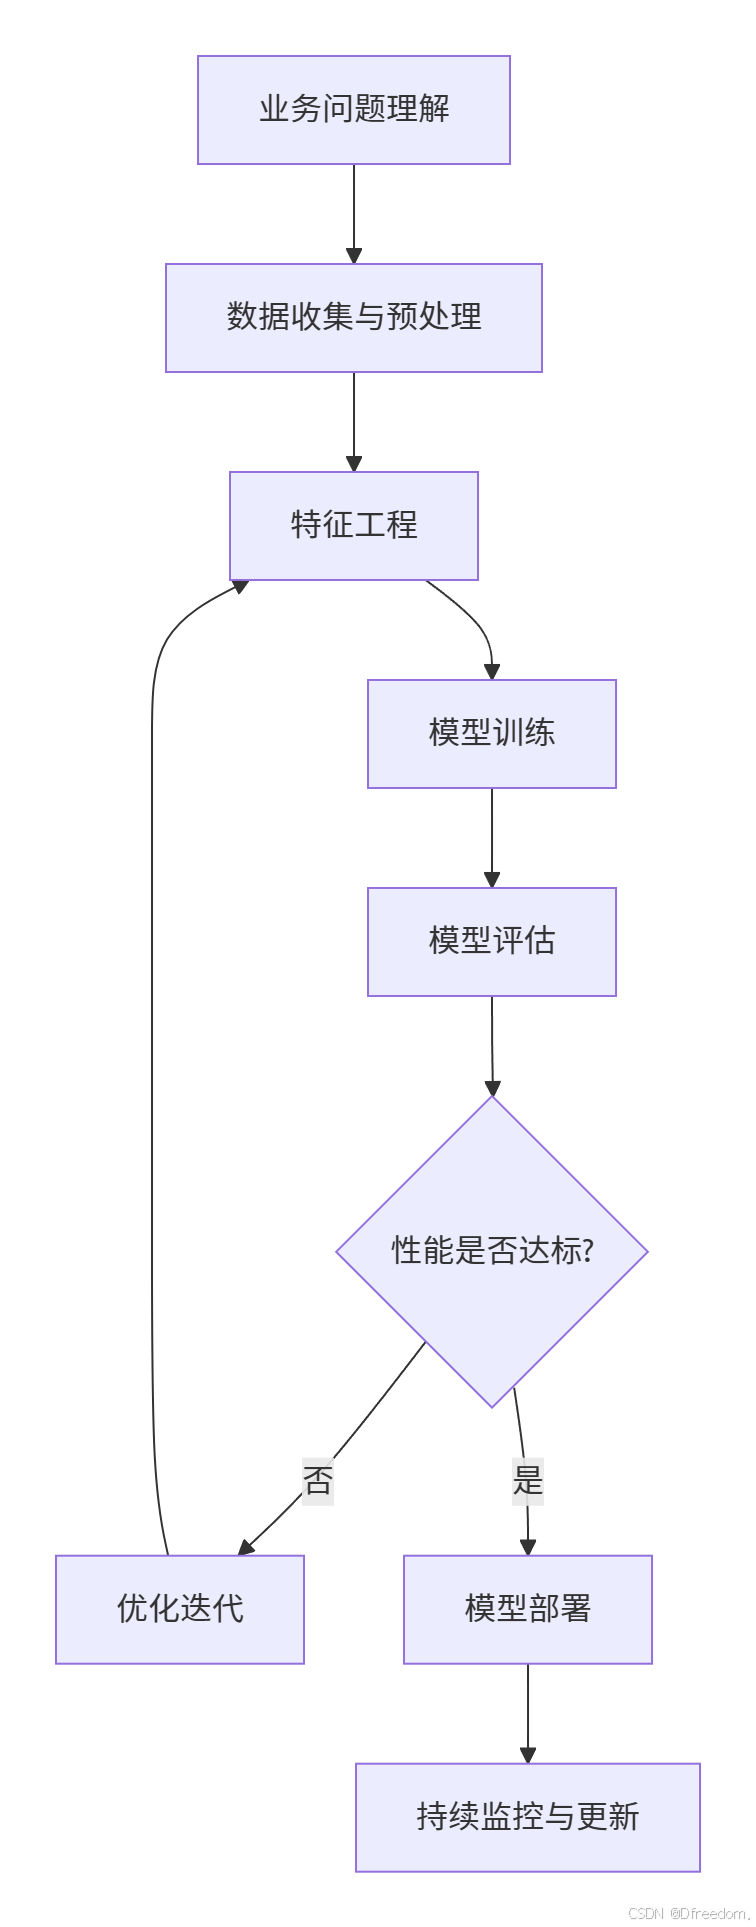
机器学习项目的成功离不开结构化的开发流程。下面通过一个流程图直观展示从数据到部署的全过程:
🔍 六大核心步骤详解
1. 数据收集与预处理:质量决定上限
数据是机器学习模型的基石,数据质量直接决定了模型性能的上限。
数据收集策略:
-
多样化数据源:公开数据集(如Kaggle、UCI、ImageNet)、网络爬虫、API接口和企业内部数据库都是常见数据来源
-
质量优于数量:确保数据具有完整性(覆盖各种场景)、准确性(真实可靠)和多样性(避免偏差)
-
合规性注意:特别注意数据隐私和安全性要求,确保合法合规使用数据
数据预处理关键技术:
-
缺失值处理:根据数据特性选择删除法(直接删除缺失记录)或插补法(使用均值、中位数、众数或模型预测填补)
-
异常值检测与处理:通过箱线图可视化或统计学方法(如3σ准则)识别异常值,并根据业务背景决定删除或修正
-
数据标准化:常用Z-score标准化(使数据均值为0,标准差为1)或Min-Max归一化(缩放到[0,1]区间)
2. 特征工程:艺术与科学的结合
特征工程是机器学习的核心环节,它通过一系列技术手段将原始数据转换为更能揭示潜在规律的高质量特征,直接决定了模型性能的上限。其关键流程与技术如下表:
| 核心环节 | 关键任务与技术 | 核心价值 |
|---|---|---|
| 数据理解与探查 | 分析数据类型、分布、缺失值与相关性 | 奠定后续处理的基石,避免盲目操作 |
| 数据清洗与预处理 | 处理缺失值(删除、填充、编码缺失)、异常值(识别与处理)、格式转换 | 提升数据质量,保证后续操作的可靠性 |
| 特征构建与转换 | 编码:独热编码(无序类别)、标签编码(有序类别)、目标编码(高基数类别) | 将原始数据转化为模型更易理解和利用的形态,是提升模型性能的关键步骤 |
| 特征选择与降维 | 特征选择:过滤法(统计指标)、包装法(模型性能)、嵌入法(模型内置) | 剔除冗余和噪声特征,降低计算复杂度,缓解维度灾难,提升模型泛化能力 |
💡 关键认知与建议
-
迭代与评估:特征工程是一个迭代过程。需通过实际模型表现(如交叉验证)不断评估和调整特征效果。
-
业务与领域知识:特征工程不仅是技术活,更需要对业务逻辑的深刻理解。很多时候,一个基于领域知识构造的特征(如“负债收入比”)比复杂变换更有效。
-
没有银弹:不存在一套放之四海皆准的方法。最佳特征工程策略高度依赖于数据特点、问题类型和所选模型。需要不断实验和摸索。
3. 模型训练:算法与数据的舞蹈
模型训练是使用算法从数据中学习模式的过程,需要根据任务类型选择合适的模型。
模型选择指南:
-
回归任务(预测连续值):线性回归、决策树回归、随机森林回归
-
分类任务(预测离散类别):逻辑回归、支持向量机(SVM)、随机森林分类、神经网络
-
复杂数据与任务:图像处理常用CNN,自然语言处理常用RNN或Transformer,生成任务可用GAN或VAE
训练过程关键要素:
-
数据划分:通常按8:1:1划分训练集、验证集和测试集
-
损失函数选择:回归常用均方误差(MSE),分类常用交叉熵损失
-
优化器选择:SGD、Adam等优化器通过反向传播等机制最小化损失,更新模型参数
-
超参数调优:使用网格搜索、随机搜索或贝叶斯优化寻找最佳超参数组合
4. 模型评估:客观衡量模型性能
用未参与训练的测试数据客观评估模型性能是确保模型可靠性的关键环节。
回归模型评估指标:
-
R² (R平方):衡量模型对目标变量方差的解释程度,越接近1越好
-
MSE (均方误差):预测值与真实值之差的平方的平均数,值越小越好
-
MAE (平均绝对误差):预测值与真实值之差的绝对值的平均数,解释更直观
分类模型评估指标:
-
准确率 (Accuracy):正确预测的样本数占总样本数的比例
-
精确率 (Precision):预测为正例的样本中真正为正例的比例,关注预测的准确性
-
召回率 (Recall):真正为正例的样本中被预测为正例的比例,关注找出所有正例的能力
-
F1分数 (F1-Score):精确率和召回率的调和平均数,综合衡量模型性能
5. 模型优化:提升泛化能力
模型优化的核心目标是提升模型的泛化能力,避免过拟合或欠拟合。
过拟合或欠拟合的应对策略:
| 问题类型 | 核心表征 | 关键策略 | 常见方法举例 |
|---|---|---|---|
| 欠拟合 | 模型过于简单,训练集和测试集表现均不佳 | 1. 增加模型复杂度 | • 添加多项式特征 • 改用更复杂算法(如用神经网络替代线性模型) • 减少或去除正则化 • 应用Boosting算法 • 增加训练轮数(Epochs) |
| 过拟合 | 模型过于复杂,训练集表现好,测试集表现差 | 1. 简化模型或增加约束 | • 增强正则化强度(L1/L2) • 增加训练数据量• 早停法(Early Stopping) • 特征选择 • Dropout(神经网络) |
特征选择与超参数调优:
-
特征选择:从已有特征中筛选最重要特征子集,减少冗余和噪声,提高模型可解释性
-
系统调参:使用网格搜索、随机搜索或贝叶斯优化等方法寻找最佳超参数组合
6. 模型部署:从实验到生产
将训练好的模型投入实际使用是整个项目价值实现的关键一步。
模型保存格式:
-
Python特有格式:
pickle、joblib -
跨平台格式:
ONNX(有助于模型在不同框架间迁移) -
框架特定格式:TensorFlow的
SavedModel,PyTorch的.pt或.pth
部署方式选择:
-
Web API服务:使用Flask、FastAPI等框架将模型封装成RESTful API服务,部署在本地服务器或云平台
-
嵌入式部署:将模型转换为TensorFlow Lite等格式,在移动设备或嵌入式设备上运行
-
应用程序集成:将模型直接集成到现有的Web、移动端或桌面应用中
持续监控与更新:
部署后需持续监控模型在生产环境中的表现,检测模型漂移(数据分布变化导致性能下降),定期用新数据重新训练或微调模型以保持其性能。
💡 深度思考与最佳实践
迭代式开发:机器学习项目的本质
机器学习项目很少是一次性成功的线性过程。迭代式开发是其核心特征:你需要不断在特征工程、模型选择和超参数调优等步骤之间循环往复。每次迭代都基于前次实验结果进行改进,逐步逼近最优解决方案。
业务理解:一切工作的出发点
技术服务于业务:对业务问题的深刻理解是项目成功的首要条件。它直接影响数据收集策略、特征工程方向和评估指标选择。一个在技术指标上表现良好的模型,如果不能满足实际业务需求,仍然是失败的。
数据质量:模型性能的天花板
"垃圾进,垃圾出" 在机器学习领域尤为显著。数据质量直接决定了模型性能的上限。即使最先进的算法也无法从低质量数据中学习到有效模式。投入足够时间在数据收集和预处理上,通常比后期盲目尝试不同算法回报更高。
没有免费午餐定理:实践出真知
No Free Lunch定理表明:没有一个模型能在所有问题上都表现最好。你必须通过实验为你的特定问题和数据集找到合适的模型和配置。这要求保持开放心态,不盲目崇拜某种算法,而是根据实际问题进行多次实验比较。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 26
 0
- 0


 已为社区贡献13条内容

所有评论(0)