Python基于Spark的社交媒体舆情分析系统 微博+贴吧数据 hadoop 毕业设计 数据仓库 大数据舆情NLP项目(建议收藏)✅
·
博主介绍:✌全网粉丝50W+,前互联网大厂软件研发、集结硕博英豪成立软件开发工作室,专注于计算机相关专业项目实战6年之久,累计开发项目作品上万套。凭借丰富的经验与专业实力,已帮助成千上万的学生顺利毕业,选择我们,就是选择放心、选择安心毕业✌
> 🍅想要获取完整文章或者源码,或者代做,拉到文章底部即可与我联系了。🍅🍅感兴趣的可以先收藏起来,点赞、关注不迷路,大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助同学们顺利毕业 。🍅
1、毕业设计:2026年计算机专业毕业设计选题汇总(建议收藏)✅
1、项目介绍
技术栈:论坛数据(百度、微博)、Python语言、requests爬虫技术、Django框架、SnowNLP情感分析、MySQL数据库、Echarts可视化、Hadoop、Spark、Hive大数据技术、虚拟机
研究背景:社交媒体数据爆炸式增长,人工舆情监测效率低、滞后长。利用requests轻量爬虫实时抓取微博与贴吧数据,结合SnowNLP情感分析与Echarts可视化,并在Hadoop+Spark+Hive大数据平台完成离线计算,可在分钟级完成“爬取-情感-图表-大屏”闭环,为高校、政府、企业提供低成本、可扩展的舆情洞察解决方案。
研究意义:系统支持单机和虚拟机双平台部署,全程本地运行保障数据隐私;模块化代码支持算法热插拔,适合作为“大数据”“情感计算”课程实践与毕业设计模板,推动大数据舆情分析在教学与产业中的落地应用。
2、项目界面
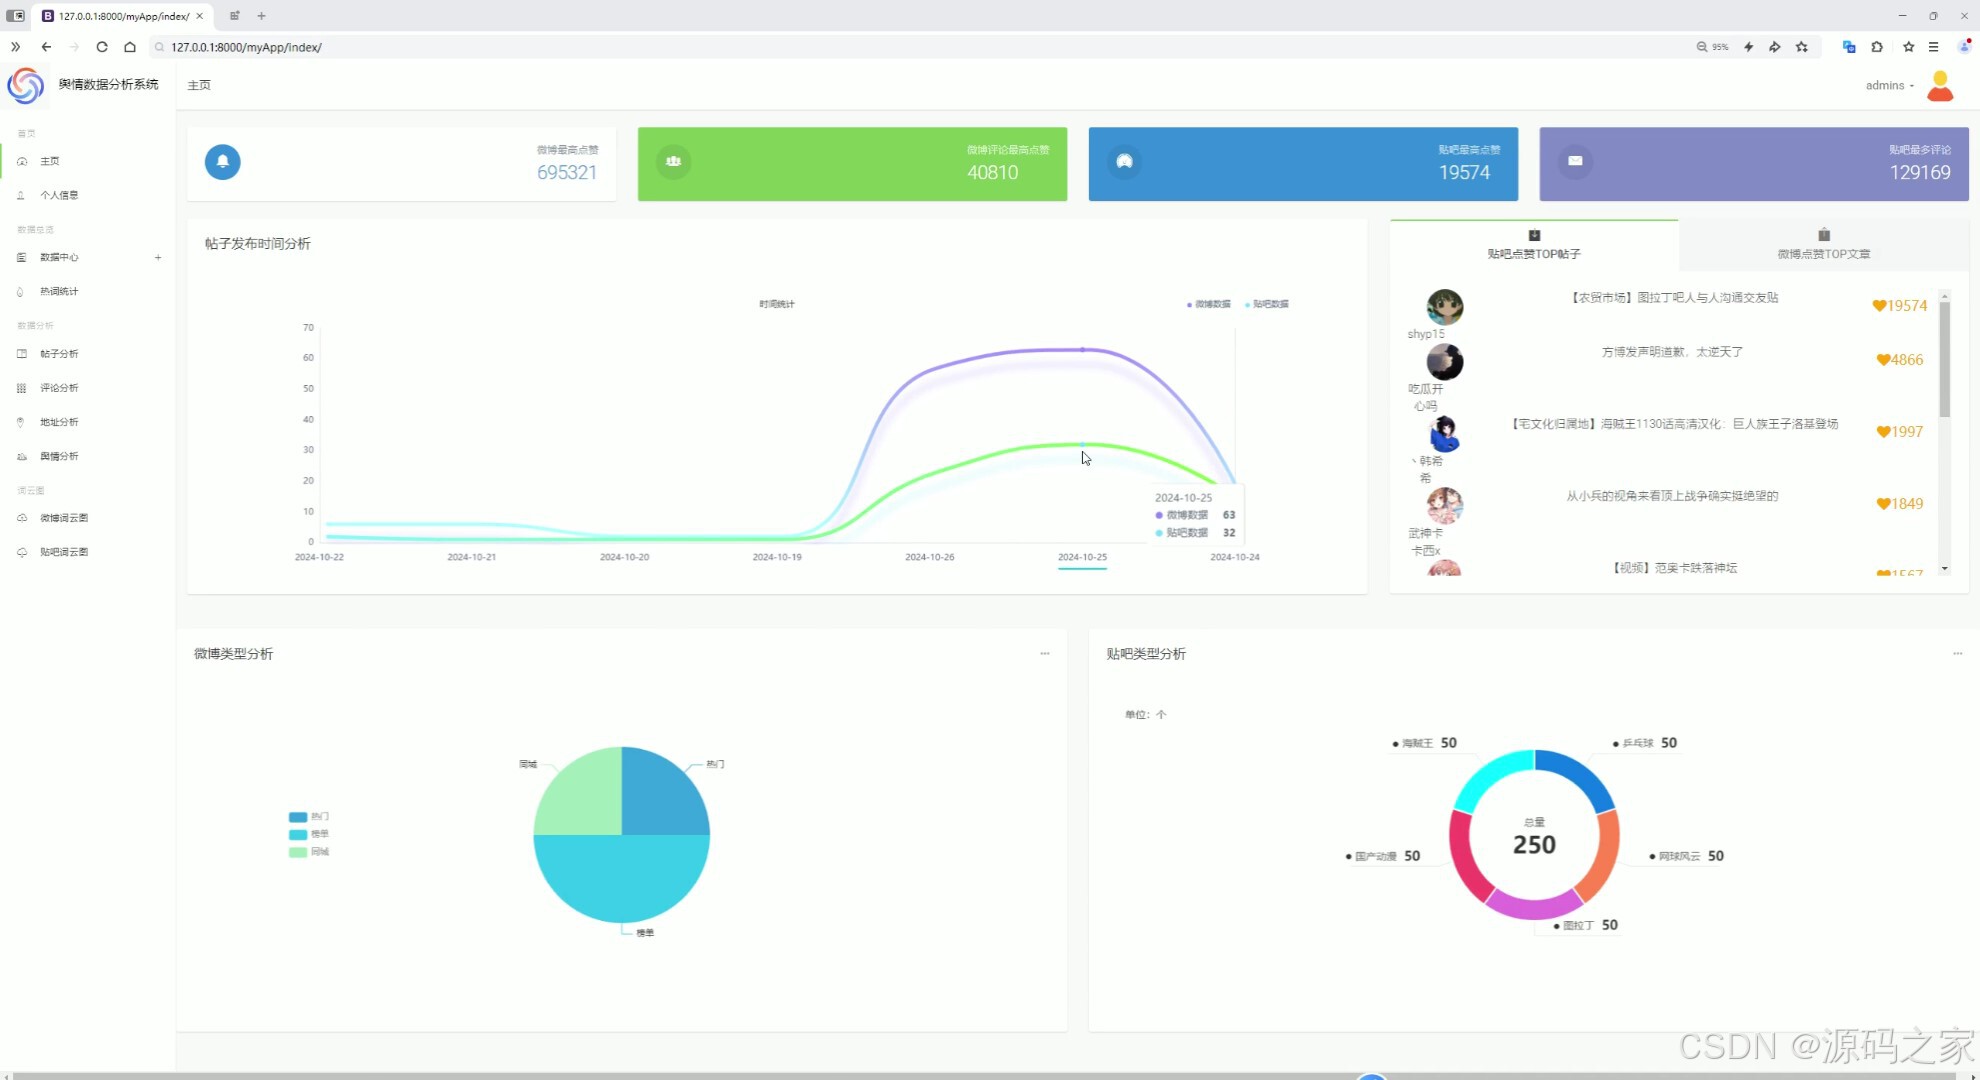
(1)首页–数据概况
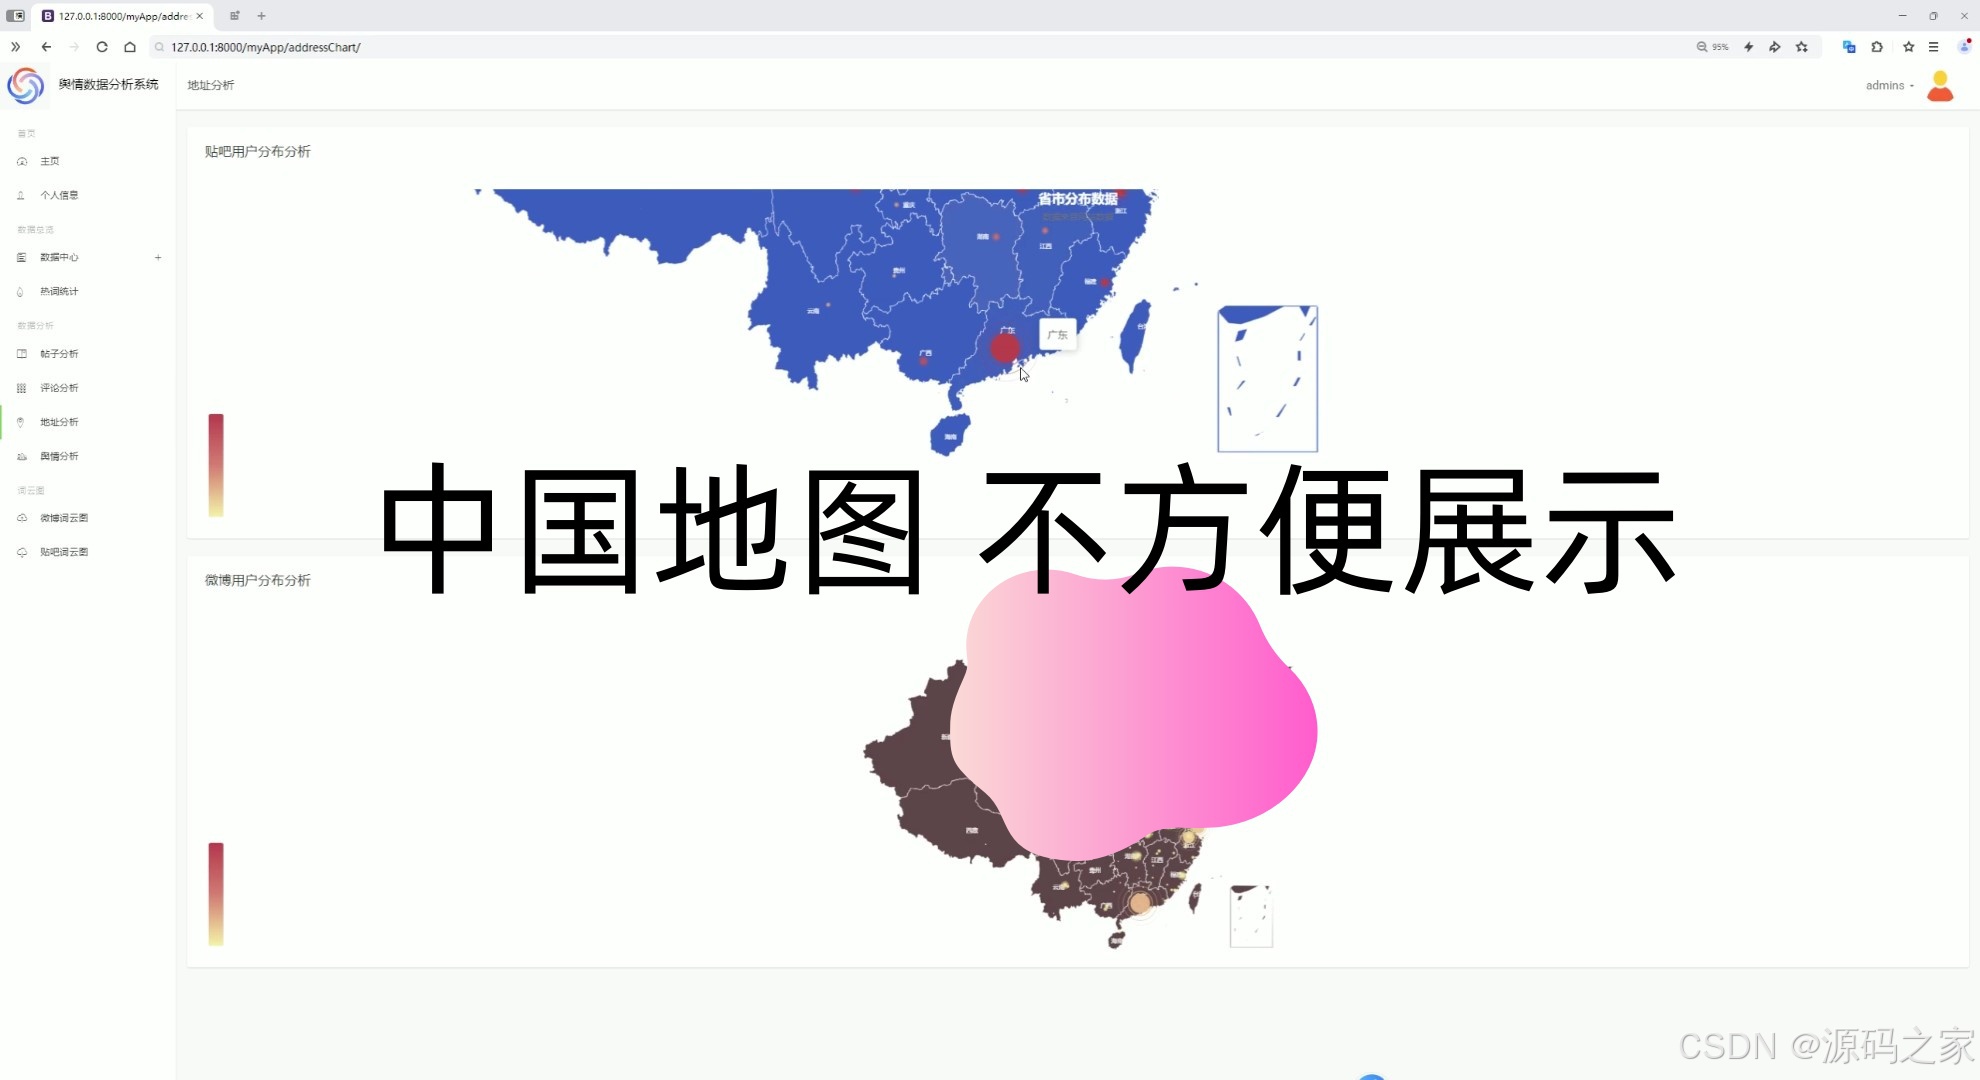
(2)贴吧用户地址分布分析、微博用户地址分布分析(中国地图)
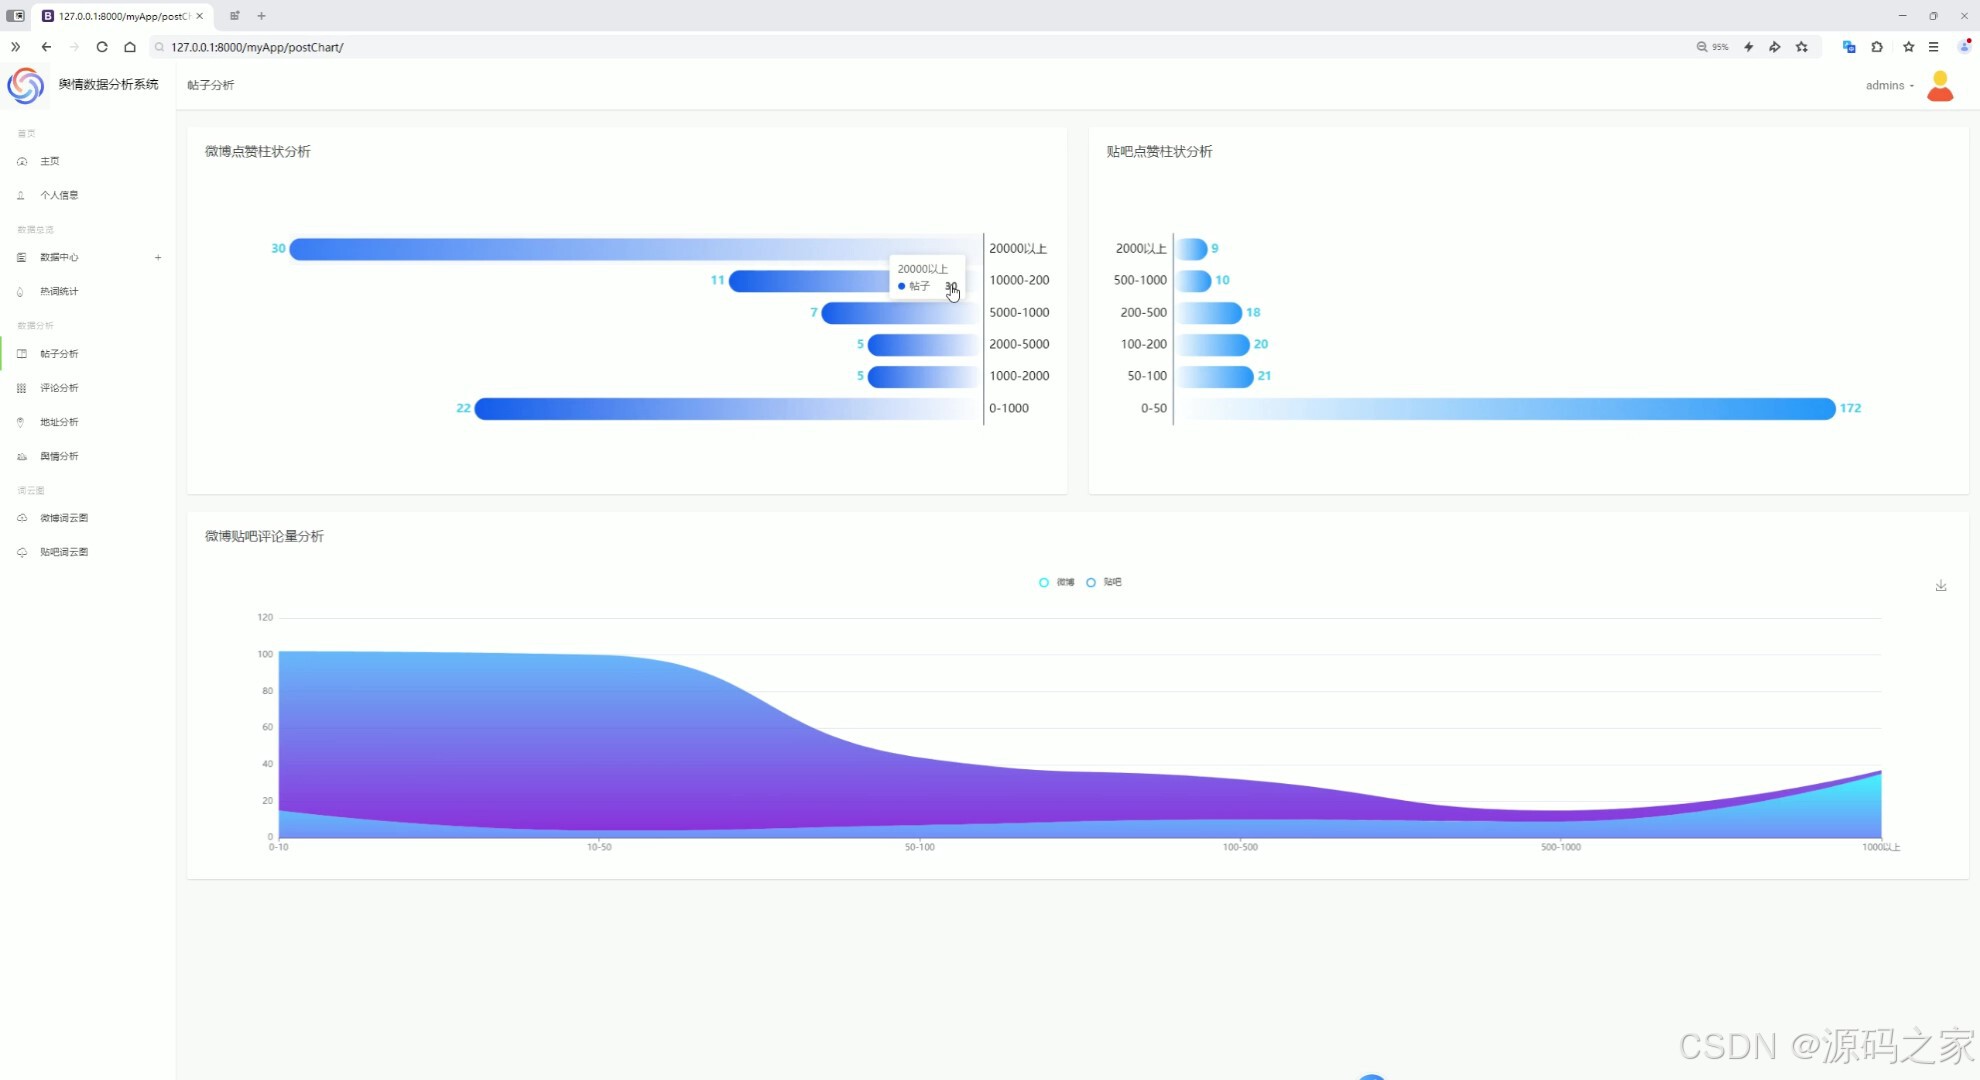
(3)帖子分析
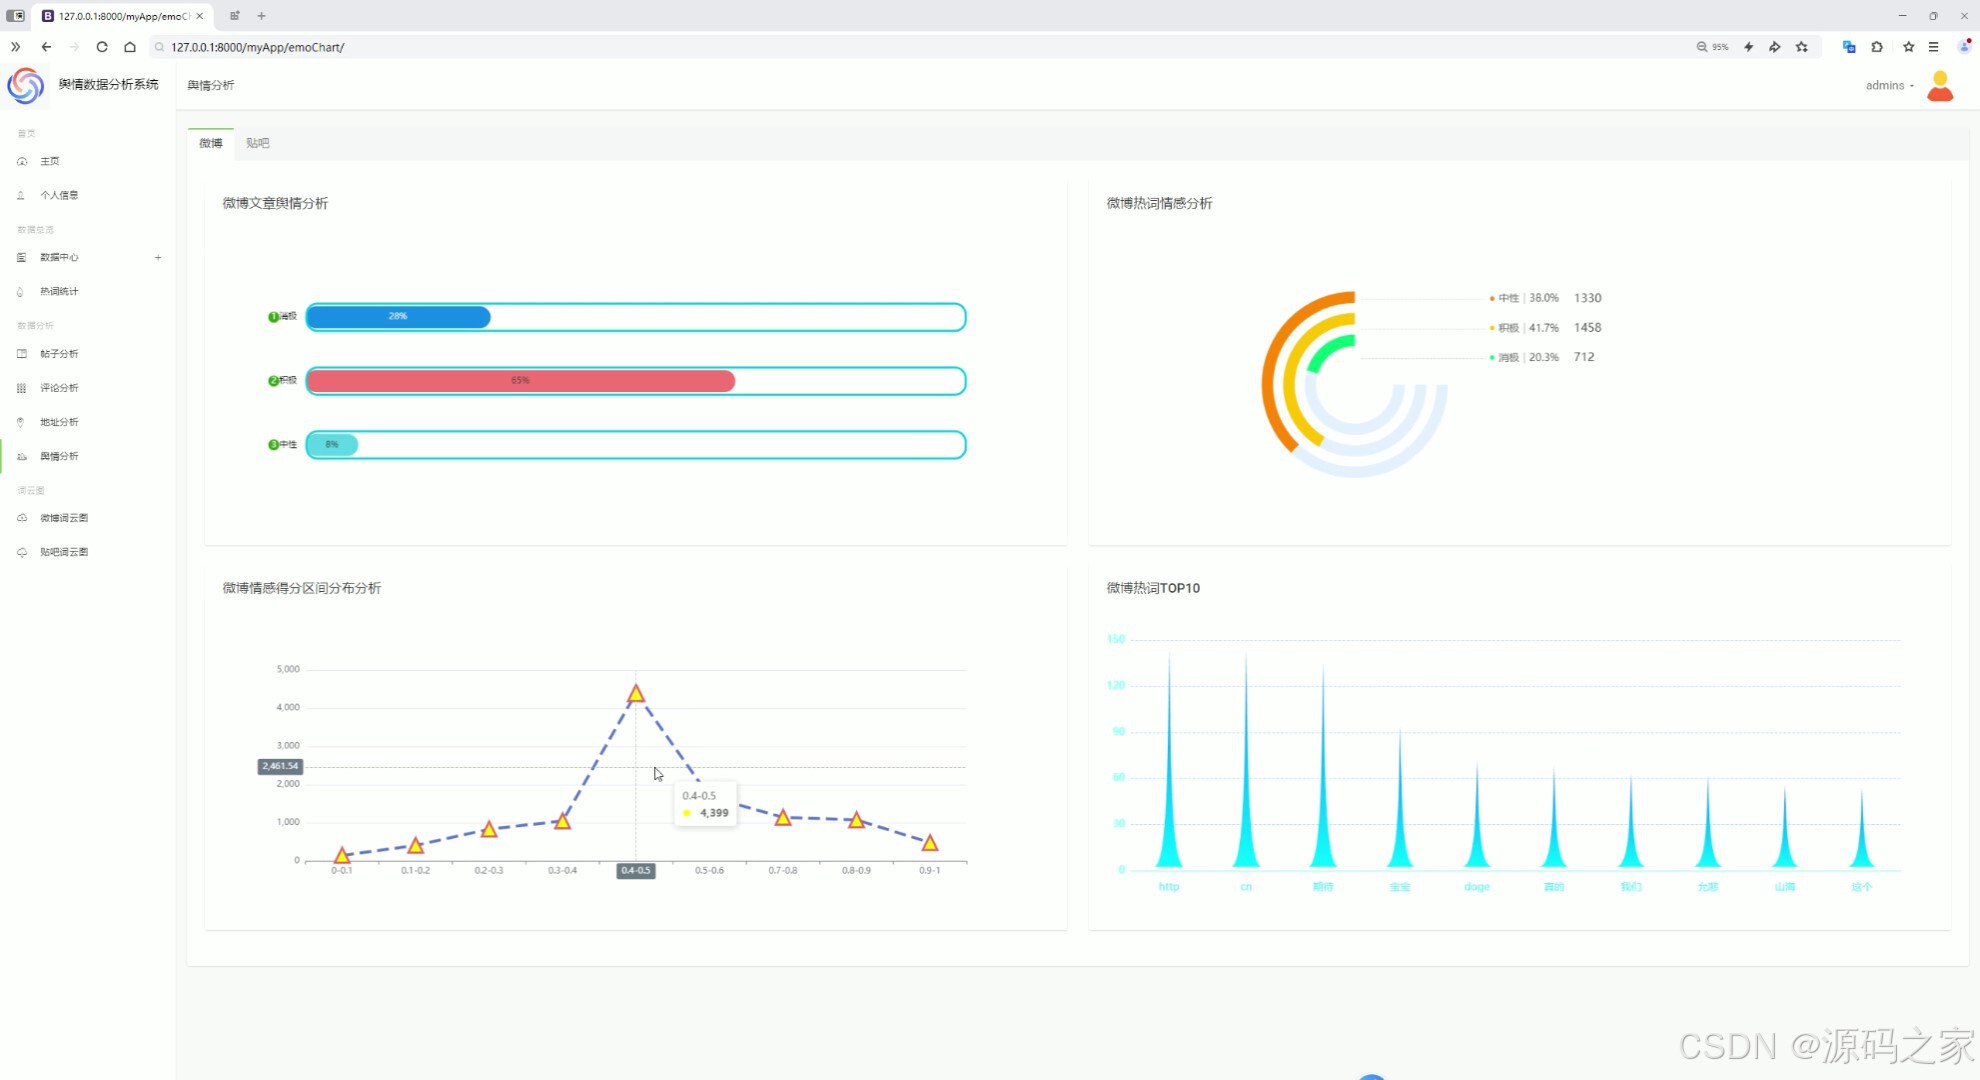
(4)舆情分析
(5)评论分析
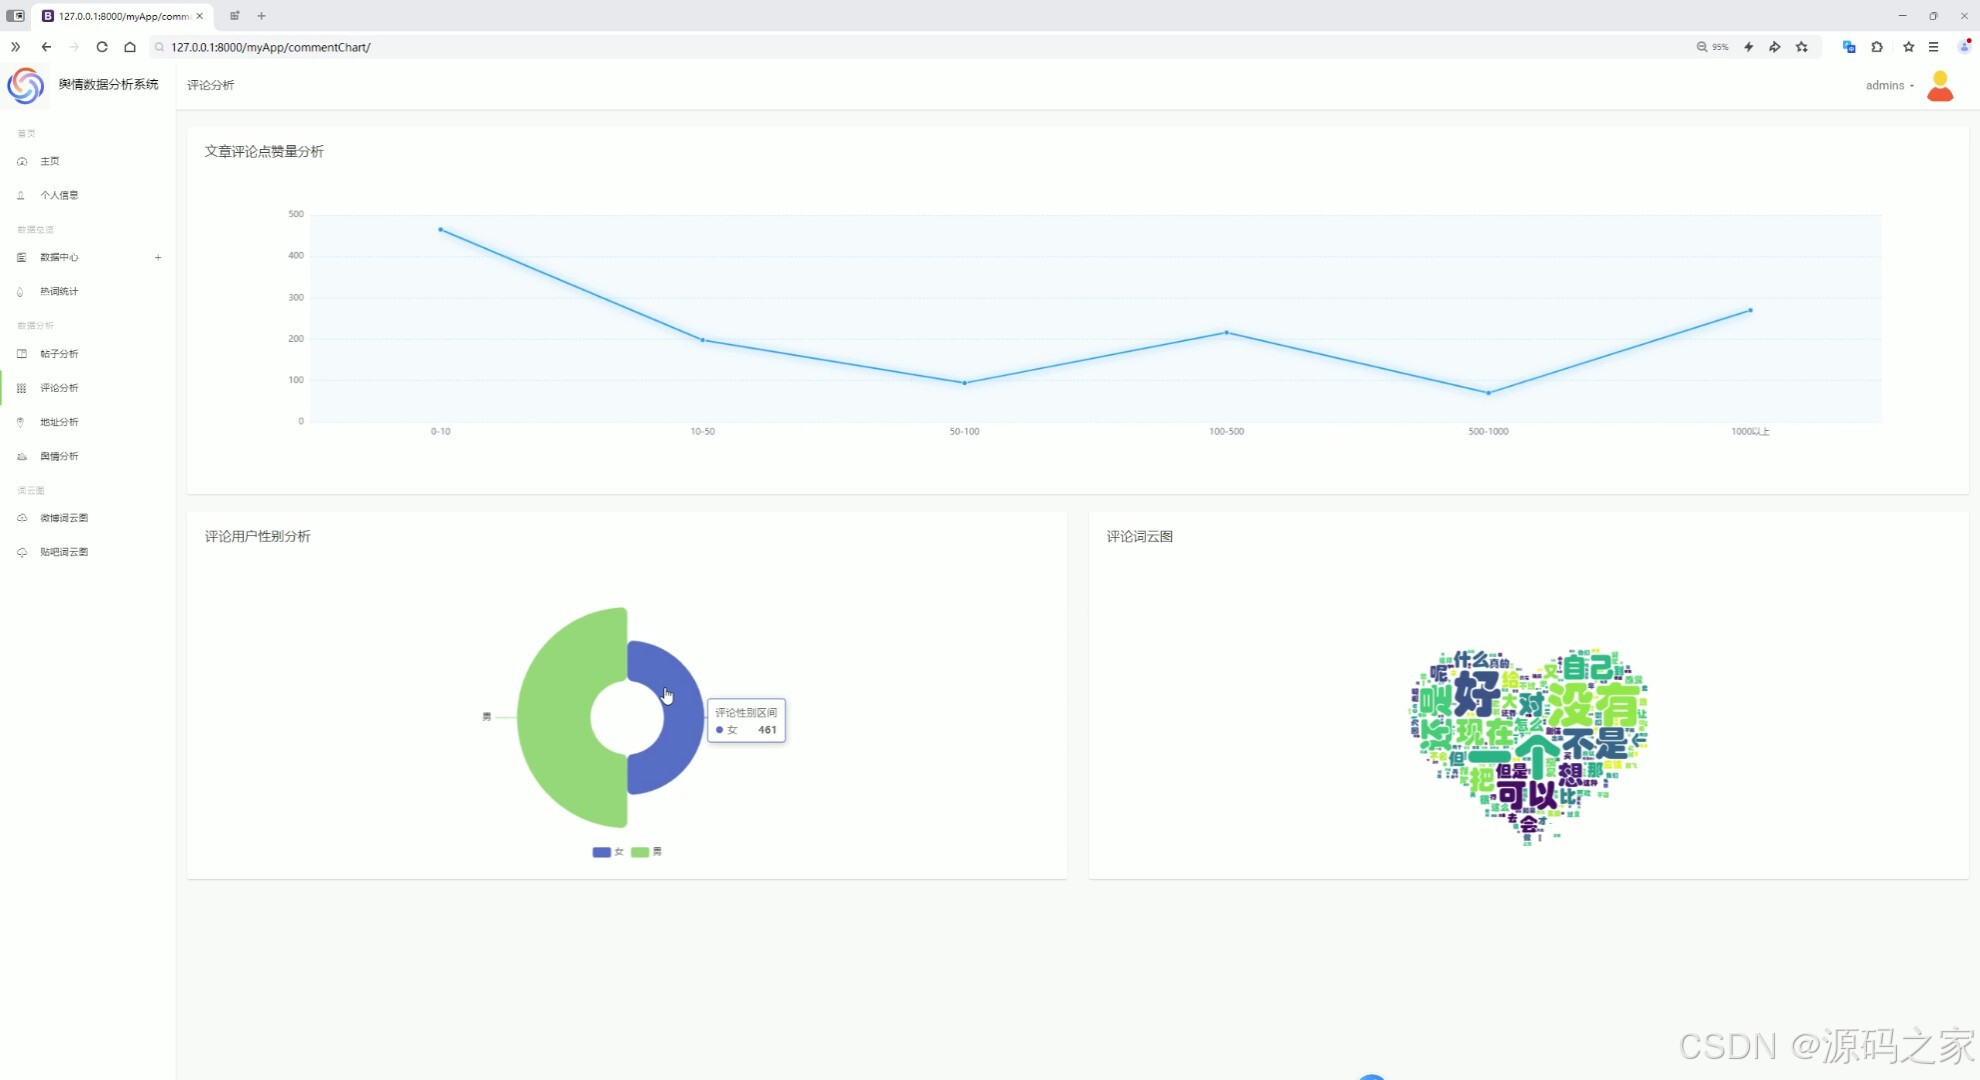
(6)词云图分析
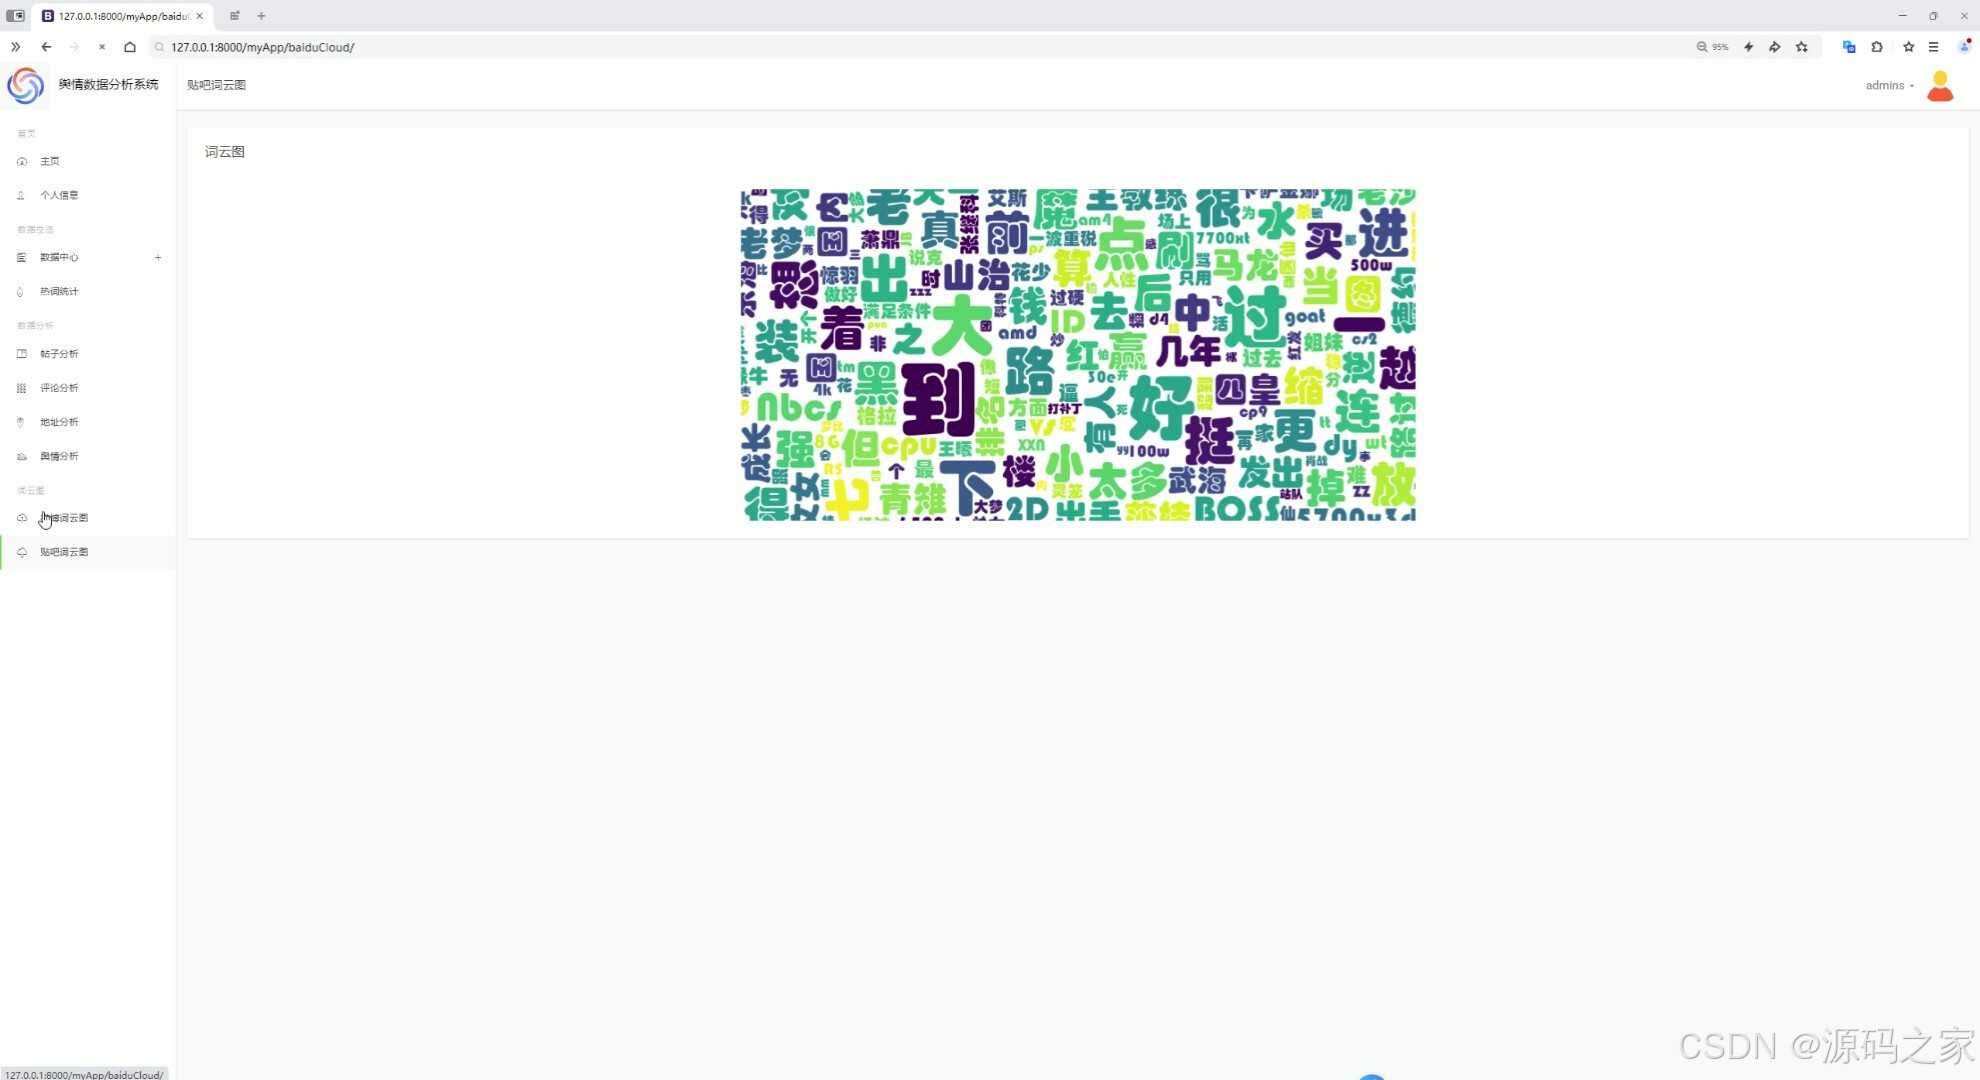
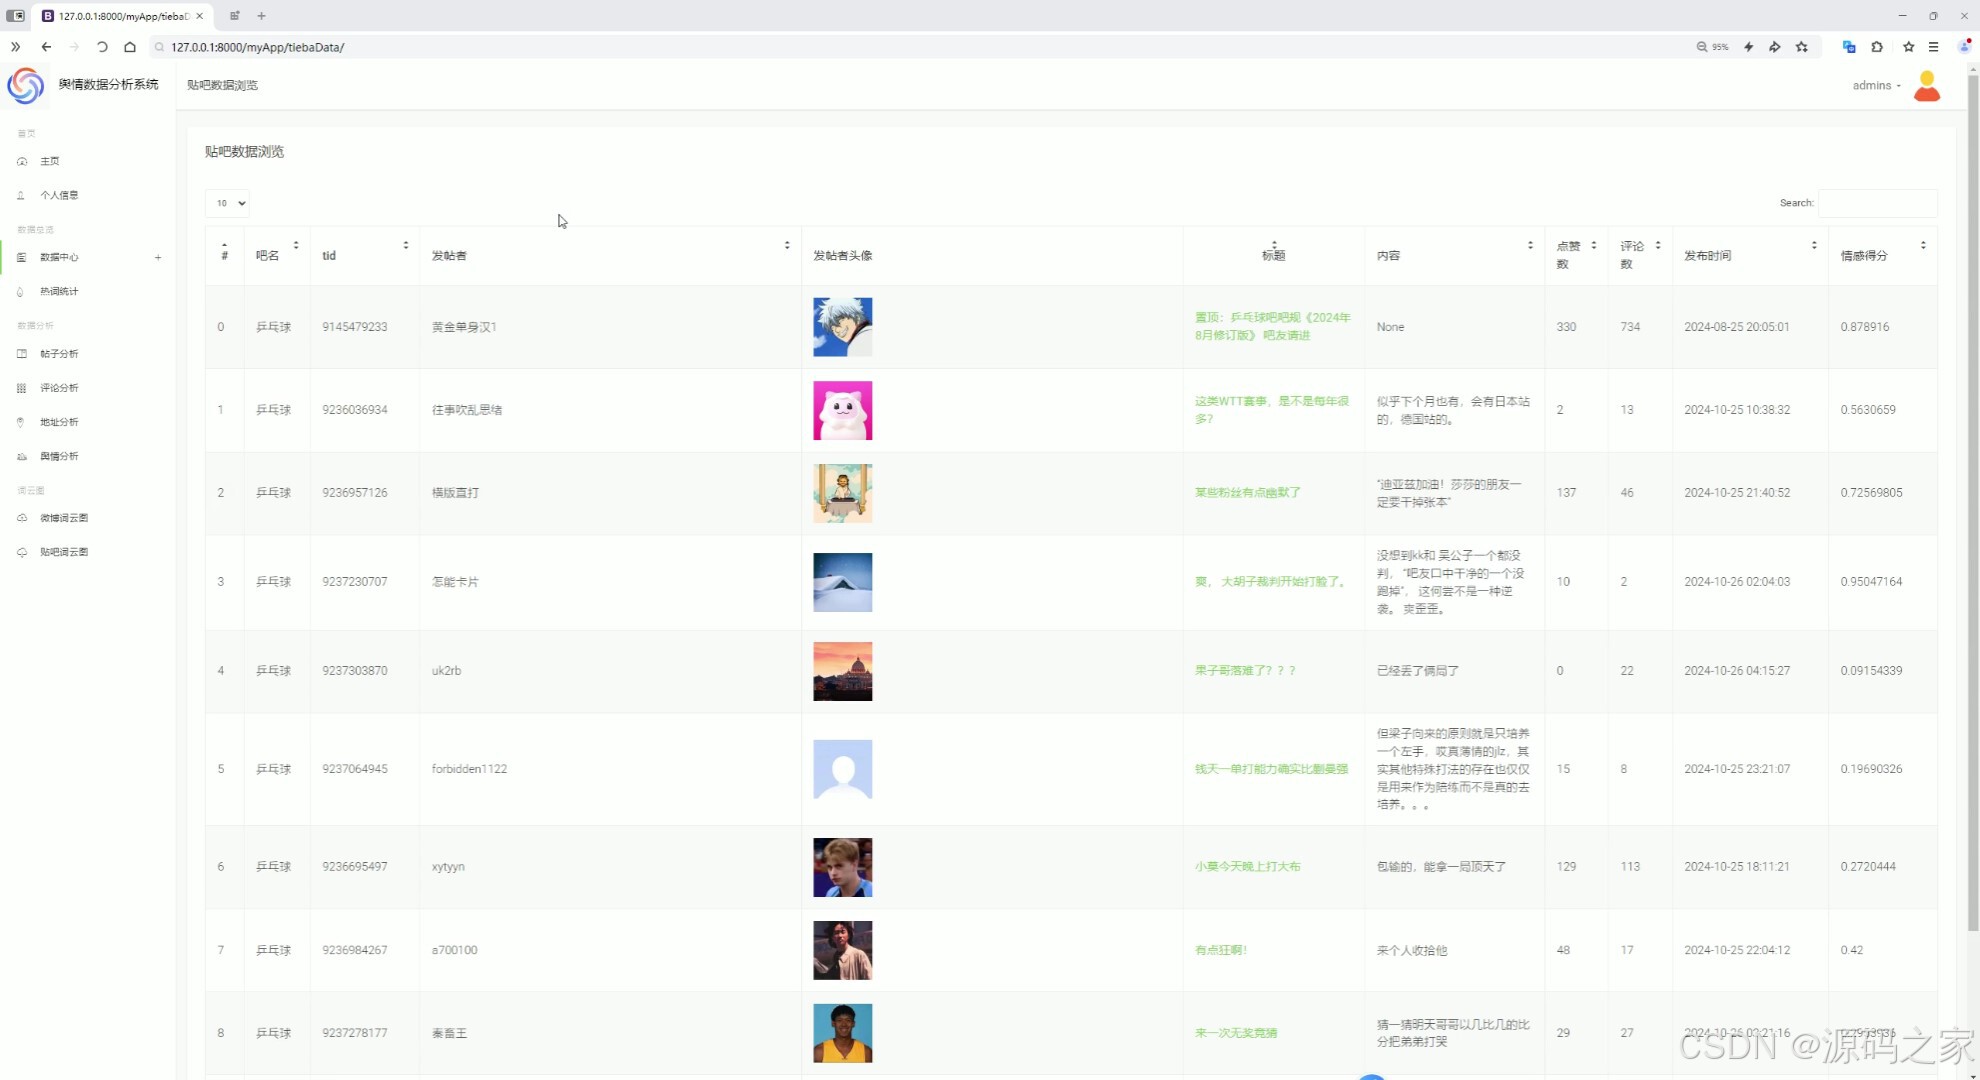
(7)贴吧数据中心、微博数据中心
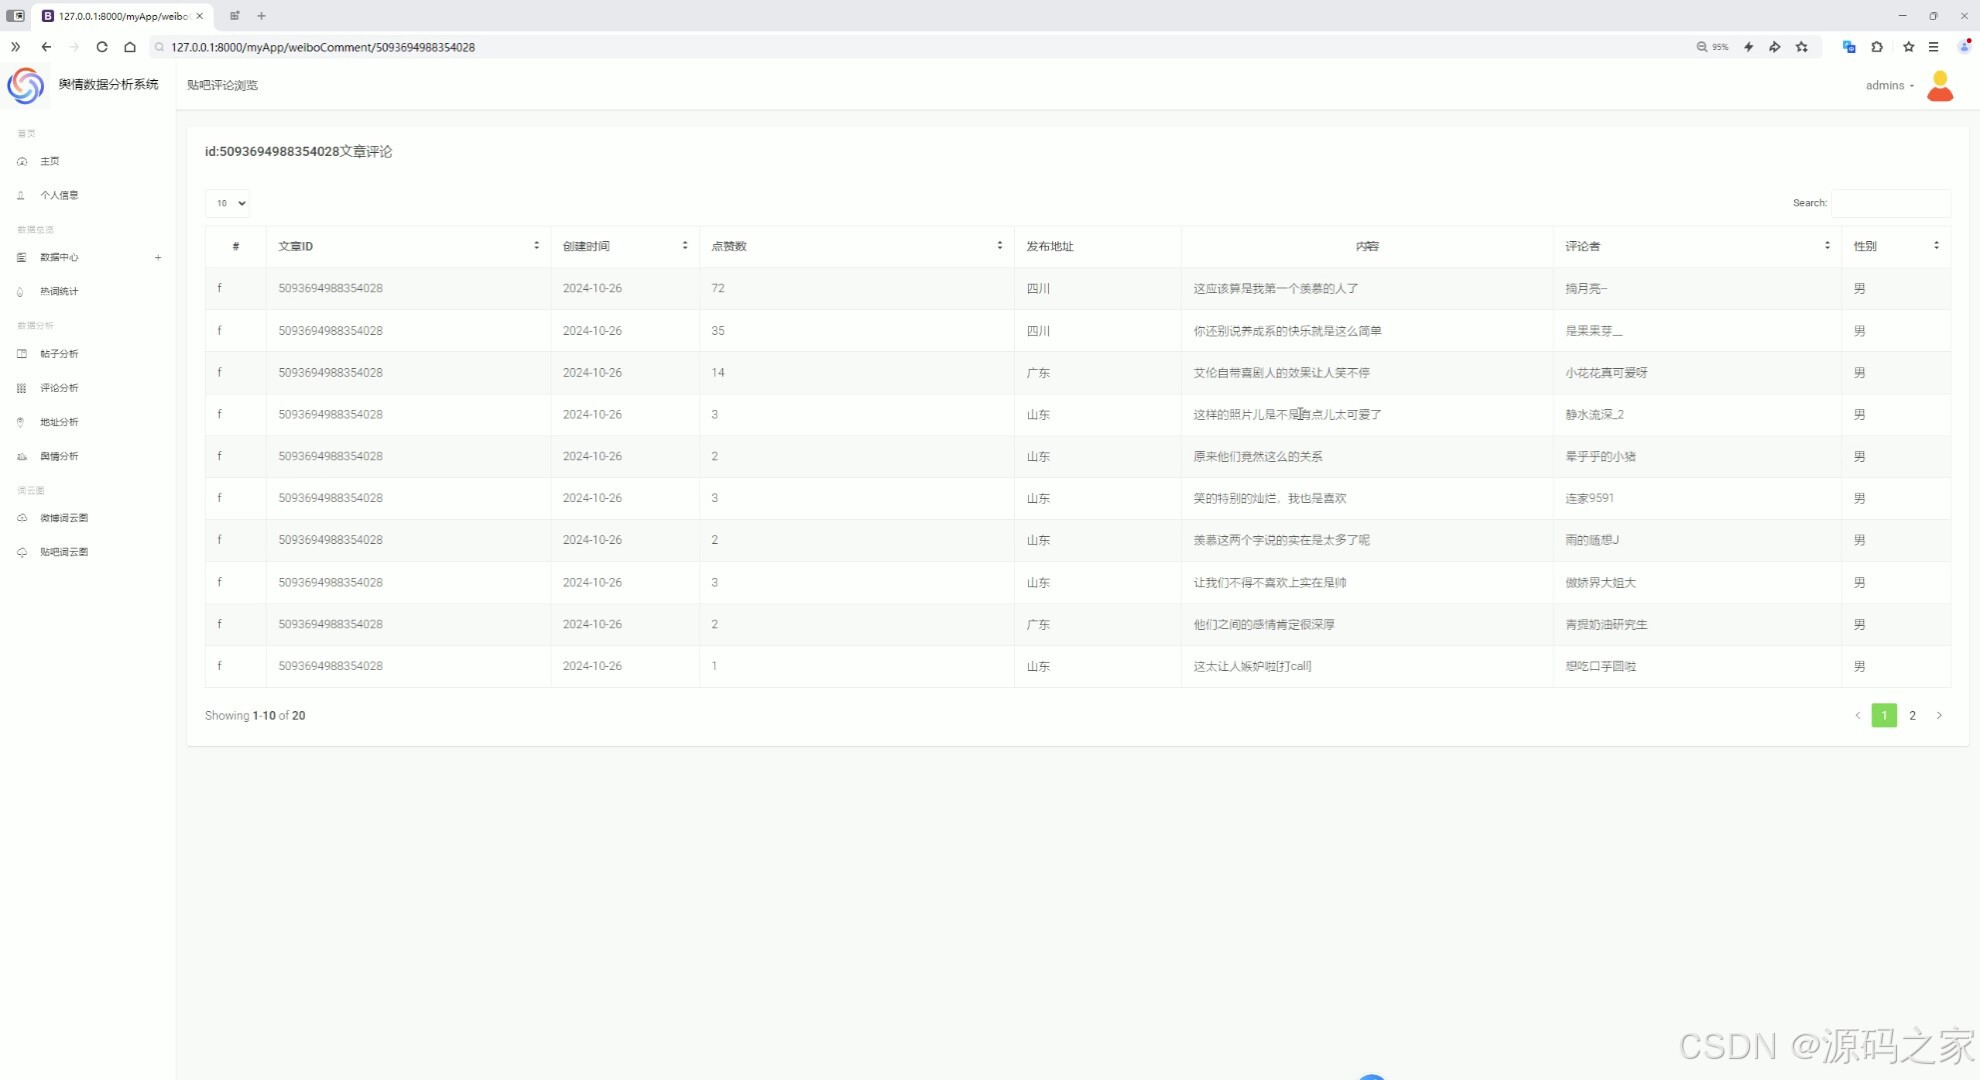
(8)微博评论中心、贴吧评论中心
(9)热词统计分析
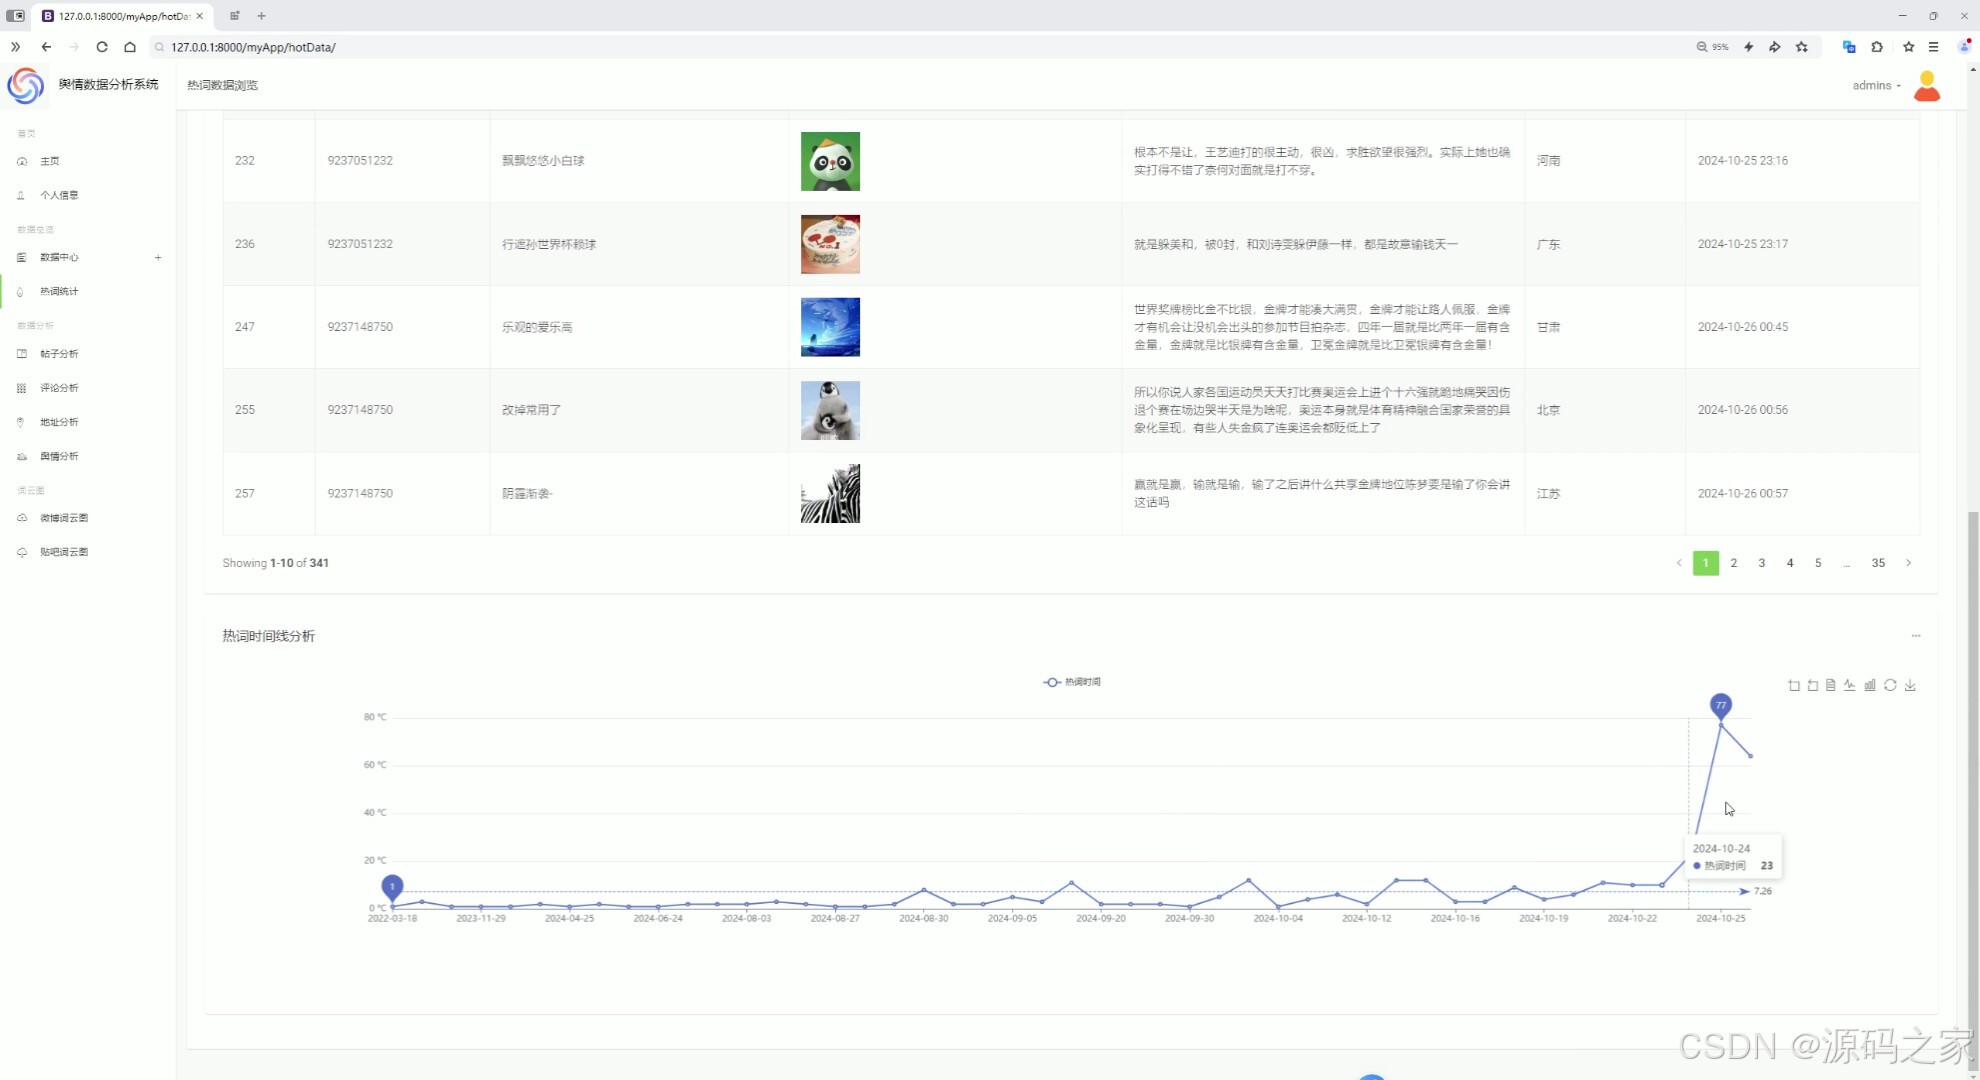
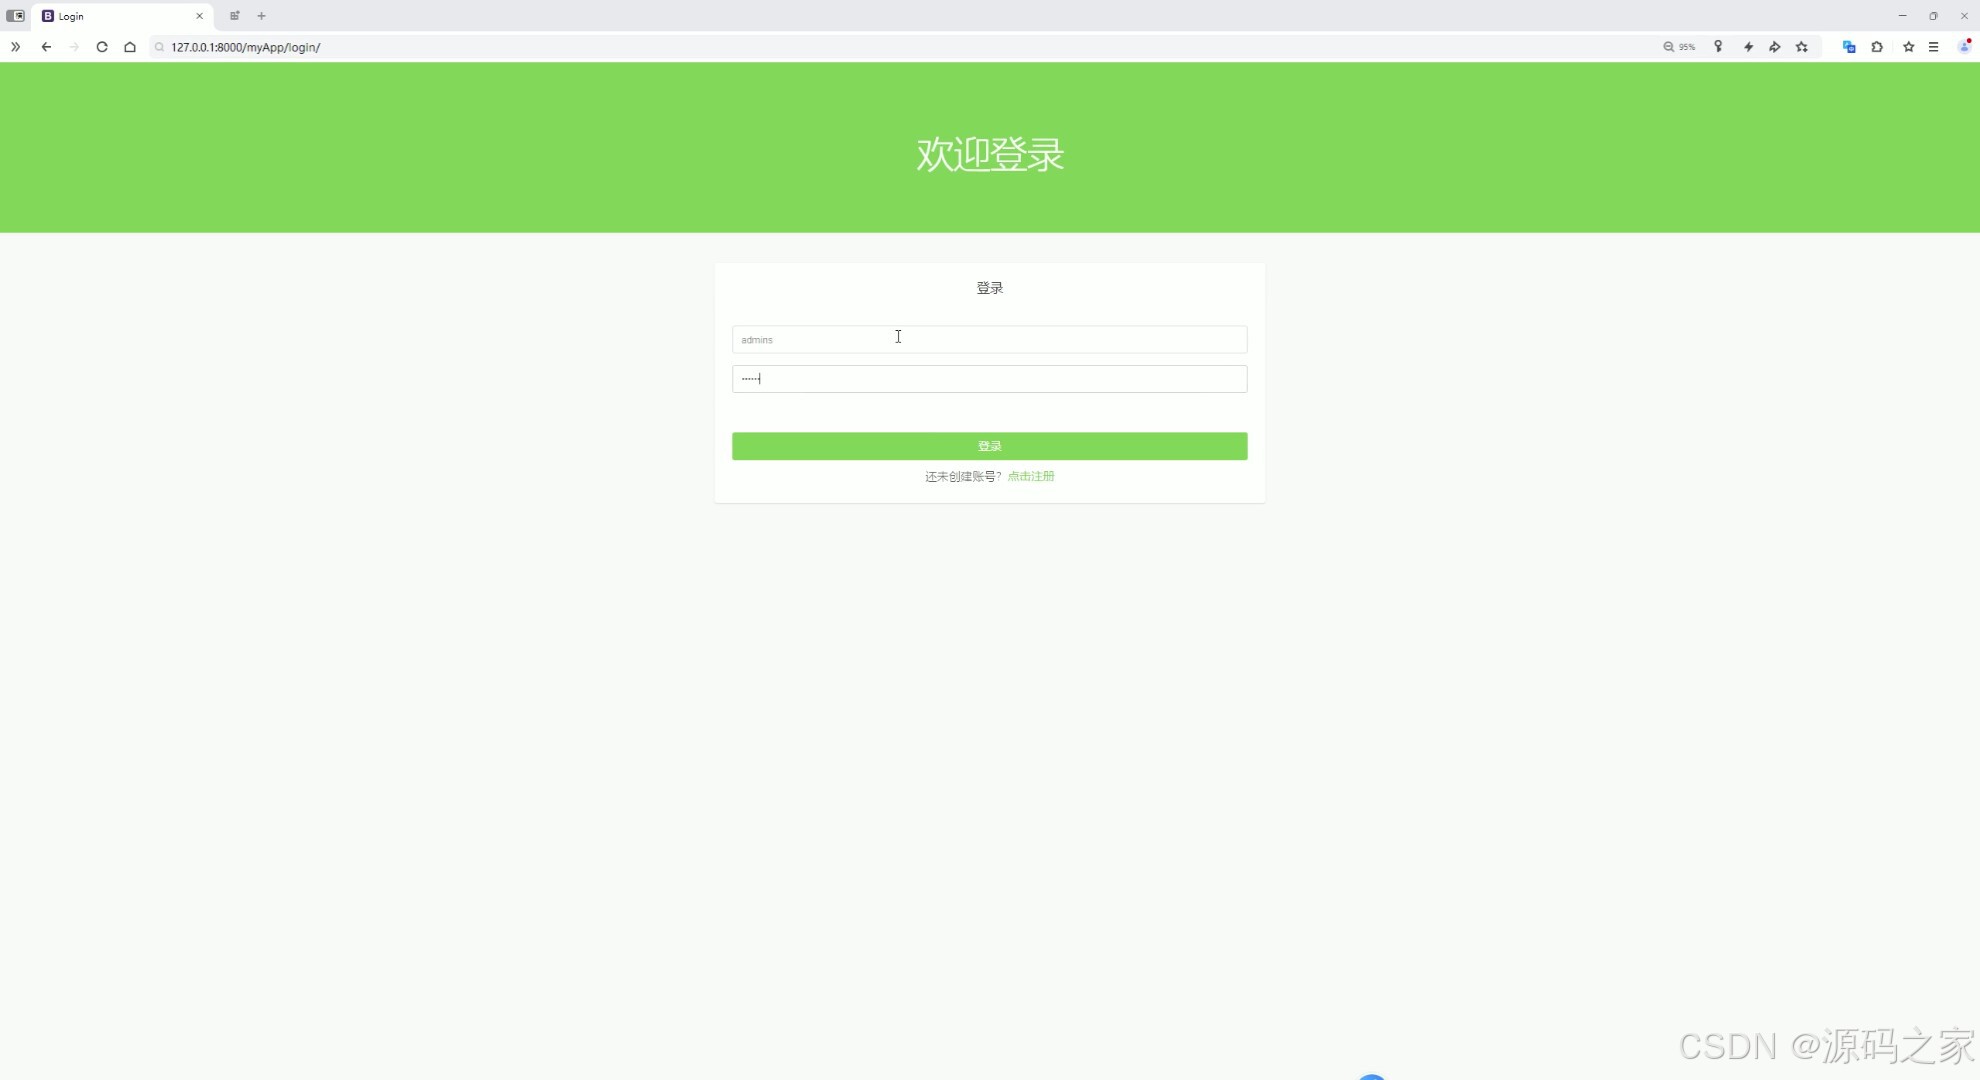
(10)注册登录
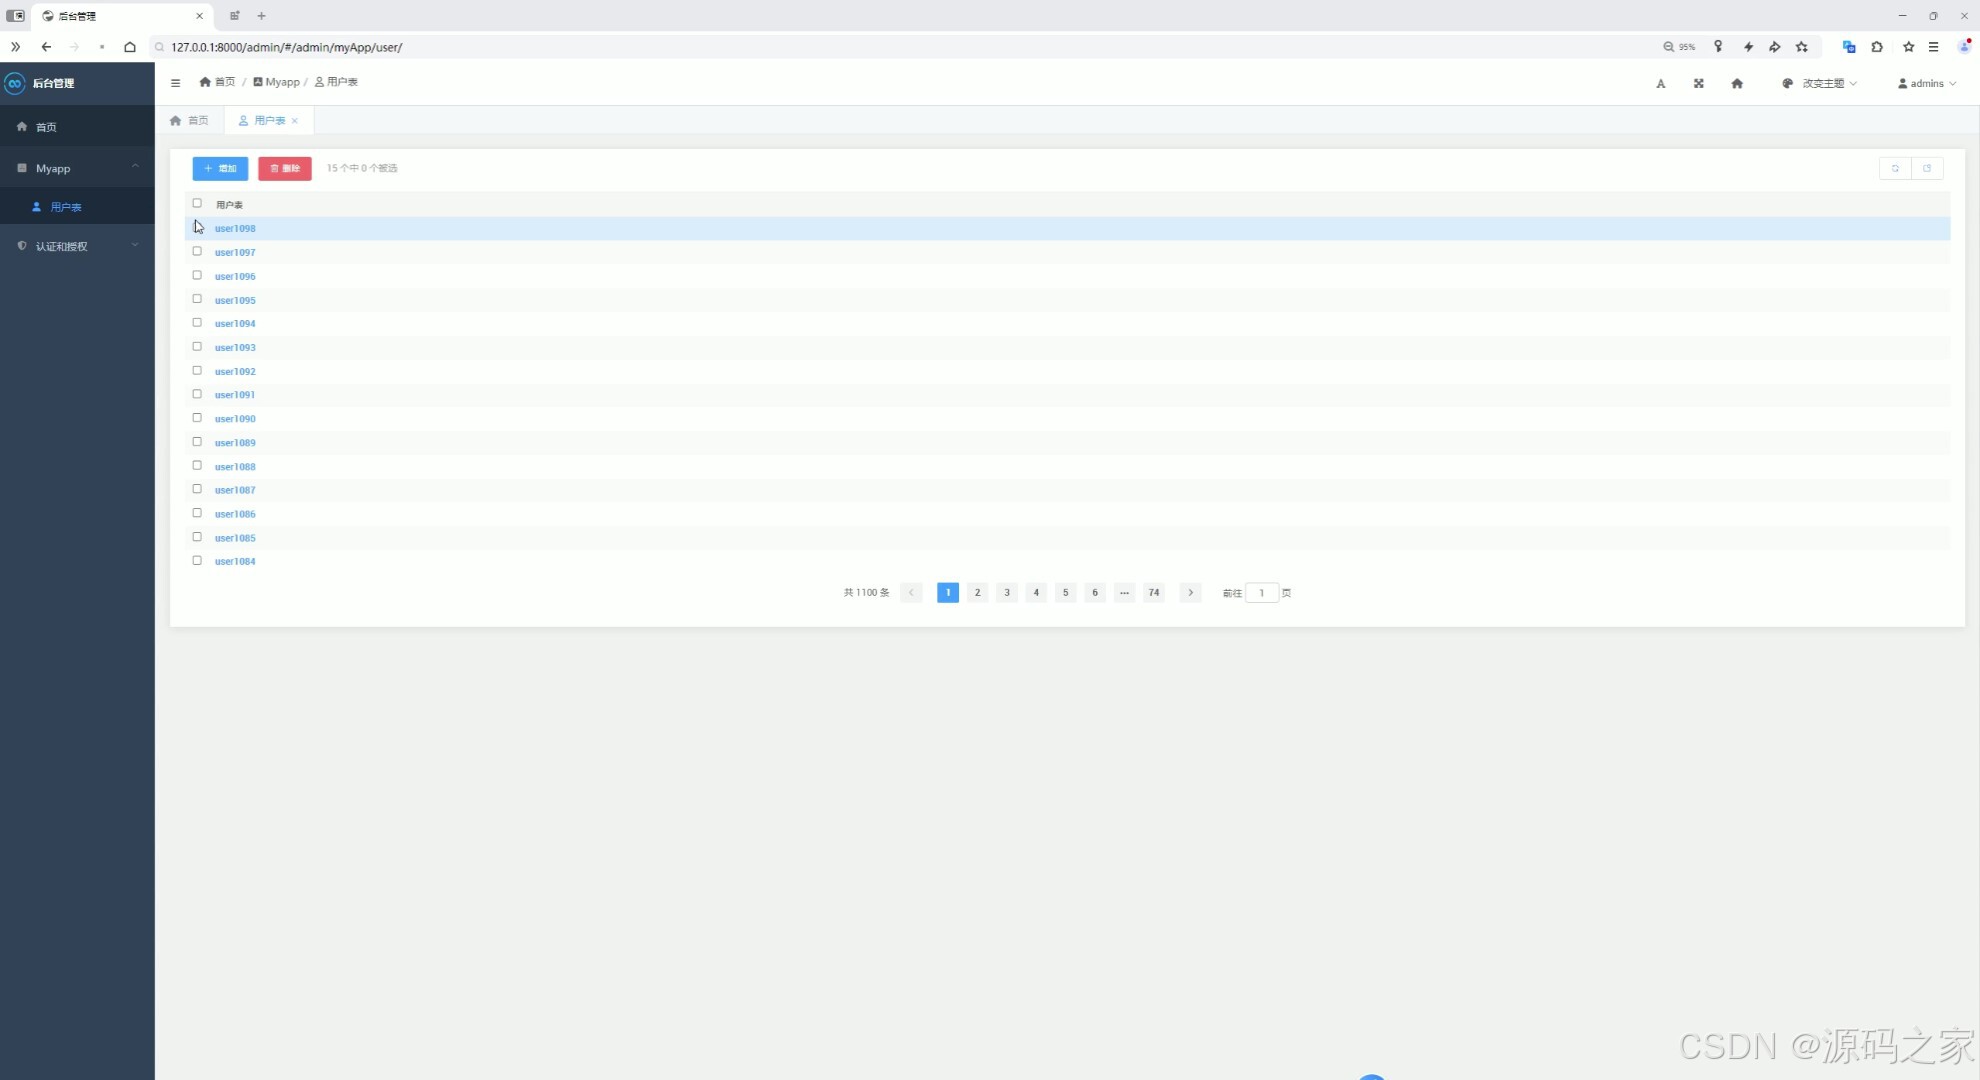
(11)后台管理
3、项目说明
一、数据采集模块
-
微博爬虫
- spiderWeiboNav.py:获取微博分类并本地落盘。
- spiderWeibo.py:按分类抓取文章详情。
- spiderWeiboDetail.py:采集评论数据。
- changeData.py:数据清洗(去换行、去HTML标签)。
-
贴吧爬虫
- spiderTieba.py:按关键词抓取贴吧主题。
- spiderTiebaDetail.py:获取帖子回复。
- hotWordDeal.py:Jieba分词+词频统计,生成热词。
二、数据分析与可视化模块
- 数据概况:展示微博+贴吧总量、更新时间及来源占比。
- 用户地址分布:Echarts中国地图展示两地用户IP分布。
- 帖子/评论分析:SnowNLP情感打分,生成正负面饼图与趋势折线。
- 词云与热词:实时词云图,Top20高频词列表支持一键导出CSV。
三、大数据离线计算(Hadoop+Spark+Hive)
原始日志通过Flume导入HDFS,Spark SQL完成日级情感聚合,Hive仓库存储结果表,Django通过PyHive接口调用,实现秒级可视化查询,支持10亿级数据离线分析。
四、用户交互与权限管理
- 注册登录:JWT令牌,同一手机号不可重复注册。
- 后台管理:Django Admin二次开发,支持用户、角色、菜单按钮级权限;可手动重跑情感分析、热词统计。
4、核心代码
#coding:utf8


# 导包
from pyspark.sql import SparkSession
from pyspark.sql.functions import monotonically_increasing_id
from pyspark.sql.types import StringType, StructField, StructType, IntegerType, FloatType
from pyspark.sql.functions import count, mean, col, sum, when, max, min, avg, to_timestamp, current_timestamp, unix_timestamp, to_date, expr, coalesce, lit


if __name__ == '__main__':
    # 构建 SparkSession
    spark = SparkSession.builder.appName("sparkSQL").master("local[*]").\
        config("spark.sql.shuffle.partitions", 2). \
        config("spark.sql.warehouse.dir", "hdfs://node1:8020/user/hive/warehouse"). \
        config("hive.metastore.uris", "thrift://node1:9083"). \
        enableHiveSupport().\
        getOrCreate()

    # 读取数据表
    tiebadata = spark.read.table('tiebadata')
    weibodata = spark.read.table('weibodata')

    tiebaComment = spark.read.table('tiebaComment')
    weiboComment = spark.read.table('weiboComment')

    tiebaHotword = spark.read.table('tiebaHotword')
    weiboHotword = spark.read.table('weiboHotword')


    # 需求一:时间统计
    # 将时间列转换为日期格式
    tiebadata = tiebadata.withColumn('postTime', to_date(col("postTime"), "yyyy-MM-dd HH:mm:ss"))
    weibodata = weibodata.withColumn('createdAt', to_date(col("createdAt"), "yyyy-MM-dd"))

    # 按日期分组统计帖子数量,并计算与当前日期的天数差
    result1 = tiebadata.groupby("postTime").agg(count('*').alias("count"))
    result2 = weibodata.groupby("createdAt").agg(count('*').alias("count"))

    result1 = result1.withColumn("days_diff", expr("datediff(current_date(), postTime)"))
    result2 = result2.withColumn("days_diff", expr("datediff(current_date(), createdAt)"))

    result1 = result1.orderBy("days_diff")
    result2 = result2.orderBy("days_diff")

    # 重命名列并合并两个结果
    result1 = result1.withColumnRenamed("count", "post_count")
    result2 = result2.withColumnRenamed("count", "created_count")

    combined_result = result1.join(result2, result1.postTime == result2.createdAt, "outer")\
        .select(
        coalesce(result1.postTime, result2.createdAt).alias("date"),
        coalesce(result1.post_count, lit(0)).alias("post_count"),
        coalesce(result2.created_count, lit(0)).alias("created_count"),
    )

    combined_result = combined_result.orderBy(col("date").desc())

    # 将结果保存到 MySQL 和 Hive
    combined_result.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "dateNum"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    combined_result.write.mode("overwrite").saveAsTable("dateNum", "parquet")
    spark.sql("select * from dateNum").show()


    # 需求二:类型统计
    # 统计微博和贴吧帖子的类型分布
    result3 = weibodata.groupby("type").count()
    result4 = tiebadata.groupby("area").count()

    # 将结果保存到 MySQL 和 Hive
    result3.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "weiboTypeCount"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result3.write.mode("overwrite").saveAsTable("weiboTypeCount", "parquet")
    spark.sql("select * from weiboTypeCount").show()

    result4.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "tiebaTypeCount"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result4.write.mode("overwrite").saveAsTable("tiebaTypeCount", "parquet")
    spark.sql("select * from tiebaTypeCount").show()


    # 需求三:帖子排序点赞
    # 按点赞数降序排列,取前 10 条记录
    result5 = weibodata.orderBy(col("likeNum").desc()).limit(10)
    result6 = tiebadata.orderBy(col("likeNum").desc()).limit(10)

    # 将结果保存到 MySQL 和 Hive
    result5.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "weiboLikeNum"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result5.write.mode("overwrite").saveAsTable("weiboLikeNum", "parquet")
    spark.sql("select * from weiboLikeNum").show()

    result6.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "tiebaLikeNum"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result6.write.mode("overwrite").saveAsTable("tiebaLikeNum", "parquet")
    spark.sql("select * from tiebaLikeNum").show()


    # 需求四:点赞区间分类
    # 将微博和贴吧帖子的点赞数分为不同区间
    weibodata_like_category = weibodata.withColumn(
        "likeCategory",
        when(col("likeNum").between(0, 1000), '0-1000')
        .when(col("likeNum").between(1000, 2000), '1000-2000')
        .when(col("likeNum").between(2000, 5000), '2000-5000')
        .when(col("likeNum").between(5000, 10000), '5000-10000')
        .when(col("likeNum").between(10000, 20000), '10000-20000')
        .otherwise('20000以上')
    )

    result7 = weibodata_like_category.groupby("likeCategory").count()

    tiebadata_like_category = tiebadata.withColumn(
        "likeCategory",
        when(col("likeNum").between(0, 50), '0-50')
        .when(col("likeNum").between(50, 100), '50-100')
        .when(col("likeNum").between(100, 200), '100-200')
        .when(col("likeNum").between(200, 500), '200-500')
        .when(col("likeNum").between(500, 1000), '500-1000')
        .otherwise('2000以上')
    )

    result8 = tiebadata_like_category.groupby("likeCategory").count()

    # 将结果保存到 MySQL 和 Hive
    result7.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "wLikeCategory"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result7.write.mode("overwrite").saveAsTable("wLikeCategory", "parquet")
    spark.sql("select * from wLikeCategory").show()


    # sql
    result8.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "tLikeCategory"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result8.write.mode("overwrite").saveAsTable("tLikeCategory", "parquet")
    spark.sql("select * from tLikeCategory").show()

    # 需求五:评论量分析
    # 将微博和贴吧的评论量分为不同区间
    weibodata_com_category = weibodata.withColumn(
        "comCategory",
        when(col("commentsLen").between(0, 10), '0-10')
        .when(col("commentsLen").between(10, 50), '10-50')
        .when(col("commentsLen").between(50, 100), '50-100')
        .when(col("commentsLen").between(100, 500), '100-500')
        .when(col("commentsLen").between(500, 1000), '500-1000')
        .otherwise('1000以上')
    )

    tiebadata_com_category = tiebadata.withColumn(
        "comCategory",
        when(col("replyNum").between(0, 10), '0-10')
        .when(col("replyNum").between(10, 50), '10-50')
        .when(col("replyNum").between(50, 100), '50-100')
        .when(col("replyNum").between(100, 500), '100-500')
        .when(col("replyNum").between(500, 1000), '500-1000')
        .otherwise('1000以上')
    )

    result9 = weibodata_com_category.groupby("comCategory").count()
    result10 = tiebadata_com_category.groupby("comCategory").count()

    # 合并微博和贴吧的评论量统计结果
    combined_result2 = result9.join(result10, result9.comCategory == result10.comCategory, "outer") \
        .select(
        coalesce(result9.comCategory, result10.comCategory).alias("category"),
        coalesce(result9['count'], lit(0)).alias("weibo_count"),
        coalesce(result10['count'], lit(0)).alias("tieba_count"),
    )

    # 将结果保存到 MySQL 和 Hive
    combined_result2.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "ComCategory"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    combined_result2.write.mode("overwrite").saveAsTable("ComCategory", "parquet")
    spark.sql("select * from ComCategory").show()

    # 需求六:评论分析
    # 对微博评论的点赞数进行区间分类
    weibodata_comLike_category = weiboComment.withColumn(
        "comLikeCategory",
        when(col("likesCounts").between(0, 10), '0-10')
        .when(col("likesCounts").between(10, 50), '10-50')
        .when(col("likesCounts").between(50, 100), '50-100')
        .when(col("likesCounts").between(100, 500), '100-500')
        .when(col("likesCounts").between(500, 1000), '500-1000')
        .otherwise('1000以上')
    )

    result11 = weibodata_comLike_category.groupby("comLikeCategory").count()

    # 将结果保存到 MySQL 和 Hive
    result11.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "comLikeCat"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result11.write.mode("overwrite").saveAsTable("comLikeCat", "parquet")
    spark.sql("select * from comLikeCat").show()

    # 需求七:评论性别分析
    # 统计微博评论的性别分布
    result12 = weiboComment.groupby("authorGender").count()

    # 将结果保存到 MySQL 和 Hive
    result12.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "comGender"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result12.write.mode("overwrite").saveAsTable("comGender", "parquet")
    spark.sql("select * from comGender").show()

    # 需求八:评论地址分析
    # 统计微博和贴吧评论的来源地址分布
    result13 = weiboComment.groupby("authorAddress").count()
    result14 = tiebaComment.groupby("comAddress").count()

    # 将结果保存到 MySQL 和 Hive
    result13.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "weiboAddress"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result13.write.mode("overwrite").saveAsTable("weiboAddress", "parquet")
    spark.sql("select * from weiboAddress").show()

    result14.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "tiebaAddress"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result14.write.mode("overwrite").saveAsTable("tiebaAddress", "parquet")
    spark.sql("select * from tiebaAddress").show()

    # 需求九:帖子情感得分分析
    # 对微博和贴吧帖子的情感得分进行分类
    weibodata_scores_category = weibodata.withColumn(
        "emoCategory",
        when(col("scores").between(0, 0.45), '消极')
        .when(col("scores").between(0.45, 0.55), '中性')
        .when(col("scores").between(0.55, 1), '积极')
        .otherwise('未知')
    )

    tiebadata_scores_category = tiebadata.withColumn(
        "emoCategory",
        when(col("scores").between(0, 0.45), '消极')
        .when(col("scores").between(0.45, 0.55), '中性')
        .when(col("scores").between(0.55, 1), '积极')
        .otherwise('未知')
    )

    result15 = weibodata_scores_category.groupby("emoCategory").count()
    result16 = tiebadata_scores_category.groupby("emoCategory").count()

    # 将结果保存到 MySQL 和 Hive
    result15.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "weiboEmoCount"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result15.write.mode("overwrite").saveAsTable("weiboEmoCount", "parquet")
    spark.sql("select * from weiboEmoCount").show()

    # sql
    result16.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "tiebaEmoCount"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result16.write.mode("overwrite").saveAsTable("tiebaEmoCount", "parquet")
    spark.sql("select * from tiebaEmoCount").show()


    # 需求十:热词情感分析
    # 对微博和贴吧的热词情感得分进行分类
    weibodata_Hotscores_category = weiboHotword.withColumn(
        "emoCategory",
        when(col("scores").between(0, 0.45), '消极')
        .when(col("scores").between(0.45, 0.55), '中性')
        .when(col("scores").between(0.55, 1), '积极')
        .otherwise('未知')
    )

    tiebadata_Hotscores_category = tiebaHotword.withColumn(
        "emoCategory",
        when(col("scores").between(0, 0.45), '消极')
        .when(col("scores").between(0.45, 0.55), '中性')
        .when(col("scores").between(0.55, 1), '积极')
        .otherwise('未知')
    )

    result17 = weibodata_Hotscores_category.groupby("emoCategory").count()
    result18 = tiebadata_Hotscores_category.groupby("emoCategory").count()

    # 将结果保存到 MySQL 和 Hive
    result17.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "weiboHotEmoCount"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result17.write.mode("overwrite").saveAsTable("weiboHotEmoCount", "parquet")
    spark.sql("select * from weiboHotEmoCount").show()

    result18.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "tiebaHotEmoCount"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result18.write.mode("overwrite").saveAsTable("tiebaHotEmoCount", "parquet")
    spark.sql("select * from tiebaHotEmoCount").show()


    # 需求十一:热词得分区间分析
    # 对微博和贴吧的热词情感得分进行区间分类
    weiboHotWord_range_category = weiboHotword.withColumn(
        "scoreCategory",
        when(col("scores").between(0, 0.1), '0-0.1')
        .when(col("scores").between(0.1, 0.2), '0.1-0.2')
        .when(col("scores").between(0.2, 0.3), '0.2-0.3')
        .when(col("scores").between(0.3, 0.4), '0.3-0.4')
        .when(col("scores").between(0.4, 0.5), '0.4-0.5')
        .when(col("scores").between(0.5, 0.6), '0.5-0.6')
        .when(col("scores").between(0.7, 0.8), '0.7-0.8')
        .when(col("scores").between(0.8, 0.9), '0.8-0.9')
        .when(col("scores").between(0.9, 1), '0.9-1')
        .otherwise('overRange')
    )

    tiebaHotWord_range_category = tiebaHotword.withColumn(
        "scoreCategory",
        when(col("scores").between(0, 0.1), '0-0.1')
        .when(col("scores").between(0.1, 0.2), '0.1-0.2')
        .when(col("scores").between(0.2, 0.3), '0.2-0.3')
        .when(col("scores").between(0.3, 0.4), '0.3-0.4')
        .when(col("scores").between(0.4, 0.5), '0.4-0.5')
        .when(col("scores").between(0.5, 0.6), '0.5-0.6')
        .when(col("scores").between(0.7, 0.8), '0.7-0.8')
        .when(col("scores").between(0.8, 0.9), '0.8-0.9')
        .when(col("scores").between(0.9, 1), '0.9-1')
        .otherwise('overRange')
    )

    result19 = weiboHotWord_range_category.groupby("scoreCategory").count()
    result20 = tiebaHotWord_range_category.groupby("scoreCategory").count()

    # 将结果保存到 MySQL 和 Hive
    result19.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "tiebaScoreCount"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result19.write.mode("overwrite").saveAsTable("tiebaScoreCount", "parquet")
    spark.sql("select * from tiebaScoreCount").show()

    result20.write.mode("overwrite"). \
        format("jdbc"). \
        option("url", "jdbc:mysql://node1:3306/bigdata?useSSL=false&useUnicode=true&charset=utf8"). \
        option("dbtable", "weiboScoreCount"). \
        option("user", "root"). \
        option("password", "root"). \
        option("encoding", "utf-8"). \
        save()

    result20.write.mode("overwrite").saveAsTable("weiboScoreCount", "parquet")
    spark.sql("select * from weiboScoreCount").show()
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目编程以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
5、源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查看👇🏻获取联系方式👇🏻

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 50
 0
- 0


 已为社区贡献80条内容

所有评论(0)