机器学习所学算法内容捋一遍(一)
·
一元线性
- 核心思想:找到一条直线(公式:
y = wx + b),让这条直线尽可能贴近所有样本点,用 “样本实际值与直线预测值的误差” 最小化来确定直线参数(w 和 b)。 - 适用场景:预测连续值,且特征(x)只有 1 个,比如用 “房屋面积” 预测 “房价”。
- 核心场景:单因素影响的连续值预测,场景相对简单。
- 用 “每日广告投放金额” 预测 “当日产品销售额”(假设其他因素影响小)。
- 用 “学生每日学习时长” 预测 “期末考试分数”。
- 核心特点:仅用 1 个特征建模,模型是简单的直线关系,可解释性极强。
- 优点:
- 模型简单直观,参数(w 和 b)可直接解读 “特征对结果的影响程度”。
- 计算速度快,无需复杂训练过程。
- 缺点:
- 仅适用于 “单特征 + 线性关系” 场景,无法处理多特征或非线性数据。
- 对异常值敏感,少量异常点会严重偏离拟合直线。
- 模型表达式:y=wx+b(y:预测值;x:输入特征;w:特征权重;b:偏置项)
- 核心参数:
- w(权重):作用:表示 “x每变化 1 个单位,y的变化量”(如w=5,x增 1 则y增 5)。影响:w绝对值越大,特征对结果的影响越强;w正 / 负表示特征与结果正 / 负相关。
- b(偏置):作用:x=0时的y值,调整模型在y轴上的截距,避免模型仅依赖特征x。影响:b过大 / 过小会导致模型整体偏移,比如预测房价时,b偏大会让所有房价预测值偏高。
多元线性
- 核心思想:在一元线性回归基础上扩展,用超平面(公式:
y = w₁x₁ + w₂x₂ + ... + wₙxₙ + b)拟合数据,最小化误差来确定多个特征的权重(w₁到 wₙ)。 - 适用场景:预测连续值,且特征有多个,比如用 “面积、楼层、房龄” 共同预测 “房价”。
- 核心场景:多因素共同影响的连续值预测,是业务中最常用的回归模型之一。
- 用 “房屋面积、房龄、楼层、距离地铁的距离” 预测 “房屋成交价格”。
- 用 “公司营收、成本、员工数量、成立年限” 预测 “年度利润”。
- 用 “用户年龄、每月消费次数、会员等级” 预测 “用户月消费金额”。
- 核心特点:支持多特征建模,模型是超平面,保留线性回归的可解释性,是业务中基础的回归工具。
- 优点:
- 可量化每个特征对结果的贡献(通过权重 w),便于业务分析(如 “房龄每增加 1 年,房价下降 5 万元”)。
- 计算成本低,适合快速构建 baseline 模型。
- 缺点:
- 假设特征与结果是线性关系,无法捕捉非线性关联(如 “收入增长到一定程度后,消费增速放缓”)。
- 特征间若存在多重共线性(如 “身高” 和 “体重” 高度相关),会导致参数估计不稳定。
- 模型表达式:y=w1x1+w2x2+...+wnxn+b(x1...xn:多个输入特征;w1...wn:对应特征的权重;b:偏置项)
- 核心参数:
- w1...wn(特征权重):作用:每个wi对应 “xi每变化 1 个单位,y的变化量”,量化单个特征的贡献。影响:某特征wi绝对值越大,该特征对y的影响越强;若wi接近 0,说明该特征对预测几乎无作用。
- b(偏置):作用:抵消特征均不为 0 时的基础偏差,保证模型在特征组合为 0 时仍有合理输出。影响:b异常会导致所有预测值整体偏移,比如用 “面积、房龄” 预测房价时,b偏小会让低价房预测更偏低。
逻辑回归
- 核心思想:先通过线性公式(
z = wx + b)计算 “线性得分”,再用Sigmoid 函数把得分映射到 0-1 之间,得到 “样本属于某一类的概率”,概率大于 0.5 归为正类,否则归为负类。 - 适用场景:二分类问题,比如判断 “邮件是否为垃圾邮件”“用户是否会点击广告”。
- 核心场景:二分类问题(结果只有两种),因模型简单、可解释性强,广泛用于风险评估和行为预测。
- 金融领域:判断 “用户申请贷款时是否会违约”(违约 / 不违约)。
- 营销领域:预测 “用户看到广告后是否会点击”(点击 / 不点击)、“用户是否会购买商品”(购买 / 不购买)。
- 医疗领域:根据 “症状指标” 判断 “患者是否患有某疾病”(患病 / 未患病)。
- 内容审核:判断 “某条评论是否为垃圾评论”(垃圾 / 正常)。
- 核心特点:本质是 “线性模型 + Sigmoid 函数”,输出概率值,专注二分类,可解释性强。
- 优点:
- 输出是 “属于正类的概率”,可直接用于风险评估(如 “用户违约概率 30%”)。
- 模型轻量,训练和预测速度快,适合大规模数据(如千万级用户的点击预测)。
- 缺点:
- 仅擅长二分类,处理多分类需额外扩展(如 One-vs-Rest)。
- 对非线性数据拟合能力弱,需手动对特征做非线性变换(如平方、对数)。

朴素贝叶斯
- 核心思想:基于贝叶斯定理,假设 “每个特征之间相互独立”(这是 “朴素” 的由来),通过计算 “样本属于每个类别的概率”,选择概率最大的类别作为预测结果。
- 适用场景:文本分类(如新闻分类、情感分析)、垃圾邮件识别,适合高维度数据且计算快。
- 核心场景:高维度数据的分类,尤其适合文本处理,计算速度快。
- 文本分类:给 “新闻” 打标签(体育 / 财经 / 娱乐)、判断 “邮件是否为垃圾邮件”。
- 情感分析:分析 “用户对产品的评价” 是正面 / 负面(如电商评论、社交媒体留言)。
- 推荐系统:根据 “用户浏览过的内容标签”,预测用户是否喜欢新内容(喜欢 / 不喜欢)。
- 核心特点:基于贝叶斯定理,假设 “特征独立”,是高维度数据的快速分类工具。
- 优点:
- 计算速度极快,无需迭代训练,直接通过概率公式计算结果。
- 对高维度数据(如文本的词向量)友好,内存占用低。
- 缺点:
- “特征独立” 假设在现实中多不成立(如文本中 “国王” 和 “皇后” 高度相关),会影响预测精度。
- 对稀有特征敏感,若某特征在训练集中未出现,会导致概率计算为 0,需额外处理(如拉普拉斯平滑)。

KNN
- 核心思想:“近朱者赤,近墨者黑”—— 预测新样本时,找它周围最近的 K 个样本(邻居),这 K 个邻居中多数属于哪个类别,新样本就归为哪个类别。
- 适用场景:简单分类 / 回归问题,无需训练模型(“惰性学习”),但数据量大时速度慢。
- 核心场景:小样本、简单分类 / 回归任务,无需训练模型,适合快速验证思路。
- 图像识别:简单的手写数字识别(如识别 0-9),找与待识别数字最像的 K 个样本。
- 推荐系统:“协同过滤” 的基础,找 “兴趣相似的 K 个用户”,推荐这些用户喜欢的内容。
- 医疗诊断:根据 “患者的症状指标”,对比 K 个相似病例的诊断结果,辅助判断病情。
- 核心特点:“惰性学习”(无训练过程),靠 “邻居投票” 决策,模型逻辑简单。
- 优点:
- 无需训练,拿到数据即可预测,适合快速验证业务思路。
- 可处理非线性数据,只要邻居划分合理,能拟合复杂决策边界。
- 缺点:
- 预测速度慢,每次预测需计算与所有样本的距离(数据量达百万级时难以使用)。
- 对高维度数据敏感(维度灾难),距离计算会失效;对异常值和数据尺度敏感(需先标准化)。

决策树(ID3,C4.5,CART)
- 核心思想:把数据按 “特征” 拆分成多个子集,每次拆分都追求 “子集内样本类别尽可能一致”(即 “纯度最高”),最终形成一棵 “树”,预测时从根节点走到叶节点就能得到类别 / 结果。
- ID3:用 “信息增益” 选拆分特征,优先拆分纯度提升最大的特征。
- C4.5:改进 ID3,用 “信息增益比” 避免偏爱多取值特征,还能处理缺失值。
- CART:可做分类 / 回归,用 “基尼系数”(分类)或 “平方误差”(回归)选特征,生成二叉树。
- 适用场景:分类 / 回归都能用,结果易解释(能看到 “决策逻辑”)。
- 核心场景:分类 / 回归均可,因结果可解释(能看到 “决策逻辑”),适合需要 “说明原因” 的业务。
- 风控领域:用 “用户收入、负债、信用记录” 判断是否通过贷款申请,能输出 “因负债过高,拒绝申请” 这类明确结论。
- 客户流失预测:分析 “用户使用频率、套餐类型、投诉次数”,预测用户是否会流失,并找到流失关键因素(如 “投诉 3 次以上的用户易流失”)。
- 医疗诊断:根据 “症状、检查指标” 判断疾病类型,方便医生理解模型判断依据。
- 回归场景:用 “农作物品种、施肥量、降雨量” 预测 “亩产量”。
- 核心特点:树形结构,决策逻辑可视化,可同时处理分类和回归。
- 优点:
- 可解释性极强,能输出 “if-else” 式决策规则(如 “若投诉次数 > 3 且使用时长 < 6 个月,则用户流失风险高”)。
- 无需对特征标准化,自动处理非线性关系,对缺失值有一定容忍度。
- 缺点:
- 易过拟合(尤其是深度深的树),会记住训练集噪声,泛化能力差。
- 对数据微小变化敏感,换少量样本可能导致树结构大幅改变。

SVM
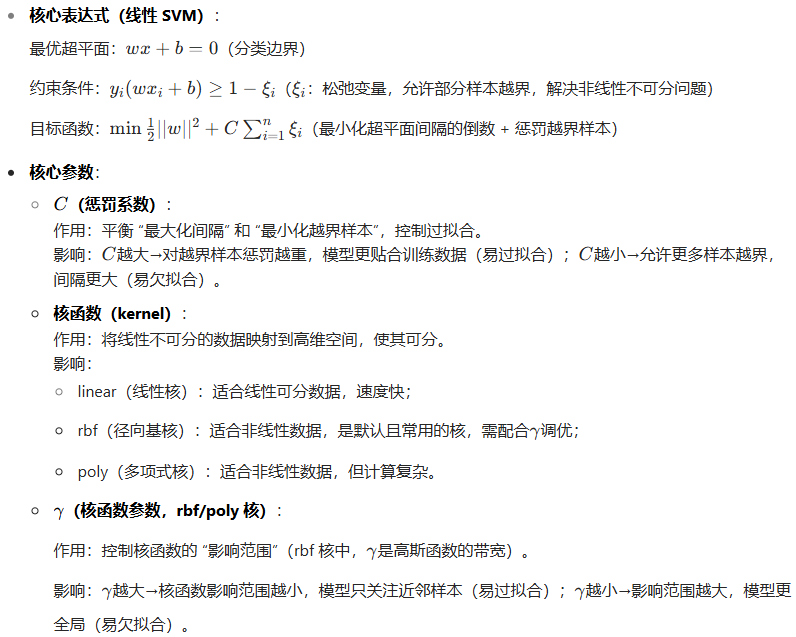
- 核心思想:在特征空间中找一个超平面,让 “超平面到两类样本的最小距离(间隔)最大”,这个超平面就是最优分类边界,而离超平面最近的样本(支持向量)决定了超平面的位置。
- 适用场景:小样本、高维度分类问题(如文本分类),可通过 “核函数” 处理非线性数据(把数据映射到高维空间后再找线性边界)。
- 核心场景:小样本、高维度数据的分类,尤其适合文本和图像领域。
- 文本分类:如法律文档分类(合同 / 判决书 / 法规)、学术论文分类(计算机 / 数学 / 生物)。
- 图像识别:手写数字识别、人脸识别(早期常用,现在多被深度学习替代,但小样本场景仍适用)。
- 生物信息学:分析基因数据,判断 “基因序列是否属于某类疾病相关基因”。
- 核心特点:以 “最大间隔” 为目标,靠 “支持向量” 决定决策边界,对小样本友好。
- 优点:
- 小样本场景下精度高,能有效避免过拟合(最大间隔原则天然有正则化效果)。
- 通过核函数可处理非线性数据(如 RBF 核适合环形分布数据),且无需手动设计非线性特征。
- 缺点:
- 数据量过大(百万级以上)时,训练速度慢、内存占用高。
- 核函数选择和参数调优复杂(如 RBF 核的 γ 值),对新手不友好;无法直接输出概率(需额外校准)。
bagging(RF随机森林为例)
- 核心思想:“集体智慧”—— 通过 “有放回抽样” 生成多个不同的训练集,对每个训练集训练一棵决策树,最终预测时 “投票”(分类)或 “取平均”(回归),用多个树的结果降低单棵树的过拟合风险。
- 随机森林:在 Bagging 基础上增加 “特征随机选择”,每棵树只选部分特征拆分,进一步提升多样性和泛化能力。
- 核心场景:解决决策树过拟合问题,分类 / 回归效果更稳定,是业务中最常用的集成模型之一。
- 电商领域:用 “商品价格、销量、好评率、类目” 预测 “商品是否会成为爆款”(分类)。
- 金融领域:用 “用户交易记录、征信数据” 预测 “信用卡诈骗风险”(分类),比单棵决策树更准确。
- 回归场景:用 “城市 GDP、人口数量、就业率” 预测 “城市房价涨幅”,结果比线性回归更贴合复杂数据。
- 核心特点:“多树并行”(独立训练多棵决策树),靠 “投票 / 平均” 降低方差,抗过拟合能力强。
- 优点:
- 比单棵决策树精度高,且不易过拟合(多棵树的噪声会相互抵消)。
- 可评估特征重要性(通过树的拆分次数),支持并行训练(多棵树可同时训练)。
- 缺点:
- 模型复杂度高(多棵树叠加),可解释性比单棵决策树差(无法输出明确决策规则)。
- 训练和预测速度比单棵树慢,内存占用更高(需存储多棵树)。

boosting(AdaBoost,GBDT,XGboost)
- 核心思想:“循序渐进”—— 先训练一个简单模型(弱学习器),重点关注 “前一个模型预测错的样本”(提高这些样本的权重),再训练下一个模型修正错误,最后把所有弱模型的结果加权结合,形成强模型。
- AdaBoost:用 “样本权重” 调整错误,每个弱模型权重由其准确率决定。
- GBDT:用 “前一个模型的残差(实际值 - 预测值)” 作为新目标,逐步减少残差。
- XGBoost:在 GBDT 基础上优化,加入正则化(防止过拟合)和并行计算,速度更快、效果更好。
- 核心场景:追求高精度的分类 / 回归任务,XGBoost、LightGBM(GBDT 改进版)是竞赛和业务中的 “顶流” 模型。
- 风控领域:XGBoost 常用于 “信贷审批评分”,精准度高于随机森林,能捕捉数据中的复杂关联。
- 推荐系统:用 “用户点击、收藏、停留时长” 预测 “用户对商品的偏好分数”(回归),提升推荐准确率。
- 时间序列预测:用 “过去 12 个月的销量、促销活动、节假日” 预测 “未来 1 个月的销量”(GBDT 适合非平稳时间序列)。
- 竞赛场景:Kaggle 等数据科学竞赛中,XGBoost、LightGBM 常作为基础模型,助力团队拿高分。
- 核心特点:“多树串行”(后一棵树修正前一棵树的错误),靠 “加权结合” 提升精度,是高精度模型的代表。
- 优点:
- 精度极高,能捕捉数据中的复杂关联,是竞赛和业务中的 “顶流” 模型(如 XGBoost 常用于风控评分)。
- XGBoost/GBDT 支持正则化(防止过拟合)、处理缺失值,且可输出特征重要性。
- 缺点:
- 训练速度慢(串行依赖,后一棵树需等前一棵树训练完),对参数调优敏感(如学习率、树深度)。
- 易受异常值影响(后一棵树会过度关注前树的错误样本,可能放大异常值的干扰)。

K-means
- 核心思想:先随机选 K 个 “中心点”,把每个样本分到 “离自己最近的中心点” 所在的簇,再计算每个簇的新中心点(簇内样本的均值),重复这两步直到中心点不再变化,最终得到 K 个簇。
- 适用场景:需要把数据分成 K 类的场景,比如用户分群、商品分类,需提前确定 K 值。
- 核心场景:需要明确分 “K 组” 的业务,适合数据呈 “球形簇” 分布的情况。
- 用户分群:电商平台根据 “用户消费金额、购买频率、浏览时长”,把用户分成 “高价值用户、普通用户、低频用户”(K=3),针对性做运营。
- 商品分类:超市根据 “商品销量、利润、库存周转天数”,把商品分成 “核心商品、潜力商品、滞销商品”,优化货架摆放。
- 图像压缩:将图像像素的颜色值聚类,用少数几个聚类中心代表所有颜色,实现图像压缩(如把 256 色图压缩到 16 色)。
- 核心特点:以 “簇内误差最小” 为目标,迭代更新中心点,是最常用的聚类算法。
- 优点:
- 算法简单易懂,训练速度快,适合大规模数据(如百万级用户分群)。
- 聚类结果清晰,每个样本归属明确,便于后续业务应用(如给不同簇的用户推不同活动)。
- 缺点:
- 需提前手动确定 K 值(簇数),且对初始中心点敏感(不同初始点可能得到不同结果)。
- 仅适用于 “球形簇” 数据,无法处理非球形簇(如环形、条形分布)。

层次聚类(Hierarchical Clustering)
- 核心思想:有 “自下而上”(聚合式)和 “自上而下”(分裂式)两种:
- 聚合式:先把每个样本当一个簇,每次把 “距离最近的两个簇” 合并,直到所有样本合并成一个簇,形成一棵 “聚类树”。
- 分裂式:先把所有样本当一个簇,每次把 “内部差异最大的簇” 拆分,直到每个样本单独成簇。
- 适用场景:不需要提前确定簇数,能直观看到簇的层级关系,比如生物分类(界、门、纲、目)。
- 核心场景:不需要提前确定 “簇数”,且需要看 “层级关系” 的场景。
- 生物分类:把 “物种” 按 “基因相似度、形态特征” 聚类,形成 “界→门→纲→目→科→属→种” 的层级结构,符合生物学分类逻辑。
- 文本聚类:对 “新闻稿件” 按主题聚类,生成 “聚类树”,能看到 “体育新闻” 下分 “足球、篮球、网球”,“足球” 下再分 “国内联赛、国际赛事”,方便内容归类。
- 客户分层:银行根据 “客户存款金额、理财购买量、贷款额度” 做层次聚类,清晰看到 “顶级 VIP→VIP→普通客户→新客户” 的层级,无需提前设 K 值。
- 核心特点:生成 “聚类树”( dendrogram ),无需提前设 K 值,可直观看到簇的层级关系。
- 优点:
- 无需确定 K 值,可通过聚类树自由选择簇数(如从树的中间截断得到 5 个簇或 8 个簇)。
- 聚类结果可视化(聚类树),便于理解数据的层级结构(如生物分类的 “界→门→纲”)。
- 缺点:
- 计算复杂度高(时间复杂度 O (n³)),无法处理大规模数据(样本数超万级时速度极慢)。
- 对噪声和异常值敏感,一个异常点可能会单独形成一个簇,影响整体聚类结果。

DBCSCAN(密度聚类)
- 核心思想:基于 “密度” 划分簇 —— 把 “密度高的区域”(样本周围一定范围内有足够多其他样本)视为簇,而 “密度低的区域”(样本周围样本少)视为噪声,无需提前确定簇数。
- 适用场景:处理非球形簇、含噪声的数据,比如异常检测(识别密度低的异常样本)、地理数据聚类。
- 核心场景:处理 “非球形簇” 或 “含噪声” 的数据,适合异常检测和复杂形状聚类。
- 异常检测:信用卡交易中,正常交易呈 “高密度簇”,异常交易(如异地大额消费)是 “低密度噪声点”,用 DBSCAN 识别异常交易。
- 地理数据聚类:分析 “城市人口分布”,把 “人口密集的居民区” 聚成簇,“公园、工业区”(人口稀疏)作为噪声,辅助城市规划。
- 图像分割:分割 “医学影像”(如 CT 图),把 “肿瘤区域”(密度与正常组织不同)聚成簇,忽略影像中的 “噪声点”(如扫描干扰)。
- 核心特点:基于 “密度连通” 划分簇,自动识别噪声点,无需提前设 K 值。
- 优点:
- 可处理任意形状的簇(如环形、条形),且能自动过滤异常值(如信用卡欺诈交易)。
- 无需手动设 K 值,适合不知道数据有多少簇的探索性分析场景。
- 缺点:
- 对参数(邻域半径 ε、最小样本数 MinPts)敏感,参数设置不当会导致聚类效果极差。
- 处理密度差异大的数据时效果差(如一个簇密度高、一个簇密度低,易把低密度簇当成噪声)。

PCA
- 核心思想:把高维度数据 “压缩” 到低维度,同时尽可能保留数据的 “信息量”—— 找到一组 “新的正交特征(主成分)”,第一主成分是数据方差最大的方向(包含信息最多),第二主成分是与第一主成分垂直且方差次大的方向,以此类推,取前几个主成分实现降维。
- 适用场景:降维(减少计算量、避免维度灾难)、数据可视化(把高维数据降到 2D/3D 后画图)。
- 核心场景:高维数据降维,解决 “维度灾难”,常用于 “数据可视化” 和 “简化模型计算”。
- 数据可视化:把 “100 个特征的用户数据” 降到 2 维,用散点图展示,直观看到用户的分布规律(如是否有明显的分组)。
- 模型优化:在训练 “图像识别模型” 前,用 PCA 把 “1000 维的图像特征” 降到 200 维,减少模型计算量,同时保留核心信息。
- 特征选择:通过 PCA 分析 “各主成分的方差占比”,找到对数据影响最大的几个核心特征(如主成分 1 占方差 80%,说明该特征是关键)。
- 核心特点:通过 “降维” 保留数据的核心信息(方差最大的方向),是高维数据处理的基础工具。
- 优点:
- 能有效减少特征维度,降低模型计算量,避免维度灾难(如把 1000 维图像特征降到 200 维)。
- 可用于数据可视化(降维到 2D/3D),直观观察数据分布(如用户分群的散点图)。
- 缺点:
- 主成分的物理意义不明确(如 “主成分 1=0.3× 身高 + 0.5× 体重 + 0.2× 年龄”,难以解释)。
- 降维会损失部分信息,若数据的核心信息不在 “方差最大的方向”,会导致后续模型精度下降。

Apriori
- 核心思想:基于 “频繁项集的子集一定是频繁的,非频繁项集的超集一定是非频繁的” 这一原理,先找出所有 “频繁项集”(出现次数超过阈值的物品组合),再从频繁项集中提取满足 “置信度”(规则的可靠程度)的关联规则。
- 适用场景:购物篮分析(比如 “买尿布的人常买啤酒”)、推荐系统(根据购买记录推荐关联商品)。
- 核心场景:中小规模数据的关联规则挖掘,适合需要明确 “买 A 带火 B” 的业务。
- 购物篮分析:超市分析收银数据,发现 “买尿布的用户有 60% 会买啤酒”,把尿布和啤酒放在相邻货架,提升销量。
- 电商推荐:用户购买 “手机” 后,推荐 “手机壳、耳机”(基于 “买手机→买手机配件” 的关联规则)。
- 餐饮搭配:餐厅分析点餐数据,发现 “点汉堡的用户有 80% 会点可乐”,推出 “汉堡 + 可乐” 的套餐,提高客单价。
- 核心特点:基于 “频繁项集的子集必频繁” 原理,分 “找频繁项集→提关联规则” 两步,逻辑清晰。
- 优点:
- 算法逻辑简单易懂,易于实现,适合中小规模数据的关联分析(如单店的购物篮数据)。
- 能明确输出关联规则的 “支持度”(规则出现频率)和 “置信度”(规则可靠程度),便于业务判断。
- 缺点:
- 需多次扫描数据,且会生成大量候选集(如商品数 1000 时,候选集可能达百万级),处理大规模数据时速度慢。
- 对 “长项集”(如同时买 5 种商品)不友好,支持度易低于阈值而被过滤。
FP-growth
- 核心思想:改进 Apriori 的效率 —— 先把数据转换成一棵 “FP 树”(频繁模式树),树中节点记录物品及其出现次数,再通过遍历 FP 树直接挖掘频繁项集,无需多次扫描数据,速度比 Apriori 快。
- 适用场景:和 Apriori 类似,适合大规模数据的关联规则挖掘,解决 Apriori“多次扫描数据、生成大量候选集” 的问题。
- 核心场景:大规模数据的关联规则挖掘,解决 Apriori “速度慢” 的问题。
- 电商平台:处理 “千万级用户的购买记录”,快速挖掘 “关联商品”(如 “买笔记本电脑→买鼠标、键盘”),实时推荐给用户。
- 零售连锁:全国连锁超市分析 “百万家门店的销售数据”,用 FP-growth 快速找到 “跨门店通用的关联规则”(如 “买牛奶→买面包” 在所有门店都成立),统一制定促销方案。
- 物流库存:分析 “商品出库记录”,发现 “发货 A 商品时,80% 会同时发 B 商品”,优化仓库拣货路径(把 A 和 B 放在相邻货位)。
- 核心特点:用 “FP 树” 存储数据,直接从树中挖掘频繁项集,无需生成候选集,效率比 Apriori 高。
- 优点:
- 仅需扫描数据 2 次(1 次建 FP 树,1 次挖频繁项集),且无候选集生成,处理大规模数据(如千万级订单)时速度快。
- 对 “长项集” 的挖掘能力比 Apriori 强,不易遗漏低频但有价值的长关联规则。
- 缺点:
- FP 树的构建和遍历逻辑复杂,比 Apriori 难理解和实现。
- 数据量极大或项集极长时,FP 树会占用较多内存,可能导致构建失败。

一、监督学习评价指标
监督学习分回归(预测连续值) 和分类(预测离散类别),两类任务的评价指标完全不同,需分开对应。
(一)回归任务(对应算法:一元 / 多元线性回归、KNN 回归、决策树回归、随机森林回归、XGBoost 回归)
核心是 “衡量预测值与真实值的差距”,常用指标如下:
| 评价指标 | 核心含义 | 计算逻辑(简化版) | 特点与适用场景 | ||
|---|---|---|---|---|---|
| MAE(平均绝对误差) | 所有样本 “预测值与真实值的绝对差” 的平均值,反映误差的平均大小。 | (Σ | 预测值 - 真实值 | )/ 样本数 | 对异常值不敏感,适合希望 “误差直观可解释” 的场景(如预测房价,MAE=5 万表示平均差 5 万元)。 |
| MSE(均方误差) | 所有样本 “预测值与真实值的差的平方” 的平均值,对大误差惩罚更重。 | (Σ(预测值 - 真实值)²)/ 样本数 | 对异常值敏感(大误差平方后会放大),适合需 “严格控制大误差” 的场景(如医疗剂量预测,不允许大幅偏差)。 | ||
| RMSE(均方根误差) | MSE 的平方根,将误差还原到与原数据相同的单位,更易理解。 | √(MSE) | 兼顾 “惩罚大误差” 和 “单位直观”,是回归任务最常用的指标(如预测销量,RMSE=100 件表示误差范围约 ±100 件)。 | ||
| R²(决定系数) | 衡量 “模型解释数据变异的能力”,取值范围 0~1,越接近 1 说明模型拟合越好。 | 1 - (误差平方和 / 真实值总变异平方和) | 直观反映模型 “有用性”:R²=0.8 表示模型能解释 80% 的真实值变化,适合需要 “评估模型解释力” 的场景(如分析因素对结果的影响)。 |
(二)分类任务(对应算法:逻辑回归、朴素贝叶斯、KNN 分类、决策树分类、SVM、随机森林分类、XGBoost 分类)
核心是 “衡量预测类别与真实类别的匹配程度”,需先明确混淆矩阵(分类任务的基础),再衍生出各类指标:
1. 基础:混淆矩阵(二分类场景)
| 真实 \ 预测 | 正类(1) | 负类(0) |
|---|---|---|
| 正类(1) | TP(真阳性):真实正类被预测为正类 | FN(假阴性):真实正类被预测为负类 |
| 负类(0) | FP(假阳性):真实负类被预测为正类 | TN(真阴性):真实负类被预测为负类 |
2. 常用分类指标
| 评价指标 | 核心含义 | 计算逻辑 | 特点与适用场景 |
|---|---|---|---|
| 准确率(Accuracy) | 所有预测正确的样本占总样本的比例,反映整体预测正确性。 | (TP + TN)/(TP + TN + FP + FN) | 适合 “正负类样本均衡” 的场景(如普通图像分类);不适合不均衡场景(如癌症检测,99% 是健康人,模型全预测负类也能得 99% 准确率,但毫无意义)。 |
| 精确率(Precision) | 预测为正类的样本中,真实为正类的比例,反映 “预测正类的可靠性”。 | TP /(TP + FP) | 适合 “重视避免假阳性” 的场景:如垃圾邮件识别(FP 是正常邮件被误判为垃圾,需严格控制,避免用户丢失重要邮件)。 |
| 召回率(Recall/Sensitivity) | 真实为正类的样本中,被预测为正类的比例,反映 “捕捉正类的能力”。 | TP /(TP + FN) | 适合 “重视避免假阴性” 的场景:如癌症检测(FN 是癌症患者被误判为健康,需尽可能捕捉,避免漏诊)、欺诈检测(漏判欺诈会导致损失)。 |
| F1 分数 | 精确率和召回率的调和平均数,综合两者表现,解决 “精确率与召回率冲突” 的问题。 | 2×(Precision×Recall)/(Precision + Recall) | 适合 “需要平衡精确率和召回率” 的场景:如电商用户流失预测(既不想误判忠诚用户为流失,也不想漏判潜在流失用户)。 |
| AUC(ROC 曲线下面积) | 衡量 “模型区分正负类的能力”,取值 0.5~1,越接近 1 说明区分能力越强(0.5 是随机猜测)。 | ROC 曲线(横轴:假阳性率 FPR,纵轴:真阳性率 TPR)下的面积 | 适合 “正负类不均衡” 或 “需要评估概率预测能力” 的场景(如逻辑回归输出概率,AUC 能反映概率排序的合理性),是分类任务的核心指标之一。 |
二、无监督学习评价指标(对应算法:K-means、层次聚类、DBSCAN、PCA)
无监督学习无标签,评价核心是 “衡量聚类结果的紧凑性(簇内样本相似)和分离度(簇间样本不同)”,或 “降维后信息的保留程度”。
(一)聚类任务(K-means、层次聚类、DBSCAN)
| 评价指标 | 核心含义 | 计算逻辑(简化版) | 特点与适用场景 |
|---|---|---|---|
| 轮廓系数(Silhouette Coefficient) | 衡量 “每个样本与自身簇的相似度” 和 “与其他簇的相似度” 的差值,取值 - 1~1,越接近 1 聚类效果越好。 | (样本与其他簇的平均距离 - 样本与自身簇的平均距离)/max (两者) | 无需真实标签,适合 “无参考标准” 的聚类场景(如探索性用户分群);但对球形簇友好,非球形簇(如 DBSCAN 的不规则簇)结果可能不准。 |
| CH 指数(Calinski-Harabasz Index) | 用 “簇间离均差平方和” 与 “簇内离均差平方和” 的比值衡量,值越大说明簇间差异大、簇内差异小,聚类越好。 | (簇间平方和 / (簇数 - 1)) / (簇内平方和 / (样本数 - 簇数)) | 计算简单,适合 “需要量化聚类效果” 的场景(如比较 K-means 不同 K 值的结果);同样对非球形簇敏感性较低。 |
| 互信息(Mutual Information, MI) | 若有 “真实类别标签”(如已知用户真实分层),可衡量 “聚类结果与真实标签的匹配程度”,值越大匹配度越高。 | 衡量聚类簇与真实类别间的 “信息重叠度”(需结合熵计算) | 适合 “有真实标签作为参考” 的场景(如验证聚类算法效果);需注意:即使聚类数与真实类别数不同,也能计算。 |
(二)降维任务(PCA)
核心是 “衡量降维后数据保留的信息比例”,常用指标如下:
| 评价指标 | 核心含义 | 计算逻辑 | 特点与适用场景 | ||
|---|---|---|---|---|---|
| 方差解释比例(Variance Explained Ratio) | 单个主成分或前 k 个主成分 “解释的原数据方差占比”,反映信息保留程度。 | (主成分的方差)/(原数据所有特征的总方差) | PCA 的核心评价指标:如前 2 个主成分的方差解释比例之和为 85%,表示降维到 2 维后保留了 85% 的原始信息,适合判断 “降维维度 k 的选择”(通常选累计占比≥80% 的 k)。 | ||
| 重构误差(Reconstruction Error) | 数据经 PCA 降维后,再还原回原维度,与原始数据的误差,反映降维的信息损失程度。 | (Σ | 原始数据 - 重构数据 | )/ 样本数(类似 MAE) | 直观衡量 “降维损失”:重构误差越小,说明降维保留的信息越多,适合对 “降维后数据精度要求高” 的场景(如图像压缩,需控制重构误差避免画质模糊)。 |
三、关联规则学习评价指标(对应算法:Apriori、FP-growth)
核心是 “衡量关联规则的‘频繁性’和‘可靠性’”,常用指标如下:
| 评价指标 | 核心含义 | 计算逻辑(以规则 “买 A→买 B” 为例) | 特点与适用场景 |
|---|---|---|---|
| 支持度(Support) | 规则中 “所有项同时出现的频率”,反映规则的 “普遍性”。 | (同时买 A 和 B 的订单数)/(总订单数) | 筛选 “频繁出现” 的规则:如支持度≥5% 表示 “买 A 又买 B” 的订单占比超 5%,避免分析低频无意义的规则(如 “买冰箱→买牙签” 可能支持度极低)。 |
| 置信度(Confidence) | 买 A 的订单中,同时买 B 的比例,反映规则的 “可靠性”。 | (同时买 A 和 B 的订单数)/(买 A 的订单数) | 衡量 “规则的可信程度”:如置信度 = 60% 表示 “买 A 的用户中有 60% 会买 B”,置信度越高,推荐 B 给买 A 的用户时成功率越高。 |
| 提升度(Lift) | 衡量 “买 A 对买 B 的促进作用”,判断规则是否有 “实际价值”(而非随机关联)。 | 置信度(A→B) / 支持度(B) | - 提升度 > 1:买 A 能促进买 B(规则有价值);- 提升度 = 1:买 A 与买 B 无关;- 提升度 < 1:买 A 抑制买 B;适合过滤 “伪关联” 规则(如 “买水→买面包” 可能支持度高,但提升度 = 1,说明两者只是随机同时出现)。 |
拟合程度控制及过/欠原因
1. 一元 / 多元线性回归
- 过拟合原因:
- 多元回归中特征过多(如引入无关特征 “用户 ID” 预测房价),模型为适配训练集拟合了无关噪声。
- 数据量极小(如用 10 个样本训练 5 个特征的模型),模型易 “死记硬背” 样本。
- 欠拟合原因:
- 模型本身是线性的,无法捕捉数据的非线性关系(如 “收入与消费” 呈二次曲线,线性模型只能拟合直线)。
- 关键特征缺失(如预测房价时没加入 “地段” 特征,模型无法解释核心差异)。
- 拟合控制方法:
- 过拟合控制:① 用正则化(L1/L2)(如 L2 正则限制权重大小,避免某特征权重过大);② 剔除无关特征(通过特征选择,如方差分析、递归特征消除);③ 增加训练数据量。
- 欠拟合控制:① 补充关键特征(如加入 “地段”“学区” 到房价预测);② 对特征做非线性变换(如给 “面积” 加平方项,适配非线性关系)。
2. 逻辑回归
- 过拟合原因:
- 正则化强度不足(如 sklearn 中
C值过大,对权重约束弱,模型拟合训练集噪声)。 - 特征维度极高且冗余(如文本分类时保留过多低频词,模型学习到无意义的词关联)。
- 正则化强度不足(如 sklearn 中
- 欠拟合原因:
- 模型是 “线性分类器”,无法处理非线性可分数据(如 “环形分布的二分类数据”,逻辑回归只能画直线边界)。
- 正则化过强(
C值过小,权重被过度压缩,模型无法区分正负类)。
- 拟合控制方法:
- 过拟合控制:① 调小
C值(增强正则化);② 特征降维(如用 PCA 减少文本特征维度);③ 增加数据量(尤其是异常样本)。 - 欠拟合控制:① 调大
C值(减弱正则化);② 对特征做非线性变换(如加入 “特征交叉项”,如 “年龄 × 收入”);③ 改用核逻辑回归(适配非线性数据)。
- 过拟合控制:① 调小
3. 朴素贝叶斯
- 过拟合原因:
- 拉普拉斯平滑系数过小(
α接近 0,未平滑 “零概率”,模型过度依赖训练集中的高频特征,忽略低频但重要的特征)。 - 特征独立性假设被严重违背(如文本中 “国王” 和 “皇后” 高度相关,模型重复计算两者权重,放大局部规律)。
- 拉普拉斯平滑系数过小(
- 欠拟合原因:
- 拉普拉斯平滑过强(
α过大,所有特征概率被平均化,模型无法区分关键特征和无关特征)。 - 特征维度不足(如情感分析时只用词频,没加入 “否定词” 特征,模型无法判断 “不好” 是负面情绪)。
- 拉普拉斯平滑过强(
- 拟合控制方法:
- 过拟合控制:① 调大
α值(增强平滑,避免极端概率);② 筛选核心特征(如文本分类时保留高频、高区分度的词)。 - 欠拟合控制:① 调小
α值(减弱平滑,保留特征差异);② 补充高区分度特征(如情感分析加入 “否定词”“程度副词”)。
- 过拟合控制:① 调大
4. KNN(K 近邻)
- 过拟合原因:
K值过小(如K=1,模型只看最近 1 个样本,易被异常值干扰,比如把 “异常高的房价” 当成正常规律)。- 特征未标准化(如 “收入(万元)” 和 “年龄(岁)” 量级差异大,距离计算偏向收入,模型拟合收入的局部噪声)。
- 欠拟合原因:
K值过大(如K=100,模型看过多远邻,忽略局部特征,比如把 “高收入用户” 和 “低收入用户” 归为一类)。- 特征维度过高(维度灾难导致距离计算失效,模型无法区分样本相似性)。
- 拟合控制方法:
- 过拟合控制:① 调大
K值(减少异常值影响);② 特征标准化(如 Z-score 标准化,让各特征量级一致);③ 特征降维(如用 PCA 减少维度)。 - 欠拟合控制:① 调小
K值(增强局部特征捕捉);② 增加高区分度特征(如给用户分群加入 “消费频率” 特征)。
- 过拟合控制:① 调大
5. 决策树(ID3/C4.5/CART)
- 过拟合原因:
- 树深度过深(
max_depth太大,或不限制深度,树分支过多,记住训练集每个样本的细节,包括噪声)。 - 叶子节点样本数过少(
min_samples_leaf太小,如 1 个样本就成叶子,模型把偶然样本当成规律)。
- 树深度过深(
- 欠拟合原因:
- 树深度过浅(
max_depth太小,如只分 2 层,模型无法捕捉复杂决策逻辑,比如 “年龄> 30 且收入 > 50 万” 的高价值用户规则)。 - 拆分节点样本数过多(
min_samples_split太大,节点早早就停止拆分,模型过于简单)。
- 树深度过浅(
- 拟合控制方法:
- 过拟合控制:① 限制树深度(调小
max_depth);② 增加叶子节点最小样本数(调大min_samples_leaf);③ 剪枝(预剪枝:拆分前判断是否提升精度;后剪枝:生成完整树后删除冗余分支)。 - 欠拟合控制:① 调大
max_depth(增加树复杂度);② 调小min_samples_split(允许节点更多拆分);③ 补充关键特征(如给用户流失预测加入 “投诉次数”)。
- 过拟合控制:① 限制树深度(调小
6. SVM(支持向量机)
- 过拟合原因:
- 惩罚系数
C过大(对越界样本惩罚重,模型为少越界,过度弯曲分类边界,拟合训练集噪声)。 - 核函数选择不当(如用高次多项式核处理简单线性数据,模型边界过于复杂)。
- 惩罚系数
- 欠拟合原因:
C值过小(对越界样本惩罚轻,模型允许大量样本越界,分类边界过于简单,无法区分正负类)。- 核函数复杂度不足(如用线性核处理非线性数据,模型只能画直线边界,无法适配数据分布)。
- 拟合控制方法:
- 过拟合控制:① 调小
C值(允许少量越界,简化边界);② 选择简单核函数(如线性核替代高次多项式核);③ 特征降维(减少冗余特征)。 - 欠拟合控制:① 调大
C值(严格惩罚越界,复杂边界);② 选择复杂核函数(如 RBF 核替代线性核);③ 增加特征维度(如加入特征交叉项)。
- 过拟合控制:① 调小
7. Bagging(随机森林)
- 过拟合原因:
- 单棵树复杂度太高(如
max_depth太大,每棵树都过拟合,投票时噪声无法抵消)。 - 特征随机选择比例不当(如每次选 90% 特征,树之间相似度高,多样性不足,无法缓解过拟合)。
- 单棵树复杂度太高(如
- 欠拟合原因:
- 树的数量过少(
n_estimators太小,如 10 棵树,投票结果不稳定,未学到核心规律)。 - 单棵树过于简单(
max_depth太小,每棵树都欠拟合,集成后仍欠拟合)。
- 树的数量过少(
- 拟合控制方法:
- 过拟合控制:① 降低单棵树复杂度(调小
max_depth、调大min_samples_leaf);② 减少每次选择的特征比例(如 sklearn 中max_features设为 “sqrt”,增强树的多样性);③ 增加树的数量(更多树能更好抵消噪声)。 - 欠拟合控制:① 增加树的数量(
n_estimators调大,如 100→200);② 提升单棵树复杂度(调大max_depth、调小min_samples_leaf);③ 补充关键特征。
- 过拟合控制:① 降低单棵树复杂度(调小
8. Boosting(AdaBoost/GBDT/XGBoost)
- 过拟合原因:
- 学习率
η过大(单棵树贡献重,模型过度关注前树错误样本,放大噪声影响)。 - 树的数量过多(
n_estimators太大,模型持续修正微小错误,最终拟合噪声)。 - 正则化不足(如 XGBoost 中
lambda太小,未限制权重,树复杂度高)。
- 学习率
- 欠拟合原因:
- 学习率
η过小(单棵树贡献轻,需极多树才能拟合规律,当前树数量不足时欠拟合)。 - 树的数量过少(
n_estimators太小,模型未完成足够修正,残留大量误差)。 - 正则化过强(
lambda太大,权重被过度压缩,树无法捕捉关键差异)。
- 学习率
- 拟合控制方法:
- 过拟合控制:① 调小
η(如 0.1→0.01),配合增加n_estimators;② 增加正则化(调大lambda/alpha);③ 降低单棵树复杂度(调小max_depth、调大min_child_weight)。 - 欠拟合控制:① 调大
η(如 0.01→0.1);② 增加n_estimators(如 100→300);③ 降低正则化(调小lambda/alpha);④ 提升单棵树复杂度(调大max_depth)。
- 过拟合控制:① 调小
1. K-means
- 过聚类原因(类似过拟合):
K值过大(如实际 3 类用户,设K=10,模型把同一类拆成多个小簇,过度细分噪声)。- 初始中心选择差(随机选初始点,导致中心偏向局部噪声,形成不合理小簇)。
- 欠聚类原因(类似欠拟合):
K值过小(如实际 5 类用户,设K=2,模型把多类合并成 2 个大簇,未区分核心差异)。- 特征未标准化(量级大的特征主导距离计算,掩盖其他特征的簇差异,导致多类合并)。
- 效果控制方法:
- 过聚类控制:① 用轮廓系数 / CH 指数选最优
K(如从 2 到 10 计算指标,取得分最高的K);② 用 “k-means++” 初始化中心(避免局部最优);③ 合并相似簇(聚类后计算簇间距离,合并距离近的簇)。 - 欠聚类控制:① 调大
K值,重新聚类;② 特征标准化(让各特征公平参与距离计算);③ 补充高区分度特征(如给用户分群加入 “消费频次”)。
- 过聚类控制:① 用轮廓系数 / CH 指数选最优
2. 层次聚类
- 过聚类原因:
- 距离度量选择不当(如用 “single” 链接,易形成链式小簇,把噪声样本单独成簇)。
- 聚类树截断过早(在树的深层截断,拆分过多小簇)。
- 欠聚类原因:
- 距离度量选择不当(如用 “complete” 链接,易把多类合并成大簇,忽略局部差异)。
- 聚类树截断过晚(在树的浅层截断,合并过多不同簇)。
- 效果控制方法:
- 过聚类控制:① 改用 “ward” 或 “complete” 链接(减少小簇);② 在聚类树的中层截断(如从树的高度 5 截断,而非高度 2);③ 过滤小簇(删除样本数 < 5 的噪声簇)。
- 欠聚类控制:① 改用 “single” 或 “average” 链接(增加簇的细分);② 在聚类树的深层截断(如从树的高度 2 截断);③ 补充特征(如加入 “用户活跃度” 提升区分度)。
3. DBSCAN
- 过聚类原因:
ε过小(邻域半径小,核心点少,大量样本被判定为噪声,少数样本形成小簇)。MinPts过大(核心点阈值高,只有密度极高的区域才成簇,其他区域拆成小簇或噪声)。
- 欠聚类原因:
ε过大(邻域半径大,多个独立簇被合并成一个大簇,无法区分)。MinPts过小(核心点阈值低,噪声样本也被当成核心点,合并成大簇)。
- 效果控制方法:
- 过聚类控制:① 调大
ε(扩大邻域,合并小簇);② 调小MinPts(降低核心点阈值,增加核心点,合并小簇);③ 用 “K 距离图” 选ε(找图中拐点,避免ε过小)。 - 欠聚类控制:① 调小
ε(缩小邻域,拆分大簇);② 调大MinPts(提高核心点阈值,减少核心点,拆分大簇);③ 特征标准化(避免某特征主导距离计算,导致大簇合并)。
- 过聚类控制:① 调大
4. PCA(主成分分析)
- 信息丢失过多(类似欠拟合):
- 降维维度
n_components过小(如从 100 维降到 10 维,累计方差解释比例仅 60%,丢失 40% 核心信息)。 - 未中心化(特征量级差异大,主成分偏向量级大的特征,忽略其他特征的信息)。
- 降维维度
- 降维效果差(类似过拟合):
n_components过大(如从 100 维降到 80 维,未有效减少维度,仍存在冗余信息)。- 数据本身线性相关性弱(如随机生成的高维数据,主成分无法提取有效信息,降维后无意义)。
- 效果控制方法:
- 信息丢失控制:① 调大
n_components(如设为 0.9,保留 90% 方差);② 对数据中心化(确保各特征公平参与主成分计算);③ 先做特征选择(剔除无关特征,再做 PCA)。 - 降维效果控制:① 调小
n_components(如从 80 维降到 30 维);② 对数据做标准化(增强特征间的线性相关性,让主成分更易提取信息)。
- 信息丢失控制:① 调大
Apriori/FP-growth
- 规则冗余(类似过拟合):
- 最小支持度
min_support过低(如 0.001,挖掘出 “买牙刷 + 买牙膏 + 买拖鞋” 这类低频偶然规则,无实际意义)。 - 最小置信度
min_confidence过低(如 0.3,保留 “买纸巾→买电视” 这类低可靠规则,推荐成功率低)。
- 最小支持度
- 规则太少(类似欠拟合):
min_support过高(如 0.1,过滤掉 “买单反→买镜头” 这类低频但高价值规则,错失商机)。min_confidence过高(如 0.9,仅保留 “买手机→买充电器” 这类 obvious 规则,无新发现)。
- 效果控制方法:
- 规则冗余控制:① 调大
min_support(如从 0.001→0.01,过滤低频规则);② 调大min_confidence(如从 0.3→0.6,保留高可靠规则);③ 用 “提升度” 过滤伪关联(仅保留提升度 > 1 的规则)。 - 规则太少控制:① 调小
min_support(如从 0.1→0.05,保留更多中频规则);② 调小min_confidence(如从 0.9→0.7,挖掘更多潜在规则);③ 拆分数据(如按 “地区” 拆分订单数据,挖掘区域专属规则)。
- 规则冗余控制:① 调大

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 32
 0
- 0


 已为社区贡献4条内容

所有评论(0)