深度学习-避免过拟合(模型选择、权重衰减、暂退法)
目录
1 基本原理
过拟合是深度学习中非常常见的问题,即模型高度拟合训练数据而失去了泛化能力,导致其在测试数据上表现不尽人意。过拟合的主要原因来自于模型复杂度过高与训练数据不足,本章将从3个方面讲解如何尽量避免过拟合。
2 模型选择
2.1 特征数
2.1.1 基本原理
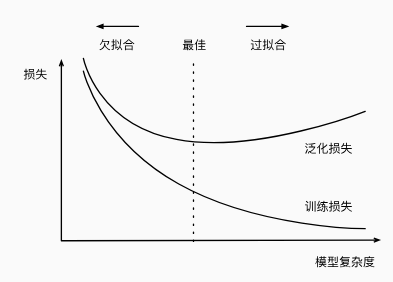
模型需要的特征数量越少,模型会越简单,反之越复杂。显然特征数量过少模型会欠拟合,特征数量过多则容易过拟合。这里以一个多项式拟合为例,在多项式中特征值表现为输入x的不同次数,权重与特征值相乘后求和,是一个简单的线性拟合,我们构造的多项式模型特征值越多则该多项式阶数就越高,其在训练中拟合效果会越好,但阶数过高以后其在测试数据中表现会急剧下降。因为阶数越高,其对输入数据的微小变化会越敏感,受到噪声的干扰也会越大。
2.1.2 数据集
接下来进行一个多项式拟合,数据集基于下式生成,是一个三阶多项式
下面的代码通过广播机制生成了由200个样本组成的张量(200行),每个样本X由生成(20列),再除以对应指数的阶乘。在设置权值时只将w的前四位赋为非0值,所以标签的值只由三阶的多项式生成。
import math
import numpy as np
import torch
from torch import nn
from d2l import torch as d2l

max_degree = 20  # 多项式的最大阶数
n_train, n_test = 100, 100  # 训练和测试数据集大小
true_w = np.zeros(max_degree)  # 分配大量的空间
true_w[0:4] = np.array([5, 1.2, -3.4, 5.6])

features = np.random.normal(size=(n_train + n_test, 1))
np.random.shuffle(features)
poly_features = np.power(features, np.arange(max_degree).reshape(1, -1))
for i in range(max_degree):
    poly_features[:, i] /= math.gamma(i + 1)  # gamma(n)=(n-1)!
# labels的维度:(n_train+n_test,)
labels = np.dot(poly_features, true_w)
labels += np.random.normal(scale=0.1, size=labels.shape)

# NumPy ndarray转换为tensor
true_w, features, poly_features, labels = [torch.tensor(x, dtype=torch.float32) for x in [true_w, features, poly_features, labels]]
2.1.3 训练
先定义损失评估函数(计算整个数据集的损失)和训练函数
def evaluate_loss(net, data_iter, loss):  #@save
    """评估给定数据集上模型的损失"""
    metric = d2l.Accumulator(2)  # 损失的总和,样本数量
    for X, y in data_iter:
        out = net(X)
        y = y.reshape(out.shape)
        l = loss(out, y)
        metric.add(l.sum(), l.numel())
    return metric[0] / metric[1]


def train(train_features, test_features, train_labels, test_labels,
          num_epochs=400):
    loss = nn.MSELoss(reduction='none')
    input_shape = train_features.shape[-1]
    # 不设置偏置,因为我们已经在多项式中实现了它
    net = nn.Sequential(nn.Linear(input_shape, 1, bias=False))
    batch_size = min(10, train_labels.shape[0])
    train_iter = d2l.load_array((train_features, train_labels.reshape(-1,1)),
                                batch_size)
    test_iter = d2l.load_array((test_features, test_labels.reshape(-1,1)),
                               batch_size, is_train=False)
    trainer = torch.optim.SGD(net.parameters(), lr=0.01)
    animator = d2l.Animator(xlabel='epoch', ylabel='loss', yscale='log',
                            xlim=[1, num_epochs], ylim=[1e-3, 1e2],
                            legend=['train', 'test'])
    for epoch in range(num_epochs):
        d2l.train_epoch_ch3(net, train_iter, loss, trainer)
        if epoch == 0 or (epoch + 1) % 20 == 0:
            animator.add(epoch + 1, (evaluate_loss(net, train_iter, loss),
                                     evaluate_loss(net, test_iter, loss)))
    print('weight:', net[0].weight.data.numpy())
分别测试三阶多项式函数拟合、线性函数拟合和高阶多项式函数拟合
用三阶多项式拟合如下
# 从多项式特征中选择前4个维度,即1,x,x^2/2!,x^3/3!
train(poly_features[:n_train, :4], poly_features[n_train:, :4],
      labels[:n_train], labels[n_train:])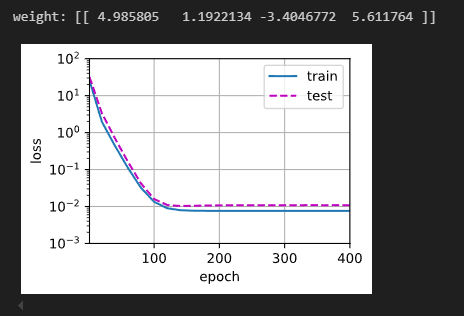
用线性函数拟合如下
# 从多项式特征中选择前2个维度,即1和x
train(poly_features[:n_train, :2], poly_features[n_train:, :2],
      labels[:n_train], labels[n_train:])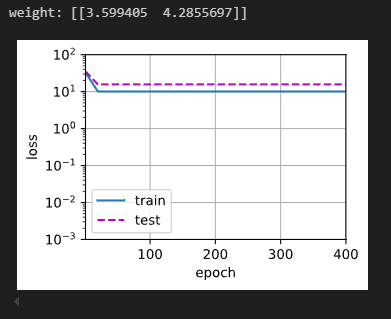
用高阶(19阶)多项式拟合如下
# 从多项式特征中选取所有维度
train(poly_features[:n_train, :], poly_features[n_train:, :],
      labels[:n_train], labels[n_train:])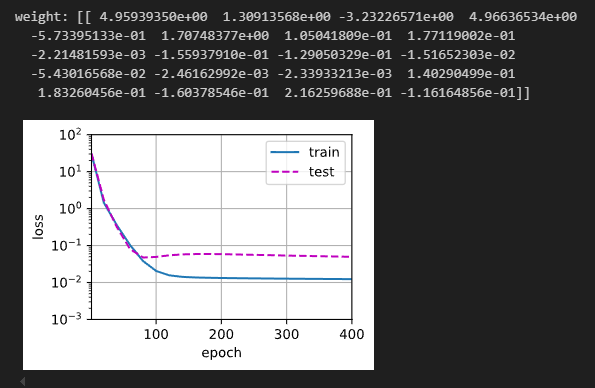
显然在阶数过少和过多时分别发生了欠拟合和过拟合。
2.2 超参数与验证集
2.2.1 基本原理
通常,模型中的超参数(批量大小、学习率等)需要多次调整并验证其训练效果,从而选出最优的超参数。这个过程中需要一批数据集来反复验证我们的模型是否合理。为了避免过拟合测试集的数据,这种情况下我们不会过早用测试集来检测模型,而是用区别于训练集与测试集的第三组数据——验证集来检验我们的模型参数设置是否合理。
2.2.2 K折交叉验证
当数据资源稀缺无法构建合适的验证集时,可以使用k折交叉验证来充分利用训练数据。具体做法是将训练数据划分为K个子集,依次选择其中的每个子集作为验证集,剩余的部分作为训练集,这样进行K次训练和验证后,用结果的平均值估计训练和验证误差。
3 权重衰减
3.1 基本原理
模型正则化(Regularization)是机器学习中的一种技术,用于防止模型过度拟合训练数据,从而提高模型的泛化能力。权重衰减(weight decay)是最广泛使用的正则化的技术之一。其主要目的可以引用书上的话:“我们已经假设了一个先验,即权重的值取自均值为0的高斯分布。 更直观的是,我们希望模型深度挖掘特征,即将其权重分散到许多特征中, 而不是过于依赖少数潜在的虚假关联”,也就是说我们希望权重尽可能分布在0周围。
为什么要这么做,可以AI给的看一个例子:
假设任务:预测房价
特征: 房屋面积(x1),卧室数量(x2),壁炉数量(x3),以及一个无关的噪音特征:上次房主买披萨的日子(x4)
没有正则化(过拟合)的情况:模型可能会发现一个非常偶然的“规律”:上次房主买披萨的日子(x4) 这个特征和房价有某种奇怪的关联(比如数据中恰好有几个房价高的房主都在15号买披萨)。为了完美拟合训练数据,模型可能会给这个无关特征x4分配一个非常大的权重(例如 100000),同时给其他真正重要的特征(如面积x1)分配一个相对较小的权重(例如 100)。
另一方面,从模型复杂度来看,通常认为模型与0的距离越近则模型越简单,所以权重衰减也降低了模型复杂度。相比控制特征数量,权重衰减只对参数范围进行限制,是控制模型复杂度的更细粒度的方法。
3.2 数据集
由下面的线性函数生成,其中特征数d取200,训练数据集大小取20,模拟出容易过拟合的情况。
import torch
from torch import nn
from d2l import torch as d2l

n_train, n_test, num_inputs, batch_size = 20, 100, 200, 5
true_w, true_b = torch.ones((num_inputs, 1)) * 0.01, 0.05
train_data = d2l.synthetic_data(true_w, true_b, n_train)
train_iter = d2l.load_array(train_data, batch_size)
test_data = d2l.synthetic_data(true_w, true_b, n_test)
test_iter = d2l.load_array(test_data, batch_size, is_train=False)
3.3 训练
与线性回归一章的训练区别在于训练时的损失函数除了计算均方误差还要考虑权重的分布(如范数),用来衡量模型是否满足权重尽可能接近0。下面的代码在构造训练器传入的参数{"params":net[0].weight,'weight_decay': wd}中weight_decay就是权重衰减选项,其值wd表示衰减程度,计算时表现为罚项系数。而偏置net[0].bias没有填写weight_decay选项,则不会衰减。
def train_concise(wd):
    net = nn.Sequential(nn.Linear(num_inputs, 1))
    for param in net.parameters():
        param.data.normal_()
    loss = nn.MSELoss(reduction='none')
    num_epochs, lr = 100, 0.003
    # 偏置参数没有衰减
    trainer = torch.optim.SGD([
        {"params":net[0].weight,'weight_decay': wd},
        {"params":net[0].bias}], lr=lr)
    animator = d2l.Animator(xlabel='epochs', ylabel='loss', yscale='log',
                            xlim=[5, num_epochs], legend=['train', 'test'])
    for epoch in range(num_epochs):
        for X, y in train_iter:
            trainer.zero_grad()
            l = loss(net(X), y)
            l.mean().backward()
            trainer.step()
        if (epoch + 1) % 5 == 0:
            animator.add(epoch + 1,
                         (d2l.evaluate_loss(net, train_iter, loss),
                          d2l.evaluate_loss(net, test_iter, loss)))
    print('w的L2范数:', net[0].weight.norm().item())
不进行权重衰减(正则化)
train_concise(0)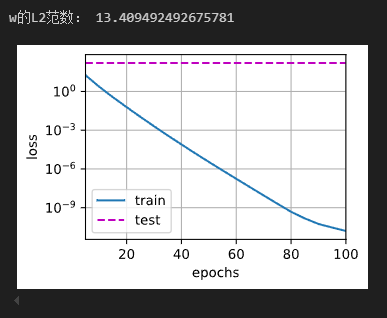
进行罚项系数为3的权重衰减
train_concise(3)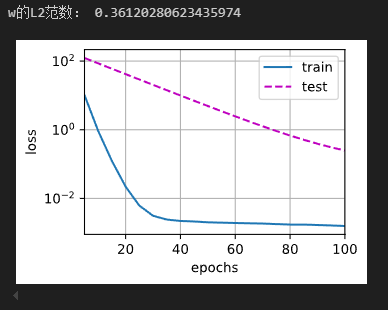
进行罚项系数为5的权重衰减
train_concise(5)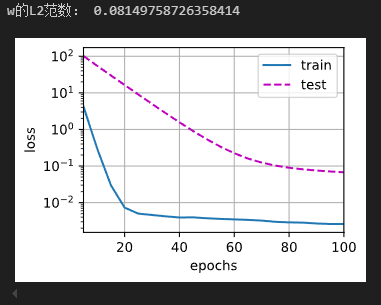
可以看到随着权重衰减程度的提升模型在训练集和测试集上的表现逐渐接近。但并不是对权重的惩罚越大模型表现越好。结合实际,在一定范围内增加罚项系数有助于缓解模型过拟合,需要把控好参数大小。
4 暂退法
4.1 基本原理
“简单性的另一个角度是平滑性,即函数不应该对其输入的微小变化敏感。 例如,当我们对图像进行分类时,我们预计向像素添加一些随机噪声应该是基本无影响的”。暂退法(Dropout)正则化就是基于这个角度提出的,希望通过增强平滑性来避免过拟合。
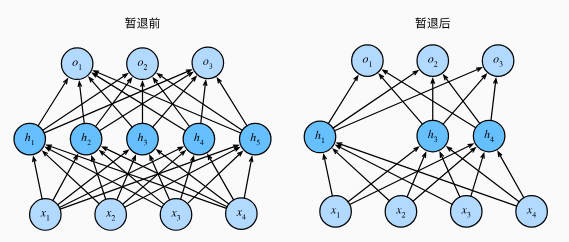
暂退法简单来说就是在训练过程中,在计算后续层之前向网络的每一层注入噪声。具体来说,每个隐藏层的活性值都会以概率p变成0,在标准暂退法中还会把保留的活性值除以1-p来保持期望不变。
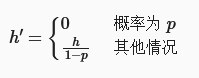
使用暂退法后相当于隐藏层中这些节点在这一轮训练中被抛弃了,如书中的图片所示。
4.2 训练
数据集使用了前面章节的分类数据集Fashion-MNIST,模型的主要区别在于激活模块后面添加了暂退法正则化模块。值得注意的是,通常会在靠近输入层的地方设置较低的暂退概率,避免输入损失太大。
import torch
from torch import nn
from d2l import torch as d2l


dropout1, dropout2 = 0.2, 0.5

net = nn.Sequential(nn.Flatten(),
        nn.Linear(784, 256),
        nn.ReLU(),
        # 在第一个全连接层之后添加一个dropout层
        nn.Dropout(dropout1),
        nn.Linear(256, 256),
        nn.ReLU(),
        # 在第二个全连接层之后添加一个dropout层
        nn.Dropout(dropout2),
        nn.Linear(256, 10))

def init_weights(m):
    if type(m) == nn.Linear:
        nn.init.normal_(m.weight, std=0.01)

net.apply(init_weights);
num_epochs, lr, batch_size = 10, 0.5, 256
loss = nn.CrossEntropyLoss(reduction='none')
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
trainer = torch.optim.SGD(net.parameters(), lr=lr)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)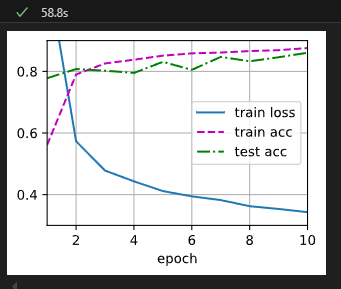

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 8
 0
- 0


 已为社区贡献4条内容

所有评论(0)