用 60 年代的穿孔卡片 COBOL 语言进行机器学习?当然可以
如今,大多数程序员都认为人工智能和机器学习就是庞大的云平台和 GPU 优化库。实际上,它的核心是算法、资源管理和纯粹的优雅。为了向我的学生证明这一点,不久前,我用一个非常老旧的 COBOL 语言编写了一个极简的 K-means 聚类算法。结果出乎意料地,它比我预想的要简单得多。
年轻女子正在使用 COBOL(人工智能生成的艺术)对大型计算机进行编程。
T他之前发表的一篇关于大型语言模型(LLM)和现代人工智能(AI)领域即将到来的“COBOL时刻”的文章获得了相当有趣的反响。大部分内容都持肯定态度,但也有一些批评意见,这些批评意见确实有道理,因为将传统的COBOL代码比作“黑匣子”。我觉得有必要更深入地探讨这个问题,澄清一下大家的误解。
如今,COBOL 还是一个“黑匣子”吗?
正如几位资深程序员在评论中指出的那样,一段扎实的程序代码,就像 COBOL 那样,从来都不是真正的“黑匣子”。只要你花足够的时间仔细研究,确保最终理解了每一步,你总能理解它的含义。
是的,停机问题中存在著名的不可判定性,即只需检查输入即可确定任意计算机程序是否会终止或继续运行,是无法证明的。然而,这并非理解能力差的结果——这与运行时因素的不可预测性和代码执行的动态性有关,即使我们使用的是纯粹确定性的机器。就现实世界的实际情况而言,我们可以进行此类评估,并基于软件开发 (SE)过程中的严格方法,包括验证和确认 (V&V)、形式化方法、模型检查等,提供极高置信度的保证。
COBOL本身就是为了方便非程序员理解而创建的。它的祖先语言FLOW-MATIC由Grace Hopper设计,它是一系列自动“翻译器”的演变,这些翻译器将抽象的人类程序描述转换为机器代码,即后来的编译器。她的一句名言是,她创造了编译器的概念,因为“……程序员太懒了,会犯错误”。因此,当CODASYL 委员会于 1959 年标准化该语言的定义时,COBOL 保持了一种非常人性化的语法,与英语的纯文本非常相似。这使得它甚至比另一个伟大的祖先Fortran 编程语言更具优势,后者也引入了编译器,但它更加面向领域对于非程序员来说更难理解——但仍然远远领先于 50 年代中期使用的任何机器代码。
那么,COBOL 的“黑匣子”标签到底是什么意思呢?我相信上一篇文章对此已经有了更好的解释,尽管似乎没有解释得足够清楚:
如今,COBOL 的问题在于缺乏人类专家,而不是语言本身。
这就像一辆非常老旧的汽车,几十年来一直运行良好,但今天却出现了问题找不到备件,也没有工程师知道如何使用它们。
使用 COBOL 进行机器学习 — 是的,真的
事实上,有很多比COBOL 更好的机器学习替代方案。在 50 年代,它的设计重点截然不同,如今使用的一些编程功能还不存在,甚至计算机中的人工智能概念也还处于起步阶段。
例如,最初的 COBOL 语言对多处理一无所知,因为它是由运行大型主机的操作系统 (OS)负责的。还有很多其他“标准”的东西超出了它的能力范围,比如动态内存管理或动态数据类型,当然还有现代特色,如lambda表达式。
尽管如此,即使是上世纪 60 年代早期的穿孔卡版本的 COBOL,在实现所有必要的核心功能方面也相当强大,包括基本数据类型和算术运算、简单的终端和打印机 I/O,以及条件分支和循环。这些在今天看来可能微不足道,但对于当时的编程水平和计算机使用方式而言,它们相当强大。事实上,根据图灵完备理论,这些功能远远超出了任何人运行任何任务算法所需的能力。
COBOL 中的 K 均值聚类
举个例子,这是我几年前用非常老版本的 COBOL 为我的学生开发的一个用例,目的是向他们展示这个特定的方面:只要有足够的时间和耐心,我们甚至可以在其中进行基本的机器学习 (ML)。
我们可以从通用机器学习领域中选择大量非常小而直接的算法来教学生基本原理,例如特征生成和选择、线性与非线性判别、针对类别的统计显着性检验等。选择任何入门级模型甚至更容易,例如最小距离分类器(MDC)或k最近邻分类器(k -nn)。
或者,我选择了介于两者之间的一种算法,用于聚类(无监督学习)—— K-means 算法显然是最佳选择。它结合了 MDC 和k -nn 在欧氏距离方面的基本功能,以及无监督学习的自组织特性,因此感觉它比简单的描述性统计更“像机器学习”。这本质上意味着在对数据集进行多次迭代“扫描”时,只需执行乘法和求和运算。
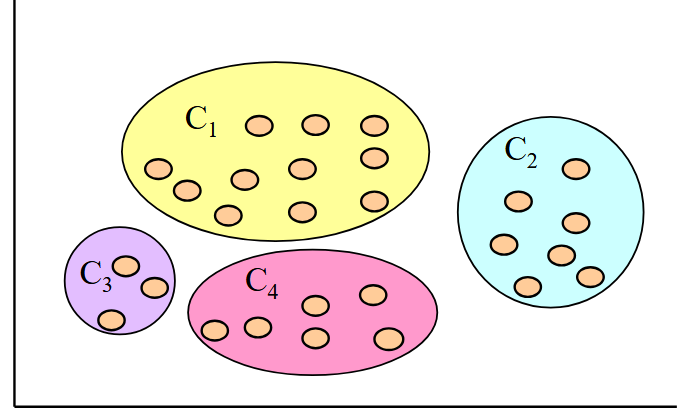
二维平面中具有 4 个聚类的典型聚类示例(CC-BY 作者)。
为了让事情更具挑战性和趣味性,我选择了1985 年的Microsoft COBOL ,这是人们能找到的最古老的 PC 计算机(MS-DOS)语言之一。它与大约同一时代的“标准” RM/COBOL语言大致相同,广泛应用于各种操作系统 (OS)和硬件。这意味着像真正的纸质穿孔卡片一样,列对齐非常严格,强制块,语法非常冗长,并且内部函数非常有限,尤其是在数学运算方面。
例如,当时没有可用的平方根函数,必须避免使用,或者由程序员明确实现(或在外部库中实现)。然而,使用欧几里得度量意味着,无论公式中是否包含平方根,检查每个数据样本的最小距离都是相同的。此外,避免这种不必要且昂贵的计算是当时的做法,因为当时的计算机非常非常慢,CPU 时间如同黄金般珍贵。
下面的代码片段是源程序的开头。完整的源代码可以在我的 Github 上下载并免费使用。
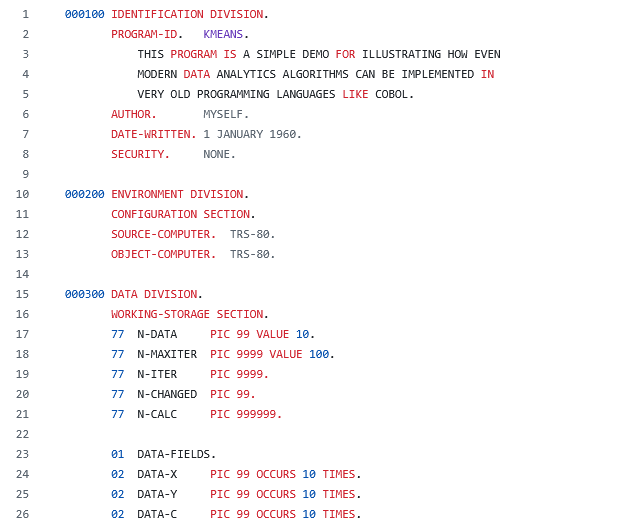
COBOL 中的 K-means 源代码片段(CC-BY 作者)。
观察如今年轻程序员的反应很有趣,他们第一次接触 Python 时,语法约定要宽松得多。一开始就看到一整段摘要和奇怪的数据类型声明,他们惊呆了,难以置信地大笑起来。给他们看这张截图也很有趣,这张截图模拟了当时在TTY 终端上编码的真实情况:没有语法高亮,没有代码提示,甚至没有一步“撤消”命令。只有一个“打字机”屏幕、一个有线键盘和很大的耐心。输入代码,保存文件,多次编译,链接可执行文件,运行它,检查错误,返回更正,然后重复。很多次。
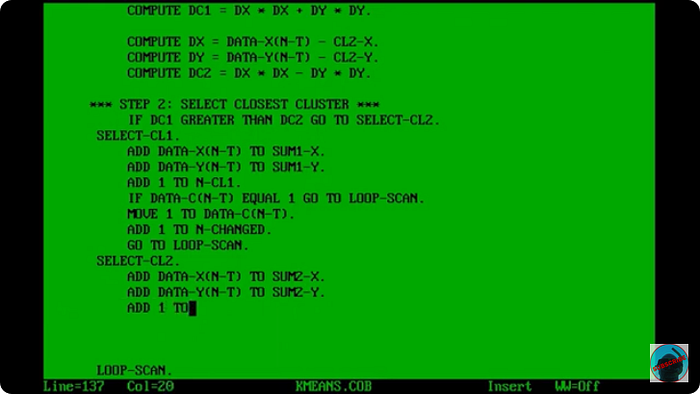
在 TTY 终端中使用 COBOL 编写 K-means 源代码(CC-BY 作者)。
尽管如此,COBOL 语言本身就易于阅读和理解,几乎就像阅读程序的文档文件一样简单,而不是源代码。这种设计选择是经过深思熟虑的,因为 50 年代后期的许多最终用户根本不是程序员,他们至少需要能够轻松地阅读代码。
回到K-means 算法,如果有人想选择其中最具代表性的部分,即“核心”处理,那很可能就是扫描样本数据,估算它们与每个临时聚类中心的距离,并在必要时更改其当前的聚类分配——当不再需要进行此类更改时,训练过程就完成了。这段非常简洁的描述几乎与实现它的 COBOL 代码逐行匹配,如下面的代码片段所示。
<span style="background-color:#f9f9f9"><span style="color:#242424">***<span style="color:#aa0d91">步骤</span> <span style="color:#1c00cf">2</span>:<span style="color:#aa0d91">选择</span>最近的聚类 ***
           <span style="color:#aa0d91">如果</span>DC1 大于 DC2,则转到<span style="color:#aa0d91">选择</span><span style="color:#aa0d91">-CL2</span> 。<span style="color:#aa0d91">选择</span>-CL1。           将数据-X(NT)添加<span style="color:#aa0d91">到</span>SUM1-X。           将数据-Y(NT)添加<span style="color:#aa0d91">到</span>SUM1-Y。           将<span style="color:#1c00cf">1添加</span><span style="color:#aa0d91">到</span>N-CL1。<span style="color:#aa0d91">如果</span>数据-C(NT)等于<span style="color:#1c00cf">1,</span><span style="color:#aa0d91">则</span>转到<span style="color:#aa0d91">循环</span>扫描。将<span style="color:#1c00cf">1</span>           移动<span style="color:#aa0d91">到</span>数据-C(NT)。将<span style="color:#1c00cf">1</span>           添加<span style="color:#aa0d91">到</span>N-CHANGED。           转到<span style="color:#aa0d91">循环</span><span style="color:#aa0d91">扫描</span>。<span style="color:#aa0d91">选择</span>-CL2。           将数据-X(NT)添加<span style="color:#aa0d91">到</span>SUM2-X。           将数据-Y(NT)添加<span style="color:#aa0d91">到</span>SUM2-Y。将<span style="color:#1c00cf">1</span>           添加<span style="color:#aa0d91">到</span>N-CL2。<span style="color:#aa0d91">如果</span>数据-C(NT)等于<span style="color:#1c00cf">2 ,</span><span style="color:#aa0d91">则</span>转到<span style="color:#aa0d91">循环</span>扫描。将<span style="color:#1c00cf">2</span>           移动<span style="color:#aa0d91">到</span>数据-C(NT)。将<span style="color:#1c00cf">1</span>           添加<span style="color:#aa0d91">到</span>N-CHANGED。


 </span></span>
这段代码几乎与 1959 年 COBOL 语言的第一个版本中编写的代码一样,当时用一张穿孔卡片写一行文本。整个程序总共约 182 行,包括注释和约 40 行用于直接在内存中手动创建数据集的代码,以避免设置和执行文件 I/O 所需的较大代码块。虚拟数据集是简单的二维、双聚类分组,包含 10 个样本,即用于此类聚类测试的“hello, world”。
编写和测试代码
如上所述,该程序完全在DOSbox 窗口内编写,这是一个功能强大的 MS-DOS 模拟器,非常适合此类测试,它使用类似于终端的文本编辑器,在功能和局限性方面与传奇的“vi”类似。编译器方面,所有功能都使用了1985 版的 Microsoft COBOL ,无需任何外部库或代码导入。
毋庸置疑,在这种环境下编码,并且没有事先使用代码笔记,效率肯定不高。我花了差不多45分钟编写代码、测试并进行全面调试,正如编码演示(视频)中所示。这也是我的学生们爆笑的时刻,这理所当然,因为同样的程序用 C 语言最多可以在 10 分钟内编写完成,而用 C++ 或 Python 编写则可能不超过 4-5 分钟。即使是 MS-COBOL 编译器也是多遍编译的,可执行文件也需要使用“run”命令在容器程序中运行。
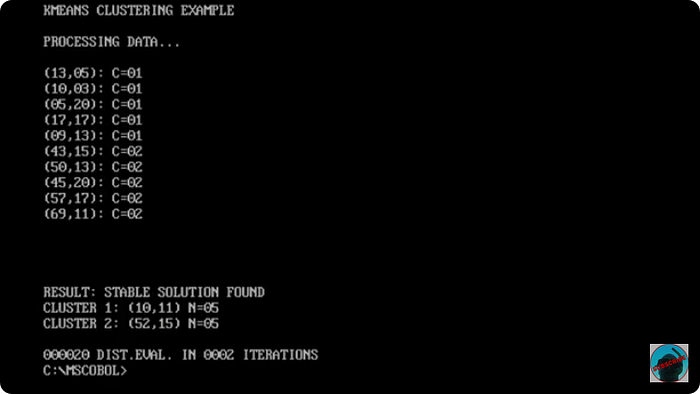
使用 MS-COBOL(CC-BY 作者)在 MS-DOS 中运行 K-means 代码。
结论
那么,这一切的意义何在?花费时间和耐心,用一种已有半个世纪历史的编程语言,以及万维网诞生十年前就存在的工具,真的值得吗?
毫无疑问,是的。也就是说,如果有人想深入挖掘过去,就能感受到当时编程是多么的不同。此外,像格蕾丝·霍珀这样的先驱者,用比80年代的个人电脑还要少的工具和计算资源,竟然取得了如此惊人的成就。对于计算机科学与信息学专业的大学生来说,这种充满乐趣的经历应该成为现代课程的必修课,因为它能增强他们对当今可用计算资源的认知。
还有一个原因:告诉学生们去用高端的大型语言模型 (LLM)来编写这样的程序。当时,机器学习并非 COBOL 的用途,如今 COBOL 也不再用于机器学习。这意味着LLM 代码生成器几乎不需要任何训练数据就能正常工作。学生们会惊讶地发现,人类程序员在如今是多么重要,尤其是在遗留系统中。问问那些在新冠疫情期间争相寻找 COBOL 专家的美国机构就知道了。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)