机器学习之PCA三维特征向量与二元线性回归预测-实验详细过程
机器学习数据分析项目实现详解
本文将详细介绍两个机器学习数据分析项目的实现过程,包括三维数据的主成分分析(PCA)降维以及基于足长和步幅预测身高的二元线性回归模型。这两个项目展示了如何使用Python进行数据可视化和预测分析。
一、三维数据的主成分分析(PCA)降维实现
主成分分析(PCA)是一种常用的降维技术,它可以将高维数据映射到低维空间,同时保留数据中的主要信息。下面详细介绍三维PCA降维的实现过程。
1. 数据生成
首先,我们需要生成具有一定相关性的三维随机数据,用于后续的PCA分析:
import numpy as np

def generate_3d_data(n_points=100):
    """
    生成三维随机数据,用于PCA降维演示

    参数:
        n_points: 数据点数量

    返回:
        三维数据矩阵,形状为(n_points, 3)
    """
    np.random.seed(42)  # 设置随机种子,保证结果可复现

    # 生成三个维度的数据,具有一定的相关性
    x = np.random.normal(0, 1, n_points)
    y = 0.8 * x + np.random.normal(0, 0.5, n_points)
    z = 0.6 * x + 0.4 * y + np.random.normal(0, 0.3, n_points)

    # 组合成三维数据
    data = np.column_stack((x, y, z))

    return data
这个函数生成了100个三维数据点,其中三个维度之间具有一定的相关性,这使得PCA降维更有意义。
2. 计算PCA关键组件
接下来,我们需要实现PCA算法的核心步骤,包括计算平均向量、散度矩阵、特征值和特征向量:
2.1 计算平均向量
def compute_mean_vector(data):
    """
    计算数据的平均向量

    参数:
        data: 输入数据矩阵,形状为(n_samples, n_features)

    返回:
        平均向量,形状为(n_features,)
        np.mean是 NumPy 库中的求平均值函数
    """
    return np.mean(data, axis=0)
2.2 计算散度矩阵
def compute_scatter_matrix(data, mean_vector):
    """
    计算散度矩阵

    参数:
        data: 输入数据矩阵,形状为(n_samples, n_features)
        mean_vector: 平均向量,形状为(n_features,)

    返回:
        散度矩阵,形状为(n_features, n_features)
    """
    # 数据中心化
    centered_data = data - mean_vector

    # 计算散度矩阵 (使用矩阵乘法)
    n_samples = data.shape[0]
    scatter_matrix = (centered_data.T @ centered_data) / (n_samples - 1)

    return scatter_matrix
2.3 计算特征值和特征向量
def compute_eigenvalues_eigenvectors(scatter_matrix):
    """
    计算特征值和特征向量

    参数:
        scatter_matrix: 散度矩阵

    返回:
        eigenvalues: 特征值数组
        eigenvectors: 特征向量矩阵
    """
    # 计算特征值和特征向量
    eigenvalues, eigenvectors = np.linalg.eigh(scatter_matrix)

    # 按特征值从大到小排序
    idx = eigenvalues.argsort()[::-1]
    eigenvalues = eigenvalues[idx]
    eigenvectors = eigenvectors[:, idx]

    return eigenvalues, eigenvectors
2.4 执行PCA降维
def pca_dimension_reduction(data, eigenvectors, n_components=2):
    """
    使用PCA将数据降维到指定维度

    参数:
        data: 输入数据矩阵
        eigenvectors: 特征向量矩阵
        n_components: 要保留的主成分数量

    返回:
        降维后的数据
    """
    # 选择前n_components个特征向量
    selected_eigenvectors = eigenvectors[:, :n_components]

    # 计算均值
    mean_vector = np.mean(data, axis=0)

    # 数据中心化
    centered_data = data - mean_vector

    # 投影到新的空间
    reduced_data = centered_data @ selected_eigenvectors

    return reduced_data
3. 数据可视化
为了更好地理解PCA的效果,我们实现了几个可视化函数:
3.1 三维数据和特征向量可视化
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D

# 设置中文显示
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

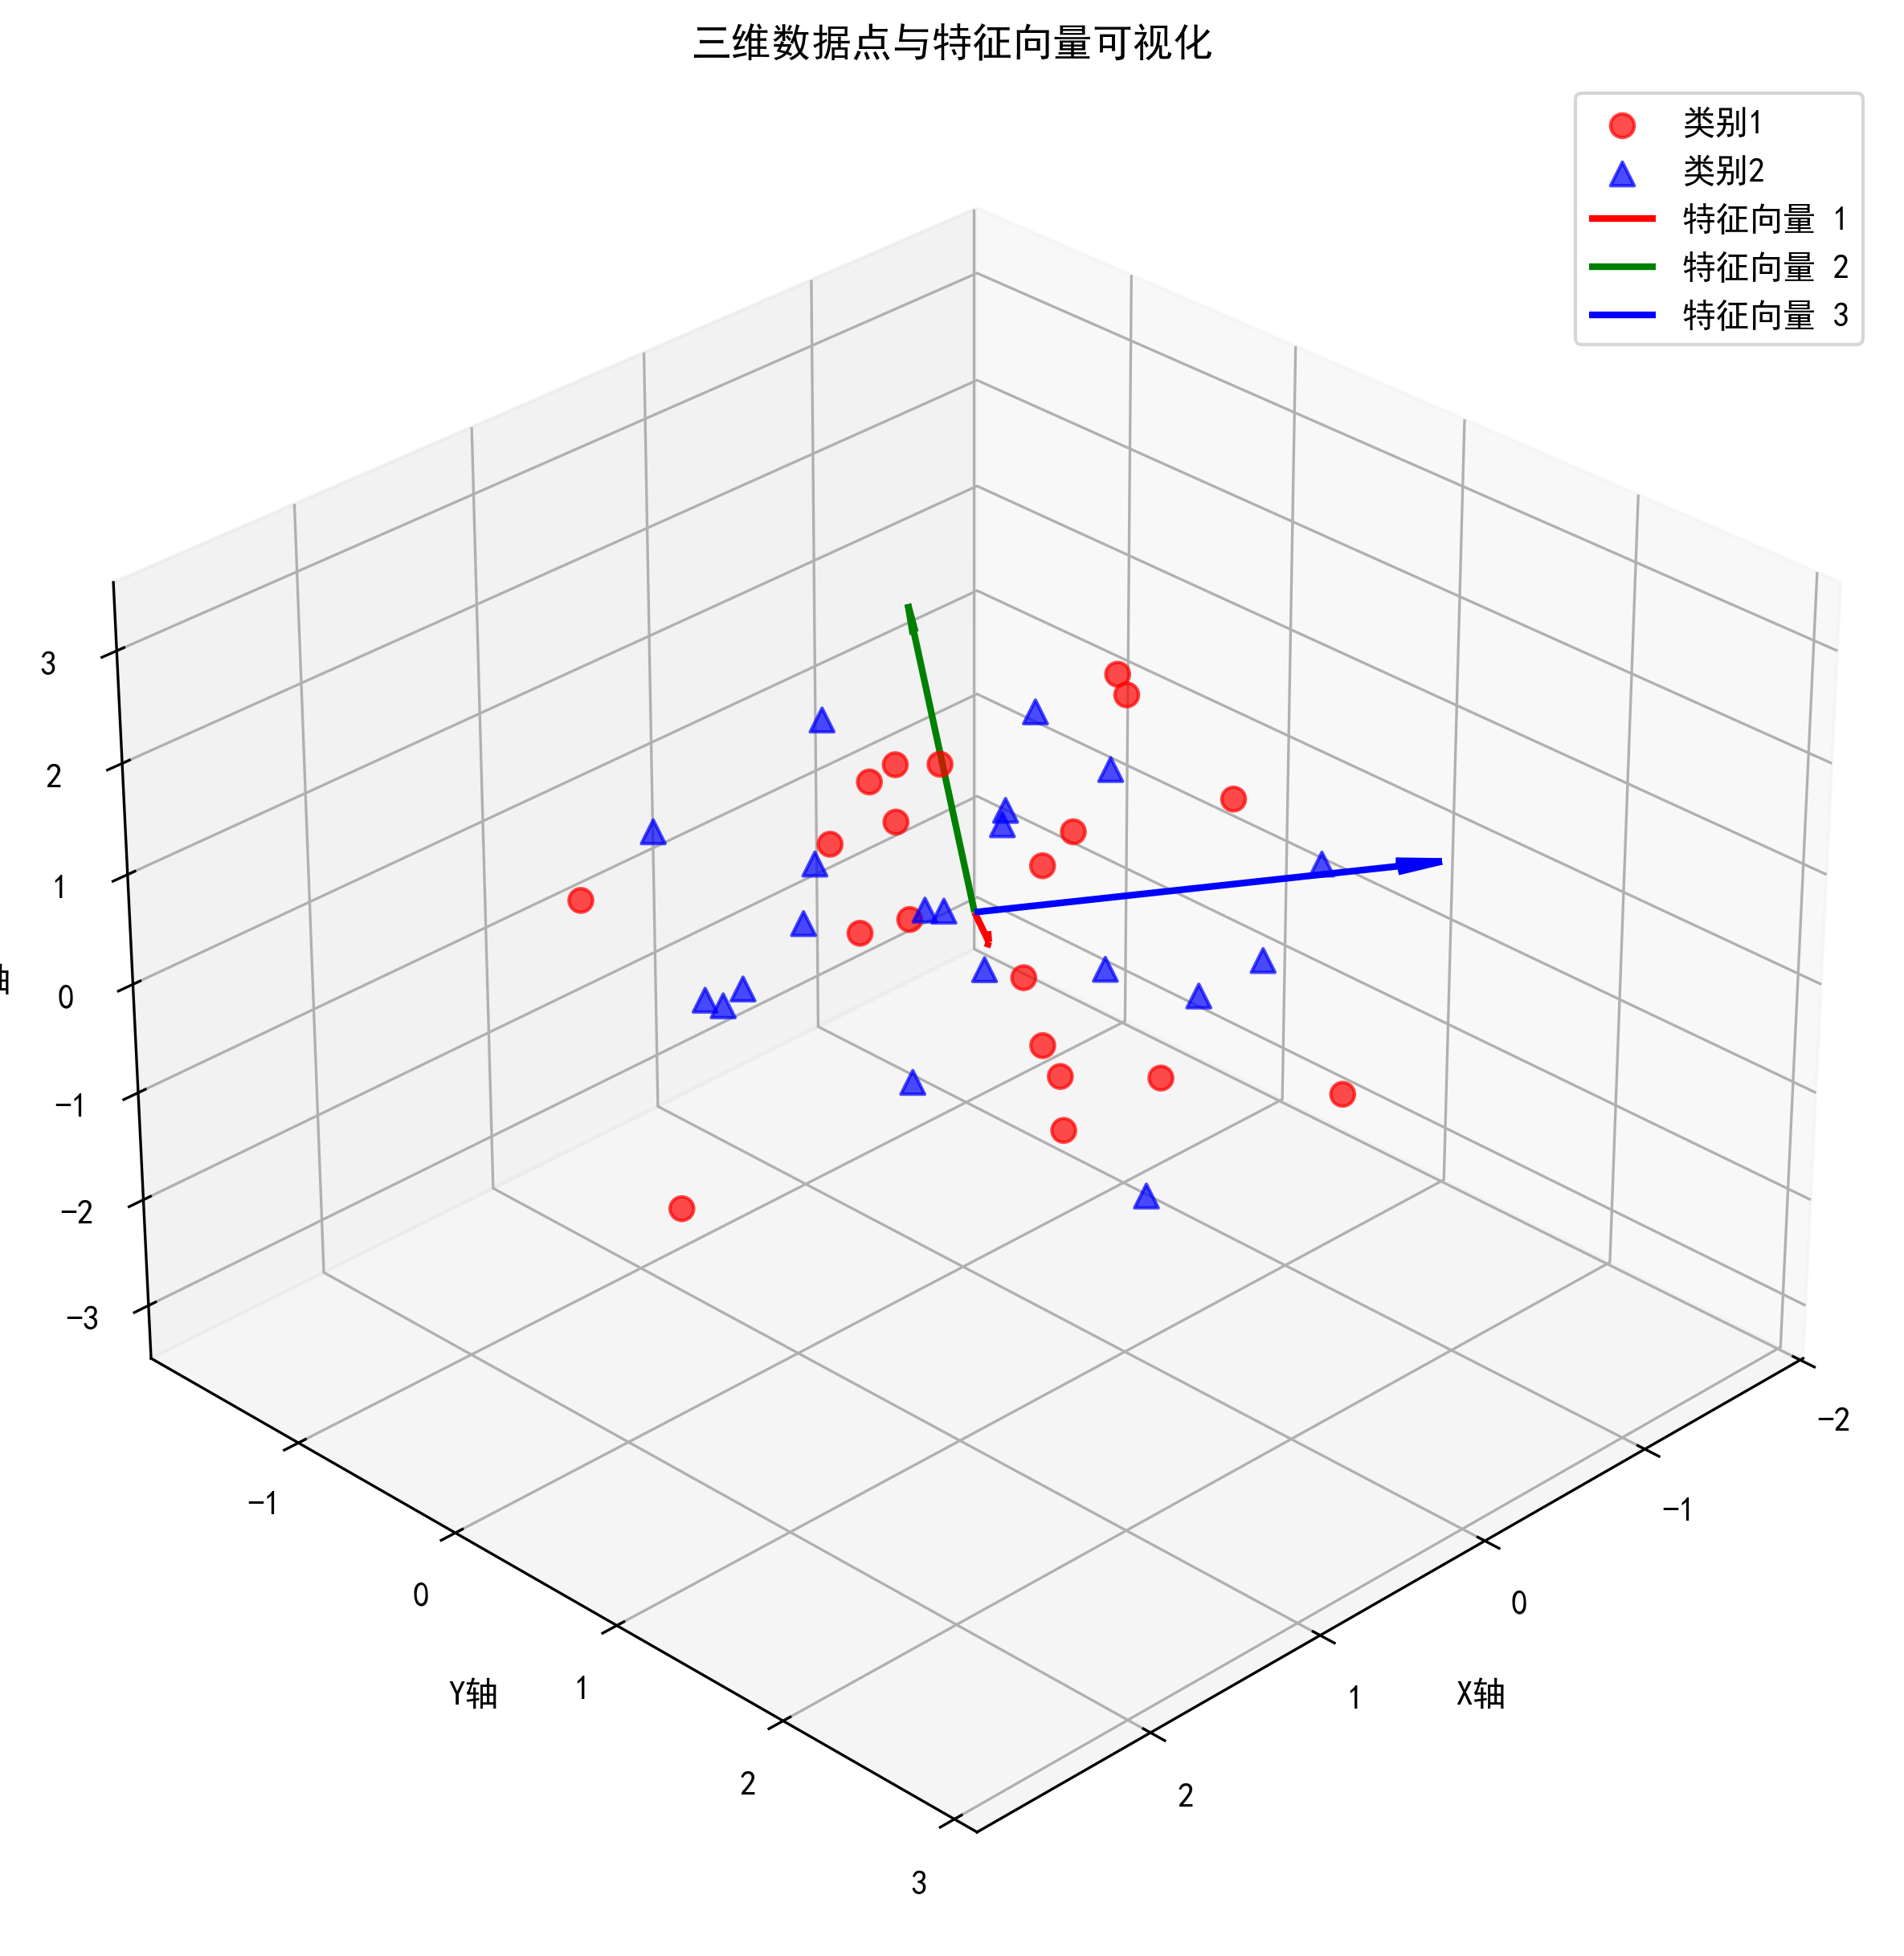
def visualize_3d_data_and_eigenvectors(data, eigenvectors, eigenvalues):
    """
    可视化三维数据和特征向量

    参数:
        data: 三维数据点
        eigenvectors: 特征向量矩阵
        eigenvalues: 特征值数组
    """
    # 创建图形和3D坐标轴
    fig = plt.figure(figsize=(12, 10))
    ax = fig.add_subplot(111, projection='3d')

    # 绘制数据点
    ax.scatter(data[:, 0], data[:, 1], data[:, 2], c='b', marker='o', alpha=0.6, label='原始数据点')

    # 计算数据中心
    mean = np.mean(data, axis=0)

    # 绘制特征向量,长度与特征值的平方根成正比
    scale = np.sqrt(np.max(eigenvalues)) * 2  # 缩放因子,使特征向量可视化更清晰

    for i in range(3):
        # 特征向量的长度与对应特征值的平方根成正比
        vec_length = np.sqrt(eigenvalues[i]) * scale
        vec = eigenvectors[:, i] * vec_length

        # 绘制特征向量(从数据中心出发)
        ax.quiver(mean[0], mean[1], mean[2],
                 vec[0], vec[1], vec[2],
                 color=['r', 'g', 'y'][i],
                 arrow_length_ratio=0.1,
                 linewidth=2,
                 label=f'特征向量 {i+1} (λ={eigenvalues[i]:.2f})')

    # 设置坐标轴标签和标题
    ax.set_xlabel('X轴')
    ax.set_ylabel('Y轴')
    ax.set_zlabel('Z轴')
    ax.set_title('三维数据点与特征向量可视化')

    # 添加图例
    ax.legend()

    # 设置坐标轴范围,使图形更加美观
    max_range = np.max(np.abs(data - mean)) * 1.2
    ax.set_xlim(mean[0] - max_range, mean[0] + max_range)
    ax.set_ylim(mean[1] - max_range, mean[1] + max_range)
    ax.set_zlim(mean[2] - max_range, mean[2] + max_range)

    # 添加网格
    ax.grid(True, alpha=0.3)
3.2 二维投影可视化
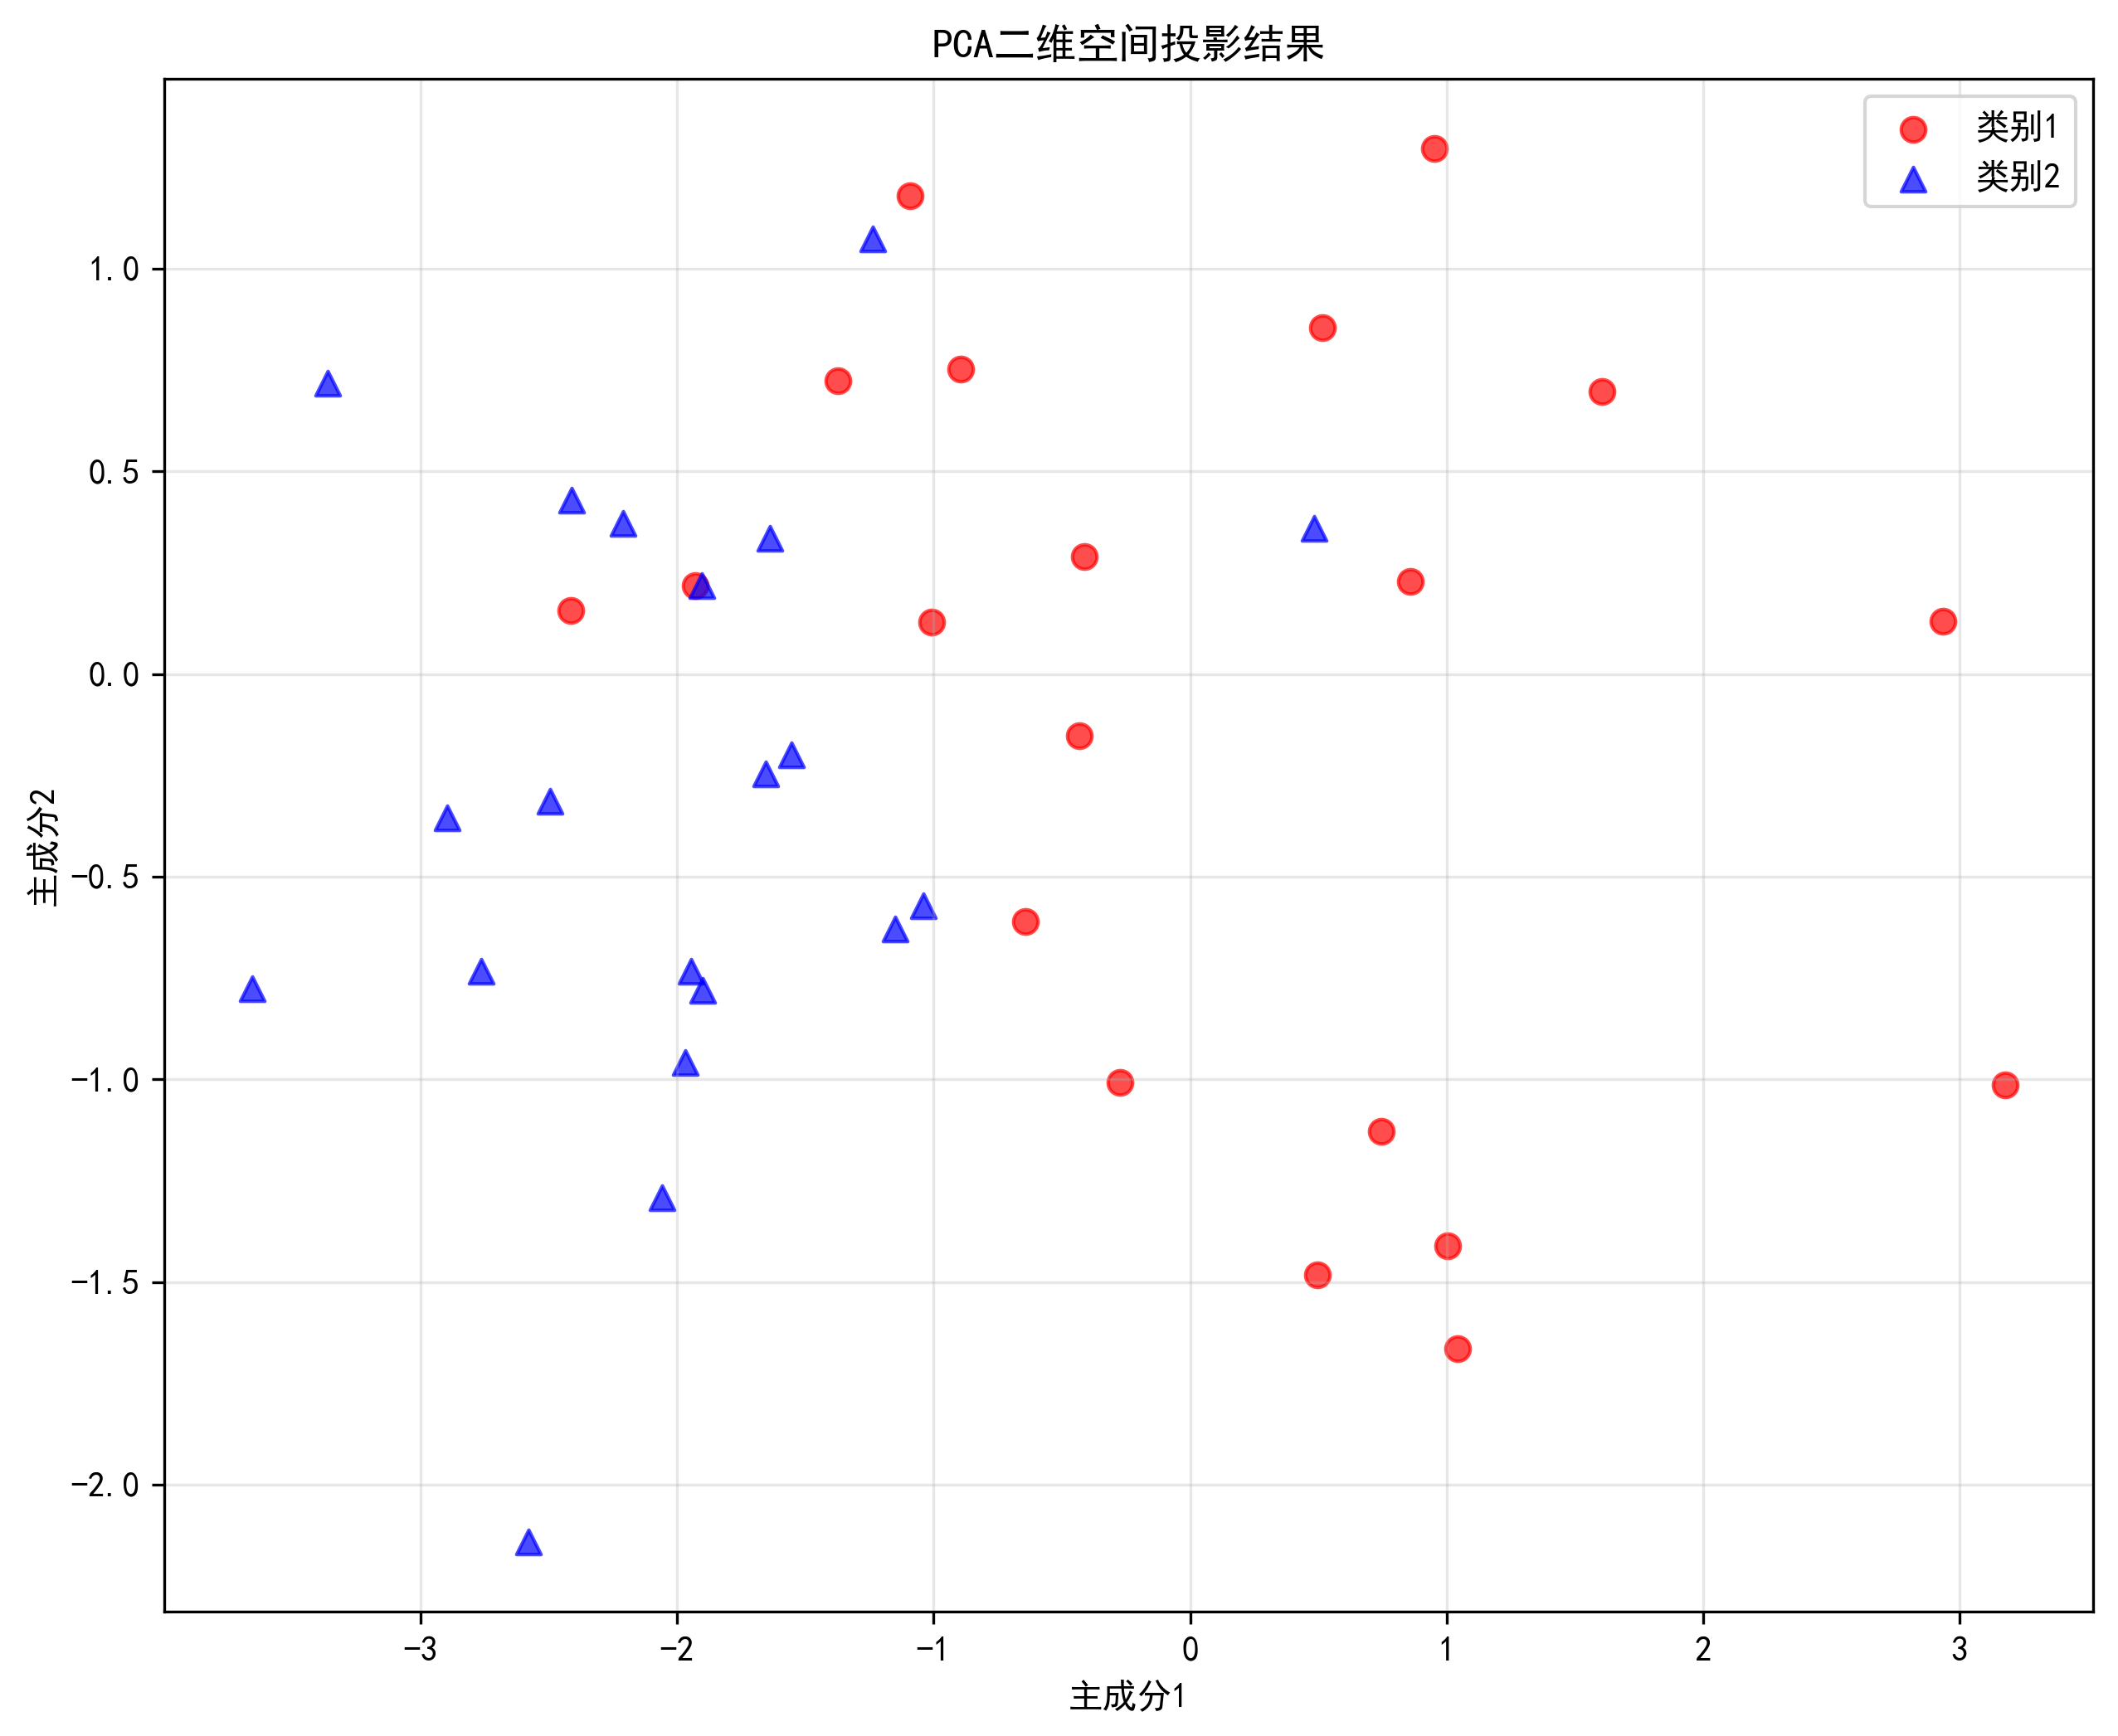
def visualize_2d_projection(reduced_data):
    """
    可视化降维到二维后的数据

    参数:
        reduced_data: 降维后的数据,形状为(n_samples, 2)
    """
    plt.figure(figsize=(10, 8))
    plt.scatter(reduced_data[:, 0], reduced_data[:, 1], c='purple', marker='o', alpha=0.6)
    plt.xlabel('主成分 1')
    plt.ylabel('主成分 2')
    plt.title('PCA降维到二维空间的数据')
    plt.grid(True, alpha=0.3)
3.3 解释方差比例可视化
def explained_variance_ratio(eigenvalues):
    """
    计算各主成分的解释方差比例

    参数:
        eigenvalues: 特征值数组

    返回:
        解释方差比例数组
    """
    total_variance = np.sum(eigenvalues)
    return eigenvalues / total_variance

def plot_explained_variance(evr):
    """
    绘制解释方差比例条形图

    参数:
        evr: 解释方差比例数组
    """
    plt.figure(figsize=(10, 6))
    plt.bar(['主成分 1', '主成分 2', '主成分 3'], evr, color=['r', 'g', 'b'])
    plt.xlabel('主成分')
    plt.ylabel('解释方差比例')
    plt.title('各主成分的解释方差比例')
    plt.ylim(0, 1)

    # 在柱状图上显示数值
    for i, v in enumerate(evr):
        plt.text(i, v + 0.02, f'{v:.3f}', ha='center')
4. 主函数实现
最后,我们编写主函数,将上述功能整合在一起:
def main():
    """
    主函数,实现三维PCA降维的完整流程
    """
    # 生成三维随机数据
    data = generate_3d_data(n_points=100)
    print(f"生成了{data.shape[0]}个三维数据点")

    # 1. 计算平均向量
    mean_vector = compute_mean_vector(data)
    print("\n1. 三个维度的平均向量:")
    print(mean_vector)

    # 2. 计算散度矩阵
    scatter_matrix = compute_scatter_matrix(data, mean_vector)
    print("\n2. 三个维度的散度矩阵:")
    print(scatter_matrix)

    # 3. 计算特征值和特征向量
    eigenvalues, eigenvectors = compute_eigenvalues_eigenvectors(scatter_matrix)
    print("\n3. 三个维度的特征值:")
    print(eigenvalues)
    print("\n三个维度的特征向量:")
    for i, vec in enumerate(eigenvectors.T):
        print(f"特征向量 {i+1}: {vec}")

    # 计算解释方差比例
    evr = explained_variance_ratio(eigenvalues)
    print("\n解释方差比例:")
    for i, ratio in enumerate(evr):
        print(f"主成分 {i+1}: {ratio:.4f}")

    # 4. 三维特征向量的可视化和二维投影可视化
    visualize_3d_data_and_eigenvectors(data, eigenvectors, eigenvalues)
    # 保存三维数据与特征向量图
    plt.savefig('../图片/三维数据与特征向量.png', dpi=300, bbox_inches='tight')

    # 使用PCA将数据降维到二维
    reduced_data = pca_dimension_reduction(data, eigenvectors, n_components=2)
    print(f"\n数据降维后形状: {reduced_data.shape}")

    # 可视化降维结果
    visualize_2d_projection(reduced_data)
    # 保存PCA二维投影图
    plt.savefig('../图片/PCA二维投影.png', dpi=300, bbox_inches='tight')

    # 绘制解释方差比例图
    plot_explained_variance(evr)
    # 保存解释方差比例图
    plt.savefig('../图片/解释方差比例.png', dpi=300, bbox_inches='tight')

    # 显示所有图形
    plt.tight_layout()
    plt.show()

if __name__ == "__main__":
    main()
二、二元线性回归预测身高实现
接下来,我们实现一个基于足长和步幅预测身高的二元线性回归模型。这个项目展示了如何使用线性回归进行预测分析,并评估模型的性能。
1. 数据加载
首先,我们需要从Excel文件中加载数据集:
import pandas as pd

def load_data(file_path):
    """
    从Excel文件加载数据集

    参数:
        file_path: Excel文件路径

    返回:
        X: 自变量矩阵 (足长, 步幅)
        y: 因变量向量 (身高)
        df: 原始数据框
    """
    # 读取Excel文件
    df = pd.read_excel(file_path)

    # 提取自变量和因变量
    X = df[['足长', '步幅']].values
    y = df['身高'].values

    return X, y, df
2. 构建线性回归模型
使用scikit-learn库构建和训练二元线性回归模型:
from sklearn.linear_model import LinearRegression

def build_linear_regression_model(X, y):
    """
    构建二元线性回归模型

    参数:
        X: 自变量矩阵
        y: 因变量向量

    返回:
        model: 训练好的线性回归模型
        y_pred: 预测值
        coefficients: 模型系数
        intercept: 截距
    """
    # 创建并训练线性回归模型
    model = LinearRegression()
    model.fit(X, y)

    # 预测
    y_pred = model.predict(X)

    # 获取模型参数
    coefficients = model.coef_
    intercept = model.intercept_

    return model, y_pred, coefficients, intercept
3. 模型评估
使用多种指标评估模型的拟合程度:
from sklearn.metrics import r2_score, mean_squared_error
import numpy as np

def evaluate_model(y_true, y_pred):
    """
    评估模型的拟合程度

    参数:
        y_true: 真实值
        y_pred: 预测值

    返回:
        metrics: 包含评估指标的字典
    """
    # 计算R²值
    r2 = r2_score(y_true, y_pred)

    # 计算均方误差
    mse = mean_squared_error(y_true, y_pred)

    # 计算均方根误差
    rmse = np.sqrt(mse)

    # 计算平均绝对误差
    mae = np.mean(np.abs(y_true - y_pred))

    metrics = {
        'R²': r2,
        'MSE': mse,
        'RMSE': rmse,
        'MAE': mae
    }

    return metrics
4. 可视化结果
为了直观地展示模型的效果,我们实现了几个可视化函数:
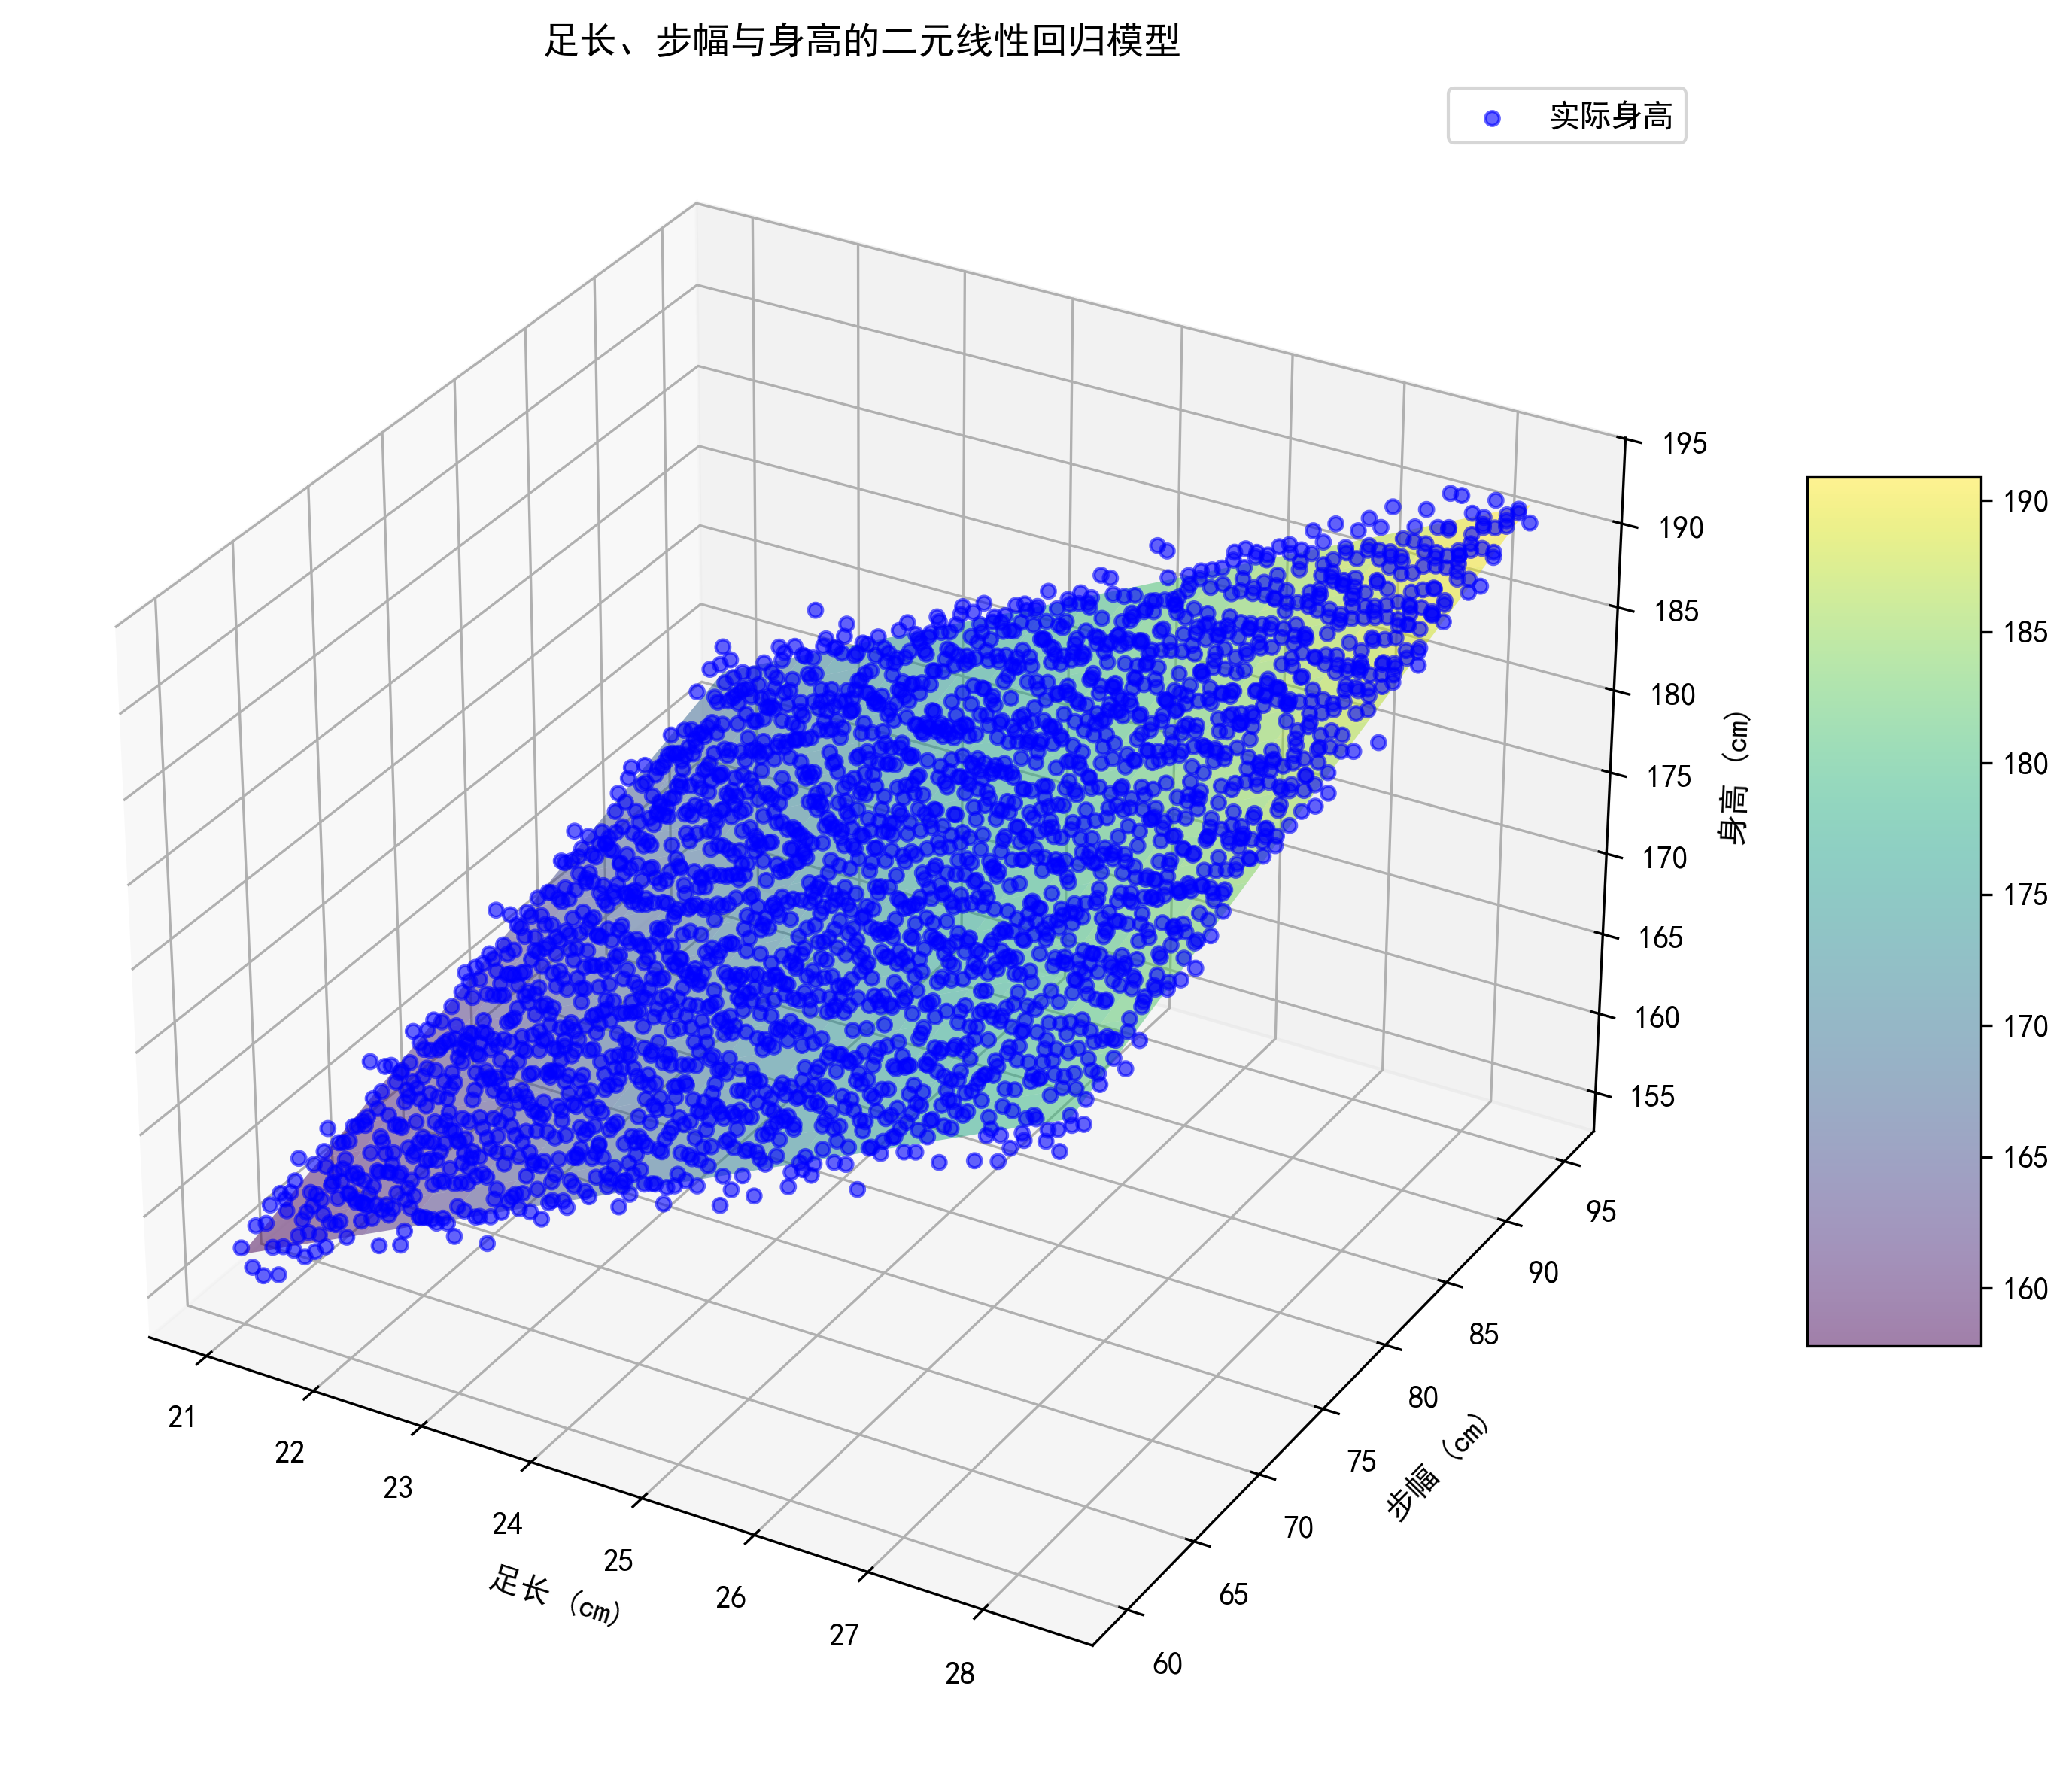
4.1 三维散点图和回归平面可视化
def visualize_3d_scatter_and_plane(X, y, y_pred):
    """
    可视化三维散点图和回归平面

    参数:
        X: 自变量矩阵
        y: 真实值
        y_pred: 预测值
    """
    # 创建图形和3D坐标轴
    fig = plt.figure(figsize=(12, 10))
    ax = fig.add_subplot(111, projection='3d')

    # 绘制原始数据散点图
    scatter = ax.scatter(X[:, 0], X[:, 1], y, c='b', marker='o', alpha=0.6, label='实际身高')

    # 为了绘制平面,我们需要创建网格
    # 取足长和步幅的最小值和最大值
    x1_min, x1_max = X[:, 0].min(), X[:, 0].max()
    x2_min, x2_max = X[:, 1].min(), X[:, 1].max()

    # 创建网格
    x1_grid, x2_grid = np.meshgrid(
        np.linspace(x1_min, x1_max, 20),
        np.linspace(x2_min, x2_max, 20)
    )

    # 为了预测网格点上的值,我们需要重塑网格
    grid_points = np.column_stack((x1_grid.ravel(), x2_grid.ravel()))

    # 创建新的线性回归模型来获取平面方程
    model = LinearRegression()
    model.fit(X, y)

    # 预测网格点上的值
    y_grid = model.predict(grid_points).reshape(x1_grid.shape)

    # 绘制回归平面
    surf = ax.plot_surface(x1_grid, x2_grid, y_grid, cmap='viridis', alpha=0.5)

    # 设置坐标轴标签和标题
    ax.set_xlabel('足长 (cm)')
    ax.set_ylabel('步幅 (cm)')
    ax.set_zlabel('身高 (cm)')
    ax.set_title('足长、步幅与身高的二元线性回归模型')

    # 添加颜色条和图例
    fig.colorbar(surf, ax=ax, shrink=0.5, aspect=5)
    ax.legend()
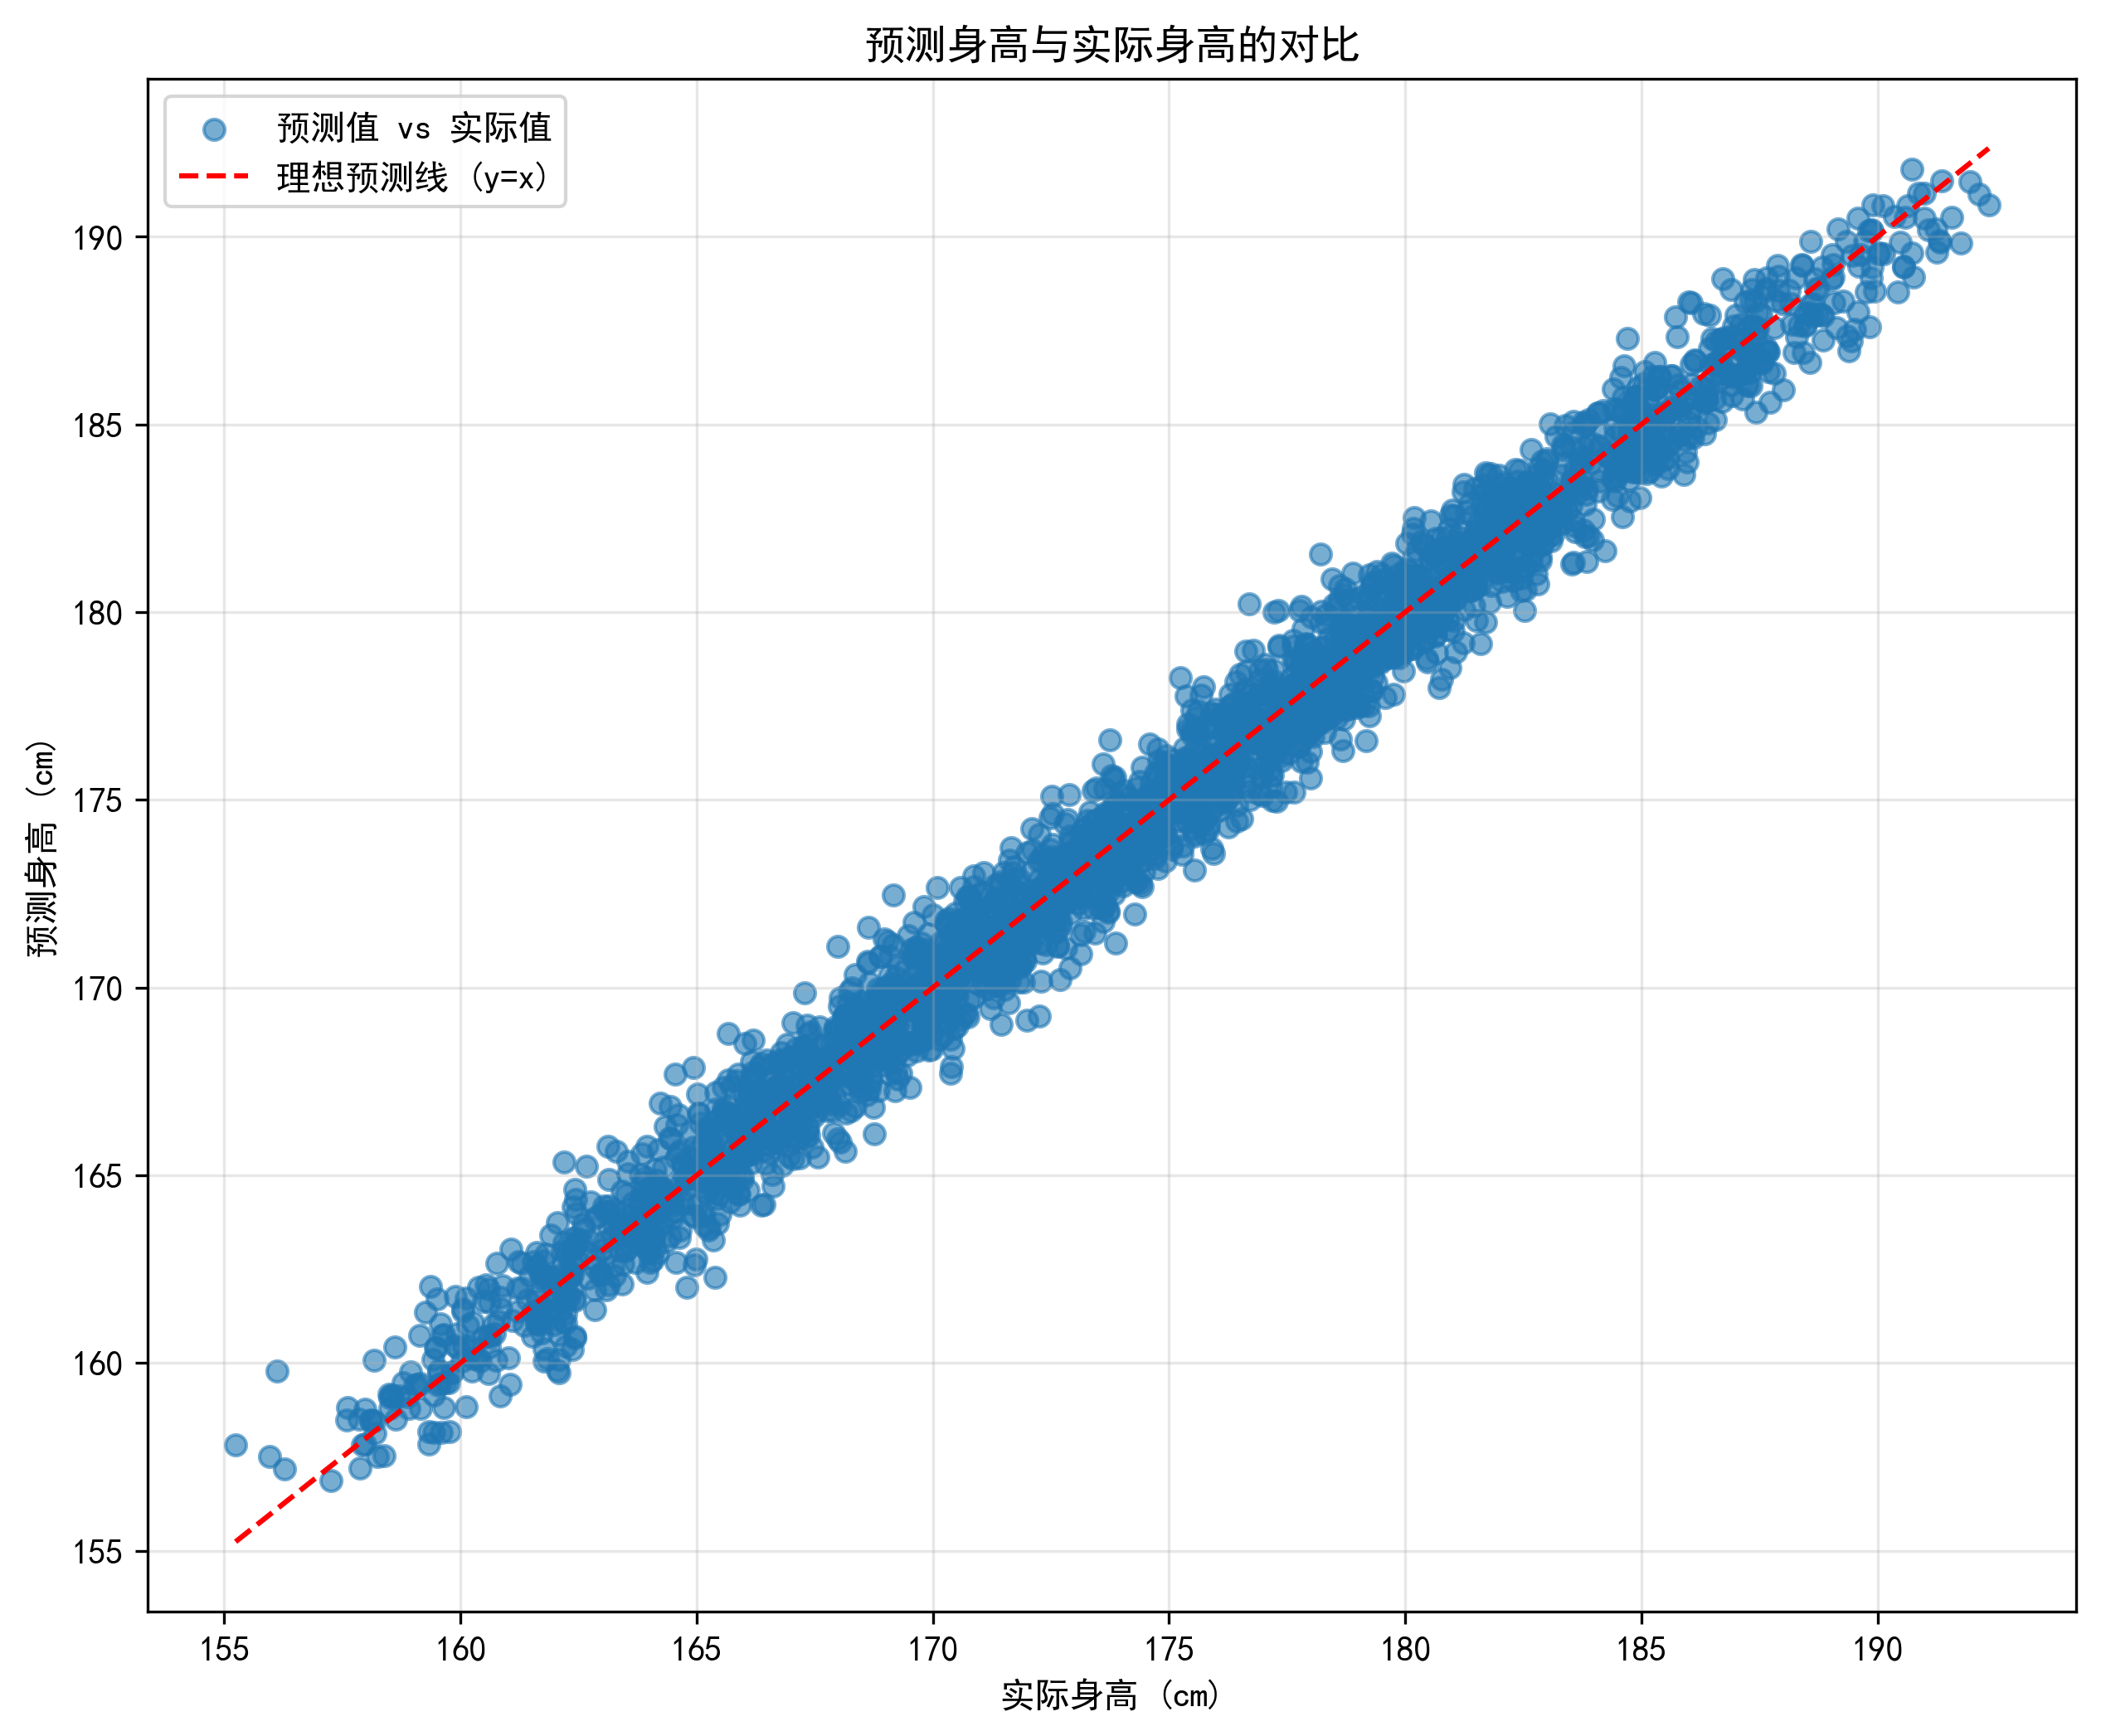
4.2 预测值与实际值对比可视化
def visualize_prediction_vs_actual(y_true, y_pred):
    """
    可视化预测值与实际值的对比

    参数:
        y_true: 实际值
        y_pred: 预测值
    """
    plt.figure(figsize=(10, 8))

    # 绘制预测值与实际值的散点图
    plt.scatter(y_true, y_pred, alpha=0.6, label='预测值 vs 实际值')

    # 绘制理想的预测线(y=x)
    min_val = min(y_true.min(), y_pred.min())
    max_val = max(y_true.max(), y_pred.max())
    plt.plot([min_val, max_val], [min_val, max_val], 'r--', label='理想预测线 (y=x)')

    # 设置坐标轴标签和标题
    plt.xlabel('实际身高 (cm)')
    plt.ylabel('预测身高 (cm)')
    plt.title('预测身高与实际身高的对比')
    plt.legend()
    plt.grid(True, alpha=0.3)
4.3 残差分布可视化
def visualize_residuals(y_true, y_pred):
    """
    可视化残差分布

    参数:
        y_true: 实际值
        y_pred: 预测值
    """
    # 计算残差
    residuals = y_true - y_pred

    plt.figure(figsize=(10, 8))

    # 绘制残差直方图
    plt.hist(residuals, bins=30, alpha=0.7, color='skyblue', edgecolor='black')
    plt.axvline(x=0, color='r', linestyle='--', linewidth=2, label='残差为0')

    # 设置坐标轴标签和标题
    plt.xlabel('残差 (cm)')
    plt.ylabel('频数')
    plt.title('残差分布图')
    plt.legend()
    plt.grid(True, alpha=0.3)
4.4 特征重要性分析与可视化
def feature_importance(coef, feature_names):
    """
    分析特征重要性

    参数:
        coef: 模型系数
        feature_names: 特征名称列表
    """
    # 计算系数的绝对值作为重要性的度量
    importance = np.abs(coef)

    # 归一化重要性
    importance = importance / np.sum(importance)

    # 创建特征重要性的DataFrame
    importance_df = pd.DataFrame({
        '特征': feature_names,
        '系数': coef,
        '重要性': importance
    }).sort_values('重要性', ascending=False)

    return importance_df

def plot_feature_importance(importance_df):
    """
    可视化特征重要性

    参数:
        importance_df: 包含特征重要性的DataFrame
    """
    plt.figure(figsize=(10, 6))

    # 绘制特征重要性条形图
    plt.bar(importance_df['特征'], importance_df['重要性'], color='lightgreen')

    # 在条形图上显示数值
    for i, v in enumerate(importance_df['重要性']):
        plt.text(i, v + 0.02, f'{v:.3f}', ha='center')

    # 设置坐标轴标签和标题
    plt.xlabel('特征')
    plt.ylabel('重要性')
    plt.title('特征重要性分析')
    plt.ylim(0, 1.1)
    plt.grid(True, alpha=0.3, axis='y')
5. 主函数实现
最后,我们编写主函数,将上述功能整合在一起:
def main():
    """
    主函数,实现二元线性回归预测身高的完整流程
    """
    # 加载数据
    file_path = r'e:\001.xlsx'
    X, y, df = load_data(file_path)

    print(f"数据集加载完成,共有{len(df)}个样本")
    print("\n数据集前5行:")
    print(df.head())

    # 构建线性回归模型
    model, y_pred, coefficients, intercept = build_linear_regression_model(X, y)

    # 输出回归方程
    print(f"\n回归方程: 身高 = {intercept:.4f} + {coefficients[0]:.4f}*足长 + {coefficients[1]:.4f}*步幅")

    # 评估模型
    metrics = evaluate_model(y, y_pred)
    print("\n模型评估指标:")
    for metric_name, metric_value in metrics.items():
        print(f"{metric_name}: {metric_value:.4f}")

    # 特征重要性分析
    feature_names = ['足长', '步幅']
    importance_df = feature_importance(coefficients, feature_names)
    print("\n特征重要性分析:")
    print(importance_df)

    # 可视化结果
    # 1. 三维散点图和回归平面
    visualize_3d_scatter_and_plane(X, y, y_pred)
    # 保存三维散点图和回归平面图
    plt.savefig('../图片/二元线性回归三维图.png', dpi=300, bbox_inches='tight')

    # 2. 预测值与实际值对比
    visualize_prediction_vs_actual(y, y_pred)
    # 保存预测值与实际值对比图
    plt.savefig('../图片/预测值与实际值对比.png', dpi=300, bbox_inches='tight')

    # 3. 残差分布
    visualize_residuals(y, y_pred)
    # 保存残差分布图
    plt.savefig('../图片/残差分布.png', dpi=300, bbox_inches='tight')

    # 4. 特征重要性
    plot_feature_importance(importance_df)
    # 保存特征重要性图
    plt.savefig('../图片/特征重要性.png', dpi=300, bbox_inches='tight')

    # 显示所有图形
    plt.tight_layout()
    plt.show()

if __name__ == "__main__":
    main()
三、批量生成图片的批处理脚本
为了方便使用,我们创建了一个批处理脚本,可以一键运行所有Python文件并生成相关图片:
@echo off


REM 运行三维PCA降维.py生成相关图片
python "e:\代码\三维PCA降维.py"
echo 三维PCA降维图片生成完成!

REM 运行二元线性回归预测身高.py生成相关图片
python "e:\代码\二元线性回归预测身高.py"
echo 二元线性回归图片生成完成!

REM 提示用户图片生成完毕
pause
四、项目总结
本文详细介绍了两个机器学习数据分析项目的实现过程:
-
三维PCA降维项目:通过实现PCA算法的核心步骤,包括计算平均向量、散度矩阵、特征值和特征向量,展示了如何将三维数据降维到二维空间,并通过可视化直观地展示降维效果。
-
二元线性回归预测身高项目:通过构建以足长和步幅为自变量、身高为因变量的二元线性回归模型,展示了如何使用线性回归进行预测分析,并通过多种指标评估模型的性能。同时,通过可视化直观地展示了模型的预测效果和特征重要性。
这两个项目不仅展示了机器学习算法的实现过程,还通过可视化技术帮助我们更好地理解数据和模型。通过批处理脚本,我们可以方便地一键运行所有代码并生成相关图片,提高了工作效率。
通过这些项目的学习和实践,我们可以更好地理解和应用机器学习技术,为实际问题提供数据分析和预测解决方案。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 30
 0
- 0


 已为社区贡献4条内容

所有评论(0)