章节五:配置/启动hadoop/操作hadoop(CentOS8)
·
下载 Hadoop
我这里用的是阿里的
https://mirrors.aliyun.com/apache/hadoop/common/hadoop-3.3.5/?spm=a2c6h.25603864.0.0.433f3a2cW0X2uU
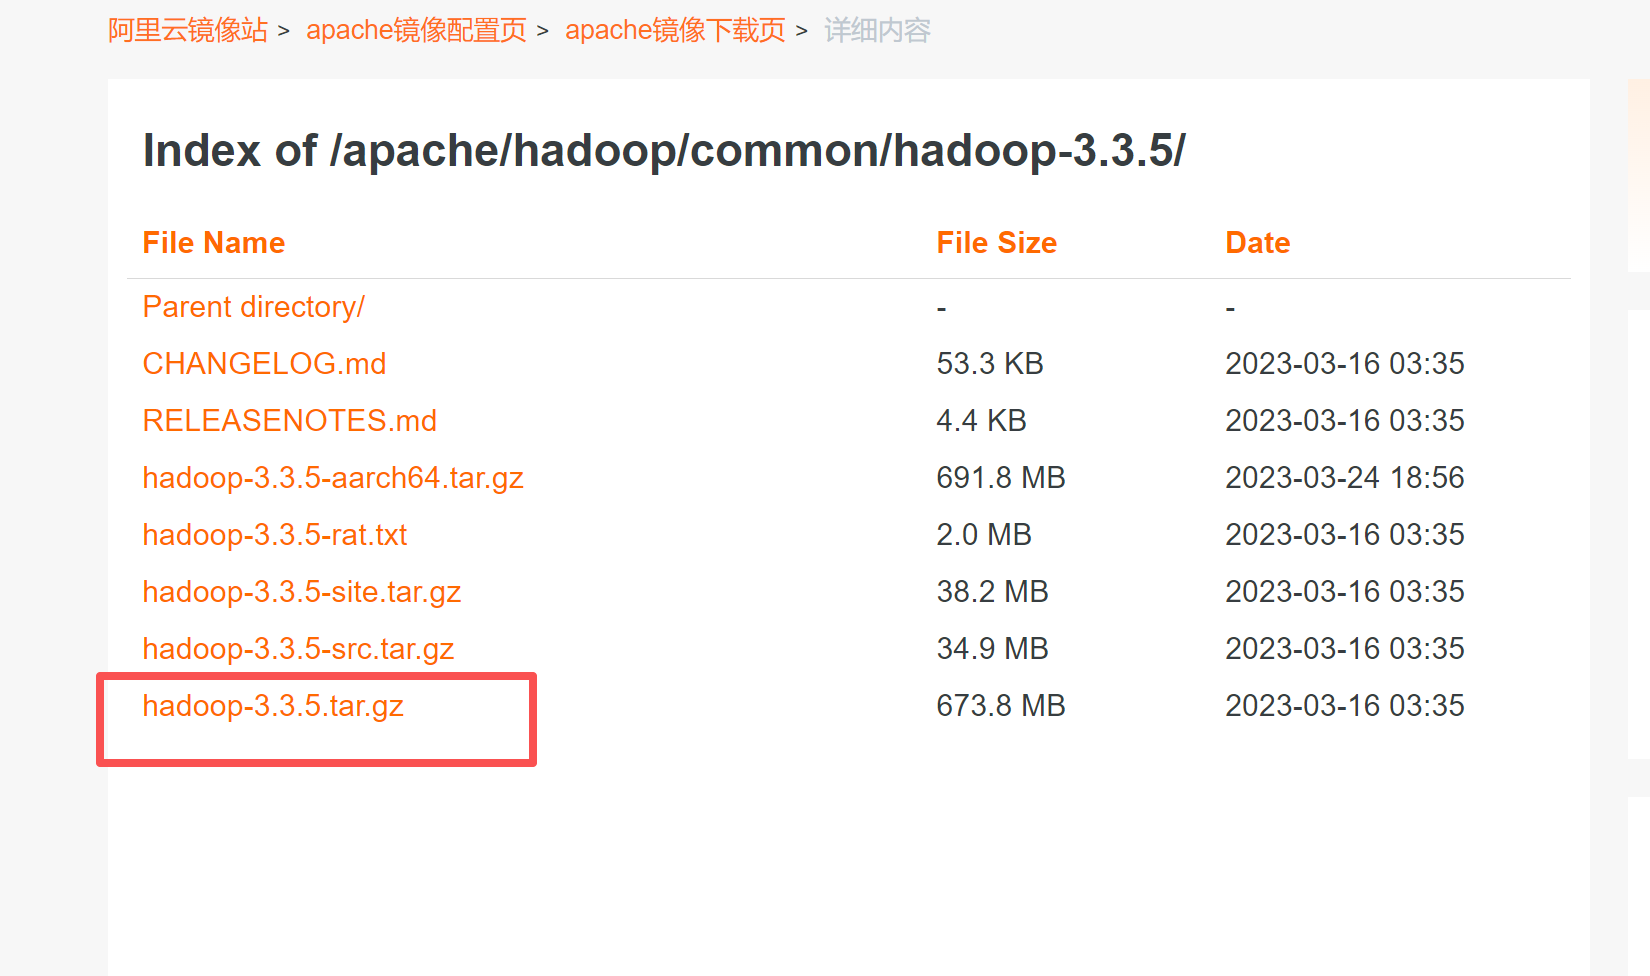
这样就下好了
然后传输到虚拟机(之前博客里有教程)
我这里已经传输到虚拟机里了
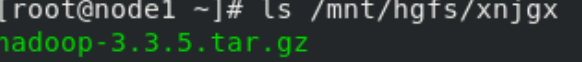
解压 Hadoop 文件
切换到 /opt 目录并解压文件
cd /opt
tar -xzf hadoop-3.3.5.tar.gz
解压后,您会得到一个名为 hadoop-3.3.5 的目录。将此目录移动到 /opt/hadoop
mv hadoop-3.3.5 /opt/hadoop设置环境变量
编辑 ~/.bashrc 文件
nano ~/.bashrc这两行是添加到文件的末尾
export HADOOP_HOME=/opt/hadoop
export PATH=$PATH:$HADOOP_HOME/bin:$HADOP_HOME/sbin
保存文件并退出编辑器。然后,重新加载 .bashrc 文件:
source ~/.bashrc再次检查 $HADOOP_HOME 和 $PATH:
echo $HADOOP_HOME
echo $PATH
这样算成功

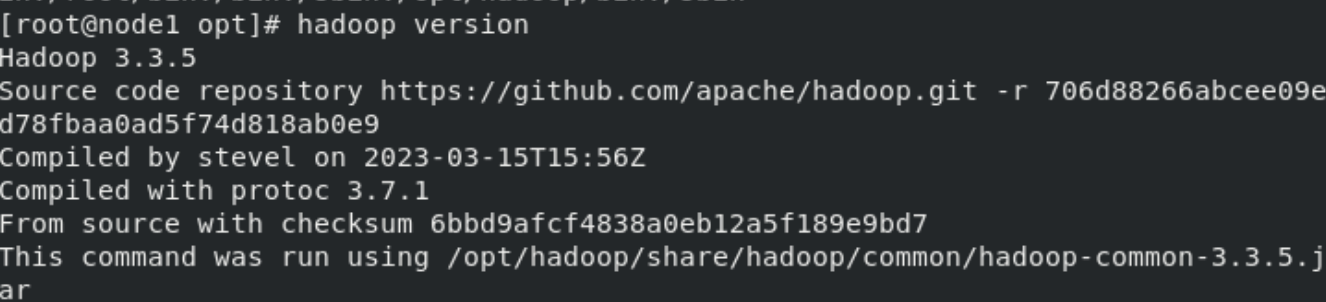
验证 Hadoop
hadoop version结果
启动
格式化 HDFS(仅首次启动时需要)
hdfs namenode -format启动 Hadoop 守护进程
source ~/.bashrc
# 若仍报错,直接全路径
/opt/hadoop/sbin/start-dfs.sh
# 1 确保变量在
export HDFS_NAMENODE_USER=root
export HDFS_DATANODE_USER=root
export HDFS_SECONDARYNAMENODE_USER=root
export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root
# 2 启 HDFS
/opt/hadoop/sbin/start-dfs.sh
# 3 启 YARN
/opt/hadoop/sbin/start-yarn.sh
# 4 启动 NameNode
/opt/hadoop/sbin/hadoop-daemon.sh start namenode
# 5 启动 SecondaryNameNode
/opt/hadoop/sbin/hadoop-daemon.sh start secondarynamenode
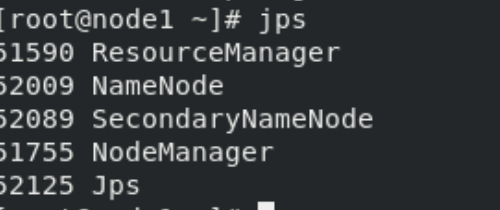
# 6 验证
jps结果
操作
上传文件 + 运行官方示例
# 1. 造测试数据
hdfs dfs -mkdir -p /user/root/input
hdfs dfs -put /etc/hosts /user/root/input/

# 2. 运行 WordCount
hadoop jar /opt/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.5.jar \
        wordcount /user/root/input /user/root/output

# 3. 查看结果
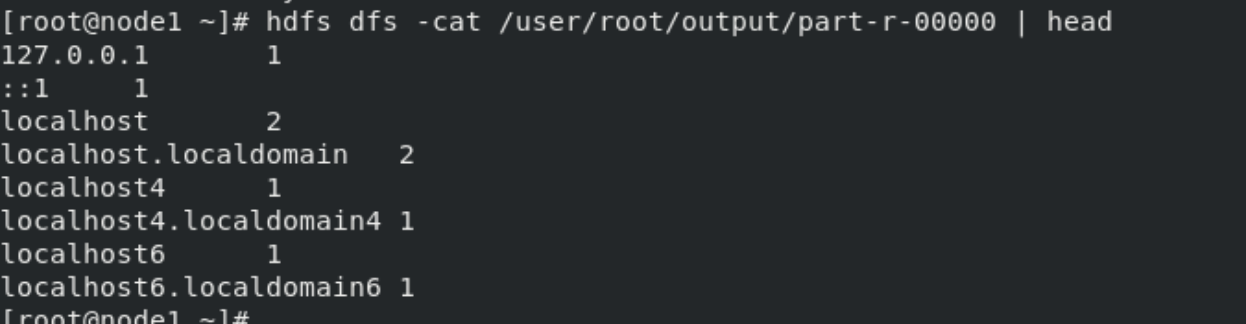
hdfs dfs -cat /user/root/output/part-r-00000 | head
结果
HDFS NameNode界面: http://192.168.24.11:9870
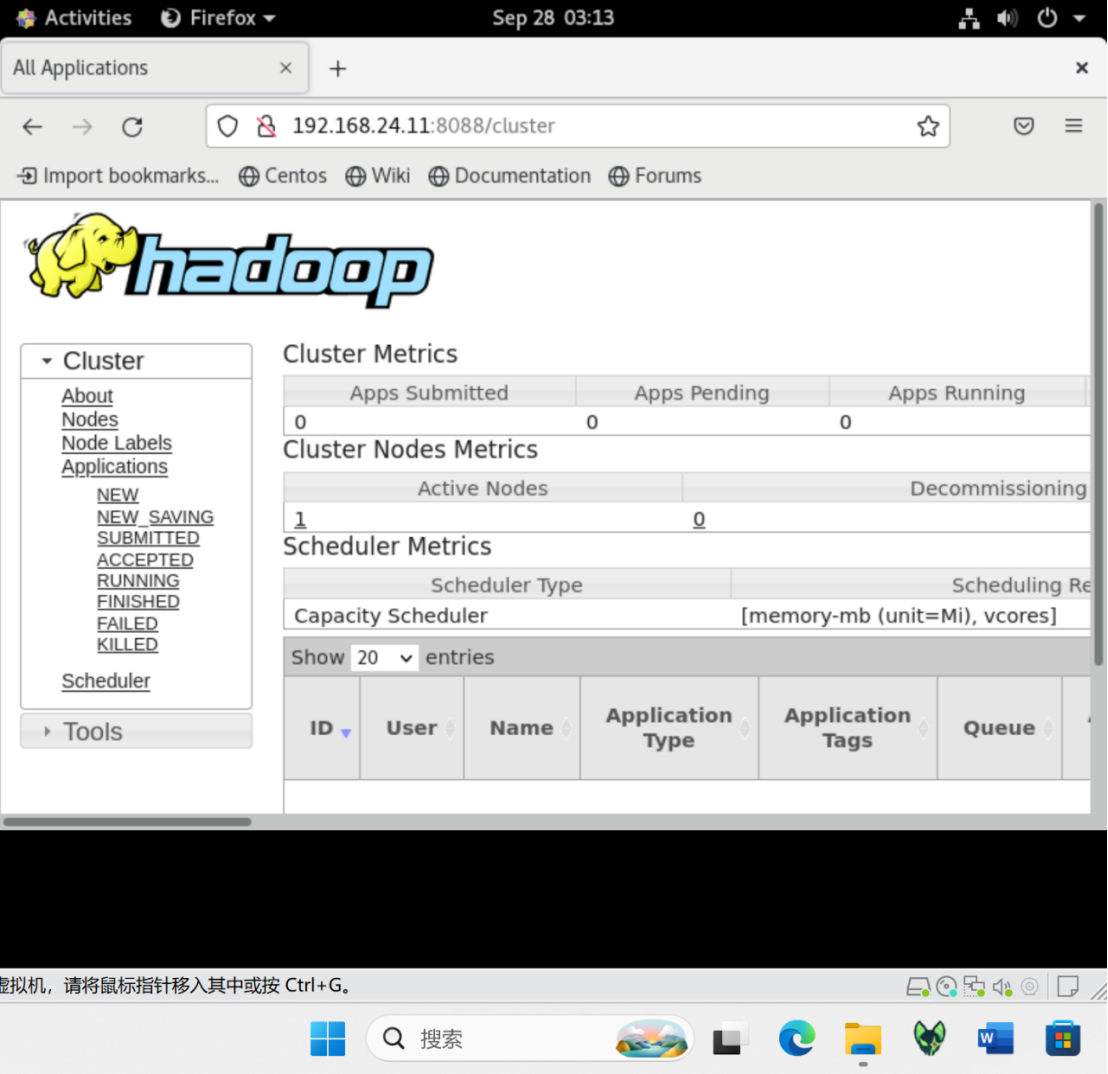
YARN ResourceManager界面: http://192.168.24.11:8088
Web界面截图

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)