Hadoop是啥
·
学习视频:https://www.bilibili.com/video/BV14CTLz9EEj?t=494.0
Hadoop是一个开源的分布式计算框架,主要用于处理和存储大规模数据集(通常是TB级甚至PB级数据)。它最初由Apache基金会开发,灵感来源于Google的三篇论文(GFS、MapReduce和BigTable),旨在解决海量数据的存储和计算难题。
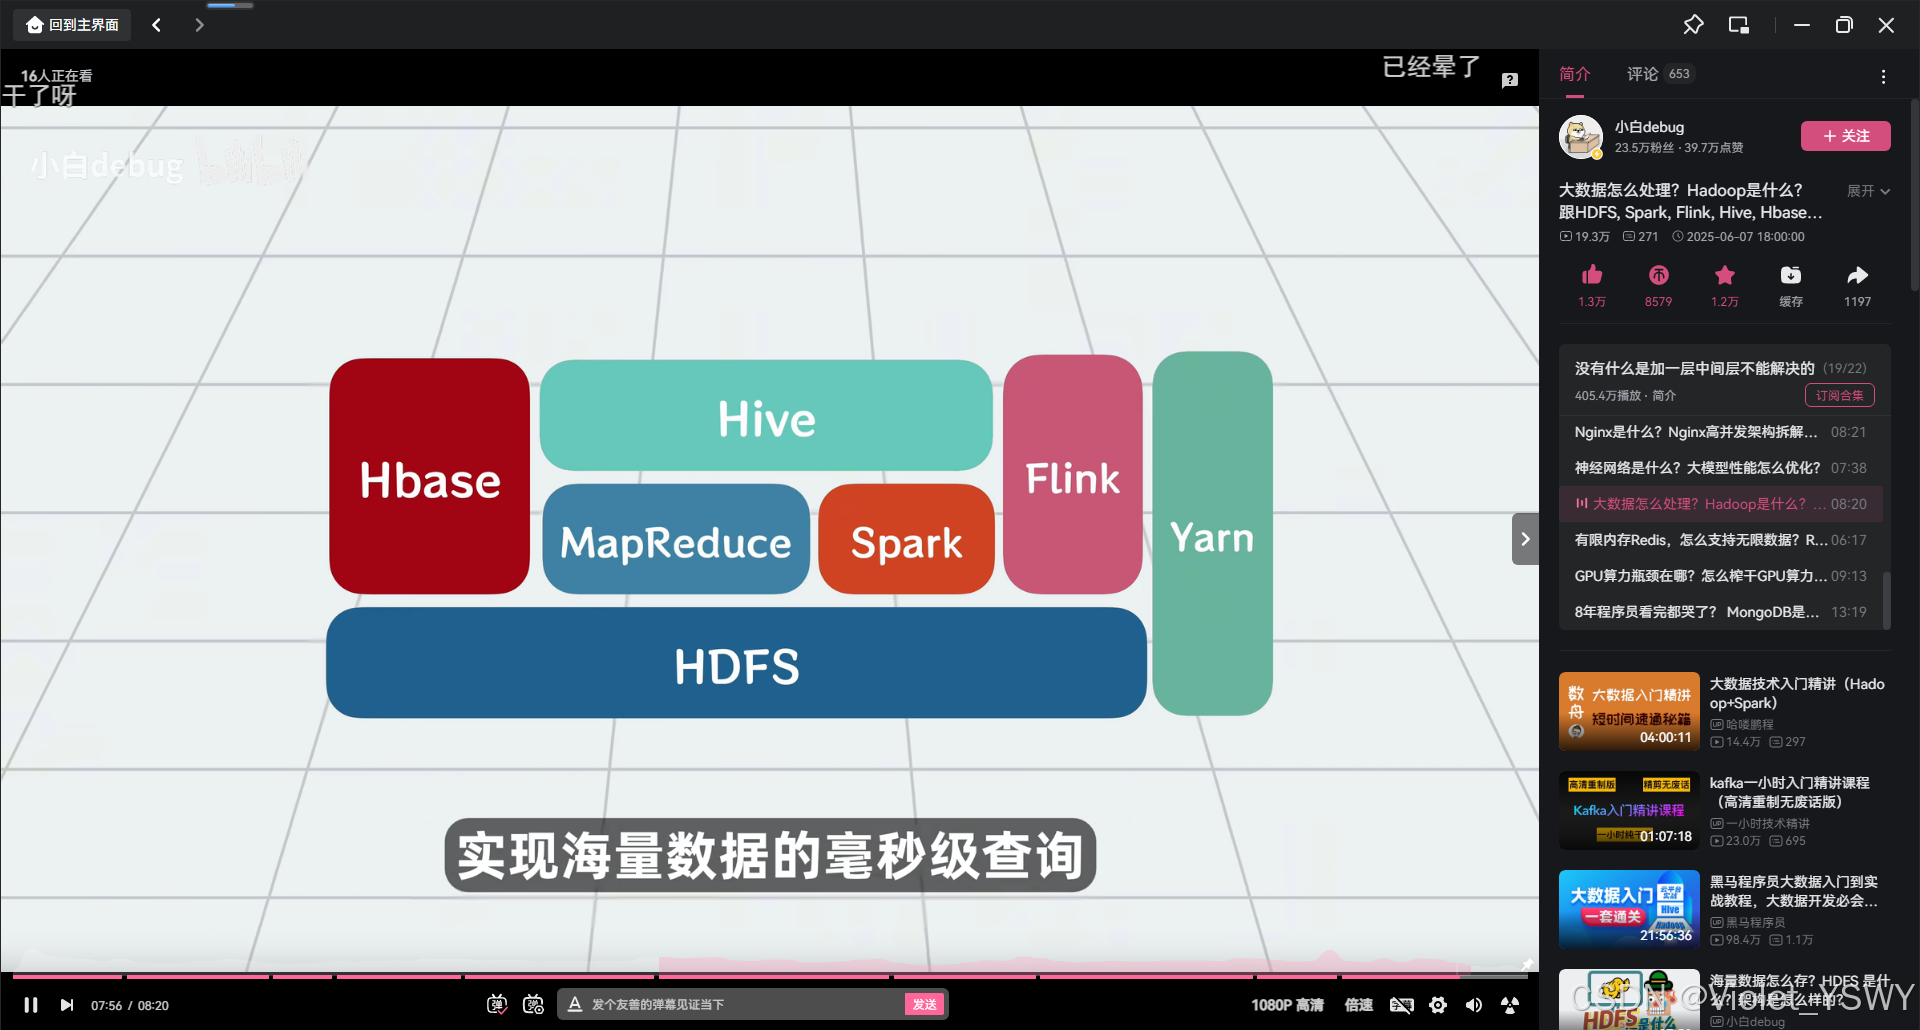
Hadoop的核心组件包括:
- HDFS(Hadoop分布式文件系统):负责将大文件分割成小块,分布式存储在多个服务器上,提供高容错性和高吞吐量的数据访问。
- MapReduce:一种分布式计算模型,将复杂任务分解为"Map(映射)"和"Reduce(归约)"两个阶段,并行处理大量数据。
- YARN(Yet Another Resource Negotiator):资源管理系统,负责分配计算资源(如CPU、内存)给各种应用程序,并协调任务的执行。
此外,Hadoop生态系统还包含许多配套工具,如:
- Hive:基于Hadoop的数据仓库工具,支持类SQL查询
- Pig:用于数据分析的高级脚本语言
- Spark:比MapReduce更快的内存计算框架(常与Hadoop配合使用)
- HBase:分布式非关系型数据库,适合实时读写大量数据
- ZooKeeper:提供分布式协调服务,如集群管理、配置维护等
Hadoop的优势在于:
- 高扩展性:可通过增加服务器节点轻松扩展集群规模
- 高容错性:数据自动备份到多个节点,某节点故障不影响整体
- 低成本:可运行在普通硬件上,无需昂贵的专用设备
- 适合离线批处理:擅长处理大规模离线数据分析任务
它广泛应用于互联网公司、金融、电信等需要处理海量数据的领域,是大数据技术的重要基础之一。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)