【动手学深度学习PyTorch】微积分
微积分
一、导数和微分
假设我们有一个函数f:R→Rf: \mathbb{R} \rightarrow \mathbb{R}f:R→R,其输入和输出都是标量。
如果fff的导数存在,这个极限被定义为(f′(x)=limh→0f(x+h)−f(x)h.f'(x) = \lim_{h \rightarrow 0} \frac{f(x+h) - f(x)}{h}.f′(x)=h→0limhf(x+h)−f(x).)
如果f′(a)f'(a)f′(a)存在,则称fff在aaa处是可微(differentiable)的。
如果fff在一个区间内的每个数上都是可微的,则此函数在此区间中是可微的。
%matplotlib inline
import numpy as np
from matplotlib_inline import backend_inline
from d2l import torch as d2l


def f(x):
    return 3 * x ** 2 - 4 * x
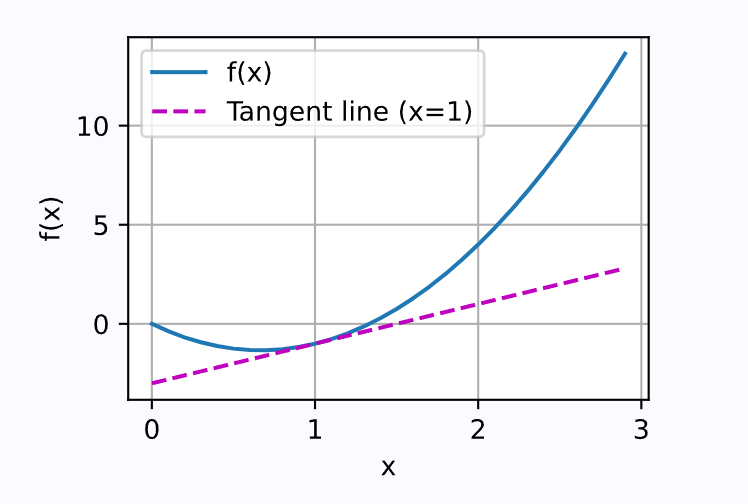
当x=1x=1x=1时,导数u′u'u′是222。
def numerical_lim(f, x, h):
    return (f(x + h) - f(x)) / h

h = 0.1
for i in range(5):
    print(f'h={h:.5f}, numerical limit={numerical_lim(f, 1, h):.5f}')
    h *= 0.1
h=0.10000, numerical limit=2.30000
h=0.01000, numerical limit=2.03000
h=0.00100, numerical limit=2.00300
h=0.00010, numerical limit=2.00030
h=0.00001, numerical limit=2.00003
注意,注释#@save是一个特殊的标记,会将对应的函数、类或语句保存在d2l包中。
因此,以后无须重新定义就可以直接调用它们(例如,d2l.use_svg_display())。
# use_svg_display函数指定matplotlib软件包输出svg图表以获得更清晰的图像
def use_svg_display():  #@save
    """使用svg格式在Jupyter中显示绘图"""
    backend_inline.set_matplotlib_formats('svg')
# set_figsize函数来设置图表大小
def set_figsize(figsize=(3.5, 2.5)):  #@save
    """设置matplotlib的图表大小"""
    use_svg_display()
    d2l.plt.rcParams['figure.figsize'] = figsize
# set_axes函数用于设置由matplotlib生成图表的轴的属性
#@save
def set_axes(axes, xlabel, ylabel, xlim, ylim, xscale, yscale, legend):
    """设置matplotlib的轴"""
    axes.set_xlabel(xlabel)
    axes.set_ylabel(ylabel)
    axes.set_xscale(xscale)
    axes.set_yscale(yscale)
    axes.set_xlim(xlim)
    axes.set_ylim(ylim)
    if legend:
        axes.legend(legend)
    axes.grid()
# 定义一个plot函数来简洁地绘制多条曲线
#@save
def plot(X, Y=None, xlabel=None, ylabel=None, legend=None, xlim=None,
         ylim=None, xscale='linear', yscale='linear',
         fmts=('-', 'm--', 'g-.', 'r:'), figsize=(3.5, 2.5), axes=None):
    """绘制数据点"""
    if legend is None:
        legend = []

    set_figsize(figsize)
    axes = axes if axes else d2l.plt.gca()

    # 如果X有一个轴,输出True
    def has_one_axis(X):
        return (hasattr(X, "ndim") and X.ndim == 1 or isinstance(X, list)
                and not hasattr(X[0], "__len__"))

    if has_one_axis(X):
        X = [X]
    if Y is None:
        X, Y = [[]] * len(X), X
    elif has_one_axis(Y):
        Y = [Y]
    if len(X) != len(Y):
        X = X * len(Y)
    axes.cla()
    for x, y, fmt in zip(X, Y, fmts):
        if len(x):
            axes.plot(x, y, fmt)
        else:
            axes.plot(y, fmt)
    set_axes(axes, xlabel, ylabel, xlim, ylim, xscale, yscale, legend)
[绘制函数u=f(x)u=f(x)u=f(x)及其在x=1x=1x=1处的切线y=2x−3y=2x-3y=2x−3],其中系数222是切线的斜率
x = np.arange(0, 3, 0.1)
plot(x, [f(x), 2 * x - 3], 'x', 'f(x)', legend=['f(x)', 'Tangent line (x=1)'])
二、偏导数
设y=f(x1,x2,…,xn)y = f(x_1, x_2, \ldots, x_n)y=f(x1,x2,…,xn)是一个具有nnn个变量的函数。
yyy关于第iii个参数xix_ixi的偏导数(partial derivative)为:
∂y∂xi=limh→0f(x1,…,xi−1,xi+h,xi+1,…,xn)−f(x1,…,xi,…,xn)h. \frac{\partial y}{\partial x_i} = \lim_{h \rightarrow 0} \frac{f(x_1, \ldots, x_{i-1}, x_i+h, x_{i+1}, \ldots, x_n) - f(x_1, \ldots, x_i, \ldots, x_n)}{h}.∂xi∂y=h→0limhf(x1,…,xi−1,xi+h,xi+1,…,xn)−f(x1,…,xi,…,xn).
为了计算∂y∂xi\frac{\partial y}{\partial x_i}∂xi∂y,可以简单地将x1,…,xi−1,xi+1,…,xnx_1, \ldots, x_{i-1}, x_{i+1}, \ldots, x_nx1,…,xi−1,xi+1,…,xn看作常数,并计算yyy关于xix_ixi的导数。
对于偏导数的表示,以下是等价的:
∂y∂xi=∂f∂xi=fxi=fi=Dif=Dxif.\frac{\partial y}{\partial x_i} = \frac{\partial f}{\partial x_i} = f_{x_i} = f_i = D_i f = D_{x_i} f.∂xi∂y=∂xi∂f=fxi=fi=Dif=Dxif.
三、梯度
连结一个多元函数对其所有变量的偏导数,以得到该函数的梯度(gradient)向量。
具体而言,设函数f:Rn→Rf:\mathbb{R}^n\rightarrow\mathbb{R}f:Rn→R的输入是一个nnn维向量x=[x1,x2,…,xn]⊤\mathbf{x}=[x_1,x_2,\ldots,x_n]^\topx=[x1,x2,…,xn]⊤,并且输出是一个标量。
函数f(x)f(\mathbf{x})f(x)相对于x\mathbf{x}x的梯度是一个包含nnn个偏导数的向量:
∇xf(x)=[∂f(x)∂x1,∂f(x)∂x2,…,∂f(x)∂xn]⊤,\nabla_{\mathbf{x}} f(\mathbf{x}) = \bigg[\frac{\partial f(\mathbf{x})}{\partial x_1}, \frac{\partial f(\mathbf{x})}{\partial x_2}, \ldots, \frac{\partial f(\mathbf{x})}{\partial x_n}\bigg]^\top,∇xf(x)=[∂x1∂f(x),∂x2∂f(x),…,∂xn∂f(x)]⊤,
其中∇xf(x)\nabla_{\mathbf{x}} f(\mathbf{x})∇xf(x)通常在没有歧义时被∇f(x)\nabla f(\mathbf{x})∇f(x)取代。
假设x\mathbf{x}x为nnn维向量,在微分多元函数时经常使用以下规则:
- 对于所有A∈Rm×n\mathbf{A} \in \mathbb{R}^{m \times n}A∈Rm×n,都有∇xAx=A⊤\nabla_{\mathbf{x}} \mathbf{A} \mathbf{x} = \mathbf{A}^\top∇xAx=A⊤
- 对于所有A∈Rn×m\mathbf{A} \in \mathbb{R}^{n \times m}A∈Rn×m,都有∇xx⊤A=A\nabla_{\mathbf{x}} \mathbf{x}^\top \mathbf{A} = \mathbf{A}∇xx⊤A=A
- 对于所有A∈Rn×n\mathbf{A} \in \mathbb{R}^{n \times n}A∈Rn×n,都有∇xx⊤Ax=(A+A⊤)x\nabla_{\mathbf{x}} \mathbf{x}^\top \mathbf{A} \mathbf{x} = (\mathbf{A} + \mathbf{A}^\top)\mathbf{x}∇xx⊤Ax=(A+A⊤)x
- ∇x∥x∥2=∇xx⊤x=2x\nabla_{\mathbf{x}} \|\mathbf{x} \|^2 = \nabla_{\mathbf{x}} \mathbf{x}^\top \mathbf{x} = 2\mathbf{x}∇x∥x∥2=∇xx⊤x=2x
同样,对于任何矩阵X\mathbf{X}X,都有∇X∥X∥F2=2X\nabla_{\mathbf{X}} \|\mathbf{X} \|_F^2 = 2\mathbf{X}∇X∥X∥F2=2X。
三、链式法则
链式法则可以被用来微分复合函数。
单变量函数中,假设函数y=f(u)y=f(u)y=f(u)和u=g(x)u=g(x)u=g(x)都是可微的,根据链式法则:
dydx=dydududx.\frac{dy}{dx} = \frac{dy}{du} \frac{du}{dx}.dxdy=dudydxdu.
函数具有任意数量的变量的情况:
假设可微分函数yyy有变量u1,u2,…,umu_1, u_2, \ldots, u_mu1,u2,…,um,其中每个可微分函数uiu_iui都有变量x1,x2,…,xnx_1, x_2, \ldots, x_nx1,x2,…,xn。
注意,yyy是x1,x2,…,xnx_1, x_2, \ldots, x_nx1,x2,…,xn的函数。
对于任意i=1,2,…,ni = 1, 2, \ldots, ni=1,2,…,n,链式法则给出:
∂y∂xi=∂y∂u1∂u1∂xi+∂y∂u2∂u2∂xi+⋯+∂y∂um∂um∂xi\frac{\partial y}{\partial x_i} = \frac{\partial y}{\partial u_1} \frac{\partial u_1}{\partial x_i} + \frac{\partial y}{\partial u_2} \frac{\partial u_2}{\partial x_i} + \cdots + \frac{\partial y}{\partial u_m} \frac{\partial u_m}{\partial x_i}∂xi∂y=∂u1∂y∂xi∂u1+∂u2∂y∂xi∂u2+⋯+∂um∂y∂xi∂um
小结
- 微分和积分是微积分的两个分支,前者可以应用于深度学习中的优化问题。
- 导数可以被解释为函数相对于其变量的瞬时变化率,它也是函数曲线的切线的斜率。
- 梯度是一个向量,其分量是多变量函数相对于其所有变量的偏导数。
- 链式法则可以用来微分复合函数。
内容声明
本文基于开源教材《动手学深度学习》(Dive into Deep Learning, 作者:Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola 等)整理,原始项目地址:https://github.com/d2l-ai/d2l-zh。
在整理过程中对部分内容进行了删改和补充,仅用于个人学习与交流,版权归原作者所有。
码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐
 35
 0
- 0


 已为社区贡献27条内容

所有评论(0)