沐神 《动手学深度学习》之3.2线性回归从零开始实现
前言
线性回归的方法包括数据流水线、模型、损失函数和小批量随机梯度下降优化器。 现代的深度学习框架几乎可以自动化地进行所有这些工作,所以不用要求自己可以手搓,明白这个东西是什么就行了。
那么我们正式开始。
一、生成数据集
import os
os.environ['KMP_DUPLICATE_LIB_OK'] = 'True'

import random
import torch
import matplotlib.pyplot as plt  # 添加matplotlib用于绘图

def synthetic_data(w, b, num_examples):  #@save
    """生成y=Xw+b+噪声"""

    X = torch.normal(0, 1, (num_examples, len(w)))
    # 生成特征矩阵X:从正态分布中随机采样,形状为(样本数, 特征数)

    y = torch.matmul(X, w) + b
    # 计算真实标签:y = X * w + b

    y += torch.normal(0, 0.01, y.shape)
    # 添加噪声:让数据更接近真实情况
    return X, y.reshape((-1, 1))

# 真实参数:权重w=[2, -3.4],偏置b=4.2
true_w = torch.tensor([2, -3.4])
true_b = 4.2

# 生成1000个样本的合成数据
features, labels = synthetic_data(true_w, true_b, 1000)

print('第一个样本的特征:', features[0])
print('第一个样本的标签:', labels[0])

# 设置图形大小
plt.figure(figsize=(10, 6))
# 绘制散点图:用第二个特征与标签的关系来可视化数据
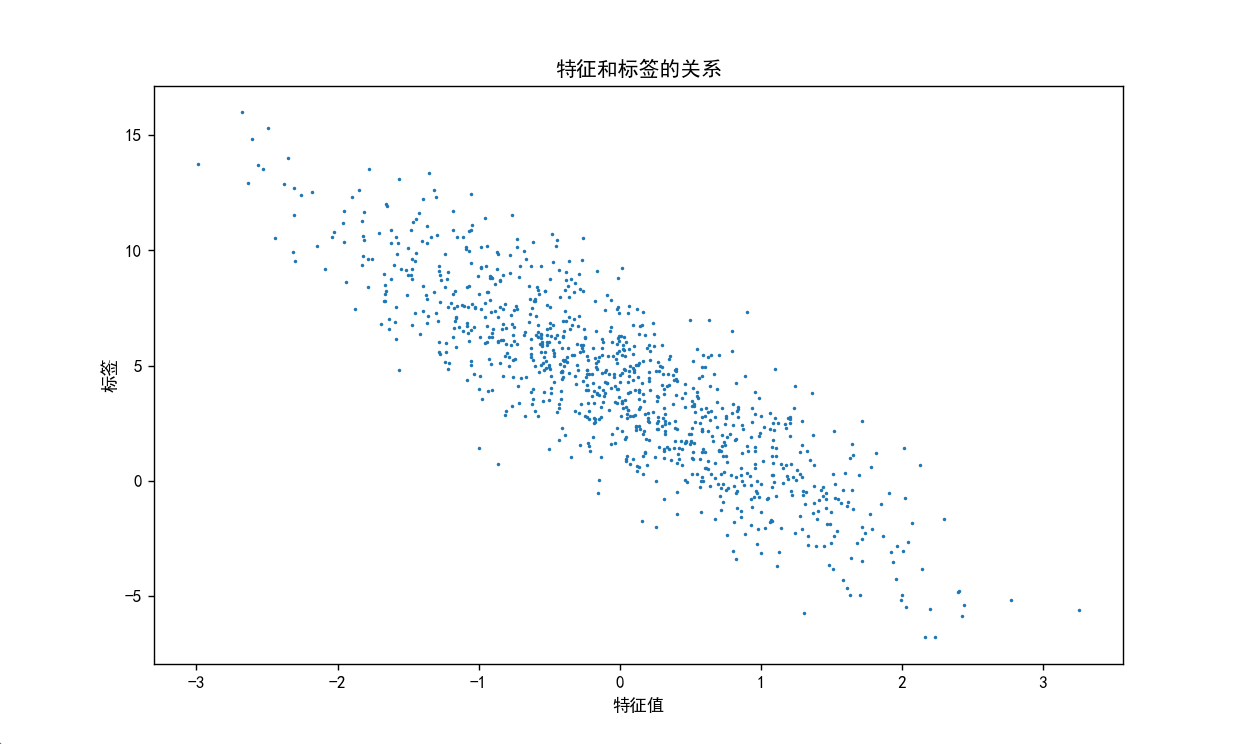
plt.scatter(features[:, 1].detach().numpy(), labels.detach().numpy(), s=1)
plt.xlabel('Feature 2')  # 改为英文
plt.ylabel('Label')
plt.title('Relationship between Feature and Label')
plt.show()  # 显示图形
代码不难,我们来看一下。
import os
os.environ['KMP_DUPLICATE_LIB_OK'] = 'True'

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False
我们2.6节用过,解决中文标签的问题。可以不加,用英文代替就行。
def synthetic_data(w, b, num_examples):  #@save
    """生成y=Xw+b+噪声"""

    X = torch.normal(0, 1, (num_examples, len(w)))
    # 生成特征矩阵X:从正态分布中随机采样,形状为(样本数, 特征数)

    y = torch.matmul(X, w) + b
    # 计算真实标签:y = X * w + b

    y += torch.normal(0, 0.01, y.shape)
    # 添加噪声:让数据更接近真实情况
    return X, y.reshape((-1, 1))
生成数据函数。
w:权重向量,决定每个特征的重要性
b:偏置项,基础偏移量
num_examples:生成的样本数量
这个函数会返回一个所有的特征值和其对应标签。
二、读取数据集
训练模型需要每次抽取小批量,因为这样比单个数据传入训练的快;而且相比于大批量,会主动添加噪声,防止过拟合化,失去泛化能力。
以下函数能打乱数据集中的样本并以小批量方式获取数据。
def data_iter(batch_size, features, labels):#batch_size表示每次批量是多少
    num_examples = len(features)#计算总共多少样本
    indices = list(range(num_examples))#创建索引列表
    random.shuffle(indices)# 这些样本是随机读取的,没有特定的顺序
    #shuffle用来打乱索引
    for i in range(0, num_examples, batch_size):
        batch_indices = torch.tensor(
            indices[i: min(i + batch_size, num_examples)])
        yield features[batch_indices], labels[batch_indices]

#接下来我们打印一下第一批次
batch_size = 10
for X, y in data_iter(batch_size, features, labels):
    print(X, '\n', y)
    break
这里讲一下啊for循环:
for i in range(0, num_examples, batch_size):
#range(0, num_examples, batch_size):从0开始,每次增加batch_size
#比如batch_size=10,num_examples=1000:0, 10, 20, 30, ..., 990
batch_indices = torch.tensor(indices[i: min(i + batch_size, num_examples)])
#获取当前批次索引
#从i开始的batch_size个索引
#加min函数,是为了防止循环到最后一个批次,已经不足batch_size个,可以单独成为一小组
#yield是生成器关键字,每次循环返回一批数据,不结束函数
三、初始化模型参数
w = torch.normal(0, 0.01, size=(2,1), requires_grad=True)
b = torch.zeros(1, requires_grad=True)
将w设置成在0到0.01之间的随机值,随机概率符合正态分布,生成2行1列的矩阵,因为我们的数据有2个特征。
把b设置生成1个零,形状是[0.]
requires_grad=True,跟踪这个参数的梯度,没有这个就没办法进行学习。
四、定义模型
我们目前只学过线性回归模型。
回想一下,要计算线性模型的输出, 我们只需计算输入特征X和模型权重w的矩阵-向量乘法后加上偏置b。
注意,这里的b是一个标量,X*w是一个向量,因为Pytorch的广播机制,二者可以相加。
广播机制:
-
通过适当复制元素来扩展一个或两个数组,以便在转换之后,两个张量具有相同的形状;
-
对生成的数组执行按元素操作。
def linreg(X, w, b):  #@save
    """线性回归模型"""
    return torch.matmul(X, w) + b
五、定义损失函数
这里的y_hat是预测值,y是真实值,reshape() 是为了确保 y_hat 和 y 的形状完全一致,避免广播机制带来的意外结果!
def squared_loss(y_hat, y):  #@save
    """均方损失"""
    return (y_hat - y.reshape(y_hat.shape)) ** 2 / 2
六、定义优化算法
以下随机梯度下降(SGD)优化器的代码。这段代码实现了模型参数更新的核心过程,根据梯度来调整参数值,让模型逐步改进。
def sgd(params, lr, batch_size):  #@save
    """小批量随机梯度下降"""
    with torch.no_grad():
        for param in params:
            param -= lr * param.grad / batch_size
            param.grad.zero_()
params:模型参数列表,比如 [w, b]:学习率(learning rate),控制每次更新的步长
lr
batch_size:批次大小,用于归一化梯度
with torch.no_grad():
#with创建也给代码块,在这个代码块内,PyTorch不会跟踪计算历史梯度
#参数更新不是模型学习的一部分,不需要计算梯度,节省计算机性能
七、训练
for epoch in range(num_epochs):#外层循环,训练num_epochs次
    for X, y in data_iter(batch_size, features, labels):#把数据分成小批次训练
        l = loss(net(X, w, b), y)  # 计算X和y的小批量损失
        l.sum().backward() # 因为l形状是(batch_size,1),而不是一个标量。l中的所有元素被加到一起,并以此计算关于[w,b]的梯度
        sgd([w, b], lr, batch_size)  # 使用参数的梯度更新参数
    with torch.no_grad():
        train_l = loss(net(features, w, b), labels)#计算整个数据集的平均损失
        print(f'epoch {epoch + 1}, loss {float(train_l.mean()):f}')

print(f'w的估计误差: {true_w - w.reshape(true_w.shape)}')
print(f'b的估计误差: {true_b - b}')
输出结果:
w的估计误差: tensor([ 0.0007, -0.0008], grad_fn=<SubBackward0>)
b的估计误差: tensor([2.8133e-05], grad_fn=<RsubBackward1>)
因为我们使用的是自己合成的数据集,所以我们知道真正的参数是什么。 因此,我们可以通过比较真实参数和通过训练学到的参数来评估训练的成功程度。
可以看到,差距非常的小,说明训练是成功的。
另外,因为数据是随机生成的,所以输出结果和作者不一样也正常。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 27
 0
- 0


 已为社区贡献20条内容

所有评论(0)