基于PySpark底座设计AI算子架构及其技术栈分析
·
基于PySpark底座设计AI算子架构及其技术栈分析
背景
公司基于 PySpark 实现了分布式大数据分析系统。现在要基于其基础上,实现AI算子来支持未来的各种AI计算(要支持的算子类型如下图所示)。应如何设计算子架构才能让使用者足够轻松,底层又能足够灵活和兼容?
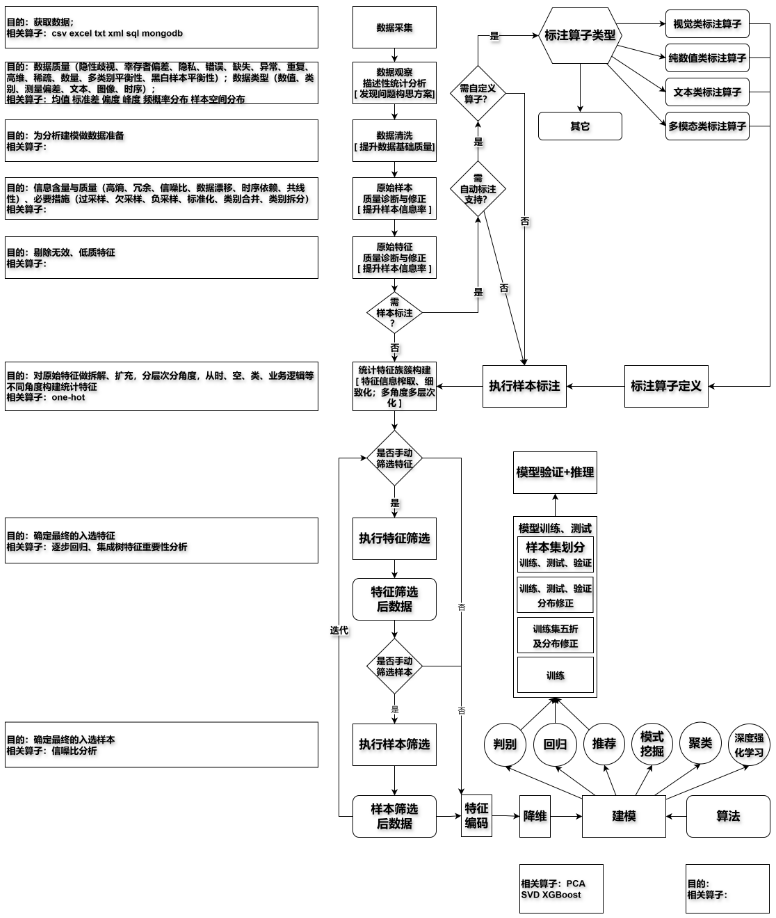
我们需要支持如下AI标准化建模流程
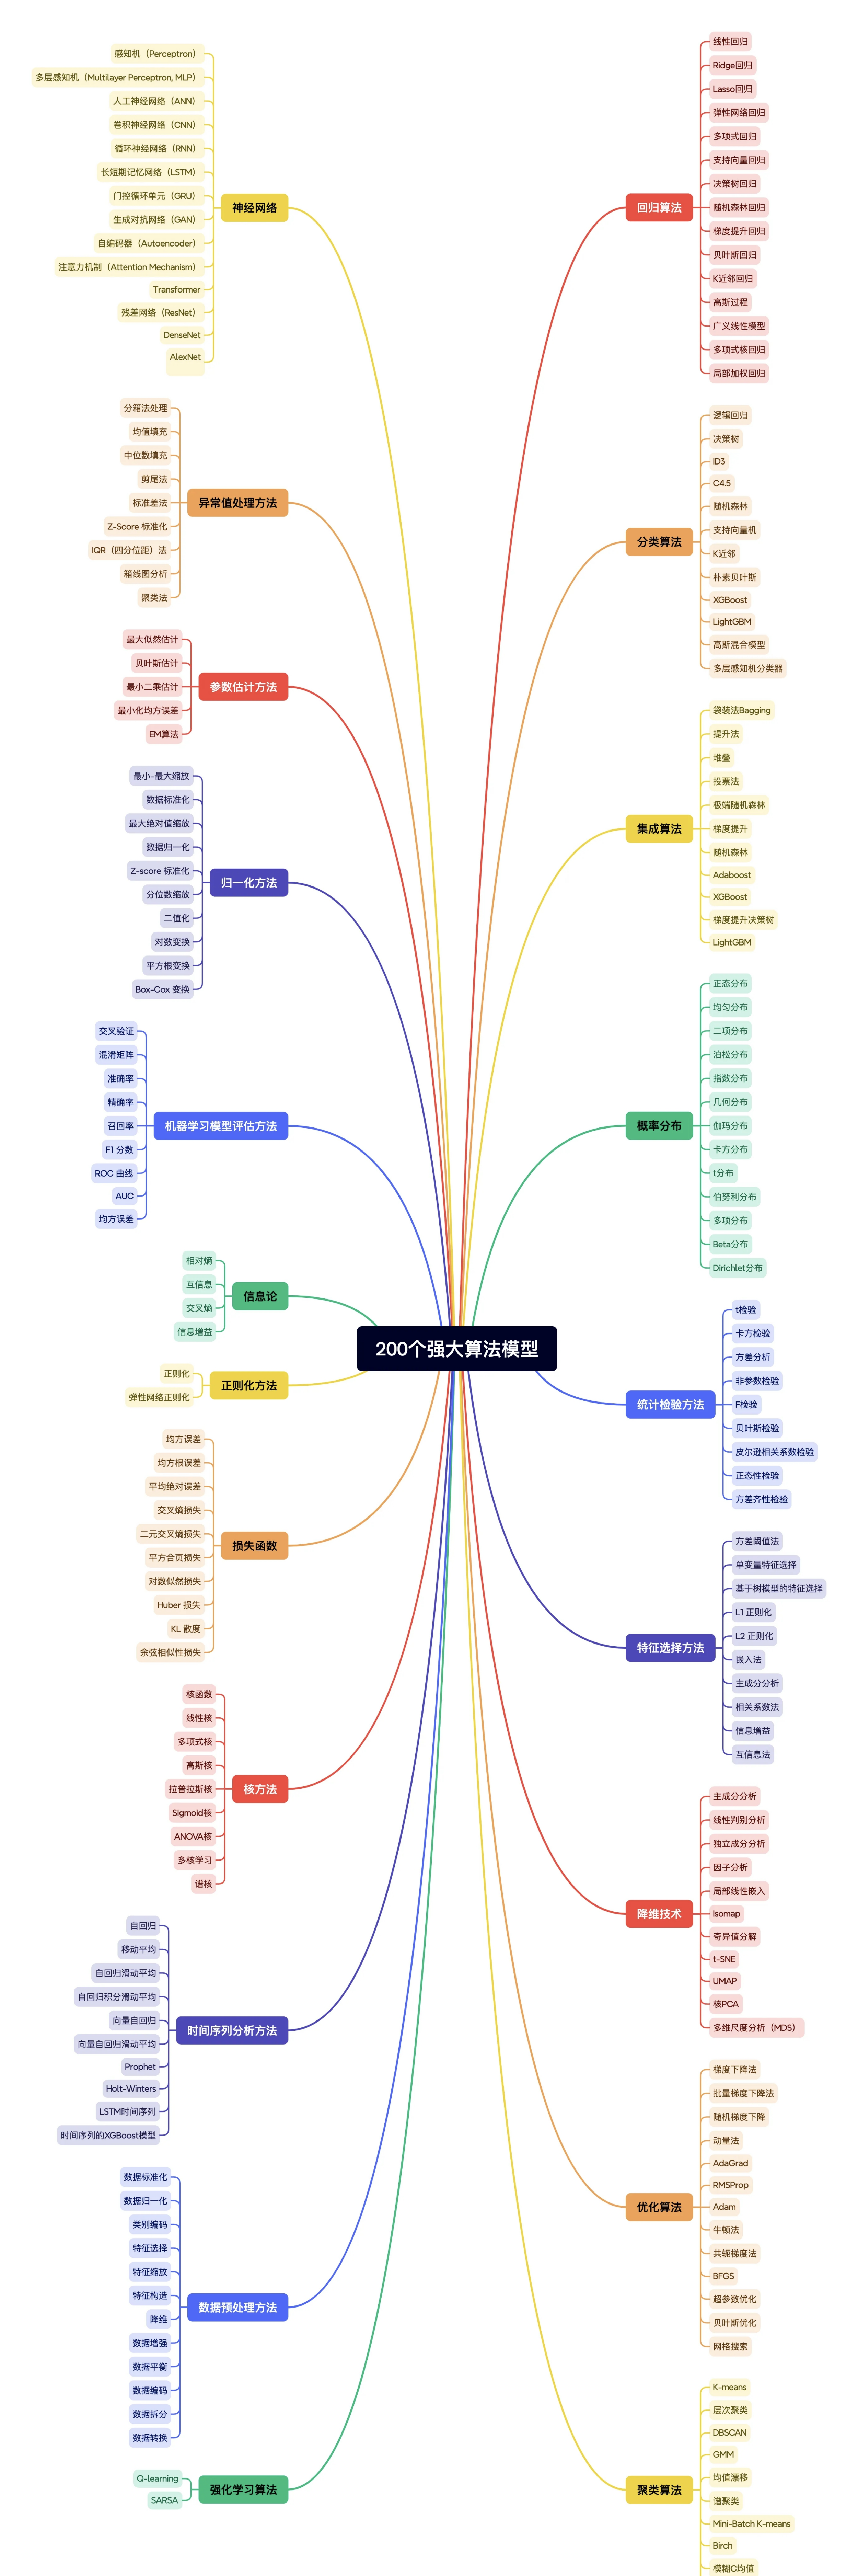
我们要支持下图所示的算子类型
PySpark对于数据的分布式处理,会把数据均匀分割到很小的块,传输给不同的worker去单独处理。小块可适应worker本身显存或内存大小去进行针对性配置。
在数据与模型层面,潜在可能遇到的现实情况有
- 数据层面上,我们要考虑要应对的极限情况,可能出自:
(1)单个不可分割的大数据(比如,单张的极限大小的高分辨率全景图);
(2)模型训练过程以视频为不可分割的基本样本单位;
(3)大模型输入的多模态样本单个batch超过显存、内存大小。 - 模型层面上,我们考虑训练模式需要应对的场景如下:
(1)单显卡显存足够训练模型所有参数;
(2)单显卡显存不足以训练模型所有参数,但多显卡显存足够;
(3)所有显存不足以训练模型所有参数,但显存+内存足够;
(4)显存+内存仍不足以训练模型所有参数;
(5)显存不足以训练模型的一层参数;
(6)显存+内存不足以存在模型的一层参数;
(7)启动训练的时候显存+内存足够,训练到一半,显存+内存不足了,需要动态切换训练模式。
针对如上的场景需求,调研得到如下针对性的推荐技术栈
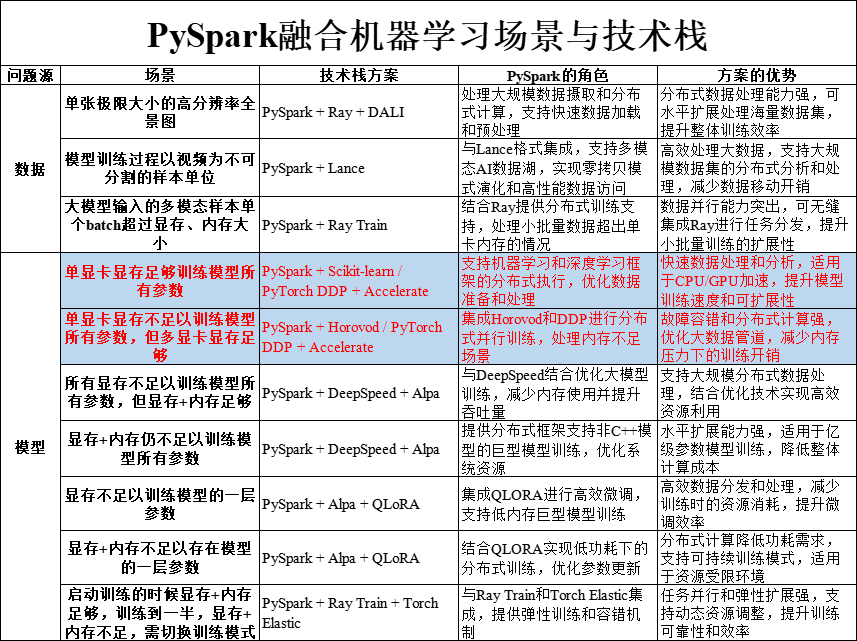
对于我们而言,模型训练一般只涉及单卡和多卡分布式训练的情况。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)