机器学习之决策树
决策树是一种应用广泛的归纳推理算法。在分类问题中,基于特征对样本进行分类,构成一棵包含一系列if-then规则的树,在数学上可以看成特征空间与类空间的条件概率分布。
一.决策树的基本结构
| 组件 | 定义 | 应用 |
|---|---|---|
| 根节点 |
决策树的起始节点,对应整个数据集 无父节点,仅含一个决策特征 | 起始问题 |
| 内部节点 |
位于根节点与叶子节点之间,每个节点对应一个 决策特征,将父节点数据拆分为多个子集 | 中间决策点 |
| 叶节点 |
决策树的终止节点,无子节点, 对应一个明确的输出结果 | 最终结果 |
| 分支 |
连接节点的边,对应特征的某个取值, 代表决策路径的一个环节 | 测试结果方向 |
二.决策树核心——特征选择
决策树的核心是选择最优特征进行划分,让划分后的数据子集样本属于同一类别,也就是尽量提高各数据子集的“纯度”(Purity),降低不确定性。
1.ID3算法
使用信息增益选择特征
1)信息熵
在讨论信息熵是什么之前,我们先讨论熵。熵是一个物理学概念,它表示一个系统的不确定性程度(混乱程度)。而信息熵就是将熵引入信息论中的体现,由于是一个叫香农的数学家提出的,故信息熵也可叫“香农熵”。
随机变量X的信息熵定义为:
其中,x表示随机变量;n表示随机变量可能的随机数;p(x)表示随机变量x的概率函数。在计算时,对数log不同的底数对应不同的单位(但其实不管是以哪个为底对结果数值影响不大)。
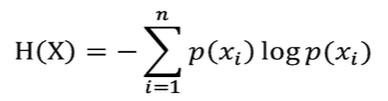
| 底数 | 熵的单位 | 应用 |
| 2 | bit(比特) | 最常用,贴合计算机二进制逻辑 |
 | nat(纳特) | 数学上求导简洁,但不直观 |
| 10 | hartley(哈特莱) | 早期用于电信领域 |
For example,投掷一枚硬币,设随机变量为面朝上,其中正面朝上概率为p,那么反面朝上概率为1-p,代入底数为2,根据计算公式可得,随机变量x的信息熵为:
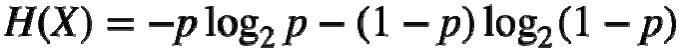
信息熵随概率p的变化规律如图1:
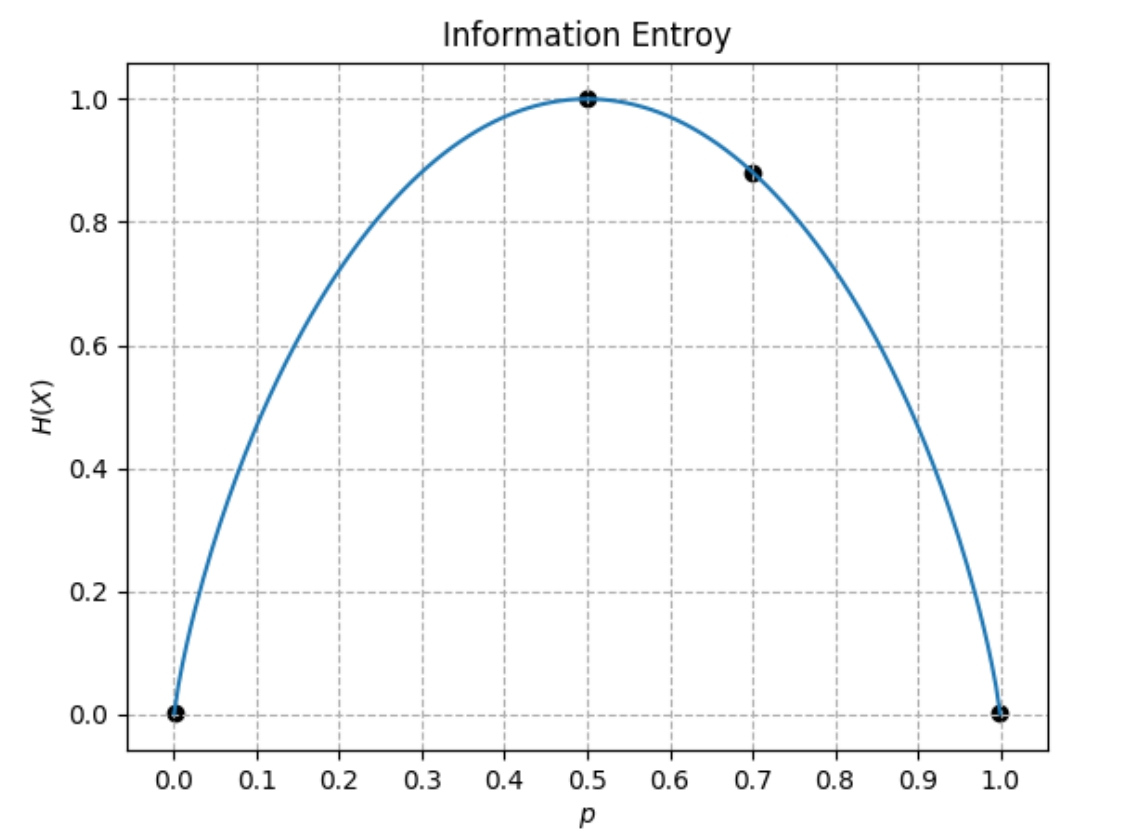
由图可知,信息熵反映的不确定性与日常直觉也是相符的。当x=0/1时,H(x)=0,此时事情是确定的,不存在不确定性;当p=0.5时,H(x)=1最大,正反面出现概率相等,不确定性最高;当p=0.7时,H(x)=0.8813,更大程度出现正面,不确定性更低。
2)条件信息熵
条件信息熵
就是在随机变量X的条件下,求随机变量Y的不确定性。
,
条件熵
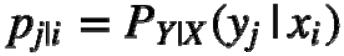
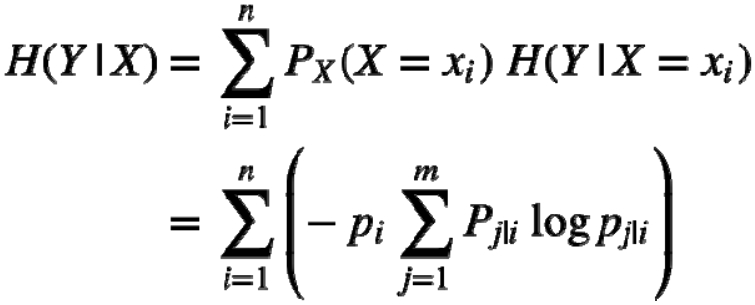
3)信息增益
信息增益衡量的是使用某个特征进行划分后,数据的不确定性减少了多少。可直接表示为随机变量Y的信息熵与条件熵的差值,公式为:
信息增益越大,说明条件X克服的不确定性越大,分类能力更强。在选择切分特征时,选择信息增益更大的特征作为切分特征。
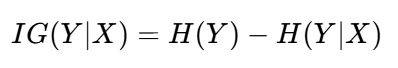
下面有一个关于信息熵、条件熵、信息增益的综合运用例子:
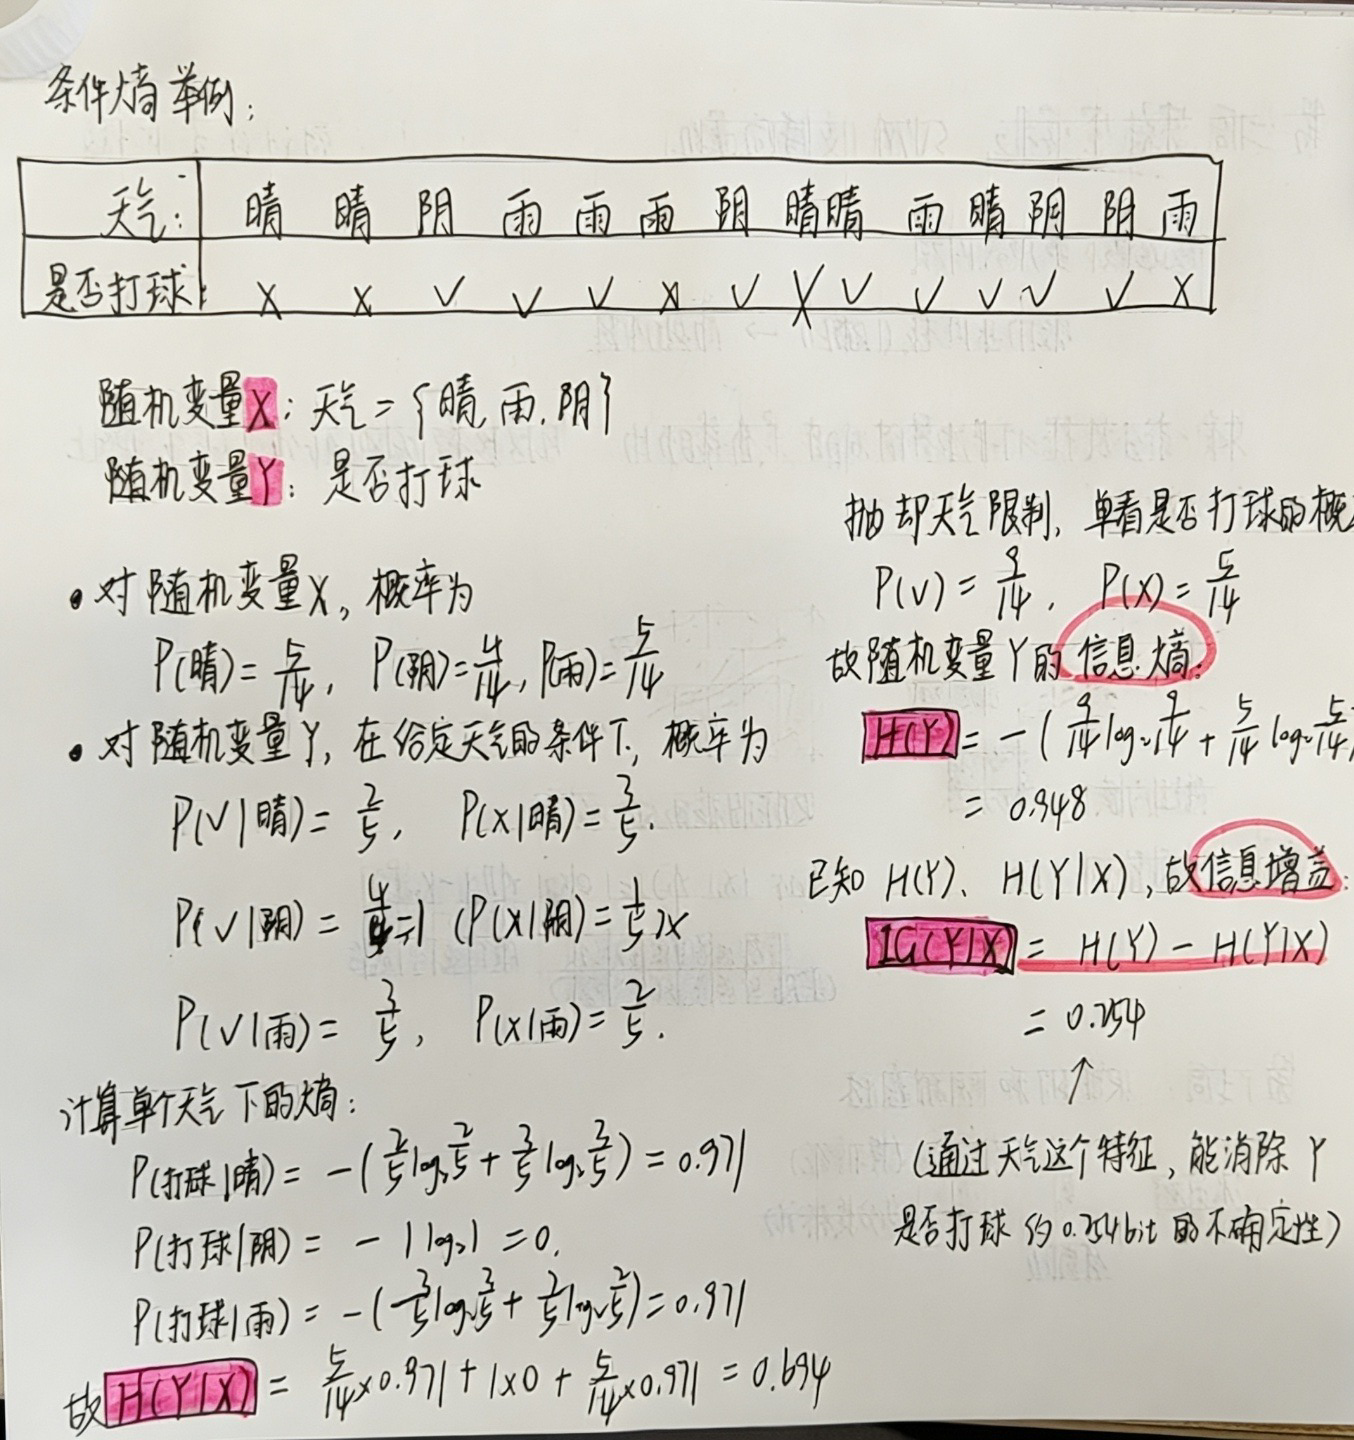
在实际问题中,影响是否打球的因素肯定不止有天气,所以可以计算多个特征的信息增益,增益最大的特征就将其选择为当前节点的分裂特征。
虽然信息增益能有效选择区分度高的特征,且相对直观,但是也存在缺点。如果一个特征有很多取值,ID3算法可能会把数据分割的很细,导致过拟合,对连续值的处理效果不是很好,接下来我们便进一步讨论ID3的优化算法
2.C4.5算法
使用信息增益率,对信息增益进行归一化,解决其偏向多值特征的问题
简单理解,信息增益率=信息增益 / 特征自身的熵(分裂信息),公式表示为:
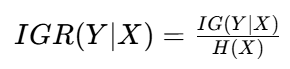
H(X)是特征自身的熵,衡量X取值的“混乱程度”,取值越多,H(X)越大,IGR则越小,越不容易被选择。生动地说就是特征取值越多,用它划分后直接生成更多的分支,但每个分支里的数据量却很少,这个分支就没什么意义。
C4.5一定程度上解决了ID3容易过拟合的问题,实际上这两种都倾向于处理离散值而不是连续值,可以很好处理分类问题,但在处理回归问题上有一定局限性。
3.CART算法
分类:使用基尼指数
数据集D 有k个分类,一个样本属于第i类的概率为
则基尼指数定义为:
与条件熵类似,在特征A条件下D的基尼指数定义为:
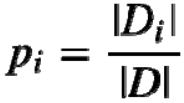
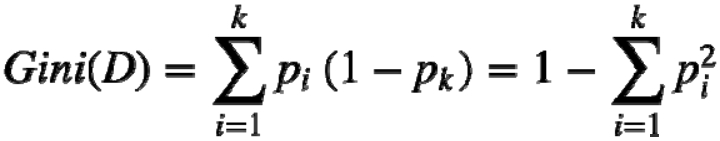
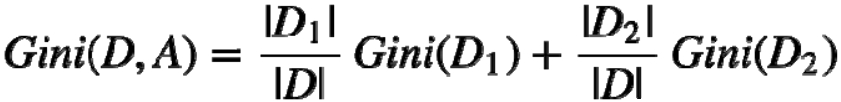
还是举抛硬币的例子,正面朝上的概率为p,则有
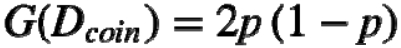
基尼指数和上述计算过信息熵的一半曲线接近,如图3:
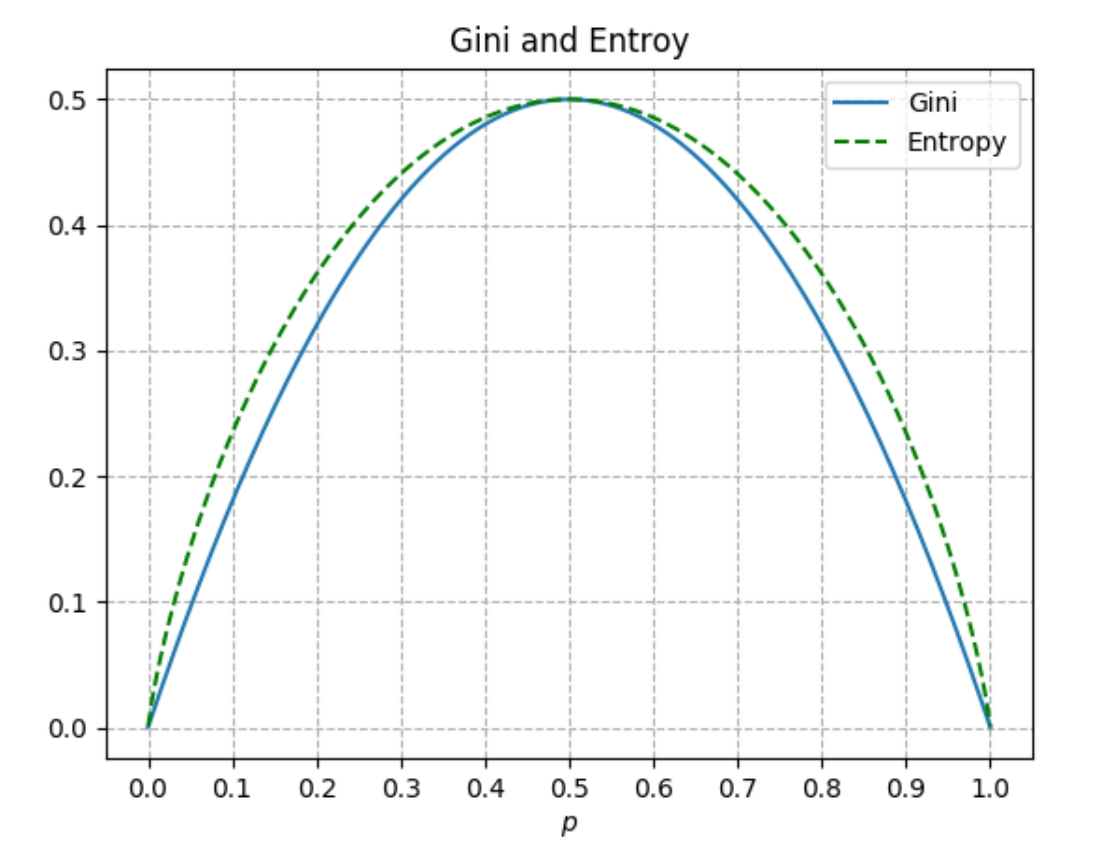
需要注意的是,使用CART分类树构造算法选择切分特征时,选择的是基尼指数最小的特征,因为基尼指数越小意味着分裂后两个子节点纯度越高,类别混杂程度越低。
回归:使用均方误差(MSE)
对于数据集D,若将其划分为2个子集,则在特征A下均方误差的公式可表示为:
其中,单个子集的均方误差为:
(
是样本 x 的真实标签,
是子集
内样本标签的均值)
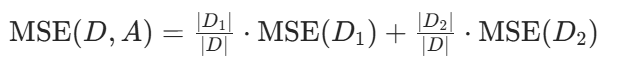
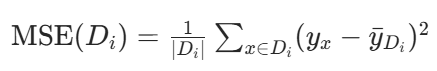
均方误差衡量划分后子集样本的离散程度——MSE越小,说明子集内样本取值越集中,回归结果的精度越高。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 22
 0
- 0


 已为社区贡献1条内容

所有评论(0)