机器学习中的逻辑回归
摘要:逻辑回归是一种监督学习分类算法,主要用于预测二元目标变量的概率,也可扩展到多分类问题。文章介绍了逻辑回归的基本概念、数学模型(S形函数)及其在Python中的实现方法。通过Iris和Digits数据集示例,分别演示了二元逻辑回归和多项逻辑回归的应用,包括数据预处理、模型训练和评估过程。其中二元逻辑回归准确率达到95.69%,展示了该算法在实际分类问题中的有效性。文章还讨论了逻辑回归的不同类型(二项式、多项式和序数)及其适用场景,为读者提供了全面的逻辑回归入门指南。
目录
逻辑回归导论
逻辑回归是一种监督式学习分类算法,用于预测目标变量的概率。目标变量或因变量的性质是二分类的,这意味着只有两个可能的类别。
简单来说,因变量是二元的,数据编码为1(代表成功/是)或0(代表失败/否)。
数学上,逻辑回归模型预测P(Y=1)是X的函数。它是最简单的机器学习算法之一,可用于垃圾邮件检测、糖尿病预测、癌症检测等多种分类问题。
逻辑回归的类型
一般来说,逻辑回归指的是具有二元目标变量的二元逻辑回归,但还可以有另外两类目标变量被预测。基于这些类别数量,逻辑回归可分为以下类型 −
二进制或二项式
在这种分类中,因变量只有两种类型,分别是1和0。例如,这些变量可能代表成功或失败、是或否、赢或输等。
多项式
在这种分类方式中,因变量可以有3种或更多无序类型,或者这些类型没有定量意义。例如,这些变量可能代表“类型A”或“类型B”或“类型C”。
序数
在这种分类中,因变量可以有3种或更多可能的有序类型,或具有定量意义的类型。例如,这些变量可能代表“差”或“好”、“非常好”、“优秀”,每个类别的得分可以是0、1、2、3。
逻辑回归假设
在深入逻辑回归的实现之前,我们必须了解以下关于相同的假设——
-
在二元逻辑回归中,目标变量必须始终是二元的,期望结果由因子级1表示。
-
模型中不应存在多重共线性,这意味着自变量必须彼此独立。
-
我们必须在模型中包含有意义的变量。
-
我们应选择较大的样本量进行逻辑回归。
二元逻辑回归模型
最简单的逻辑回归形式是二元或二项逻辑回归,其中目标变量或因变量只能有两种可能类型,分别是1或0。它使我们能够模拟多个预测变量与二元/二项目标变量之间的关系。在逻辑回归的情况下,线性函数基本上用作另一个函数的输入,如下关系 −
这里, 是逻辑斯或S形函数,可以表示为−
到S形曲线可以通过以下图表表示。我们可以看到y轴的值位于0和1之间,并且在0.5处横跨该轴。
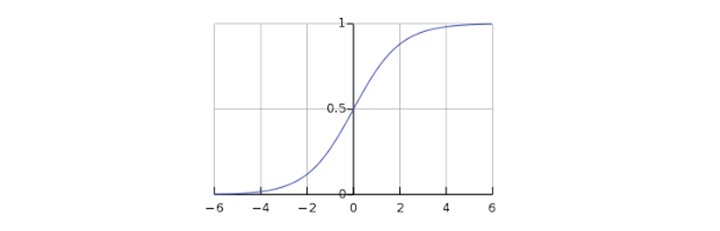
这些类别可以分为正面或负面。如果输出位于0和1之间,则属于正类概率。在我们的实现中,假设函数输出为0.5时为正,否则为负。
我们还需要定义一个损失函数,用函数权重(theta 表示如下)来衡量算法的表现 −
现在,在定义了损失函数后,我们的主要目标是最小化损失函数。这可以通过调整配重来完成,也就是通过增加或减少配重来实现。借助损失函数对每个权重的导数,我们可以知道哪些参数权重应该很高,哪些参数权重应该较小。
以下梯度下降方程告诉我们,如果我们修改参数−,损失会如何变化
Python 中实现二元逻辑回归模型
现在我们将在 Python 中实现上述二项逻辑回归的概念。为此,我们使用了一个名为Iris的多变量花卉数据集,包含3个类别,每个类别50个实例,但我们将使用前两个特征列。每个类别代表一种鸢尾花。
首先,我们需要导入所需的库,具体如下 −
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn import datasets
接下来,加载虹膜数据集如下 −
iris = datasets.load_iris()
X = iris.data[:, :2]
y = (iris.target != 0) * 1
我们可以绘制训练数据s,从以下为−
plt.figure(figsize=(6, 6))
plt.scatter(X[y == 0][:, 0], X[y == 0][:, 1], color='g', label='0')
plt.scatter(X[y == 1][:, 0], X[y == 1][:, 1], color='y', label='1')
plt.legend();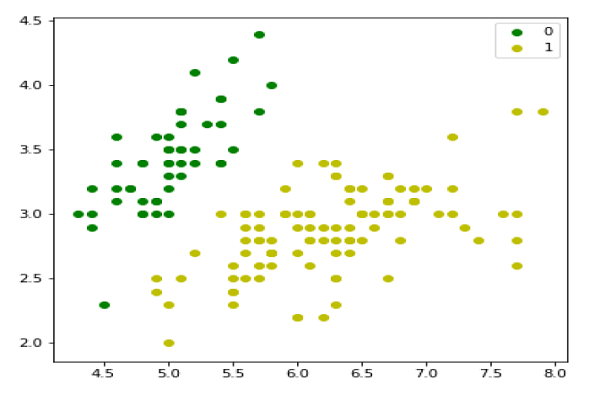
接下来,我们将定义S形函数、损失函数和梯度下降如下 −
class LogisticRegression:
   def __init__(self, lr=0.01, num_iter=100000, fit_intercept=True, verbose=False):
      self.lr = lr
      self.num_iter = num_iter
      self.fit_intercept = fit_intercept
      self.verbose = verbose
   def __add_intercept(self, X):
      intercept = np.ones((X.shape[0], 1))
      return np.concatenate((intercept, X), axis=1)
   def __sigmoid(self, z):
      return 1 / (1 + np.exp(-z))
   def __loss(self, h, y):
      return (-y * np.log(h) - (1 - y) * np.log(1 - h)).mean()
   def fit(self, X, y):
      if self.fit_intercept:
         X = self.__add_intercept(X)
现在,权重初始化如下 −
self.theta = np.zeros(X.shape[1])
   for i in range(self.num_iter):
      z = np.dot(X, self.theta)
      h = self.__sigmoid(z)
      gradient = np.dot(X.T, (h - y)) / y.size
      self.theta -= self.lr * gradient
      z = np.dot(X, self.theta)
      h = self.__sigmoid(z)
      loss = self.__loss(h, y)
      if(self.verbose ==True and i % 10000 == 0):
         print(f'loss: {loss} \t')
借助以下脚本,我们可以预测输出概率 −
def predict_prob(self, X):
   if self.fit_intercept:
      X = self.__add_intercept(X)
   return self.__sigmoid(np.dot(X, self.theta))
def predict(self, X):
   return self.predict_prob(X).round()
接下来,我们可以评估模型并绘制如下图 −
model = LogisticRegression(lr=0.1, num_iter=300000)
preds = model.predict(X)
(preds == y).mean()

plt.figure(figsize=(10, 6))
plt.scatter(X[y == 0][:, 0], X[y == 0][:, 1], color='g', label='0')
plt.scatter(X[y == 1][:, 0], X[y == 1][:, 1], color='y', label='1')
plt.legend()
x1_min, x1_max = X[:,0].min(), X[:,0].max(),
x2_min, x2_max = X[:,1].min(), X[:,1].max(),
xx1, xx2 = np.meshgrid(np.linspace(x1_min, x1_max), np.linspace(x2_min, x2_max))
grid = np.c_[xx1.ravel(), xx2.ravel()]
probs = model.predict_prob(grid).reshape(xx1.shape)
plt.contour(xx1, xx2, probs, [0.5], linewidths=1, colors='red');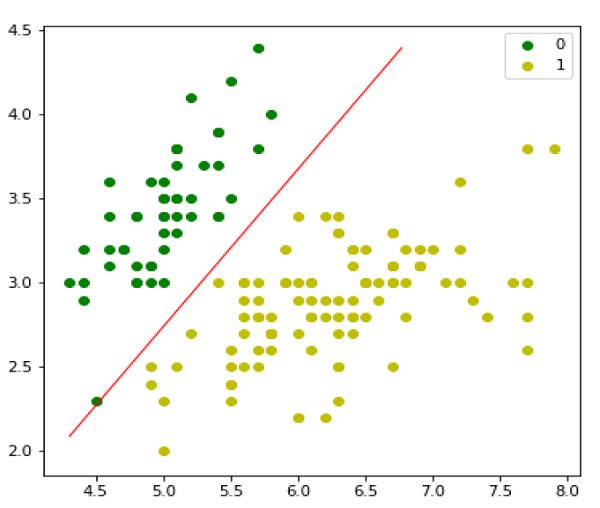
多项逻辑回归模型
另一种有用的逻辑回归形式是多项逻辑回归,其中目标变量或因变量可以有3种或更多可能的无序类型,即这些类型没有定量意义。
在 Python 中实现多项逻辑回归模型
现在我们将在 Python 中实现上述多项式逻辑回归的概念。为此,我们使用了 sklearn 上名为 digit 的数据集。
首先,我们需要导入所需的库,具体如下 −
Import sklearn
from sklearn import datasets
from sklearn import linear_model
from sklearn import metrics
from sklearn.model_selection import train_test_split
接下来,我们需要加载数字数据集 −
digits = datasets.load_digits()现在,定义特征矩阵(X)和响应向量(y)如下 −
X = digits.data
y = digits.target
借助下一行代码,我们可以将 X 和 y 拆分为训练集和测试集 -
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.4, random_state=1)现在创建一个逻辑回归对象如下 −
digreg = linear_model.LogisticRegression()现在,我们需要通过以下训练集训练模型 −
digreg.fit(X_train, y_train)接下来,对测试集进行预测如下 −
y_pred = digreg.predict(X_test)接着打印模型的精度如下 −
print("Accuracy of Logistic Regression model is:",
metrics.accuracy_score(y_test, y_pred)*100)
输出
Accuracy of Logistic Regression model is: 95.6884561891516
从上述输出来看,我们模型的准确率约为96%。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 26
 0
- 0


 已为社区贡献3条内容

所有评论(0)