沐神《动手学深度学习》之3.5图像分类数据集
目录
前言
之前我们学了softmax回归,这一掌我们学习图像分类数据集,这一节本应该实现softmax回归,但是有一个问题,没有数据给我们分类。
本节解决的就是训练数据和测试数据。书上觉得MINIST数据集过于简单,于是选择了类似但更复杂的Fashion-MNIST数据集。
那好,我们现在开始。
一、读取数据集
1.1获取数据集
import torchvision
from torchvision import transforms

#获取数据集
trans = transforms.ToTensor()
minist_train = torchvision.datasets.FashionMNIST(root='./data',
 train=True, transform=trans,download=True)
minist_test = torchvision.datasets.FashionMNIST(root='./data',
train=False, transform=trans, download=True)

print(len(minist_test))#10000
print(len(minist_train))#60000transforms:可以理解为工具箱,然后利用里面的类创造工具(类)输入一张图片,然后输出想要得到的图片。Totensor类是吧图片转化成tensor也就是张量类型的图片。
训练数据 = 从torchvision.datasets下载的FashionMNIST(root = 参数(目录),train=是(训练)否(测试),transform=通过前面trans工具转化,download=是不是下载)
注意,download可以常设置成为True,因为如果它判断你的root目录下面已经有了,它就不会再下载了。
1.2转换标签
输入:labels-包含数字标签的列表或数组(0-9之间的整数)
输出:对应的文本标签列表
#这段代码是一个用于处理Fashion-MNIST数据集的辅助函数
#主要功能是将数字标签转换为对应的文本标签。
def get_fashion_mnist_labels(labels):  #@save
    """返回Fashion-MNIST数据集的文本标签"""
    text_labels = ['t-shirt', 'trouser', 'pullover', 'dress', 'coat',
                   'sandal', 'shirt', 'sneaker', 'bag', 'ankle boot']
    return [text_labels[int(i)] for i in labels]
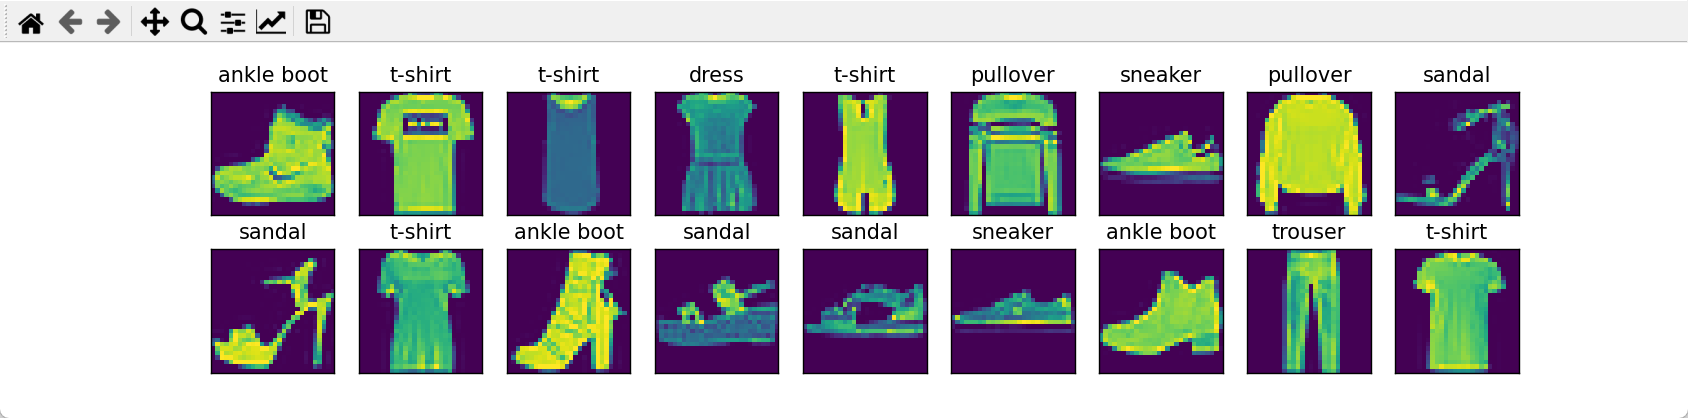
1.3可视化样本
仍然不用d2l选择, 用PyTorch自带的工具matplotlib。
import os
os.environ['KMP_DUPLICATE_LIB_OK'] = 'True'

import matplotlib.pyplot as plt
import torch

def show_images(imgs, num_rows, num_cols, titles=None, scale=1.5):
    """绘制图像列表"""
    figsize = (num_cols * scale, num_rows * scale)
    _, axes = plt.subplots(num_rows, num_cols, figsize=figsize)
    axes = axes.flatten()
    for i, (ax, img) in enumerate(zip(axes, imgs)):
        if torch.is_tensor(img):
            # 图片张量
            ax.imshow(img.numpy())
        else:
            # PIL图片
            ax.imshow(img)
        ax.axes.get_xaxis().set_visible(False)
        ax.axes.get_yaxis().set_visible(False)
        if titles:
            ax.set_title(titles[i])
    plt.show()  # 添加这行来显示图像
    return axes
运行结果:
二、读取小批量
batch_size = 256

def get_dataloader_workers():  #@save
    """使用4个进程来读取数据"""
    return 4

train_iter = data.DataLoader(mnist_train, batch_size, shuffle=True,
                             num_workers=get_dataloader_workers())
以上是一个常用的加载器,我们通常通过它来读取小批量数据。
通过内置数据迭代器,我们可以随机打乱了所有样本,从而无偏见地读取小批量。
而且使用多进程可以提高cpu的利用率。
三、一站式加载工具
接下来我们常常要用到Fashion-MINIST数据集,每次我们都要像刚才上面那样写代码加载吗?编程有一个重要的思想,那就是不要重复造轮子。
于是,我们想到了,把加载数据集写成一个方法,那是不是可以直接使用了。
Fashion-MNIST数据集的一站式加载工具:
def load_data_fashion_mnist(batch_size, resize=None):  #@save
    """下载Fashion-MNIST数据集,然后将其加载到内存中"""
    trans = [transforms.ToTensor()]
    #设置图像大小
    if resize:
        trans.insert(0, transforms.Resize(resize))
    trans = transforms.Compose(trans)
    #数据集
    mnist_train = torchvision.datasets.FashionMNIST(
        root="../data", train=True, transform=trans, download=True)
    mnist_test = torchvision.datasets.FashionMNIST(
        root="../data", train=False, transform=trans, download=True)
    #返回数据加载器
    return (data.DataLoader(mnist_train, batch_size, shuffle=True,
                            num_workers=get_dataloader_workers()),
            data.DataLoader(mnist_test, batch_size, shuffle=False,
                            num_workers=get_dataloader_workers()))
四、数据加载功能类
既然已经把加载工具写成了一个方法,为什么用软件工程的思想把它封装成一个类呢?
如下,数据加载功能类:
import platform
import torchvision
from torchvision import transforms
from torch.utils import data


class FashionMNISTDataLoader:
    """Fashion-MNIST数据加载器类"""

    def __init__(self, root="../data", batch_size=256, resize=None):
        """
        初始化数据加载器

        Args:
            root: 数据存储路径
            batch_size: 批次大小
            resize: 图像调整大小,例如 (64, 64)
        """
        self.root = root
        self.batch_size = batch_size
        self.resize = resize
        self.transforms = self._build_transforms()

    def _build_transforms(self):
        """构建数据转换流水线"""
        trans = [transforms.ToTensor()]
        if self.resize:
            trans.insert(0, transforms.Resize(self.resize))
        return transforms.Compose(trans)

    @staticmethod
    def get_dataloader_workers():
        """根据环境返回合适的worker数量"""
        if platform.system() in ['Windows', 'Darwin']:  # Windows或macOS
            return 0  # 在这些系统上多进程可能有问题
        else:
            return 4  # Linux系统通常可以正常工作

    def load_datasets(self):
        """加载数据集"""
        self.train_dataset = torchvision.datasets.FashionMNIST(
            root=self.root, train=True, transform=self.transforms, download=True)
        self.test_dataset = torchvision.datasets.FashionMNIST(
            root=self.root, train=False, transform=self.transforms, download=True)
        return self.train_dataset, self.test_dataset

    def create_dataloaders(self):
        """创建数据加载器"""
        if not hasattr(self, 'train_dataset'):
            self.load_datasets()

        train_loader = data.DataLoader(
            self.train_dataset, self.batch_size, shuffle=True,
            num_workers=self.get_dataloader_workers())

        test_loader = data.DataLoader(
            self.test_dataset, self.batch_size, shuffle=False,
            num_workers=self.get_dataloader_workers())

        return train_loader, test_loader

    def get_sample_batch(self, num_samples=18):
        """获取一个样本批次用于可视化"""
        train_loader, _ = self.create_dataloaders()
        X, y = next(iter(train_loader))
        return X[:num_samples], y[:num_samples]
码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 14
 0
- 0


 已为社区贡献20条内容

所有评论(0)