【第十六周】机器学习笔记05
摘要
本文介绍了逻辑回归的决策边界及其计算方法,通过可视化示例展示了不同参数下决策边界的变化。同时,探讨了逻辑回归的代价函数,解释了为什么平方误差函数不适用于逻辑回归,并提出了更适合的凸代价函数,以优化模型训练过程。
Abstract
This article explains the decision boundary in logistic regression and its calculation method, using visual examples to demonstrate how the decision boundary changes with different parameters. It also explores the cost function for logistic regression, detailing why the squared error function is unsuitable and introducing a more appropriate convex cost function to optimize the model training process.
一、决策边界
现在让我们看看决策边界,以更好的理解逻辑回归如何计算,回顾一下,逻辑回归模型的输出是通过两个步骤计算。
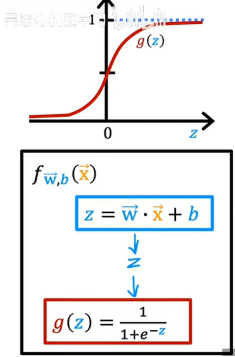
在第一步中,我们计算z即w点积x加b,然后我们把算出来的z应用到sigmoid函数g。
现在,如果我们想让学习算法进行预测,y的值是0还是1?
我们可能会做的一件事是设定一个阈值,超过这个值我们的预测就为1,低于这个值我们就预测为0,一个常见的选择是选择0.5作为阈值。
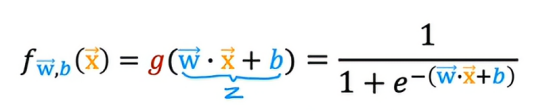
我们都知道f(x)=g(z),如果f大于或等于0.5,只需要g(z)大于或等于0.5,g(z)大于等于0.5当且仅当z大于0或等于0,也就是说,只要z在这个轴的右半部分,又因为z等于w乘以x加b,所以只要w乘以x加b大于或等于0,z就大于等于0。
所以总结一下,我们看到的是模型在w乘以x加b大于等于0时预测为1,反过来,当w乘以x加b小于0时,算法预测y为0,所以在了解这一点后,我们可以可视化模型如何进行预测,我们将举一个分类问题的例子,其中有两个特征,x1和x2
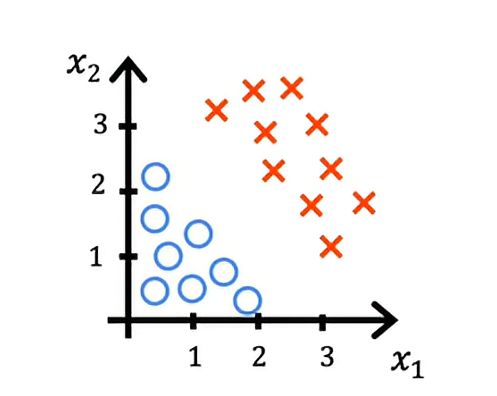
上图是一个训练集,小红叉表示正例而小篮圈表示负例,所以红叉对应y等于1,篮圈等于y等于0,逻辑回归模型将使用这个函数来预测,其中z现在是这个表达式
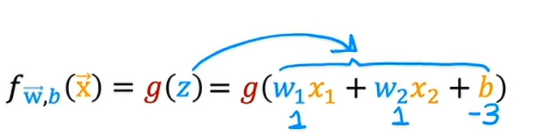
因为我们有2个特征,x1和x2,假设在这个例子中,参数的值w1等于1,w2等于1,b等于-3,现在我们来看看逻辑回归是怎么预测的,特别要注意何时wx加b大于等于0以及何时wx加b小于0 ,为了解决这个问题,我们需要看一条非常有趣的线,就是当wx加b正好等于0的时候
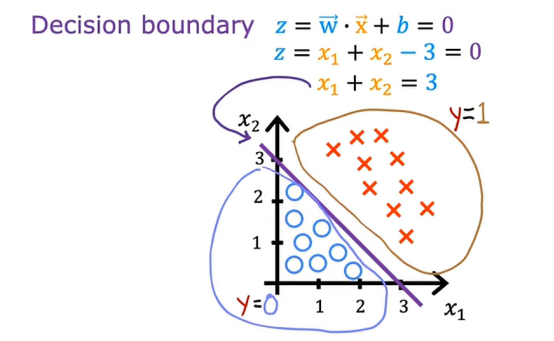
事实证明,这条线也被称为决策边界,因为这是你几乎对y是0还是1比较暧昧的位置,现在对于我们上面写下的参数w1,这个决策边界是x1加x2减3,如果特征x这条线的右边,逻辑回归就会预测y=1,如果特征在这条线的左边,逻辑回归就会预测y=0,换句话说,我们刚刚可视化的就是当参数w1、w2、b分别是1、1和-3时的逻辑回归的决策边界,当然,如果我们选择了不同的参数,决策边界将是另外一条线
现在我们来看一个更复杂的例子,其中决策边界不再是一条直线,
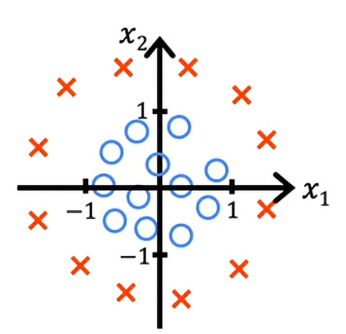
和之前一样 叉号表示类别y等于1,小圆圈表示类别y等于0,之前我们看到了如何在线性回归中使用多项式,我们也可以在逻辑回归中这样做,所以我们设z为w1 x1的平方加上w2 x2的平方加上b,在这种将多项式特征应用于逻辑回归的选择下,所以f(x)应该是这样
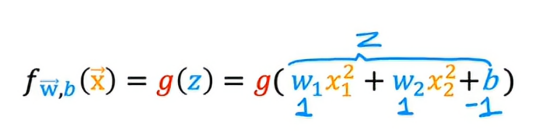
我们假设w1=1,w2=1,b= -1
所以z的方程如下
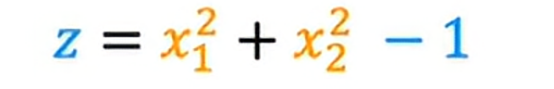
寻找决策边界和之前一样,z=0即为决策边界,化简上式,即为
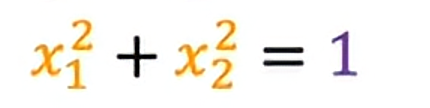
将决策边界绘制到刚刚初始的图上
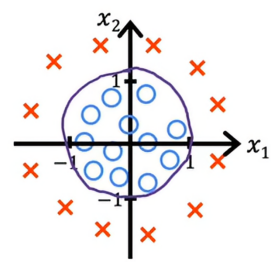
当x1的平方加上x2的平方大于或等于1时,即在红色小叉的范围内,这里逻辑模型预测的是y=1,当x1的平方加上x2的平方小于1时,即在蓝色小圈的范围内,这里逻辑模型预测是y=0
其实我们还能提出更加复杂的决策边界
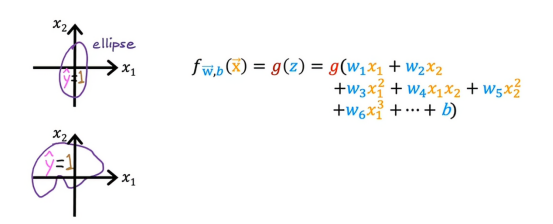
因为数据有时候不会呈现的很简单,往往需要复杂的决策边界而不是简单的圆和直线,举这些例子就是希望我们能对逻辑回归可能得到的模型范围有了一个概念。
二、逻辑回归的代价函数
成本函数为我们提供了一种衡量特定参数集与训练数据适合度的方法,现在我们来讨论我们之前埋下的疑问,为什么平方误差成本函数不是逻辑回归的理想成本函数,并且我们还要为逻辑回归选择更好参数的不同成本函数。
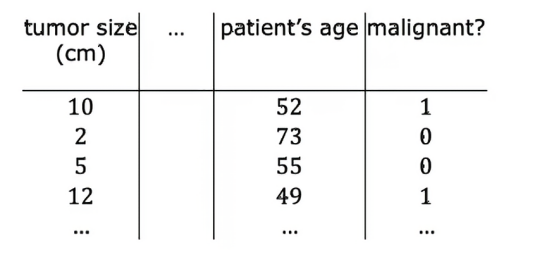
这是逻辑回归模型的训练集可能的样子,这里每一行可能对应一个去看医生并得到诊断的患者,如前所述,我们用m表示训练样本的数量,每个训练样本都有一个或多个特征 ,比如肿瘤大小、患者年龄等,因此我们将这些特征称为x1到xn,目标标签只有2个取值,即y=0或y=1,最后逻辑回归模型通过这个方程定义
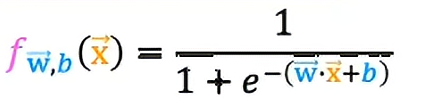
所以我们想要回答的问题是,我们如何选择参数w和b,回顾线性回归,我们唯一要改变的是把二分之一放在求和符号之后而不是外面
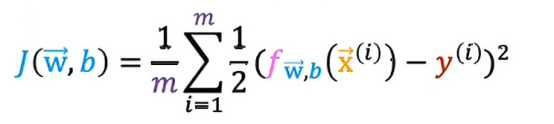
我们都知道,在线性回归中,f(x)是线性函数w点乘x加b
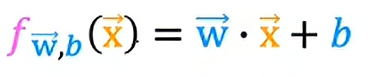
而成本函数看起来像这样
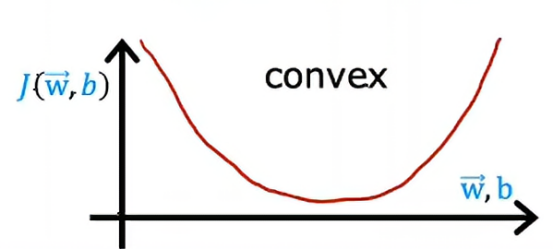
这是一个凸函数,只有一个局部最小值,我们一步一步运行成本函数,最终我们会达到局部最小值,现在我们可以尝试使用相同的成本函数进行逻辑回归
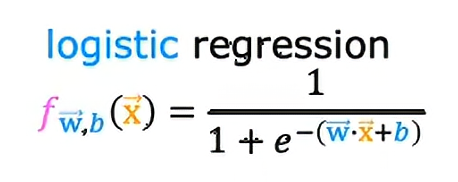
但事实证明,如果我们将f(x)写作这样,并使用f(x)来绘制图像,则成本函数如下图所示
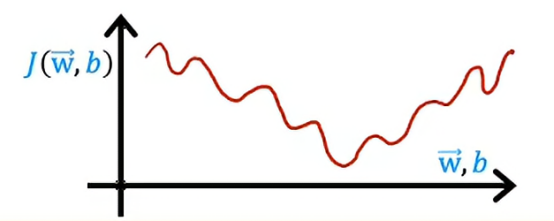
这就成为了所谓的非凸成本函数,从图中我们可以看出来,这个成本函数拥有多个局部最小值,这样我们无法达到最合适的局部最小值。所以这个平方误差成本函数并不是一个很好的选择,相反,会有一个不同的成本函数,可再次使成本函数凸起,这样梯度下降才能保证收敛到全局最小值。
为了建立一个新的成本函数,我们将稍微改变成本函数j(w)和b的定义,特别的,如果我们看一下求和符号里面,我们称下式为单个训练实例的内部损失
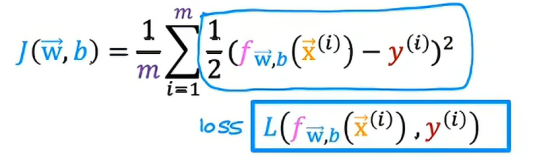
我们将通过这个大写的L来表示损失,它是学习算法的预测f(x)的函数,因此,给定预测f(x)和真实标签y的损失,在这种情况下等于二分之一的平方差,我们很快能看到,通过选择不同形式的这个损失函数,即这些损失函数之和的1/m,现在,损失函数输入f(x)和真实标签y告诉我们在这个实例上表现如何,我们直接在这里写下用于逻辑回归的损失函数定义
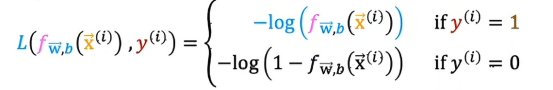
让我们来看一下为什么这个损失函数有意义
首先看y=1的情况并绘制这个函数的图像,以获得这个函数的直观感觉,请注意,损失函数衡量的是单个训练样本的表现,通过对所有训练样本的损失求和,我们可以得到代价函数,它衡量的是整个训练集的表现,所以当我们绘制log(f(x)),它看起来像这条曲线
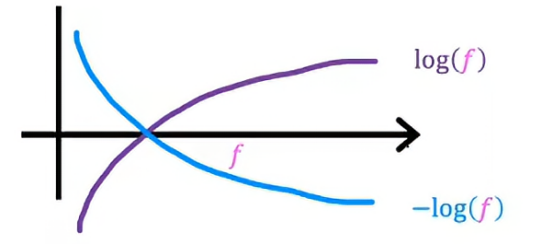
-log(f)这是将图像绕x翻转了一下,现在f是逻辑回归的输出,因此f总是在0和1之间,因为逻辑回归总是在0到1之间,所以函数只作用一部分,我们部分放大来看
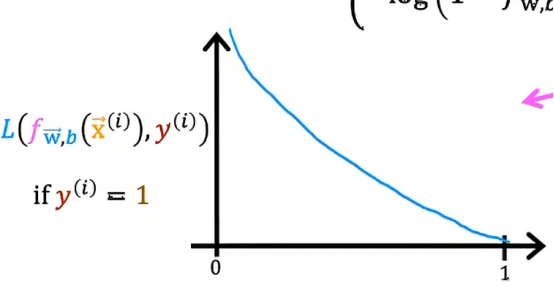
如果算法的预测概率接近1,而真实标签是1,那么损失就会非常小,因此我们是非常接近正确答案。
我们继续来讨论y=1的情况,如果算法预测为0.5,那么损失在这里
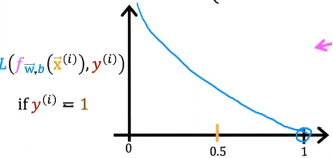
这个值稍微高一点,但不是特别高,如果算法输出为0.1时,,它认为肿瘤是恶性肿瘤的概率只有10%,但y确实是1并且它确实是恶性的,所以当y=1时,损失函数会帮助算法做出更加准确的预测,因为当预测值接近1时的损失是最低的
现在我们来看损失函数对应等于0的第二部分,在这种情况下,损失是负的log(1-f(x)),当这个函数被绘制出来时,f的范围被限制在0到1之间
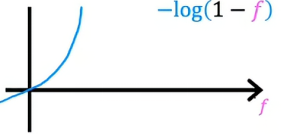
因为逻辑回归只输出0到1之间的值,如果我们放大来看的话,它是这样的
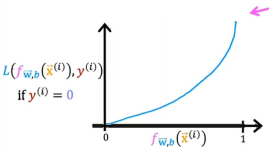
当f是0或者非常接近0的时,损失会非常小,那么我预测的基本没有任何损失,而且f(x)的值越大,损失越大,因为预测与真实标签0越远,当输出预测为0的话,这个损失实际上趋向于无限大,回到肿瘤预测的例子,这意味着如果模型预测患者的肿瘤几乎肯定是恶性的,但实际上又不是恶性的,因为y是等于0的,那么我们就需要非常严重的损失来惩罚模型,所以在y=0的情况下,类似于y=1的情况,预测值f(x)离y的真实值越远,损失越高。以这个例子来看的话,如果y=0,那么算法就被强烈要求不要预测接近1的值
1、逻辑回归的简化版代价函数
在上一小节,我们看到了逻辑回归的损失函数和成本函数,在本小节中,我们会看到一种稍微简单的方法来写出损失函数和成本函数,这样实现起来当我们使用梯度下降来拟合逻辑回归模型的参数时,这样实现起来会更加简单一些
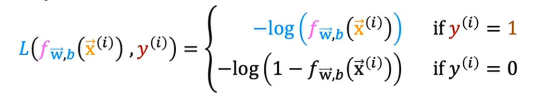
这是我们上一节讨论出来的损失函数公式,因为现在我们仍然在处理一个二元分类问题,所以y的取值只能是0或者1并且不能取其他的值,我们能够选择一个更加简单办法来写这个损失函数,我们可以按如下方式写出损失函数
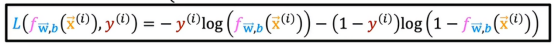
这里写出的公式完全等同于上面那个公式,无论y=0或y=1,这个式子都会消除掉另外一个情况的式子,这样我们讨论的时候就可以同时带入两个情况
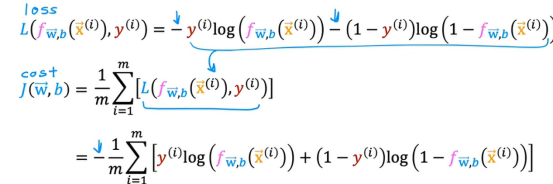
我们把简化后的的损失函数代入到逻辑回归函数当中就是上图的公式
在这里得提醒一下,这个特定得代价函数是根据统计学原理推导得,叫做最大似然估计,这个函数有个很好的属性,它是凸的。
总结
逻辑回归通过计算加权输入并应用Sigmoid函数得到预测概率,以0.5为阈值进行分类。决策边界由参数决定,可以是直线或曲线(如圆形),适应不同数据分布。平方误差代价函数在逻辑回归中会导致非凸优化问题,难以收敛到全局最优。因此,采用基于对数损失的代价函数,确保凸性并使梯度下降有效。该函数在预测与真实标签差异较大时惩罚更大,推动模型更准确分类。简化后的损失函数结合了两种情况(y=0和y=1),便于实现和优化。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 11
 0
- 0


 已为社区贡献6条内容

所有评论(0)