上下文工程:优化智能体性能的关键策略,大模型入门到精通,收藏这篇就足够了!
智能体在执行长期任务时,上下文窗口(类似计算机的RAM)的容量有限,易导致性能下降、成本飙升或幻觉问题。上下文工程正是为解决这些问题而生。它通过精心筛选、存储和优化上下文信息,确保智能体高效运行。
本文将基于核心概念、挑战和策略,详细拆解上下文工程的实践方法,如果对你有所帮助,记得点个小红心,告诉身边有需要的朋友。
一. 上下文工程的核心概念
大型语言模型(LLMs)可视为一种新型操作系统:LLM是中央处理器(CPU),上下文窗口则是工作内存(RAM)。与RAM类似,上下文窗口容量有限(如GPT-4的128K token上限),无法容纳所有来源信息。上下文工程的目标是为每个智能体运行步骤填充“恰到好处”的信息——不多不少,刚好够用。这不仅涉及指令(如提示词和工具描述)、知识(如事实和记忆),还包括工具调用的反馈。

在智能体架构中,上下文工程尤其关键。智能体通过“LLM调用—工具调用—工具反馈”循环处理任务。例如,一个代码生成智能体可能先调用LLM解析需求,再调用搜索工具获取API文档,最后将反馈注入下一轮LLM推理。在项目实践中,Anthropic的Claude和OpenAI的GPT系列都强调,上下文管理是智能体设计的“首要工作”(源自Anthropic技术博客)。忽略它会导致成本失控——长期任务中,token消耗可增长15倍以上。
二. 智能体上下文管理的挑战
当智能体执行数百轮交互时,工具反馈的累积会迅速耗尽上下文窗口,引发四大问题:
- 上下文污染(Context Poisoning):幻觉信息混入上下文,误导后续决策。
- 上下文干扰(Context Distraction):过量信息超出模型训练范围,降低响应质量。
- 上下文混淆(Context Confusion):冗余或重叠内容(如相似工具描述)导致模型混淆。
- 上下文冲突(Context Clash):矛盾信息(如不同来源的事实)使智能体行为不一致。

这些问题在代码智能体(如GitHub Copilot)或问答系统中尤为常见。例如,Hugging Face的报告显示,未优化的上下文管理可使延迟增加200%,成本上升50%。所以在解决方案中我们强调“预防优于修复”:通过监控token使用率(如Claude Code的95%阈值告警)和动态调整,避免窗口溢出。
三. 上下文工程的四大策略
基于研究和全网实践,上下文工程可归纳为四类策略:写入、选择、压缩和隔离。每种策略针对不同场景,结合使用可大幅提升智能体效率。
3.1 写入上下文(Write Context)
写入上下文将关键信息存储在上下文窗口外,供智能体按需调用,避免窗口拥堵。核心方法包括:
- 便签本(Scratchpads):类似人类笔记,智能体在运行时将临时信息(如任务计划)持久化到外部存储(如文件或数据库)。Anthropic的多智能体系统展示了其价值:子智能体将探索计划存入“记忆”字段,确保核心逻辑不被截断。实现时,可通过工具调用(如Python的
open().write())或运行时状态对象实现。 - 记忆(Memories):跨会话复用信息,分为三类:
- 语义记忆:存储事实(如用户偏好),用于个性化智能体。
- 情节记忆:记录过往行为(如成功案例),作为少样本示例。
- 程序记忆:保存指令模板(如
CLAUDE.md文件),引导行为一致性。

在我看过的一些案例中,ChatGPT的“长期记忆”功能自动合成用户交互历史,而Reflexion框架通过反思机制生成可复用的记忆库。但大家需注意:记忆索引依赖嵌入(Embeddings)或知识图谱,但检索失误(如ChatGPT意外注入位置信息)会引发隐私风险——建议添加重排序层(如BERT-based reranker)提升相关性。
3.2 选择上下文(Select Context)
选择上下文从外部源拉取相关信息填充窗口,减少不必要负载。关键技巧包括:
- 便签本选择:智能体通过工具调用读取便签本内容,大家可精细控制暴露字段(如仅共享任务相关状态)。
- 记忆选择:针对记忆类型动态检索。例如,代码智能体Windsurf结合grep搜索、AST解析和知识图谱,仅拉取高相关性代码片段,将检索准确率提升3倍。
- 工具选择:工具过多时,模型易混淆。解决方案是RAG增强——仅检索与当前任务匹配的工具描述。全网数据显示,这可将工具调用准确率从60%提升至90%。

实践中,LangChain的RetrievalQA模块支持实时索引更新,避免静态规则失效。这里提醒一下:选择算法需平衡召回率与精度——过度依赖嵌入搜索会导致规模扩展问题。
3.3 压缩上下文(Compress Context)
压缩上下文通过总结或修剪减少token占用,保持窗口精简:
- 总结(Summarization):递归或分层提炼长上下文。Claude Code的“自动压缩”功能在窗口满载时总结交互轨迹,保留关键事件。Cognition的多智能体系统则在知识交接点微调总结模型,确保信息保真度。

- 修剪(Trimming):硬编码规则(如移除旧消息)或训练型修剪器(如Provence)过滤低价值内容。德鲁·布赖尼格的研究表明,修剪可降低30% token消耗,但需设置白名单保护关键指令。
3.4 隔离上下文(Isolate Context)
隔离上下文拆分窗口,处理独立子任务:
- 多智能体(Multi-agent):子智能体拥有专用上下文、工具和指令。Anthropic实验证明,隔离后性能提升40%,因每个子智能体聚焦特定问题(如一个处理搜索,另一个生成代码)。OpenAI的Swarm库通过协调层管理通信,避免tokens激增。

- 基于环境的隔离:Hugging Face的CodeAgent在沙箱中运行工具,仅将返回值传回LLM。例如,图像处理工具的输出存储在环境变量中,隔离大对象(如音频文件),减少窗口污染。

LangGraph框架原生支持状态对象Schema,允许字段级隔离。这里建议:多智能体虽高效,但需设计负载均衡(如Round-robin调度),防止少数智能体过载。
四. 一些建议与总结
上下文工程是智能体优化的基石。在实践时,各位需要注意以下几点:
- 评估需求:短期任务用选择/压缩;长期任务加写入/隔离。
- 工具链整合:LangGraph提供策略原生支持,结合Hugging Face或OpenAI API。
- 监控指标:跟踪token使用率、准确率延迟,设置阈值告警。
通过以上策略,上下文工程将释放智能体潜力——让AI像人类一样高效“思考”,而非淹没在信息洪流中。好了,今天的分享就到这里,点个小红心,你的鼓励就是我更新的动力,我们下期见。
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
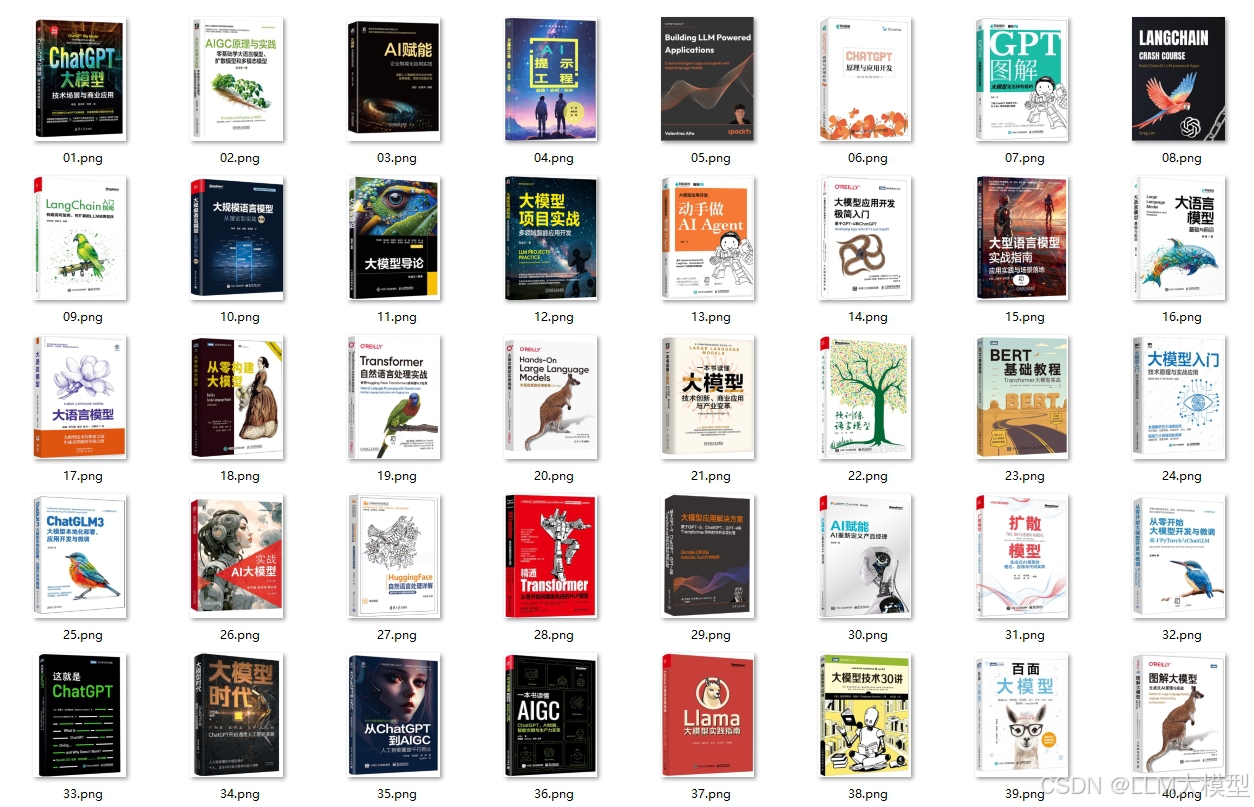
1. 100+本大模型方向电子书
2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
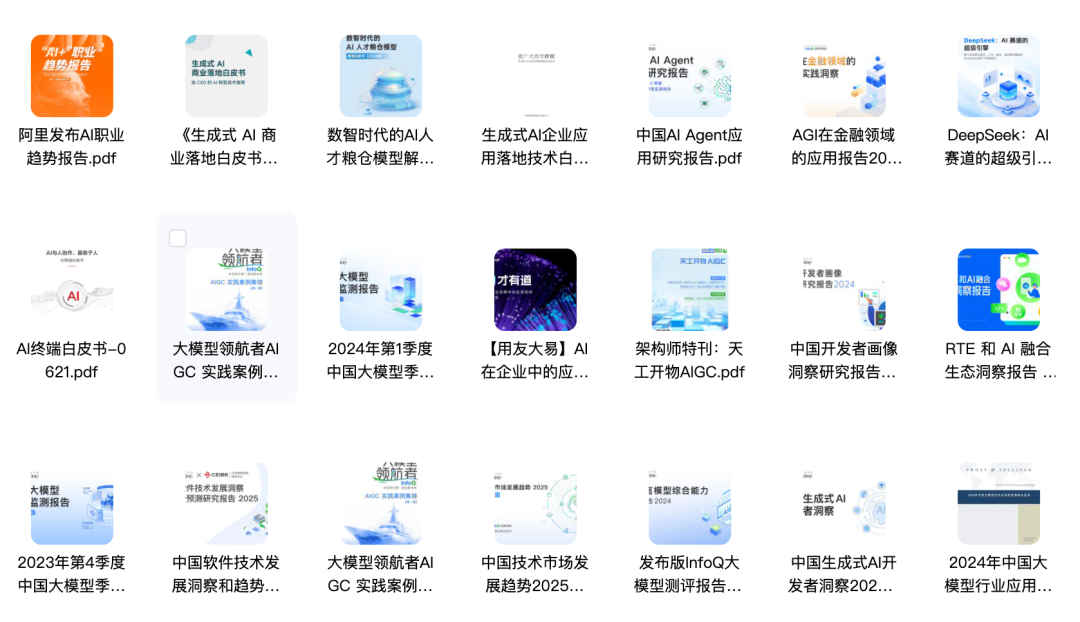
- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
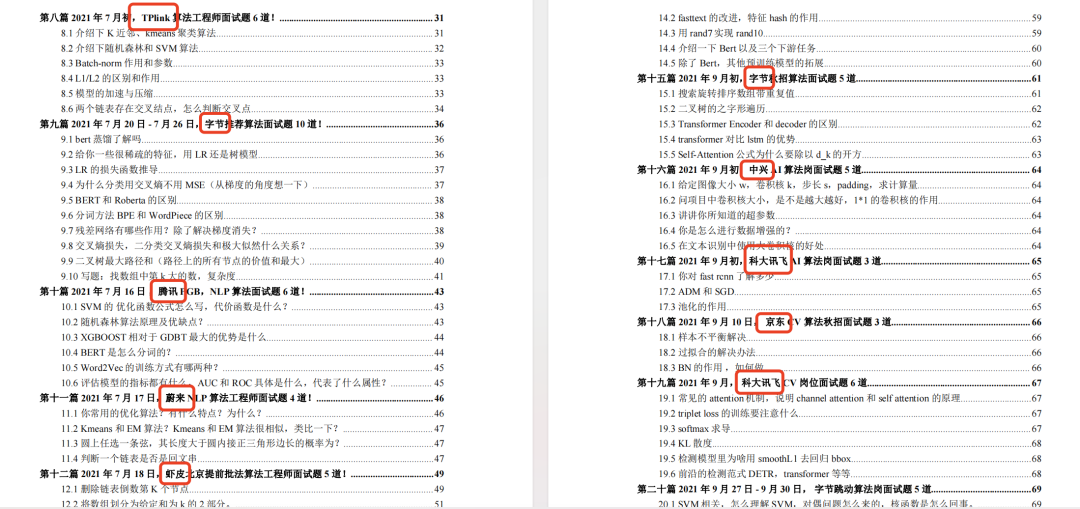
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
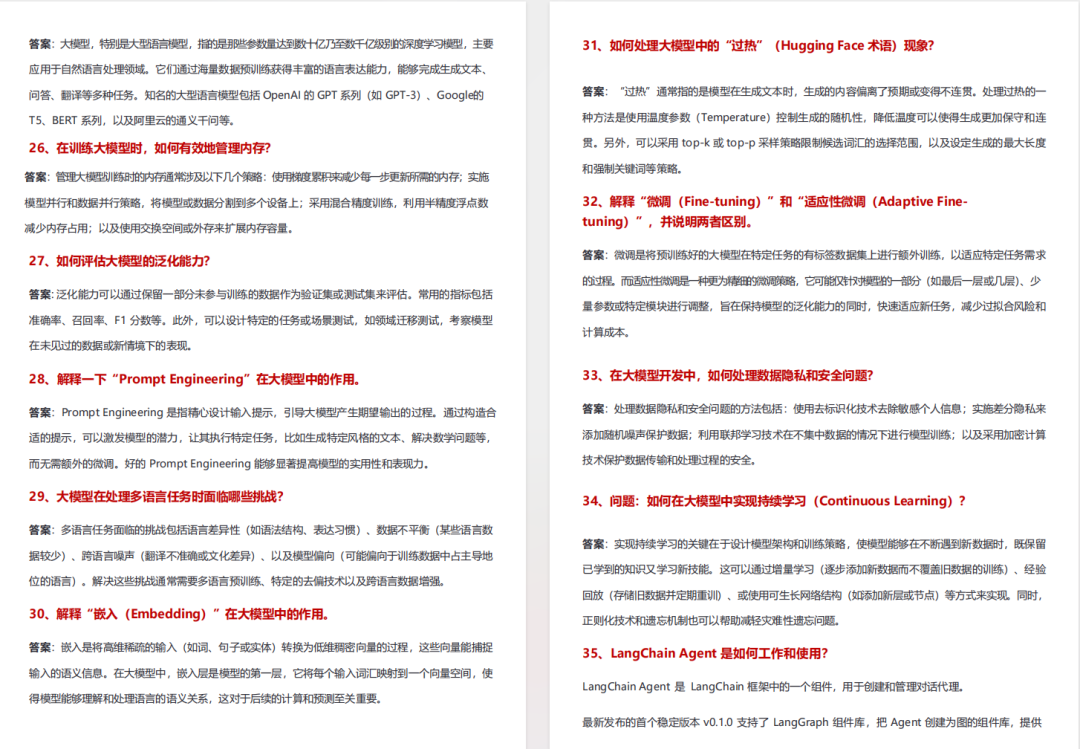
2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
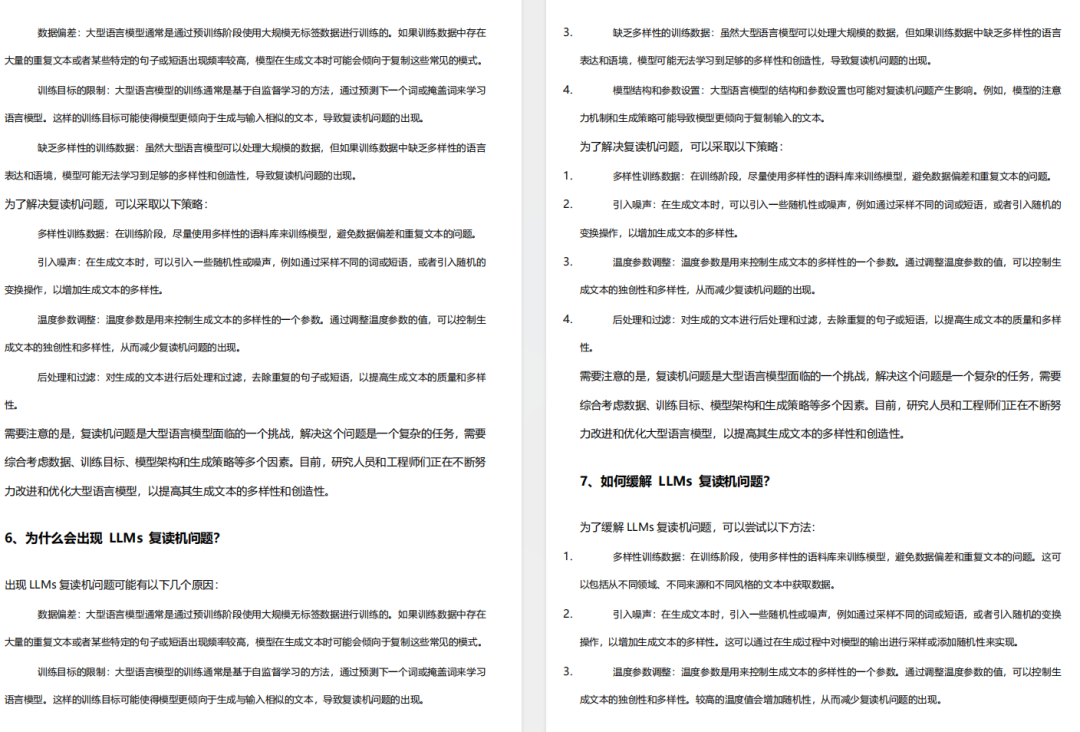
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
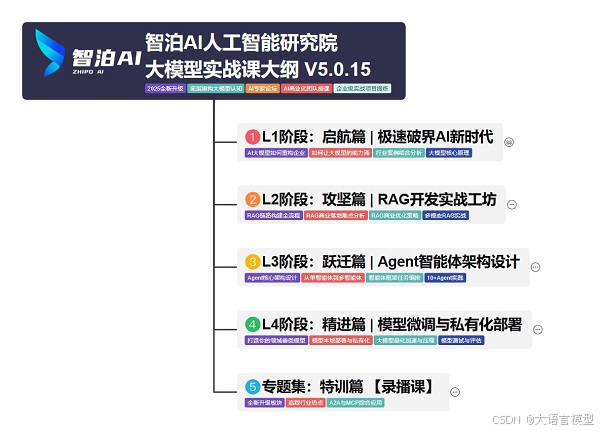
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
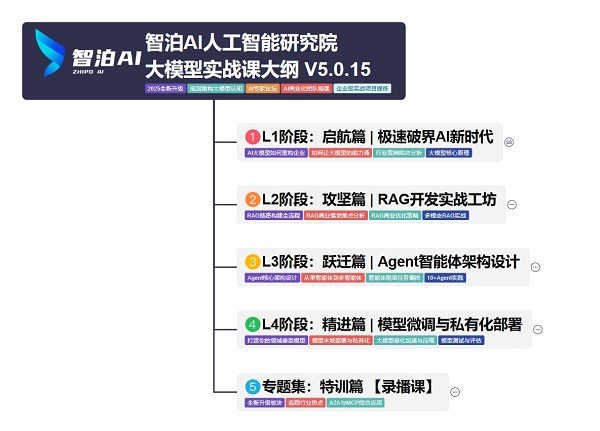
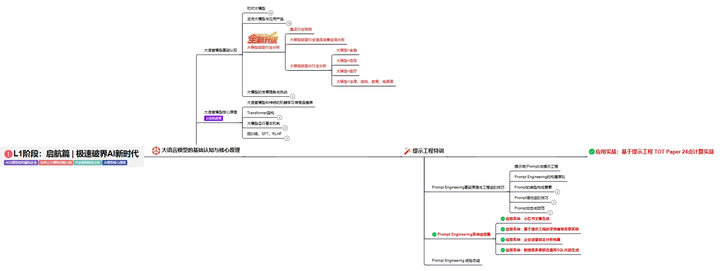
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
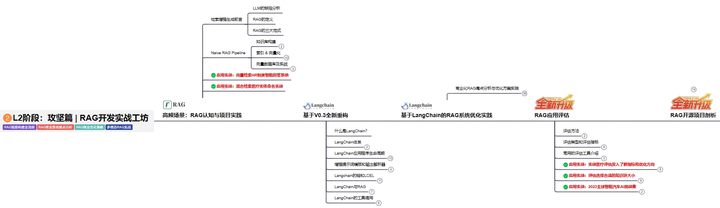
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
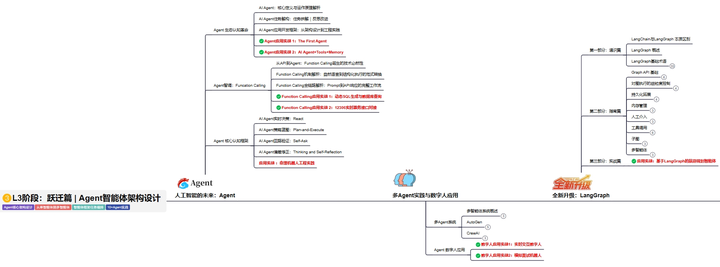
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
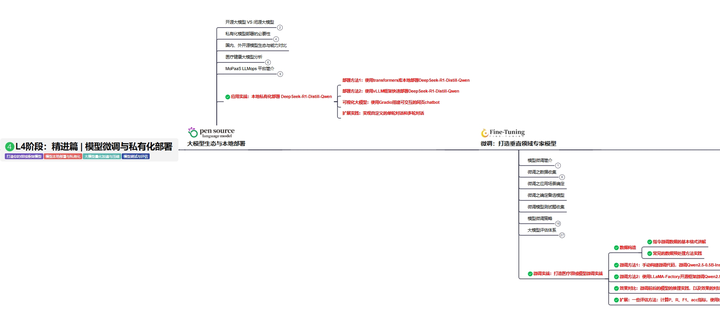
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
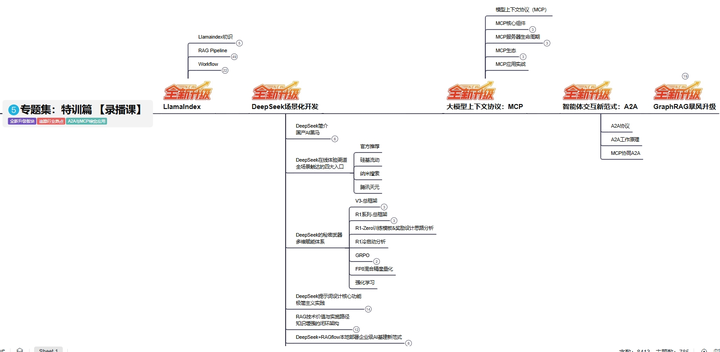
L5阶段:专题集丨特训篇 【录播课】
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 23
 0
- 0


 已为社区贡献241条内容

所有评论(0)