神经网络与深度学习(第一章笔记)
基础要求(学习前提):
在我个人看来还是得学会使用一些基本的工具,基本的编程知识,数学基础。
基本工具:学会使用conda,conda主要是包管理工具,可用于创建虚拟环境,其实也可以去了解一下mamba (conda的加速工具,可提高包管理和环境创建的速度。)
数学基础:微积分(常见的求解偏导数,积分,微分公式即可),线性代数,概率论,信息论。
编程基础:python(这里推荐莫烦的python教程和廖雪峰的python教程)
莫烦b站视频(极速的入门Python):http://【【莫烦Python】Python 基础教程】 https://www.bilibili.com/video/BV1wW411Y7ai/?share_source=copy_web&vd_source=79d02fc68acada1752b980d2692702af
廖雪峰python文档:https://liaoxuefeng.com/books/python/introduction/index.html
当然你也可以学习一下廖雪峰的其他教程。
IDE按照个人习惯使用,我更推荐PyCharm,其实vscode也行,就是不是老手用起来比较难受,综合性上vscode更好用。
在学习之前建议先去看一下:鱼书(《深度学习入门:基于Python的理论与实现》)
推荐教材:邱锡鹏,《神经网络与深度学习》https://nndl.github.io/
推荐的课程:(去油管上基本可以搜索到)
斯坦福大学:CS224n:Deep Learning for Natural Language Processing
(自然语言处理领域的各种深度学习模型)
斯坦福大学:CS231n:Convolutional Neural Networks for Visual Recognition
(主要讲解CNN,RNN在图像领域的应用)
伯克利大学:CS294:Deep Reinforcement Learning(深度强化学习)
最重要的一点:关注前沿的论文。
1.绪论
该部分内容属于人工智能的子领域内容
神经网络:一种以(人工)神经元为基本单元的模型。
深度学习:一类机器学习问题,主要解决贡献度分配问题。
tip:深度学习本身就是一种基于神经网络的机器学习方法。深度学习是神经网络的"深度版本",强调网络的深度(层数),通过多层结构来学习更复杂的特征;而神经网络是一个更广泛的概念,包括了浅层和深层的结构。深度学习是神经网络在特定条件下的应用,是神经网络的子集。
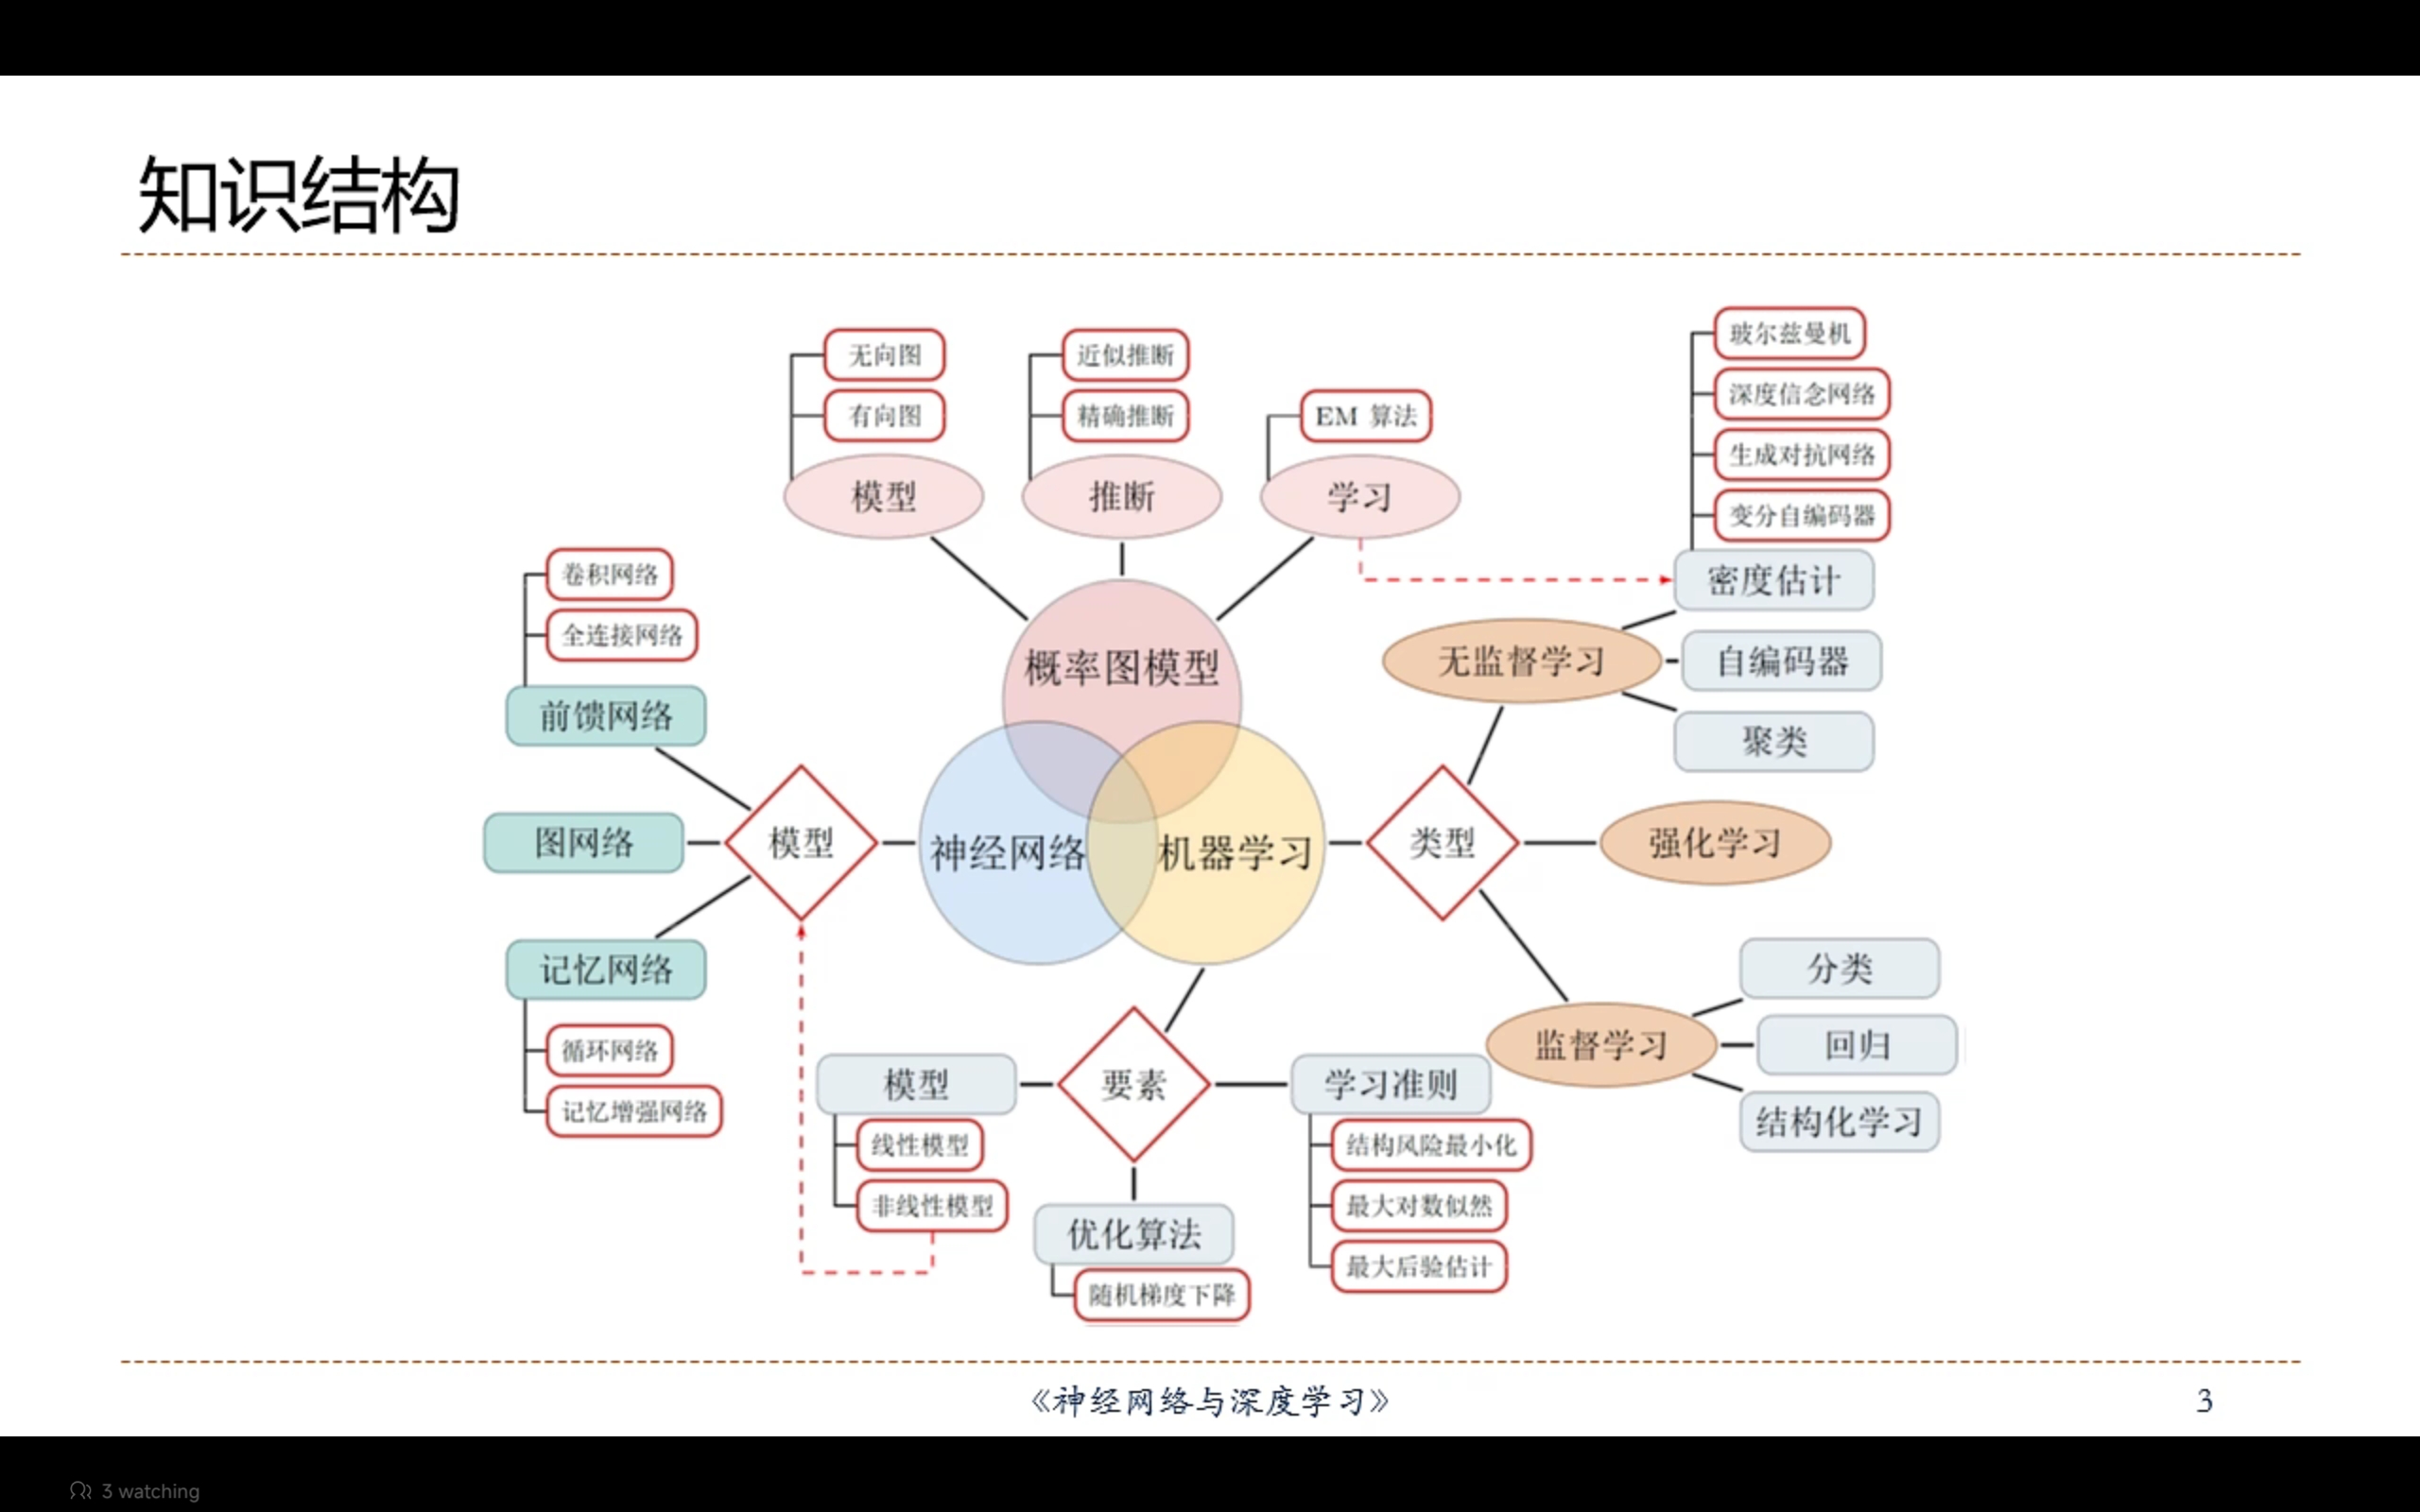
笔记主要来源于:复旦邱锡鹏老师
二维路线图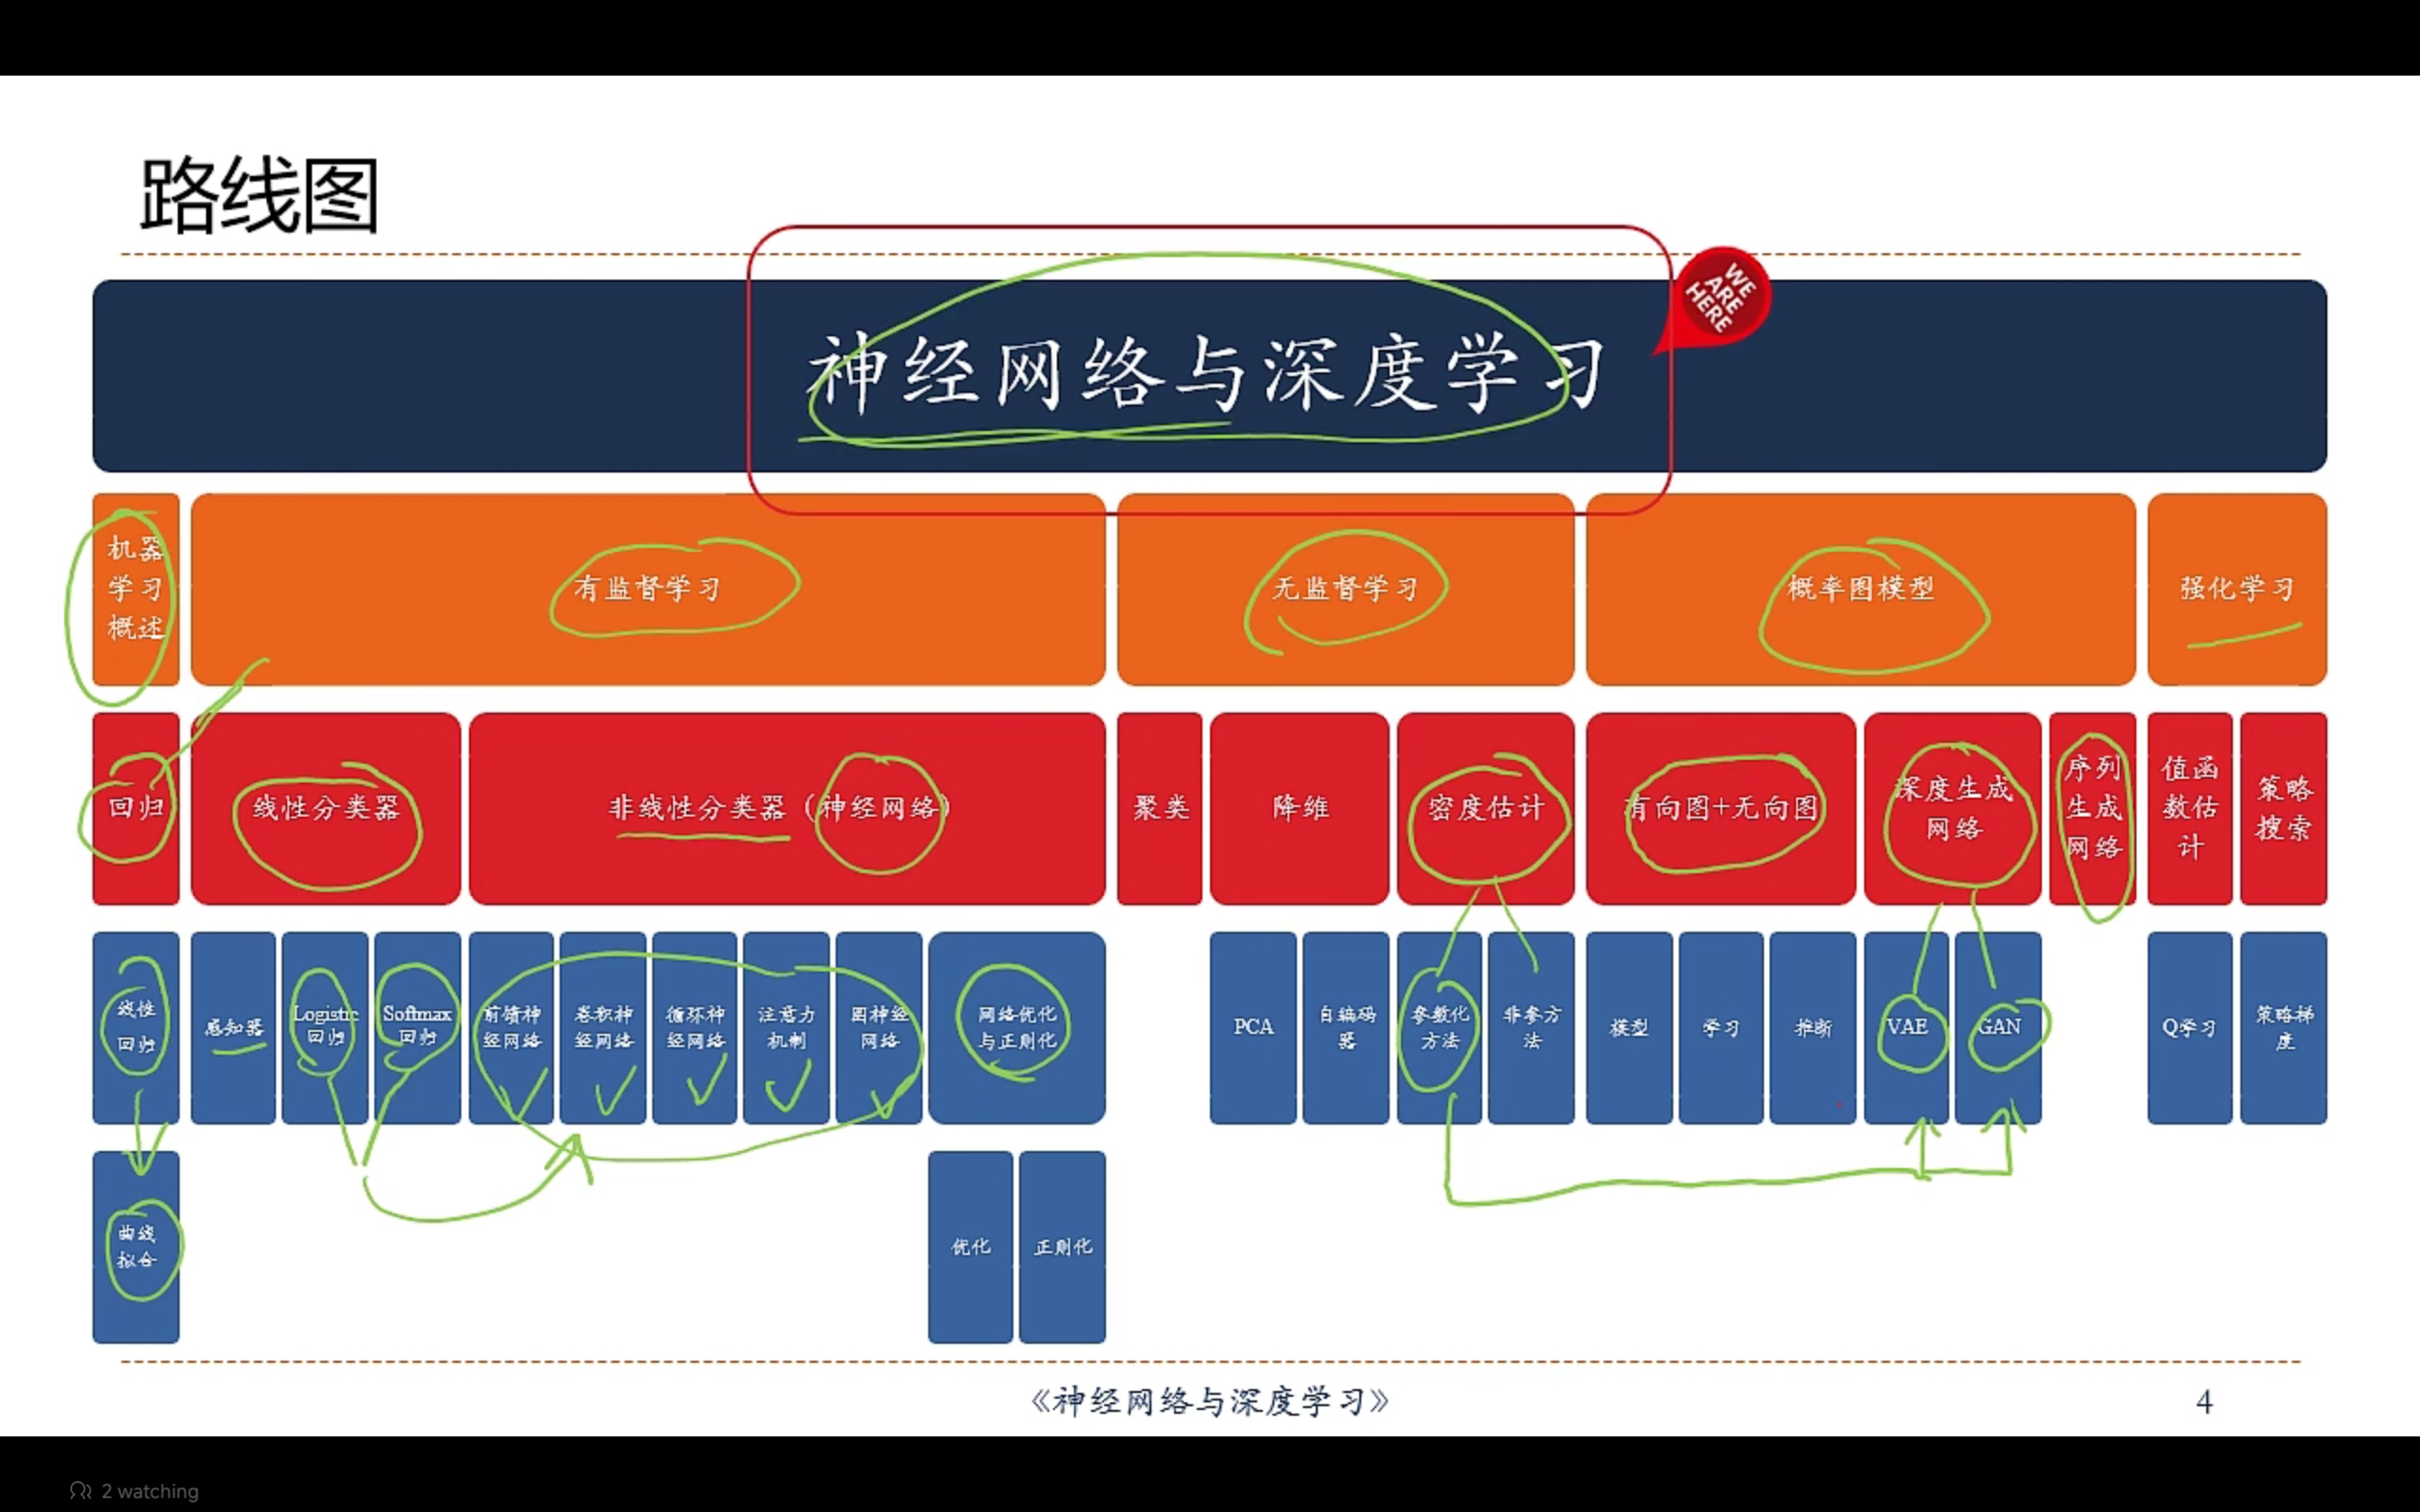
常用的深度学习框架:
1.简易和快速的原型设计
2.自动梯度计算
3.无缝CPU和GPU切换
4.分布式计算
推荐使用的框架:TensorFlow(TensorFlow 1.x 是基于静态计算图的框架,但TensorFlow 2.x 已经引入了动态执行机制。),PyTorch(最推荐使用框架),
PaddlePaddle(百度研发的框架)——>熟悉该框架可以参与百度举办的c4-ai大赛,MindSpore(华为研发)。
1.1人工智能
让机器具有人类的智能
“计算机控制”+“智能行为”
1.人工智能三大流派:
联结主义
内涵:模仿生物神经系统,通过学习实现知识与技能获取,核心是神经网络。该流派认为智能源于大量简单单元的连接与互动,通过调整连接权重来学习。
特点:
- 模拟人脑能力强
- 训练耗时大
- 缺乏可解释性
单一应用:
- 图像识别(如人脸识别、医学影像分析)
- 语音识别(如智能音箱的语音交互)
- 游戏AI(如AlphaGo的围棋决策)
符号主义
内涵:强调逻辑符号表达思维过程,通过"如果就"规则实现推理与决策。该流派认为智能源于对符号的操纵和逻辑推理。
特点:
- 逻辑清晰,易于解释
- 在处理模糊与不确定性方面存在困难
单一应用:
- 专家系统(如医疗诊断系统)
- 自然语言处理(如早期的语法分析器)
- 知识表示与推理(如逻辑推理引擎)
行为主义
内涵:侧重控制论与感知动作系统,通过训练与奖惩机制实现学习。该流派认为智能是与环境互动的结果,强调"行动-反馈"循环。(强化学习)
特点:
- 实时处理环境信息能力强
- 数据与计算需求大
- 应用范围相对有限
单一应用:
- 自动控制(如工业机器人)
- 机器人导航(如扫地机器人路径规划)
- 自动驾驶(早期的车辆控制算法)
现代AI系统中,单一流派往往难以满足复杂需求,因此综合应用成为主流
综合应用案例:
-
智能汽车系统:
- 联结主义:用于图像识别(如车辆检测、交通标志识别)
- 符号主义:用于逻辑推理(如驾驶规则判断、决策树)
- 行为主义:用于实时控制(如方向盘转向、刹车控制)
-
AI购车助手:
- 联结主义:用于多模态交互理解(语音、文本)
- 符号主义:用于知识库推理(车型参数匹配、用户需求分析)
- 行为主义:用于个性化推荐(根据用户反馈调整推荐策略)
-
智能客服系统:
- 联结主义:处理自然语言理解
- 符号主义:构建知识库进行逻辑推理
- 行为主义:根据用户反馈调整交互策略
图灵测试往往用于判断计算机是否具备智能,要使得计算机通过图灵测试,计算机必须具备理解语言、学习、记忆、推理、决策等能力。
2.人工智能研究领域
机器感知(计算机视觉、语音信息处理、模式识别)
学习(机器学习、强化学习)
语言(自然语言处理)
记忆(知识表示)
决策(规划、数据挖掘)
1.2如何开发人工智能系统
专家知识(人工规划):是非(例如人为划分两个区间)
机器学习:构建一个映射函数
芒果机器学习方法:
1.数据准备:
- 随机采集市场芒果样本作为训练数据
- 记录每个芒果的所有特征指标
- 基于特征构建相应的特征函数
2.学习:设计一个学习算法来学习芒果的特征与输出变量之间的相关模型。
3.测试:可以根据芒果(测试数据)的特征,使用前面计算的模型来预测芒果的质量。(注意不要使用训练集当测试集,这是不合规矩的)。
1.3表示学习
机器学习解决模式识别任务时,一般流程:
原始数据——>数据预处理——>特征提取——>特征转换——>预测——>结果
| 数据预处理——>特征提取——>特征转换 | 特征处理 |
| 预测 | 浅层学习 |
预测到结果:建模模型 x——>f——>y
特征工程(Feature Engineering):
是机器学习和数据科学中的一个关键步骤,指的是从原始数据中提取、构造、转换和选择对模型预测最有用的输入变量(即“特征”)的过程。
特征工程的本质是将原始数据转化为更适合机器学习模型理解和学习的形式,从而提升模型的性能(如准确性、泛化能力、训练效率等)。换句话说,它是将领域知识和数据理解转化为模型可利用的信号的过程。
【没有引进自动化机器学习(AutoML)之前,往往特征工程的工作是大量重复而感觉枯燥的,数据清洗、缺失值处理、异常值处理等】
特征工程重要性:
“垃圾进,垃圾出”(Garbage in, garbage out):即使使用最先进的模型,如果输入特征质量差,模型效果也会受限。(像我们做图像识别相关的模型,如yolo模型的训练,训练集人为去打标签,做出的数据集很差劲,那么训练出来的模型的识别效果当然也会很烂,这正是为什么有些时候需要花钱去购买高品质的数据集)
在很多实际场景中,特征工程对模型性能的提升远大于调参或换模型。
良好的特征能提升模型的可解释性、训练速度和泛化能力。
浅层学习(Shallow Learning):
不涉及特征学习,其特征主要靠人工经验或特征转换方法来抽取。
语义鸿沟(人工智能挑战之一):、
底层特征VS高层语义
人们对文本、图像的理解无法从字符串或者图像的底层直接获得。
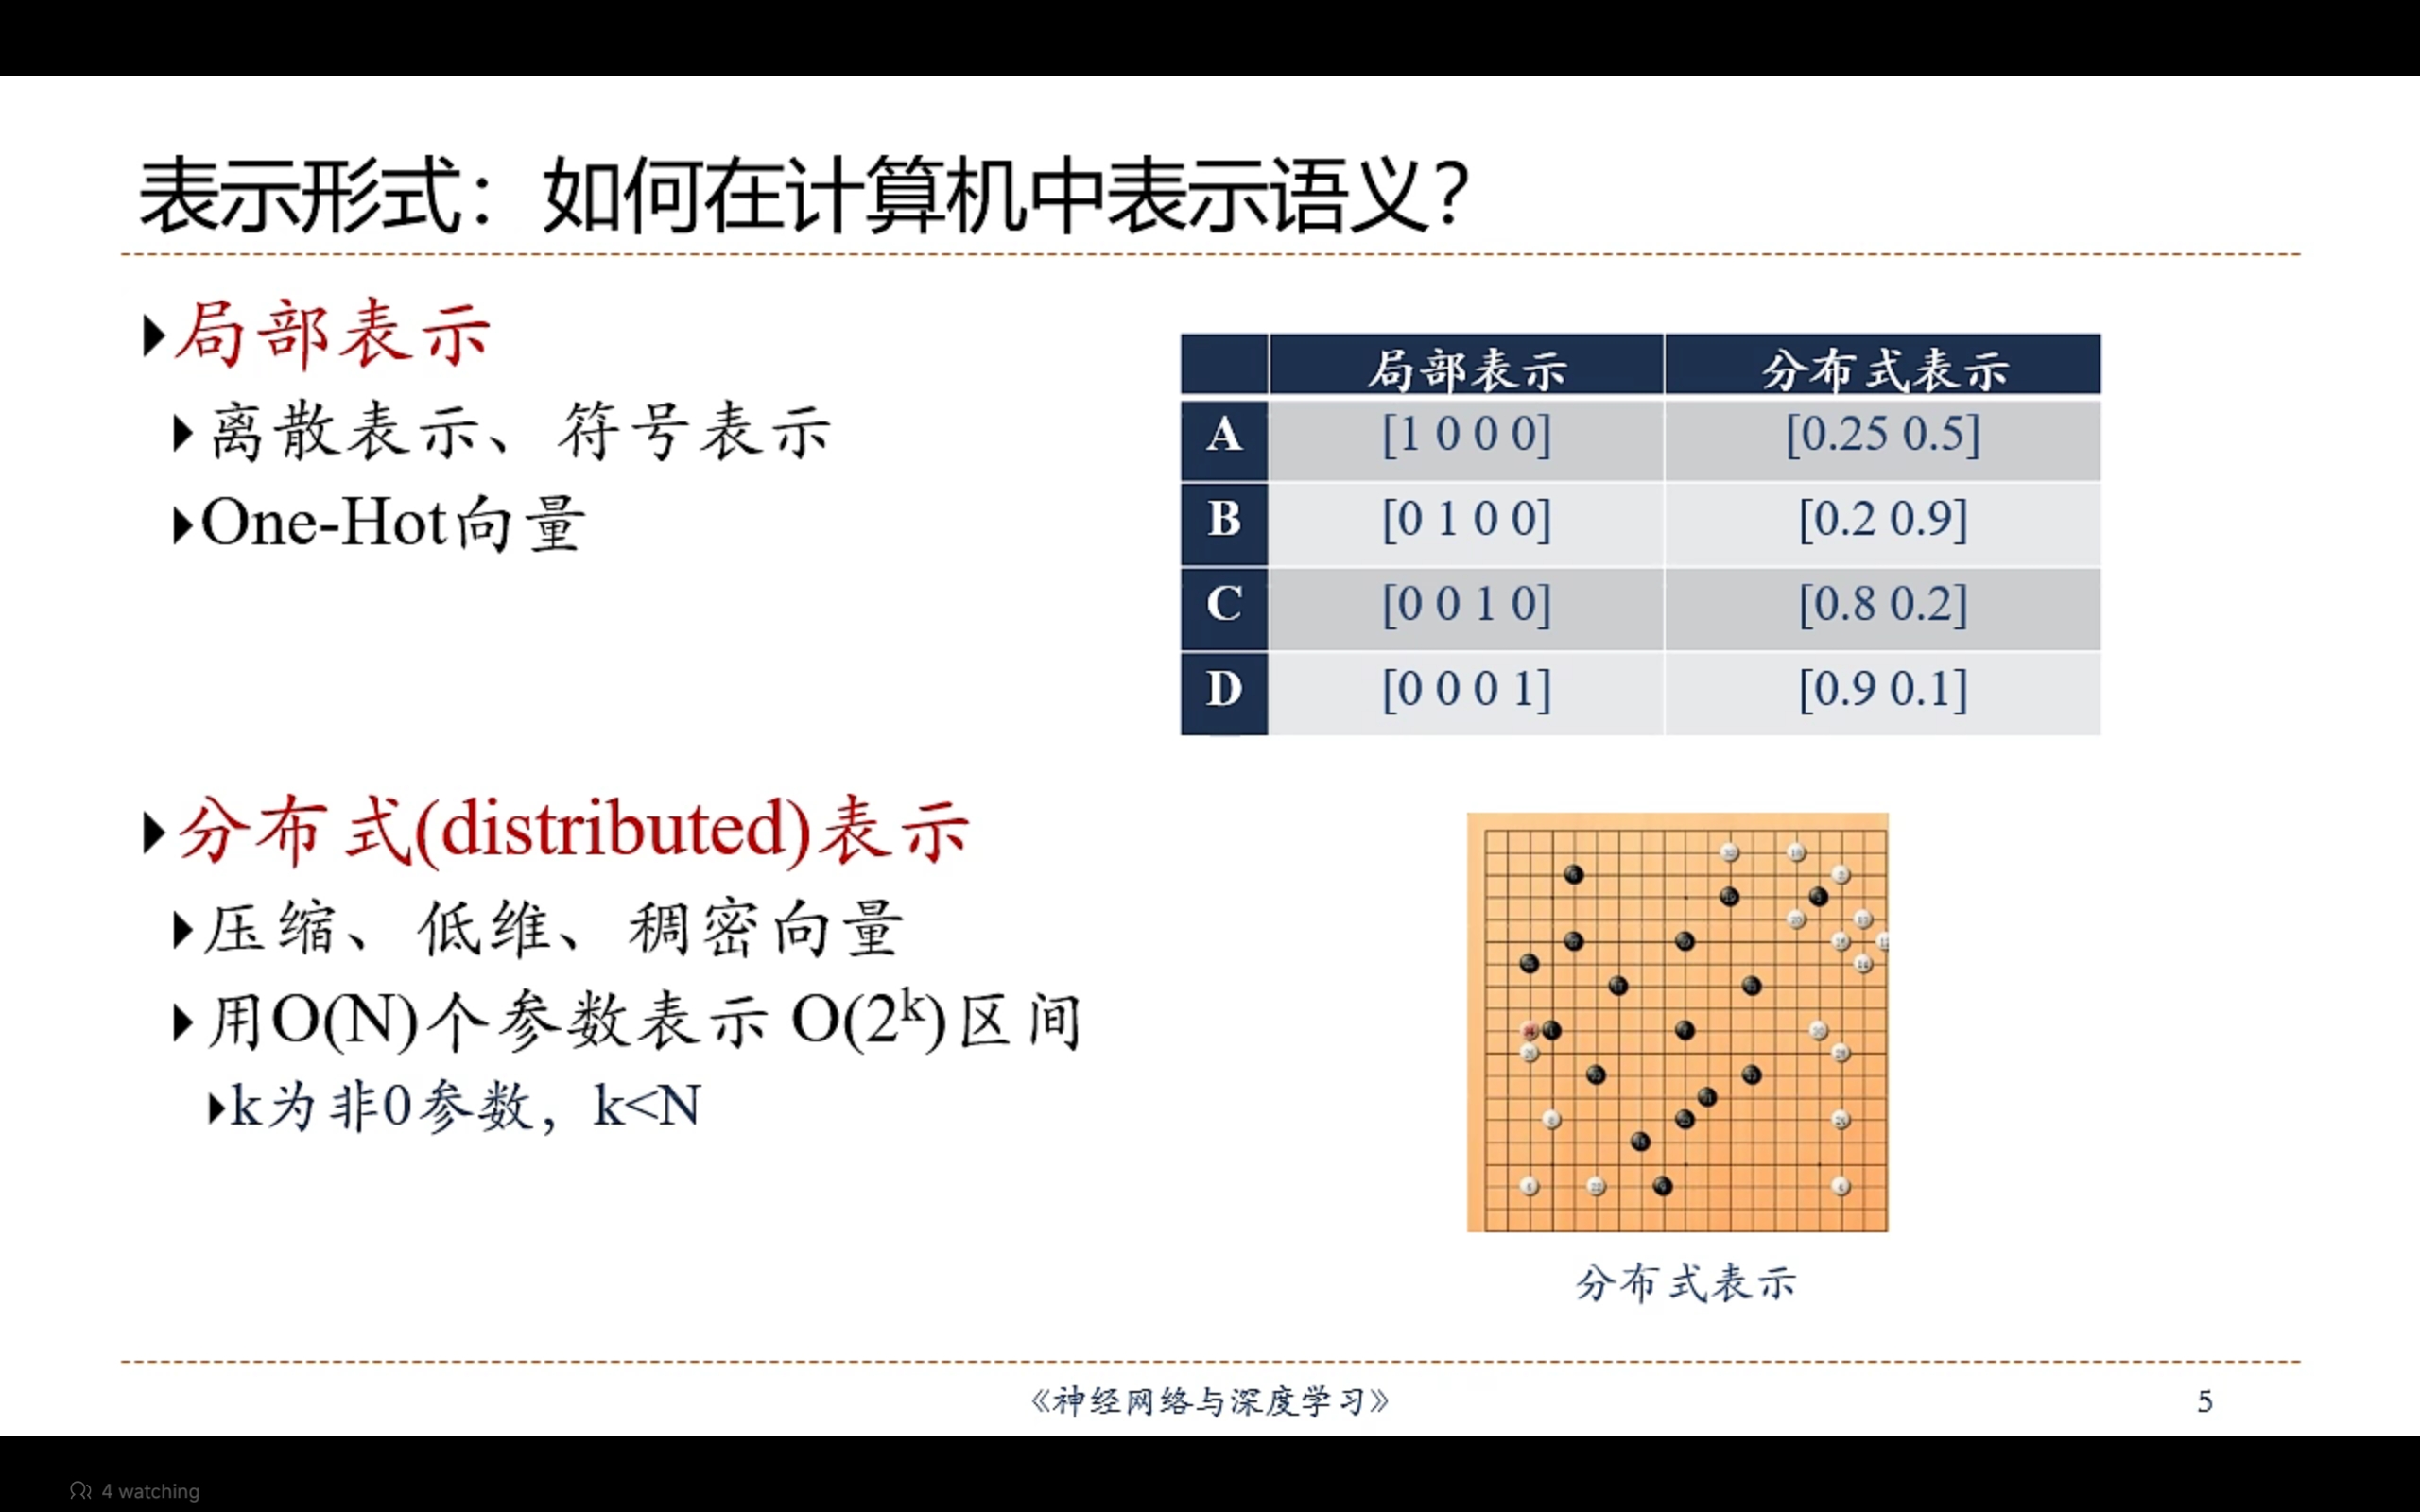
one-hot(独热编码)。
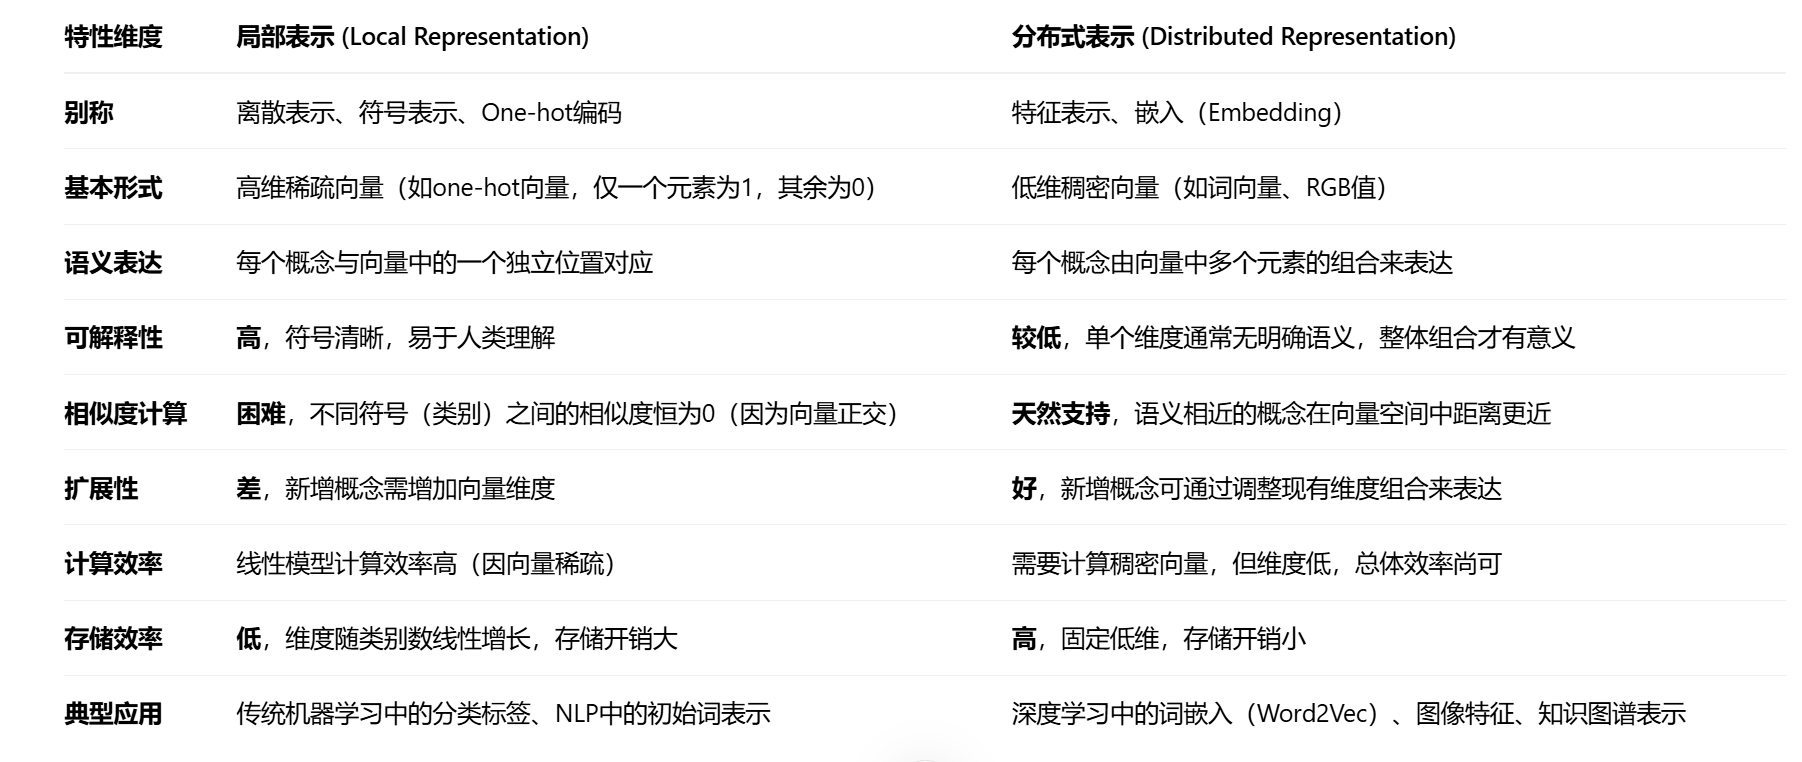
分布式表示通常是为了克服局部表示的局限性而发展起来的。在深度学习中,嵌入层(Embedding Layer) 的一个重要作用就是将高维稀疏的局部表示(如One-hot编码)映射到低维稠密的分布式表示空间。这个过程也称为嵌入(Embedding)。
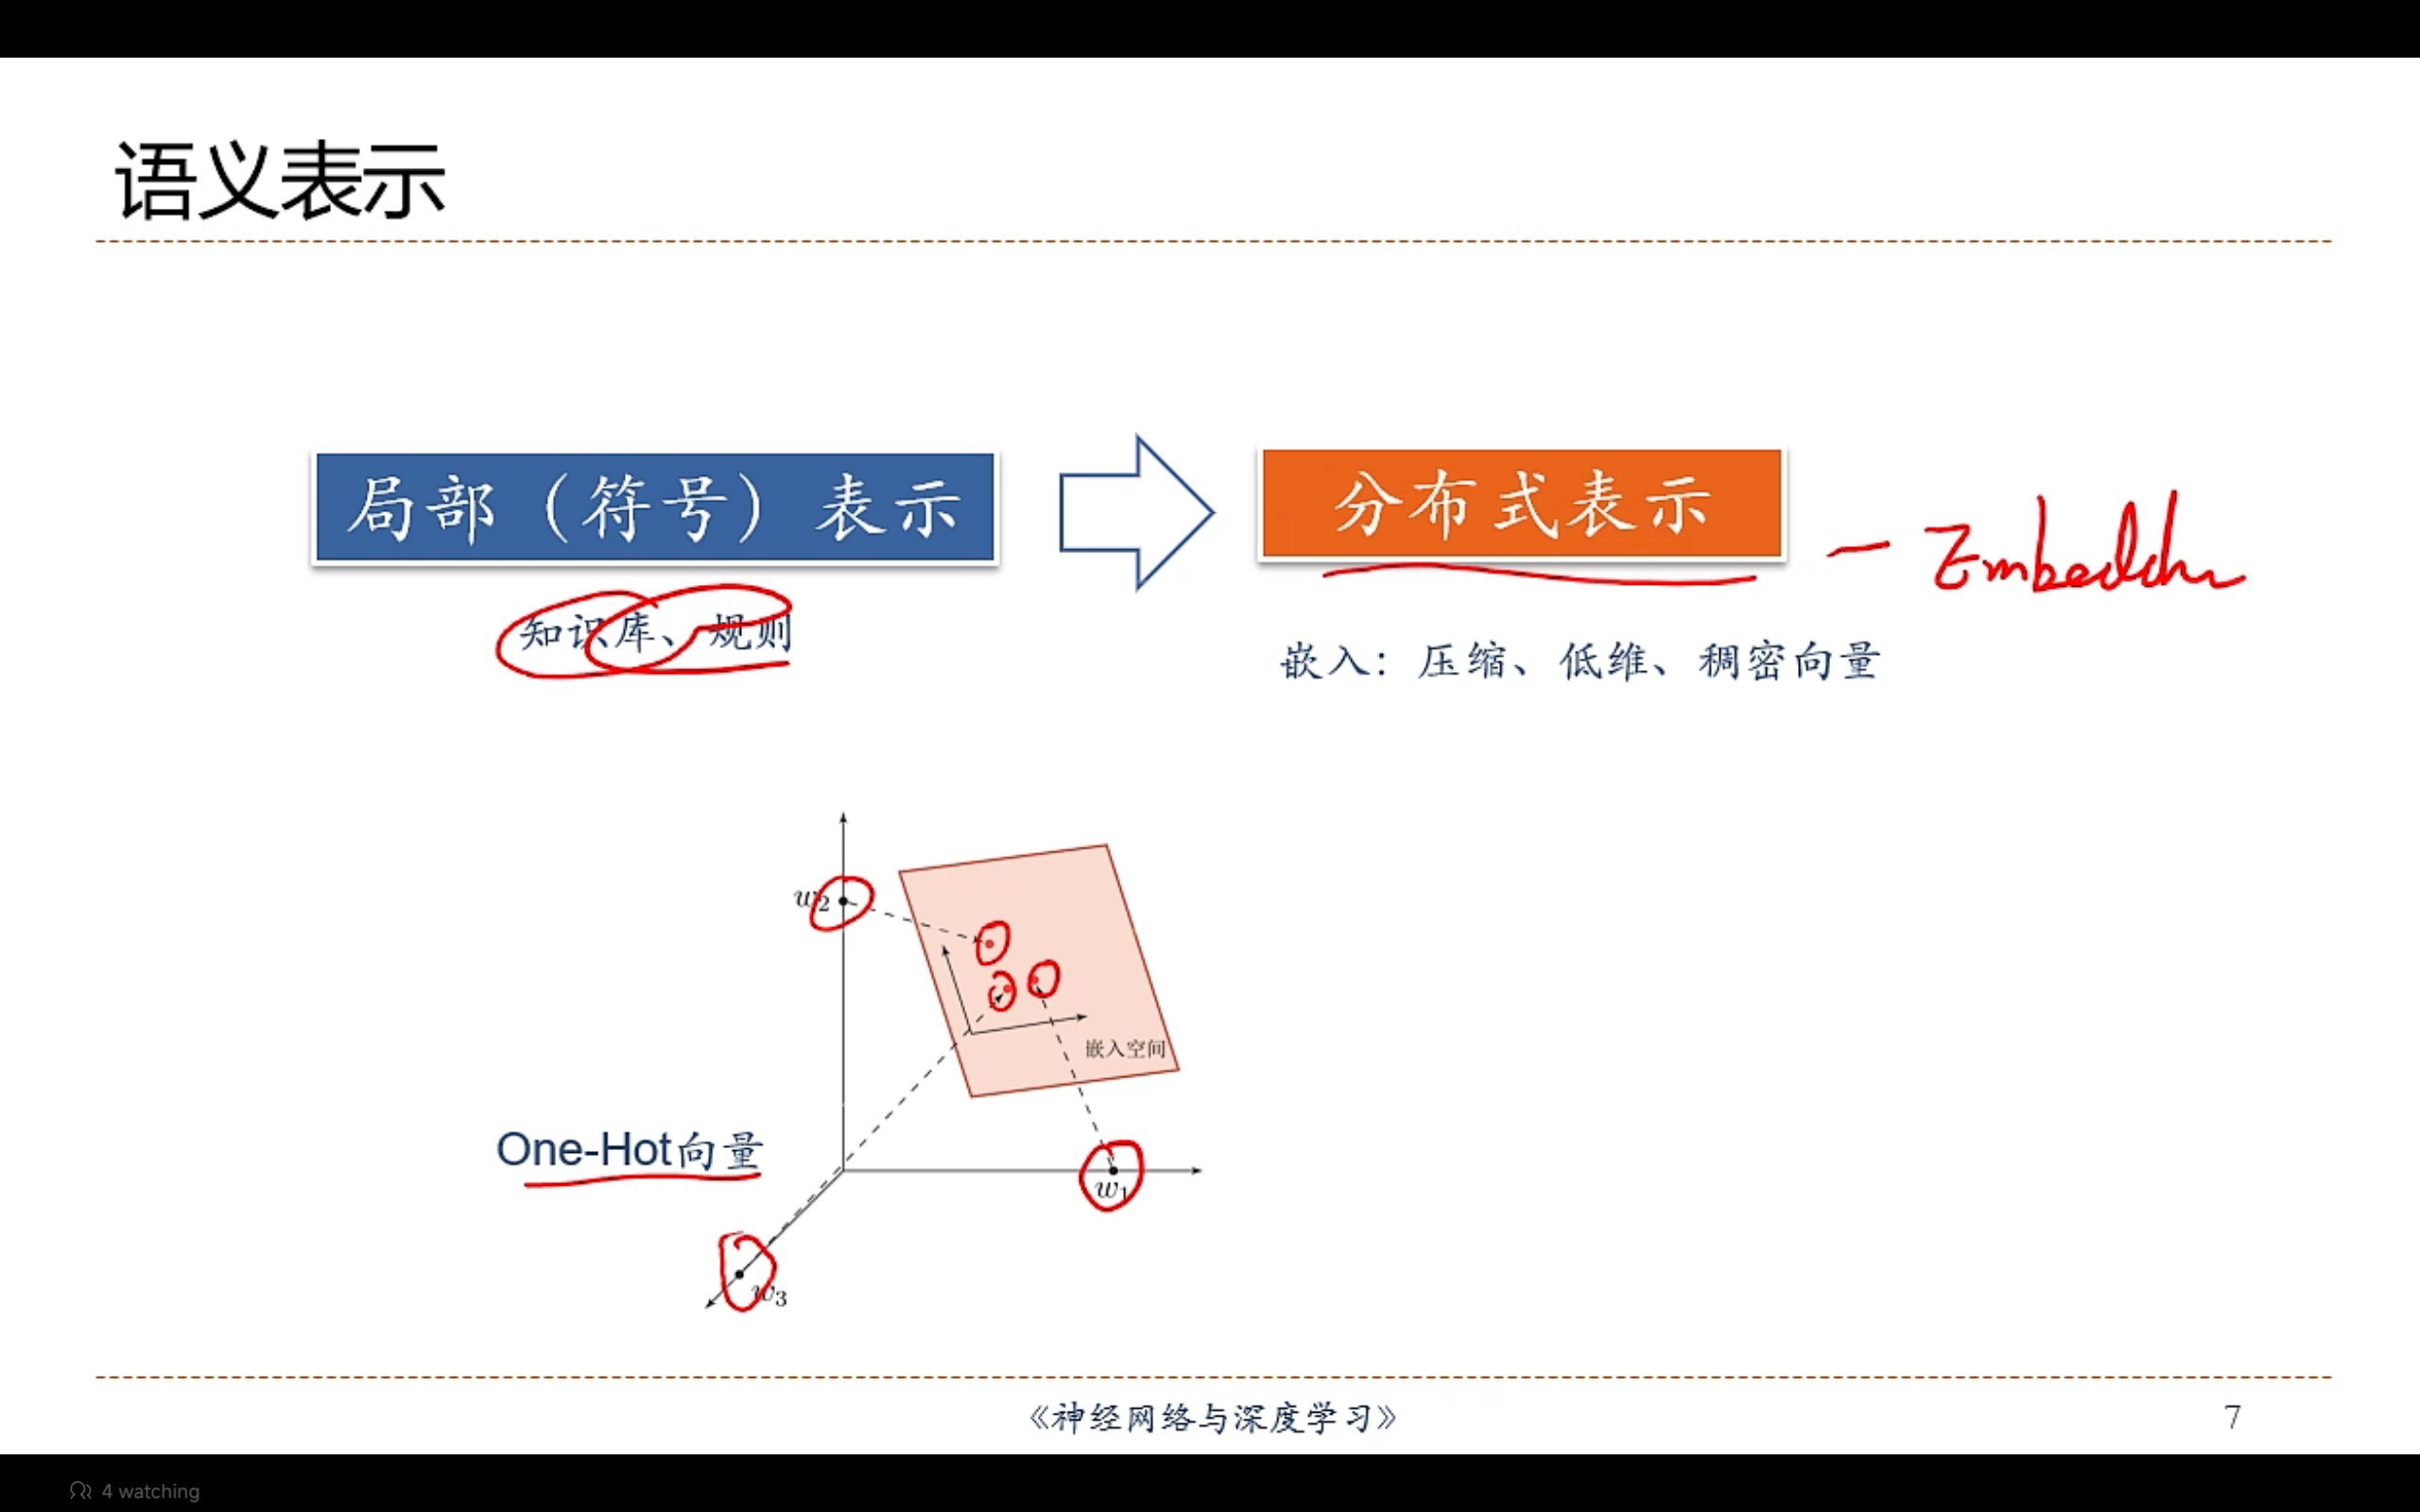
-
优先考虑局部表示的场景:类别数量非常少、对模型的可解释性要求极高(需要清楚知道每个特征的具体含义)、计算资源极度受限且类别关系不是关注重点。
-
优先考虑分布式表示的场景:类别数量多或特征复杂(如自然语言、图像)、需要捕捉和利用类别间的语义关系(如推荐系统、相似性搜索)、希望模型具备更好的泛化能力(机器学习领域,泛化能力指的是模型在训练数据上学习后,在未见过的新数据上表现良好的能力)。
两者多方位对比:
好的数据表示是什么?
没有明确的标准
一般而言,好的表示具有以下优点:
应该具有很强的表示能力。
应该使得后续的学习任务变得简单,
具有一般性,是任务或领域独立的。(不能在这部分数据好,在另一部分数据上不好)
数据表示是机器学习的核心问题。
图像数据:使用预训练CNN提取特征(迁移学习)
原始像素不是“好的表示”,但通过预训练模型提取的高层特征是
# 安装:pip install torch torchvision
import torch
import torchvision.models as models
from torchvision import transforms
from PIL import Image

# 加载预训练 ResNet(去掉最后分类层)
model = models.resnet18(pretrained=True)
model = torch.nn.Sequential(*list(model.children())[:-1])  # 移除最后的全连接层
model.eval()

# 图像预处理
preprocess = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])

# 加载图像
img = Image.open("example.jpg").convert("RGB")
img_tensor = preprocess(img).unsqueeze(0)  # 添加 batch 维度

# 提取特征
with torch.no_grad():
    features = model(img_tensor).flatten()

print(features.shape)  # torch.Size([512]) —— 512维语义特征
表示学习:如何从数据中学习好的表示
通过构建具有一定“深度”的模型,可以让模型来自动学习好的特征表示(从底层到中层,再到高层特征),从而最终提升预测或识别的准确性。
原始数据——>底层特征——>中层特征——>高层特征——>预测——>结果
| 底层特征——>中层特征——>高层特征 | 表示学习 |
传统的特征提取VS表示学习
特征提取:基于任务或先验对去除无用特征。
表示学习:通过深度模型学习高层语义特征。
| 对比维度 | 传统特征提取 (手工特征工程) | 表示学习 (特征学习) |
| 核心思路 | 依赖领域知识和人工经验,手动设计并提取特征 | 机器自动从原始数据中学习有用的特征表示 |
| 自动化程度 | 低,需要大量人工干预和试错 | 高,端到端学习,减少对人力的依赖 |
| 可解释性 | 强。特征具有明确的物理或语义意义(如颜色直方图、边缘特征),易于理解和调试 | 弱。学习到的特征(如神经网络中的隐藏层输出)是难以直接解释的抽象向量,类似“黑盒” |
| 数据依赖 | 对小规模数据集表现良好,无需大量数据即可构建有效特征. | 依赖大规模数据进行训练,数据量不足时容易过拟合或效果不佳 |
| 计算成本 | 相对较低,特征提取速度快,对计算资源要求不高 | 高,模型复杂,需要强大的计算资源(如GPU)和更长的训练时间 |
| 泛化能力 | 较差。手工设计的特征针对特定任务和场景,难以适应数据分布的变化或新任务 | 强。学习到的特征更具通用性,能更好地适应未见过的数据,并可迁移到相关任务上(迁移学习) |
1.4深度学习
深度学习=表示学习+决策(预测)学习
| 底层特征——>中层特征——>高层特征——>预测 | 深度学习 |
从原始数据(x)经过很多模块,底层特征(f1)、中层特征(f2)、高层特征(f3)、预测(f4),最后得到结果(y)我们需要研究其中哪一个模块做的决策对最终的结果影响最大。(这里倒是感觉更像是一种动态的环境——深度强化学习,如王者荣耀里的高级人机,因为对局中每一步的状态都不一样,通过下述操作不断去更新智能体,使得我们的人机(智能体)往往会去选择对自己更有益处(奖励reward)的操作(动作action)以获得对局的胜利,当做出不利的操作的时(引入损失函数进行参数调整))。
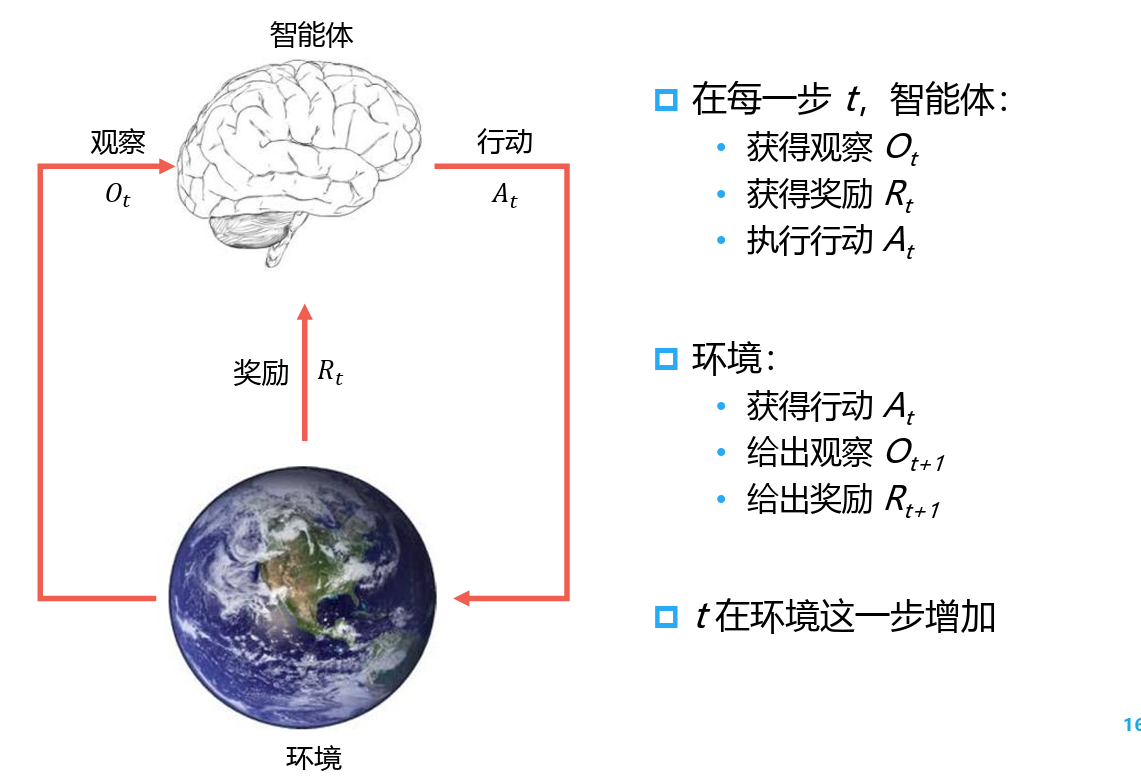
强化学习交互过程
例子:
下象棋AI中各个模块对最终决策的影响程度,可以将整个决策过程分解为多个层次:
-
原始数据层(x):
- 棋盘状态(64个格子的棋子分布)
- 当前回合(红方/黑方)
- 历史走法记录
-
底层特征(f1):
- 基础棋面评估:
- 子力价值计算(车=9,马/炮=4等)
- 基础棋子位置分
- 将帅安全性评估
- 示例:计算当前棋盘上红黑双方的总子力差值
- 基础棋面评估:
-
中层特征(f2):
- 战术组合识别:
- 捉双、抽将等战术检测
- 棋子配合度分析
- 攻防态势评估:
- 关键线路控制
- 子力活跃度
- 示例:发现马跳卧槽的潜在杀招
- 战术组合识别:
-
高层特征(f3):
- 战略规划:
- 开局/中局/残局策略选择
- 长期优势积累
- 局势判断:
- 优势/劣势量化评估
- 胜率预测
- 示例:决定是否兑子简化局面
- 战略规划:
-
预测层(f4):
- 走法生成:
- 合法着法枚举(通常30-50种)
- 候选着法筛选(缩减到5-10个)
- 深度搜索:
- 3-5步模拟推演
- 最佳应对路径评估
- 示例:最终选择"车八平六"的着法
- 走法生成:
-
最终决策(y):
- 实际执行的走法
- 附带评估分值(如+0.5表示红方优势)
核心问题:贡献度分配问题
深度学习的数学描述:
y=f(x)浅层
y=f^5(f^1(x))
........
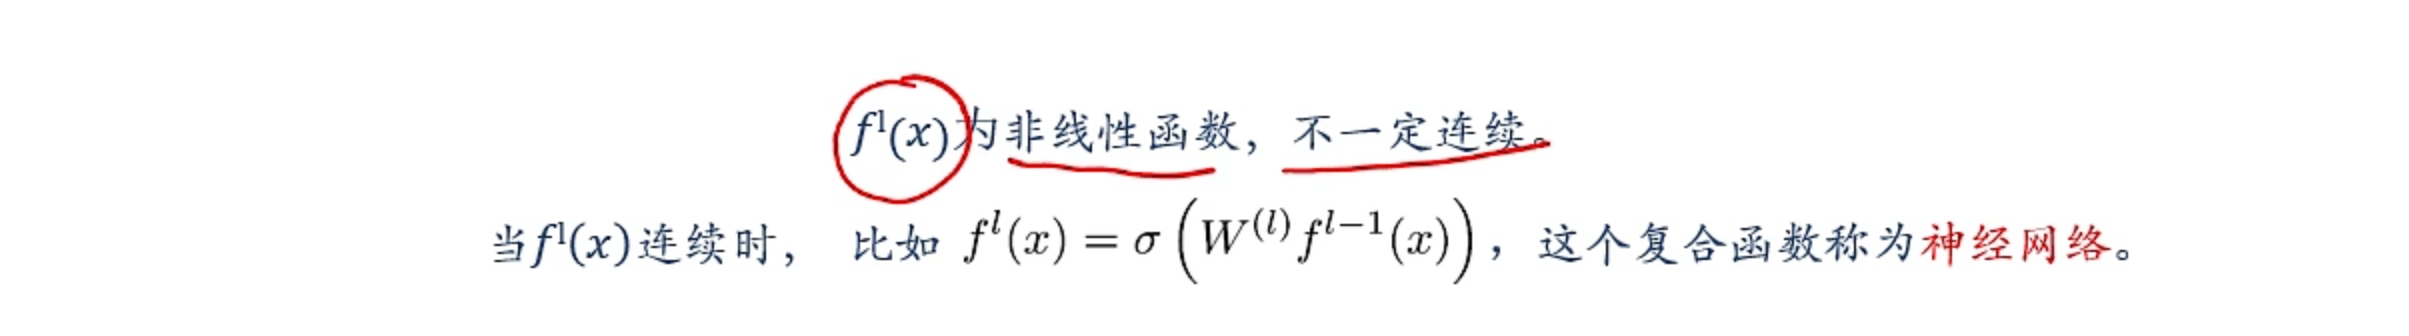
y=f^5(f^4(f^3(f^2(f^1(x))))深度学习
由简单函数嵌套成一个复杂函数
1.5神经网络
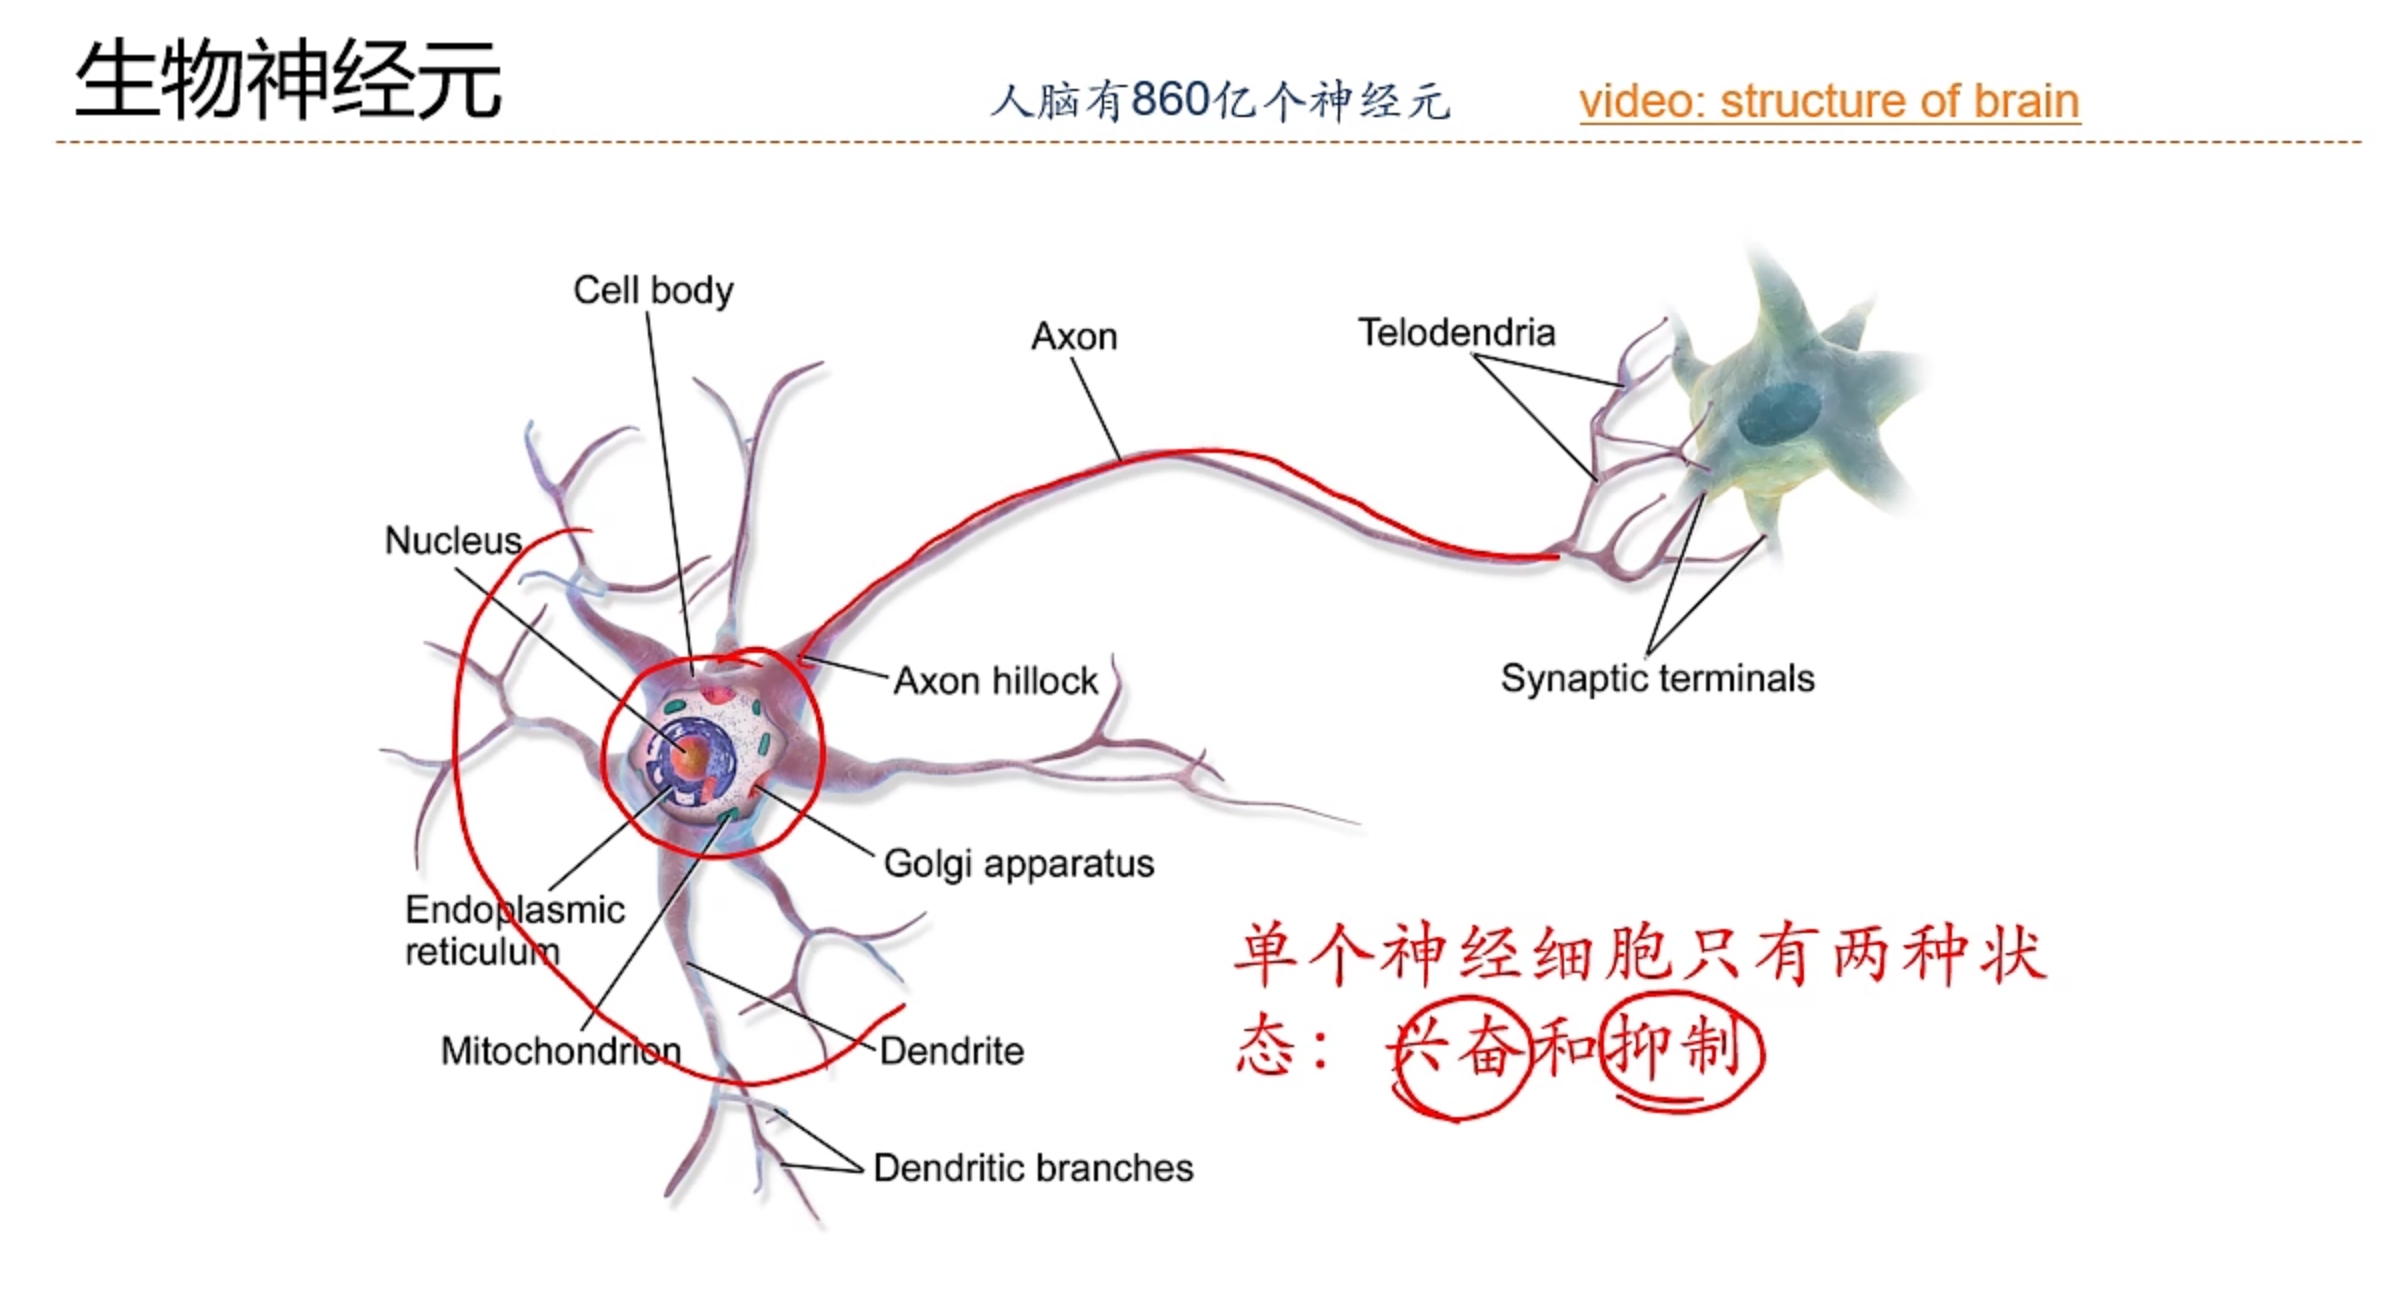
生物神经网络与人工搭建的神经网络二者之间的对比:
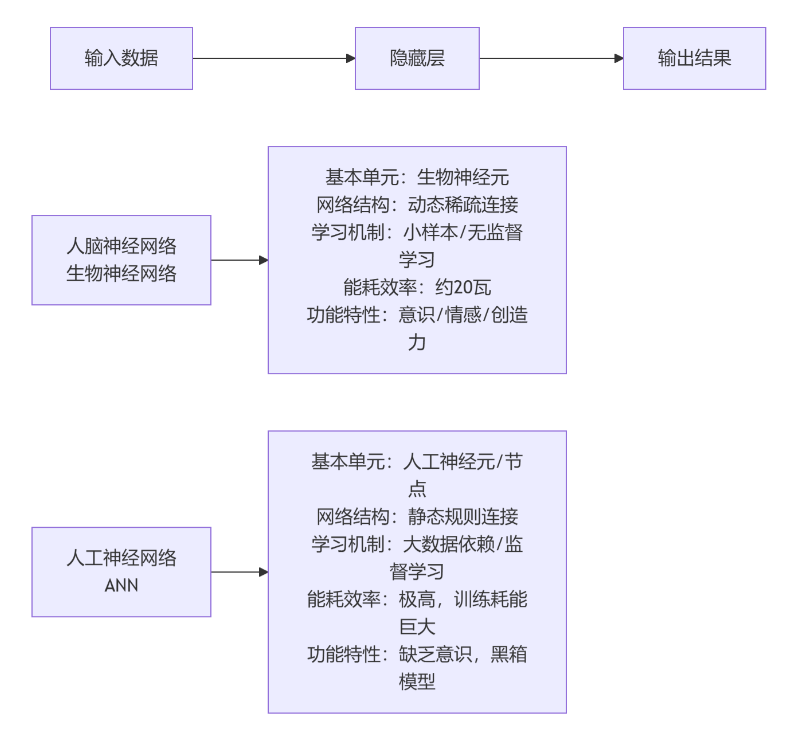
神经网络如何学习?
神经网络的学习过程本质上是一个参数优化过程,通过调整网络中的权重和偏置参数,使网络输出尽可能接近真实标签。
#核心思想
输入数据 → 前向传播 → 计算损失 → 反向传播 → 更新参数 → 重复迭代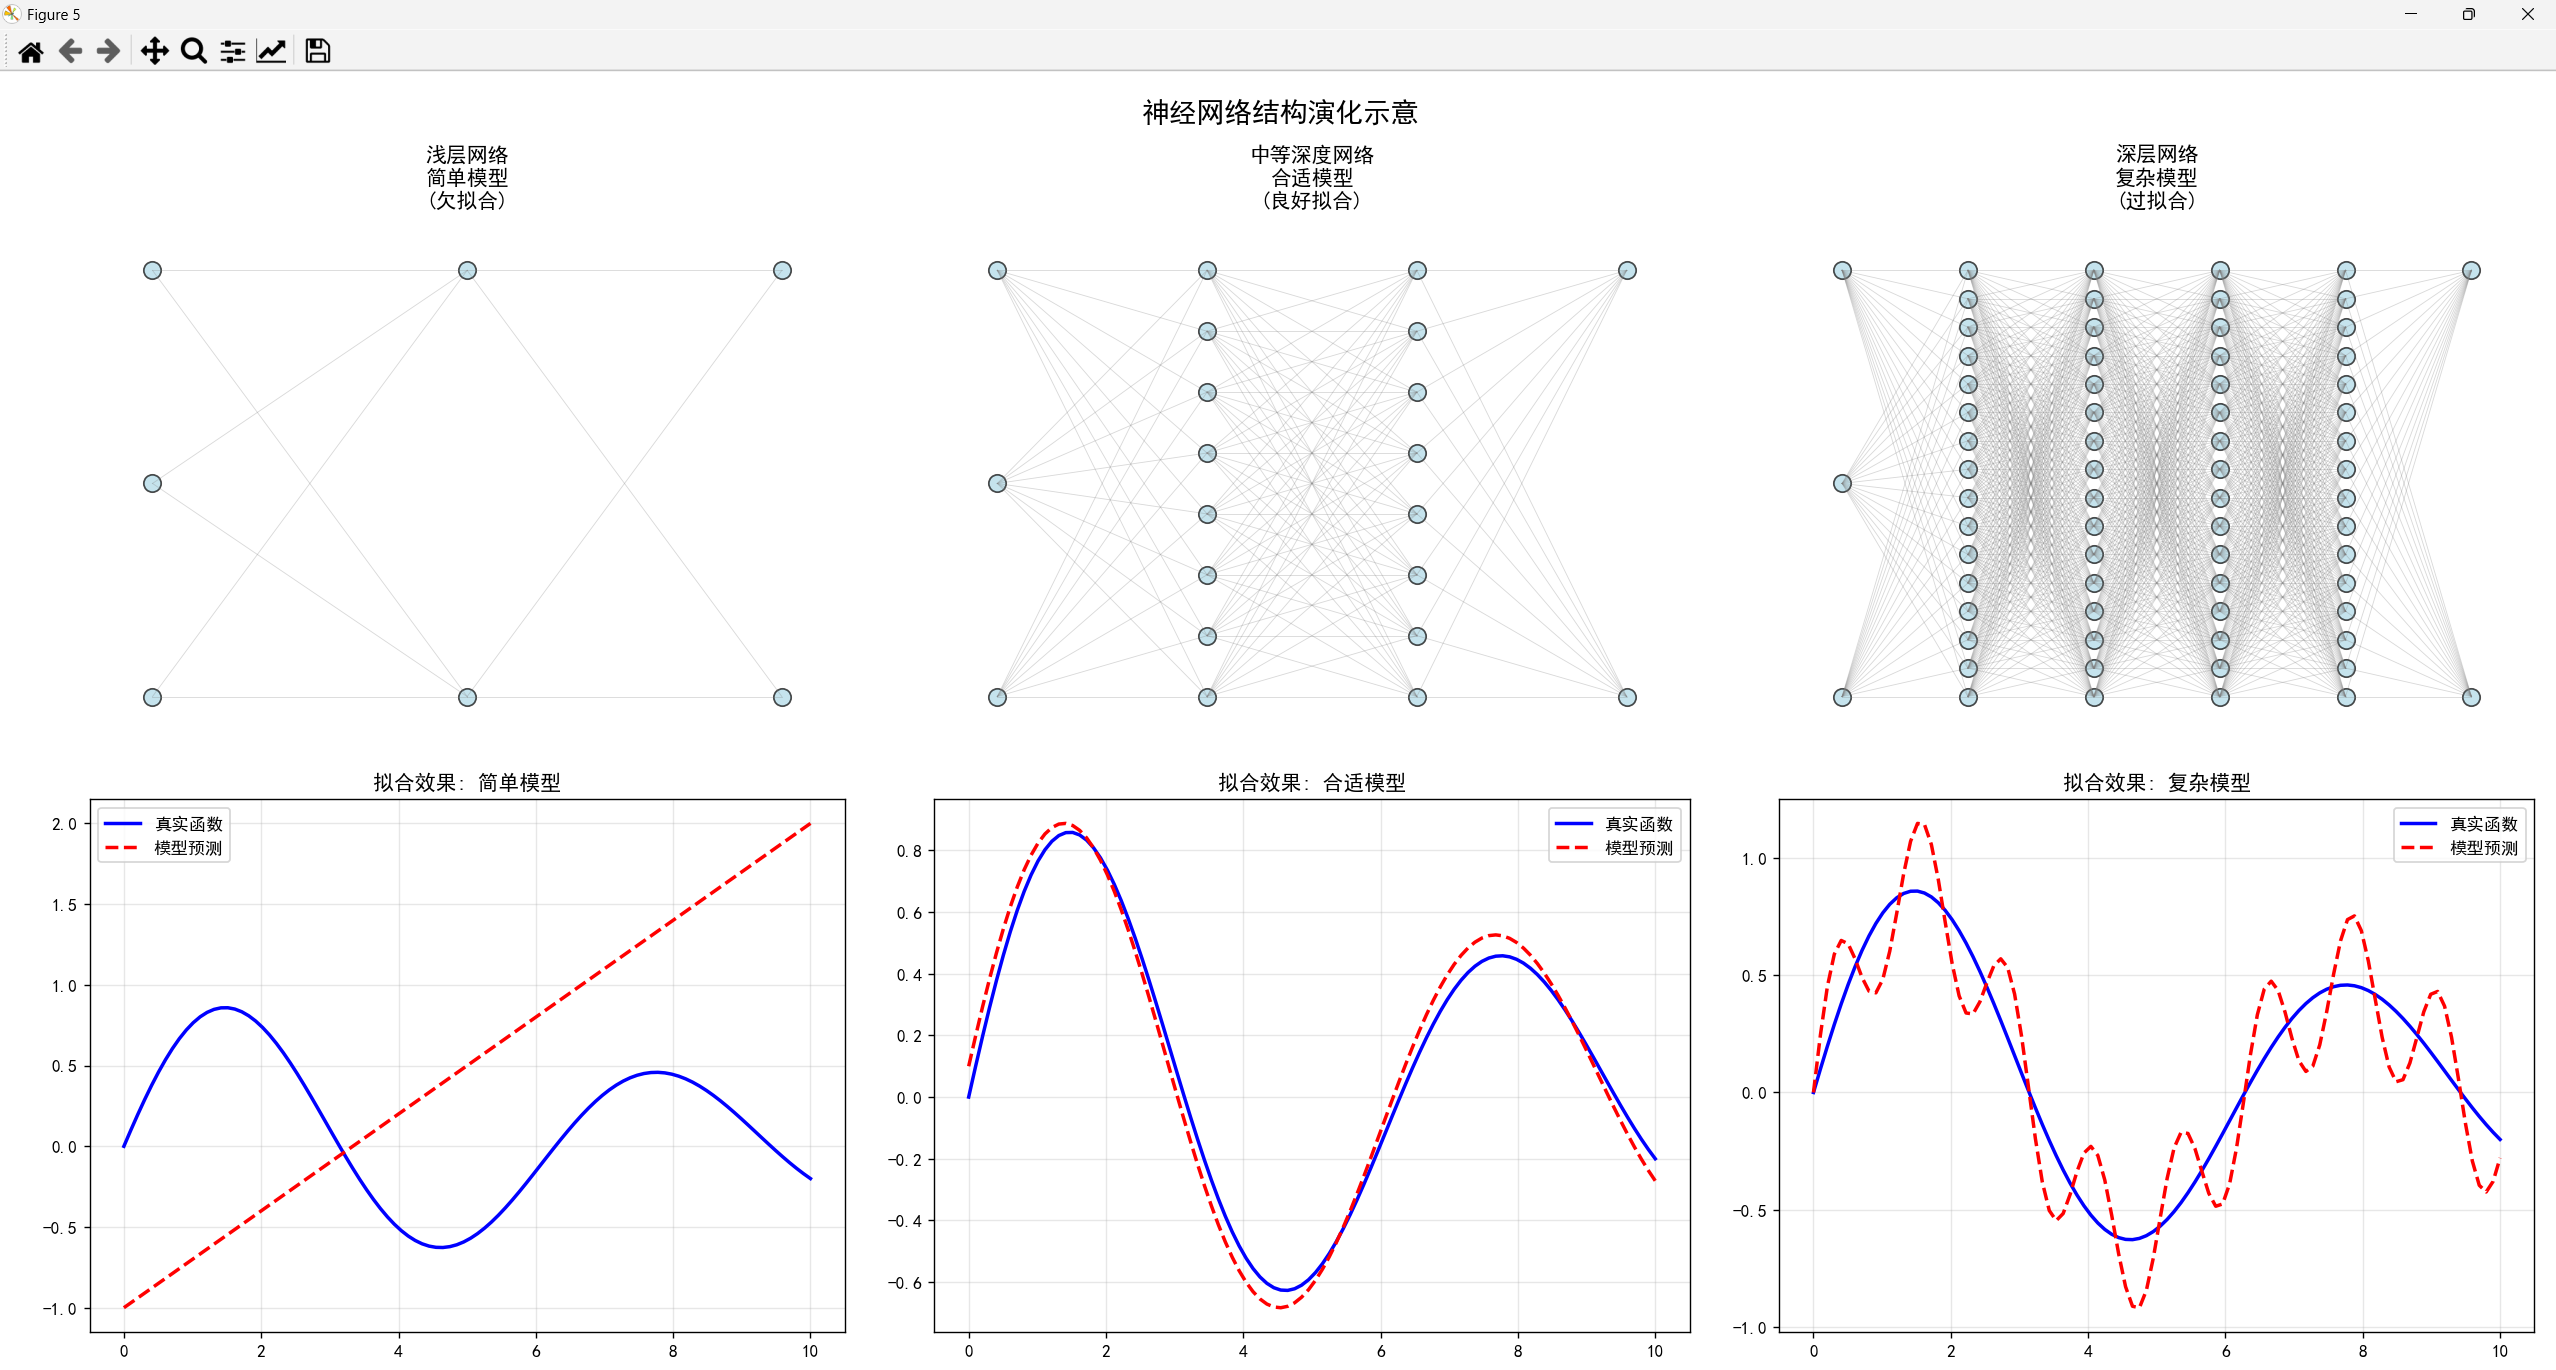
这是一个神经网络演化示意,包括代码运行后模型的拟合效果
神经网络本质:
1. 生物学启发
模仿大脑结构:神经元之间的连接和信息传递机制
并行处理:多个神经元同时工作,提高计算效率
学习能力:通过调整连接权重来适应新数据
2. 数学本质
函数逼近器:能够逼近任意复杂的非线性函数
特征学习:自动从原始数据中提取有用特征
非线性变换:通过激活函数引入非线性能力
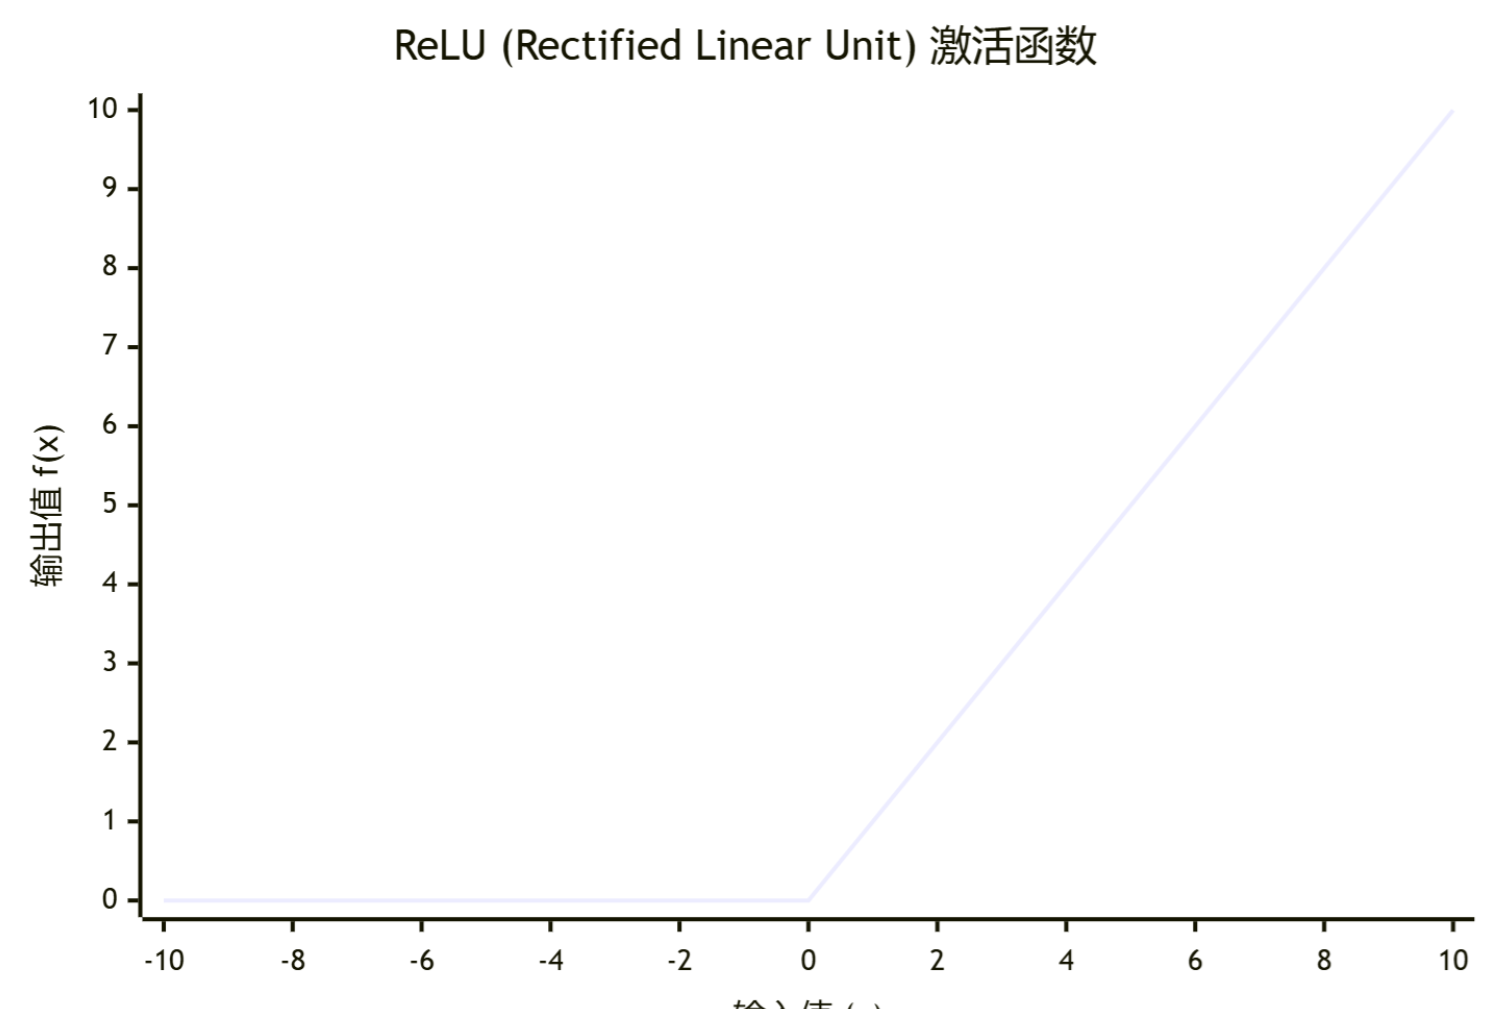
目前使用最多的激活函数ReLU:作用:
-
打破线性:如果没有激活函数,多层神经网络的的组合效果仍然等同于单层线性变换,无法学习复杂模式。例如,即使叠加多个线性层,最终输出仍是输入的线性组合。
-
决定神经元激活状态:不同的激活函数具有不同的特性。ReLU函数(f(x)=max(0,x))会将负值置零,实现稀疏激活;Sigmoid函数(f(x)=1/(1+e^-x))将输出压缩到(0,1)区间,适合概率输出。
-
梯度传播控制:激活函数的导数影响反向传播时的梯度流动。ReLU的导数在正区间为1,能缓解梯度消失问题;而Sigmoid的导数最大值仅0.25,深层网络容易出现梯度消失。
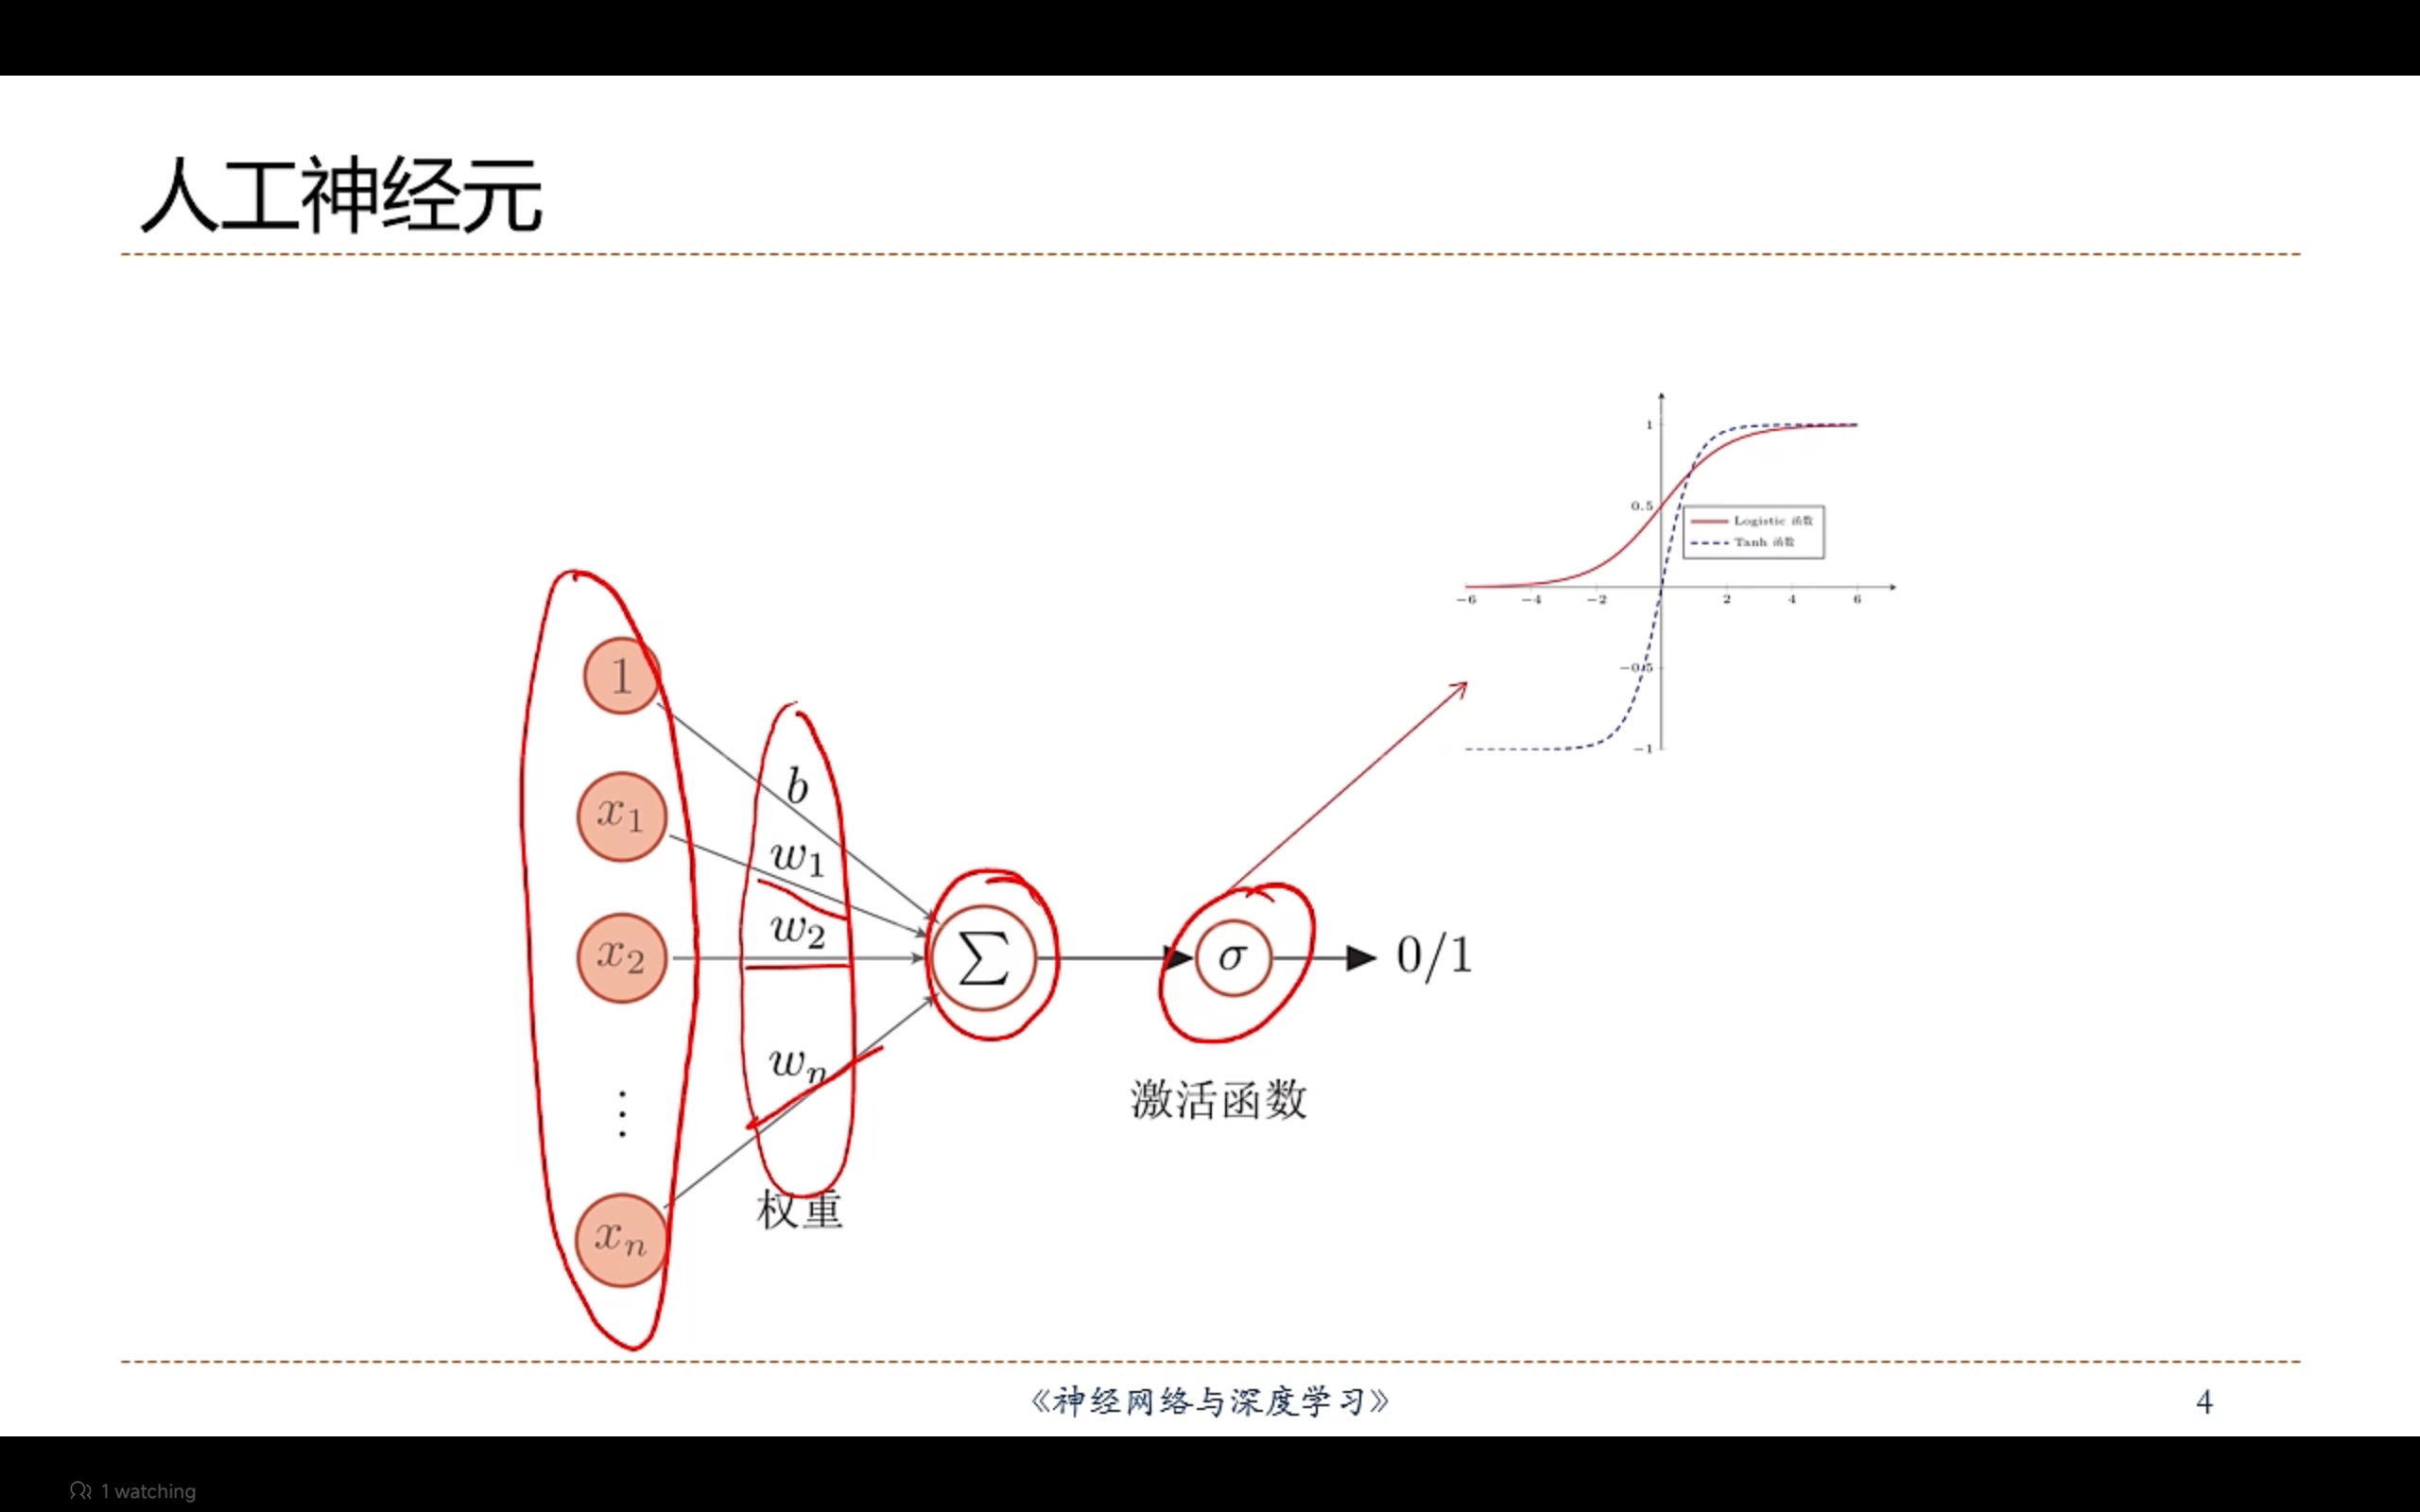
人工神经网络
人工神经网络主要由大量的神经元以及它们之间的有向连接构成。因此考虑三方面:
神经元的激活规则
主要是指神经元输入到输出之间的映射关系,一般为非线性函数。
网络的拓扑结构
不同神经元之间的连接关系
学习算法
通过训练数据来学习神经网络的参数
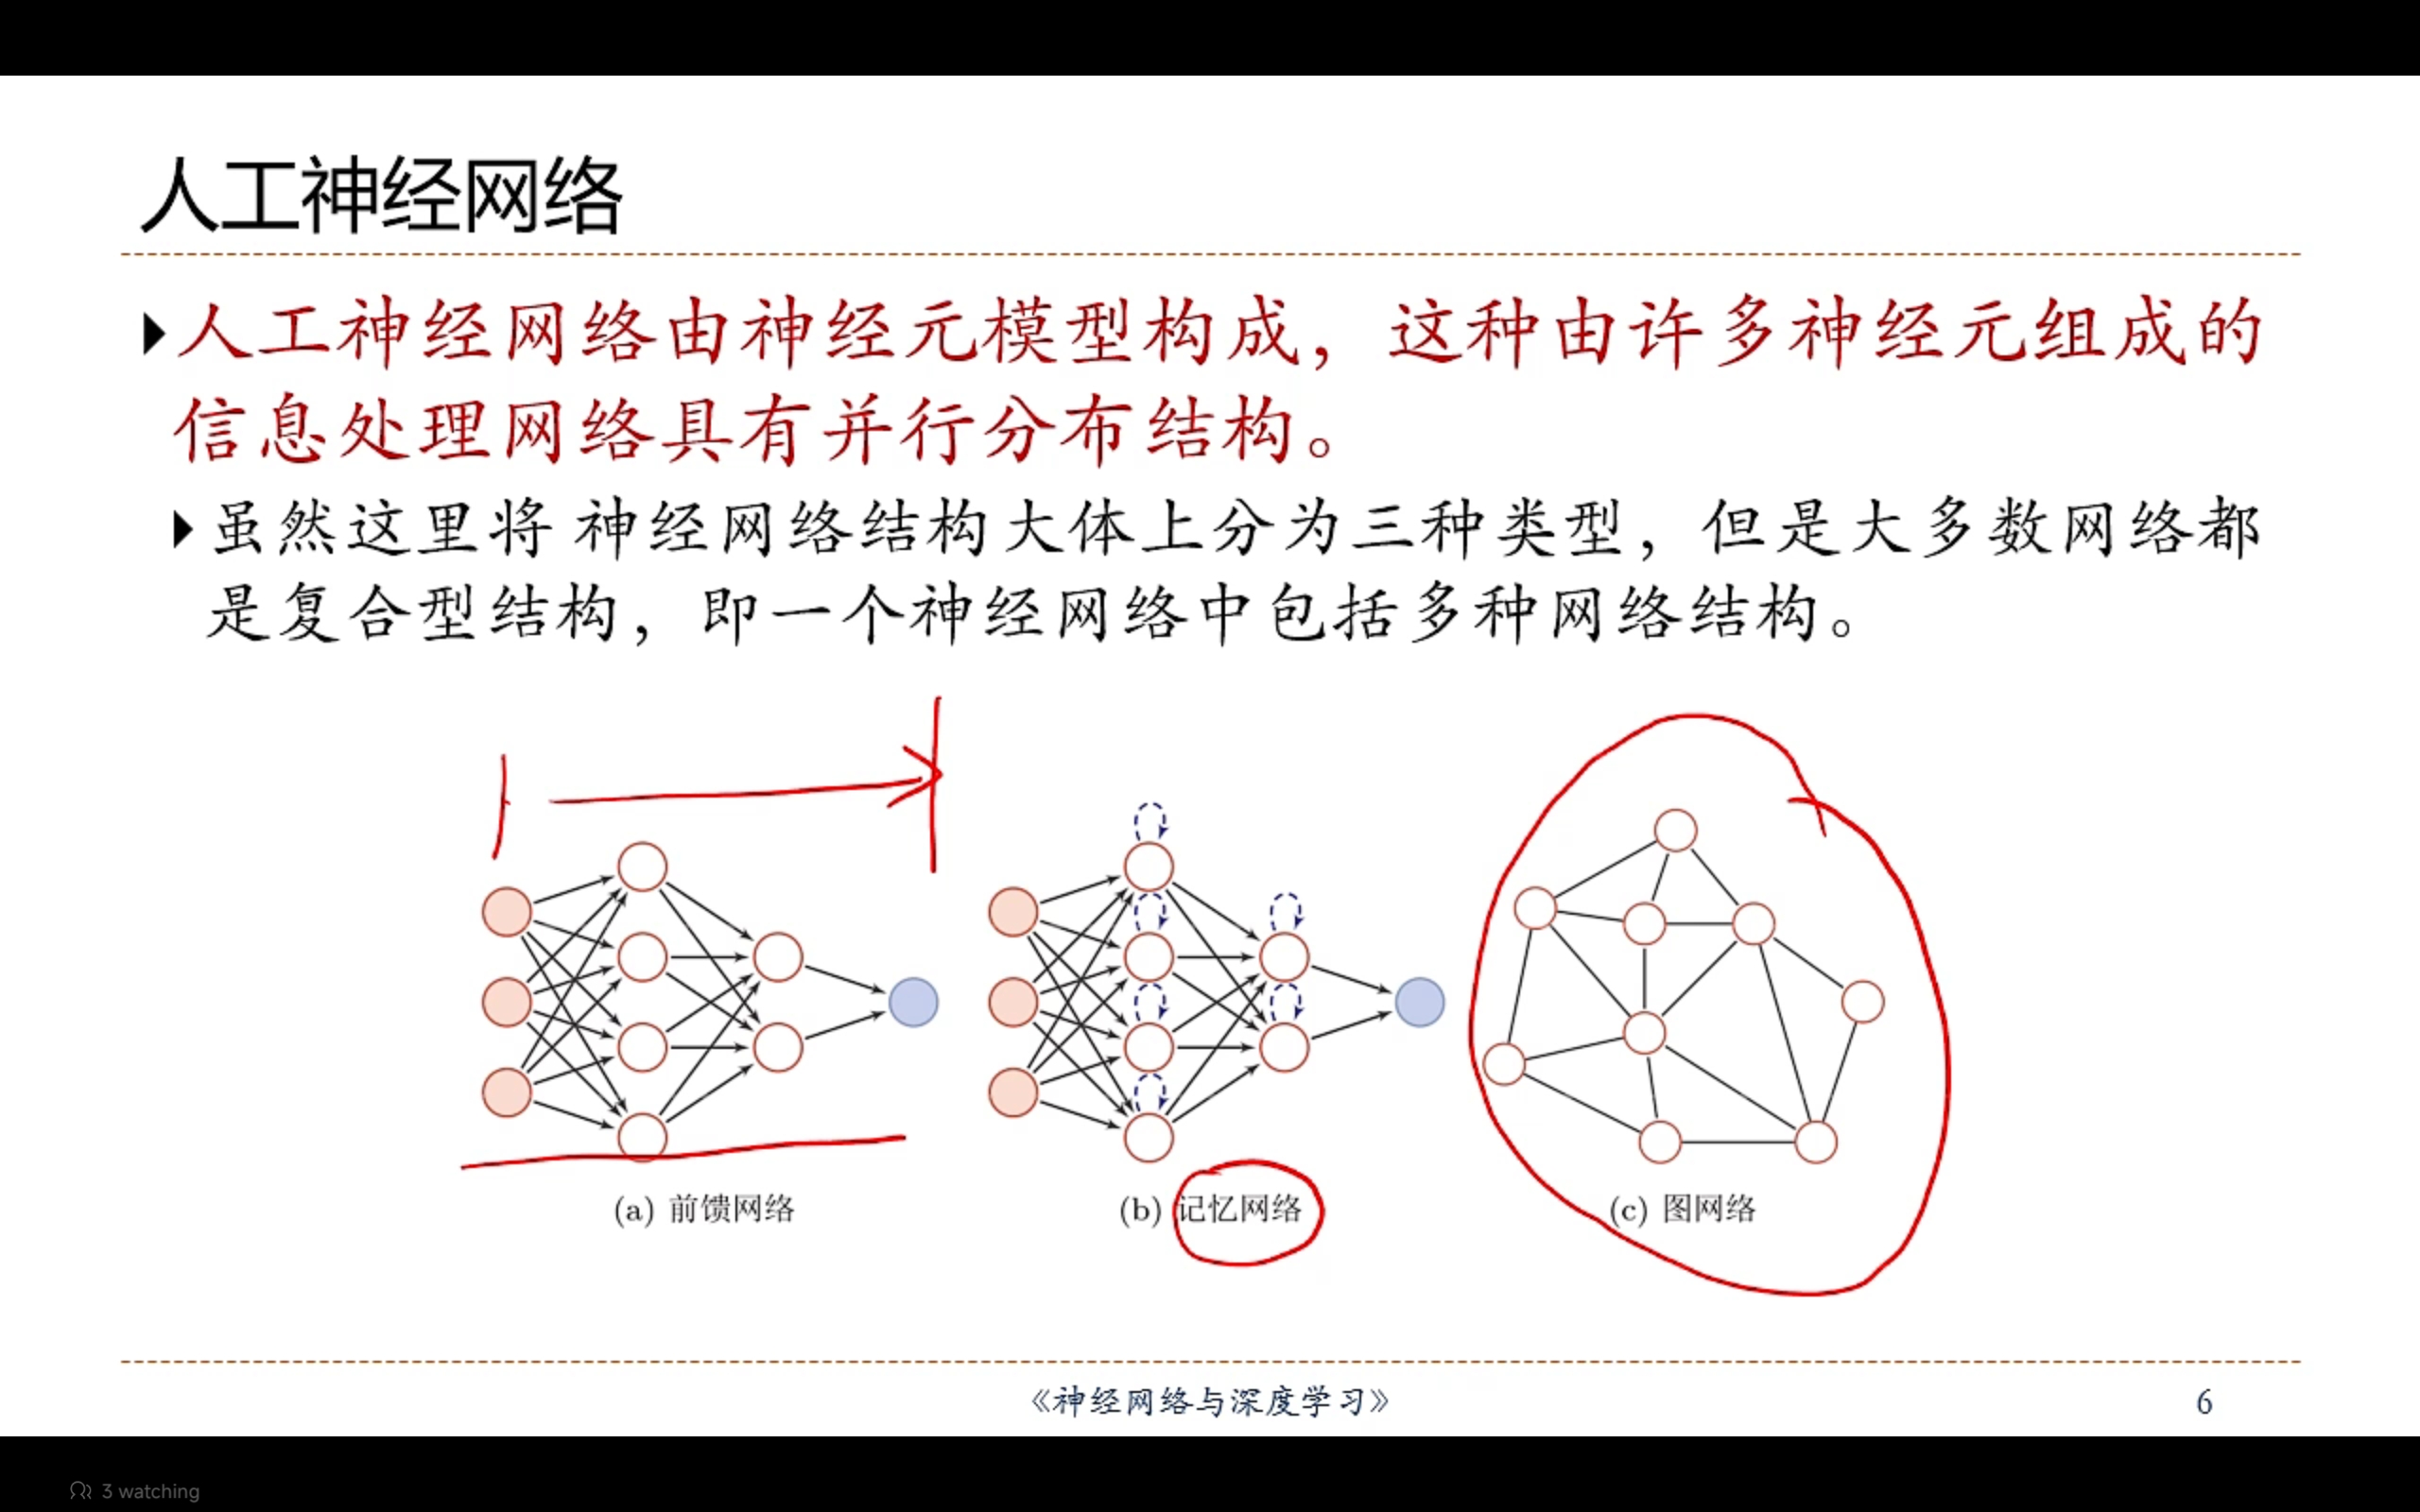
图网络的常见类型
- 图神经网络(GNN):通过迭代式消息传递更新节点状态,经典模型包括GCN(图卷积网络)、GAT(图注意力网络)。
- 图嵌入(Graph Embedding):将图结构映射为低维向量,如DeepWalk、Node2Vec。
- 动态图网络:处理随时间变化的图结构,如动态GNN。
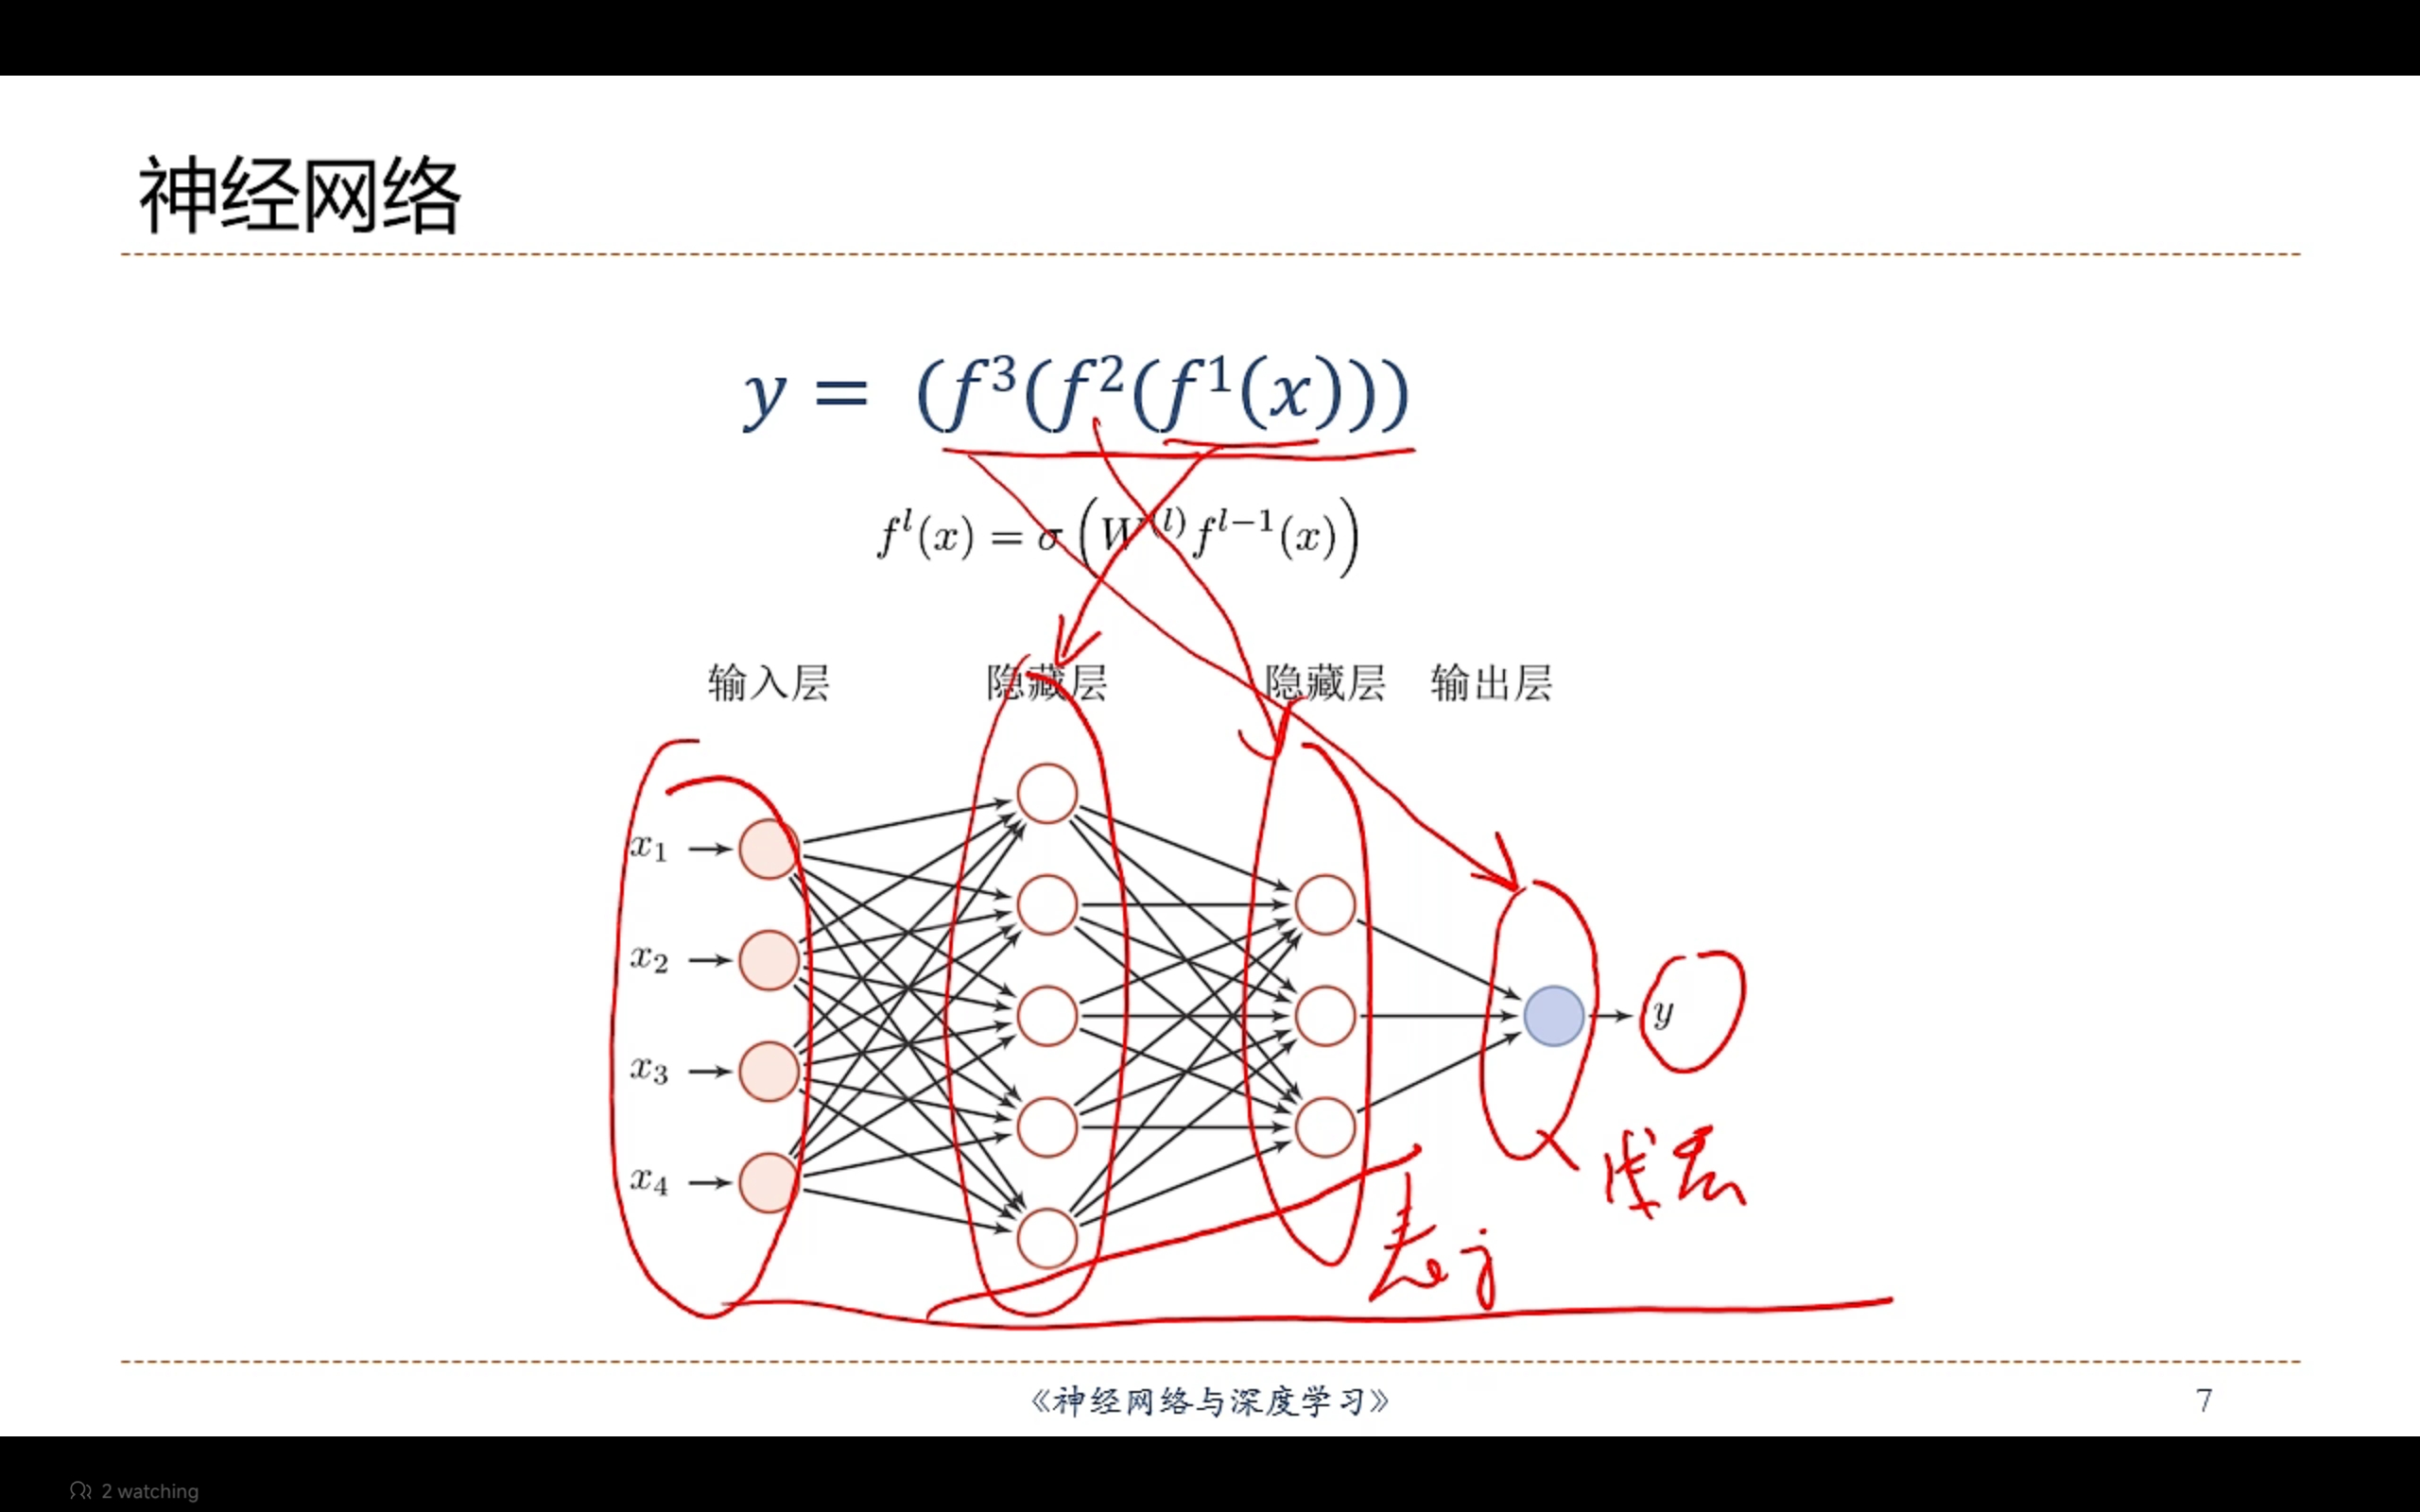
我们的神经网络可以看成一种端到端的机器学习系统,它能够直接从原始输入数据中学习特征表示并完成最终的预测任务。
解决贡献度分配问题: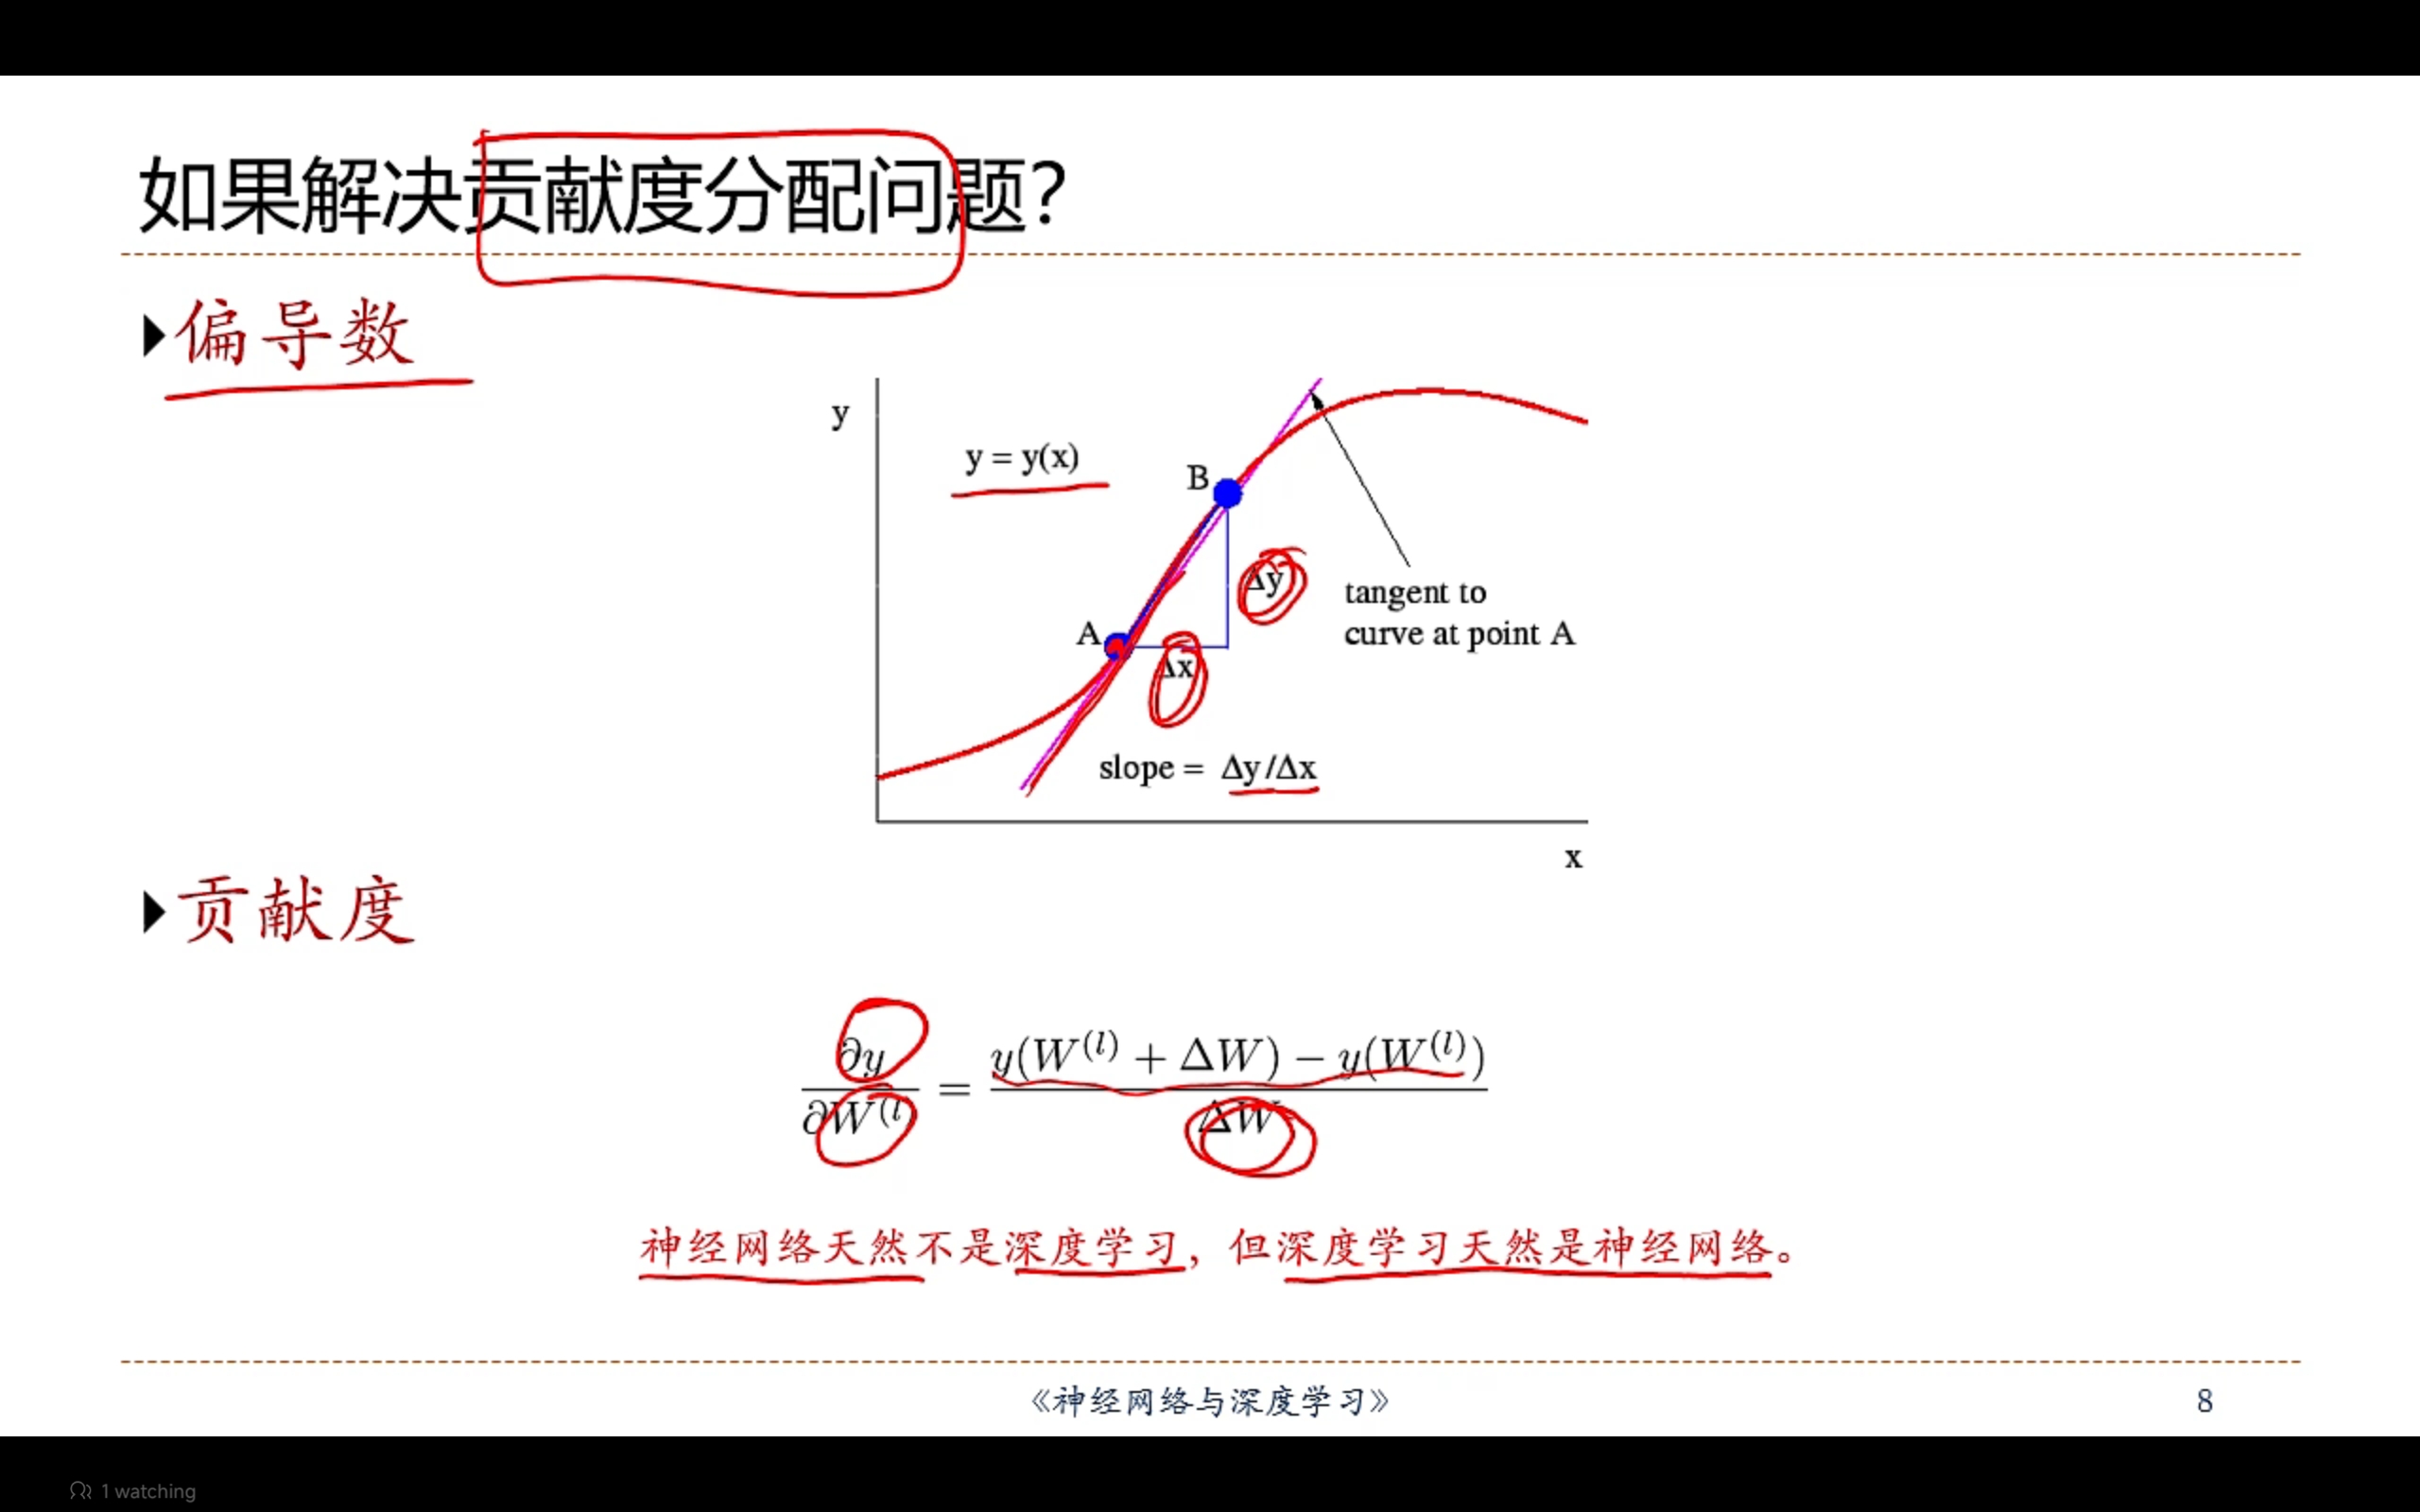
如果对x做一个很小的扰动,y变动过大,意味着它的贡献度大。
1.基于梯度的方法
这类方法通过梯度(偏导数) 来衡量输入特征或模型参数的微小变化对最终输出的影响程度。
-
积分梯度(Integrated Gradients)
通过在输入空间中选择一个基线(Baseline,如全黑图像),并沿着从基线到真实输入的路径对梯度进行积分,有效解决了直接梯度方法在饱和区梯度为零的问题。它满足敏感性(只要对输出有影响,贡献度就不为零)和实现不变性(功能相同的模型分配结果一致)两个重要公理。 -
梯度饱和问题:在模型输出对输入变化不敏感的区域(例如 Sigmoid 函数接近饱和的区域),普通梯度可能为零或很小,无法反映其真实贡献。积分梯度通过路径积分避免了这一点。
2. 基于传播的方法
这类方法通过定义特定的传播规则,将输出层的贡献度分数逐层反向传播,直至输入层。
逐层相关性传播(Layer-wise Relevance Propagation, LRP)
其核心是守恒性,即某一层所有神经元的相关性之和等于其下一层所有神经元的相关性之和。通过定义传播规则(如 ϵ-rule, β-rule 等),将输出层的预测分数分解并反向传播到输入像素,生成热力图以显示不同区域对预测的正面或负面贡献。
3. 基于注意力机制的方法
注意力机制让网络能够自适应地学习并关注对当前任务最关键的信息
-
在图神经网络中,图注意力网络(GAT)通过计算节点之间的注意力权重(通常用可学习的神经网络实现)来聚合邻居信息。这些权重清晰地表明了不同邻居节点对中心节点更新的贡献程度,本身就提供了可解释性
-
在 Transformer 及其衍生模型中,自注意力(Self-Attention)机制直接计算序列中每个元素对所有其他元素的注意力权重,这些权重直观地显示了不同部分之间的关联强度和对最终输出的贡献
4. 博弈论方法
这类方法借用博弈论中的概念来公平地分配“总收益”(即模型的预测输出)。
-
SHAP(SHapley Additive exPlanations)
其核心是计算每个特征的 Shapley 值。Shapley 值来源于合作博弈论,用于衡量多个参与者合作时,每个参与者对整体收益的平均边际贡献。SHAP 提供了一种统一且理论坚实的框架来解释任何机器学习模型的预测,但它需要计算特征所有可能的子集组合,计算成本较高。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 25
 0
- 0


 已为社区贡献1条内容

所有评论(0)