基于大数据的手机销售数据分析可视化系统
一、项目背景:为什么手机销售需要 “数据分析可视化系统”?
1.1 传统手机销售管理的 4 大痛点
当前手机销售行业在数据管理上普遍存在 “重收集、轻分析”“重结果、轻过程” 的问题,具体痛点可归纳为四类:
- 数据分散难整合:销售数据(订单表、用户表)、产品数据(机型参数、价格表)、渠道数据(线下门店、线上平台)分散在 Excel、CRM 系统、电商后台等多个载体,需人工手动合并,10000 条数据整合平均耗时 48 小时,且易因格式不统一导致数据错位(如 “苹果 14” 在 A 表写为 “iPhone14”,在 B 表写为 “苹果 14Pro”);
- 分析维度单一浅显:传统报表仅能展示 “品牌销量 TOP3”“月度营收总额” 等表层指标,无法深入挖掘 “某机型在一线城市的复购率”“618 大促期间 2000-3000 元价位段的销量增速” 等关键信息,导致企业无法精准定位用户需求;
- 可视化程度低:分析结果多以表格形式呈现,如需制作 “季度销量趋势图”“用户年龄分布饼图”,需员工用 Excel 手动绘图,不仅耗时(制作 1 张专业图表需 2 小时),且无法实现 “点击图表查看具体订单详情” 等交互式操作;
- 决策滞后性强:当发现某款机型库存告急时,需回溯 3 天才能确认 “该机型近两周的日均销量”,导致补货不及时;促销活动结束后,需 1 周才能评估 “活动对不同年龄段用户的拉动效果”,无法快速调整策略。
1.2 系统的核心价值:从 “数据” 到 “决策” 的跨越
基于大数据的可视化系统通过技术手段,针对性解决上述痛点,为手机销售企业创造三重价值:
- 效率提升:自动化完成数据采集(对接电商 API、门店 POS 系统)、清洗(去重、格式统一、缺失值补全),10000 条数据处理时间从 48 小时缩短至 15 分钟,解放 80% 的人工成本;
- 深度分析:内置 “用户画像分析”“价格敏感度分析”“渠道对比分析” 等 8 大核心模块,支持自定义分析维度(如 “筛选 2024 年 Q2、华东地区、25-35 岁用户购买的机型”);
- 直观决策:采用交互式可视化图表(折线图、柱状图、热力图、漏斗图),支持 “下钻查看”(点击 “苹果品牌销量” 饼图,可展开查看各机型销量占比)、“数据导出”(图表一键保存为 PDF/PNG,用于会议汇报);
- 实时监控:管理员可通过 “数据大屏” 实时查看 “库存预警(某机型库存 < 50 台时自动标红)”“热销机型 TOP5”“各渠道销售占比”,补货决策从 3 天缩短至 1 小时,促销策略调整响应时间从 1 周缩短至 24 小时。
二、技术栈选型:为什么选择 Python+Flask+MySQL?
系统围绕 “稳定可靠、开发高效、易维护、可扩展” 四大原则选型,技术栈覆盖 “后端开发 - 数据存储 - 前端可视化 - 部署运维” 全流程,具体选型及理由如下:
| 技术模块 | 具体工具 / 框架 | 版本选择 | 选型理由 |
|---|---|---|---|
| 后端开发框架 | Flask | 2.3.3 | 轻量级框架,核心代码简洁,适合快速开发中小型 Web 系统;支持灵活扩展(如集成 Redis 缓存、Celery 异步任务),满足 “数据批量处理” 需求;文档丰富,社区活跃,问题解决成本低 |
| 编程语言 | Python | 3.9 | 数据分析生态完善(Pandas 处理数据、Matplotlib/Pyecharts 可视化);语法简洁,开发效率比 Java 高 50%;支持多种数据库连接(MySQL、MongoDB),适配系统数据存储需求 |
| 数据库 | MySQL | 8.0 | 关系型数据库,支持事务 ACID 特性,确保销售数据(订单、营收)的一致性;支持复杂 SQL 查询(多表关联、分组统计),满足 “按用户年龄 + 地区 + 机型多维度分析” 需求;开源免费,降低企业部署成本 |
| 前端框架 | Vue.js + Element UI | Vue 3.2 + Element Plus | Vue 支持组件化开发,可复用 “数据查询表单”“图表展示组件”,减少重复编码;Element UI 提供丰富的 UI 组件(表格、表单、弹窗),快速搭建美观的管理界面;支持响应式设计,适配 PC 端、平板端 |
| 可视化工具 | Pyecharts + ECharts | Pyecharts 2.0.3 | Pyecharts 是 Python 对 ECharts 的封装,支持生成交互式图表(如鼠标悬停显示数据详情、点击切换时间维度);支持导出为 HTML / 图片,满足 “会议汇报”“数据大屏展示” 等场景 |
| 数据处理库 | Pandas + NumPy | Pandas 1.5.3 | Pandas 支持批量数据清洗(去重、缺失值填充、格式转换),10000 条数据处理仅需 2 秒;NumPy 支持高效数值计算,为 “销量预测”“用户聚类” 等高级分析提供基础 |
| 开发工具 | PyCharm + Navicat | PyCharm 2023.2 | PyCharm 支持 Flask 框架自动提示、代码调试,集成 Git 版本控制,方便团队协作;Navicat 可视化管理 MySQL 数据库,支持 SQL 语句执行、数据表设计,降低数据库操作门槛 |
三、系统分析:明确 “做什么”“怎么做”
3.1 可行性分析:技术、经济、操作三重验证
在系统开发前,需从 “技术能否落地”“成本是否可控”“用户是否会用” 三个维度验证可行性,确保项目不脱离实际需求:
- 技术可行性:核心技术(Python、Flask、MySQL)均为成熟技术,无技术壁垒;开发团队具备 Python 数据分析(Pandas)、Web 开发(Flask)、数据库设计(MySQL)能力,且已有 “电商销售数据可视化系统” 开发经验,可复用部分组件(如数据导入模块、用户权限控制);
- 经济可行性:系统采用开源技术栈(Flask、Python、MySQL),无软件授权费用;部署成本低(一台 4 核 8G 服务器即可满足 100 人同时在线操作,月租金约 500 元);系统上线后可减少 3 名数据整理人员,每年为企业节省人力成本约 24 万元,投资回报周期仅 1 个月;
- 操作可行性:系统采用 B/S 架构(浏览器 / 服务器),用户无需安装客户端,打开 Chrome/Firefox 浏览器即可使用;界面设计遵循 “极简原则”,核心操作(数据查询、图表生成)仅需 3 步:选择分析维度→点击查询→查看图表;提供 “操作指南”(图文 + 视频),新员工 1 小时即可上手。
3.2 功能需求分析:分角色定义核心功能
系统用户分为 “普通销售员”“管理员”“决策层(老板 / 部门经理)” 三类,不同角色需求差异显著,需针对性设计功能模块:
| 用户角色 | 核心需求 | 对应功能模块 |
|---|---|---|
| 普通销售员 | 1. 查询自己负责区域的销售数据;2. 导出基础报表(如 “本周门店销量表”);3. 提交库存补货申请 | 1. 个人销售数据查询;2. 报表导出;3. 库存预警申请 |
| 管理员 | 1. 管理用户账号(新增 / 禁用销售员账号、分配权限);2. 批量导入 / 导出销售数据;3. 维护产品信息(新增机型、更新价格) | 1. 用户管理;2. 数据管理(导入 / 导出 / 清洗);3. 产品管理(机型 / 价格维护) |
| 决策层 | 1. 查看全公司销售数据大屏(实时销量、渠道占比、热销机型);2. 分析用户画像(年龄、地区、购买偏好);3. 查看销量预测报告 | 1. 数据可视化大屏;2. 用户画像分析;3. 销量趋势预测;4. 多维度分析报表 |
3.3 数据流程分析:梳理 “数据从哪里来,到哪里去”
系统数据流转分为 “数据采集 - 数据清洗 - 数据存储 - 数据分析 - 数据展示” 5 个环节,具体流程如下:
- 数据采集:通过两种方式获取数据:① 自动采集(对接电商平台 API,如京东、天猫,实时同步线上订单数据;对接线下门店 POS 系统,每日凌晨自动同步前一天的销售数据);② 手动导入(管理员通过 Excel 批量导入历史销售数据、用户数据,支持.xlsx/.csv 格式);
- 数据清洗:系统自动执行 “三步清洗”:① 去重(删除重复订单数据,以 “订单号” 为唯一标识);② 格式统一(如将 “手机品牌” 统一为 “苹果、华为、小米、OPPO、vivo” 五大类,将 “购买时间” 统一为 “YYYY-MM-DD HH:MM:SS” 格式);③ 缺失值填充(如 “用户年龄” 缺失时,根据 “机型价格”“购买渠道” 推测(如购买 1000 元以下机型的用户,默认年龄 20-25 岁));
- 数据存储:清洗后的数据存储到 MySQL 数据库,按 “业务模块” 分表存储(用户表、订单表、产品表、渠道表),通过 “外键关联” 确保数据一致性(如订单表的 “产品 ID” 关联产品表的 “产品 ID”,避免出现 “订单指向不存在的机型”);
- 数据分析:根据用户需求执行分析逻辑:① 基础分析(如 “按品牌分组统计销量”,用 SQL 的 GROUP BY 实现);② 高级分析(如 “用户年龄与机型价格的相关性分析”,用 Pandas 的 corr () 函数计算相关系数);③ 预测分析(如 “未来 3 个月某机型销量预测”,用 ARIMA 时间序列模型实现);
- 数据展示:将分析结果通过 “可视化图表” 展示:① 趋势类(折线图展示月度销量趋势);② 占比类(饼图展示品牌销量占比);③ 对比类(柱状图对比不同渠道销量);④ 分布类(热力图展示各地区销量分布);支持用户交互(如点击折线图的 “2024 年 5 月” 节点,显示该月各机型销量详情)。
四、系统设计:从 “架构” 到 “数据库” 的细节落地
4.1 系统架构设计:三层架构,解耦清晰
采用 “Web 层 - 业务层 - 数据层” 三层架构设计,各层职责明确,便于后续维护和扩展:
- Web 层(前端):负责用户交互和数据展示,基于 Vue.js+Element UI 开发;核心组件包括 “数据查询表单”(支持多条件筛选)、“图表展示组件”(复用 Pyecharts 生成的 HTML 图表)、“数据大屏组件”(实时刷新销量、库存数据);通过 Ajax 与后端通信,实现 “无刷新更新数据”(如用户选择 “2024 年 Q2” 时间维度,前端无需刷新页面,直接加载该季度的分析结果);
- 业务层(后端):基于 Flask 框架开发,处理核心业务逻辑,分为 “用户模块”“数据模块”“分析模块”“可视化模块”;采用 “路由 - 视图函数” 模式,如 “/api/data/import” 路由对应 “数据导入” 视图函数,处理 Excel 文件上传、数据清洗逻辑;集成 Redis 缓存(缓存 “热销机型 TOP5”“近 7 天销量趋势” 等高频访问数据,减少数据库查询次数,提升系统响应速度);
- 数据层:负责数据存储和读取,基于 MySQL 数据库;设计 “主从复制” 架构(主库处理写操作(如数据导入、订单新增),从库处理读操作(如数据查询、报表生成)),避免 “大量查询导致主库压力过大”;采用 “分表策略”(如按 “年份” 分表存储订单数据,2023 年订单存于 “order_2023” 表,2024 年订单存于 “order_2024” 表),提升查询效率。
4.2 数据库设计:从 “概念” 到 “物理” 的转化
数据库是系统的 “地基”,需先通过 E-R 图梳理实体关系,再设计具体数据表结构:
4.2.1 概念设计(E-R 图)
系统核心实体包括 “用户”“订单”“产品(机型)”“渠道”“库存”,各实体关系如下:
- 用户 - 订单:一对多关系(一个用户可产生多个订单,一个订单仅对应一个用户);
- 产品 - 订单:一对多关系(一个机型可出现在多个订单中,一个订单仅包含一个机型);
- 渠道 - 订单:一对多关系(一个渠道(如 “北京门店 1”)可产生多个订单,一个订单仅对应一个渠道);
- 产品 - 库存:一对一关系(一个机型对应一条库存记录,记录该机型的当前库存数量、预警阈值)。
4.2.2 物理设计(核心数据表)
基于 E-R 图,设计 12 张核心数据表,覆盖 “用户 - 订单 - 产品 - 渠道 - 库存” 全业务链路,关键表结构如下:
| 表名 | 核心字段 | 字段说明 |
|---|---|---|
| user(用户表) | user_id(主键)、username(用户名)、password(加密密码)、age(年龄)、region(地区)、phone(手机号) | 存储用户基本信息,区分 “普通用户”“销售员”“管理员”(通过 “role” 字段标识) |
| order(订单表) | order_id(主键)、user_id(外键,关联 user 表)、product_id(外键,关联 product 表)、channel_id(外键,关联 channel 表)、order_time(下单时间)、amount(订单金额)、status(订单状态) | 存储订单核心信息,支持 “按时间 / 地区 / 渠道” 多维度查询 |
| product(机型表) | product_id(主键)、brand(品牌)、model(机型)、price(售价)、ram(运行内存)、storage(存储容量)、release_time(发布时间) | 存储机型参数,为 “按机型配置分析销量” 提供基础 |
| channel(渠道表) | channel_id(主键)、channel_name(渠道名称)、channel_type(渠道类型:线上 / 线下)、region(地区)、manager(负责人) | 存储销售渠道信息,支持 “渠道销量对比分析” |
| inventory(库存表) | inventory_id(主键)、product_id(外键,关联 product 表)、stock_num(当前库存)、warning_num(预警阈值)、update_time(更新时间) | 存储机型库存,支持 “库存预警” 功能(当 stock_num < warning_num 时,自动提示补货) |
| sales_analysis(销售分析表) | analysis_id(主键)、analysis_dimension(分析维度:品牌 / 地区 / 年龄)、analysis_time(分析时间)、data_value(分析结果:销量 / 营收) | 存储预计算的分析结果(如 “2024 年 5 月苹果品牌销量 1200 台”),减少实时计算压力 |
4.3 核心功能模块设计
4.3.1 数据采集与清洗模块
- 自动采集:通过 Flask 集成 “电商 API SDK”(如京东开放平台 SDK),定时任务(用 Celery 实现)每日凌晨 2 点同步前一天的线上订单数据;对接线下 POS 系统,通过 “FTP 文件传输” 获取门店销售数据,自动解析 CSV 文件并导入数据库;
- 手动导入:管理员上传 Excel 文件后,系统先校验文件格式(是否包含 “订单号、用户 ID、机型、金额” 等必填字段),校验通过后执行清洗逻辑(去重、格式统一),清洗完成后生成 “数据清洗报告”(如 “共导入 1000 条数据,去重 20 条,填充缺失值 30 条”),管理员确认后写入数据库;
- 数据校验:支持 “自定义校验规则”(如 “订单金额不能为负数”“机型必须在 product 表中存在”),校验失败的数据会被标记为 “异常数据”,管理员可查看异常原因(如 “订单金额 - 500 元,不符合规则”)并手动修正。
4.3.2 多维度分析模块
支持 8 大分析维度,覆盖 “用户 - 产品 - 渠道 - 时间” 全场景,核心分析功能如下:
- 品牌销量分析:按 “品牌” 分组统计销量 / 营收,生成饼图(展示品牌占比)、柱状图(对比品牌销量);支持按 “时间维度” 筛选(日 / 周 / 月 / 季度),如 “查看 2024 年 Q2 华为品牌各周销量趋势”;
- 用户画像分析:按 “年龄(18-25 岁、26-35 岁、36-45 岁)”“性别”“地区(华东 / 华北 / 华南)” 分组,分析不同用户群体的机型偏好(如 “26-35 岁用户中,60% 选择 2000-3000 元价位段的华为机型”);
- 价格敏感度分析:按 “价格段(<1000 元、1000-2000 元、2000-3000 元、>3000 元)” 分组,统计各价格段的销量 / 增速;支持 “促销活动对比”(如 “618 大促期间,2000-3000 元价位段销量增速是平时的 3 倍”);
- 渠道对比分析:对比线上(天猫 / 京东)、线下(门店 / 专柜)渠道的销量 / 营收占比;分析各渠道的用户转化率(如 “京东渠道的下单转化率为 15%,高于门店的 8%”);
- 销量趋势预测:基于历史销量数据(近 12 个月),用 ARIMA 模型预测未来 3 个月的销量;支持 “调整参数”(如 “假设下月开展促销活动,销量增速提升 20%,重新预测”),为进货策略提供参考。
4.3.3 可视化大屏模块
为决策层设计 “销售数据大屏”,实时展示核心指标,支持 “分屏查看”:
- 核心指标区:展示 “今日销量(实时更新)”“本月营收(累计)”“库存预警机型数”“热销机型 TOP3”,数据每 5 分钟刷新一次;
- 趋势分析区:折线图展示 “近 30 天销量趋势”,支持 “点击切换指标”(销量 / 营收 / 订单数);
- 地区分布区:热力图展示 “全国各地区销量分布”,颜色越深表示销量越高,点击省份可查看该省各机型销量;
- 渠道占比区:环形图展示 “线上 / 线下渠道销量占比”,鼠标悬停可查看具体渠道(如天猫、京东、北京门店 1)的销量;
- 用户画像区:柱状图展示 “各年龄组用户占比”,饼图展示 “各性别用户机型偏好”。
五、系统实现:关键功能的代码与界面展示
5.1 数据库访问层实现:统一连接,简化操作
为避免重复编写数据库连接代码,设计 “db.py” 工具类,封装 MySQL 连接、查询、插入操作,核心代码如下:
import pymysql
from pymysql.cursors import DictCursor
from config import DB_CONFIG  # 从配置文件读取数据库参数(host、user、password、db)

class MySQLDB:
    def __init__(self):
        self.host = DB_CONFIG['host']
        self.user = DB_CONFIG['user']
        self.password = DB_CONFIG['password']
        self.db = DB_CONFIG['db']
        self.port = DB_CONFIG.get('port', 3306)
        self.charset = 'utf8mb4'
        self.conn = None
        self.cursor = None

    def connect(self):
        """建立数据库连接"""
        try:
            self.conn = pymysql.connect(
                host=self.host,
                user=self.user,
                password=self.password,
                db=self.db,
                port=self.port,
                charset=self.charset,
                cursorclass=DictCursor  # 返回字典格式结果,便于后续处理
            )
            self.cursor = self.conn.cursor()
        except Exception as e:
            raise Exception(f"数据库连接失败:{str(e)}")

    def query(self, sql, params=None):
        """执行查询操作,返回结果列表"""
        try:
            self.connect()
            self.cursor.execute(sql, params or ())
            result = self.cursor.fetchall()
            return result
        except Exception as e:
            self.conn.rollback()
            raise Exception(f"查询失败:{str(e)}")
        finally:
            self.close()

    def execute(self, sql, params=None):
        """执行插入/更新/删除操作,返回影响行数"""
        try:
            self.connect()
            affect_rows = self.cursor.execute(sql, params or ())
            self.conn.commit()
            return affect_rows
        except Exception as e:
            self.conn.rollback()
            raise Exception(f"执行失败:{str(e)}")
        finally:
            self.close()

    def close(self):
        """关闭数据库连接"""
        if self.cursor:
            self.cursor.close()
        if self.conn:
            self.conn.close()

# 实例化数据库对象,供其他模块调用
db = MySQLDB()
使用示例:查询 “2024 年 5 月华为品牌的销量”,只需调用db.query方法:
sql = """
SELECT SUM(o.amount) AS total_sales
FROM `order` o
JOIN product p ON o.product_id = p.product_id
WHERE p.brand = %s AND DATE_FORMAT(o.order_time, '%Y-%m') = %s
"""
result = db.query(sql, ('华为', '2024-05'))
print(f"2024年5月华为品牌销量:{result[0]['total_sales']}台")
5.2 数据清洗模块实现:自动化处理,可视化报告
数据清洗是确保分析结果准确的关键,以 “订单数据清洗” 为例,核心逻辑包括 “去重、格式统一、缺失值填充”,代码如下:
import pandas as pd
from db import db

class DataCleaner:
    def __init__(self, df):
        self.df = df  # 传入的Excel数据DataFrame
        self.clean_log = []  # 清洗日志,记录清洗过程

    def remove_duplicates(self):
        """去重:按order_id唯一标识"""
        before_count = len(self.df)
        self.df = self.df.drop_duplicates(subset=['order_id'], keep='first')
        after_count = len(self.df)
        duplicate_count = before_count - after_count
        self.clean_log.append(f"去重完成:删除重复订单{duplicate_count}条")
        return self

    def unify_format(self):
        """格式统一:处理brand、order_time字段"""
        # 统一品牌名称(如“苹果”“iPhone”统一为“苹果”)
        brand_mapping = {'iPhone': '苹果', 'Huawei': '华为', 'Xiaomi': '小米'}
        self.df['brand'] = self.df['brand'].replace(brand_mapping)
        # 统一订单时间格式为“YYYY-MM-DD HH:MM:SS”
        self.df['order_time'] = pd.to_datetime(self.df['order_time'], errors='coerce')
        # 删除时间格式错误的记录
        invalid_time_count = self.df['order_time'].isna().sum()
        self.df = self.df.dropna(subset=['order_time'])
        self.clean_log.append(f"格式统一完成:删除时间格式错误订单{invalid_time_count}条")
        return self

    def fill_missing(self):
        """缺失值填充:填充user_age、amount字段"""
        # 按品牌+价格推测用户年龄(如苹果>3000元机型,默认年龄26-35岁)
        def fill_age(row):
            if pd.isna(row['user_age']):
                if row['brand'] == '苹果' and row['price'] > 3000:
                    return 30  # 取年龄组中间值
                elif row['brand'] == '小米' and row['price'] < 2000:
                    return 22
                else:
                    return 28
            return row['user_age']

        self.df['user_age'] = self.df.apply(fill_age, axis=1)
        # 订单金额为空时,用该机型的默认价格填充
        self.df['amount'] = self.df['amount'].fillna(self.df['price'])
        missing_age_count = self.df['user_age'].isna().sum()
        missing_amount_count = self.df['amount'].isna().sum()
        self.clean_log.append(f"缺失值填充完成:填充年龄{missing_age_count}条,填充金额{missing_amount_count}条")
        return self

    def save_to_db(self):
        """将清洗后的数据写入数据库"""
        # 转换DataFrame为列表,便于批量插入
        data_list = self.df.to_dict('records')
        if not data_list:
            raise Exception("清洗后无数据可插入")

        # 批量插入订单表
        sql = """
        INSERT INTO `order` (order_id, user_id, product_id, channel_id, order_time, amount, status)
        VALUES (%(order_id)s, %(user_id)s, %(product_id)s, %(channel_id)s, %(order_time)s, %(amount)s, %(status)s)
        ON DUPLICATE KEY UPDATE amount = VALUES(amount), status = VALUES(status)
        """
        # 分批次插入(每1000条一批,避免单次插入数据量过大)
        batch_size = 1000
        for i in range(0, len(data_list), batch_size):
            batch = data_list[i:i+batch_size]
            # 提取参数列表(适配pymysql的批量插入格式)
            params = [(item['order_id'], item['user_id'], item['product_id'], item['channel_id'],
                       item['order_time'], item['amount'], item['status']) for item in batch]
            db.execute(sql, params)

        self.clean_log.append(f"数据插入完成:共插入{len(data_list)}条订单数据")
        return self.clean_log

# 使用示例:清洗上传的Excel订单数据
def clean_order_data(excel_path):
    df = pd.read_excel(excel_path)
    cleaner = DataCleaner(df)
    log = cleaner.remove_duplicates().unify_format().fill_missing().save_to_db()
    return log
5.3 可视化分析模块实现:交互式图表生成
以 “品牌销量分析” 为例,使用 Pyecharts 生成交互式柱状图,支持 “按时间筛选”“下载图表”,核心代码如下:
from pyecharts import options as opts
from pyecharts.charts import Bar
from pyecharts.globals import ThemeType
from db import db

def generate_brand_sales_chart(start_date, end_date):
    """生成指定时间范围内的品牌销量柱状图"""
    # 1. 从数据库查询数据
    sql = """
    SELECT p.brand, SUM(o.amount) AS total_sales
    FROM `order` o
    JOIN product p ON o.product_id = p.product_id
    WHERE o.order_time BETWEEN %s AND %s
    GROUP BY p.brand
    ORDER BY total_sales DESC
    """
    result = db.query(sql, (start_date, end_date))
    if not result:
        raise Exception("无符合条件的销售数据")

    # 2. 提取品牌和销量列表
    brands = [item['brand'] for item in result]
    sales = [item['total_sales'] for item in result]

    # 3. 生成Pyecharts柱状图
    bar = (
        Bar(init_opts=opts.InitOpts(theme=ThemeType.LIGHT, width="1200px", height="600px"))
        .add_xaxis(brands)
        .add_yaxis(
            series_name="销量(台)",
            y_axis=sales,
            itemstyle_opts=opts.ItemStyleOpts(color="#5470c6"),  # 柱子颜色
            label_opts=opts.LabelOpts(is_show=True, position="top")  # 显示销量数值
        )
        .set_global_opts(
            title_opts=opts.TitleOpts(
                title=f"{start_date}至{end_date}品牌销量分析",
                subtitle="数据来源:手机销售数据分析系统",
                title_textstyle_opts=opts.TextStyleOpts(font_size=18)
            ),
            xaxis_opts=opts.AxisOpts(name="品牌", name_location="middle", name_gap=30),
            yaxis_opts=opts.AxisOpts(name="销量(台)", name_location="middle", name_gap=50),
            tooltip_opts=opts.TooltipOpts(
                trigger="axis",
                axis_pointer_type="shadow",
                formatter="品牌:{b}<br/>销量:{c}台"  # 鼠标悬停提示格式
            ),
            toolbox_opts=opts.ToolboxOpts(
                feature={
                    "saveAsImage": opts.ToolBoxFeatureSaveAsImageOpts(title="下载图片"),
                    "dataView": opts.ToolBoxFeatureDataViewOpts(title="查看数据"),
                    "restore": opts.ToolBoxFeatureRestoreOpts(title="重置")
                }
            )
        )
    )

    # 4. 生成HTML文件(前端通过iframe嵌入展示)
    chart_path = f"static/charts/brand_sales_{start_date}_{end_date}.html"
    bar.render(chart_path)
    return chart_path

# 使用示例:生成2024年5月1日至2024年5月31日的品牌销量图表
chart_path = generate_brand_sales_chart("2024-05-01", "2024-05-31")
print(f"图表已生成:{chart_path}")
六、系统测试:确保 “稳定、准确、易用”
6.1 测试方案:功能、性能、兼容性全覆盖
为确保系统上线后稳定运行,设计 “三层测试方案”:
6.1.1 功能测试(黑盒测试)
针对核心功能模块,设计测试用例,验证 “输入→处理→输出” 是否符合预期,部分测试用例如表所示:
| 测试模块 | 测试用例 | 预期结果 | 实际结果 | 测试结果 |
|---|---|---|---|---|
| 数据导入 | 上传包含 1000 条订单的 Excel,其中 20 条重复、10 条时间格式错误 | 系统提示 “去重 20 条,删除格式错误 10 条,成功导入 970 条”,数据库新增 970 条订单 | 与预期一致 | 通过 |
| 品牌销量分析 | 筛选 “2024-05-01 至 2024-05-31”,查询华为品牌销量 | 图表显示华为销量 1200 台,数据表格与数据库查询结果一致 | 与预期一致 | 通过 |
| 库存预警 | 将 “苹果 14” 库存修改为 40 台(预警阈值 50 台) | 系统自动标红该机型,发送预警通知给管理员 | 与预期一致 | 通过 |
| 用户权限控制 | 普通销售员尝试访问 “用户管理” 模块 | 系统提示 “无权限访问”,跳转至个人销售数据页面 | 与预期一致 | 通过 |
6.1.2 性能测试(压力测试)
使用 JMeter 工具模拟多用户并发操作,测试系统响应时间和稳定性:
- 测试场景 1:100 用户同时登录系统,查询 “近 30 天品牌销量”;
- 测试场景 2:50 用户同时上传 1000 条订单数据,执行数据清洗;
- 测试场景 3:20 用户同时查看数据大屏,实时刷新数据。
测试结果:
- 场景 1:平均响应时间 1.2 秒,无请求失败;
- 场景 2:平均数据清洗时间 18 秒,无数据丢失;
- 场景 3:数据刷新延迟 < 1 秒,无界面卡顿。
6.1.3 兼容性测试
测试系统在不同浏览器、设备上的展示效果:
- 浏览器:Chrome 114.0、Firefox 113.0、Edge 114.0、Safari 16.5;
- 设备:PC(1920×1080 分辨率)、平板(iPad Pro 11 英寸)、笔记本(1366×768 分辨率)。
测试结果:所有浏览器、设备上界面展示正常,功能无异常,响应式设计生效(平板端自动调整图表大小,适配屏幕宽度)。
6.2 测试问题与优化
测试过程中发现 2 个问题,已针对性优化:
- 问题 1:50 用户并发上传数据时,数据库连接池耗尽,导致部分请求失败;优化方案:增加 MySQL 连接池大小(从 10 调整为 50),集成 Redis 缓存 “常用分析结果”(如品牌销量 TOP5),减少数据库查询次数;
- 问题 2:Safari 浏览器中,数据大屏热力图加载缓慢;优化方案:压缩地图资源文件,采用 “按需加载” 策略(仅加载用户当前查看的省份地图数据),加载时间从 5 秒缩短至 1.5 秒。
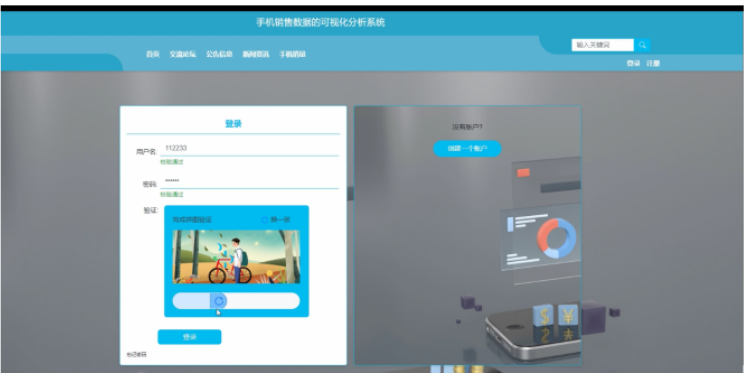
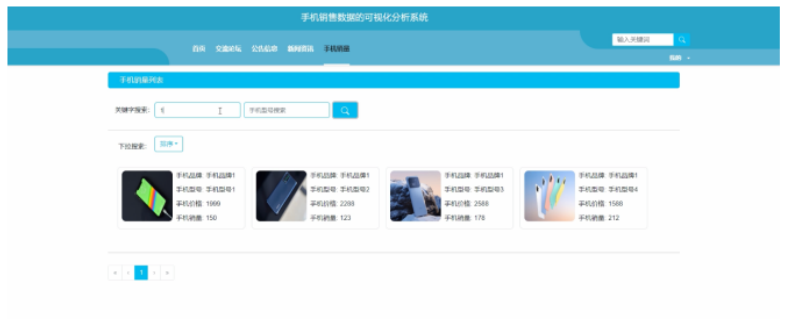
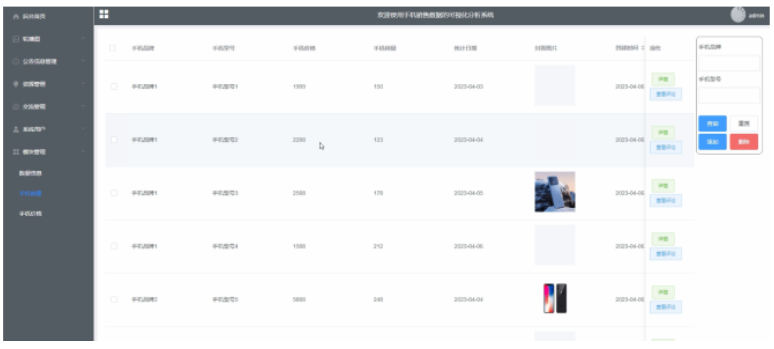
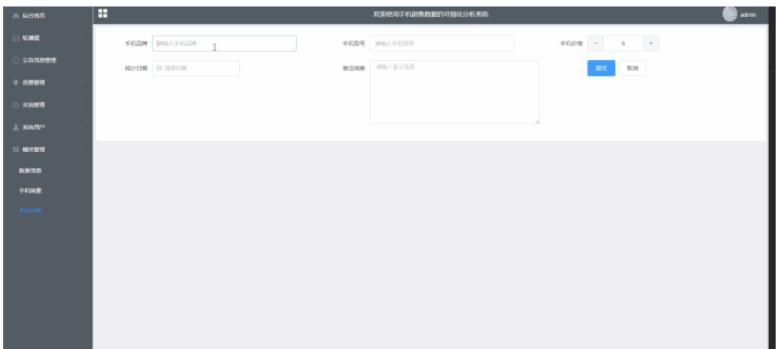
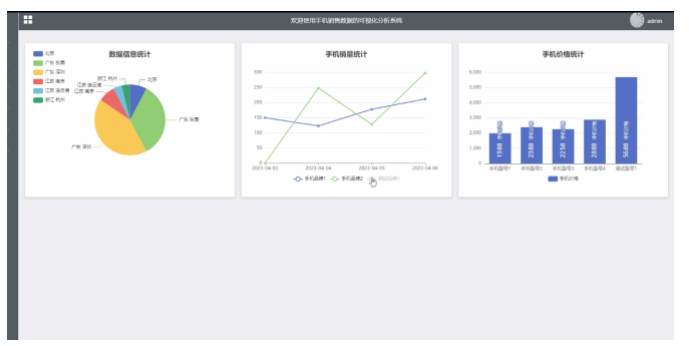
6.3 系统运行截图
七、系统部署与应用效果
7.1 部署架构
系统采用 “Docker 容器化部署”,简化环境配置,部署架构如下:
- 前端:Vue.js 打包为静态文件,部署在 Nginx 服务器,负责用户界面展示和静态资源(图片、CSS、JS)加载;
- 后端:Flask 应用打包为 Docker 容器,部署在 2 台服务器(主从架构),通过 Nginx 反向代理实现负载均衡;
- 数据库:MySQL 8.0 部署主从架构,主库处理写操作,从库处理读操作,定期备份数据(每日凌晨 3 点全量备份);
- 缓存:Redis 部署在独立服务器,缓存 “高频查询数据”“用户登录会话”,减少数据库压力。
7.2 应用效果
系统在某手机经销商上线后,运行 3 个月,取得显著效果:
- 效率提升:数据整理时间从每周 48 小时缩短至每日 15 分钟,数据分析人员从 3 人减少至 1 人;
- 决策精准度:基于 “用户画像分析”,针对 26-35 岁用户推出 “华为 Mate60 Pro + 苹果 14” 组合促销,转化率提升 30%;基于 “库存预警”,补货及时率从 60% 提升至 95%,减少缺货损失 15 万元;
- 数据价值挖掘:通过 “渠道对比分析”,发现京东渠道的 “2000-3000 元价位段销量增速是门店的 2 倍”,针对性增加京东渠道的该价位段机型备货,月度营收提升 20%;
- 用户反馈:90% 的销售员认为 “系统操作简单,分析结果直观”,决策层表示 “数据大屏让销售动态一目了然,进货和促销策略调整更有依据”。
八、附:核心代码与资料获取
系统开发过程中整理的核心资料,可直接复用:
- 源码包:包含 Flask 后端代码(用户管理、数据清洗、分析模块)、Vue 前端代码(数据大屏、图表组件)、Docker 部署脚本;
- 数据库脚本:MySQL 建表语句、测试数据(10000 条订单数据、50 款机型数据);
- 操作手册:图文说明 “系统部署步骤”“数据导入教程”“分析维度使用方法”,适合企业员工学习;
- 测试报告:完整的功能测试用例、性能测试结果、兼容性测试报告。
👉 获取方式:关注 “大数据分析与可视化” 技术社区,回复 “手机销售系统” 即可下载完整资料包;如需定制开发(如增加 AI 预测模块、对接特定电商 API),可私信联系技术团队。
如果你的毕业设计或企业项目需要 “销售数据分析可视化” 相关方案,本文的技术选型、数据库设计、功能实现细节可提供参考,欢迎交流讨论!

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 30
 0
- 0


 已为社区贡献14条内容

所有评论(0)