[Kubernetes] Kubernetes集群概念:Pod
工作负载
https://kubernetes.io/zh-cn/docs/concepts/workloads/
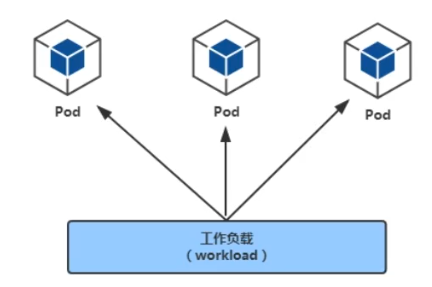
工作负载(workload)是在kubernetes集群中运行的应用程序。无论你的工作负载是单一服务还是多个一 同工作的服务构成,在kubernetes中都可以使用pod来运行它。
workloads分为pod与controllers
-
pod通过控制器实现应用的运行,如何伸缩,升级等
-
controllers 在集群中管理pod
-
pod与控制器之间通过label-selector相关联,是唯一的关联方式
在pod的YAML里指定pod标签
# 定义标签
labels:
  app: nginx
在控制器的YAML里指定标签选择器匹配标签
# 通过标签选择器选择对应的pod
selector:
  matchLabels:
    app: nginx
pod介绍
pod定义与分类
https://kubernetes.io/zh-cn/docs/concepts/workloads/pods/
Pod定义
-
Pod是Kubernetes集群管理(创建、部署)与调度的最小计算单元,表示处于运行状态的一组容器。
-
Pod不是进程,而是容器运行的环境。
-
一个Pod可以封装一个容器或多个容器(主容器或sidecar边车容器)
-
一个pod内的多个容器之间共享部分命名空间,例如:Net Namespace,UTs Namespace,IPC Namespace及存储资源
-
用户pod默认会被调度运行在node节点之上(不运行在master节点上,但也有例外情况)
-
pod内的IP不是固定的,集群外不能直接访问pod
Pod分类
-
静态Pod 也称之为“无控制器管理的自主式pod”,直接由特定节点上的 kubelet 守护进程管理,不需要API 服务器看到它们,尽管大多数 Pod都是通过控制平面控制器(例如,Deployment)来管理的,对于静态 Pod 而言,kubelet 直接监控每个 Pod,并在其失效时重启之。
-
控制器管理的pod控制器可以控制pod的副本数,扩容与裁剪,版本更新与回滚等
查看pod方法
pod是一种计算资源,可以通过kubectl get pod来查看
kubectl get pod
##pod或者pods都可以,不指定namespace,默认名是default的namespace

kubectl get pod -n kube-system
pod的YAML资源清单格式
# yam1格式的pod定义文件完整内容:
apiVersion:v1 #必选,api版本号,例如v1
kind: Pod #必选,Pod
metadata: #必选,元数据
  name: string #必选,Pod名称
  namespace:string #Pod所属的命名空间,默认在default的namespace
  labels: #自定义标签
    name: string #自定义标签名字
  annotations : #自定义注释列表
    name: string
spec: #必选,Pod中容器的详细定义(期望)
  containers: #必选,Pod中容器列表
  - name: string #必选,容器名称
    image: string #必选,容器的镜像名称
    imagePullPolicy: [Always | Never | IfNotPresent] #获取镜像的策略 Alawys表示下载镜像 Ifnotpresent表示优先使用本地镜像,否则下载镜像,Nerver表示仅使用本地镜像
    command: [string] #容器的启动命令列表,如不指定,使用打包时的启动命令
    args: [string] #容器的启动命令参数列表
    workingDir: string #容器的工作目录
    volumeMounts: #挂载到容器内部的存储卷配置
    - name: string #引用pod定义的共享存储卷的名称,需用vo1umes[]部分定义的的卷名
    mountPath: string #存储卷在容器内mount的绝对路径,应少于512字符
    readOnly: boolean #是否为只读模式
  ports: #需要暴露的端口库号列表
  - name: string #端口号名称
    containerPort: int #容器需要监听的端口号
    hostPort:int #容器所在主机需要监听的端口号,默认与Container相同
    protocol: string #端口协议,支持TCP和UDP,默认TCP
  env: #容器运行前需设置的环境变量列表
  - name: string #环境变量名称
    value: string #环境变量值
  resources: #资源限制和请求的设置
    limits: #资源限制设置
      cpu: string #Cpu的限制,单位为core数,将用于docker run--cpu-shares参数
      memory: string #内存限制,单位可以为Mib/Gib,将用于docker run --memory参数
    requests: #资源请求的设置
      cpu: string #cpu请求,容器启动的初始可用数量
      memory: string #内存清求,容器启动的初始可用数量
    livenessProbe: #对Pod内个容器健康检查的设置,当探测无响应几次后将自动重启该容器,检查方法有exec、httpGet和tcpsocket,对一个容器只需设置其中一种方法即可
      exec: #对Pod容器内检查方式设置为exec方式
        command: [string] #exec方式需要制定的命令或脚本
      httpGet: #对Pod内个容器健康检查方法设置为HttpGet,需要制定Path、port
        path: string
        port: number
        host: string
        scheme: string
        HttpHeaders:
        - name: string
          value: string
      tcpSocket: #对Pod内个容器健康检查方式设置为tcpsocket方式
        port: number
      initialDelaySeconds: 0 #容器启动完成后首次探测的时间,单位为秒
      timeoutSeconds: 0 #对容器健康检查探测等待响应的超时时间,单位秒,默认1秒
      periodSeconds: 0 #对容器监控检查的定期探测时间设置,单位秒,默认10秒一次
      successThreshold: 0
      failureThreshold: 0
      securityContext:
        privileged: false
    restartPolicy: [Always | Never | OnFailure] #pod的重启策略,Always表示一旦不管以何种方式终止运行,kubelet都将重启,0nFai1ure表示只有Pod以非0退出码退出才重启,Nerver表示不再重启该Pod
    nodeSelector: object #设置NodeSelector表示将该Pod调度到包含这个1abel的node上,以key:value的格式指定
    imagePullSecrets: #私有镜像仓库Pu11镜像时使用的secret名称,以key:secretkey格式指定
    - name: string
    hostNetwork:false #是否使用主机网络模式,默认为fa1se,如果设置为true,表示使用宿主机网络
    volumes: #在该pod上定义共享存储卷列表
    - name: string #共享存储卷名称(volumes类型有很多种)
      emptyDir: {} #类型为emtyDir的存储卷,与Pod同生命周期的一个临时目录。为空值
      hostPath: string #类型为hostPath的存储卷,表示挂载Pod所在宿主机的目录
        path: string #Pod所在宿主机的目录,将被用于同期中mount的目录
      secret: #类型为secret的存储卷,挂载集群与定义的secret对象到容器内部
        secretname: string
        items:
        - key: string
          path: string
      configMap: #类型为configMap的存储卷,挂载预定义的configMap对象到容器内部
        name: string
        items:
        - key: string
          path: string
YAML格式查找帮助
kubectl explain pod
pod创建与验证
命令创建pod
创建名为pod-nginx的pod
kubectl run nginx1 --image=nginx:1.26-alpine

拉取失败需要检查:
-
镜像名称是否正确
-
仓库地址是否正确
-
calico是否正常运行
-
网络是否正常
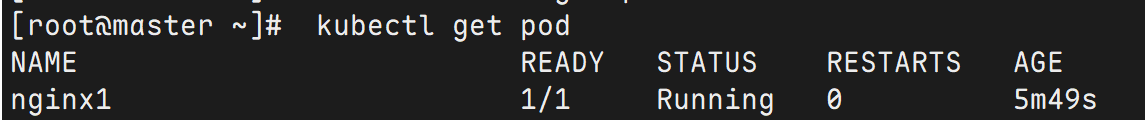
验证
kubectl get pods
YAML创建pod
vim pod1.yaml
#写入
apiVersion: v1
kind: Pod
metadata:
  name: pod-stress
spec:
  containers:
  - name: c1
    image: polinux/stress
    command: ["stress"]
    args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]


#------------------解析-------------------#
apiVersion: v1 #api版本
kind: Pod #资源类型为Pod
metadata:
name: pod-stress #自定义pod名称
spec:
containers: #定义pod里包含的容器
- name: c1 #自定义pod中的容器名
image: polinux/stress #启动容器的镜像名
command: ["stress"] #自定义启动容器时要执行的命令(类似dockerfile里的CMD)
args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"] #自定义启动容器执行命令的参数
#polinux/stress这个镜像用于压力测试,在启动容器时传命令与参数就是相当于分配容器运行时需要的压力
通过yaml文件创建pod
kubectl apply -f pod1.yml
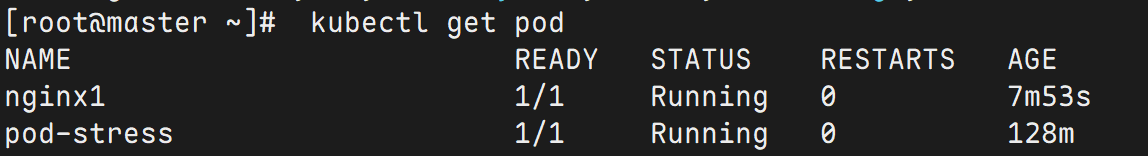
查看pod信息
kubectl get pod
查看pod详细信息
kubectl get pods -o wide

描述pod详细信息
kubectl describe pod pod-stress
删除pod
单个pod删除
在没有控制器管理的前提下可以直接删除,但是如果有控制器管理,控制器就会重新拉起pod
kubectl delete pod pod-stress
# 或
kubectl delete -f pod1.yml
多个pod删除
- 后面接多个pod名
kubectl delete pod tomcat-test-7d8bdf894-p62j5 tomcat-test-7d8bdf894-xp8vf
- 通过awk截取要删除的pod名称(NR>1 从第2行开始取),然后管道给xargs
kubectl get pods | awk 'NR>1 {print $1}' | xargs kubectl delete pod
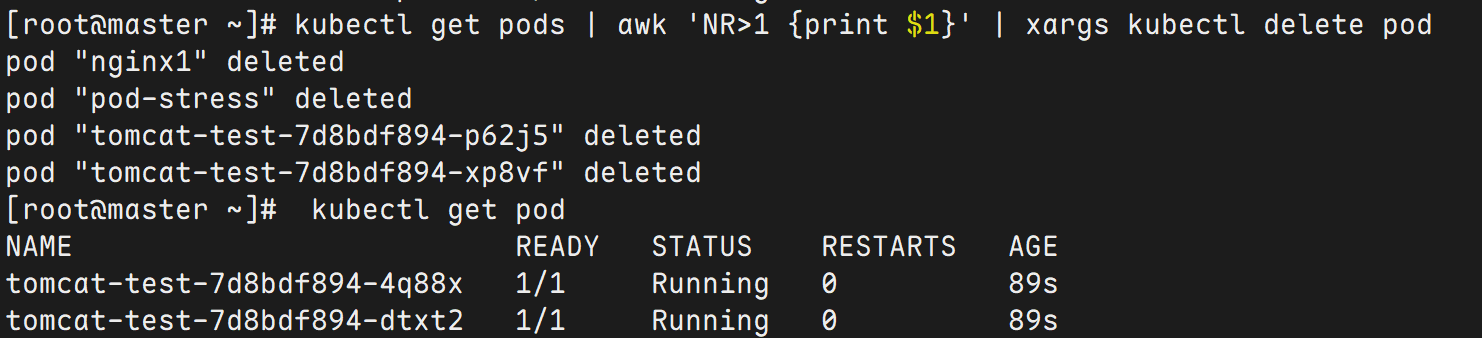
可以看到,虽然被重新拉起了,但是名称已经和原来不同了
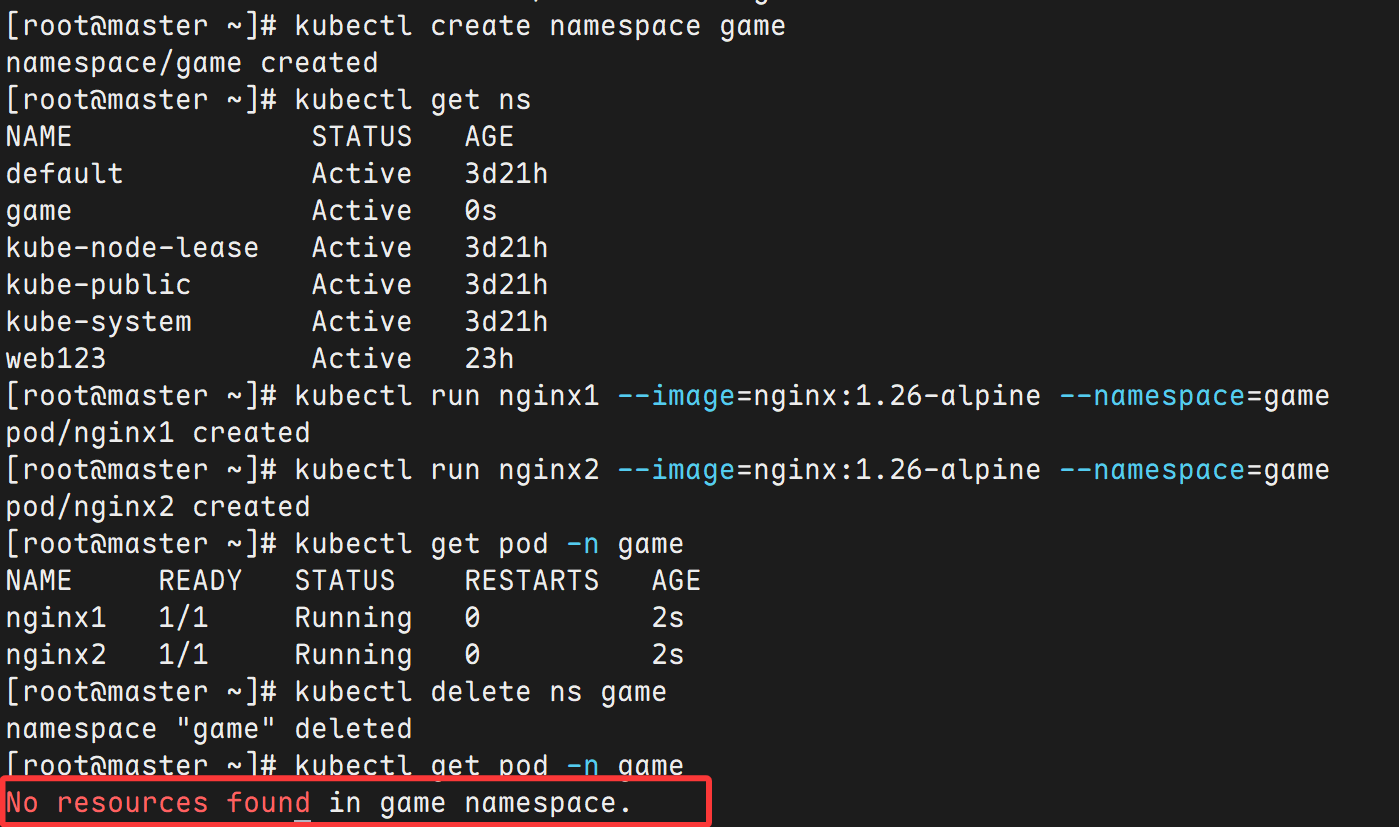
如果要删除的pod都在同一个非default的命名空间,则可直接删除命令空间
kubectl create namespace game
kubectl get ns
kubectl run nginx1 --image=nginx:1.26-alpine --namespace=game
kubectl run nginx2 --image=nginx:1.26-alpine --namespace=game
kubectl get pod -n game
kubectl delete ns game
镜像拉取策略
由imagePullPolicy参数控制
-
Always:不管本地有没有镜像,都要从仓库中下载镜像
-
Never:从来不从仓库下载镜像,只用本地镜像,本地没有就算了
-
IfNotPresent:如果本地存在就直接使用,不存在才从仓库下载
默认的策略是:
-
当镜像标签版本是latest,默认策略就是Always
-
如果指定特定版本默认拉取策略就是IfNotPresent
pod的标签
为pod设置label,用于控制器通过label与pod关联
语法与前面学的node标签几乎一致
通过命令管理pod标签
查看pod的标签
kubectl get pods --show-labels
打标签
kubectl label pod pod-stress region=nanjing zone=A env=test bussiness=game
通过等值关系标签查询
kubectl get pods -l zone=A
通过集合关系标签查询
kubectl get pods -l "zone in (A,B,C)"
删除标签后再验证
kubectl label pod pod-stress region- zone- env- bussiness-
kubectl get pods --show-labels
总结:
-
pod的label与node的label操作方式几乎相同
-
node的label用于pod调度到指定label的node节点
-
pod的label用于controller关联控制的pod
通过YAML创建pod时添加标签
修改yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-stress
  labels:    #添加
    zone: south    #添加 key
    business: AI    #添加 value
spec:
  containers:
  - name: c1
    image: polinux/stress
    imagePullPolicy: IfNotPresent
    command: ["stress"]
    args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]
    imagePullPolicy: IfNotPresent
更新并验证
kubectl apply -f pod1.yml
kubectl get pod --show-labels
pod资源限制
准备2个不同限制方式,创建pod的yaml文件
apiVersion: v1
kind: Namespace
metadata:
  name: namespace1
---
apiVersion: v1
kind: Pod
metadata:
  name: pod-stress2
  namespace: namespace1
spec:
  containers:
  - name: c1
    image: polinux/stress
    command: ["stress"]
    args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]
    imagePullPolicy: IfNotPresent
    resources:
      limits:
        memory: "200Mi"
      requests:
        memory: "100Mi"
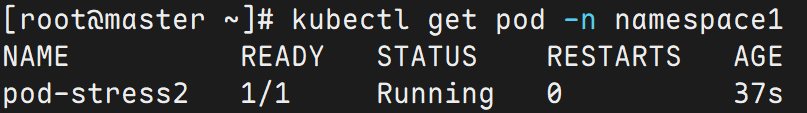
kubectl apply -f pod2.yaml
查看资源
kubectl get pod -n namespace1
创建超出限制的资源文件
apiVersion: v1
kind: Namespace
metadata:
  name: namespace1
---
apiVersion: v1
kind: Pod
metadata:
  name: pod-stress3
  namespace: namespace1
spec:
  containers:
  - name: c1
    image: polinux/stress
    command: ["stress"]
    args: ["--vm","1","--vm-bytes","250M","--vm-hang","1"]    ##超出资源限制
    imagePullPolicy: IfNotPresent
    resources:
      limits:
        memory: "200Mi"
      requests:
        memory: "150Mi"    #启动升为150M
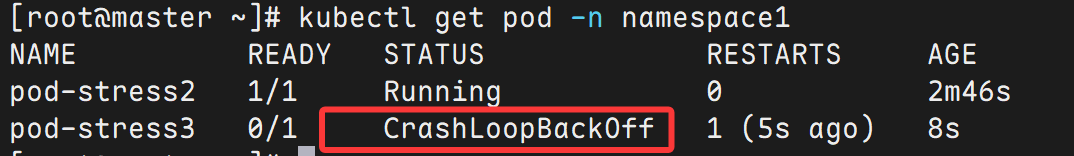
kubectl apply -f pod3.yaml
kubectl get pod -n namespace1
kubectl describe pod pod-stress3 -n namespace1
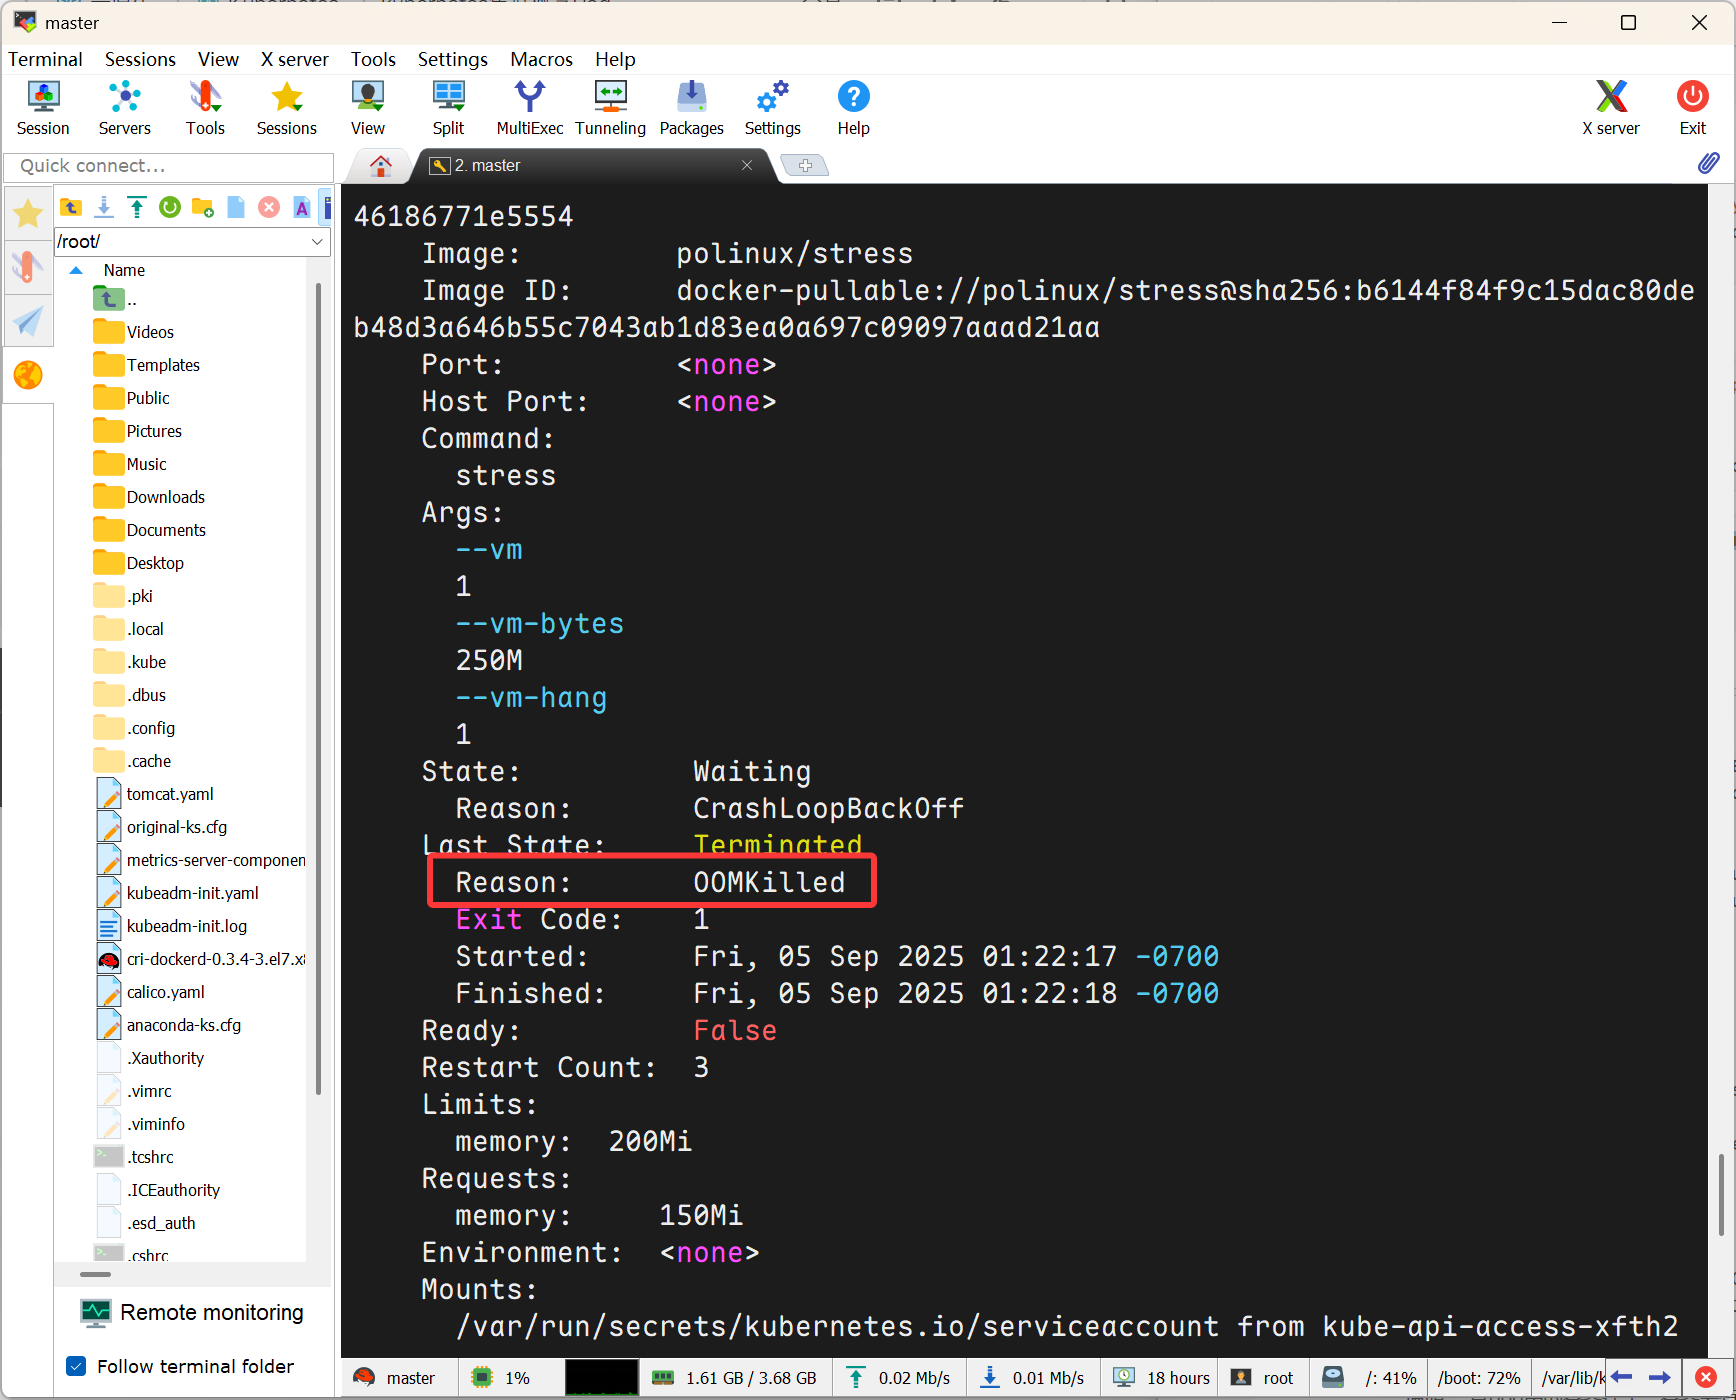
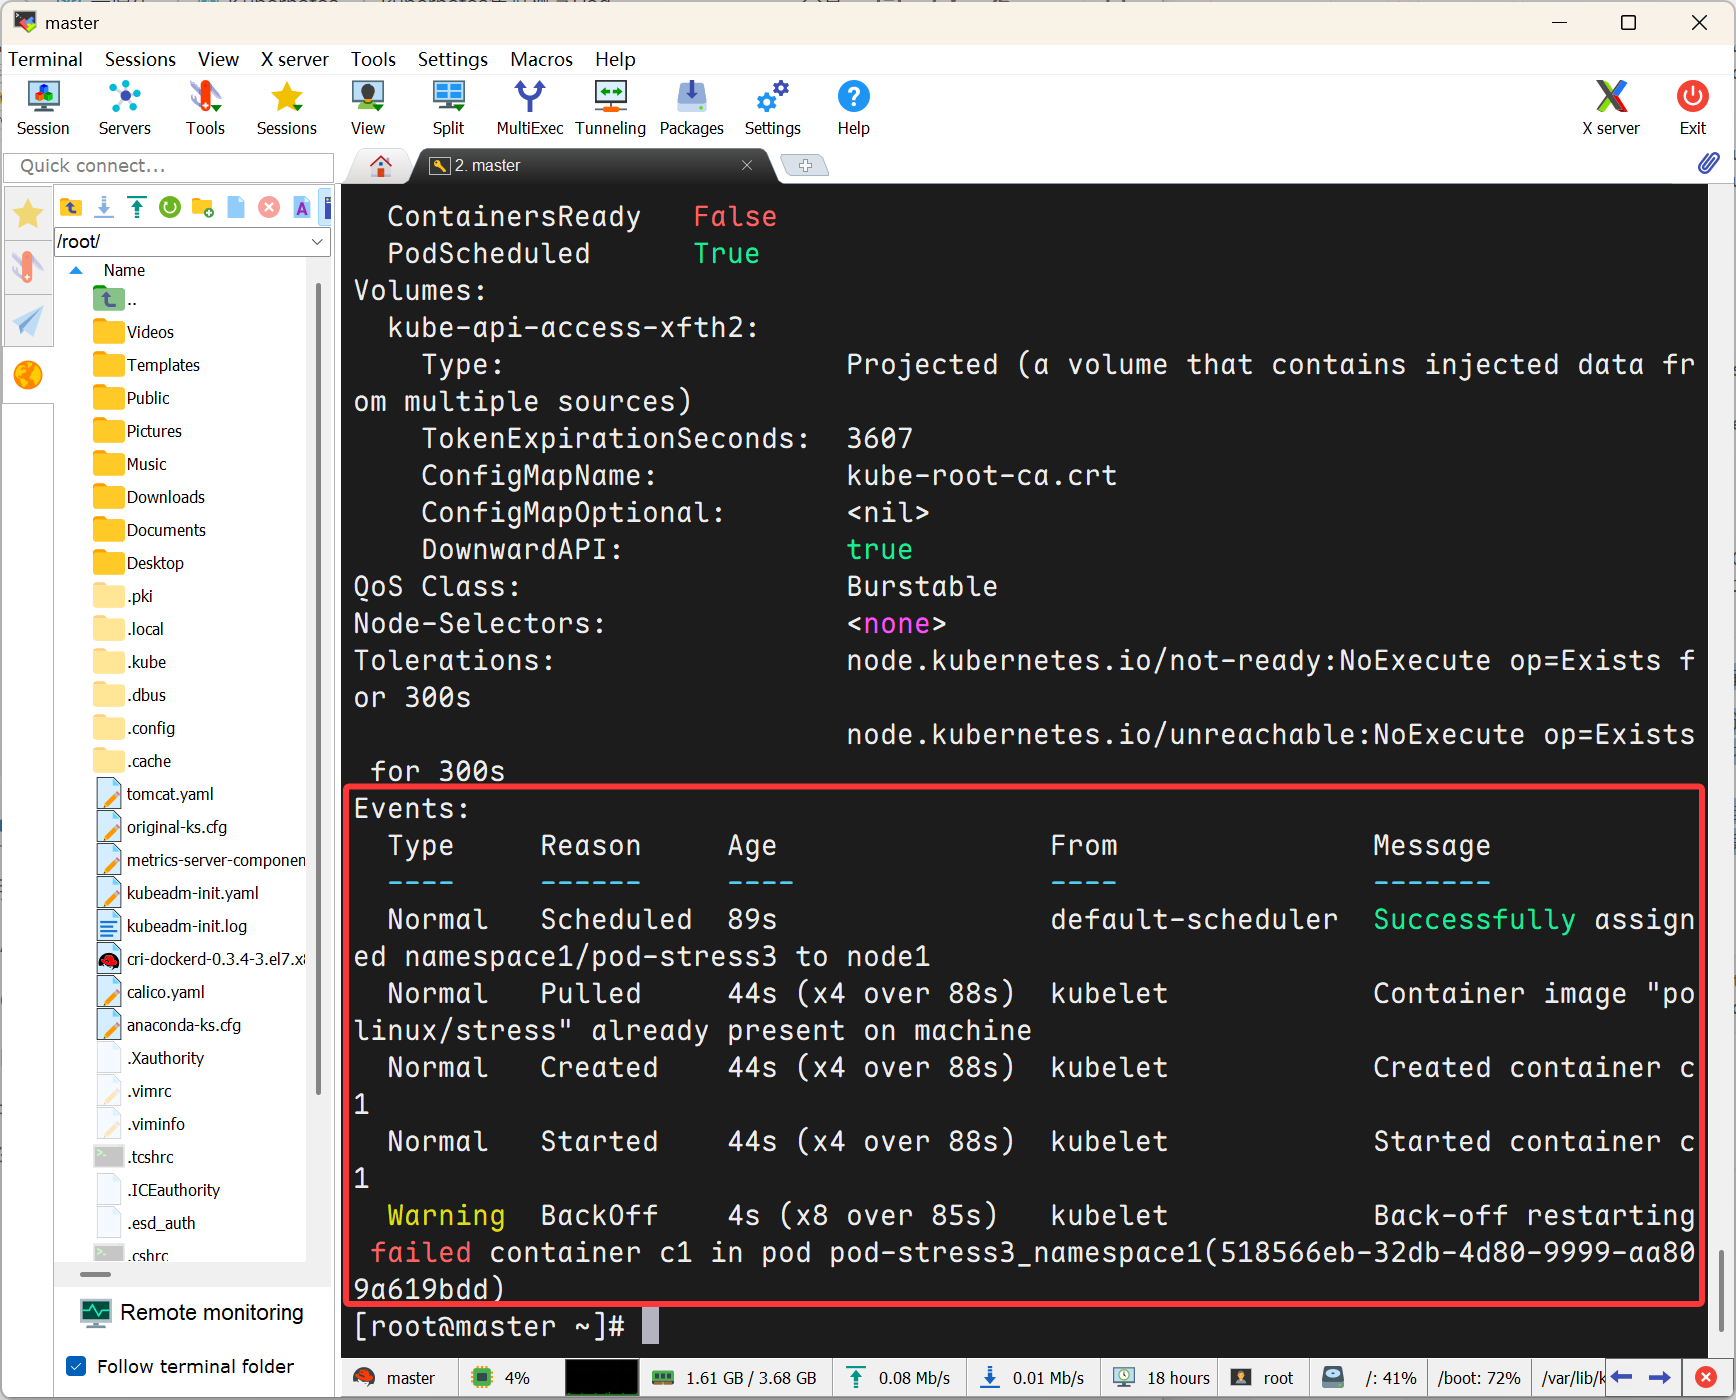
说明:一旦pod中的容器挂了,容器会有重启策略,如下:
-
Always:表示容器挂了总是重启,这是默认策略
-
OnFailures:表容器状态为错误时才重启,也就是容器正常终止时才重启
-
Never:表示容器挂了不予重启
对于Always这种策略,容器只要挂了,就会立即重启,这样是很耗费资源的。所以Always重启策略是这么做的:第一次容器挂了立即重启,如果再挂了就要延时10s重启,第三次挂了就等20s重启…依次类推
删除资源
kubectl delete ns namespace1
pod包含多个容器
在yaml的pod中声明两个容器
apiVersion: v1
kind: Pod
metadata:
  name: pod-stress4
  namespace: default
  labels:
    env: dev
    app: nginx
spec:
    containers:
    - name: c1
      image: polinux/stress
      command: ["stress"]
      args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]
      imagePullPolicy: IfNotPresent

    - name: c2
      image: polinux/stress
      command: ["stress"]
      args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]
      imagePullPolicy: IfNotPresent
查看pod状态
kubectl apply -f pod4.yaml
kubectl get pod
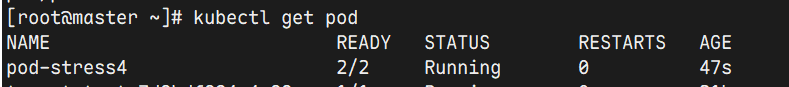
查看pod的节点分布
kubectl get pods -o wide

在node1中验证,产生了2个容器
docker ps -a | grep stress

如果用的是containerd运行时,则使用(只在containerd运行时使用)
crictl ps
对pod里的容器进行操作
不用交互直接执行命令
kubectl exec pod名 -c 容器名 -- 命令
注意:
-
-c 容器名为可选项,如果是1个pod中1个容器,则不用指定。
-
如果是1个pod中多个容器,不指定默认为第1个。
kubectl exec pod-stress4 -- date
kubectl exec pod-stress4 -c c1 -- date
kubectl exec pod-stress4 -c c2 -- date
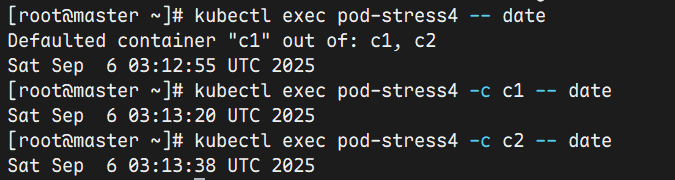
不指定容器名,则默认为pod里的第1个容器
kubectl exec pod-stress4 -- touch /abc.txt

和容器交互操作
和docker exec几乎一样,会发现刚才创建的abc.txt
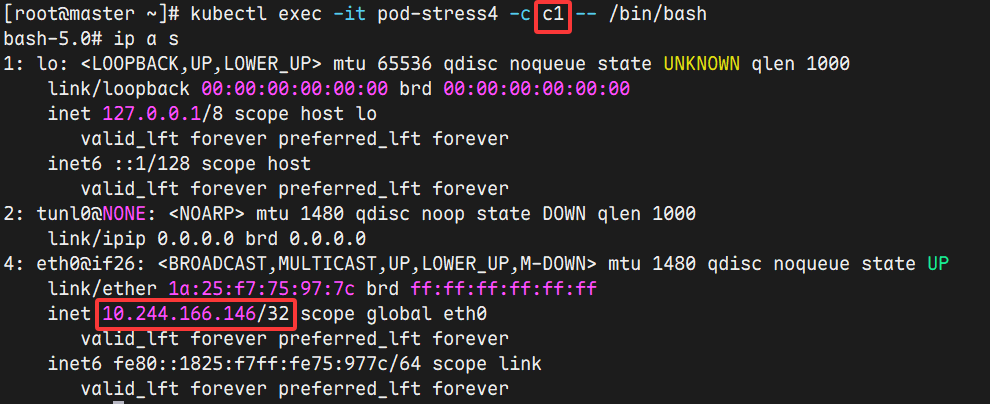
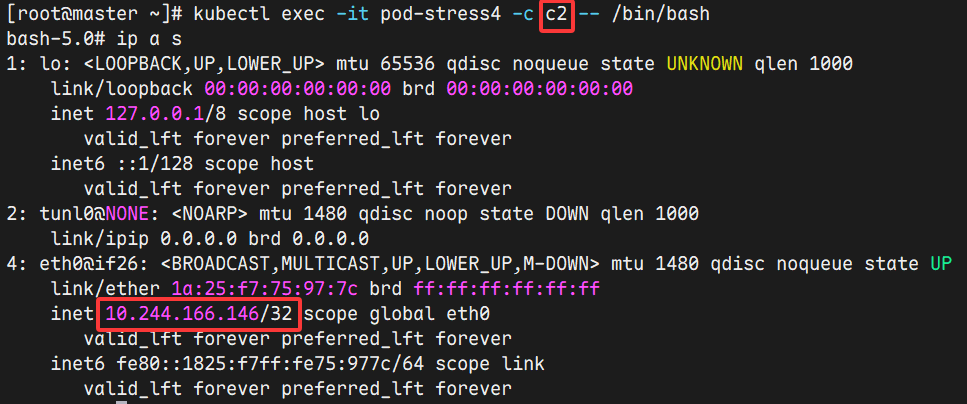
kubectl exec -it pod-stress4 -c c1 -- /bin/bash
bash-5.0# ls /
bash-5.0# exit
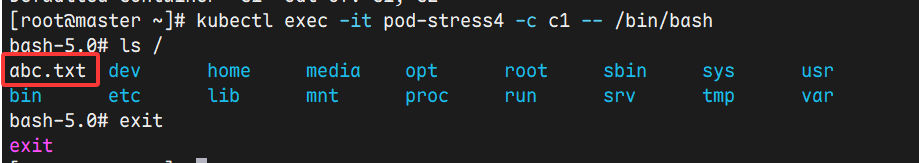
同一个pod中两个容器IP地址相同,是共享的10.244.166.146/32
验证pod中多个容器网络共享
vim pod-nginx.yaml
#写入
apiVersion: v1
kind: Pod
metadata:
  name: nginx2
spec:
  containers:
  - name: c1
    image: nginx:1.26-alpine

  - name: c2
    image: nginx:1.26-alpine
查看pod信息与状态
kubectl get pod
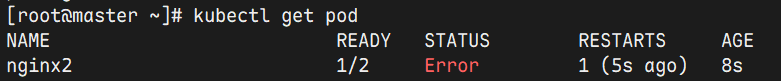

发现有1个容器启动失败,主要原因是在同一个网络环境中两个nginx都启动的80端口产生冲突
kubectl get pods -o wide

在node1节点中查看
docker ps -a | grep nginx

docker logs k8s_c2_nginx2_default_93c71ff6-c0fa-4afd-93e6-61f544f19061_9
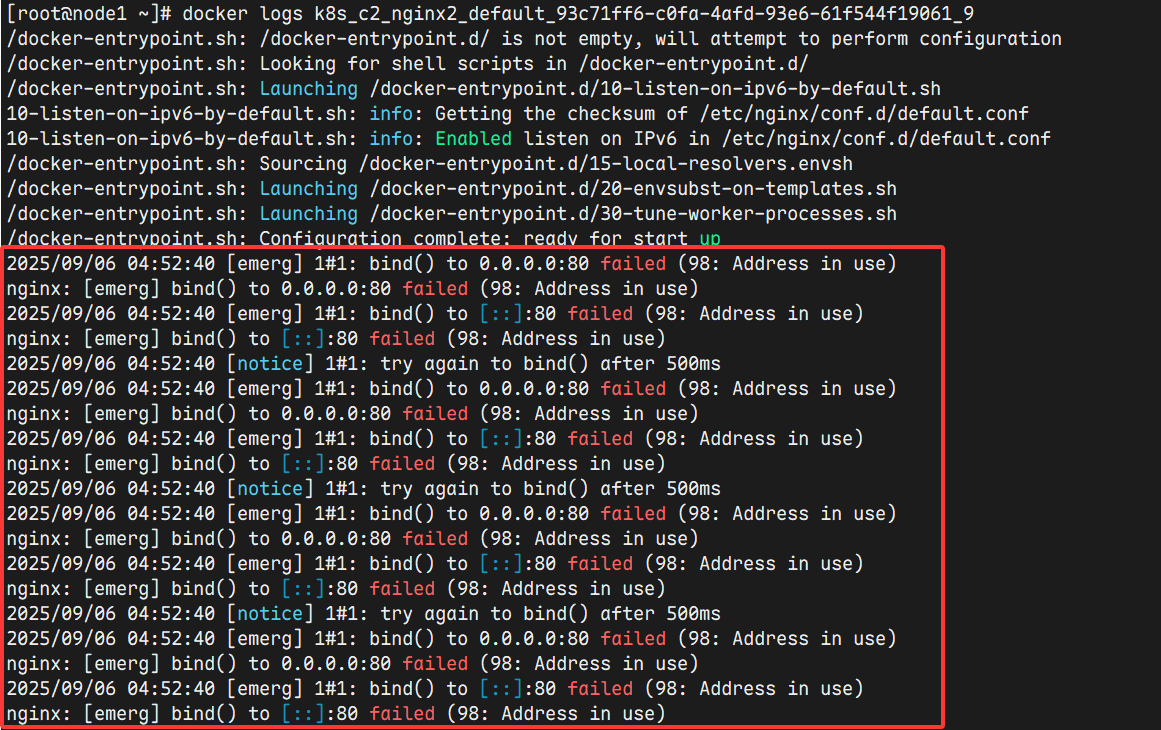
可以看到是80端口被占用导致的错误
pod调度
调度流程
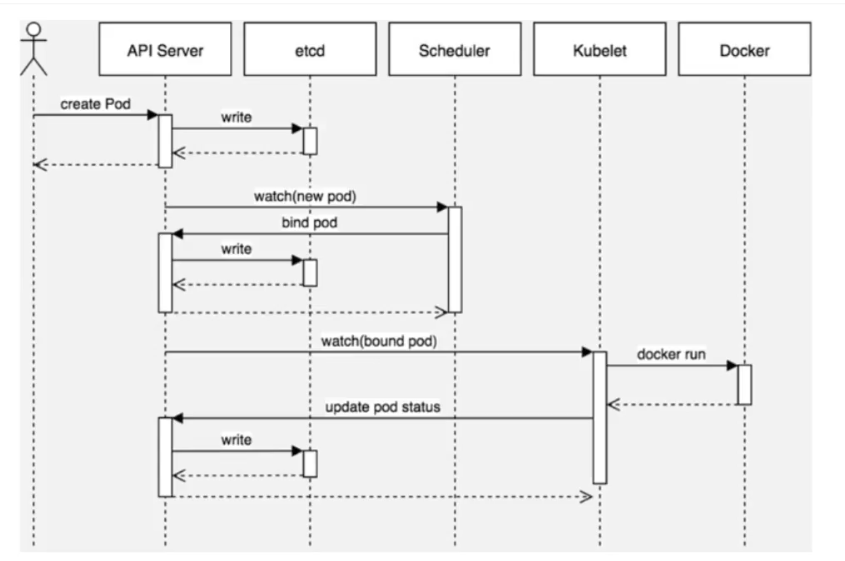
-
通过kubectl命令应用资源清单文件(yaml格式)向api server发起一个create pod请求
-
api server接收到pod创建请求后,生成一个包含创建信息资源清单文件
-
api server将资源清单文件中信息写入etcd数据库
-
scheduler启动后会一直watch API server,获取podspec.NodeName为空的Pod,即判断 pod.spec.Node == null? 若为null,表示这个Pod请求是新的,需要创建,因此先进行调度计算(共计2 步:1、过滤不满足条件的,2、选择优先级高的),找到合适的node,然后将信息在etcd数据库中更新分配结 果:pod.spec.Node =nodeA(设置一个具体的节点)
-
Kubelet通过watch etcd数据库(即不停地看etcd中的记录),发现有新的Node出现,如果这条记录中的 Node与所在节点编号相同,即这个Pod由scheduler分配给自己,则调用node中的container Runtime, 进而创建container,并将创建后的结果返回到给api server用于更新etcd数据库中数据状态。
调度约束方法
我们为了实现容器主机资源平衡使用,可以使用约束把pod调度到指定的node节点
-
nodeName用于将pod调度到指定的node名称上
-
nodeSelector用于将pod调度到匹配Label的node上
nodeName
[root@master ~]# cat pod-nodename.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-nodename
spec:
  nodeName: node2
  containers:
  - name: nginx
    image: nginx:1.26-alpine
应用YAML文件创建pod
kubectl apply -f pod-nodename.yaml
验证
kubectl describe pod pod-nodename | tail -10

发现:没有使用scheduler,而是直接给运行了,说明nodeName约束生效
nodeSelector
给node1节点打上标签为game
kubectl label nodes node1 bussiness=game
编写YAML文件
[root@master ~]# cat pod-nodeselector.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-nodeselector
spec:
  nodeSelector:
    business: game
  containers:
  - name: nginx
    image: nginx:1.26-alpine
应用YAML文件创建pod
kubectl apply -f pod-nodeselector.yml
验证
kubectl describe pod pod-nodeselect | tail -10
发现:经过了scheduler,分配到了node1节点上
总结:nodeName不需要经过调度,而nodeSelector需要经过调度器,并且node需要label
Pod的生命周期
pod生命周期
-
有些pod(比如运行httpd服务),正常情况下会一直运行中,但如果手动删除它,此pod会终止。
-
也有些pod(比如执行计算任务),任务计算完后就会自动终止。
上面两种场景中,pod从创建到终止的过程就是pod的生命周期。
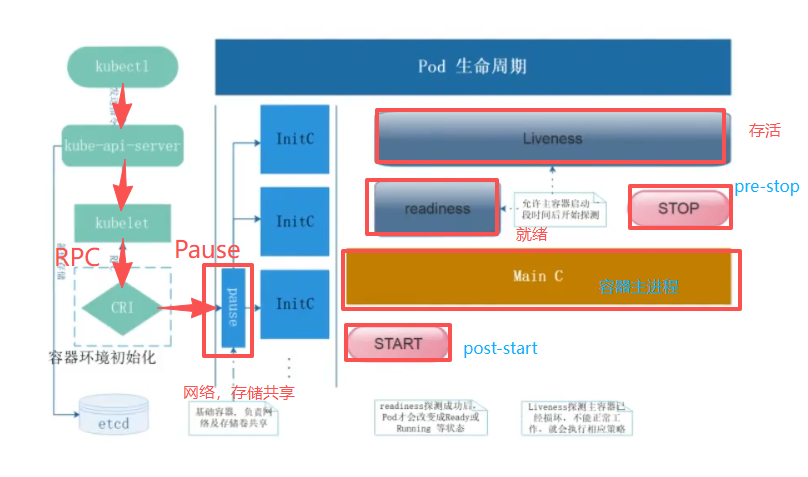
流程:
1. 用户发起创建请求
用户通过 kubectl 命令行工具,向 kube - api - server 发送创建 Pod 的指令。kubectl 是 Kubernetes 提供给用户与集群交互的接口,用户可以用它来部署应用、查看和管理集群资源等。
2. API 服务器处理请求
kube - api - server 接收并验证来自 kubectl 的请求,将相关的资源配置信息存储到 etcd 中。etcd 是一个高可用的键值存储系统,用于持久化保存 Kubernetes 集群的配置数据和状态信息。
3. kubelet 执行创建操作
kubelet 作为工作节点上负责管理 Pod 和容器的组件,会定期从 kube - api - server 检查是否有新的 Pod 需要在本节点创建。当发现有新的 Pod 任务时,kubelet 通过 RPC(远程过程调用) 与 CRI(容器运行时接口) 进行通信,指示容器运行时(如 containerd 等)创建容器。
4. 容器环境初始化
CRI 接到 kubelet 的指令后,开始初始化容器运行环境。在一个 Pod 中,首先会创建 Pause 容器,它为 Pod 内的其他容器提供基础的网络、存储共享等环境。Pod 内的其他容器会共享 Pause 容器的网络命名空间、存储卷等资源,这使得 Pod 内的容器之间可以通过 localhost 进行通信,并且能够方便地共享数据。
5. 初始化容器运行
在主容器启动之前,Pod 内的 InitC(初始化容器) 会按照定义的顺序依次运行。Init 容器主要用于执行一些初始化任务,比如安装必要的依赖包、配置网络策略、创建数据目录等。只有当所有的 Init 容器都成功运行完毕后,才会进入主容器的启动流程。
6. 主容器启动及钩子执行
Main C(容器主进程) 启动,这是 Pod 中承载实际业务应用的容器。在主容器启动后,会触发 post - start 钩子(如果定义了的话),可以利用这个钩子来执行一些容器启动后的初始化操作,例如向配置中心注册服务等。
7. 就绪探针检测
主容器启动一段时间后(可以配置等待时间),会开始进行 Readiness(就绪探针) 检测。Readiness 探针用于判断容器是否已经准备好对外提供服务。如果检测通过,Pod 的状态会变为 Ready 或 Running,此时 Pod 会被纳入到服务的负载均衡范围,开始接收客户端的请求流量;如果检测不通过,Pod 不会接收流量,直到通过检测为止。
8. 存活探针监控
在 Pod 运行过程中,会持续通过 Liveness(存活探针) 对容器进行健康检查。Liveness 探针主要用于检测容器是否处于 “存活” 状态,比如检测容器内的应用进程是否崩溃。如果检测到容器不健康,会根据配置的策略来处理,常见的策略是重启容器,以保证容器能够持续正常地提供服务。
9. Pod 终止及钩子执行
当需要终止 Pod 时(例如用户执行删除 Pod 的操作),首先会触发容器的 pre - stop 钩子(如果定义了的话)。pre - stop 钩子可以用于执行一些清理工作,比如关闭数据库连接、保存数据状态等。之后,容器会被停止,Pod 从集群中被移除。
容器启动
-
pod中的容器在创建前,有初始化容器(init container)来进行初始化环境
-
初化完后,主容器(main container)开始启动
-
主容器启动后,有一个post start的操作(启动后的触发型操作,或者叫启动后钩子)
-
post start后,就开始做健康检查
-
第一个健康检查叫存活状态检查(liveness probe),用来检查主容器存活状态的
-
第二个健康检查叫准备就绪检查(readiness probe),用来检查主容器是否启动就绪
容器终止
-
可以在容器终止前设置pre stop操作(终止前的触发型操作,或者叫终止前钩子)
-
当出现特殊情况不能正常销毁pod时,大概等待30秒会强制终止
-
终止容器后还可能会重启容器(视容器重启策略而定)。
容器重启策略
-
Always:表示容器挂了总是重启,这是默认策略
-
OnFailures:表容器状态为错误时才重启,也就是容器正常终止时不重启
-
Never:表示容器挂了不予重启
-
对于Always这种策略,容器只要挂了,就会立即重启,这样是很耗费资源的。所以Aways重启策略 是这么做的:第一次容器挂了立即重启,如果再挂了就要延时10s重启,第三次挂了就等20s重启…依 次类推
HealthCheck健康检查
当Pod启动时,容器可能会因为某种错误(服务未启动或端口不正确)而无法访问等。
Health Check方式
kubelet拥有两个检测器,它们分别对应不同的触发器(根据触发器的结构执行进一步的动作)
-
Liveness Probe(存 活状态探 测)
-
指示容器是否正在运行。如果存活态探测失败,则 kubelet 会杀死容器, 并且容器 将根据其重启策略决定未来。如果容器不提供存活探针,则默认状态为 success。
-
readiness Probe(就 绪型探 测)
-
指示容器是否准备好为请求提供服务。如果就绪态探测失败,端点控制器将从与 Pod 匹配的所有服务的端点列表中删除该Pod 的 IP地址。 初始延迟之前的就绪态 的状态值默认为 Failure。 如果容器不提供就绪态探针,则默认状态为success。注: 检查后不健康,将容器设置为Notready;如果使用service来访问,流量不会转发给此 种状态的pod
-
startup Probe
-
指示容器中的应用是否已经启动。如果提供了启动探针,则所有其他探针都会被禁 用,直到此探针成功为止。如果启动探测失败,kubelet 将杀死容器,而容器依其 重启策略进行重启。如果容器没有提供启动探测,则默认状态为 success。
Probe探测方式
-
Exec
-
执行命令
-
HTTPGet
-
http请求某一个URL路径,查看返回状态码
-
TCP
-
tcp连接某一个端口
-
gRPC
-
使用gRPC执行一个远程过程调用。目标应该实现gRPC健康检查。如果响应的状态是 “SERVING”,则认为诊断成功。gRPC探针是一个alpha特性,只有在你启动了“GRPC ContainerProbe”特性门控时才能使用。
liveness-exec 案例
准备yaml文件
apiVersion: v1
kind: Pod
metadata:
  name: liveness-exec
  namespace: default
spec:
  containers:
  - name: liveness
    image: busybox
    imagePullPolicy: IfNotPresent
    args:
    - /bin/sh
    - -c       #sh -c 的作用是从字符串中读取命令并执行
    - touch /tmp/healthy; sleep 30; rm -rf /tmp/healthy; sleep 600
    livenessProbe:
      exec:
        command:
        - cat
        - /tmp/healthy
      initialDelaySeconds: 5     #pod启动延迟5秒后探测
      periodSeconds: 5            #每5秒探测1次
应用YAML文件
kubectl apply -f pod-liveness-exec.yaml
观察pod
watch kubectl get pod
发现过了一会后,容器的restart变为了1,若继续观察会发现每隔一段时间restart的次数就会增加。
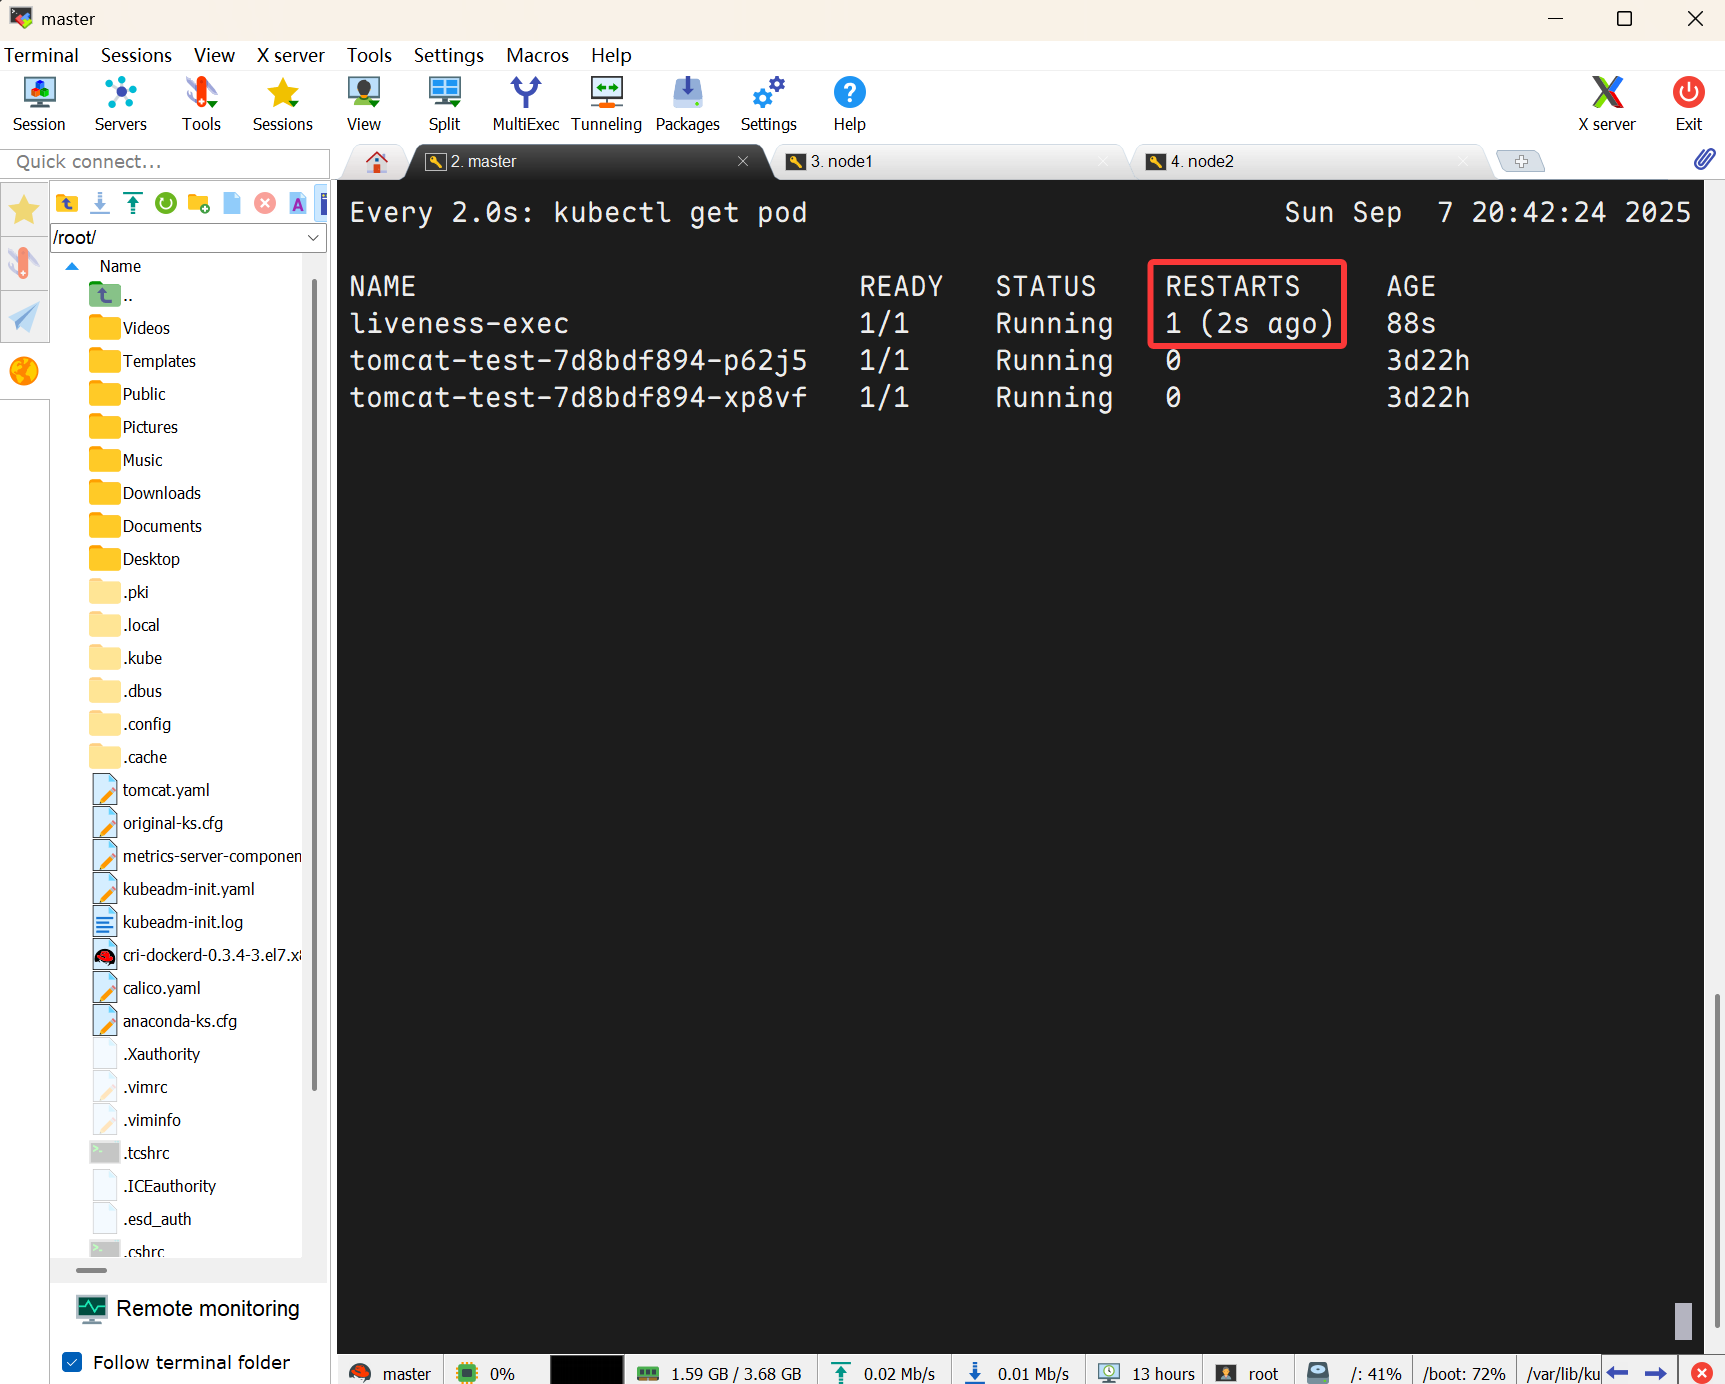
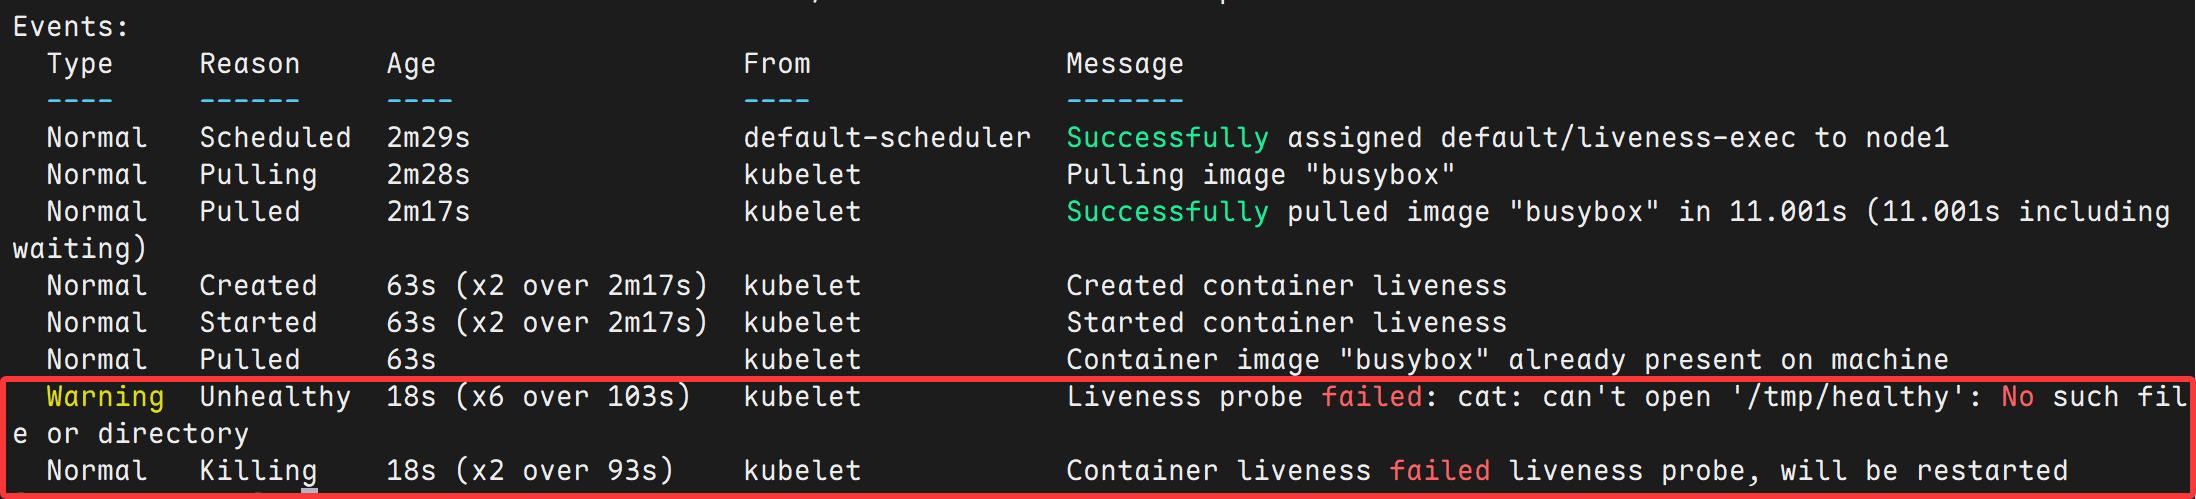
这是因为容器被探针检测失败又会被重新拉起。
kubectl describe pod liveness-exec
扩展:容器重启策略验证
apiVersion: v1
kind: Pod
metadata:
  name: liveness-exec
  namespace: default
spec:
  restartPolicy: Never    #把容器重启策略由默认的always改为Never
  containers:
  - name: liveness
    image: busybox
    imagePullPolicy: IfNotPresent
    args:
    - /bin/sh
    - -c
    - touch /tmp/healthy; sleep 30; rm -rf /tmp/healthy; sleep 600
    livenessProbe:
      exec:
        command:
        - cat
        - /tmp/healthy
      initialDelaySeconds: 5
      periodSeconds: 5
部署、验证
kubectl apply -f pod-liveness-exec.yml
kubectl get pod
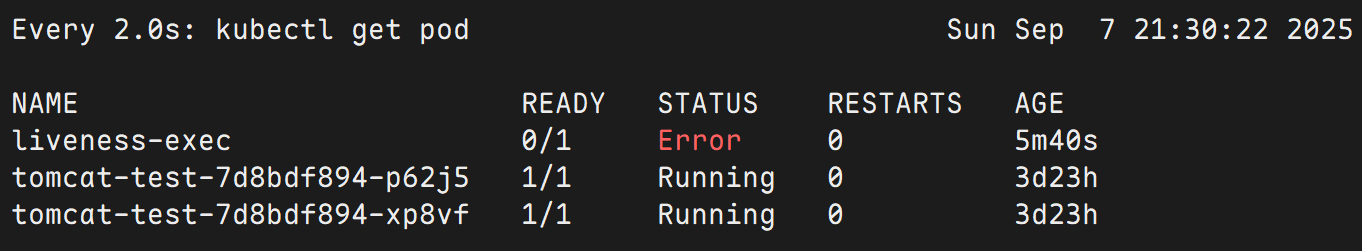
可以发现liveness-exec的状态变为了error
kubectl describe pod liveness-exec
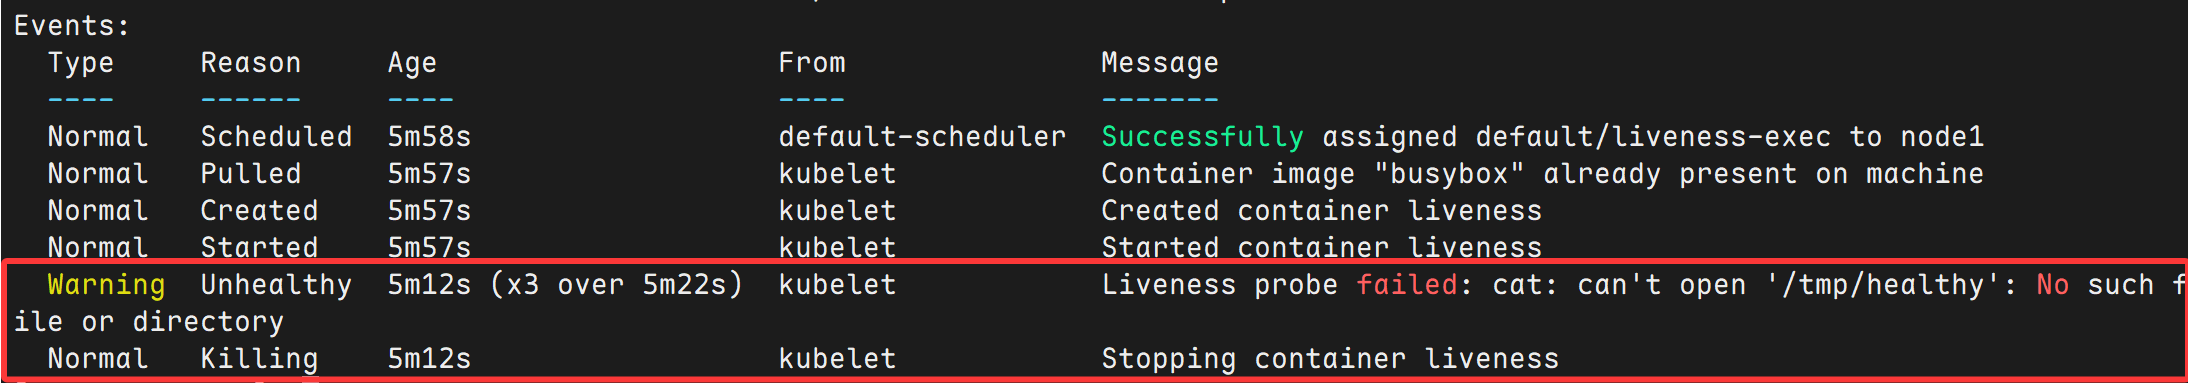
验证结果为:容器健康检查出现问题后,不再重启,也不会继续sleep 600秒,而是直接关闭了
liveness-httpget案例
编写pod-liveness-httpget.yml
apiVersion: v1
kind: Pod
metadata:
  name: liveness-httpget
  namespace: default
spec:
  containers:
  - name: liveness
    image: nginx:1.26-alpine
    imagePullPolicy: IfNotPresent
    ports:
    - name: http    #指定容器端口,这一行不写也行,端口由镜像决定
      containerPort: 80    #自定义名称,不需要与下面的port:http对应
    livenessProbe:
      httpGet:    #类似dockerfile里的expose 80
        port: http    #http协议,也可以直接写80端口
        path: /index.html    #探测家目录下的index.html
      initialDelaySeconds: 3    #延迟3秒开始探测
      periodSeconds: 5    #每个5s探测一次
应用YAML文件
kubectl apply -f pod-liveness-httpget.yml
检查验证
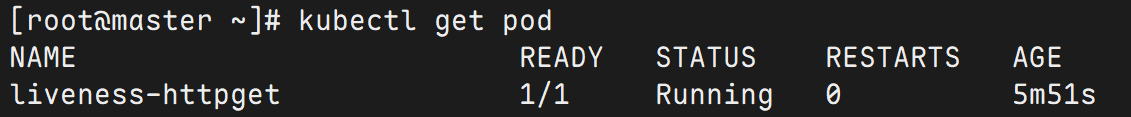
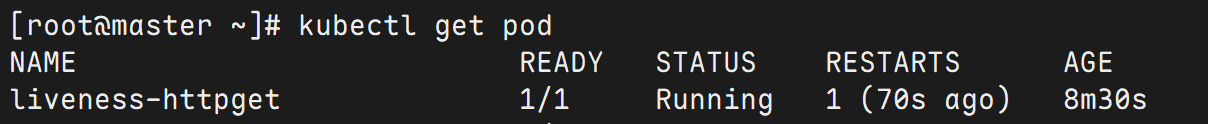
交互删除nginx里的主页文件
kubectl exec -it liveness-httpget -- rm -rf /usr/share/nginx/html/index.html

#验证查看
kubectl describe pod liveness-httpget | tail -10
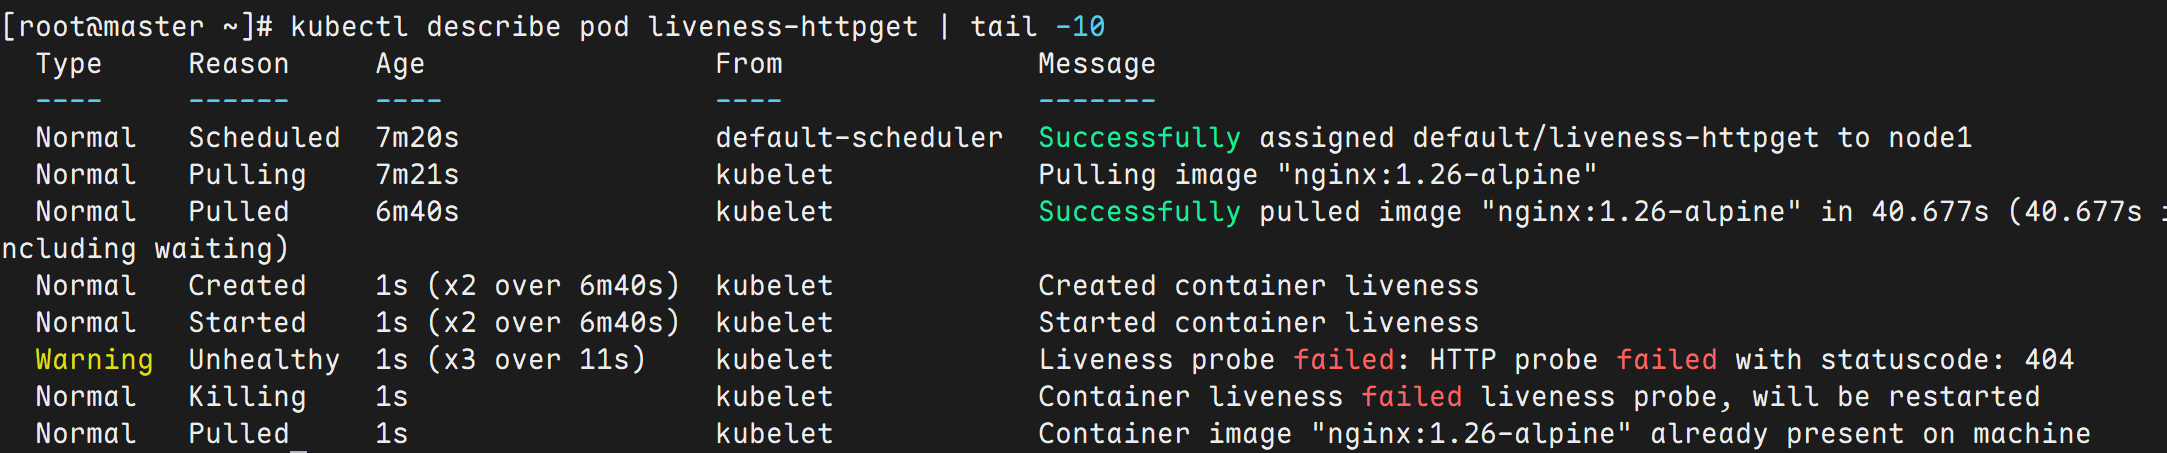
发现pod重新启动了
liveness-tcp案例
编写YAML文件
apiVersion: v1
kind: Pod
metadata:
  name: liveness-tcpsocket
  namespace: default
spec:
  restartPolicy: Never
  containers:
  - name: c1
    image: nginx:1.26-alpine
    imagePullPolicy: IfNotPresent
    ports:
    - name: http
      containerPort: 82
    livenessProbe:
      tcpSocket:    #使用tcp连接方式
        port: 82    #连接82端口进行探测
      initialDelaySeconds: 3
      periodSeconds: 5
验证
kubectl get pod -o wide

尝试访问IP
curl http://10.244.166.136:82
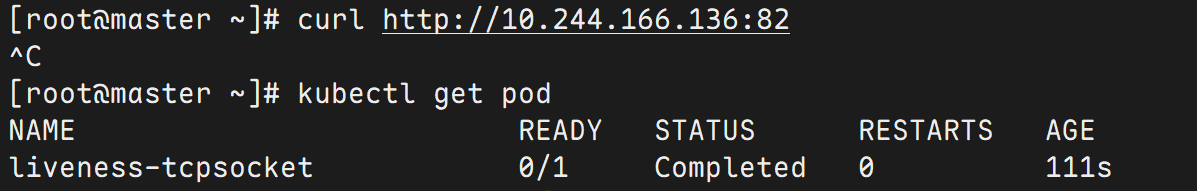
发现pod断开了
再尝试修改yaml文件
apiVersion: v1
kind: Pod
metadata:
  name: liveness-tcpsocket
  namespace: default
spec:
  restartPolicy: Never
  containers:
  - name: c1
    image: nginx:1.26-alpine
    imagePullPolicy: IfNotPresent
    ports:
    - name: http
      containerPort: 82
    livenessProbe:
      tcpSocket:    #使用tcp连接方式
        port: 80    #连接80端口进行探测
      initialDelaySeconds: 3
      periodSeconds: 5
重新部署
kubectl delete -f liveness-tcp.yml
kubectl apply -f liveness-tcp.yml
等待一会后发现pod不会被停止
再尝试访问,那么应该访问82端口还是80端口呢?
我们先尝试82端口
kubectl get pod -o wide
NAME                          READY   STATUS    RESTARTS   AGE    IP               NODE    NOMINATED NODE   READINESS GATES
liveness-tcpsocket            1/1     Running   0          54s    10.244.166.137   node1   <none>           <none>

curl http://10.244.166.137:82

发现被拒绝了,再尝试80端口:
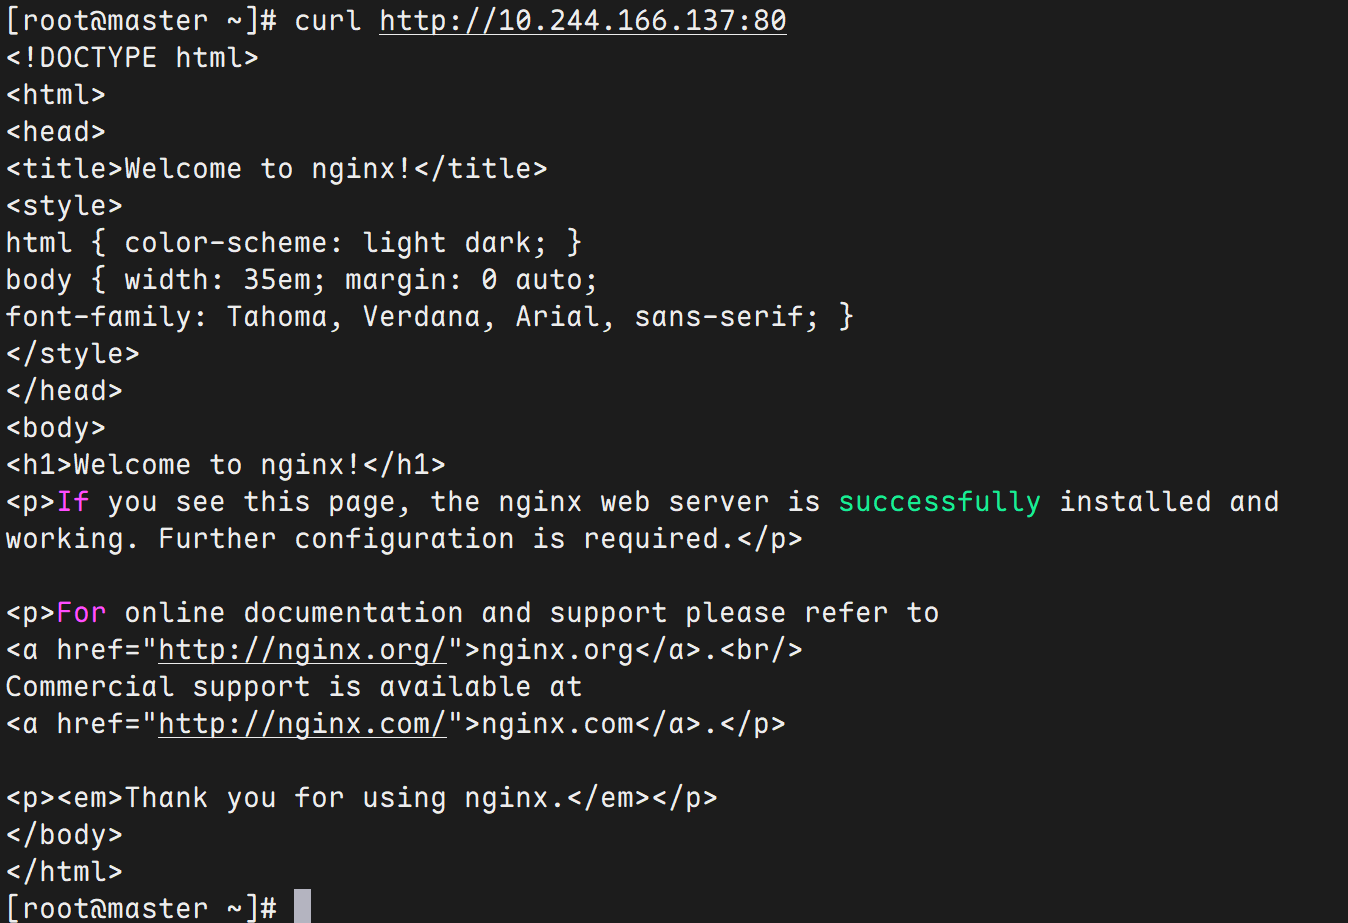
成功访问了。
这说明liveness-tcpSocket只探测pod的端口,跟容器端口无关。
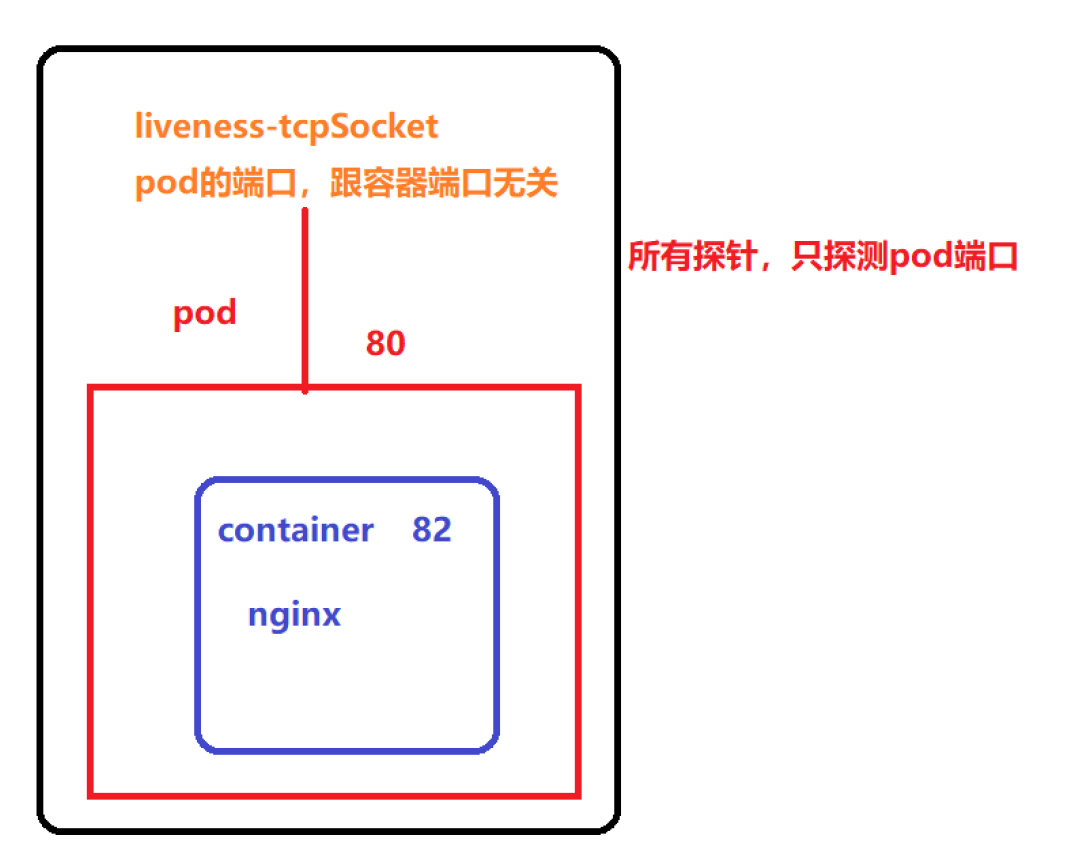
总结:所有的探针只探测pod端口,与容器端口无关
readiness案例
apiVersion: v1
kind: Pod
metadata:
  name: readiness-httpget
  namespace: default
spec:
  containers:
  - name: readiness
    image: nginx:1.26-alpine
    imagePullPolicy: IfNotPresent
    ports:
    - name: http
      containerPort: 80
    readinessProbe:
      httpGet:
        port: http
        path: /index.html
      initialDelaySeconds: 3
      periodSeconds: 5
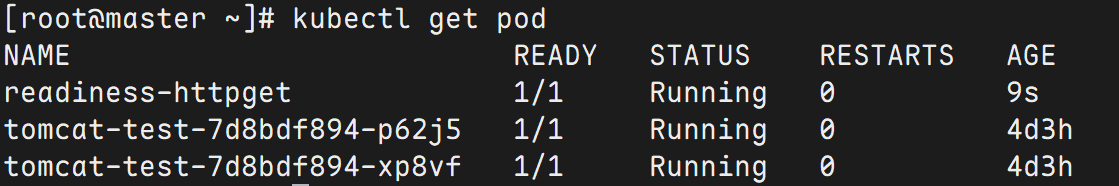
应用YAML文件
kubectl apply -f pod-readiness-httpget.yml
#验证查看
kubectl get pod
交互删除nginx主页
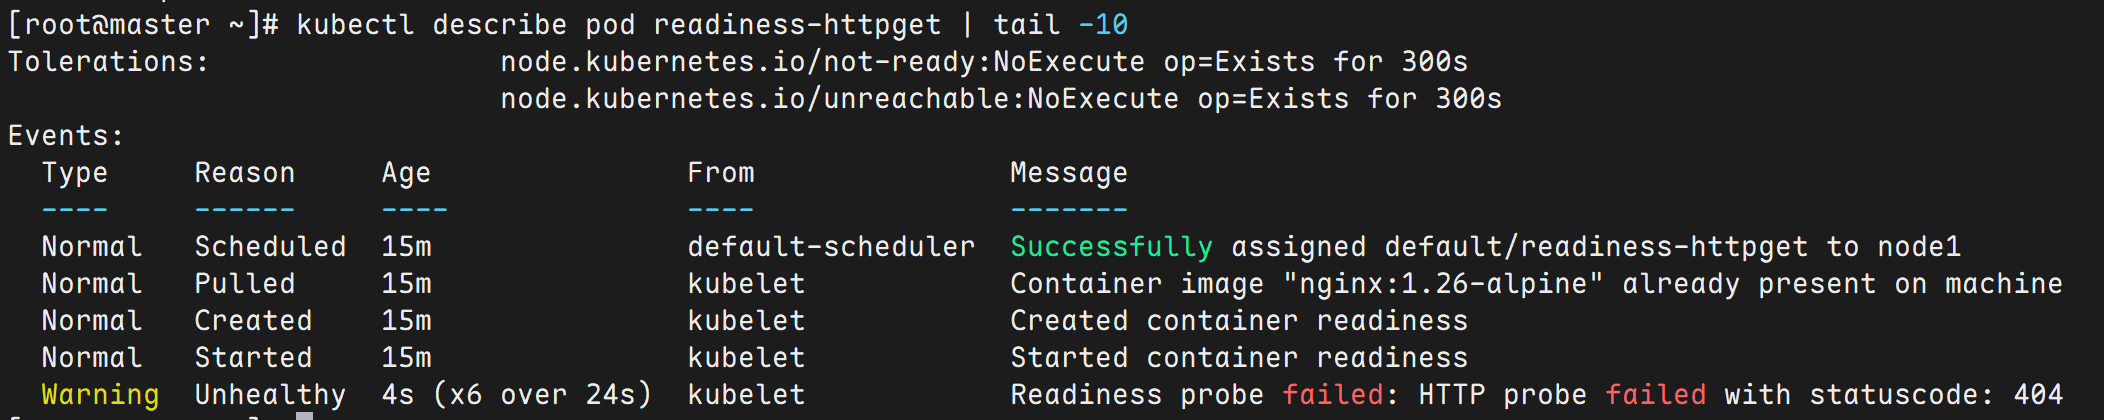
kubectl exec -it readiness-httpget -- rm -rf /usr/share/nginx/

#验证
kubectl describe pod readiness-httpget | tail -10
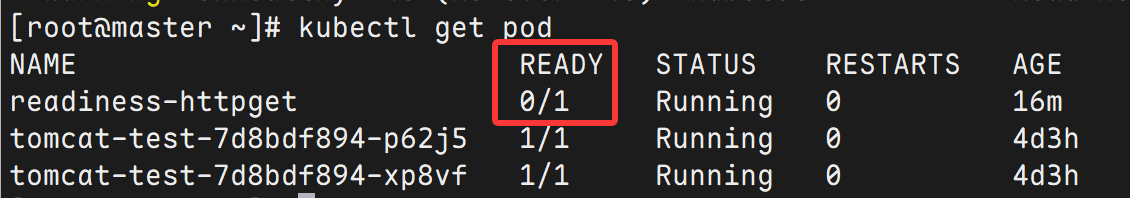
kubectl get pod
恢复删除的文件
kubectl exec -it readiness-httpget -- touch /usr/share/nginx/html/index.html
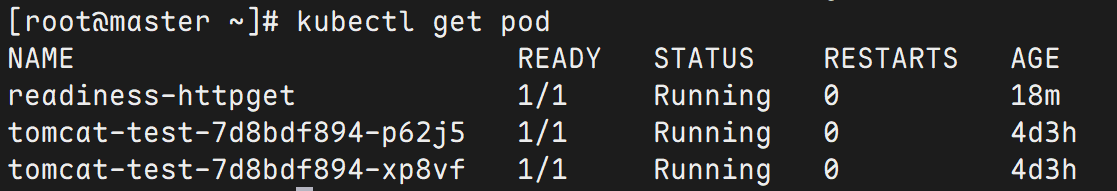
readiness会把pod标记为noready状态,直到文件恢复,才会正常
总结:
-
liveness探测失败pod就被停止;
-
readiness探测失败,进入noread状态,pod保持running,继续探测,知道条件成立进入ready状态
readiness+liveness综合案例
apiVersion: v1
kind: Pod
metadata:
  name: readiness-liveness-httpget
  namespace: default
spec:
  containers:
  - name: readiness-liveness
    image: nginx:1.26-alpine
    imagePullPolicy: IfNotPresent
    ports:
    - name: http
      containerPort: 80
    livenessProbe:
      httpGet:
        port: http
        path: /index.html    #首页
      initialDelaySeconds: 1
      periodSeconds: 3
    readinessProbe:
      httpGet:
        port: http
        path: login.html    #其他页面
      initialDelaySeconds: 5
      periodSeconds: 5
应用YAML文件
kubectl apply -f pod-readiness-liveiness.yml
验证,pod正常运行,但是没有就绪
kubectl get pod
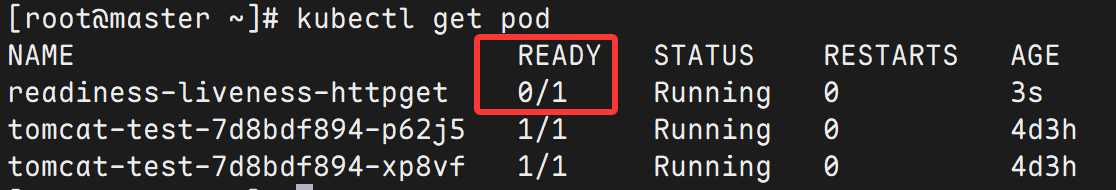
创建登录login文件
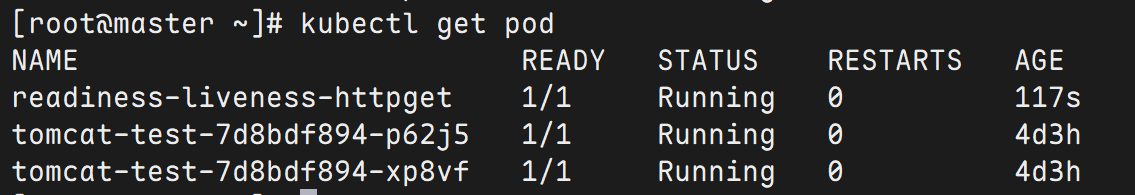
kubectl exec -it readiness-liveness-httpget -- touch /usr/share/nginx/html/login.html
再次查看状态,进入到ready状态
post-start
启动资源时容器执行的操作
apiVersion: v1
kind: Pod
metadata:
  name: poststart
  namespace: default
spec:
  containers:
  - name: poststart
    image: nginx:1.26-alpine
    imagePullPolicy: IfNotPresent
    lifecycle:
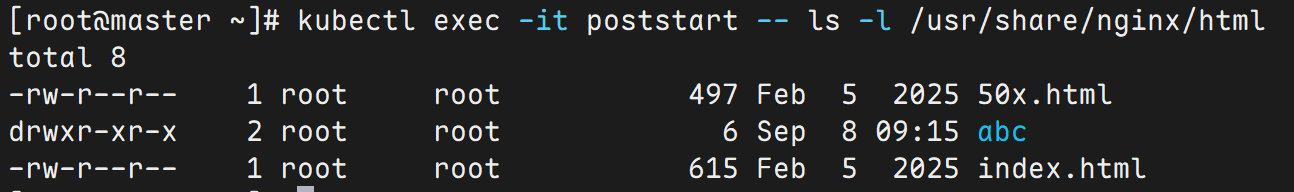
      postStart:
        exec:
          command: ["mkdir","-p","/usr/share/nginx/html/abc"]
kubectl apply -f pod-poststat.yml
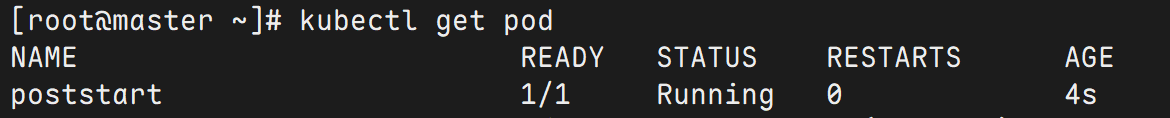
kubectl exec -it poststart -- ls -l /usr/share/nginx/html
pre-stop
容器终止前执行的命令
apiVersion: v1
kind: Pod
metadata:
  name: poststart
  namespace: default
spec:
  containers:
  - name: poststart
    image: nginx:1.26-alpine
    imagePullPolicy: IfNotPresent
    lifecycle:
      postStart:
        exec:
          command: ["mkdir","-p","/usr/share/nginx/html/abc"]
      preStop:
        exec:
          command: ["/bin/sh","-c","sleep 6000"]
kubectl apply -f prestop.yml
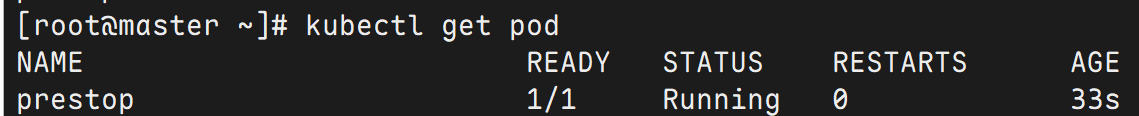
删除pod验证
kubectl delete -f prestop.yml

结论:当出现特殊情况不能正常销毁pod时,大概等待30秒会强制终止
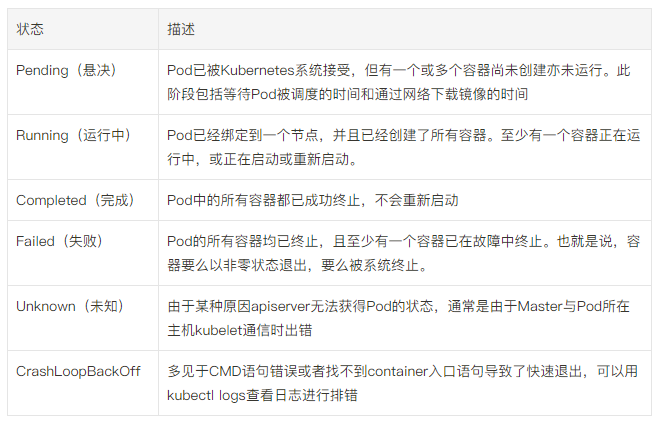
pod故障排除

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 16
 0
- 0


 已为社区贡献4条内容

所有评论(0)