【深度学习】激活函数、前向传播、手写数字识别、损失函数
文章目录
一、神经网络概念
1.三个层
- 输入层
是一个样本的所有特征
- 隐藏层
以房价预测为例:
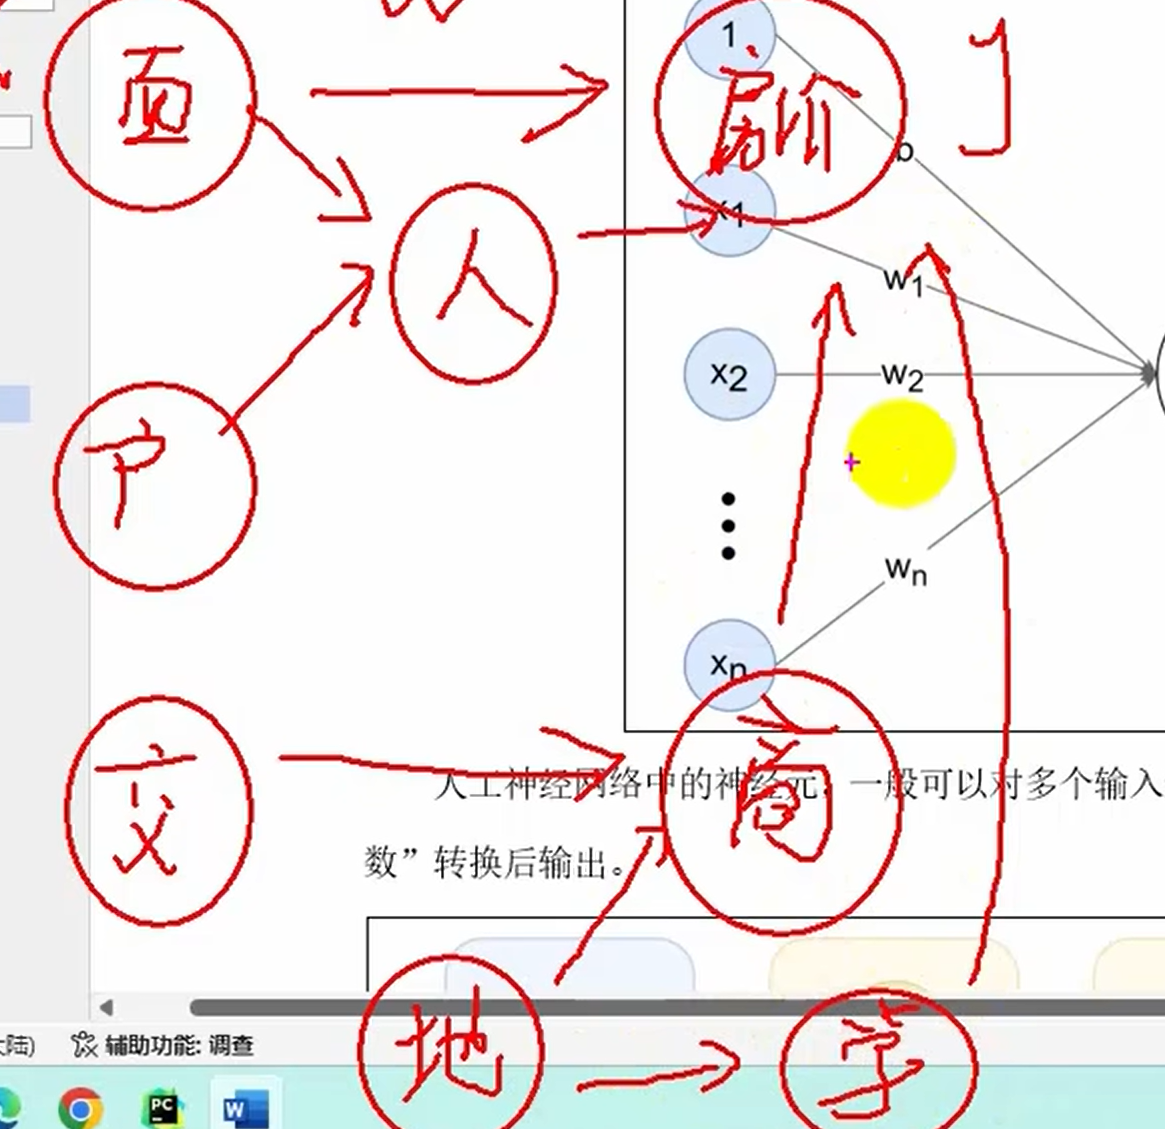
面积和户型可能不是直接影响房价,而是先共同决定能容纳居住人口数,再影响房价。
因此,特征与结果之间不是简单的线性关系。
我们不需要关心隐藏层有几个特征,只需要让特征做一个全连接即可,如果不影响,则权重为0.
- 输出层
输出模型的分类或预测结果。
2. 节点与边的含义
输入层节点
表示每个特征的值
边
表示权重。
-
输入层与隐藏层之间的边,表示特征的权重。
-
隐藏层内部的边,以及隐藏层和输出层的边,表示中间节点的权重。
隐藏层节点
是一个激活函数。
- 先对前一层的输入进行加权计算(线性组合,X*W+b)
- 再将值输入激活函数,得到输出
输出层节点
是最后一个激活函数,函数值就是模型的预测值。
3. 模型参数个数计算
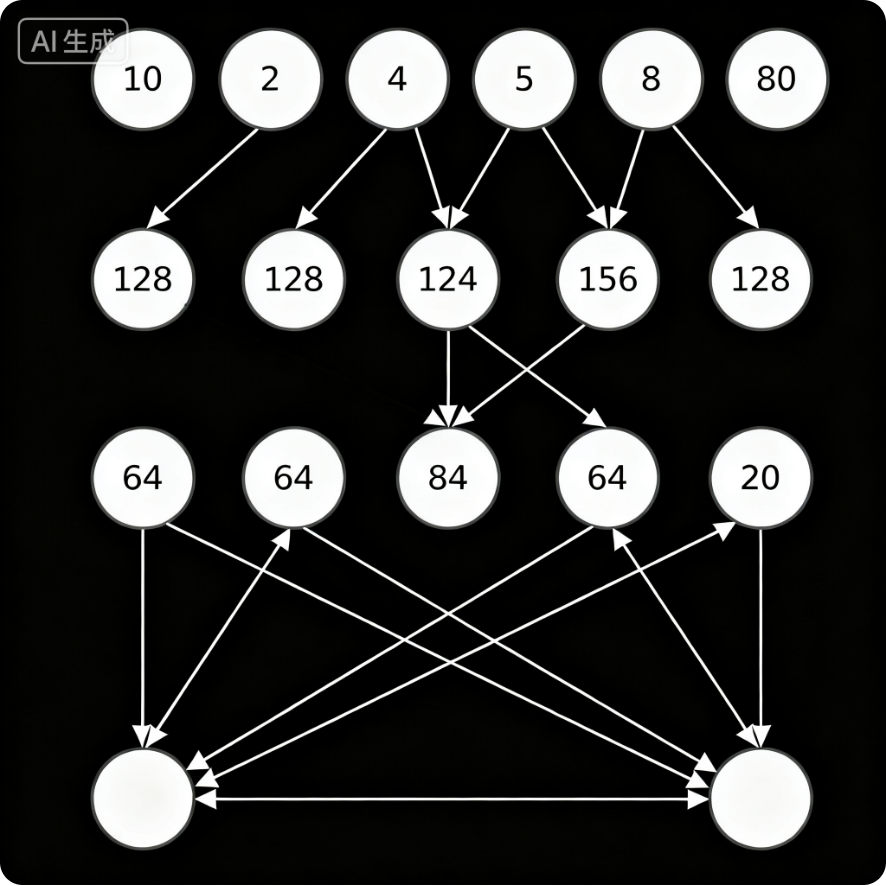
输入层有10个节点,隐藏层有2层,第一层128个节点,第二层64个节点,输出层有2个节点的神经网络,一共有几个参数?
- 11 * 128 + 129 * 64 + 65 * 2 = 9794 个
二、激活函数
1.作用
由于隐藏层做的是线性组合 + 激活函数,如果没有激活函数,或者,激活函数为线性函数,则输入与输出还是线性相关的,但实际问题并不总是线性相关的。
例如:y = ax + b, 激活函数:h(x) = kx + c
则:h(x) = ky + c = k(ax + b) + c = kax + kb + c
2.阶跃函数
f(x) = 1 if x > 0 else 0
局限性:
- x = 0处不可导
- 导数恒为0
由于这两个特点,我们无法使用梯度下降来更新权重,所以它基本不用。
3.sigmoid
f(x) = 1/ (1+e-x)
# 这个函数接收一个列向量,然后对每一个元素作一次sigmoid运算
def sigmoid(x):
    return 1 / (1 + np.exp(-x))
局限性:
- 涉及指数运算,运算量高
- 当输入值在[-6,6]之外时,函数值很小,可能导致信息丢失
- 导数值很小,网络参数更新会极其缓慢,可能出现梯度消失
因此它一般不用作隐藏层的激活函数,最多作为二分类的输出层。
4.tanh
图象类似于sigmoid向下平移了0.5,使得图象关于原点对称。
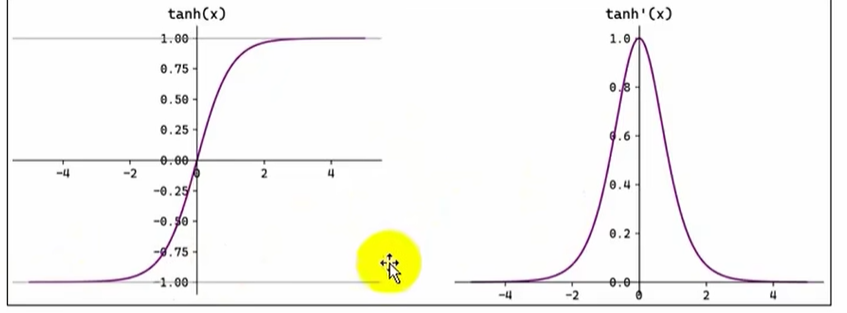
由于也存在梯度消失的情况,一般也不用。
可以直接使用numpy的tanh函数。
5.ReLU
f(x)=x if x >= 0 else 0
def relu(x):
    return np.maximum(0, x)
- 避免了梯度消失
- 当输入为负数时,当前神经元不被激活,即当前节点值为0,相当于参与下一步计算时0*权重=0,可以简化计算,提高模型效率。
Leaky ReLU
f(x) = x if x>=0 else ax (a -->0)
保证不会出现太多的节点不被激活。
6.多分类softmax
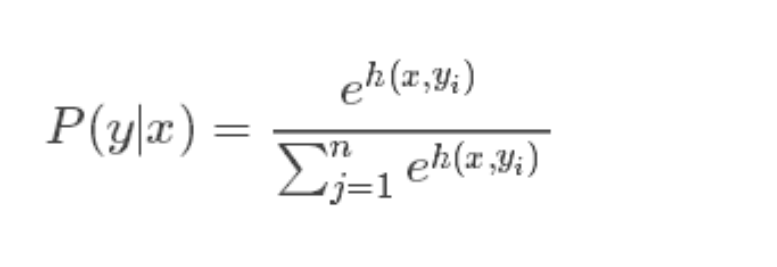
- softmax中,e的指数(X)就是线性组合的结果,本质是各部分所占比例
- softmax常用与多分类问题的输出层
- softmax会放大更大的输入值,例如:
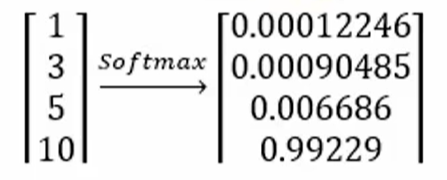
下面是一些先验知识
- 1.numpy的内置函数(sum, exp)等都可以传入数组作为参数。
a = [1, 2, 3]
b = np.exp(a)
print(b)
在这段代码中,exp函数对数组中的每个元素执行exp操作,然后返回一个新的数组。
- 2.整数也可以和数组运算
x = np.array([1, -2, 1])
print(1 / x)
1 将分别除以 x 中的每一个元素。
- 3.numpy的max函数和maximum函数的区别
    x = np.array([1, -2, 5])
    print(np.max(x))
    print(np.maximum(0, x))
max求数组的最大值,而maximum比较两个数组对应元素,取最大值,形成新的数组。
下面是softmax代码实现
def softmax(x):
    # 首先对x进行转置
    x = x.T - np.max(x.T, axis=0)  # 按列求最大值
    y = np.exp(x) / np.sum(np.exp(x), axis=0)
    return y.T
三、简单神经网络实现
1.forward
前向传播,也就是从输入到输出这个过程。训练时,要经过前向传播和反向传播以调整参数,预测时,只需要进行前向传播。
2.数值传递
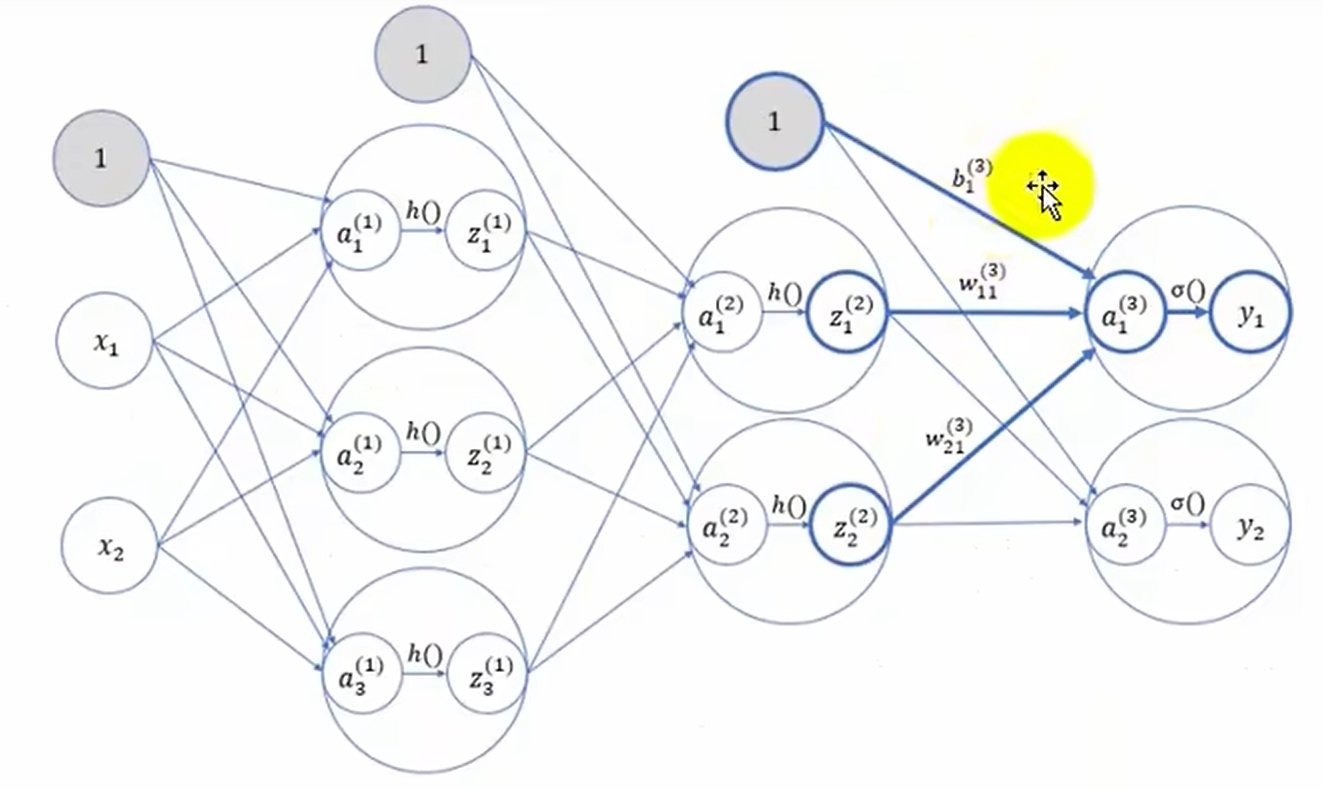
在这个例子中:
- X:1 * 2
- W1:2 * 3(因为输入的矩阵列是2,所以它的行要是2,才能乘,又因为要得到的矩阵是3列,所以列是3)
- Y = X * W + B
3.代码实现
import numpy as np
from common.functions import sigmoid, identity

# 1.定义网络的参数,在定义时就确定了网络的结构
def init_network():
    network = {}
    # 第一层
    network["w1"] = np.array([[0.2, 0.5, 0.1], [0.3, 0.2, 0.8]])
    network["b1"] = np.array([0.1, 0.2, 0.3])
    # 第二层
    network["w2"] = np.array([[0.2, 0.5], [0.3, 0.8], [0.1, 0.3]])
    network["b2"] = np.array([0.1, 0.2])
    # 第三层
    network["w3"] = np.array([[0.2, 0.5], [0.3, 0.8]])
    network["b3"] = np.array([0.1, 0.2])
    return network

# 前向传播(预测过程)
def forward_propagate(x):
    network = init_network()
    w1 = network["w1"]
    w2 = network["w2"]
    w3 = network["w3"]
    b1 = network["b1"]
    b2 = network["b2"]
    b3 = network["b3"]
    a = sigmoid(np.dot(x, w1) + b1)
    b = sigmoid(np.dot(a, w2) + b2)
    c = identity(np.dot(b, w3) + b3)
    return c

if __name__ == '__main__':
    x = [0.2, 0.3]
    print(forward_propagate(x))
四、案例:手写数字识别
1.整体思路
灰度图象
- 28*28的大小,共784个像素
- 每个像素是一个值0~255,表示亮度。0:黑色,255:白色
由于神经网络中特征是一个列向量,而现在得到的是一个二维矩阵,因此要将它平展为 1*784 的列向量,表示 784 个特征。
输入层
有784个特征,所以输入层有784个节点
隐藏层
采用两个隐藏层,第一层50个节点,第二层100个节点
输出层
由于是要输出10个类别的概率,因此输出层有10个节点
由于目前还没学神经网络的训练过程,因此参数从nn_sample中读取。
数据来源于train.csv。
2.具体实现
先验知识
- MinMaxScaler(归一化)
将数据严格缩放到[0,1]区间
- StandardScaler(标准化)
将数据缩放到均值为0,标准差为1的正态分布
- 通过权重矩阵w的行列数,来定义各层的节点数
# -------手写数字识别-----------

import numpy as np
import pandas as pd
import joblib
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
from common.functions import sigmoid, softmax


def get_data():
    # 读取数据
    data = pd.read_csv('./data/train.csv')
    # 获取特征和标签
    x = data.drop('label', axis=1)
    y = data['label']
    # 划分训练集和测试集
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.3, random_state=39)
    # 训练集和测试集归一化
    scaler = MinMaxScaler()
    x_train = scaler.fit_transform(x_train)
    x_test = scaler.transform(x_test)
    # 返回测试数据
    return x_test, y_test


def init_network():
    # 加载模型参数
    network = joblib.load('data/nn_sample')
    return network


# 前向传播
def forward(network, x):
    w1 = network["W1"]
    w2 = network["W2"]
    w3 = network["W3"]
    b1 = network["b1"]
    b2 = network["b2"]
    b3 = network["b3"]
    # sigmoid + sigmoid + softmax
    a = sigmoid(np.dot(x, w1) + b1)
    b = sigmoid(np.dot(a, w2) + b2)
    c = softmax(np.dot(b, w3) + b3)
    return c


if __name__ == '__main__':
    x, y = get_data()
    network = init_network()
    y_pred = forward(network, x)
    y_max = np.argmax(y_pred, axis=1)
    count = np.sum(y_max == y)
    print("accuracy:", count / x.shape[0])
3.批量测试
只修改main函数,每次使用一个批量的数据进行前向传播,然后累加预测正确的数量,最后得出预测的准确率。
if __name__ == '__main__':
    x, y = get_data()
    network = init_network()
    correct_count = 0  # 预测正确的数量
    batch_size = 128  # 批次大小
    n = x.shape[0]  # 数据总数
    for i in range(0, n, batch_size):
        x_test = x[i:i + batch_size]
        y_pred = forward(network, x_test)
        y_label = np.argmax(y_pred, axis=1)
        correct_count += np.sum(y_label == y[i:i + batch_size])

    print("accuracy:", correct_count / n)
五、损失函数
深度学习不需要做特征工程,模型最终效果好,但是模型的可解释性差(隐藏层节点的含义不清楚)。
1.均方误差
- MSE,主要用于回归问题
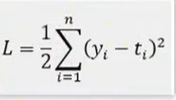
由于 1 / n 并不影响损失函数的最小值点,所以可以将它去掉,或者换成1 / 2
下面是手写均方误差函数,其中y_pred是w的函数。
def mean_squared_error(y, y_pred):
    return 0.5 * np.sum((y - y_pred) ** 2)
2.交叉熵损失
- 适用于分类问题
def cross_entropy(y, t):
    if y.ndim == 1:
        t = t.reshape(1, t.size)
        y = y.reshape(1, y.size)
    if t.size == y.size:
        t = t.argmax(axis=1)
    n = y.shape[0]
    return -np.sum(np.log(y[np.arange(n), t] + 1e-10)) / n

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 30
 0
- 0


 已为社区贡献2条内容

所有评论(0)