基于深度学习的数字图像分类实验与分析
基于深度学习的数字图像分类实验与分析
随便讲讲
本文详细记录了基于深度学习的数字图像分类实验的全过程,包括实验环境搭建、数据预处理、模型选择与搭建、训练与评估等关键环节。通过基础实验、改进实验、进阶实验和补充实验四个部分,逐步深入探讨了深度学习在数字图像分类中的应用。实验结果表明,卷积神经网络(CNN)结合注意力机制在图像分类任务中表现出色,具有较高的准确率和鲁棒性。
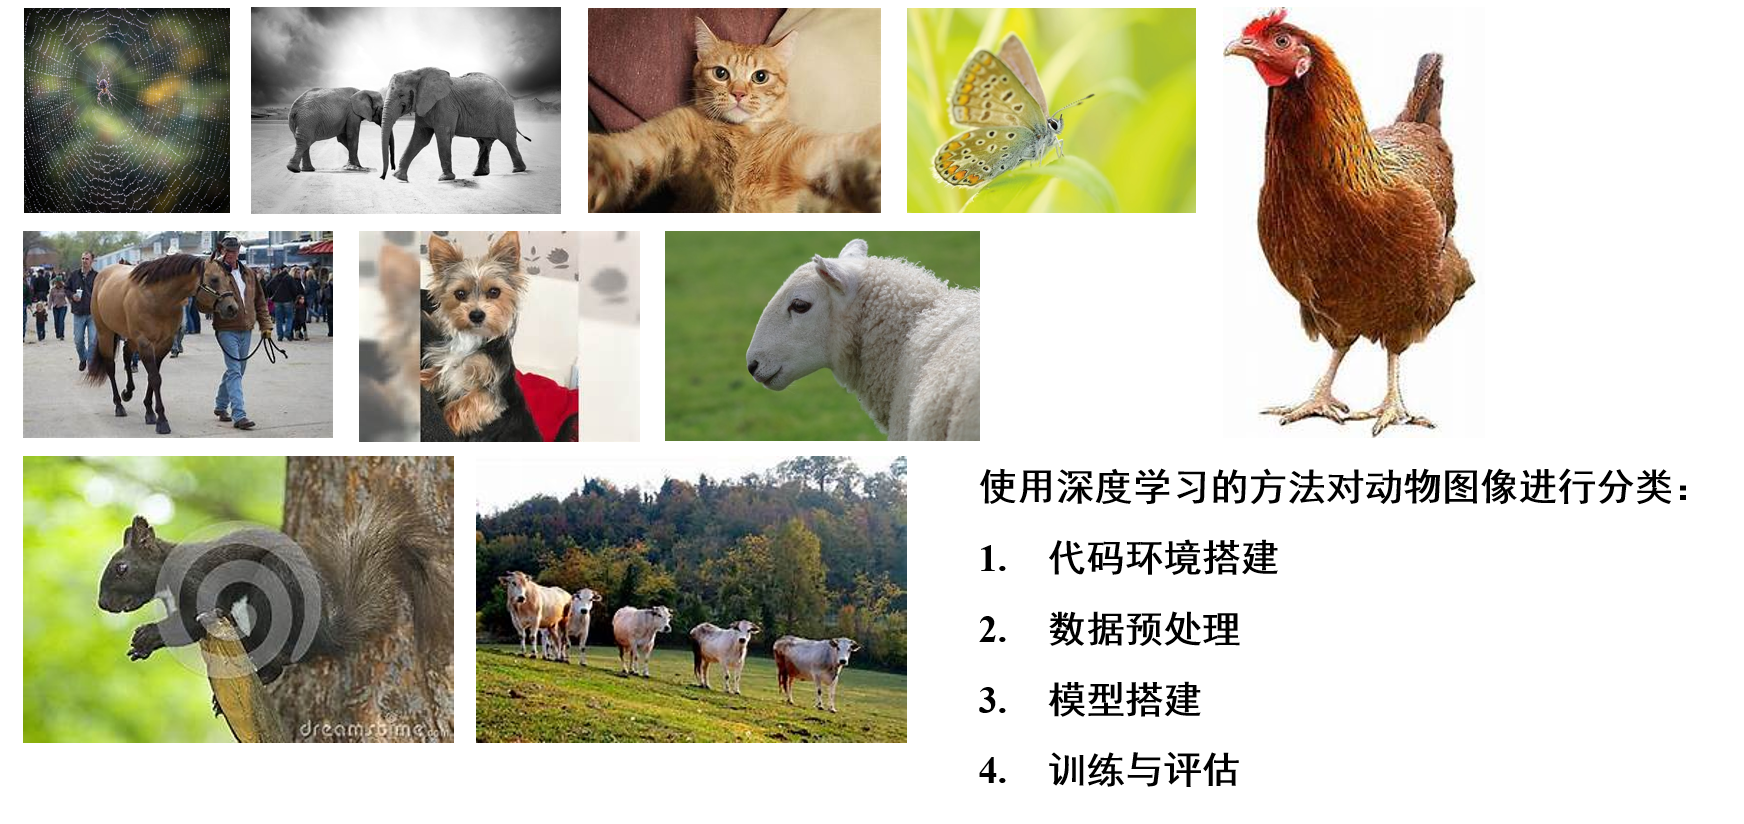
1. 实验目的
随着深度学习技术的快速发展,数字图像分类已成为计算机视觉领域的研究热点。本文通过一系列实验,系统探讨了深度学习在数字图像分类中的应用,旨在为相关领域的研究人员提供技术参考和实验指导。
2. 实验环境搭建
2.1 软件环境配置
Anaconda安装:首先下载并安装Anaconda,这是一个包含Python解释器和大量科学计算库的集成环境。安装教程参考Anaconda安装指南。
Python版本选择:安装Python 3.9版本,该版本在深度学习领域具有广泛的兼容性和稳定性。下载教程参考Python下载指南。
Python库安装:根据实验需求,安装常用的科学计算库如numpy、matplotlib等。具体安装指导参考Python库安装指南。
Torch库安装:
CPU版本:对于没有独立显卡的计算机,下载并安装CPU版本的torch库。安装指南参考Torch CPU版安装指南。
GPU版本:对于配备独立显卡的计算机,首先根据显卡驱动版本下载并安装CUDA。安装指南参考CUDA安装指南。随后下载并安装GPU版本的torch库,安装指南同上。
3. 实验内容与操作细节
3.1 基础实验一:全连接神经网络(MLP)
3.1.1 数据预处理
数据集下载:使用animals10数据集,该数据集包含大约28K张中等质量的动物图像,分为10个类别。数据集地址:animals10数据集。
数据集划分:使用data_loader将数据集划分为训练集、验证集和测试集,比例为7:2:1。具体实现代码如下:
python
def get_dataloaders(data_dir, batch_size=32, val_split=0.2, test_split=0.1):
    full_dataset = datasets.ImageFolder(data_dir)
    train_size = int((1 - val_split - test_split) * len(full_dataset))
    val_size = int(val_split * len(full_dataset))
    test_size = len(full_dataset) - train_size - val_size
    train_dataset, val_dataset, test_dataset = random_split(full_dataset, [train_size, val_size, test_size], generator=torch.Generator().manual_seed(42))
    # 创建DataLoader
    train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
    val_loader = DataLoader(val_dataset, batch_size=batch_size, shuffle=False)
    test_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=False)
    return train_loader, val_loader, test_loader
3.1.2 模型搭建
全连接神经网络(MLP):构建一个简单的MLP模型,包括输入层、隐藏层和输出层。输入层接收展平后的图像数据,隐藏层进行加权求和和非线性转换,输出层给出分类结果。
python
class SimpleMLP(nn.Module):
    def __init__(self, input_size, hidden_size, num_classes):
        super(SimpleMLP, self).__init__()
        self.fc1 = nn.Linear(input_size, hidden_size)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_size, num_classes)

    def forward(self, x):
        x = x.view(x.size(0), -1)  # 展平图像
        out = self.fc1(x)
        out = self.relu(out)
        out = self.fc2(out)
        return out
3.1.3 训练与评估
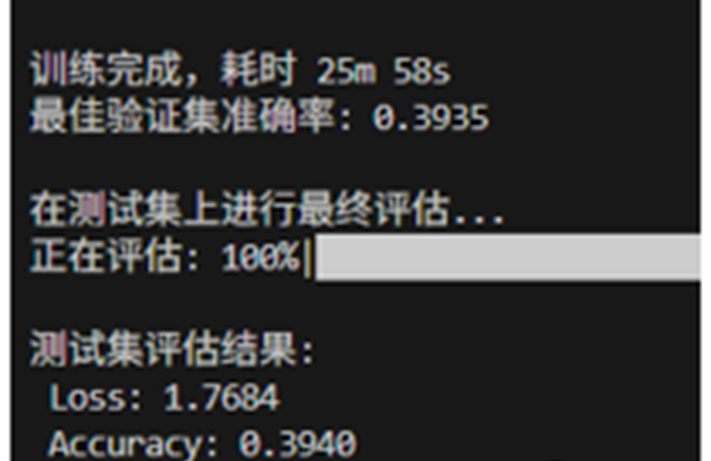
训练过程:在训练集上训练模型,通过调整学习率等超参数,让模型在测试集上展示最佳性能。训练30个epoch,测试集准确率约为0.4。
实验一代码实现:
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, random_split
from torchvision import datasets, transforms
import os
import time
import copy
import matplotlib.pyplot as plt
from tqdm import tqdm


# ======================================================================
# 1. 简单的全连接模型定义
# ======================================================================
class SimpleMLP(nn.Module):
    def __init__(self, input_size, hidden_sizes, num_classes):
        super(SimpleMLP, self).__init__()
        self.input_size = input_size

        layers = []
        in_size = input_size
        for h_size in hidden_sizes:
            layers.append(nn.Linear(in_size, h_size))
            layers.append(nn.ReLU(inplace=True))
            layers.append(nn.Dropout(0.5))
            in_size = h_size

        layers.append(nn.Linear(in_size, num_classes))
        self.classifier = nn.Sequential(*layers)

    def forward(self, x):
        # 将图像展平以适应全连接网络
        x = torch.flatten(x, start_dim=1)
        return self.classifier(x)


# ======================================================================
# 2. 数据处理模块
# ======================================================================
def get_dataloaders(data_dir, batch_size=32, val_split=0.2, test_split=0.1):
    data_transforms = {
        'train': transforms.Compose([
            transforms.RandomResizedCrop(224),
            transforms.RandomHorizontalFlip(),
            transforms.ToTensor(),
            transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
        ]),
        'val': transforms.Compose([
            transforms.Resize(256),
            transforms.CenterCrop(224),
            transforms.ToTensor(),
            transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
        ]),
    }
    full_dataset = datasets.ImageFolder(root=data_dir)
    class_names = full_dataset.classes
    total_size = len(full_dataset)
    test_size = int(total_size * test_split)
    val_size = int((total_size - test_size) * val_split)
    train_size = total_size - test_size - val_size
    train_dataset, val_dataset, test_dataset = random_split(
        full_dataset, [train_size, val_size, test_size],
        generator=torch.Generator().manual_seed(42)
    )
    train_dataset.dataset.transform = data_transforms['train']
    val_dataset.dataset.transform = data_transforms['val']
    test_dataset.dataset.transform = data_transforms['val']
    dataloaders = {
        'train': DataLoader(train_dataset, batch_size=batch_size, shuffle=True, num_workers=2),
        'val': DataLoader(val_dataset, batch_size=batch_size, shuffle=False, num_workers=2),
        'test': DataLoader(test_dataset, batch_size=batch_size, shuffle=False, num_workers=2)
    }
    dataset_sizes = {'train': len(train_dataset), 'val': len(val_dataset), 'test': len(test_dataset)}
    return dataloaders, dataset_sizes, class_names


# ======================================================================
# 3. 模型加载模块
# ======================================================================
def get_model(num_classes):
    """
    创建一个简单的全连接网络模型。
    """
    input_size = 3 * 224 * 224  # 图像展平后的大小
    hidden_sizes = [512, 256]  # 定义两个隐藏层

    model = SimpleMLP(
        input_size=input_size,
        hidden_sizes=hidden_sizes,
        num_classes=num_classes
    )
    print("已加载简单的全连接网络 (MLP) 模型。")
    print(model)
    return model


# ======================================================================
# 4. 训练与评估模块
# ======================================================================
def train_model(model, dataloaders, dataset_sizes, criterion, optimizer, device, num_epochs=25, save_dir='models'):
    since = time.time()
    os.makedirs(save_dir, exist_ok=True)
    best_model_weights = copy.deepcopy(model.state_dict())
    best_acc = 0.0
    history = {'train_loss': [], 'train_acc': [], 'val_loss': [], 'val_acc': []}

    for epoch in range(num_epochs):
        print(f'\nEpoch {epoch + 1}/{num_epochs}')
        print('-' * 10)
        for phase in ['train', 'val']:
            model.train() if phase == 'train' else model.eval()
            running_loss = 0.0
            running_corrects = 0
            for inputs, labels in tqdm(dataloaders[phase], desc=f"{phase.capitalize()} Epoch"):
                inputs, labels = inputs.to(device), labels.to(device)
                optimizer.zero_grad()
                with torch.set_grad_enabled(phase == 'train'):
                    outputs = model(inputs)
                    _, preds = torch.max(outputs, 1)
                    loss = criterion(outputs, labels)
                    if phase == 'train':
                        loss.backward()
                        optimizer.step()
                running_loss += loss.item() * inputs.size(0)
                running_corrects += torch.sum(preds == labels.data)
            epoch_loss = running_loss / dataset_sizes[phase]
            epoch_acc = running_corrects.double() / dataset_sizes[phase]
            print(f'{phase.capitalize()} Loss: {epoch_loss:.4f} Acc: {epoch_acc:.4f}')
            history[f'{phase}_loss'].append(epoch_loss)
            history[f'{phase}_acc'].append(epoch_acc.item())
            if phase == 'val' and epoch_acc > best_acc:
                best_acc = epoch_acc
                best_model_weights = copy.deepcopy(model.state_dict())
                torch.save(best_model_weights, os.path.join(save_dir, 'best_mlp_model.pth'))
    time_elapsed = time.time() - since
    print(f'\n训练完成,耗时 {time_elapsed // 60:.0f}m {time_elapsed % 60:.0f}s')
    print(f'最佳验证集准确率: {best_acc:.4f}')
    model.load_state_dict(best_model_weights)
    return model, history


def evaluate_model(model, dataloader, criterion, device):
    model.eval()
    running_loss, running_corrects = 0.0, 0
    with torch.no_grad():
        for inputs, labels in tqdm(dataloader, desc="正在评估"):
            inputs, labels = inputs.to(device), labels.to(device)
            outputs = model(inputs)
            loss = criterion(outputs, labels)
            _, preds = torch.max(outputs, 1)
            running_loss += loss.item() * inputs.size(0)
            running_corrects += torch.sum(preds == labels.data)
    total_loss = running_loss / len(dataloader.dataset)
    total_acc = running_corrects.double() / len(dataloader.dataset)
    print(f'\n测试集评估结果: \n Loss: {total_loss:.4f} \n Accuracy: {total_acc:.4f}')


def plot_history(history, save_dir='models'):
    plt.figure(figsize=(12, 5))
    plt.subplot(1, 2, 1)
    plt.plot(history['train_acc'], label='Train Accuracy')
    plt.plot(history['val_acc'], label='Validation Accuracy')
    plt.title('Accuracy History');
    plt.xlabel('Epoch');
    plt.ylabel('Accuracy');
    plt.legend()
    plt.subplot(1, 2, 2)
    plt.plot(history['train_loss'], label='Train Loss')
    plt.plot(history['val_loss'], label='Validation Loss')
    plt.title('Loss History');
    plt.xlabel('Epoch');
    plt.ylabel('Loss');
    plt.legend()
    plt.tight_layout()
    plt.savefig(os.path.join(save_dir, 'mlp_training_history.png'))
    plt.show()


# ======================================================================
# 5. 主执行模块
# ======================================================================
if __name__ == '__main__':
    # --- 参数配置 ---
    DATA_DIR = r'D:\software\data\archive\raw-img'  # !!!重要!!! 请修改为你的数据集路径
    if not os.path.exists(DATA_DIR):
        raise FileNotFoundError(f"错误:数据集目录 '{DATA_DIR}' 不存在。")

    NUM_EPOCHS = 6
    BATCH_SIZE = 32
    LEARNING_RATE = 0.0001  # 对于MLP,使用一个更小的学习率可能更稳定
    SAVE_DIR = 'models_mlp'

    # --- 设备配置 ---
    DEVICE = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
    print(f"使用设备: {DEVICE}")

    # --- 数据加载 ---
    dataloaders, dataset_sizes, class_names = get_dataloaders(DATA_DIR, batch_size=BATCH_SIZE)
    num_classes = len(class_names)
    print(f"发现 {num_classes} 个类别: {', '.join(class_names)}")

    # --- 模型、损失函数和优化器 ---
    model = get_model(num_classes=num_classes).to(DEVICE)

    # ***重要***: 优化器现在需要更新模型的所有参数
    optimizer = optim.Adam(model.parameters(), lr=LEARNING_RATE)
    criterion = nn.CrossEntropyLoss()

    # --- 模型训练 ---
    trained_model, history = train_model(
        model, dataloaders, dataset_sizes, criterion, optimizer, DEVICE, num_epochs=NUM_EPOCHS, save_dir=SAVE_DIR
    )


    # --- 模型评估 ---
    print("\n在测试集上进行最终评估...")
    evaluate_model(trained_model, dataloaders['test'], criterion, DEVICE)
3.2 改进实验二:卷积神经网络(CNN)
3.2.1 数据预处理
数据筛选:从十种动物数据中筛选出牛、羊、马、狗、猫、象、鸡等特定类别的图像进行训练、验证和测试。实现代码如下:
python
class FilteredImageFolder(datasets.ImageFolder):
    def __init__(self, root, classes, transform=None):
        super(FilteredImageFolder, self).__init__(root, transform)
        self.classes = classes
        self.imgs = [img for img in self.imgs if img[1] in self.classes]
3.2.2 模型搭建
卷积神经网络(CNN):将全连接网络改为CNN网络,增加卷积层和池化层以提取图像中的空间特征。
python
class SimpleCNN(nn.Module):
    def __init__(self, num_classes):
        super(SimpleCNN, self).__init__()
        self.conv1 = nn.Conv2d(3, 16, kernel_size=3, stride=1, padding=1)
        self.relu = nn.ReLU()
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
        self.conv2 = nn.Conv2d(16, 32, kernel_size=3, stride=1, padding=1)
        self.fc = nn.Linear(32 * 56 * 56, num_classes)  # 假设输入图像大小为224x224

    def forward(self, x):
        out = self.conv1(x)
        out = self.relu(out)
        out = self.pool(out)
        out = self.conv2(out)
        out = self.relu(out)
        out = self.pool(out)
        out = out.view(out.size(0), -1)  # 展平特征图
        out = self.fc(out)
        return out
3.2.3 训练与评估
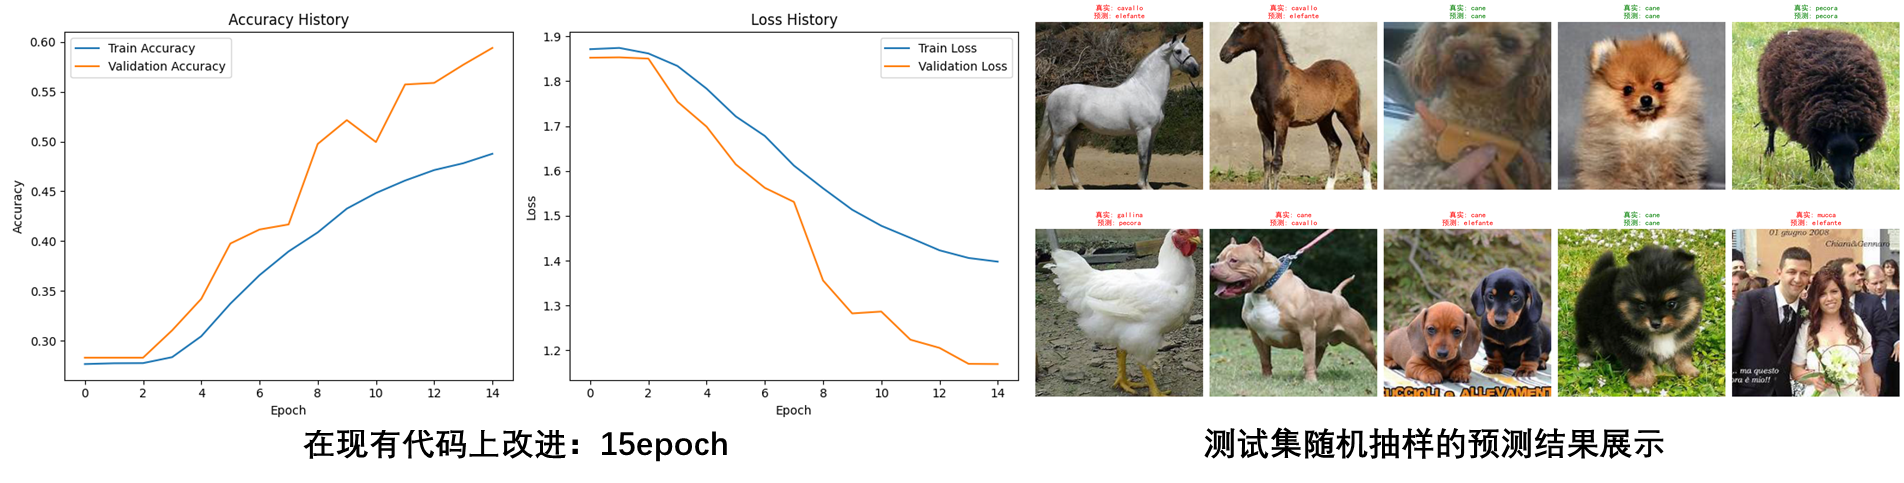
可视化训练过程:在训练过程中记录损失和准确率,并使用matplotlib进行可视化。15个epoch后,测试集准确率显著提升。
——————————————————————————————
实验二代码实现
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, random_split, Subset
from torchvision import datasets, transforms
import os
import time
import copy
import matplotlib.pyplot as plt
import numpy as np
from PIL import Image
import sys


# ======================================================================
# 1. 超轻量级CNN模型定义 (修复版本)
# ======================================================================
class UltraLightCNN(nn.Module):
    def __init__(self, num_classes):
        super(UltraLightCNN, self).__init__()
        self.features = nn.Sequential(
            # 输入: 3x56x56 (经过RandomCrop(56))
            nn.Conv2d(3, 16, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),  # 输出: 16x28x28

            nn.Conv2d(16, 32, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),  # 输出: 32x14x14

            nn.Conv2d(32, 64, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),  # 输出: 64x7x7
        )

        # 计算全连接层输入大小: 64 * 7 * 7 = 3136
        self.classifier = nn.Sequential(
            nn.Dropout(0.3),
            nn.Linear(64 * 7 * 7, 128),  # 修正输入维度
            nn.ReLU(inplace=True),
            nn.Dropout(0.3),
            nn.Linear(128, num_classes),
        )

    def forward(self, x):
        x = self.features(x)
        x = torch.flatten(x, 1)
        x = self.classifier(x)
        return x


# ======================================================================
# 2. 数据处理模块 (筛选7种动物)
# ======================================================================
class FilteredImageFolder(datasets.ImageFolder):
    def __init__(self, root, selected_classes, transform=None):
        self.selected_classes = selected_classes
        super(FilteredImageFolder, self).__init__(root, transform=transform)

        # 筛选类别
        selected_indices = []
        class_mapping = {}
        new_classes = []

        # 创建类别映射
        for i, class_name in enumerate(self.classes):
            if class_name in selected_classes:
                class_mapping[i] = len(new_classes)
                new_classes.append(class_name)

        # 筛选样本
        filtered_samples = []
        for path, label in self.samples:
            class_name = self.classes[label]
            if class_name in selected_classes:
                filtered_samples.append((path, class_mapping[label]))

        self.samples = filtered_samples
        self.imgs = filtered_samples
        self.classes = new_classes
        self.class_to_idx = {cls_name: i for i, cls_name in enumerate(new_classes)}


def get_dataloaders(data_dir, batch_size=8, val_split=0.2, test_split=0.1):
    # 定义我们需要的7种动物
    selected_classes = ['cane', 'cavallo', 'elefante', 'gallina', 'gatto', 'mucca', 'pecora']

    # 简化数据增强和归一化
    data_transforms = {
        'train': transforms.Compose([
            transforms.Resize(64),
            transforms.RandomCrop(56),  # 裁剪为56x56
            transforms.RandomHorizontalFlip(),
            transforms.ToTensor(),
            transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
        ]),
        'val': transforms.Compose([
            transforms.Resize(64),
            transforms.CenterCrop(56),  # 裁剪为56x56
            transforms.ToTensor(),
            transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
        ]),
        'test': transforms.Compose([
            transforms.Resize(64),
            transforms.CenterCrop(56),  # 裁剪为56x56
            transforms.ToTensor(),
            transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
        ]),
    }

    # 创建筛选后的数据集
    full_dataset = FilteredImageFolder(
        root=data_dir,
        selected_classes=selected_classes,
        transform=data_transforms['train']  # 初始transform,后续会覆盖
    )

    # 计算数据集大小
    total_size = len(full_dataset)
    test_size = int(total_size * test_split)
    val_size = int((total_size - test_size) * val_split)
    train_size = total_size - test_size - val_size

    # 划分数据集
    train_dataset, val_dataset, test_dataset = random_split(
        full_dataset, [train_size, val_size, test_size],
        generator=torch.Generator().manual_seed(42)
    )

    # 为每个子集应用不同的transform
    class TransformedSubset(Subset):
        def __init__(self, dataset, indices, transform=None):
            super().__init__(dataset, indices)
            self.transform = transform

        def __getitem__(self, idx):
            x, y = self.dataset[self.indices[idx]]
            if self.transform:
                x = self.transform(x)
            return x, y

    # 应用不同的transform
    train_dataset = TransformedSubset(train_dataset.dataset, train_dataset.indices, data_transforms['train'])
    val_dataset = TransformedSubset(val_dataset.dataset, val_dataset.indices, data_transforms['val'])
    test_dataset = TransformedSubset(test_dataset.dataset, test_dataset.indices, data_transforms['test'])

    # 创建数据加载器
    dataloaders = {
        'train': DataLoader(train_dataset, batch_size=batch_size, shuffle=True, num_workers=0),
        'val': DataLoader(val_dataset, batch_size=batch_size, shuffle=False, num_workers=0),
        'test': DataLoader(test_dataset, batch_size=batch_size, shuffle=False, num_workers=0)
    }

    dataset_sizes = {
        'train': len(train_dataset),
        'val': len(val_dataset),
        'test': len(test_dataset)
    }

    return dataloaders, dataset_sizes, full_dataset.classes


# ======================================================================
# 3. 模型加载模块
# ======================================================================
def get_model(num_classes):
    """
    创建一个超轻量级CNN模型。
    """
    model = UltraLightCNN(num_classes=num_classes)
    print("已加载超轻量级CNN模型。")
    print(f"模型参数数量: {sum(p.numel() for p in model.parameters()):,}")
    return model


# ======================================================================
# 4. 训练与评估模块
# ======================================================================
def train_model(model, dataloaders, dataset_sizes, criterion, optimizer, device, num_epochs=10, save_dir='models'):
    since = time.time()
    os.makedirs(save_dir, exist_ok=True)
    best_model_weights = copy.deepcopy(model.state_dict())
    best_acc = 0.0
    history = {'train_loss': [], 'train_acc': [], 'val_loss': [], 'val_acc': []}

    for epoch in range(num_epochs):
        print(f'\nEpoch {epoch + 1}/{num_epochs}')
        print('-' * 10)

        for phase in ['train', 'val']:
            if phase == 'train':
                model.train()
            else:
                model.eval()

            running_loss = 0.0
            running_corrects = 0

            # 遍历数据
            for inputs, labels in dataloaders[phase]:
                inputs, labels = inputs.to(device), labels.to(device)

                optimizer.zero_grad()

                with torch.set_grad_enabled(phase == 'train'):
                    outputs = model(inputs)
                    _, preds = torch.max(outputs, 1)
                    loss = criterion(outputs, labels)

                    if phase == 'train':
                        loss.backward()
                        optimizer.step()

                running_loss += loss.item() * inputs.size(0)
                running_corrects += torch.sum(preds == labels.data)

            epoch_loss = running_loss / dataset_sizes[phase]
            epoch_acc = running_corrects.double() / dataset_sizes[phase]

            print(f'{phase.capitalize()} Loss: {epoch_loss:.4f} Acc: {epoch_acc:.4f}')

            history[f'{phase}_loss'].append(epoch_loss)
            history[f'{phase}_acc'].append(epoch_acc.item())

            if phase == 'val' and epoch_acc > best_acc:
                best_acc = epoch_acc
                best_model_weights = copy.deepcopy(model.state_dict())
                torch.save(best_model_weights, os.path.join(save_dir, 'best_ultra_light_cnn_model.pth'))

    time_elapsed = time.time() - since
    print(f'\n训练完成,耗时 {time_elapsed // 60:.0f}m {time_elapsed % 60:.0f}s')
    print(f'最佳验证集准确率: {best_acc:.4f}')

    model.load_state_dict(best_model_weights)
    return model, history


def evaluate_model(model, dataloader, criterion, device):
    model.eval()
    running_loss, running_corrects = 0.0, 0

    with torch.no_grad():
        for inputs, labels in dataloader:
            inputs, labels = inputs.to(device), labels.to(device)
            outputs = model(inputs)
            loss = criterion(outputs, labels)
            _, preds = torch.max(outputs, 1)
            running_loss += loss.item() * inputs.size(0)
            running_corrects += torch.sum(preds == labels.data)

    total_loss = running_loss / len(dataloader.dataset)
    total_acc = running_corrects.double() / len(dataloader.dataset)
    print(f'\n测试集评估结果: \n Loss: {total_loss:.4f} \n Accuracy: {total_acc:.4f}')


def plot_history(history, save_dir='models'):
    plt.figure(figsize=(12, 5))
    plt.subplot(1, 2, 1)
    plt.plot(history['train_acc'], label='Train Accuracy')
    plt.plot(history['val_acc'], label='Validation Accuracy')
    plt.title('Accuracy History')
    plt.xlabel('Epoch')
    plt.ylabel('Accuracy')
    plt.legend()

    plt.subplot(1, 2, 2)
    plt.plot(history['train_loss'], label='Train Loss')
    plt.plot(history['val_loss'], label='Validation Loss')
    plt.title('Loss History')
    plt.xlabel('Epoch')
    plt.ylabel('Loss')
    plt.legend()

    plt.tight_layout()
    plt.savefig(os.path.join(save_dir, 'ultra_light_cnn_training_history.png'))
    plt.show()


# ======================================================================
# 5. 主执行模块
# ======================================================================
def main():
    # --- 参数配置 ---
    DATA_DIR = r'D:\software\data\archive\raw-img'  # 请修改为你的数据集路径
    if not os.path.exists(DATA_DIR):
        print(f"错误:数据集目录 '{DATA_DIR}' 不存在。")
        return

    NUM_EPOCHS = 5
    BATCH_SIZE = 8
    LEARNING_RATE = 0.001
    SAVE_DIR = 'models_ultra_light_cnn'

    # --- 设备配置 ---
    DEVICE = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
    print(f"使用设备: {DEVICE}")

    # --- 数据加载 ---
    try:
        dataloaders, dataset_sizes, class_names = get_dataloaders(DATA_DIR, batch_size=BATCH_SIZE)
        num_classes = len(class_names)
        print(f"筛选后的 {num_classes} 个类别: {', '.join(class_names)}")
        print(f"数据集大小: 训练集={dataset_sizes['train']}, 验证集={dataset_sizes['val']}, 测试集={dataset_sizes['test']}")
    except Exception as e:
        print(f"数据加载错误: {e}")
        return

    # --- 模型、损失函数和优化器 ---
    model = get_model(num_classes=num_classes).to(DEVICE)
    optimizer = optim.Adam(model.parameters(), lr=LEARNING_RATE)
    criterion = nn.CrossEntropyLoss()

    # --- 模型训练 ---
    try:
        trained_model, history = train_model(
            model, dataloaders, dataset_sizes, criterion, optimizer, DEVICE,
            num_epochs=NUM_EPOCHS, save_dir=SAVE_DIR
        )
    except Exception as e:
        print(f"训练错误: {e}")
        return

    # --- 模型评估 ---
    print("\n在测试集上进行最终评估...")
    try:
        evaluate_model(trained_model, dataloaders['test'], criterion, DEVICE)
    except Exception as e:
        print(f"评估错误: {e}")

    # --- 绘制训练历史 ---
    try:
        plot_history(history, save_dir=SAVE_DIR)
    except Exception as e:
        print(f"绘图错误: {e}")


if __name__ == '__main__':
    main()
3.3 进阶实验三:数据增强与高级模型
3.3.1 数据预处理
数据增强:加入裁剪、旋转、模糊、高斯噪声、遮挡等噪声进行数据增强,以提高模型的泛化能力。
python
transform = transforms.Compose([
    transforms.RandomResizedCrop(224, scale=(0.8, 1.0)),  # 裁剪
    transforms.RandomRotation(15),  # 旋转
    transforms.ColorJitter(brightness=0.1, contrast=0.1, saturation=0.1, hue=0.1),  # 色彩抖动
    transforms.GaussianBlur(kernel_size=(5, 9), sigma=(0.1, 2.0)),  # 模糊
    transforms.RandomErasing(p=0.5, scale=(0.02, 0.33), ratio=(0.3, 3.3), value=0, inplace=False),  # 遮挡
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))  # 归一化
])
3.3.2 模型搭建
ResNet与注意力机制:使用ResNet-18作为特征提取器,并在其输出特征图上应用通道注意力机制。
python
class ChannelAttention(nn.Module):
    def __init__(self, in_planes, ratio=16):
        super(ChannelAttention, self).__init__()
        self.avg_pool = nn.AdaptiveAvgPool2d(1)
        self.max_pool = nn.AdaptiveMaxPool2d(1)

        self.fc = nn.Sequential(
            nn.Linear(in_planes, in_planes // ratio),
            nn.ReLU(),
            nn.Linear(in_planes // ratio, in_planes)
        )

    def forward(self, x):
        b, c, _, _ = x.size()
        avg_out = self.fc(self.avg_pool(x).view(b, c))
        max_out = self.fc(self.max_pool(x).view(b, c))
        out = avg_out + max_out
        return torch.sigmoid(out).view(b, c, 1, 1)

class ResNetWithAttention(nn.Module):
    def __init__(self, num_classes):
        super(ResNetWithAttention, self).__init__()
        self.resnet = models.resnet18(pretrained=False)
        self.attention = ChannelAttention(512)  # ResNet-18最后一层特征图通道数为512
        self.fc = nn.Linear(512, num_classes)

    def forward(self, x):
        x = self.resnet.conv1(x)
        x = self.resnet.bn1(x)
        x = self.resnet.relu(x)
        x = self.resnet.maxpool(x)
        x = self.resnet.layer1(x)
        x = self.resnet.layer2(x)
        x = self.resnet.layer3(x)
        x = self.resnet.layer4(x)
        attention_weights = self.attention(x)
        x = x * attention_weights
        x = self.resnet.avgpool(x)
        x = torch.flatten(x, 1)
        x = self.fc(x)
        return x
3.3.3 训练与评估
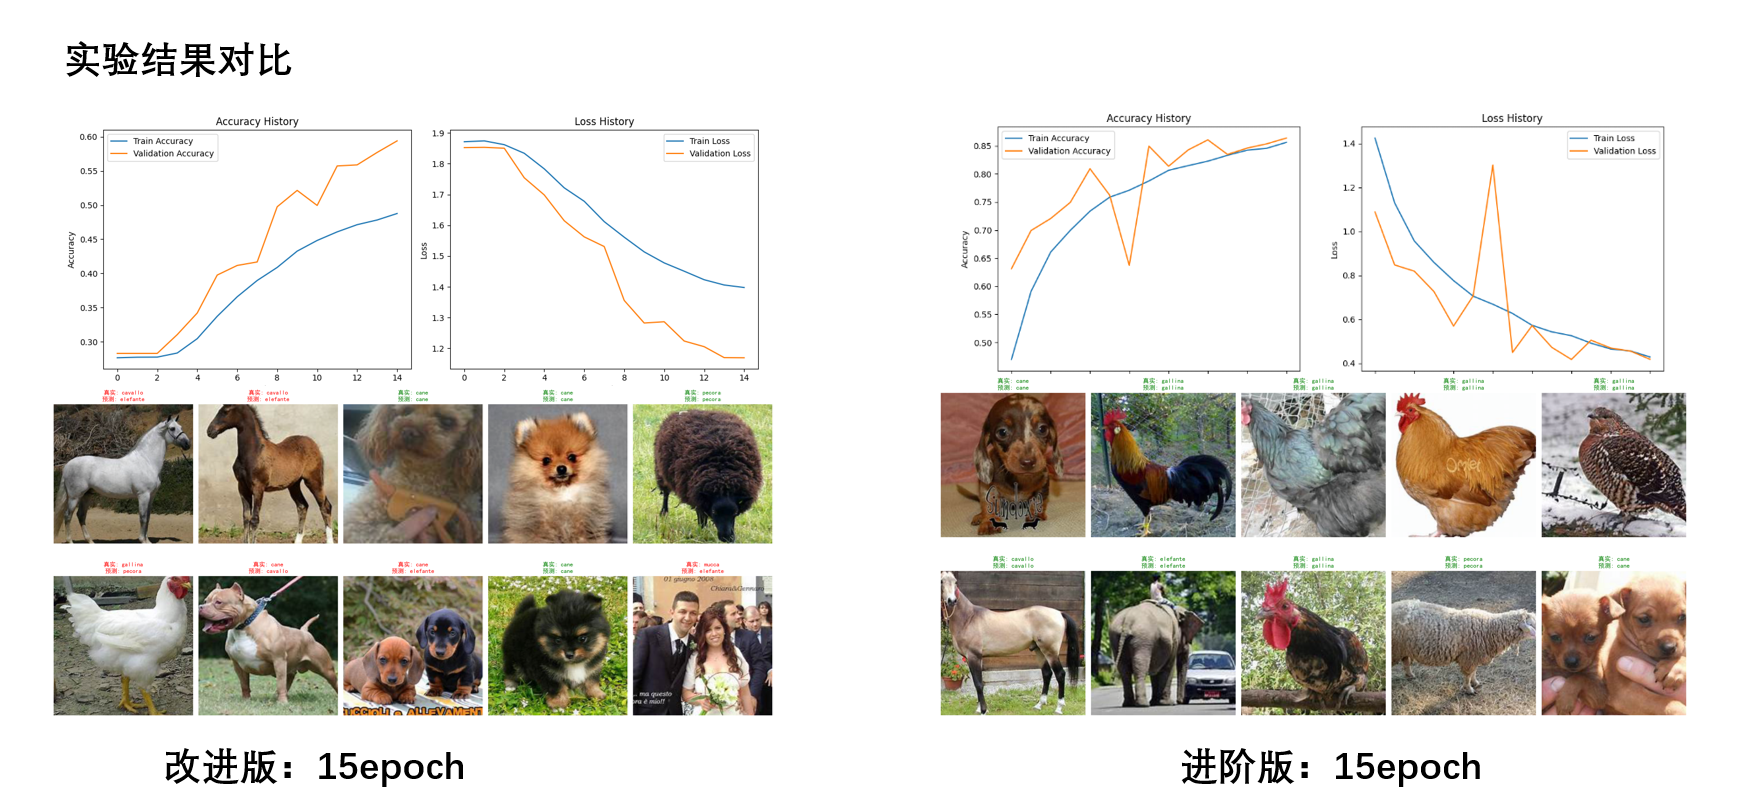
实验结果对比:通过对比不同模型在15个epoch后的测试集准确率,发现结合注意力机制的ResNet模型性能显著优于简单MLP和CNN模型。
——————————————————————————————
实验三代码实现
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, random_split, Subset
from torchvision import datasets, transforms, models
import os
import time
import copy
import matplotlib.pyplot as plt
import numpy as np
from PIL import Image
import sys
import random
import torch.nn.functional as F

# ======================================================================
# 1. 通道注意力机制 (SENet-like)
# ======================================================================
class ChannelAttention(nn.Module):
    def __init__(self, in_channels, reduction_ratio=16):
        super(ChannelAttention, self).__init__()
        self.avg_pool = nn.AdaptiveAvgPool2d(1)
        self.max_pool = nn.AdaptiveMaxPool2d(1)

        self.fc = nn.Sequential(
            nn.Linear(in_channels, in_channels // reduction_ratio, bias=False),
            nn.ReLU(inplace=True),
            nn.Linear(in_channels // reduction_ratio, in_channels, bias=False),
            nn.Sigmoid()
        )

    def forward(self, x):
        b, c, _, _ = x.size()
        avg_out = self.fc(self.avg_pool(x).view(b, c))
        max_out = self.fc(self.max_pool(x).view(b, c))
        out = avg_out + max_out
        return x * out.view(b, c, 1, 1)


# ======================================================================
# 2. 基于ResNet-18的模型定义
# ======================================================================
class ResNetWithAttention(nn.Module):
    def __init__(self, num_classes):
        super(ResNetWithAttention, self).__init__()

        # 加载预训练的ResNet-18
        self.resnet = models.resnet18(pretrained=True)

        # 移除最后的全连接层
        self.features = nn.Sequential(*list(self.resnet.children())[:-2])

        # 获取ResNet的输出通道数
        self.in_channels = self.resnet.fc.in_features

        # 添加通道注意力机制
        self.attention = ChannelAttention(self.in_channels)

        # 全局平均池化
        self.avgpool = nn.AdaptiveAvgPool2d(1)

        # 分类器
        self.classifier = nn.Sequential(
            nn.Dropout(0.5),
            nn.Linear(self.in_channels, 512),
            nn.ReLU(inplace=True),
            nn.Dropout(0.5),
            nn.Linear(512, num_classes)
        )

    def forward(self, x):
        # 提取特征
        x = self.features(x)

        # 应用通道注意力
        x = self.attention(x)

        # 全局平均池化
        x = self.avgpool(x)
        x = torch.flatten(x, 1)

        # 分类
        x = self.classifier(x)
        return x


# ======================================================================
# 3. 数据处理模块 (增强版数据增强)
# ======================================================================
class FilteredImageFolder(datasets.ImageFolder):
    def __init__(self, root, selected_classes, transform=None):
        self.selected_classes = selected_classes
        super(FilteredImageFolder, self).__init__(root, transform=transform)

        # 筛选类别
        selected_indices = []
        class_mapping = {}
        new_classes = []

        # 创建类别映射
        for i, class_name in enumerate(self.classes):
            if class_name in selected_classes:
                class_mapping[i] = len(new_classes)
                new_classes.append(class_name)

        # 筛选样本
        filtered_samples = []
        for path, label in self.samples:
            class_name = self.classes[label]
            if class_name in selected_classes:
                filtered_samples.append((path, class_mapping[label]))

        self.samples = filtered_samples
        self.imgs = filtered_samples
        self.classes = new_classes
        self.class_to_idx = {cls_name: i for i, cls_name in enumerate(new_classes)}


# 在模块级别定义TransformedSubset类(而不是在函数内部)
class TransformedSubset(Subset):
    def __init__(self, dataset, indices, transform=None):
        super().__init__(dataset, indices)
        self.transform = transform

    def __getitem__(self, idx):
        x, y = self.dataset[self.indices[idx]]
        if self.transform:
            x = self.transform(x)
        return x, y


def get_dataloaders(data_dir, batch_size=16, val_split=0.2, test_split=0.1):
    # 定义我们需要的7种动物
    selected_classes = ['cane', 'cavallo', 'elefante', 'gallina', 'gatto', 'mucca', 'pecora']

    # 增强的数据增强和归一化
    data_transforms = {
        'train': transforms.Compose([
            transforms.Resize(256),
            transforms.RandomResizedCrop(224),  # 随机裁剪
            transforms.RandomRotation(30),      # 随机旋转
            transforms.RandomHorizontalFlip(),  # 随机水平翻转
            transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2, hue=0.1),  # 颜色抖动
            transforms.ToTensor(),
            transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225]),
            transforms.RandomErasing(p=0.5, scale=(0.02, 0.1), ratio=(0.3, 3.3)),  # 随机遮挡
        ]),
        'val': transforms.Compose([
            transforms.Resize(256),
            transforms.CenterCrop(224),
            transforms.ToTensor(),
            transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
        ]),
        'test': transforms.Compose([
            transforms.Resize(256),
            transforms.CenterCrop(224),
            transforms.ToTensor(),
            transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
        ]),
    }

    # 创建筛选后的数据集
    full_dataset = FilteredImageFolder(
        root=data_dir,
        selected_classes=selected_classes,
        transform=data_transforms['train']  # 初始transform,后续会覆盖
    )

    # 计算数据集大小
    total_size = len(full_dataset)
    test_size = int(total_size * test_split)
    val_size = int((total_size - test_size) * val_split)
    train_size = total_size - test_size - val_size

    # 划分数据集
    train_dataset, val_dataset, test_dataset = random_split(
        full_dataset, [train_size, val_size, test_size],
        generator=torch.Generator().manual_seed(42)
    )

    # 为每个子集应用不同的transform(使用全局定义的TransformedSubset类)
    train_dataset = TransformedSubset(full_dataset, train_dataset.indices, data_transforms['train'])
    val_dataset = TransformedSubset(full_dataset, val_dataset.indices, data_transforms['val'])
    test_dataset = TransformedSubset(full_dataset, test_dataset.indices, data_transforms['test'])

    # 创建数据加载器
    dataloaders = {
        'train': DataLoader(train_dataset, batch_size=batch_size, shuffle=True, num_workers=4),
        'val': DataLoader(val_dataset, batch_size=batch_size, shuffle=False, num_workers=4),
        'test': DataLoader(test_dataset, batch_size=batch_size, shuffle=False, num_workers=4)
    }

    dataset_sizes = {
        'train': len(train_dataset),
        'val': len(val_dataset),
        'test': len(test_dataset)
    }

    return dataloaders, dataset_sizes, full_dataset.classes


# ======================================================================
# 4. 模型加载模块
# ======================================================================
def get_model(num_classes, model_path=None):
    """
    创建一个基于ResNet-18并带有通道注意力机制的模型。
    """
    model = ResNetWithAttention(num_classes=num_classes)

    # 加载预训练权重(如果存在)
    if model_path and os.path.exists(model_path):
        model.load_state_dict(torch.load(model_path, map_location=torch.device('cpu')))
        print(f"已加载预训练模型权重: {model_path}")

    print("已加载基于ResNet-18的模型(带通道注意力机制)。")
    print(f"模型参数数量: {sum(p.numel() for p in model.parameters()):,}")
    return model


# ======================================================================
# 5. 训练与评估模块
# ======================================================================
def train_model(model, dataloaders, dataset_sizes, criterion, optimizer, device, num_epochs=25, save_dir='models'):
    since = time.time()
    os.makedirs(save_dir, exist_ok=True)
    best_model_weights = copy.deepcopy(model.state_dict())
    best_acc = 0.0
    history = {'train_loss': [], 'train_acc': [], 'val_loss': [], 'val_acc': []}

    # 学习率调度器
    scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=7, gamma=0.1)

    for epoch in range(num_epochs):
        print(f'\nEpoch {epoch + 1}/{num_epochs}')
        print('-' * 10)

        for phase in ['train', 'val']:
            if phase == 'train':
                model.train()
            else:
                model.eval()

            running_loss = 0.0
            running_corrects = 0

            # 遍历数据
            for inputs, labels in dataloaders[phase]:
                inputs, labels = inputs.to(device), labels.to(device)

                optimizer.zero_grad()

                with torch.set_grad_enabled(phase == 'train'):
                    outputs = model(inputs)
                    _, preds = torch.max(outputs, 1)
                    loss = criterion(outputs, labels)

                    if phase == 'train':
                        loss.backward()
                        optimizer.step()

                running_loss += loss.item() * inputs.size(0)
                running_corrects += torch.sum(preds == labels.data)

            if phase == 'train':
                scheduler.step()

            epoch_loss = running_loss / dataset_sizes[phase]
            epoch_acc = running_corrects.double() / dataset_sizes[phase]

            print(f'{phase.capitalize()} Loss: {epoch_loss:.4f} Acc: {epoch_acc:.4f}')

            history[f'{phase}_loss'].append(epoch_loss)
            history[f'{phase}_acc'].append(epoch_acc.item())

            if phase == 'val' and epoch_acc > best_acc:
                best_acc = epoch_acc
                best_model_weights = copy.deepcopy(model.state_dict())
                torch.save(best_model_weights, os.path.join(save_dir, 'best_resnet_attention_model.pth'))

    time_elapsed = time.time() - since
    print(f'\n训练完成,耗时 {time_elapsed // 60:.0f}m {time_elapsed % 60:.0f}s')
    print(f'最佳验证集准确率: {best_acc:.4f}')

    model.load_state_dict(best_model_weights)
    return model, history


def evaluate_model(model, dataloader, criterion, device):
    model.eval()
    running_loss, running_corrects = 0.0, 0

    with torch.no_grad():
        for inputs, labels in dataloader:
            inputs, labels = inputs.to(device), labels.to(device)
            outputs = model(inputs)
            loss = criterion(outputs, labels)
            _, preds = torch.max(outputs, 1)
            running_loss += loss.item() * inputs.size(0)
            running_corrects += torch.sum(preds == labels.data)

    total_loss = running_loss / len(dataloader.dataset)
    total_acc = running_corrects.double() / len(dataloader.dataset)
    print(f'\n测试集评估结果: \n Loss: {total_loss:.4f} \n Accuracy: {total_acc:.4f}')


def plot_history(history, save_dir='models'):
    plt.figure(figsize=(12, 5))
    plt.subplot(1, 2, 1)
    plt.plot(history['train_acc'], label='Train Accuracy')
    plt.plot(history['val_acc'], label='Validation Accuracy')
    plt.title('Accuracy History')
    plt.xlabel('Epoch')
    plt.ylabel('Accuracy')
    plt.legend()

    plt.subplot(1, 2, 2)
    plt.plot(history['train_loss'], label='Train Loss')
    plt.plot(history['val_loss'], label='Validation Loss')
    plt.title('Loss History')
    plt.xlabel('Epoch')
    plt.ylabel('Loss')
    plt.legend()

    plt.tight_layout()
    plt.savefig(os.path.join(save_dir, 'resnet_attention_training_history.png'))
    plt.show()


# ======================================================================
# 6. 预测结果可视化模块
# ======================================================================
def visualize_predictions(model, dataloader, class_names, device, num_images=16):
    """
    可视化模型在测试集上的预测结果
    """
    model.eval()

    # 获取一个批次的数据
    dataiter = iter(dataloader)
    images, labels = next(dataiter)

    # 如果批次大小小于num_images,则使用批次大小
    if len(images) < num_images:
        num_images = len(images)

    # 随机选择一些图像
    indices = random.sample(range(len(images)), num_images)
    selected_images = images[indices]
    selected_labels = labels[indices]

    # 将图像转移到设备并进行预测
    selected_images = selected_images.to(device)
    outputs = model(selected_images)
    _, preds = torch.max(outputs, 1)

    # 将图像转移到CPU并反归一化
    selected_images = selected_images.cpu()

    # 反归一化函数
    def denormalize(tensor):
        mean = torch.tensor([0.485, 0.456, 0.406]).view(3, 1, 1)
        std = torch.tensor([0.229, 0.224, 0.225]).view(3, 1, 1)
        return tensor * std + mean

    # 创建图像网格
    fig = plt.figure(figsize=(12, 12))

    for i in range(num_images):
        ax = fig.add_subplot(4, 4, i+1, xticks=[], yticks=[])

        # 反归一化并显示图像
        img = denormalize(selected_images[i])
        img = img.numpy().transpose((1, 2, 0))
        img = np.clip(img, 0, 1)
        ax.imshow(img)

        # 设置标题,正确预测为绿色,错误预测为红色
        true_label = class_names[selected_labels[i]]
        pred_label = class_names[preds[i]]

        color = 'green' if preds[i] == selected_labels[i] else 'red'
        ax.set_title(f'True: {true_label}\nPred: {pred_label}', color=color)

    plt.tight_layout()
    plt.savefig('test_predictions.png')
    plt.show()

    # 计算并显示这个批次的准确率
    correct = (preds.cpu() == selected_labels).sum().item()
    accuracy = correct / num_images
    print(f'\n随机抽样 {num_images} 个测试样本的准确率: {accuracy:.2f}')


# ======================================================================
# 7. 主执行模块
# ======================================================================
def main():
    # 设置随机种子以确保可重复性
    torch.manual_seed(42)
    torch.cuda.manual_seed(42)
    torch.cuda.manual_seed_all(42)
    np.random.seed(42)
    random.seed(42)
    torch.backends.cudnn.deterministic = True
    torch.backends.cudnn.benchmark = False

    # --- 参数配置 ---
    DATA_DIR = r'D:\software\data\archive\raw-img'  # 数据集路径
    MODEL_PATH = None  # 设置为None表示从头训练,或提供已训练模型的路径

    if not os.path.exists(DATA_DIR):
        print(f"错误:数据集目录 '{DATA_DIR}' 不存在。")
        return

    NUM_EPOCHS = 5
    BATCH_SIZE = 16
    LEARNING_RATE = 0.0001
    SAVE_DIR = 'models_resnet_attention'

    # --- 设备配置 ---
    DEVICE = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
    print(f"使用设备: {DEVICE}")

    # --- 数据加载 ---
    try:
        dataloaders, dataset_sizes, class_names = get_dataloaders(DATA_DIR, batch_size=BATCH_SIZE)
        num_classes = len(class_names)
        print(f"筛选后的 {num_classes} 个类别: {', '.join(class_names)}")
        print(f"数据集大小: 训练集={dataset_sizes['train']}, 验证集={dataset_sizes['val']}, 测试集={dataset_sizes['test']}")
    except Exception as e:
        print(f"数据加载错误: {e}")
        return

    # --- 模型、损失函数和优化器 ---
    model = get_model(num_classes=num_classes, model_path=MODEL_PATH).to(DEVICE)
    optimizer = optim.Adam(model.parameters(), lr=LEARNING_RATE)
    criterion = nn.CrossEntropyLoss()

    # --- 模型训练 ---
    try:
        trained_model, history = train_model(
            model, dataloaders, dataset_sizes, criterion, optimizer, DEVICE,
            num_epochs=NUM_EPOCHS, save_dir=SAVE_DIR
        )
    except Exception as e:
        print(f"训练错误: {e}")
        return

    # --- 模型评估 ---
    print("\n在测试集上进行最终评估...")
    try:
        evaluate_model(trained_model, dataloaders['test'], criterion, DEVICE)
    except Exception as e:
        print(f"评估错误: {e}")

    # --- 可视化预测结果 ---
    print("\n可视化测试集随机抽样预测结果...")
    try:
        visualize_predictions(trained_model, dataloaders['test'], class_names, DEVICE, num_images=16)
    except Exception as e:
        print(f"可视化错误: {e}")

    # --- 绘制训练历史 ---
    try:
        plot_history(history, save_dir=SAVE_DIR)
    except Exception as e:
        print(f"绘图错误: {e}")


if __name__ == '__main__':
    main()
3.4 补充实验四:迁移实验
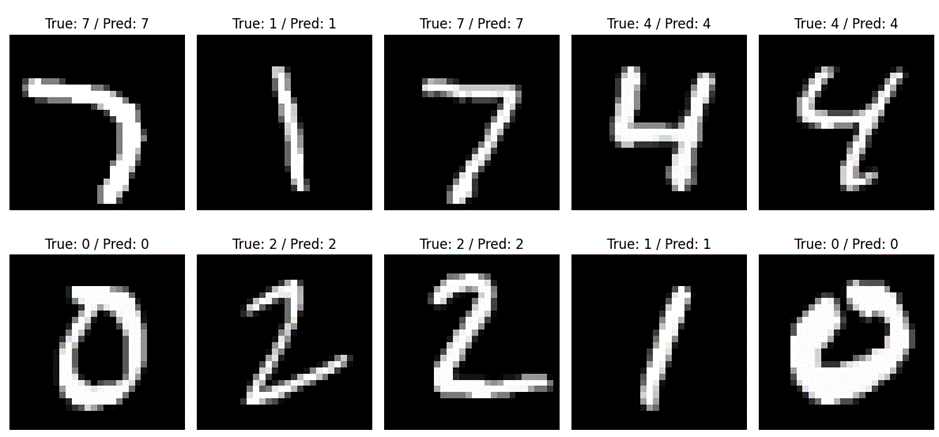
3.4.1 迁移到MNIST手写数字识别
数据集加载:使用torchvision提供的MNIST数据集类,简化数据集加载和预处理过程。
python
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.1307,), (0.3081,))
])
train_dataset = datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = datasets.MNIST(root='./data', train=False, download=True, transform=transform)
3.4.2 模型迁移与调整
模型调整:将之前训练的模型结构稍作调整,以适应MNIST数据集的输入尺寸和类别数。通过迁移学习,快速适应新的图像分类任务。
4. 结论
本文通过一系列实验,系统探讨了深度学习在数字图像分类中的应用。实验结果表明,卷积神经网络(CNN)结合注意力机制在图像分类任务中表现出色,具有较高的准确率和鲁棒性。同时,数据增强技术有效提高了模型的泛化能力。未来工作将进一步探索更复杂的模型结构和数据增强方法,以提升图像分类的性能。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 49
 0
- 0


 已为社区贡献1条内容

所有评论(0)