基于边缘计算的安卓克隆检测
基于物联网边缘计算的安卓市场克隆诈骗者检测
摘要
盗版应用程序开发者找到了一种替代方法,可在不同的安卓应用市场发布相同安卓移动应用程序(app)的盗版版本。因此,为了防止这些安卓应用程序的盗版或克隆版本被发布,在多个应用商店之间建立一个集中式自动化审查系统是不可避免的。在本文中,我们提出了一种面向物联网(IoT)设备的安卓克隆检测系统(Droid‐IoT)。首先,该系统通过云网络接收原始安卓应用程序包(APK)文件以及可能的候选克隆APK文件。系统使用 apkExtractor工具提取每个目标程序的Dalvik可执行(DEX)文件。然后利用Jdex反编译器从DEX文件中提取Java源文件。接着采用词袋模型从源文件中提取分词特征。此外,使用权重过滤器来放大每个词项的重要性。同时,应用合成少数类过采样以获取平衡特征,从而更好地进行数据训练。最后,设计基于TensorFlow的Keras深度学习模型来预测Android应用程序中的克隆。实验结果表明,Droid‐IoT能够成功检测克隆应用,准确率高达 96%。该系统的主要目的是防止盗版应用在不同应用商店以不同盗版名称发布。
1 引言
边缘计算已成为一个新兴的研究领域,可在物联网(IoT)网络上提供低处理能力和更高的资源容量。它还被认为能够减轻数据中心的负载,并支持人工智能服务。因此,边缘计算与物联网领域的应用是开启智能家居、智能医院、智慧城市、智能车辆和智能可穿戴设备等新机遇的关键技术方向。1-3
过去几年,手机销量大幅增长。安卓占据了新智能手机市场份额,其手机销量最近达到了每日85万次激活。尽管安卓操作系统提供了手机的主要使用体验,但用户在很大程度上依赖第三方应用程序来获得完整的客户端体验。安卓拥有多个应用市场,用户可以在其中下载第三方应用程序,以方便地访问社交网络和游戏。有必要保护用户免受那些企图从合法开发者辛勤劳动中获利的诈骗者的侵害。Android应用程序可以发布在官方安卓市场或其他第三方市场上。4,5
 )
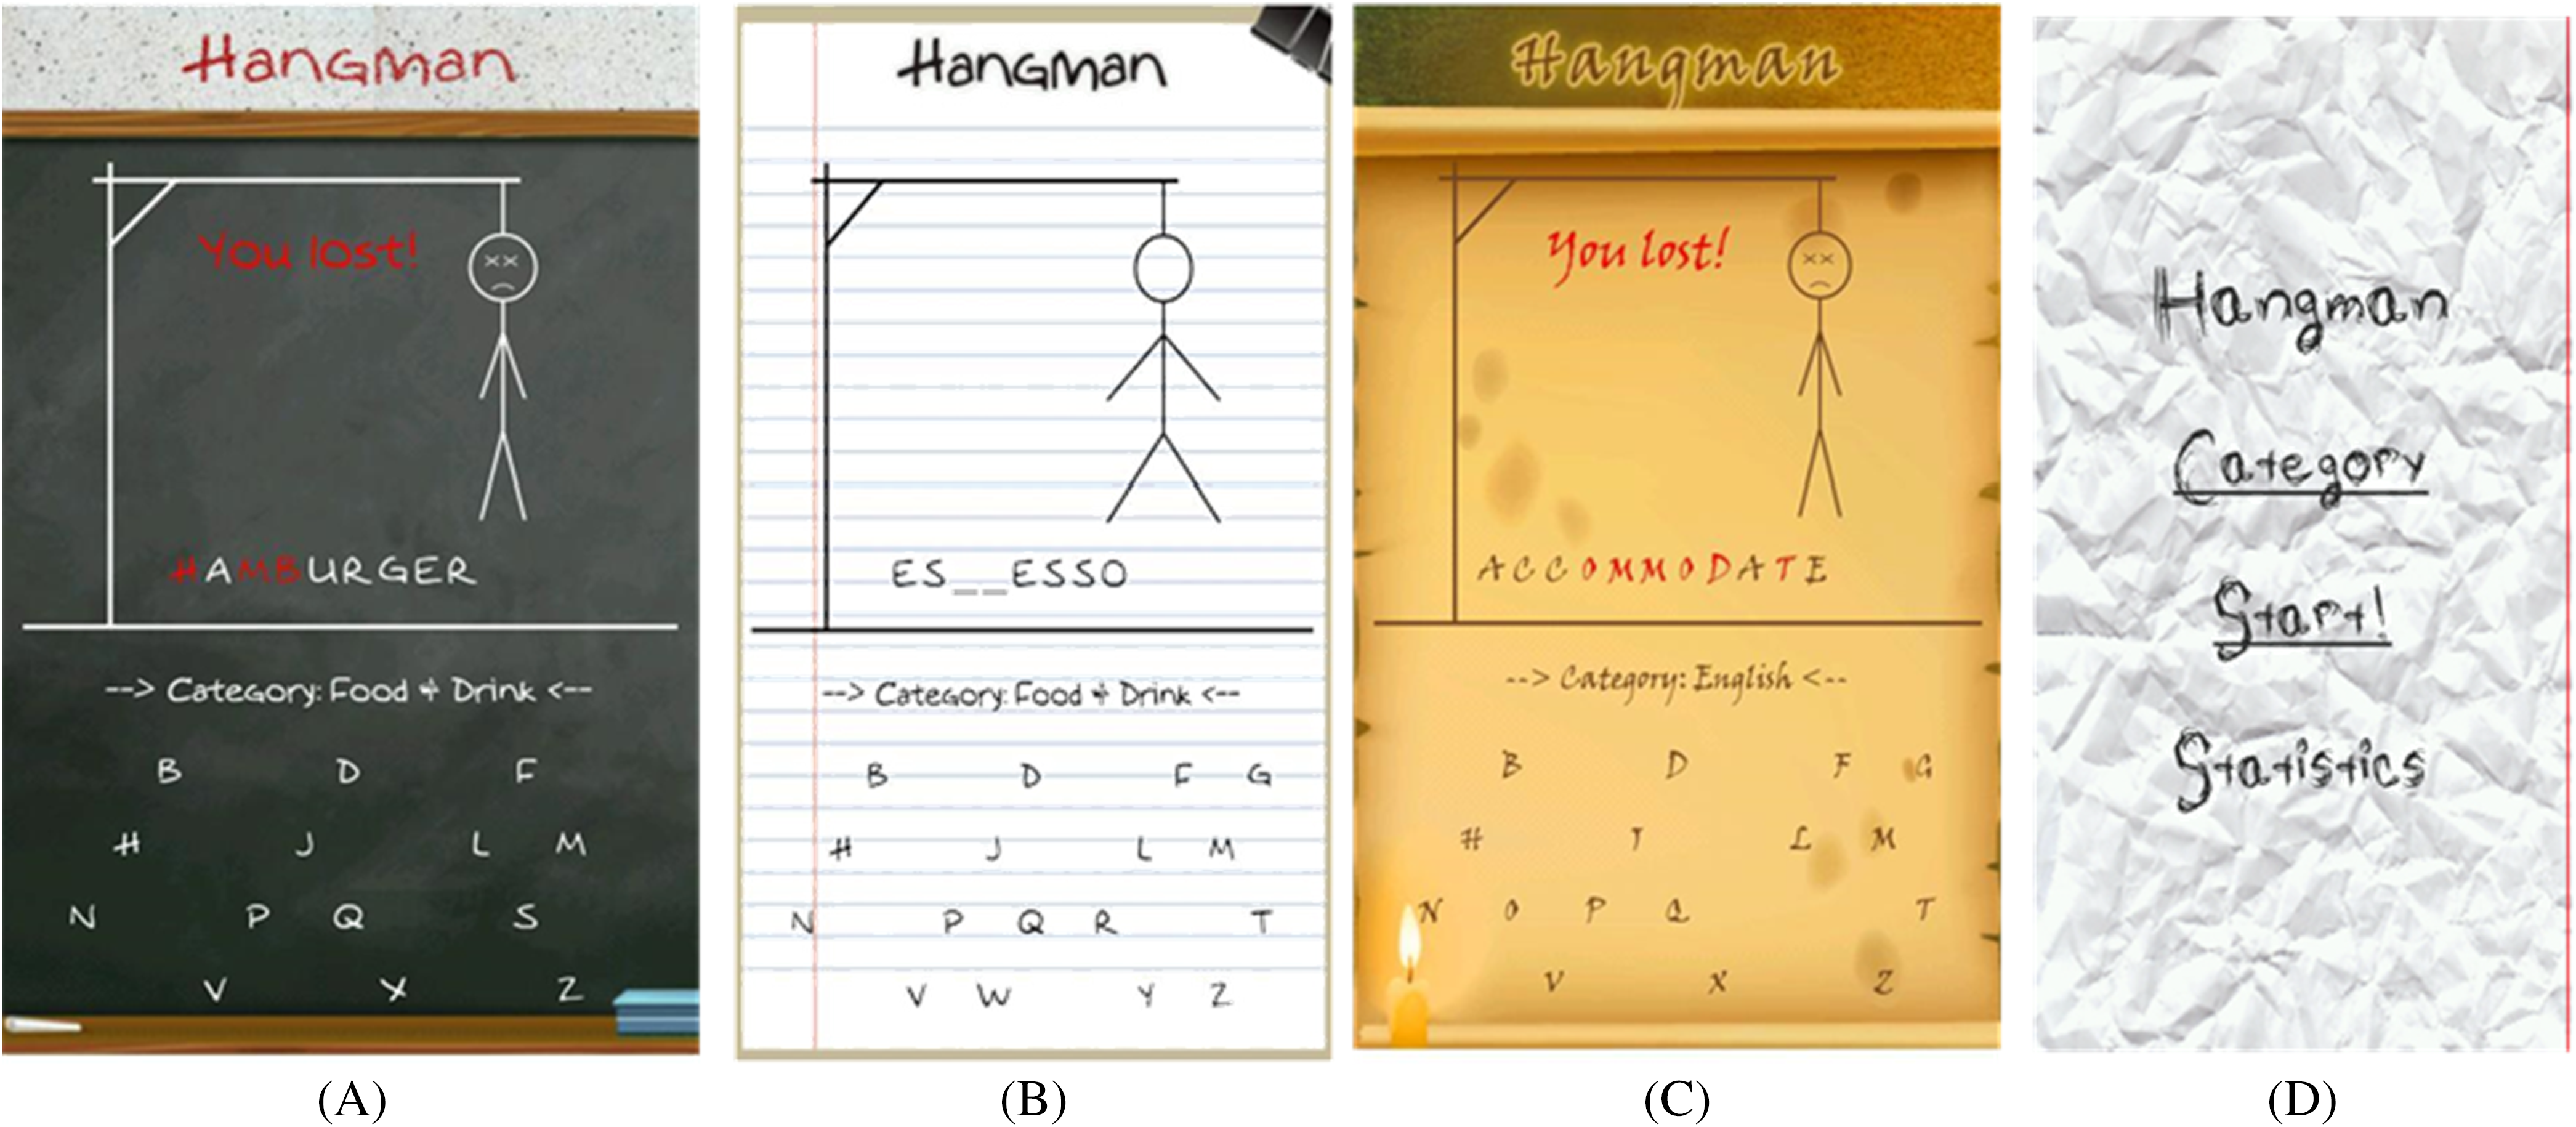
为了持续开发应用程序,必须为开发者提供一个健康的市场环境。付费应用可能被破解后发布,免费应用可能被克隆并重新发布,导致广告收入流向诈骗者。诈骗者可以修改现有应用的库文件,替换开发者的客户端ID,并插入可带来收益的新库。开源Android市场使得诈骗者能够克隆应用程序并将其重新提交至各大市场。与Android手机市场相比,应用程序在苹果App Store上架前必须通过审核流程。近期,安卓市场已增加了一项扫描新应用程序的服务。开发者和学术界已指出Android应用克隆†问题
图1显示,有四个应用程序在用户界面和代码方面相似,但它们由不同的开发者发布到不同的移动市场中。结果表明,所有应用程序的源代码相互重叠,这意味着其中至少有三个是克隆应用。由于Android应用程序的普及,应用程序数量迅速增长。6开发者只需支付25美元费用并提供电子邮件,即可将应用程序发布到SlideMe‡和 GoApk§等安卓应用市场。与苹果App Store不同,在安卓应用市场中克隆、修改和重新分发应用程序非常容易。因此,保护开发者的知识产权和收入流至关重要。7,8,*
安卓应用程序以包的形式分发,这些包包含图像和XML文件。XML清单文件指定了应用程序的多个特征,例如其名称、版本、代码命名空间以及执行权限。Android应用程序主要使用Java源代码开发。Java源代码被编译为字节码,然后转换为Dalvik可执行文件(DEX)。DEX字节码通常在Dalvik虚拟机上运行。Java字节码通过多种第三方逆向工程工具被转换为DEX字节码。提出的工作旨在回答以下问题:
研究问题1.
提出的方法在不同安卓应用市场的克隆检测中表现如何?
研究问题2.
基于深度学习的分类在大规模安卓克隆应用检测中的有效性如何?
当前研究的重点是提出一种鲁棒技术,用于检测不同安卓应用市场中的Android应用程序克隆。我们开发了一种技术,通过边缘计算与物联网的融合技术来调查多个Android商店中安卓应用程序的克隆。本文的贡献如下:
- 为避免多个安卓应用市场中的克隆诈骗者,我们提出了一种面向物联网的Android克隆检测系统(Droid‐IoT)。
- 提出了一种优化的深度学习方法,以大规模处理克隆检测问题。设计了分词和加权特征,以在无噪声数据的情况下提取有意义的模式。
- 我们在训练阶段使用合成少数类过采样(SMOTE)技术来处理不平衡数据问题。
- 实验结果表明,所提出的技术可将ESL文件下载器在400个文件情况下的检测准确率提高至90%。
本文其余部分安排如下:第2节进行文献综述;第3节描述所提出的方法;第4节解释结果并进行讨论;第5节对全文进行总结。
2 文献综述
我们描述了多种静态检测克隆代码方法的优缺点,并提出了建议的方法。例如,基于特征的方法会分析程序并提取一组功能,然后通过比较两个应用程序的功能来进行克隆检测。这些功能的差异取决于程序中的多个类、方法、变量和循环。该方法存在局限性,可能缺乏有关程序结构的有用信息。由于误报率较高,基于特征的方法具有很高的脆弱性。
基于结构的方法首先将程序分词为流,然后比较两个应用程序之间的流。它将程序转换为词元流,并忽略其注释、空白字符和变量名称。与基于特征的方法相比,该方法能更可靠地检测克隆。DEX字节码流的比较可以快速找到完全复制的代码。然而,字节码流无法提供关于代码的语义层面信息。因此,该方法容易受到代码修改的影响。例如,Winnowing9尝试使用k‐gram(k元组)来发现带有更改的克隆。如果程序之间的差异较少,则比较会发现大量的相同长度为k的词元流。
如果程序中被复制的部分与其原始部分行为相同,则它们在输入和输出变量之间应具有相同的依赖关系。由于这些依赖关系即使在对复制的代码应用了显著伪装后也不会改变,因此基于程序依赖图(PDG)的克隆检测比基于结构的系统更 robust。如果程序中被复制部分的行为与原始部分相同,那么它必须具有相同的输入和输出变量之间的依赖关系。然而,与基于结构的方法相比,这些依赖关系即使在对克隆代码进行了重大修改后也不会改变。
最近,一些研究人员在其研究中应用基于结构的技术进行安卓代码克隆检测。例如,Androguard 支持普通压缩距离和 SHA256 哈希。DEXCD#首先对反编译的 APK 中的操作码进行分词,然后查找两个应用程序之间相似的操作码流。DroidMOSS12首先计算 APK 文件中每个方法的模糊哈希,然后将它们组合起来比较 APK 的模糊哈希,以基于特定方法哈希检测相似性。他们的工作可能容易受到规避技术的影响。ComDroid13使用静态分析检测应用间通信漏洞。PiOS14使用二进制静态分析检测 iOS 应用程序中的隐私泄露。动态分析也可以通过监控正在运行的应用程序来执行。例如,TaintDroid15,16在安卓上对敏感数据的使用应用了动态污点追踪和分析。TaintDroid 标记的数据来自污点源。如果不可信的应用程序使用了这些数据,则 TaintDroid 将其报告为数据泄露。王等人17提出了一种两阶段克隆检测方法用于识别可疑文件。该方法在第一阶段用于比较基于语义的加权静态特征,然后在第二阶段使用已检测到的文件来比较详细特征。此外,他们使用自动聚类预处理方法对聚类的克隆应用程序进行分组。
克鲁塞尔等人18提出了一种方法,即 AnDrawn,基于两个用例来检测来自不同开发者的相似克隆。所设计的算法在语料库中预测出 88 个恶意文件。该方法用于预测应用程序簇中包含的相似源代码。在李等人19的研究中,基于所提出的算法针对第三方软件。该方法基于哈希和 LibD 算法,并在一个大型数据集上进行了评估。该方法用于检测 Android 应用程序中源代码的内部依赖,这些特征进一步用于分类第三方库。实验值表明,LibD 可能能够处理多包第三方软件。用户界面分析用于在安卓市场中识别克隆。20该界面通过执行应用程序在动态环境中收集用户信息。从用户处收集不同的输入信息很容易
在全球范围内。其次,它主要针对语义信息和不影响实时行为的混淆方法。所设计的方法在真实世界的数据集上产生了较低的误报和漏报值。
上述研究人员在其克隆检测工作中未使用任何语义信息。在结构化编程中,与程序依赖图(PDG)相比,分词更加稳健,且资源消耗更少、耗时更短。在我们的情况下,每个安卓应用都有数百个源文件,因此提取每个文件的 PDG成本较高。由于我们检测的是克隆片段,因此结构化分词更为有效。我们提出的工作主要针对提交至不同安卓应用商店的安卓克隆应用。每个克隆的代码结构被捕获,用于后续的数据处理。
3 面向物联网的安卓克隆检测(DROID‐IOT)系统
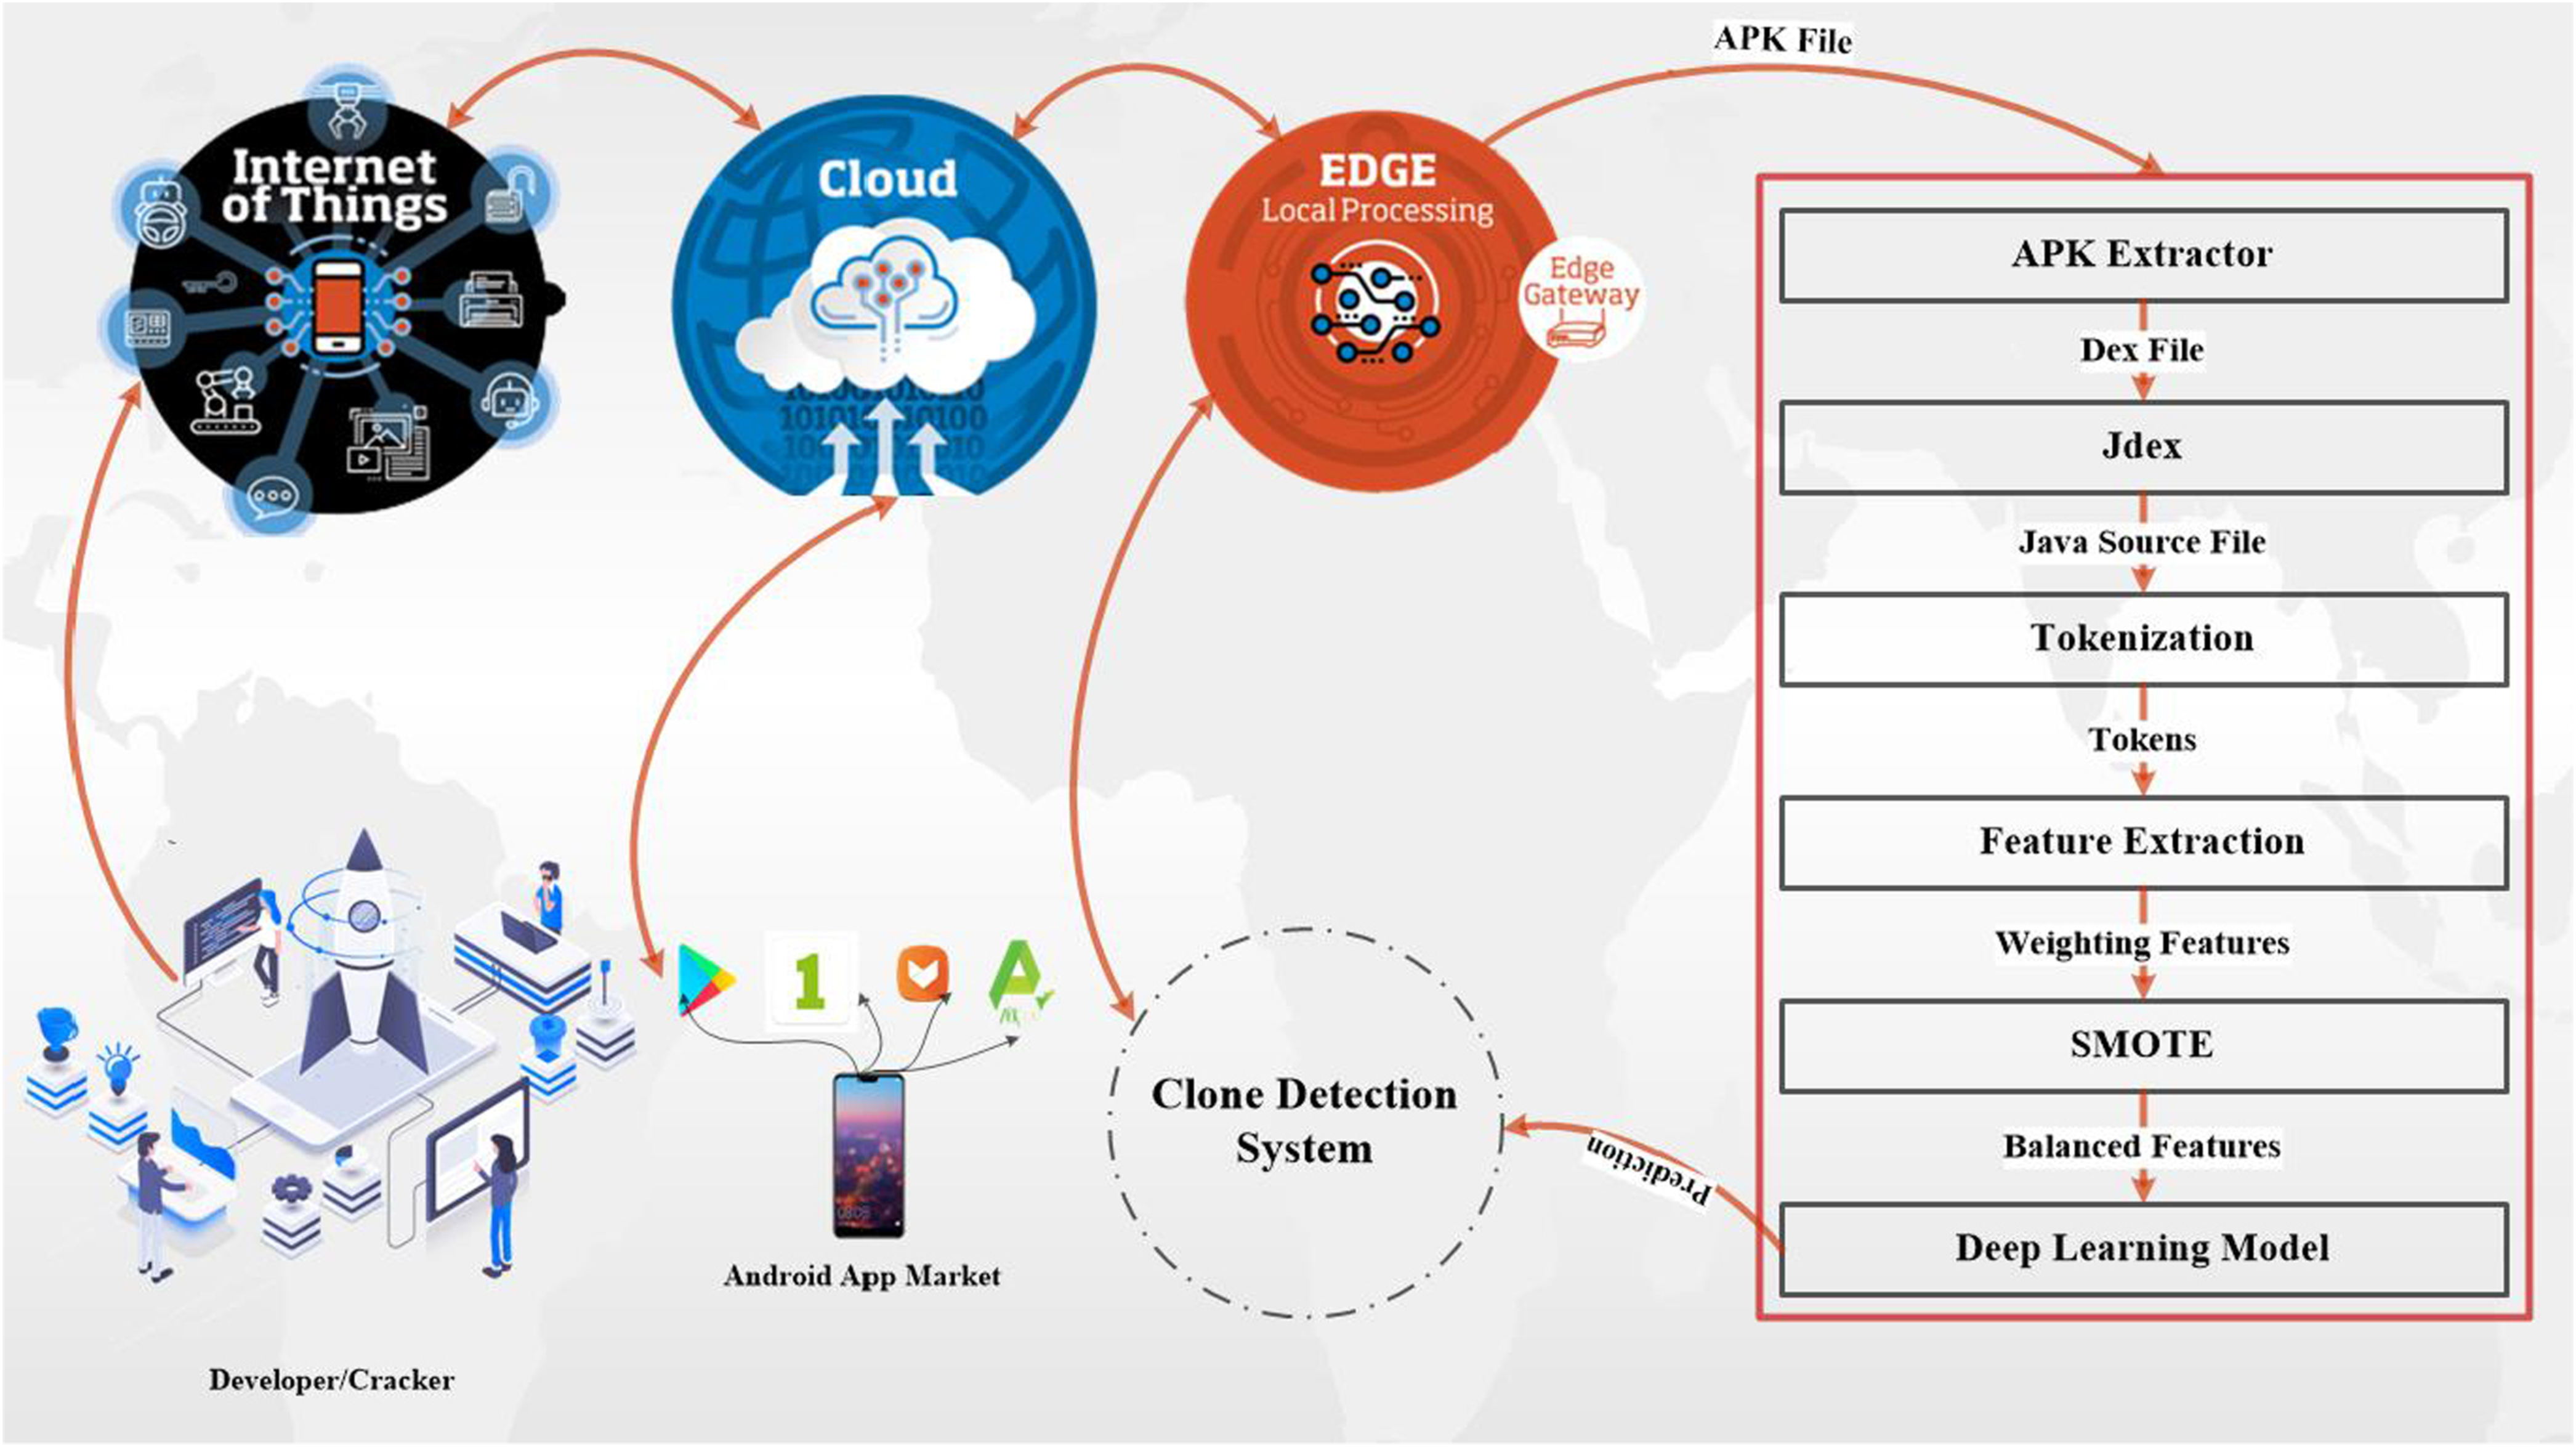
边缘计算是一种集中式技术,通过云计算向用户提供不同的服务。安卓应用商店是开放的市场,用户可以轻松上传和下载应用程序。目前各个安卓应用商店之间缺乏适当的检查机制来调查克隆应用。因此,需要一个集中的安卓应用检测系统,以在不同安卓商店中检测克隆应用。我们提出了Droid‐IoT系统,能够在克隆应用对安卓用户公开之前,捕捉提交至安卓商店的克隆应用。用户使用物联网设备上传或下载Android应用程序。这些设备通过云基础设施连接,而云基础设施进一步与安卓应用商店和边缘计算服务器相连。在此架构中,边缘计算服务器向安卓应用商店提供克隆检测服务,如图2所示。
3.1 应用提取器
用户使用物联网设备上传或下载安卓应用程序。这些设备通过云基础设施连接,而云基础设施进一步与安卓应用商店和边缘计算服务器相连。在此架构中,边缘计算服务器为安卓应用商店提供克隆检测服务,如图2所示。克隆检测系统被激活并选择可能的候选安卓应用程序。克隆检测模型实例启动后,系统调用“apkExtractor”从安卓应用程序中提取DEX文件。首先,应用商店通过云和边缘计算服务器的融合技术实现连接。诈骗者将一个APK文件上传至服务器,以在应用商店中发布。为了执行克隆
在对Android应用程序进行检测时,我们需要提取Java文件,以便分析相似程序源代码中的代码克隆。使用Jdex反编译器从APK中提取DEX文件。DEX文件是安卓平台的可执行文件,由已编译的Java文件组成。从DEX文件中获取已编译的文件后,再次使用Jdex反编译器将已编译的Java类反编译为原始源代码,这是数据基于词袋的预处理所必需的步骤。在从每个目标及其相应的克隆应用中提取源代码文件后,我们进一步使用词袋模型从各个源代码文件中提取有意义的词元。
3.2 特征加权
该数据集包含1000多个Java类,每个类根据每个Java源文件中的代码行数生成数百个词元。因此,采用其他预处理步骤,如词干提取、词根、最小和最大频次功能,用于加权、最小化并提取最有用的词元。加权技术基于每个词元在相似性度量方面的局部和全局重要性进行提取。这些分解后的功能详细说明了词元的重要性。我们分别使用对数词频(LogTF)和词频‐逆文档频率(TFIDF)22作为局部和全局加权特征。单个源代码文档中以及多个源代码文档之间的词元重要性分别称为局部加权和全局加权。词频解释了每个词元在其对应源代码文档中的出现次数。这些功能进一步有助于深度学习算法进行高效的分类。LogTF和TFIDF的数学形式如公式(1)、(2)和(3)所示。
$$
tf(t, d)= \log(1+ f_{t,d}), \quad (1)
$$
其中 $tf$ 表示词频,$t$ 代表术语,$d$ 代表文档,对数函数用于提取文档中每个标记的对数尺度值。此外,$tf$ 在公式 (2)中定义。
$$
tf(t, d)= \frac{f_{t,d}}{\max{f_{t’,d} \colon t’ \in d}}
\quad (2)
$$
$\max$ 定义了每个标记在源代码文档中的最大出现次数。逆文档频率(IDF)特征在数学上由公式 (3) 定义。
$$
idf= \log \left( \frac{N}{|{d \in D \colon t \in d}|} \right) \quad (3)
$$
其中,$idf$ 表示逆文档频率,$N$ 用于表示多个文档,$d$ 表示单个文档,$D$ 用于表示所有文档的语料库,$t$ 表示每个词元中的术语。词频‐逆文档频率(TFIDF)通过公式(4)进行数学表达。
$$
tfidf(t, d,D)= tf(t, d) \times idf(t,D) \quad (4)
$$
3.3 类别平衡器
少数类中的数据不平衡是一个严重影响Droid‐IoT系统预测准确率的问题。例如,在ES文件下载器中存在250个克隆文件,每个文件具有不同数量的源代码行。不同的源代码行会导致每个类生成不同数量的词元,从而引发类别不平衡问题。由于源代码行较少,少数类可能包含更少的词元。为解决此问题,我们使用SMOTE生成少数类的合成观测值,以解决类别不平衡问题。生成的SMOTE值随后作为输入提供给深度神经网络模型。在多分类问题中,采用分类交叉熵损失函数来预测相似克隆的准确率。SMOTE过采样分为以下三个步骤:
- 使用欧几里得距离测量每个少数类实例的k‐最近邻,使得 $x_i \in S_{min}$。
- 选择一个随机的k‐最近邻组 $x_i$,然后从每组中选择一个随机的k‐最近邻 $x_j$。
- 使用三个或五个邻居通过公式(5)生成一个新的样本。
$$
x_{new}= x_i + |x_i - x_j| \times \delta \quad (5)
$$
3.4 深度学习Keras模型
TensorFlow 是谷歌提供的开源深度学习框架,可以在本地机器、集群设备、云、边缘计算以及安卓设备上运行。由于大多数安卓设备都通过谷歌API连接并使用其服务,因此由TensorFlow生成的模型可以轻松部署到任何设备上,以提供相似克隆的预测。在我们提出的框架中,从原始应用中提取的功能被视为训练数据,而从诈骗者应用中提取的功能则被视为测试数据。如果检测到克隆应用,生成的报告将自动转发至所有连接到边缘计算服务器的安卓应用市场。这不仅有助于安卓应用市场防止克隆应用的发布,还能帮助其他安卓应用商店应对应用盗版问题。我们在TensorFlow框架中使用了序列模型来检测不同安卓应用商店中的相似克隆——Dropout层用于微调参数以解决过拟合问题。自适应矩估计(Adam)用于在动态曲线中的连续训练周期上计算当前和下一个梯度的平均动态执行。
选择精确率、召回率、F‐值和准确率作为性能评估指标。真正例(TPs)和假正例(FPs)的数量分别表示被分类为真和假的恶意软件样本数量。类似地,真反例(TNs)和假反例(FNs)的数量分别表示被分类为假和真的良性样本数量。分类性能通过准确率指标进行评估,准确率等于正确分类的实例数之和除以实例总数。评估指标如公式(6)、(7)、(8)和(9)所示。25,26
$$
Recall = \frac{TP}{TP + FN} \quad (6)
$$
$$
Precision = \frac{TP}{TP + FP} \quad (7)
$$
$$
Accuracy = \frac{TP + TN}{TP + TN + FP + FN} \quad (8)
$$
$$
F - measure = \frac{2 \times TP}{2TP + FP + FN} \quad (9)
$$
4 实验与讨论
4.1 数据集
该数据集基于五个主题提取,即ES文件下载器、猜词游戏、Hangman2、一键清理和Shadow-socks,以及从APK纯净版、谷歌商店、Mobile1市场、应用大脑,和Aptoide等安卓应用商店收集的相应克隆应用。最初,这些应用程序以.apk格式下载,这是一种用于在不同应用商店之间分发安卓应用程序的安卓安装包文件。数据集的详细信息见表 1,即Java文件数量、克隆文件数量、加权特征和平衡特征。
表1 五个Android应用程序的Java文件、克隆文件、权重和平 衡特征的数量
| 安卓应用 | 数字克隆的Java文件 | 权重功能 | 平衡功能 |
|---|---|---|---|
| ES文件下载器 | 400 | 250 | 2847 |
| 猜词游戏 | 46 | 43 | 285 |
| Hangman 2 | 84 | 57 | 588 |
| 一键清理 | 137 | 65 | 1027 |
| Shadowsocks | 350 | 235 | 2583 |
| 总计 | 1017 | 650 | 7330 |
4.2 结果分析
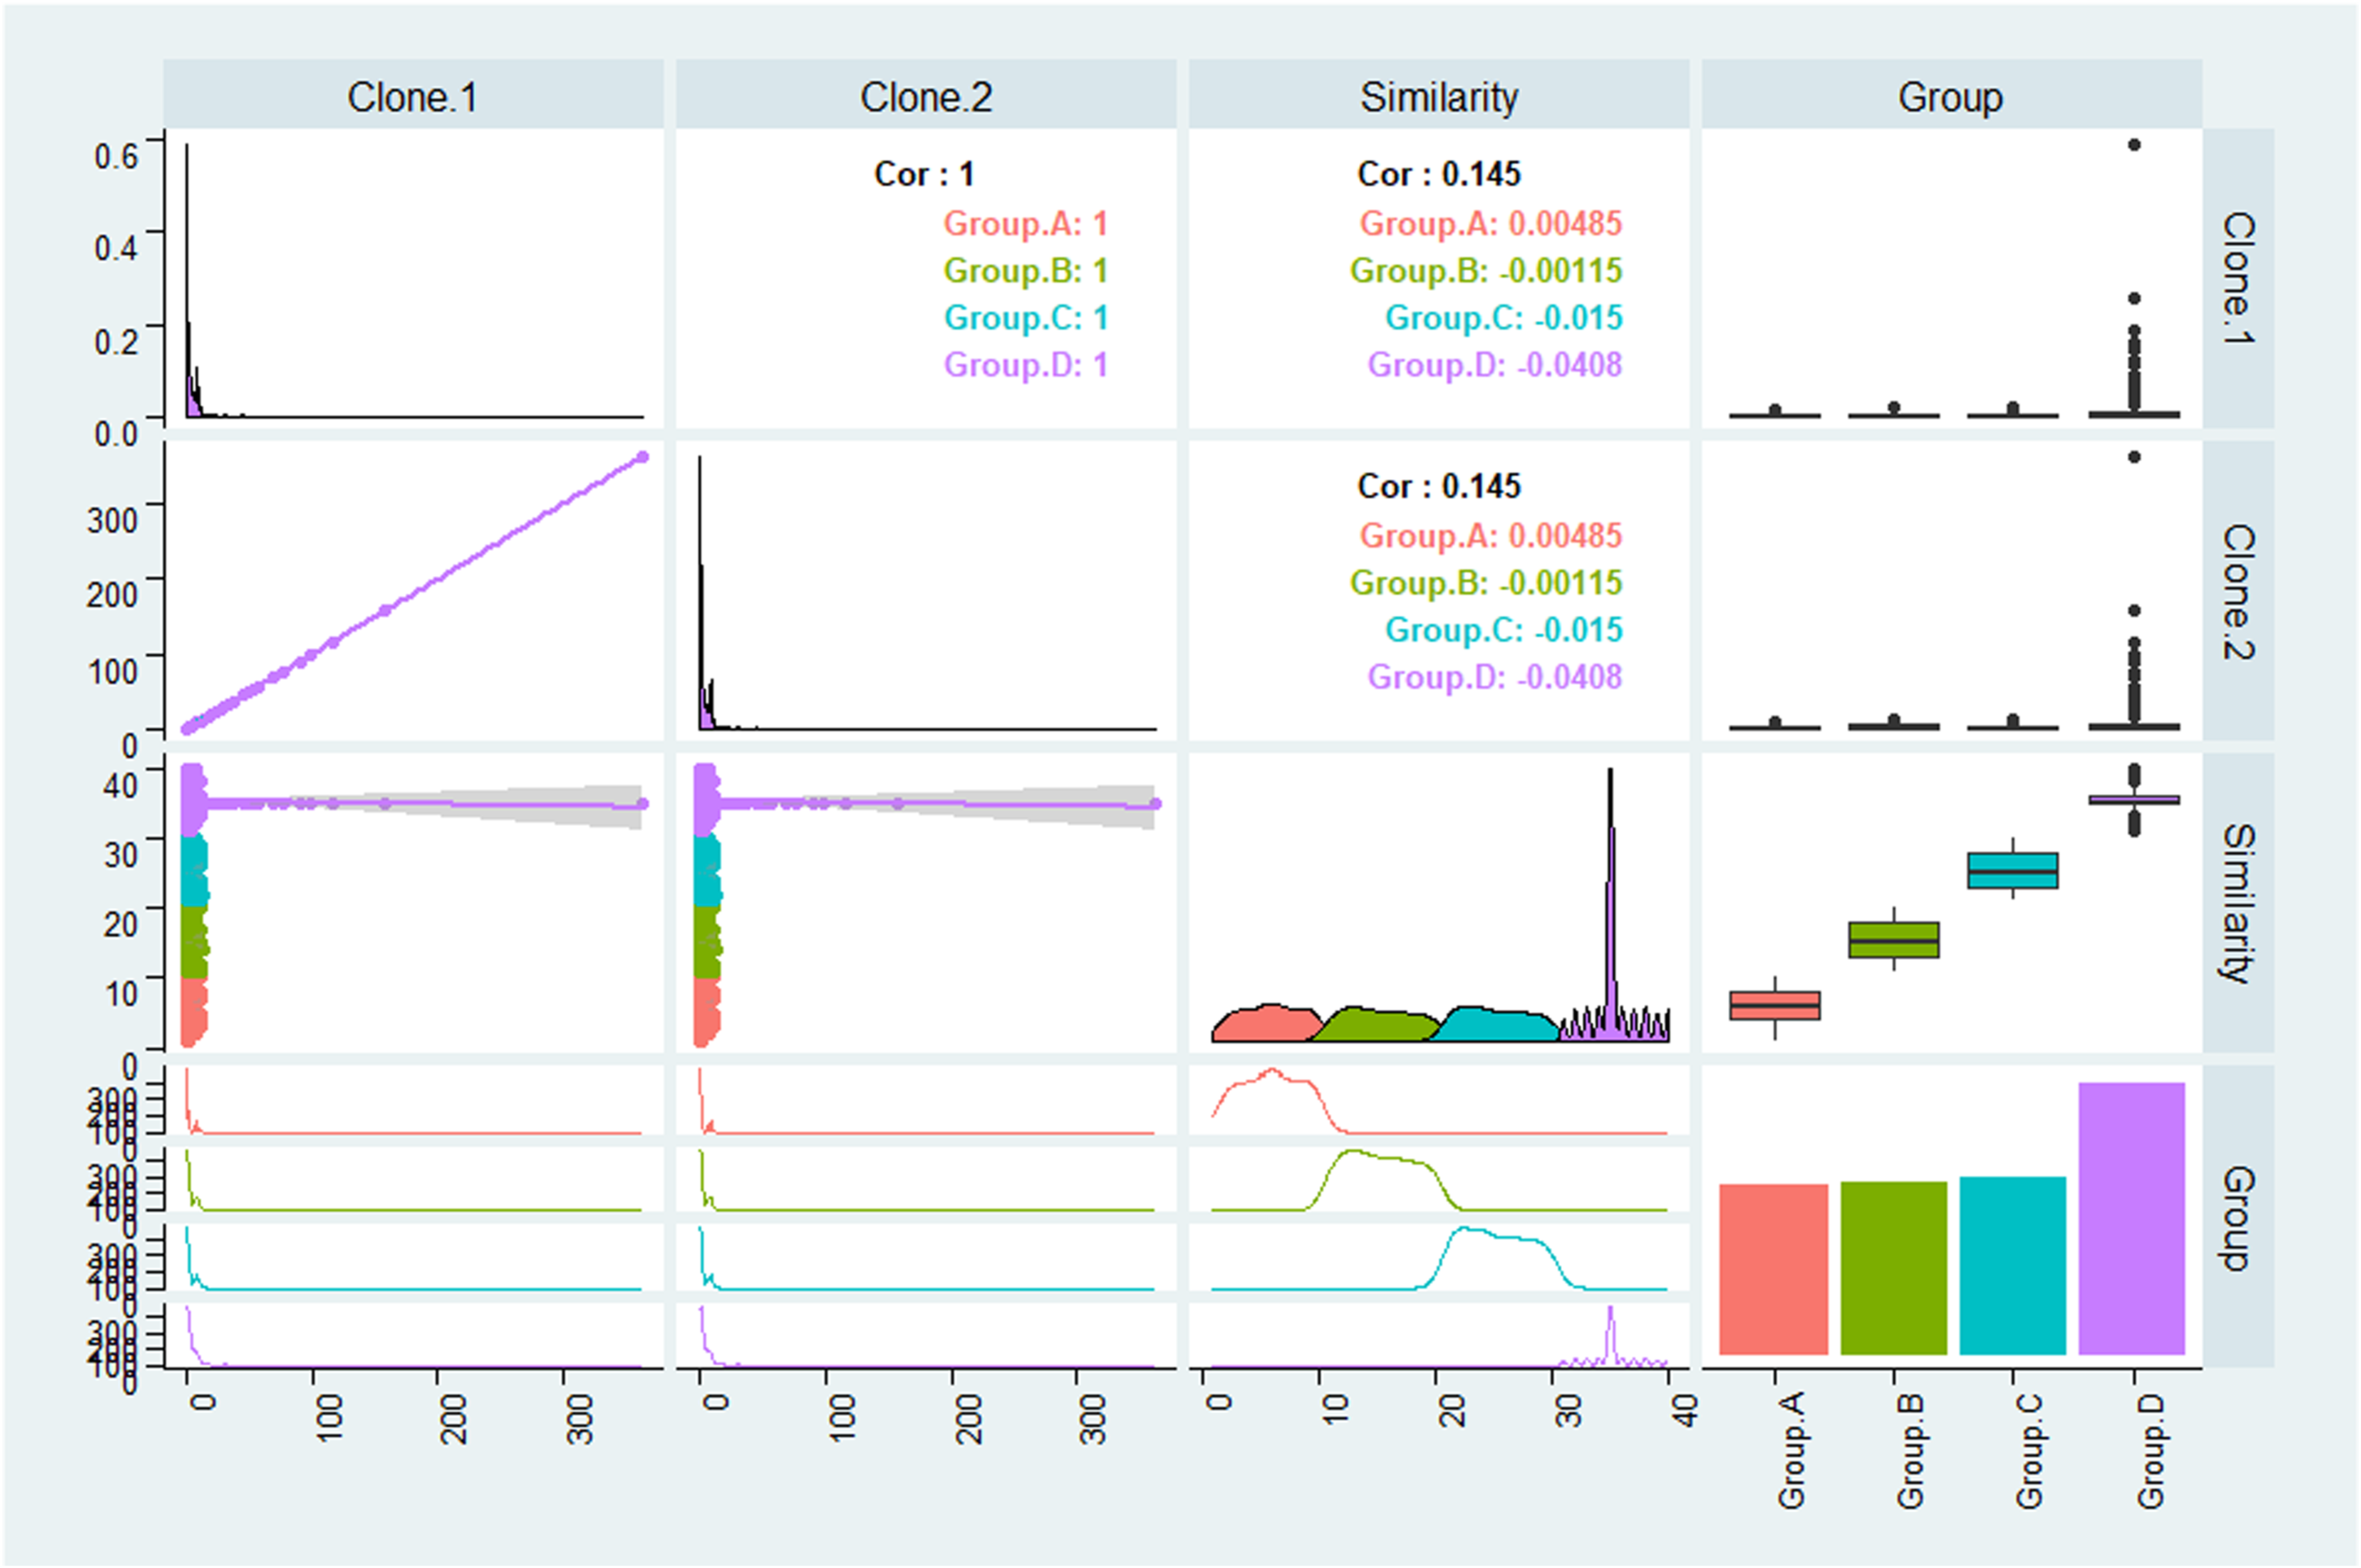
在多类别之间对数据点进行可视化,以识别相关性方面的相似性,如图3和图4所示。相关系数矩阵展示了多组变量或特征之间的相关系数。由于我们的数据包含数百个类别,因此我们将多个类别的集合视为一组。共展示了四组,以可视化多个数据点以及不同特征之间的相关性。相关性基于斯皮尔曼相关系数进行计算。斯皮尔曼相关系数用于衡量两个变量之间关联的强度和方向。
排序变量。27,28数据之间的相关性可作为选择分类算法的依据,具体取决于数据的形态。例如,如果数据没有良好的线性相关性,则使用线性回归训练数据模型不会产生良好的结果。如图3所示,通过预处理技术提取的加权特征存在不平衡现象。各特征之间的相关系数非常低。造成这一现象的一个可能原因是采用了词频的分词技术。由于不同Java源文件之间存在不一致性,代码行数较少的Java源文件可能包含的词元数量最少,从而导致了不平衡数据问题。我们采用SMOTE来平衡特征,因为每个目标应用的克隆文件数量不同,其中包含的词元数量也不同。SMOTE即合成少数类过采样技术,该技术通过最近邻方法生成少数类的合成样本,显著提高了少数类的准确率。29在使用SMOTE实例进行数据平衡后,图4展示了基于四组克隆的Java源文件的平衡特征之间的相关性。从图4可以看出,与图3中展示的特征相比,不同特征之间的相关系数明显增强,这表明在克隆应用的平衡数据集上分类器具有更好的可预测性。在相关性分析之后,我们从TensorFlow Keras API中选择了序列模式来预测克隆应用之间的相似性。目标应用的详细信息,包括所选原始和克隆源文件的数量以及加权和平衡特征,见表1。
平衡特征随后被用作深度神经网络的输入,以预测相似克隆。该深度学习模型的设计包含四个全连接层和三个 Dropout层,如表2所示。第一层用于获取来自五个主体Android应用程序的平衡克隆特征输入。Dropout层旨在最小化分类结果的过拟合。最后,密集层4用于目标变量,对Android应用程序的相似克隆进行分类。每个全连接层和Dropout层的参数规模及输出形状在表2中进行了说明。
表2 Dropout层、输入和输出全连接层及多个参数
| 层类型 | 输出形状 | 参数数量 |
|---|---|---|
| 全连接层1 | 200 | 2400 |
| Dropout层1 | 200 | 0 |
| 全连接层2 | 100 | 20100 |
| Dropout层2 | 100 | 0 |
| 密集层3 | 50 | 5050 |
| Dropout层3 | 50 | 0 |
| 密集层4 | 20 | 1020 |
深度学习模型在测试和训练数据上的准确率如图5所示。我们可视化了从0到1000个训练周期的分类结果准确率。蓝色曲线表示训练准确率,而橙色曲线表示克隆应用分类中的测试准确率。在图5A中,SMOTE(合成少数类过采样技术)的模型准确率介于0.50至0.70之间,且随着训练周期数量的增加,准确率逐渐提高。结果具有一致性,在200个训练周期或更大的情况下,准确率介于0.65至0.70之间,提升空间较小。相比之下,图5B展示了经过 SMOTE预处理后平衡数据上深度学习模型的准确率。所有训练周期下的分类整体准确率均高于0.55。然而,在 200个或更多训练周期后,模型性能逐渐提高,训练和测试模型的模型准确率分别达到0.90至0.96。图5A和图5B的结果表明,分类模型能够正确预测克隆应用,模型准确率最高可达0.70,而使用SMOTE数据平衡后获得了最高的准确率。
为了可视化训练和测试模型上的分类损失,图6展示了基于不平衡与平衡数据的准确率损失。图6A显示,分类模型在所有训练周期中的准确率损失介于0.60到0.75之间,而经过200个训练周期后,准确率损失逐渐下降至0.62。如图6B所示,使用SMOTE实例进行数据平衡后,准确率损失得到改善。在200个训练周期大小之后,准确率损失逐渐下降,训练和测试数据的模型损失分别处于0.40和0.2之间。实验结果表明,Droid‐IoT系统上的平衡数据不仅提高了分类模型的准确率,而且根据训练周期的大小将准确率损失降低至0.20。然而,从图5和图6中我们得出结论:大于200的训练周期在所提出的分类模型上表现更优,尽管模型准确率略有损失,但在克隆应用预测中的效率与有效性之间实现了良好的权衡。
最后,我们使用混淆矩阵来可视化基于三组克隆应用各自的Java源文件正确与错误分类的实例百分比。在图 7A中,混淆矩阵是在不平衡数据上生成的。结果清楚地显示,克隆集1的准确率仅为0.10,而克隆集3的准确率为 0.57。克隆集2达到最高的准确率,但也仅为0.60。图7B是在平衡使用SMOTE实例对数据进行处理,展示了在三个相似的克隆集上混淆矩阵的性能表现。克隆集1的准确率从0.10提高到1.00,而克隆集3的准确率也提升至1.00。相比之下,克隆集3的准确率相较于克隆集1和2提升不多,仅为 0.67。然而,对于平衡数据集上的三个克隆集整体性能,明显优于不平衡数据集。对比平衡与不平衡数据的结果表明,基于词频的分词方法可能会对克隆应用产生误分类,因为不同的Java源文件由于源代码行数不一致,生成的词元数量也不同。然而,所提出的深度学习模型、参数调优以及不平衡数据处理策略显著提升了分类结果,且分类误差损失较小。实际结果与预测结果分别以蓝色曲线和橙色曲线的形式在图8中展示。
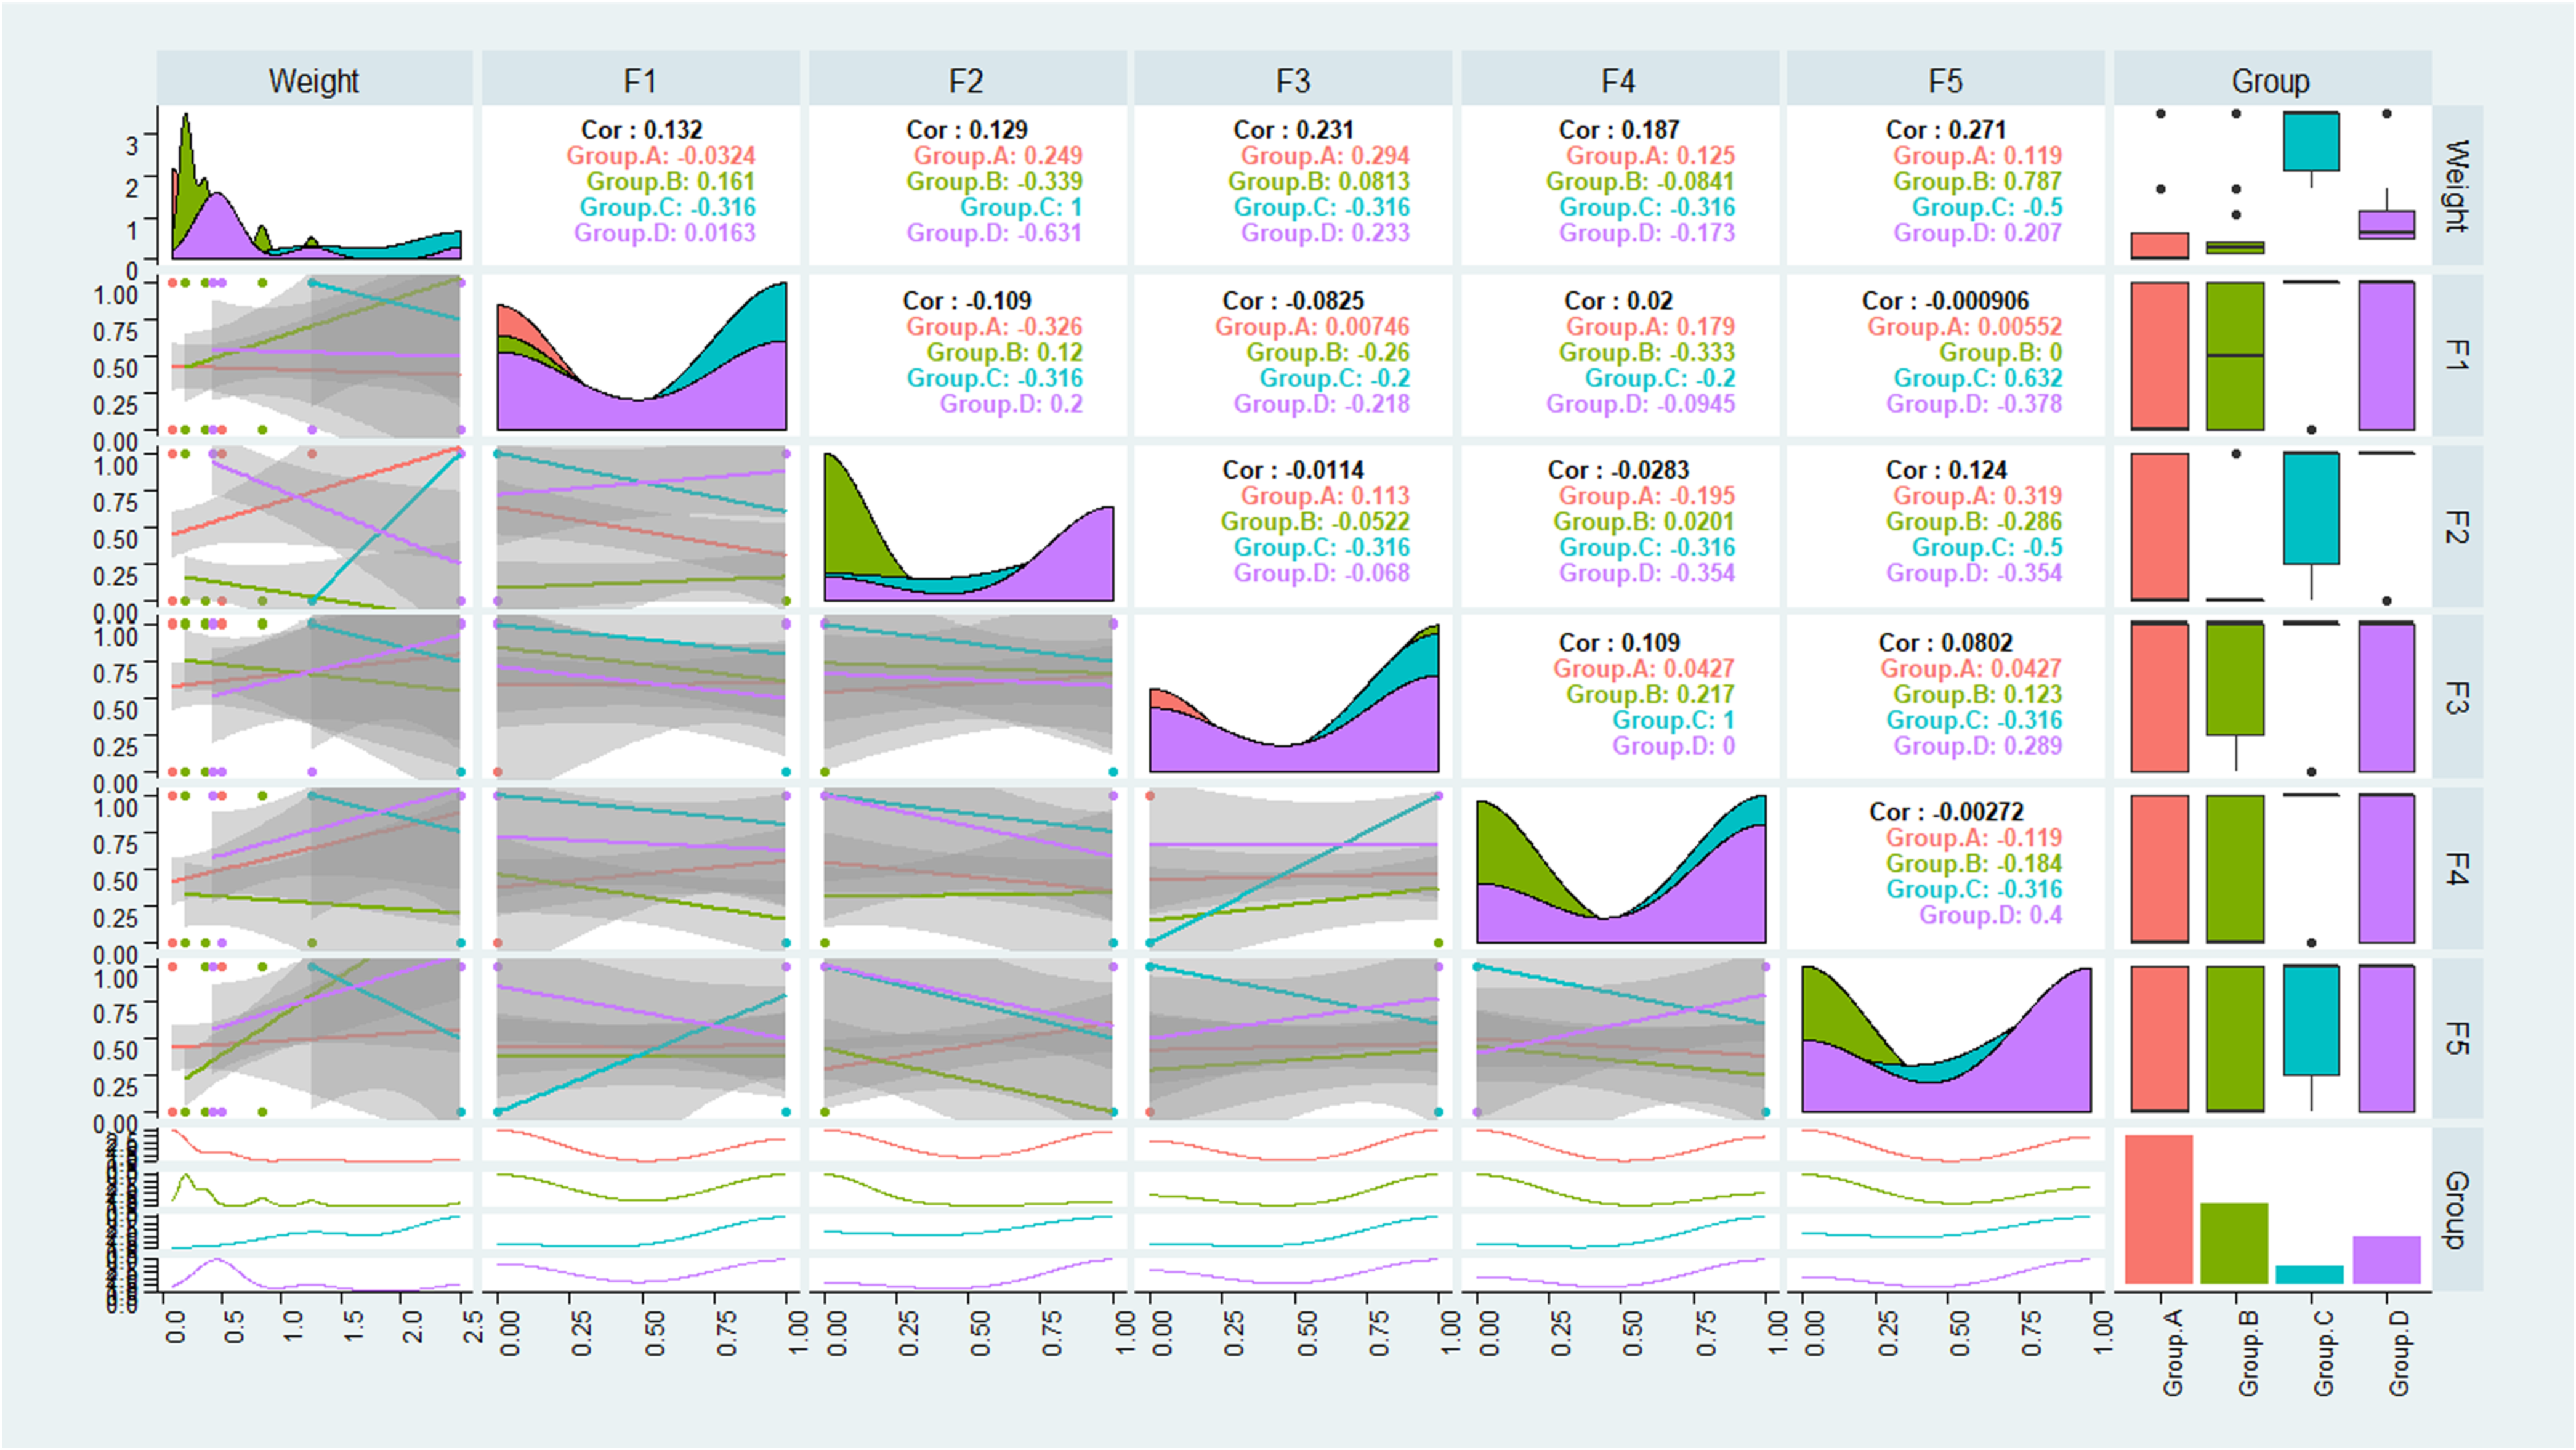
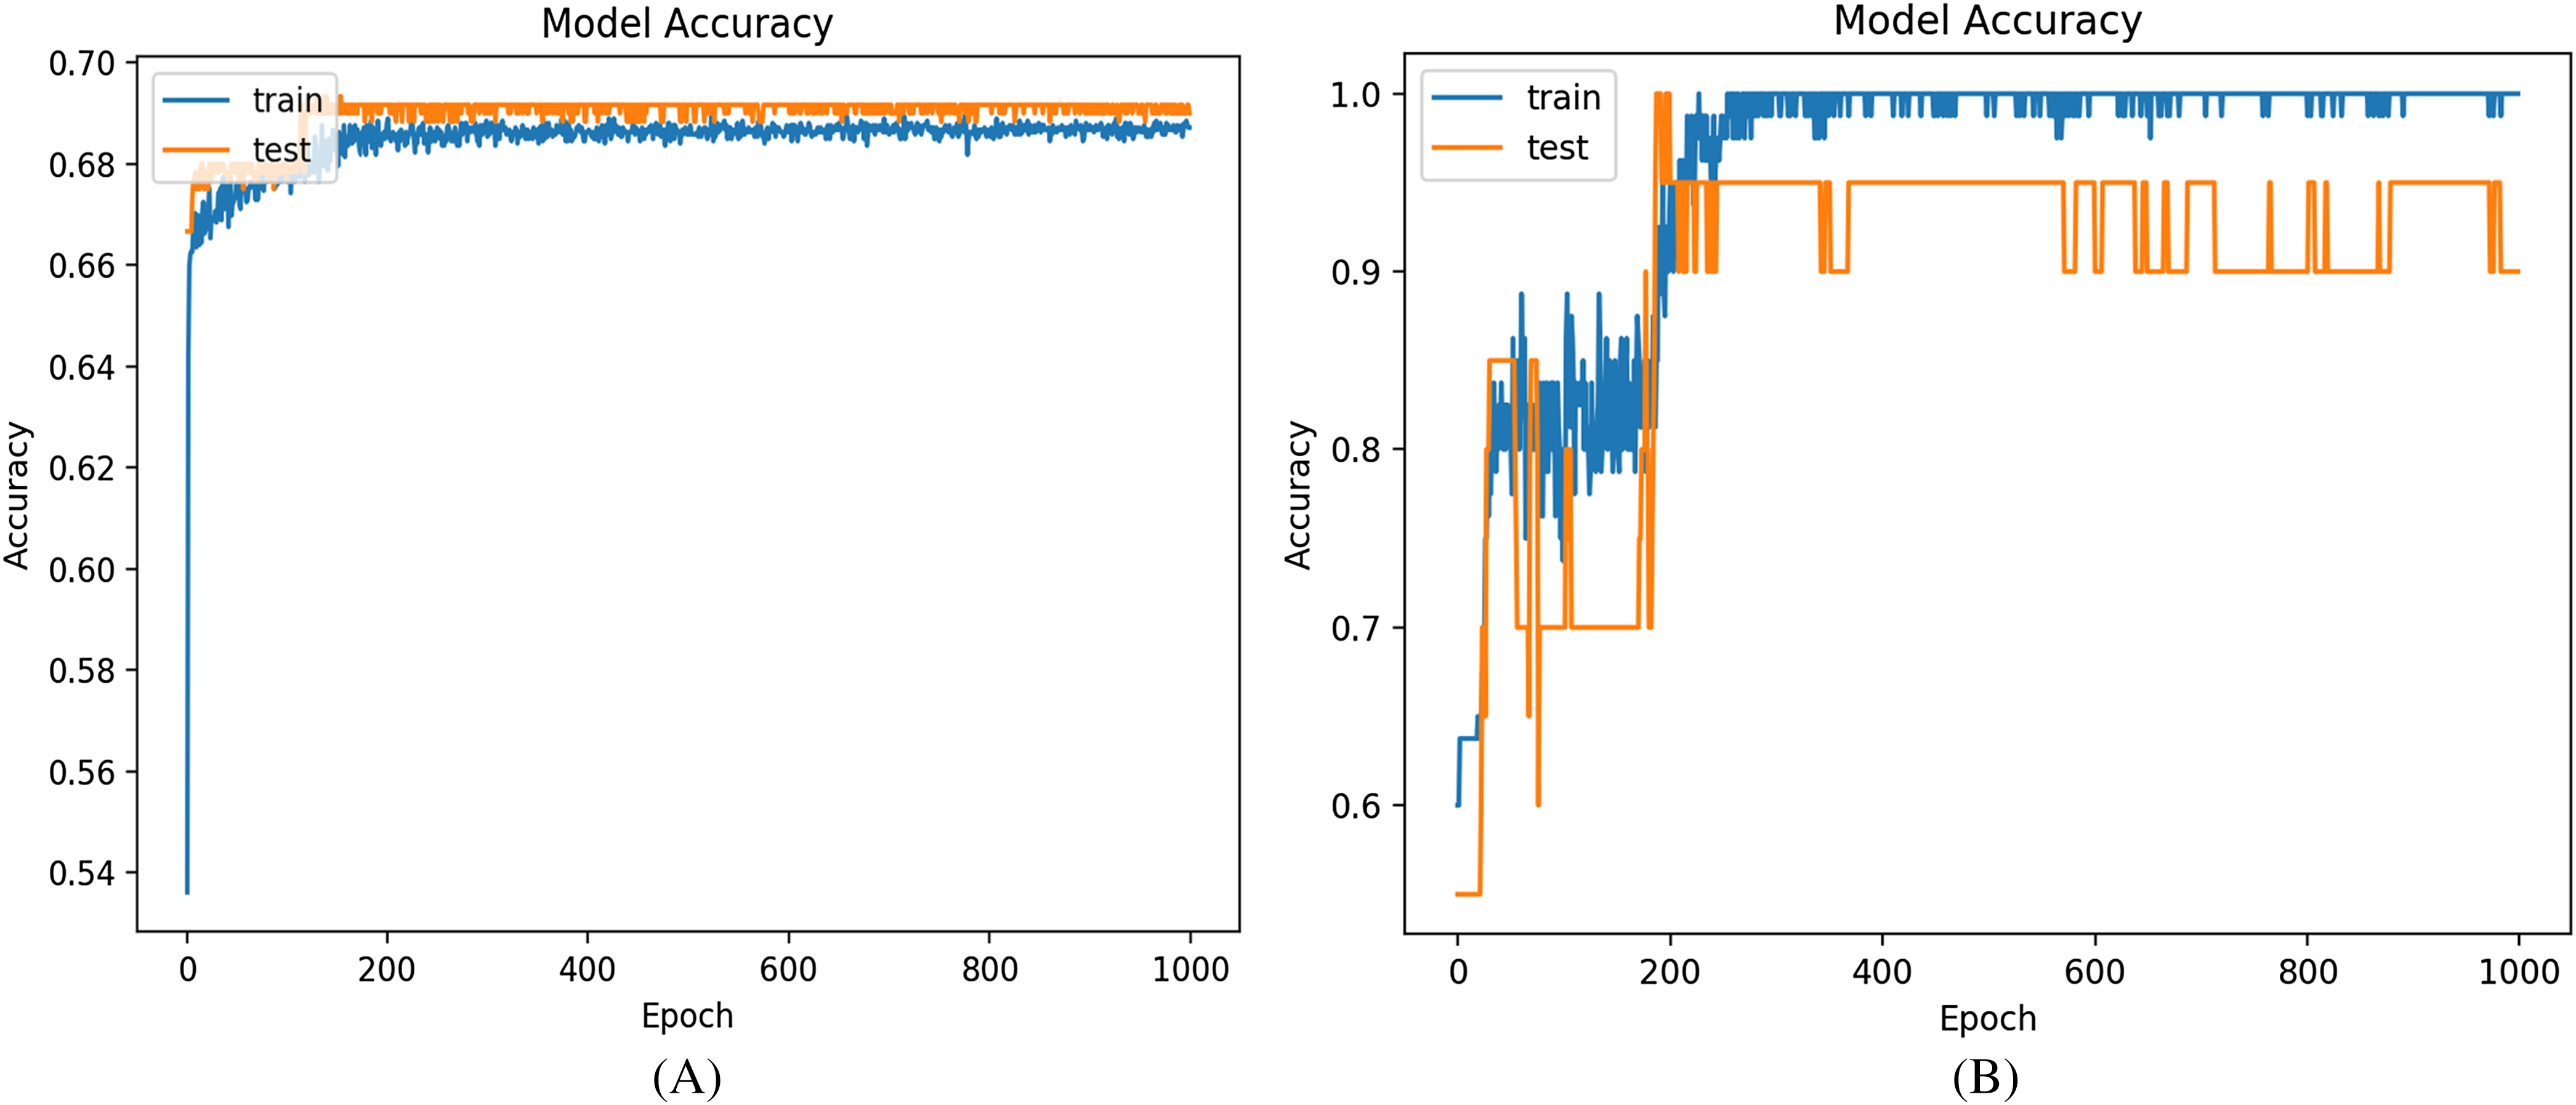
表3 五个克隆应用的精确率、召回率和F1分数值比较
| 安卓应用程序 | 精确率 | 召回率 | F1分数 |
|---|---|---|---|
| ES文件下载器 | 0.96 | 0.88 | 0.89 |
| 猜词游戏 | 0.94 | 0.86 | 0.89 |
| Hangman 2 | 0.91 | 0.88 | 0.86 |
| 一键清理 | 0.92 | 0.88 | 0.90 |
| 影子袜子 | 0.87 | 0.83 | 0.85 |
| 平均值 | 0.92 | 0.87 | 0.88 |
基于五个主题应用,在不同应用商店之间的平均精确率和召回率均大于0.85,而平均F1分数为0.88,显示出 Droid‐IoT系统的实用性。
4.3 对有效性的威胁
对有效性的威胁是指可能影响研究结论和讨论的因素。
我们使用基于分词的流程将源代码分解为频次,以进行克隆检测。分词对噪声敏感,即容易受到代码重排序、代码插入或删除、逻辑流等影响。因此,Droid‐IoT系统可能无法对这类克隆产生高效的结果。然而,我们的重点是那些内部逻辑相同但仅在输出视图上不同的应用,例如图1中所示,其颜色方案和文本格式不同,但内部类和工作方式相同。我们的检测系统能够有效处理这类在安卓应用市场中常见的克隆。
我们精心挑选并使用了五个主题来分析Droid‐IoT系统。如果将同一系统用于其他应用程序,则可能会产生不同的分类结果。为了降低这种威胁,我们针对不同的安卓应用商店使用了多种应用程序来调查提出的工作。因此,这种克隆检测方法有可能对任何安卓应用程序产生相同的结果。
5 CONCLUSION
软件盗版是影响安卓软件产业的重大威胁之一。根据Arxan安全公司发布的报告,仅在2014年就有97%的付费安卓应用程序被克隆。应用克隆是指由不同开发者名称在任意应用商店中创建相似应用的过程。为防止与盗版相关的问题,谷歌推出了应用许可服务,使开发者能够对其应用程序实施许可政策。边缘计算平台提供集中式数据存储,可用于向云计算系统存储、过滤、发送和接收数据。它可以连接物联网设备,以优化数据流量,并使用分析智能进行实时数据分析。安卓应用商店对物联网用户来说很容易访问,但没有任何检查点可以验证不同安卓应用商店之间应用程序的克隆特征。用户可以出于商业目的将克隆应用上传到任何安卓应用商店。这种行为可能给原始开发者造成巨大的经济损失。我们提出了可配置在边缘计算架构上的Droid‐IoT系统,以检测不同安卓应用商店中的相似克隆。
我们使用“apkExtractor”从可执行文件中提取源代码。采用分词方法对源代码进行预处理,以便高效使用。采用类别平衡方法解决训练样本不足的问题。调整深度学习方法以大规模预测重叠的安卓应用程序。我们通过五个案例研究评估了所提出的方案,每个案例包含不同数量的克隆文件。结果证实,所提出的研究在所有现有先进方法中表现更优,且误报率非常低。我们的研究结果表明,该提出的方法是一种有效捕捉不同安卓应用市场中克隆应用的手段。
我们使用分词方法来比较克隆检测中的词元到词元处理过程。我们计划通过使用控制流图(CFG)来捕获克隆程序的语义结构,以替代词元,从而优化克隆检测系统。CFG不仅能解决噪声代码问题,还能促进深度学习模型在分类中的应用。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 30
 0
- 0


 已为社区贡献1条内容

所有评论(0)