机器学习feature transform中的归一化
1. 归一化:核心思想:缩放至统一范围
归一化 是一种最常用的特征缩放方法。它的核心目标是:将数据特征(列)的数值范围缩放到一个指定的区间内,通常是 [0, 1] 或 [-1, 1]。
可以把它想象成:
计算示例:
假设一个特征列的数据为:[20, 30, 40, 50, 60]
对每个值进行归一化:
最终得到归一化后的数据:[0, 0.25, 0.5, 0.75, 1]
具体好处包括:
如果不做归一化,年收入这个特征由于其数值巨大,会在模型中占据主导地位,而年龄的影响则微乎其微。这会导致模型不合理地偏向数值范围大的特征。
归一化后,两个特征都被压缩到 [0, 1] 的范围内,处于平等的地位,模型可以公平地学习每个特征的重要性。
简单选择指南:
4. 归一化 vs. 标准化
这是一个非常常见的困惑点,它们是两种不同的缩放技术:
| 方面 | 归一化 | 标准化 |
|---|---|---|
| 方法 | 最小-最大缩放 | 减去均值,除以标准差 |
| 结果范围 | 固定的(如 [0, 1]) | 无固定边界,理论上范围是 (−∞,+∞)(−∞,+∞) |
| 结果分布 | 不改变原始数据的分布形状 | 使数据服从均值为0,标准差为1的分布 |
| 对异常值 | 非常敏感。因为极值(最小/最大值)直接用于计算,一个异常点会压缩正常数据的范围。 | 相对鲁棒。因为均值和标准差受异常值影响较小。 |
| 适用场景 | 当你需要数据处于有界区间内时;图像处理(像素值归一化)。 | 更通用,适用于大多数情况,特别是数据包含异常值或未知分布时。 |
-
你有一群身高不同的人(比如从150cm到200cm)。
-
归一化的过程就像是让所有人都按照同一个比例“缩放”,使得最矮的人变成0,最高的人变成1,中间的人按比例分布在0到1之间。
-
这样,所有人的“身高”这个特征都被统一到了同一个尺度和范围内。
-
2. 最常用的方法:最小-最大归一化
-
这是最经典、最直观的归一化方法,它将数据缩放到 [0, 1] 的区间。
公式如下:
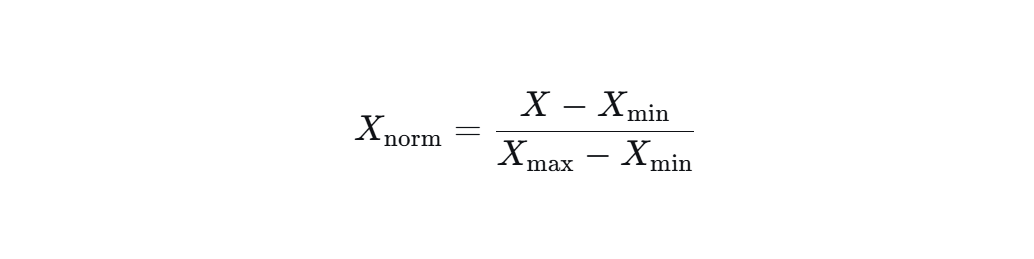
其中:
-
X:原始数据值
-
Xmin:该特征列中的最小值
-
Xmax:该特征列中的最大值
-
Xnorm:归一化后的新值
-
Xmin=20
-
20→ (20−20)/40=0 -
30→ (30−20)/40=0. -
40→ (40−20)/40=0.5 -
50→ (50−20)/40=0.75 -
60→ (60−20)/40=1 -
Xmax=60
-
最终得到归一化后的数据:
[0, 0.25, 0.5, 0.75, 1]
3. 为什么要进行归一化?(主要目的)
归一化主要是为了解决由于特征尺度不同所带来的问题。
举个例子:
假设我们用两个特征来预测一个人的信用等级: -
特征A:年龄,范围是 [20, 80] 岁
-
特征B:年收入,范围是 [50,000, 1,000,000] 元
-
加速模型收敛:对于使用梯度下降进行优化的算法(如线性回归、逻辑回归、神经网络),归一化是至关重要的。它可以使得损失函数的“碗”状更圆,梯度下降能沿着更直接的路径走向最小值,从而大大加快训练速度。
-
提升基于距离的算法的精度:对于如 K-近邻、支持向量机、K-均值聚类 等算法,它们依赖于数据点之间的距离计算。如果某个特征的尺度很大,它在距离计算中的权重就会天然地更大,从而导致错误的计算结果。归一化能确保所有特征对距离计算的贡献是均衡的。
-
提高解的稳定性:对于一些高级的求解器,归一化可以使数值计算更加稳定,避免因数据范围过大而导致的数值溢出等问题。
-
当你不确定该用哪种,或者数据有异常值时,优先使用标准化。
-
当你确需将数据限制在特定范围内(如神经网络的激活函数要求输入在[0,1])时,使用归一化。
5. 注意事项
防止数据泄露:在机器学习中,归一化时使用的 XminXmin 和 XmaxXmax 必须仅从训练集计算,然后用这个训练集的参数去转换验证集和测试集。绝对不能在整个数据集上计算最小最大值后再划分数据集,这会造成信息泄露,导致模型评估结果不真实。
总结
归一化是一种通过最小-最大缩放将数据特征缩放到一个固定范围(如[0,1])的数据预处理技术。它的主要目的是消除特征之间的尺度差异,从而加速模型训练、提升模型性能,并确保某些算法(特别是基于距离的算法)能正常工作。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)