Kubernetes:探针解析
1、存活探针exec和http
我们先来给大家演示下存活探针的使用方法(原理可以看之前的文章),首先我们用 exec 执行命令的方式来检测容器的存活,如下:(liveness-exec.yaml)
exec方式
# 主要讲解pod当中的健康检查当中的livenessProbe
# liveness probe 来确定你的应用程序是否正在运行,通俗点将就是是否还活着  exec方式
apiVersion: v1
kind: Pod
metadata:
  name: liveness-exec
spec:
  containers:
    - name: liveness
      image: busybox
      args: ["/bin/sh","-c","touch /tmp/healthy; sleep 30; rm -rf /tmp/healthy; sleep 600"] # 容器启动之后创建healthy文件 30s后删除并睡眠600s避免容器死掉
      # 存活探针
      livenessProbe:
        exec:                               # 通过exec执行命令的方式来搞
          command: ['/bin/sh','-c','cat /tmp/healthy']   # 执行命令读取文件内容 读取不到就认定为失败 读取到了就是成功 #如果命令执行成功了,将返回0,那么 kubelet 就会认为当前这个容器是存活的,如果返回的是非0值,那么 kubelet 就会把该容器杀掉然后重启它
        initialDelaySeconds: 10             # 延迟多久后开始探测  表示在第一次执行探针的时候要等待5秒,这样能够确保我们的容器能够有足够的时间启动起来
        periodSeconds: 5                    # 执行探测频率(秒) 每隔秒执行一次
        timeoutSeconds: 1                   #  超时时间
        failureThreshold: 2                 # 处于成功状态时,探测连续失败几次可被认为失败
        successThreshold: 1                 # 处于失败状态时,探测连续成功几次,被认为成功

# 使用场景说明:
# 比如你的容器当中需要用到第三方服务,必须等待第三方服务启动之后再启动,这个时候就可以利用存活探针探测第三方服务是有已经启动(可以读取某个文件作为标识) 只有探测到了那么这里才会返回正确的
# 值认定服务是可用的从而不会重启本服务;
# 再比如你的pod状态是好的,端口号也是能访问的,但是你内部服务异常,这个时候可以通过探活探针判断是否要重启该服务;

# liveness probe存活性探针,用于判断容器是不是健康,如果不满足健康条件,那么 Kubelet 将根据 Pod 中设置的 restartPolicy (重启策略)来判断,Pod 是否要进行重启操作;
# LivenessProbe按照配置去探测 ( 进程、或者端口、或者命令执行后是否成功等等),来判断容器是不是正常;
# 如果探测不到,代表容器不健康(可以配置连续多少次失败才记为不健康),则 kubelet 会杀掉该容器,并根据容器的重启策略做相应的处理;
# 如果未配置存活探针,则默认容器启动为通过(Success)状态。即探针返回的值永远是 Success。即Success后pod状态是RUNING。

# 可参考文章:https://www.cnblogs.com/liugp/p/16630873.html#%E5%9B%9B%E5%AE%9
我们这里需要用到一个新的属性:livenessProbe,下面通过 exec 执行一段命令:
- periodSeconds:表示让 kubelet 每隔5秒执行一次存活探针,也就是每5秒执行一次上面的cat /tmp/healthy命令,如果命令执行成功了,将返回0,那么 kubelet 就会认为当前这个容器是存活的,如果返回的是非0值,那么 kubelet 就会把该容器杀掉然后重启它。默认是10秒,最小1秒。
- initialDelaySeconds:表示在第一次执行探针的时候要等待5秒,这样能够确保我们的容器能够有足够的时间启动起来。大家可以想象下,如果你的第一次执行探针等候的时间太短,是不是很有可能容器还没正常启动起来,所以存活探针很可能始终都是失败的,这样就会无休止的重启下去了,对吧?
我们在容器启动的时候,执行了如下命令
$ /bin/sh -c "touch /tmp/healthy; sleep 30; rm -rf /tmp/healthy; sleep 600"
意思是说在容器最开始的30秒内创建了一个/tmp/healthy文件,在这30秒内执行cat /tmp/healthy命令都会返回一个成功的返回码。30 秒后,我们删除这个文件,现在执行cat /tmp/healthy是不是就会失败了(默认检测失败3次才认为失败),所以这个时候就会重启容器了。
我们来创建下该 Pod,然后在 30 秒内,查看 Pod 的 Event:
$ kubectl apply -f liveness-exec.yaml
$ kubectl describe pod liveness-exec
......
  Normal  Started    20s        kubelet, node2  Started container liveness
......
 Normal   Started    46s               kubelet, node2  Started container liveness
  Warning  Unhealthy  3s (x3 over 13s)  kubelet, node2  Liveness probe failed: cat: can't open '/tmp/healthy': No such file or directory
  Normal   Killing    3s                kubelet, node2  Container liveness failed liveness probe, will be restarted
我们可以观察到容器是正常启动的,在隔一会儿,比如 40s 后,再查看下 Pod 的 Event,在最下面有一条信息显示 liveness probe 失败了,容器将要重启。然后可以查看到 Pod 的RESTARTS值加 1 了:
$ kubectl get pods
NAME            READY   STATUS    RESTARTS   AGE
liveness-exec   1/1     Running   1          1m
Http方式
同样的,我们还可以使用HTTP GET请求来配置我们的存活探针,我们这里使用一个 liveness 镜像来验证演示下:(liveness-http.yaml)
# 主要讲解pod当中的健康检查当中的livenessProbe
# liveness probe 来确定你的应用程序是否正在运行,通俗点将就是是否还活着   http方式
apiVersion: v1
kind: Pod
metadata:
  name: liveness-http
spec:
  containers:
    - name: liveness-http
      image: nginx:1.7.9
      ports:
        - containerPort: 80
      # 存活探针
      livenessProbe:
        httpGet:                            # 通过http请求的方式来搞   大于200小于400的状态码都会认定是成功的返回码。其他返回码都会被认为是失败的返回码  一旦不是200-400的那么容器就会被杀死并重启
          path: /                           # 请求的路径 即容器内部的 /  即ningx的首页
          port: 80                          # 请求的服务的端口号
        initialDelaySeconds: 10             # 延迟多久后开始探测  表示在第一次执行探针的时候要等待5秒,这样能够确保我们的容器能够有足够的时间启动起来
        periodSeconds: 5                    # 执行探测频率(秒) 每隔秒执行一次
        timeoutSeconds: 1                   #  超时时间
        failureThreshold: 2                 # 处于成功状态时,探测连续失败几次可被认为失败
        successThreshold: 1                 # 处于失败状态时,探测连续成功几次,被认为成功

# 使用场景说明:
# 比如你的容器当中需要用到第三方服务,必须等待第三方服务启动之后再启动,这个时候就可以利用存活探针探测第三方服务是有已经启动(可以读取某个文件作为标识) 只有探测到了那么这里才会返回正确的
# 值认定服务是可用的从而不会重启本服务;
# 再比如你的pod状态是好的,端口号也是能访问的,但是你内部服务异常,这个时候可以通过探活探针判断是否要重启该服务;

# liveness probe存活性探针,用于判断容器是不是健康,如果不满足健康条件,那么 Kubelet 将根据 Pod 中设置的 restartPolicy (重启策略)来判断,Pod 是否要进行重启操作;
# LivenessProbe按照配置去探测 ( 进程、或者端口、或者命令执行后是否成功等等),来判断容器是不是正常;
# 如果探测不到,代表容器不健康(可以配置连续多少次失败才记为不健康),则 kubelet 会杀掉该容器,并根据容器的重启策略做相应的处理;
# 如果未配置存活探针,则默认容器启动为通过(Success)状态。即探针返回的值永远是 Success。即Success后pod状态是RUNING。

# 可参考文章:https://www.cnblogs.com/liugp/p/16630873.html#%E5%9B%9B%E5%AE%9E%E6%88%98%E6%BC%94%E7%A4%BA
返回码
通常来说,任何大于200小于400的状态码都会认定是成功的返回码。其他返回码都会被认为是失败的返回码。
另外除了上面的initialDelaySeconds和periodSeconds属性外,探针还可以配置如下几个参数:
- timeoutSeconds:探测超时时间,默认1秒,最小1秒。
- successThreshold:探测失败后,最少连续探测成功多少次才被认定为成功。默认是 1,但是如果是liveness则必须是 1。最小值是 1。
- failureThreshold:探测成功后,最少连续探测失败多少次才被认定为失败。默认是 3,最小值是 1。
liveness-exec.yaml
# 主要讲解pod当中的健康检查当中的livenessProbe
# liveness probe 来确定你的应用程序是否正在运行,通俗点将就是是否还活着  exec方式
apiVersion: v1
kind: Pod
metadata:
  name: liveness-exec
spec:
  containers:
    - name: liveness
      image: busybox
      args: ["/bin/sh","-c","touch /tmp/healthy; sleep 30; rm -rf /tmp/healthy; sleep 600"] # 容器启动之后创建healthy文件 30s后删除并睡眠600s避免容器死掉
      # 存活探针
      livenessProbe:
        exec:                               # 通过exec执行命令的方式来搞
          command: ['/bin/sh','-c','cat /tmp/healthy']   # 执行命令读取文件内容 读取不到就认定为失败 读取到了就是成功 #如果命令执行成功了,将返回0,那么 kubelet 就会认为当前这个容器是存活的,如果返回的是非0值,那么 kubelet 就会把该容器杀掉然后重启它
        initialDelaySeconds: 10             # 延迟多久后开始探测  表示在第一次执行探针的时候要等待5秒,这样能够确保我们的容器能够有足够的时间启动起来
        periodSeconds: 5                    # 执行探测频率(秒) 每隔秒执行一次
        timeoutSeconds: 1                   #  超时时间
        failureThreshold: 2                 # 处于成功状态时,探测连续失败几次可被认为失败
        successThreshold: 1                 # 处于失败状态时,探测连续成功几次,被认为成功

# 使用场景说明:
# 比如你的容器当中需要用到第三方服务,必须等待第三方服务启动之后再启动,这个时候就可以利用存活探针探测第三方服务是有已经启动(可以读取某个文件作为标识) 只有探测到了那么这里才会返回正确的
# 值认定服务是可用的从而不会重启本服务;
# 再比如你的pod状态是好的,端口号也是能访问的,但是你内部服务异常,这个时候可以通过探活探针判断是否要重启该服务;

# liveness probe存活性探针,用于判断容器是不是健康,如果不满足健康条件,那么 Kubelet 将根据 Pod 中设置的 restartPolicy (重启策略)来判断,Pod 是否要进行重启操作;
# LivenessProbe按照配置去探测 ( 进程、或者端口、或者命令执行后是否成功等等),来判断容器是不是正常;
# 如果探测不到,代表容器不健康(可以配置连续多少次失败才记为不健康),则 kubelet 会杀掉该容器,并根据容器的重启策略做相应的处理;
# 如果未配置存活探针,则默认容器启动为通过(Success)状态。即探针返回的值永远是 Success。即Success后pod状态是RUNING。

# 可参考文章:https://www.cnblogs.com/liugp/p/16630873.html#%E5%9B%9B%E5%AE%9E%E6%88%98%E6%BC%94%E7%A4%BA
liveness-http.yaml
# 主要讲解pod当中的健康检查当中的livenessProbe
# liveness probe 来确定你的应用程序是否正在运行,通俗点将就是是否还活着   http方式
apiVersion: v1
kind: Pod
metadata:
  name: liveness-http
spec:
  containers:
    - name: liveness-http
      image: nginx:1.7.9
      ports:
        - containerPort: 80
      # 存活探针
      livenessProbe:
        httpGet:                            # 通过http请求的方式来搞   大于200小于400的状态码都会认定是成功的返回码。其他返回码都会被认为是失败的返回码  一旦不是200-400的那么容器就会被杀死并重启
          path: /                           # 请求的路径 即容器内部的 /  即nginx的首页
          port: 80                          # 请求的服务的端口号
        initialDelaySeconds: 10             # 延迟多久后开始探测  表示在第一次执行探针的时候要等待5秒,这样能够确保我们的容器能够有足够的时间启动起来
        periodSeconds: 5                    # 执行探测频率(秒) 每隔秒执行一次
        timeoutSeconds: 1                   #  超时时间
        failureThreshold: 2                 # 处于成功状态时,探测连续失败几次可被认为失败
        successThreshold: 1                 # 处于失败状态时,探测连续成功几次,被认为成功

# 使用场景说明:
# 比如你的容器当中需要用到第三方服务,必须等待第三方服务启动之后再启动,这个时候就可以利用存活探针探测第三方服务是有已经启动(可以读取某个文件作为标识) 只有探测到了那么这里才会返回正确的
# 值认定服务是可用的从而不会重启本服务;
# 再比如你的pod状态是好的,端口号也是能访问的,但是你内部服务异常,这个时候可以通过探活探针判断是否要重启该服务;

# liveness probe存活性探针,用于判断容器是不是健康,如果不满足健康条件,那么 Kubelet 将根据 Pod 中设置的 restartPolicy (重启策略)来判断,Pod 是否要进行重启操作;
# LivenessProbe按照配置去探测 ( 进程、或者端口、或者命令执行后是否成功等等),来判断容器是不是正常;
# 如果探测不到,代表容器不健康(可以配置连续多少次失败才记为不健康),则 kubelet 会杀掉该容器,并根据容器的重启策略做相应的处理;
# 如果未配置存活探针,则默认容器启动为通过(Success)状态。即探针返回的值永远是 Success。即Success后pod状态是RUNING。

# 可参考文章:https://www.cnblogs.com/liugp/p/16630873.html#%E5%9B%9B%E5%AE%9E%E6%88%98%E6%BC%94%E7%A4%BA
2、启动探针
前面我们提到了探针里面有一个initialDelaySeconds的属性,可以来配置第一次执行探针的等待时间,对于启动非常慢的应用这个参数非常有用,比如Jenkins、Gitlab这类应用,但是如何设置一个合适的初始延迟时间呢?这个就和应用具体的环境有关系了,所以这个值往往不是通用的,这样的话可能就会导致一个问题,我们的资源清单在别的环境下可能就会健康检查失败了,为解决这个问题,在 Kubernetes v1.16 版本官方特地新增了一个startupProbe(启动探针),该探针将推迟所有其他探针,直到 Pod 完成启动为止,使用方法和存活探针一样,直接看yaml资源清单:
# 主要讲解pod当中的健康检查当中的startupProbe启动探针
# startupProbe启动探针, 启动检查机制,应用一些启动缓慢的业务,避免业务长时间启动而被前面的探针kill掉
# 判断容器内的应用程序是否已启动,主要针对于不能确定具体启动时间的应用。如果匹配了 startupProbes 探测,
# 则在 startupProbes 状态为 Success 之前,其他所有探针都处于无效状态,直到它成功后其他探针才起作用。
# 如果 startupProbe 失败,kubelet 将杀死容器,容器将根据 restartPolicy 来重启。如果容器没有配置 startupProbe,则默认状态为 Success。其实一般主要是设置上面两种即可
apiVersion: v1
kind: Pod
metadata:
  name: startup-http
spec:
  containers:
    - name: startup-http
      image: nginx:1.7.9
      ports:
        - containerPort: 80
      # 启动探针
      startupProbe:
        httpGet:                            # 通过http请求的方式来搞   大于200小于400的状态码都会认定是成功的返回码。其他返回码都会被认为是失败的返回码  一旦不是200-400的那么容器就会被杀死并重启
          path: /                           # 请求的路径 即容器内部的 /  即ningx的首页
          port: 80                          # 请求的服务的端口号
        initialDelaySeconds: 1              # 延迟多久后开始探测  表示在第一次执行探针的时候要等待5秒,这样能够确保我们的容器能够有足够的时间启动起来
        periodSeconds: 1                    # 执行探测频率(秒) 每隔秒执行一次
        timeoutSeconds: 1                   #  超时时间
        failureThreshold: 2                 # 处于成功状态时,探测连续失败几次可被认为失败
        successThreshold: 1                 # 处于失败状态时,探测连续成功几次,被认为成功

# 应用场景: 比如我们容器内部需要加载大量的数据或者配置文件,可以通过启动探针判断服务是否加载数据完毕!完毕了才能算是正常启动!pod状态才会变为success对外提供服务!
# 可参考文章:https://www.cnblogs.com/liugp/p/16630873.html#%E5%9B%9B%E5%AE%9E%E6%88%98%E6%BC%94%E7%A4%BA

# 这个在测试的时候可能不会有太多的日志产生哈  瞬间就起来了 都不给你请求的机会
应用场景: 比如我们容器内部需要加载大量的数据或者配置文件,可以通过启动探针判断服务是否加载数据完毕!完毕了才能算是正常启动!pod状态才会变为success对外提供服务!
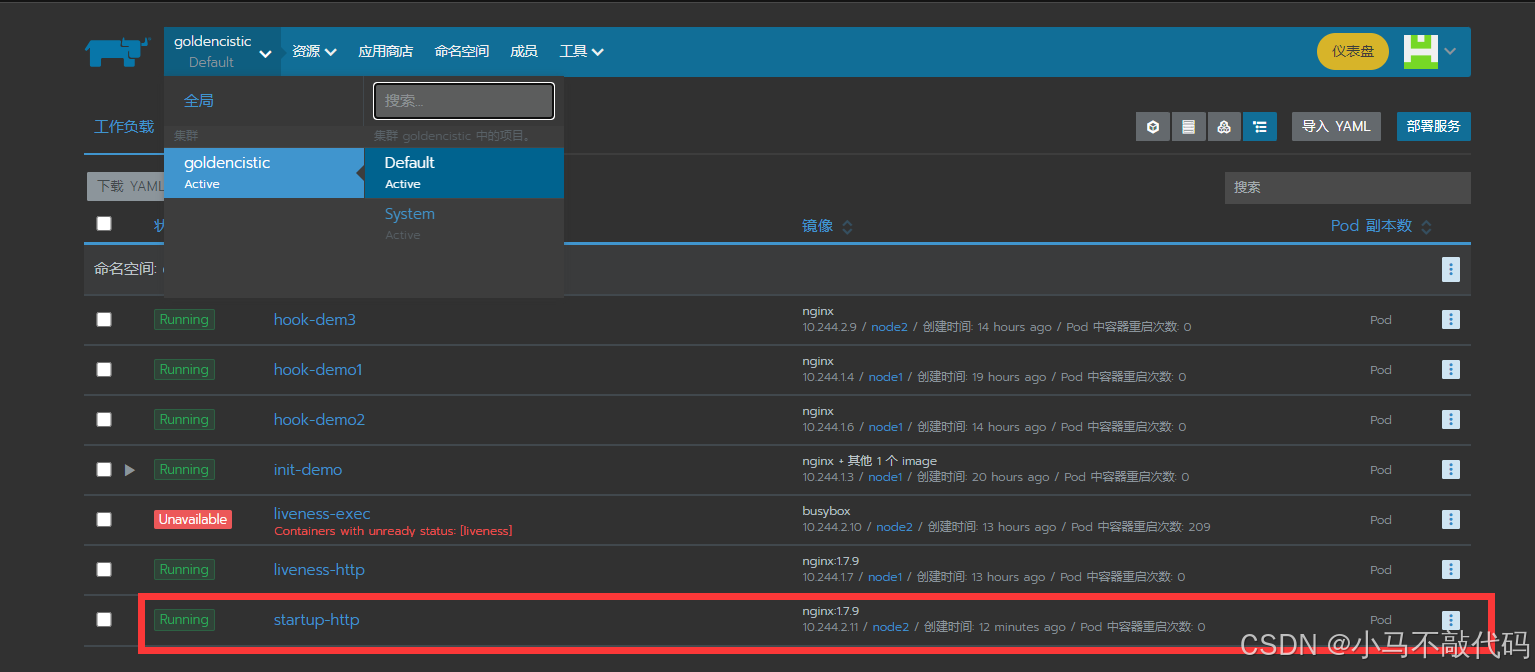
进入到rancher2当中找到对应的命名空间下的pod点击进入之后如下图所示:
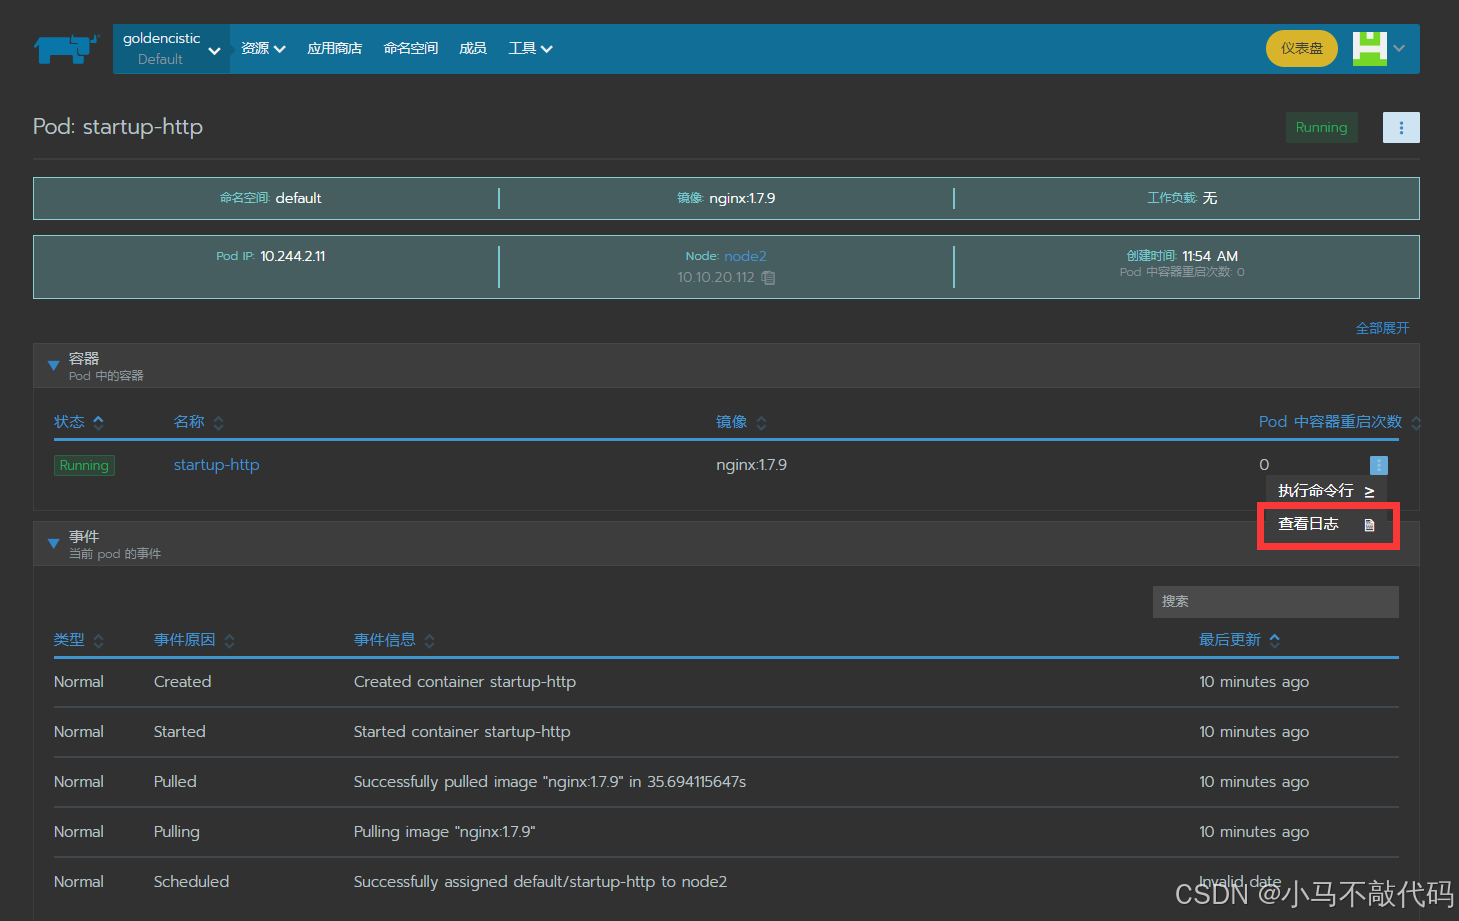
当然我们这个案例相对比较简单,只看到了一条日志的输出。
另外除了上面的initialDelaySeconds和periodSeconds属性外,探针还可以配置如下几个参数:
- timeoutSeconds:探测超时时间,默认1秒,最小1秒。
- successThreshold:探测失败后,最少连续探测成功多少次才被认定为成功。默认是 1,但是如果是liveness则必须是 1。最小值是 1。
- failureThreshold:探测成功后,最少连续探测失败多少次才被认定为失败。默认是 3,最小值是 1。
startup-http.yaml
# 主要讲解pod当中的健康检查当中的startupProbe启动探针
# startupProbe启动探针, 启动检查机制,应用一些启动缓慢的业务,避免业务长时间启动而被前面的探针kill掉
# 判断容器内的应用程序是否已启动,主要针对于不能确定具体启动时间的应用。如果匹配了 startupProbes 探测,
# 则在 startupProbes 状态为 Success 之前,其他所有探针都处于无效状态,直到它成功后其他探针才起作用。
# 如果 startupProbe 失败,kubelet 将杀死容器,容器将根据 restartPolicy 来重启。如果容器没有配置 startupProbe,则默认状态为 Success。其实一般主要是设置上面两种即可
apiVersion: v1
kind: Pod
metadata:
  name: startup-http
spec:
  containers:
    - name: startup-http
      image: nginx:1.7.9
      ports:
        - containerPort: 80
      # 启动探针
      startupProbe:
        httpGet:                            # 通过http请求的方式来搞   大于200小于400的状态码都会认定是成功的返回码。其他返回码都会被认为是失败的返回码  一旦不是200-400的那么容器就会被杀死并重启
          path: /                           # 请求的路径 即容器内部的 /  即ningx的首页
          port: 80                          # 请求的服务的端口号
        initialDelaySeconds: 1              # 延迟多久后开始探测  表示在第一次执行探针的时候要等待5秒,这样能够确保我们的容器能够有足够的时间启动起来
        periodSeconds: 1                    # 执行探测频率(秒) 每隔秒执行一次
        timeoutSeconds: 1                   #  超时时间
        failureThreshold: 2                 # 处于成功状态时,探测连续失败几次可被认为失败
        successThreshold: 1                 # 处于失败状态时,探测连续成功几次,被认为成功

# 应用场景: 比如我们容器内部需要加载大量的数据或者配置文件,可以通过启动探针判断服务是否加载数据完毕!完毕了才能算是正常启动!pod状态才会变为success对外提供服务!
# 可参考文章:https://www.cnblogs.com/liugp/p/16630873.html#%E5%9B%9B%E5%AE%9E%E6%88%98%E6%BC%94%E7%A4%BA

# 这个在测试的时候可能不会有太多的日志产生哈  瞬间就起来了 都不给你请求的机会
3、就绪探针
kubelet 使用readiness probe来确定容器是否已经就绪可以接收流量过来了。这个探针通俗点讲就是说是否准备好了,现在可以开始工作了。只有当 Pod 中的容器都处于就绪状态的时候 kubelet 才会认定该 Pod 处于就绪状态,因为一个 Pod 下面可能会有多个容器。当然 Pod 如果处于非就绪状态,那么我们就会将他从 Service 的 Endpoints 列表中移除出来,这样我们的流量就不会被路由到这个 Pod 里面来了。
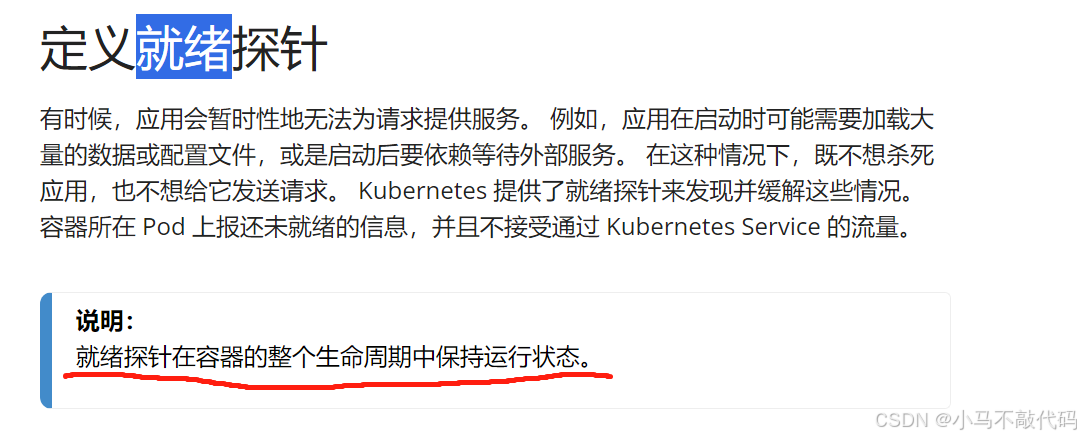
就绪探针并不是容器启动返回正常结果之后就会停止探测,就绪探针在容器的整个生命周期中保持运行状态
应用场景: 比如通过就绪探针可以判断我们容器内部的服务是否运行 是否可以正常对外提供服务了
接下来我们看具体的实际案例:
# 主要讲解pod当中的健康检查当中的readinessProbe就绪探针
# readinessProbe就绪探针,来确定你的应用程序是否准备好了,http方式
apiVersion: v1
kind: Pod
metadata:
  name: readiness-http
spec:
  containers:
    - name: readiness-http
      image: nginx:1.7.9
      ports:
        - containerPort: 80
      # 就绪探针
      readinessProbe:
        httpGet:                            # 通过http请求的方式来搞   大于200小于400的状态码都会认定是成功的返回码。其他返回码都会被认为是失败的返回码  一旦不是200-400的那么容器就会被杀死并重启
          path: /                           # 请求的路径 即容器内部的 /  即ningx的首页
          port: 80                          # 请求的服务的端口号
        initialDelaySeconds: 10             # 延迟多久后开始探测  表示在第一次执行探针的时候要等待5秒,这样能够确保我们的容器能够有足够的时间启动起来
        periodSeconds: 5                    # 执行探测频率(秒) 每隔秒执行一次
        timeoutSeconds: 1                   #  超时时间
        failureThreshold: 2                 # 处于成功状态时,探测连续失败几次可被认为失败
        successThreshold: 1                 # 处于失败状态时,探测连续成功几次,被认为成功

# readiness probe 就绪性探针,用于判断容器内的程序是否存活(或者说是否健康),只有程序(服务)正常, 容器开始对外提供网络访问(启动完成并就绪);
# pod的READY状态为 true,从0/1变为1/1。如果失败继续为0/1,状态为 false;
# 若未配置就绪探针,则默认状态容器启动后为Success。对于此pod、此pod关联的Service资源、EndPoint 的关系也将基于 Pod 的 Ready 状态进行设置;
# 如果 Pod 运行过程中 Ready 状态变为 false,则系统自动从 Service资源 关联的 EndPoint列表中去除此pod,届时service资源接收到GET请求后,kube-proxy将一定不会把流量引入此pod中,通过这种机制就能防止将流量转发到不可用的 Pod 上.

# 可参考文章:https://www.cnblogs.com/liugp/p/16630873.html#%E5%9B%9B%E5%AE%9E%E6%88%98%E6%BC%94%E7%A4%BA

# 应用场景: 比如通过就绪探针可以判断我们容器内部的服务是否运行 是否可以正常对外提供服务了
#就绪探针并不是容器启动返回正常结果之后就会停止探测,就绪探针在容器的整个生命周期中保持运行状态
readiness-http.yaml
# 主要讲解pod当中的健康检查当中的readinessProbe就绪探针
# readinessProbe就绪探针,来确定你的应用程序是否准备好了,http方式
apiVersion: v1
kind: Pod
metadata:
  name: readiness-http
spec:
  containers:
    - name: readiness-http
      image: nginx:1.7.9
      ports:
        - containerPort: 80
      # 就绪探针
      readinessProbe:
        httpGet:                            # 通过http请求的方式来搞   大于200小于400的状态码都会认定是成功的返回码。其他返回码都会被认为是失败的返回码  一旦不是200-400的那么容器就会被杀死并重启
          path: /                           # 请求的路径 即容器内部的 /  即ningx的首页
          port: 80                          # 请求的服务的端口号
        initialDelaySeconds: 10             # 延迟多久后开始探测  表示在第一次执行探针的时候要等待5秒,这样能够确保我们的容器能够有足够的时间启动起来
        periodSeconds: 5                    # 执行探测频率(秒) 每隔秒执行一次
        timeoutSeconds: 1                   #  超时时间
        failureThreshold: 2                 # 处于成功状态时,探测连续失败几次可被认为失败
        successThreshold: 1                 # 处于失败状态时,探测连续成功几次,被认为成功

# readiness probe 就绪性探针,用于判断容器内的程序是否存活(或者说是否健康),只有程序(服务)正常, 容器开始对外提供网络访问(启动完成并就绪);
# pod的READY状态为 true,从0/1变为1/1。如果失败继续为0/1,状态为 false;
# 若未配置就绪探针,则默认状态容器启动后为Success。对于此pod、此pod关联的Service资源、EndPoint 的关系也将基于 Pod 的 Ready 状态进行设置;
# 如果 Pod 运行过程中 Ready 状态变为 false,则系统自动从 Service资源 关联的 EndPoint列表中去除此pod,届时service资源接收到GET请求后,kube-proxy将一定不会把流量引入此pod中,通过这种机制就能防止将流量转发到不可用的 Pod 上.

# 可参考文章:https://www.cnblogs.com/liugp/p/16630873.html#%E5%9B%9B%E5%AE%9E%E6%88%98%E6%BC%94%E7%A4%BA

# 应用场景: 比如通过就绪探针可以判断我们容器内部的服务是否运行 是否可以正常对外提供服务了
#就绪探针并不是容器启动返回正常结果之后就会停止探测,就绪探针在容器的整个生命周期中保持运行状态

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 39
 0
- 0


 已为社区贡献18条内容

所有评论(0)