Kubernetes:控制器 - PV & Set
1、初识PV
作用:创建两个pv
apiVersion: v1
kind: PersistentVolume       # 创建pv需要用到的关键词 这个不能变
metadata:
  name: pv001                # pv的名称
spec:
  capacity:
    storage: 1Gi             # pv占用的物理空间1Gi
  accessModes:
    - ReadWriteOnce            # pv的模式
  hostPath:
    path: /tmp/pv001         # 宿主机所在的路径

---

apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv002
spec:
  capacity:
    storage: 1Gi
  accessModes:
    - ReadWriteOnce
  hostPath:
    path: /tmp/pv002

# 需要几个pv 你就创建几个就好 这只是pv  可以通过 kubectl get pv 获取创建好的所有的pv列表
# 刚创建好的pv的status状态是Available 可获得的  也就是说可以被获取使用
# 创建好的pv 就会放在那里等着pvc去关联  接下来要说的pvc又会根据配置属性自动取绑定pv

# 最终这个pv里面的host当中的/tmp/pv001在哪台宿主机上创建 这还得看想关联的pod被分配到了哪个宿主机上运行 如果pod被分配到了node1节点 那么就去node1节点上找/tmp/pv001目录
然后直接创建 PV 即可:
[root@master StatefulSet]# kubectl get pv
NAME    CAPACITY   ACCESS MODES   RECLAIM POLICY   STATUS      CLAIM   STORAGECLASS   REASON   AGE
pv001   1Gi        RWO            Retain           Available                                   3s
pv002   1Gi        RWO            Retain           Available                                   3s
可以看到成功创建了两个 PV 对象,状态是:Available。
pv-demo.yaml
# 作用:创建两个pv
apiVersion: v1
kind: PersistentVolume       # 创建pv需要用到的关键词 这个不能变
metadata:
  name: pv001                # pv的名称
spec:
  capacity:
    storage: 1Gi             # pv占用的物理空间1Gi
  accessModes:
    - ReadWriteOnce            # pv的模式
  hostPath:
    path: /tmp/pv001         # 宿主机所在的路径

---

apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv002
spec:
  capacity:
    storage: 1Gi
  accessModes:
    - ReadWriteOnce
  hostPath:
    path: /tmp/pv002

# 需要几个pv 你就创建几个就好 这只是pv  可以通过 kubectl get pv 获取创建好的所有的pv列表
# 刚创建好的pv的status状态是Available 可获得的  也就是说可以被获取使用
# 创建好的pv 就会放在那里等着pvc去关联  接下来要说的pvc又会根据配置属性自动取绑定pv

# 最终这个pv里面的host当中的/tmp/pv001在哪台宿主机上创建 这还得看想关联的pod被分配到了哪个宿主机上运行 如果pod被分配到了node1节点 那么就去node1节点上找/tmp/pv001目录
2、StatefulSet
我们先来说结果,方便大家正确的理解StatefulSet的作用,看下图:
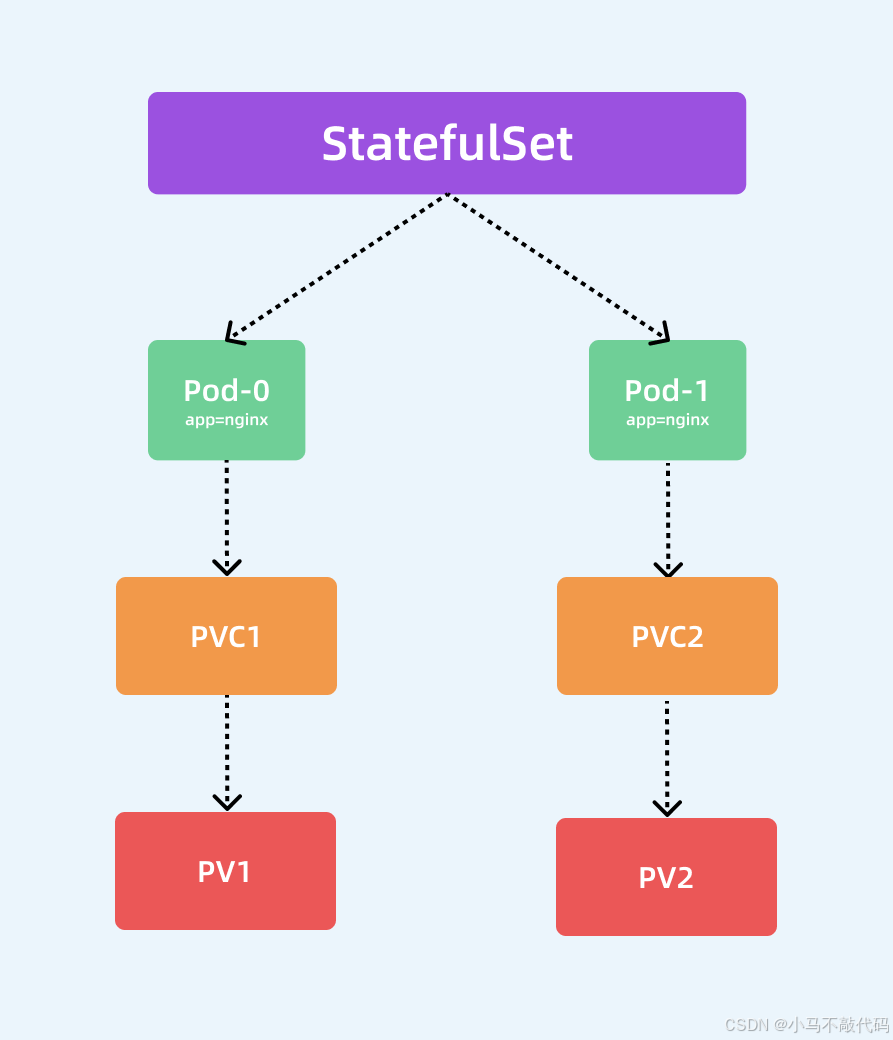
比如我们有两个有状态的服务方别部署到了pod 0 和 pod 1并且分别绑定了pvc1和pvc2,pvc1和pvc2又分别绑定了pv1和pv2,按道理来说有状态的服务的数据都应该分别存储到对应的自己关联的pv1和pv2当中去,如果这个时候我们不是用statufuleSet控制器的话,那么pod 0和pod 1重新生成肯定集群内的ip变化了,如果是一个普通的service服务而不是headleService服务的话DNS 服务解析到的这个 普通Service 的 cluster IP 的,但是这个时候pod的cluster IP已经发生变化了,数据找不到了也就不再是有状态的服务了!!!
我们使用StatefulSet的需要结合headlessService以及创建自己的PV,前面文章有介绍headlessService。
我们先来看statefulSet的yaml资源清单:
apiVersion: apps/v1
kind: StatefulSet                                   # 必须生命为 StatefulSet
metadata:
  name: web                                         # 定义的StatefulSet的名称  kubectl get StatefulSet 获取到所有的StatefuleSet
  namespace: default                                # StatefulSet所在的命名空间
spec:
  serviceName: "nginx"                              # 这里很重要 在生成nginx-sts.yaml文件之前我们一定是创建好了headless-svc这个service服务的 这里就是填写的headless-svc服务的名称也就是headless-svc里面的metadata.name的值
  podManagementPolicy: Parallel                     # 默认是 OrderedReady 表示有序的启动或者停止  Parallel表示并行的启动或者停止
  replicas: 2                                       # 生成几个pod副本
  selector:
    matchLabels:                                    # 管理者哪些pod副本 是通过app:nginx标签来寻找的
      app: mynginx
  template:                                         # pod副本模版  很重要
    metadata:
      labels:
        app: mynginx                                  # pod副本的标签 很重要;
    spec:
      containers:
        - name: nginx
          image: nginx:1.7.9
          ports:
            - name: web
              containerPort: 80
          volumeMounts:                               # 绑定pvc
            - name: www                                 # 通过name:www寻找要绑定的pvc是哪个
              mountPath: /usr/share/nginx/html          # pvc当中的路径映射到了容器内部的mountPath路径
  volumeClaimTemplates:                             # 这里你可以理解为pvc模版
    - metadata:
        name: www                                     # pvc模版的名称  pod当中通过volumeMounts当中的name来绑定这里的pvc模版
      spec:
        accessModes: [ "ReadWriteOnce" ]              # pvc的模式 这里要和pv的模式保持一致
        resources:
          requests:
            storage: 1Gi                              # pvc当中配置的空间大小也是1Gi
从上面的资源清单中可以看出和我们前面的 Deployment 基本上也是一致的,也是通过声明的 Pod 模板来创建 Pod 的,另外上面资源清单中和volumeMounts进行关联的不是volumes而是一个新的属性:volumeClaimTemplates,该属性会自动创建一个 PVC 对象,其实这里就是一个 PVC 的模板,和 Pod 模板类似,PVC 被创建后会自动去关联当前系统中和他合适的 PV 进行绑定。
除此之外,还多了一个serviceName: "nginx"的字段,serviceName就是管理当前StatefulSet的服务名称,该服务必须在 StatefulSet 之前存在,并且负责该集合的网络标识,这个服务就是我们前边创建过的headlessService服务
Pod 会遵循以下格式获取 DNS/主机名:pod-specific-string.serviceName.default.svc.cluster.local,其中pod-specific-string由 StatefulSet 控制器管理。
结论:
结合headless-svc 和 pv 创建StatefulSet 在看这个之前 先把前边的pv.yaml和headless-svc.yaml两个配置文件搞懂!
通俗的描述:StatefulSet我们用大白话讲,平时我们创建service会自动分配给这个service一个集群内ip,拿着这个集群内ip访问service服务,service服务会将请求负载到不同的pod上边去!但是这里的StatefulSet就不一样了,它得结合headless-svc,headless-svc是一种service但是是一种没有集群内ip地址的service,我们只能通过dns的形式去访问这个service服务 也就是说headless-svc的创建必须要在StatefulSet创建之前搞定!因为在StatefulSet创建的时候需要使用到这个已经创建好的headless-svc !
StatefulSet 的拓扑结构和其他用于部署的资源对象其实比较类似,比较大的区别在于 StatefulSet 引入了 PV 和 PVC 对象来持久存储服务产生的状态,这样所有的服务虽然可以被杀掉或者重启,但是其中的数据由于 PV 的原因不会丢失!保证了允许不同pod当中运行不同状态的服务!并且pod荡掉之后重新启动数据都还会是以前的数据 维持了原有状态!
StatefulSet 保证了 Pod 网络标识的唯一稳定性,由于 Pod IP 并不是固定的,所以我们访问有状态应用实例的时候,就必须使用 DNS 记录的方式来访问了 一切都是因为Pod IP并不是固定的!
StatefulSet的拓扑结构和其他用于部署的资源对象其实比较类似,比较大的区别在于StatefulSet引入了 PV 和 PVC 对象来持久存储服务产生的状态,这样所有的服务虽然可以被杀掉或者重启,但是其中的数据由于 PV 的原因不会丢失。
为什么数据不会丢失呢?
我们先大体的说一下,将上边的yaml资源清单执行以后会生成两个pod,因为replicas: 2,并且serviceName: "nginx"也就是我们前边创建好了的healessService服务然后创建的pod的名称是web,这个时候创建出来的pod如下所示:
[root@master ~]# kubectl get pods -l app=mynginx
NAME    READY   STATUS    RESTARTS   AGE
web-0   1/1     Running   0          21m
web-1   1/1     Running   0          21m
你会发现很有规律web-0 web-1
因为我们在yaml资源清单当中使用了pvc的模板来自动创建pvc去关联前边我们创建好的pv,我们再来看看执行完上述yaml资源清单之后的pvc有哪些:
[root@master ~]# kubectl get pvc
NAME        STATUS   VOLUME   CAPACITY   ACCESS MODES   STORAGECLASS   AGE
www-web-0   Bound    pv001    1Gi        RWO                           55m
www-web-1   Bound    pv002    1Gi        RWO                           55m
也是那么的有规律 www-web-0 和www-web-1两个pvc !!!
这个时候即使是我们删除了pod重新创建 因为pv和pvc的关系已经确定了并且pod的web-0和pvc的www-web-0的关系也是内部决定的,所以再怎么折腾pod他们的关系依然不会乱,这也就是为什么可以用于有状态服务的原因。
详细步骤:
现在我们优先创建上面定义的Headless Service:
$ kubectl apply -f headless-svc.yaml
service/nginx created
$ kubectl get service nginx
NAME    TYPE        CLUSTER-IP   EXTERNAL-IP   PORT(S)   AGE
nginx   ClusterIP   None         <none>        80/TCP    9s
Headless Service创建完成后就可以来创建对应的 StatefulSet 对象了:
$ kubectl apply -f nginx-sts.yaml
statefulset.apps/web created
$ kubectl get pvc
NAME        STATUS   VOLUME   CAPACITY   ACCESS MODES   STORAGECLASS   AGE
www-web-0   Bound    pv001    1Gi        RWO                           10m
www-web-1   Bound    pv002    1Gi        RWO                           6m26s
可以看到这里通过 Volume 模板自动生成了两个 PVC 对象,也自动和 PV 进行了绑定。这个时候我们可以快速通过一个–watch参数来查看 Pod 的创建过程:
$ kubectl get pods -l app=nginx --watch
NAME                      READY   STATUS              RESTARTS   AGE
web-0                     0/1     ContainerCreating   0          1s
web-0                     1/1     Running             0          2s
web-1                     0/1     Pending             0          0s
web-1                     0/1     Pending             0          0s
web-1                     0/1     ContainerCreating   0          0s
web-1                     1/1     Running             0          6s
我们仔细观察整个过程出现了两个 Pod:web-0和web-1,而且这两个 Pod 是按照顺序进行创建的,web-0启动起来后web-1才开始创建。如同上面 StatefulSet 概念中所提到的,StatefulSet 中的 Pod 拥有一个具有稳定的、独一无二的身份标志。这个标志基于 StatefulSet 控制器分配给每个 Pod 的唯一顺序索引。Pod 的名称的形式为-。我们这里的对象拥有两个副本,所以它创建了两个 Pod 名称分别为:web-0 和 web-1,我们可以使用kubectl exec命令进入到容器中查看它们的 hostname:
$ kubectl exec web-0 hostname
web-0
$ kubectl exec web-1 hostname
web-1
可以看到,这两个 Pod 的 hostname 与 Pod 名字是一致的,都被分配了对应的编号。我们随意查看一个 Pod 的描述信息:
$ kubectl describe pod web-0
Name:               web-0
Namespace:          default
Priority:           0
PriorityClassName:  <none>
Node:               ydzs-node3/10.151.30.57
Start Time:         Sun, 17 Nov 2019 12:32:50 +0800
Labels:             app=nginx
                    controller-revision-hash=web-6c5c7fd59b
                    statefulset.kubernetes.io/pod-name=web-0
Annotations:        podpreset.admission.kubernetes.io/podpreset-time-preset: 2062768
Status:             Running
IP:                 10.244.3.98
Controlled By:      StatefulSet/web
我们可以看到Controlled By: StatefulSet/web,证明我们的 Pod 是直接受到 StatefulSet 控制器管理的。
现在我们创建一个 busybox(该镜像中有一系列的工具)的容器,在容器中用 DNS 的方式来访问一下这个Headless Service,由于我们这里只是单纯的为了测试,所以没必要写资源清单文件来声明,用kubectl run命令启动一个测试的容器即可:
$ kubectl run -it --image busybox:1.28.3 test --restart=Never --rm /bin/sh
If you don't see a command prompt, try pressing enter.
/ #
busybox 镜像
busybox最新版本的镜像有 BUG,会出现nslookup提示无法解析的问题,我们这里使用老一点的镜像版本1.28.3即可。
如果对kubectl run命令的使用参数不清楚,我们可以使用kubectl run --help命令查看可使用的参数。我们这里使用kubectl run命令启动了一个以 busybox 为镜像的 Pod,–rm参数意味着我们退出 Pod 后就会被删除,和之前的docker run命令用法基本一致,现在我们在这个 Pod 容器里面可以使用nslookup命令来尝试解析下上面我们创建的Headless Service:
/ # nslookup nginx
Server:    10.96.0.10
Address 1: 10.96.0.10 kube-dns.kube-system.svc.cluster.local

Name:      nginx
Address 1: 10.244.1.175 web-1.nginx.default.svc.cluster.local
Address 2: 10.244.4.83 web-0.nginx.default.svc.cluster.local
/ # ping nginx
PING nginx (10.244.1.175): 56 data bytes
64 bytes from 10.244.1.175: seq=0 ttl=62 time=1.076 ms
64 bytes from 10.244.1.175: seq=1 ttl=62 time=1.029 ms
64 bytes from 10.244.1.175: seq=2 ttl=62 time=1.075 ms
我们直接解析Headless Service的名称,可以看到得到的是两个 Pod 的解析记录,但实际上如果我们通过nginx这个 DNS 去访问我们的服务的话,并不会随机或者轮询背后的两个 Pod,而是访问到一个固定的 Pod,所以不能代替普通的 Service。如果分别解析对应的 Pod 呢?
$ / # nslookup web-0.nginx
Server:    10.96.0.10
Address 1: 10.96.0.10 kube-dns.kube-system.svc.cluster.local

Name:      web-0.nginx
Address 1: 10.244.4.83 web-0.nginx.default.svc.cluster.local
/ # nslookup web-1.nginx
Server:    10.96.0.10
Address 1: 10.96.0.10 kube-dns.kube-system.svc.cluster.local

Name:      web-1.nginx
Address 1: 10.244.1.175 web-1.nginx.default.svc.cluster.local
可以看到解析web-0.nginx的时候解析到了web-0这个 Pod 的 IP,web-1.nginx解析到了web-1这个 Pod 的 IP,而且这个 DNS 地址还是稳定的,因为 Pod 名称就是固定的,比如我们这个时候去删掉web-0和web-1这两个 Pod:
$ kubectl delete pod -l app=nginx
pod "web-0" deleted
pod "web-1" deleted
删除完成后才看 Pod 状态:
$ kubectl get pods -l app=nginx
NAME    READY   STATUS    RESTARTS   AGE
web-0   1/1     Running   0          42s
web-1   1/1     Running   0          39s
可以看到 StatefulSet 控制器仍然会安装顺序创建出两个 Pod 副本出来,而且 Pod 的唯一标识依然没变,所以这两个 Pod 的网络标识还是固定的,我们依然可以通过web-0.nginx去访问到web-0这个 Pod,虽然 Pod 已经重建了,对应 Pod IP 已经变化了,但是访问这个 Pod 的地址依然没变,并且他们依然还是关联的之前的 PVC,数据并不会丢失:
/ # nslookup web-0.nginx
Server:    10.96.0.10
Address 1: 10.96.0.10 kube-dns.kube-system.svc.cluster.local

Name:      web-0.nginx
Address 1: 10.244.3.98 web-0.nginx.default.svc.cluster.local
/ # nslookup web-1.nginx
Server:    10.96.0.10
Address 1: 10.96.0.10 kube-dns.kube-system.svc.cluster.local

Name:      web-1.nginx
Address 1: 10.244.1.176 web-1.nginx.default.svc.cluster.local
通过Headless Service,StatefulSet 就保证了 Pod 网络标识的唯一稳定性,由于 Pod IP 并不是固定的,所以我们访问有状态应用实例的时候,就必须使用 DNS 记录的方式来访问了,所以很多同学偶尔有固定的 Pod IP 的需求,或许可以用这种方式来代替。
最后我们可以通过删除 StatefulSet 对象来删除所有的 Pod,仔细观察也会发现是按照倒序的方式进行删除的:
$ kubectl delete statefulsets  web
statefulset.apps "web" deleted
$ kubectl get pods --watch
NAME    READY   STATUS    RESTARTS   AGE
web-1   1/1   Terminating   0     3h/31m
web-0   1/1   Terminating   0     3h/31m
在实际的项目中,其实我们还是很少会去直接通过 StatefulSet 来部署我们的有状态服务的,除非你自己能够完全能够 hold 住,对于一些特定的服务,我们可能会使用更加高级的 Operator 来部署,比如 etcd-operator、prometheus-operator 等等,这些应用都能够很好的来管理有状态的服务,而不是单纯的使用一个 StatefulSet 来部署一个 Pod 就行,因为对于有状态的应用最重要的还是数据恢复、故障转移等等。
pv.yaml
# 作用:创建两个pv
apiVersion: v1
kind: PersistentVolume       # 创建pv需要用到的关键词 这个不能变
metadata:
  name: pv001                # pv的名称
spec:
  capacity:
    storage: 1Gi             # pv占用的物理空间1Gi
  accessModes:
    - ReadWriteOnce            # pv的模式
  hostPath:
    path: /tmp/pv001         # 宿主机所在的路径

---

apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv002
spec:
  capacity:
    storage: 1Gi
  accessModes:
    - ReadWriteOnce
  hostPath:
    path: /tmp/pv002

# 需要几个pv 你就创建几个就好 这只是pv  可以通过 kubectl get pv 获取创建好的所有的pv列表
# 刚创建好的pv的status状态是Available 可获得的  也就是说可以被获取使用
# 创建好的pv 就会放在那里等着pvc去关联  接下来要说的pvc又会根据配置属性自动取绑定pv

# 最终这个pv里面的host当中的/tmp/pv001在哪台宿主机上创建 这还得看想关联的pod被分配到了哪个宿主机上运行 如果pod被分配到了node1节点 那么就去node1节点上找/tmp/pv001目录
headless-svc.yaml
# 作用:这是一个Headless Service
# 实际上Headless Service在定义上和普通的Service几乎一致 只不过它的clusterIP:None 这样就不会给这个service分配集群内ip通过dns的方式访问该service服务
apiVersion: v1
kind: Service
metadata:
  name: nginx                            # 所定义的service的名称
  namespace: default                     # 这个service所在的命名空间
  labels:                                # 这个标签 随便定义 不重要
    app: nginx
spec:
  ports:
    - name: http                           # 所定义的service里面ports端口的名称叫做http
      port: 80                             # 所定义的service的端口号80
  clusterIP: None                        # clusterIP:None 看到这个 那么就一定是Headless Service 不会为该service分配集群内ip而是通过dns的形式访问
  selector:                              # 这个就很重要了  这个指的是所定义的service关联的要管理的pod的标签 所有pod的标签被定义为了app:mynginx的都将会通过该service被访问到 相当重要
    app: mynginx                         # 这里的app: mynginx 所要管理的pod会存在于nginx-sts.yaml当中声明

# StatefulSet 资源对象是要结合 Headless Service 提供服务的!
nginx-sts.yaml
# 作用:结合headless-svc 和 pv 创建StatefulSet  在看这个之前 先把前边的pv.yaml和headless-svc.yaml两个配置文件搞懂!
# 通俗的描述:StatefulSet我们用大白话讲,平时我们创建service会自动分配给这个service一个集群内ip,拿着这个集群内ip访问service服务,service服务会将请求负载到不同的pod上边去!但是这里的StatefulSet
# 就不一样了,它得结合headless-svc,headless-svc是一种service但是是一种没有集群内ip地址的service,我们只能通过dns的形式去访问这个service服务  也就是说headless-svc的创建必须要在StatefulSet创建之前搞定!
# 因为在StatefulSet创建的时候需要使用到这个已经创建好的headless-svc !
# StatefulSet 的拓扑结构和其他用于部署的资源对象其实比较类似,比较大的区别在于 StatefulSet 引入了 PV 和 PVC 对象来持久存储服务产生的状态,这样所有的服务虽然可以被杀掉或者重启,但是其中的数据由于 PV 的原因不会丢失!保证了
# 允许不同pod当中运行不同状态的服务!并且pod荡掉之后重新启动数据都还会是以前的数据 维持了原有状态!
# StatefulSet 保证了 Pod 网络标识的唯一稳定性,由于 Pod IP 并不是固定的,所以我们访问有状态应用实例的时候,就必须使用 DNS 记录的方式来访问了 一切都是因为Pod IP并不是固定的!

apiVersion: apps/v1
kind: StatefulSet                                   # 必须生命为 StatefulSet
metadata:
  name: web                                         # 定义的StatefulSet的名称  kubectl get StatefulSet 获取到所有的StatefuleSet
  namespace: default                                # StatefulSet所在的命名空间
spec:
  serviceName: "nginx"                              # 这里很重要 在生成nginx-sts.yaml文件之前我们一定是创建好了headless-svc这个service服务的 这里就是填写的headless-svc服务的名称也就是headless-svc里面的metadata.name的值
  podManagementPolicy: Parallel                     # 默认是 OrderedReady 表示有序的启动或者停止  Parallel表示并行的启动或者停止
  replicas: 2                                       # 生成几个pod副本
  selector:
    matchLabels:                                    # 管理者哪些pod副本 是通过app:nginx标签来寻找的
      app: mynginx
  template:                                         # pod副本模版  很重要
    metadata:
      labels:
        app: mynginx                                  # pod副本的标签 很重要;
    spec:
      containers:
        - name: nginx
          image: nginx:1.7.9
          ports:
            - name: web
              containerPort: 80
          volumeMounts:                               # 绑定pvc
            - name: www                                 # 通过name:www寻找要绑定的pvc是哪个
              mountPath: /usr/share/nginx/html          # pvc当中的路径映射到了容器内部的mountPath路径
  volumeClaimTemplates:                             # 这里你可以理解为pvc模版
    - metadata:
        name: www                                     # pvc模版的名称  pod当中通过volumeMounts当中的name来绑定这里的pvc模版
      spec:
        accessModes: [ "ReadWriteOnce" ]              # pvc的模式 这里要和pv的模式保持一致
        resources:
          requests:
            storage: 1Gi                              # pvc当中配置的空间大小也是1Gi

# 也许你很疑惑pvc是如何关联到pv的呢?
# 文档当中提到PVC 被创建后会自动去关联当前系统中和他合适的 PV 进行绑定;里面的原理是通过特征去绑定的,比如pvc的模式以及空间大小,匹配到之后就会相互关联,一旦被关联pv的状态就会变成bound被绑定了!
# 理解PV和PVC的关系 PVC的容量是来源于PV,类似本地电脑的目录大小和磁盘的关系  并且pvc的容量小于等于pv的就可以去匹配到相关的pv 比如pvc是1Gi pv是1Gi或者2Gi都会被匹配到的!
# 通过StatefulSet创建出来的pod不受RS控制而是直接受StatefulSet控制器控制的
3、DaemonSet
通过该控制器的名称我们可以看出它的用法:Daemon,就是用来部署守护进程的,DaemonSet用于在每个 Kubernetes 节点中将守护进程的副本作为后台进程运行,说白了就是在每个节点部署一个 Pod副本,当节点加入到 Kubernetes 集群中,Pod 会被调度到该节点上运行,当节点从集群只能够被移除后,该节点上的这个 Pod 也会被移除,当然,如果我们删除 DaemonSet,所有和这个对象相关的 Pods都会被删除。那么在哪种情况下我们会需要用到这种业务场景呢?其实这种场景还是比较普通的,比如:
- 集群存储守护程序,如 glusterd、ceph 要部署在每个节点上以提供持久性存储;
- 节点监控守护进程,如 Prometheus 监控集群,可以在每个节点上运行一个 node-exporter 进程来收集监控节点的信息;
- 日志收集守护程序,如 fluentd 或 logstash,在每个节点上运行以收集容器的日志
- 节点网络插件,比如 flannel、calico,在每个节点上运行为 Pod 提供网络服务。
这里需要特别说明的一个就是关于 DaemonSet 运行的 Pod 的调度问题,正常情况下,Pod 运行在哪个节点上是由 Kubernetes 的调度器策略来决定的,然而,由 DaemonSet 控制器创建的 Pod 实际上提前已经确定了在哪个节点上了(Pod创建时指定了.spec.nodeName),所以:
- DaemonSet并不关心一个节点的unshedulable字段,这个我们会在后面的调度章节和大家讲解的。
- DaemonSet可以创建 Pod,即使调度器还没有启动。
下面我们直接使用一个示例来演示下,在每个节点上部署一个 Nginx Pod:(nginx-ds.yaml)
# 作用:Daemon就是用来部署守护进程的,Daemon会在每个k8s节点中将守护进程的副本作为后台进程运行,说变了就是每个节点部署一个pod副本
# 当节点加入到k8s集群中的时候,pod就会调取到该节点上运行;当节点从集群删除了那么该节点的这个pod也会被删除,当然我们删除DaemonSet
# 那么所有和这个对象相关的pod都会被删除 所有节点上的哈!
apiVersion: apps/v1
kind: DaemonSet
metadata:
name: nginx-ds
namespace: default
spec:
selector:
matchLabels:
k8s-app: nginx
template:
metadata:
labels:
k8s-app: nginx
spec:
containers:
- image: nginx:1.7.9
name: nginx
ports:
- name: http
containerPort: 80
# kubectl get DaemonSet 获取所有的DaemonSet控制器
然后直接创建即可:
$ kubectl apply -f nginx-ds.yaml
daemonset.apps/nginx-ds created
创建完成后,我们查看 Pod 的状态:
$ kubectl get nodes
NAME          STATUS   ROLES    AGE     VERSION
ydzs-master   Ready    master   8d      v1.16.2
ydzs-node1    Ready    <none>   8d      v1.16.2
ydzs-node2    Ready    <none>   8d      v1.16.2
ydzs-node3    Ready    <none>   6d23h   v1.16.2
ydzs-node4    Ready    <none>   6d23h   v1.16.2
$ kubectl get pods -l k8s-app=nginx -o wide
NAME             READY   STATUS    RESTARTS   AGE   IP             NODE         NOMINATED NODE   READINESS GATES
nginx-ds-bpsb7   1/1     Running   0          75s   10.244.3.102   ydzs-node3   <none>           <none>
nginx-ds-f4s2w   1/1     Running   0          75s   10.244.2.74    ydzs-node2   <none>           <none>
nginx-ds-j9789   1/1     Running   0          75s   10.244.4.85    ydzs-node4   <none>           <none>
nginx-ds-ngkt2   1/1     Running   0          75s   10.244.1.178   ydzs-node1   <none>           <none>
我们观察可以发现除了 master 节点之外的4个节点上都有一个相应的 Pod 运行,因为 master 节点上默认被打上了污点,所以默认情况下不能调度普通的 Pod 上去,后面讲解调度器的时候会和大家学习如何调度上去。
基本上我们可以用下图来描述 DaemonSet 的拓扑图:
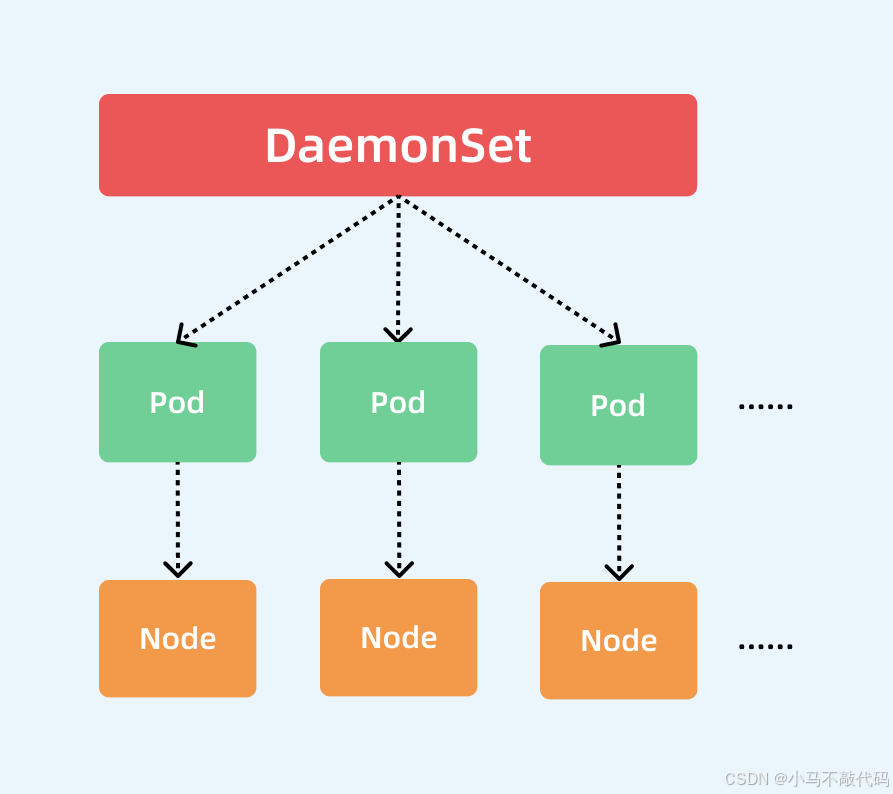
集群中的 Pod 和 Node 是一一对应d的,而 DaemonSet 会管理全部机器上的 Pod 副本,负责对它们进行更新和删除。
那么,DaemonSet 控制器是如何保证每个 Node 上有且只有一个被管理的 Pod 呢?
- 首先控制器从 Etcd 获取到所有的 Node 列表,然后遍历所有的 Node。
- 根据资源对象定义是否有调度相关的配置,然后分别检查 Node 是否符合要求。
- 在可运行 Pod 的节点上检查是否已有对应的 Pod,如果没有,则在这个 Node 上创建该 Pod;如果有,并且数量大于 1,那就把多余的 Pod 从这个节点上删除;如果有且只有一个 Pod,那就说明是正常情况。
实际上当我们学习了资源调度后,我们也可以自己用 Deployment 来实现 DaemonSet 的效果,这里我们明白 DaemonSet 如何使用的即可,当然该资源对象也有对应的更新策略,有OnDelete和RollingUpdate两种方式,默认是滚动更新。
nignx-ds.yaml
# 作用:Daemon就是用来部署守护进程的,Daemon会在每个k8s节点中将守护进程的副本作为后台进程运行,说变了就是每个节点部署一个pod副本
# 当节点加入到k8s集群中的时候,pod就会调取到该节点上运行;当节点从集群删除了那么该节点的这个pod也会被删除,当然我们删除DaemonSet
# 那么所有和这个对象相关的pod都会被删除 所有节点上的哈!
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: nginx-ds
  namespace: default
spec:
  selector:
    matchLabels:
      k8s-app: nginx
  template:
    metadata:
      labels:
        k8s-app: nginx
    spec:
      containers:
        - image: nginx:1.7.9
          name: nginx
          ports:
            - name: http
              containerPort: 80

# kubectl get DaemonSet  获取所有的DaemonSet控制器

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 57
 0
- 0


 已为社区贡献18条内容

所有评论(0)