基于Django的社区设备报修住户反馈智能预测系统(可作为毕设使用,机器学习决策树算法)
基于机器学习的社区设备报修住户反馈智能预测系统
前言介绍
项目的背景和意义
在我国城市化快速发展的今天,居住小区的面积越来越大,居住小区的设施和设施也越来越多。由于物业公司在设备使用过程中,难免会发了故障和损伤,所以物业公司的设备维护就成了社区物业管理的一个重要工作环节。但目前的维修方法,大多采用人工登记和电话通知等低效率的方法,造成了维修过程繁琐、响应缓慢、管理效率低等问题。另外,在对居民反馈信息的处理上,存在着不系统、处理不及时等问题,很难对物业服务的满意程度和效果进行准确的预测和评价。
针对上述问题,本文提出了一种基于 Django技术的居民维修信息智能预报系统。本项目的研究成果不仅可以对维护过程进行优化,还可以通过对设备维修信息进行预测,从而为社区管理人员的维护工作提供改善依据,来进一步提高社区服务水平。
意义:
提高维修服务质量:利用设备报修预测系统,迅速地收集、传输维修信息,降低人人工成本,提高设备维修工作的效率。
维护资源的最优配置:通过对维护人员的闲置时间及技术水平,实现对维修人员的维护工作的安排,从而避免了不必要的资源浪费。
提高居民满意度:通过对居民的反馈进行智能化的预测,使社区管理人员能够实时掌握居民对维护工作的满意程度和意见,以便有针对性的改善服务,提高居民的满意度。
辅助决策:通过对海量的维修信息及居民的信息进行采集与分析,为物业管理人员制定设备维修计划、维修服务商选择等提供决策支持。
推进社区管理信息化:通过本项目的实施,能够促使社区管理迈向信息化、智能化的崭新阶段,全面提升其管理品质与层次。
01开发环境
1.1 Python技术
1.2 Django框架
1.3 MySQL数据库
1.4 B/S 结构
1.5 Vue.js 技术
1.6 智能推荐
1.7 机器学习决策树算法
02系统功能模块
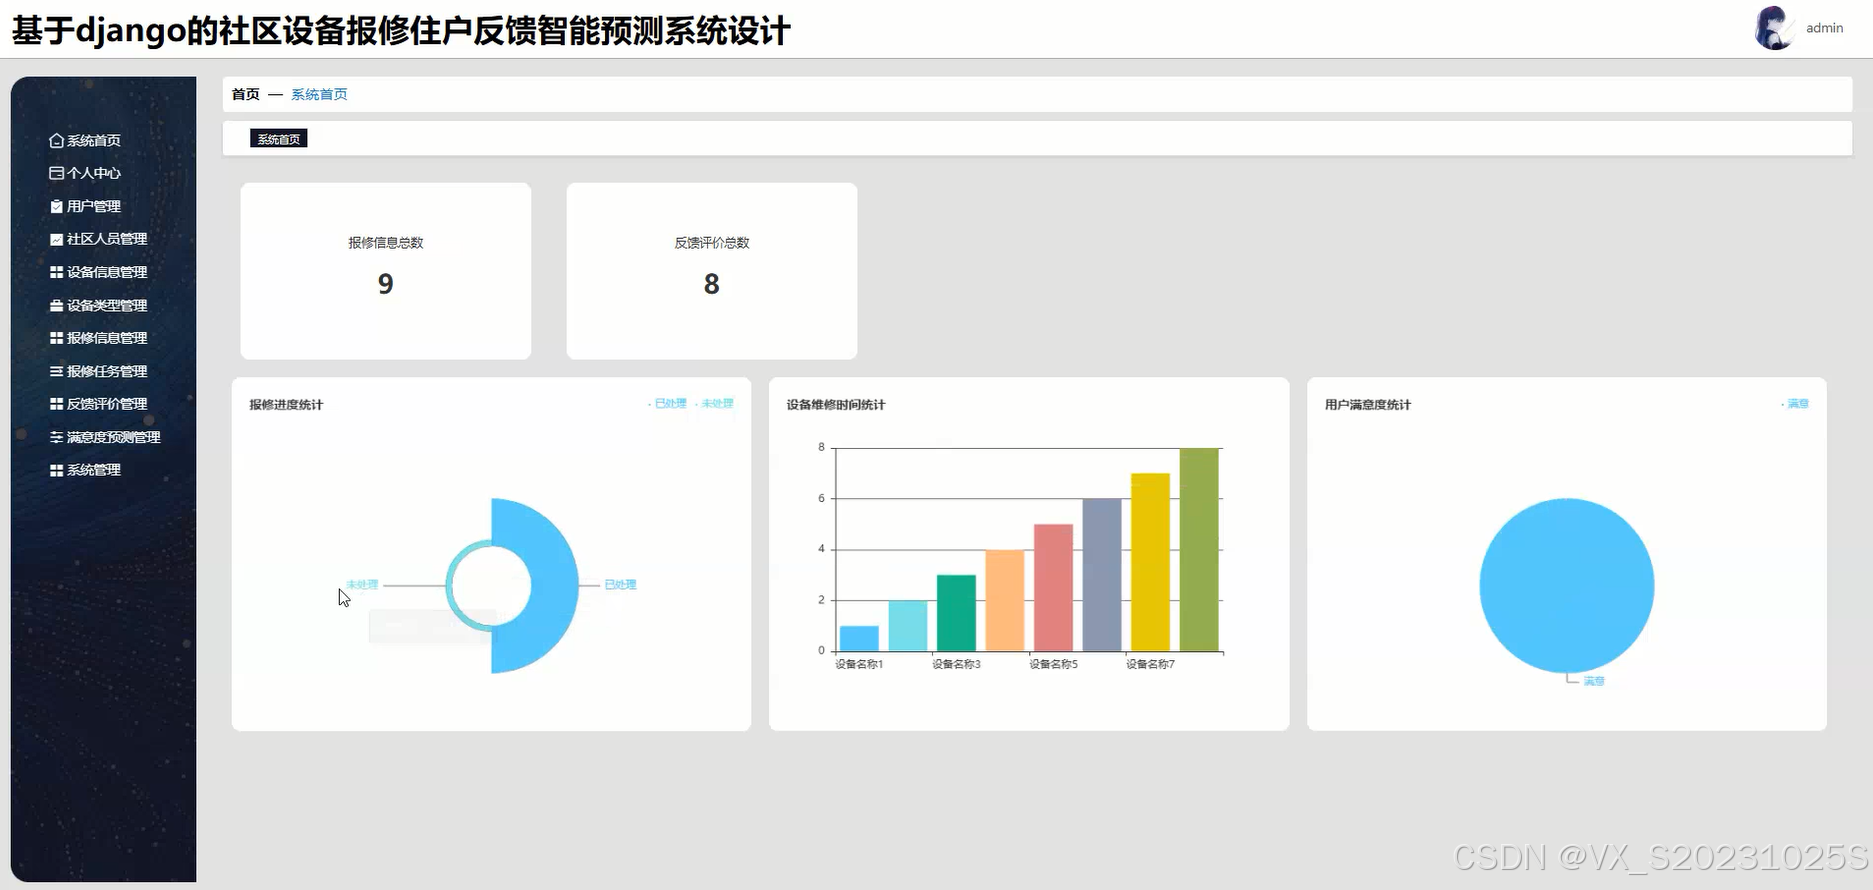
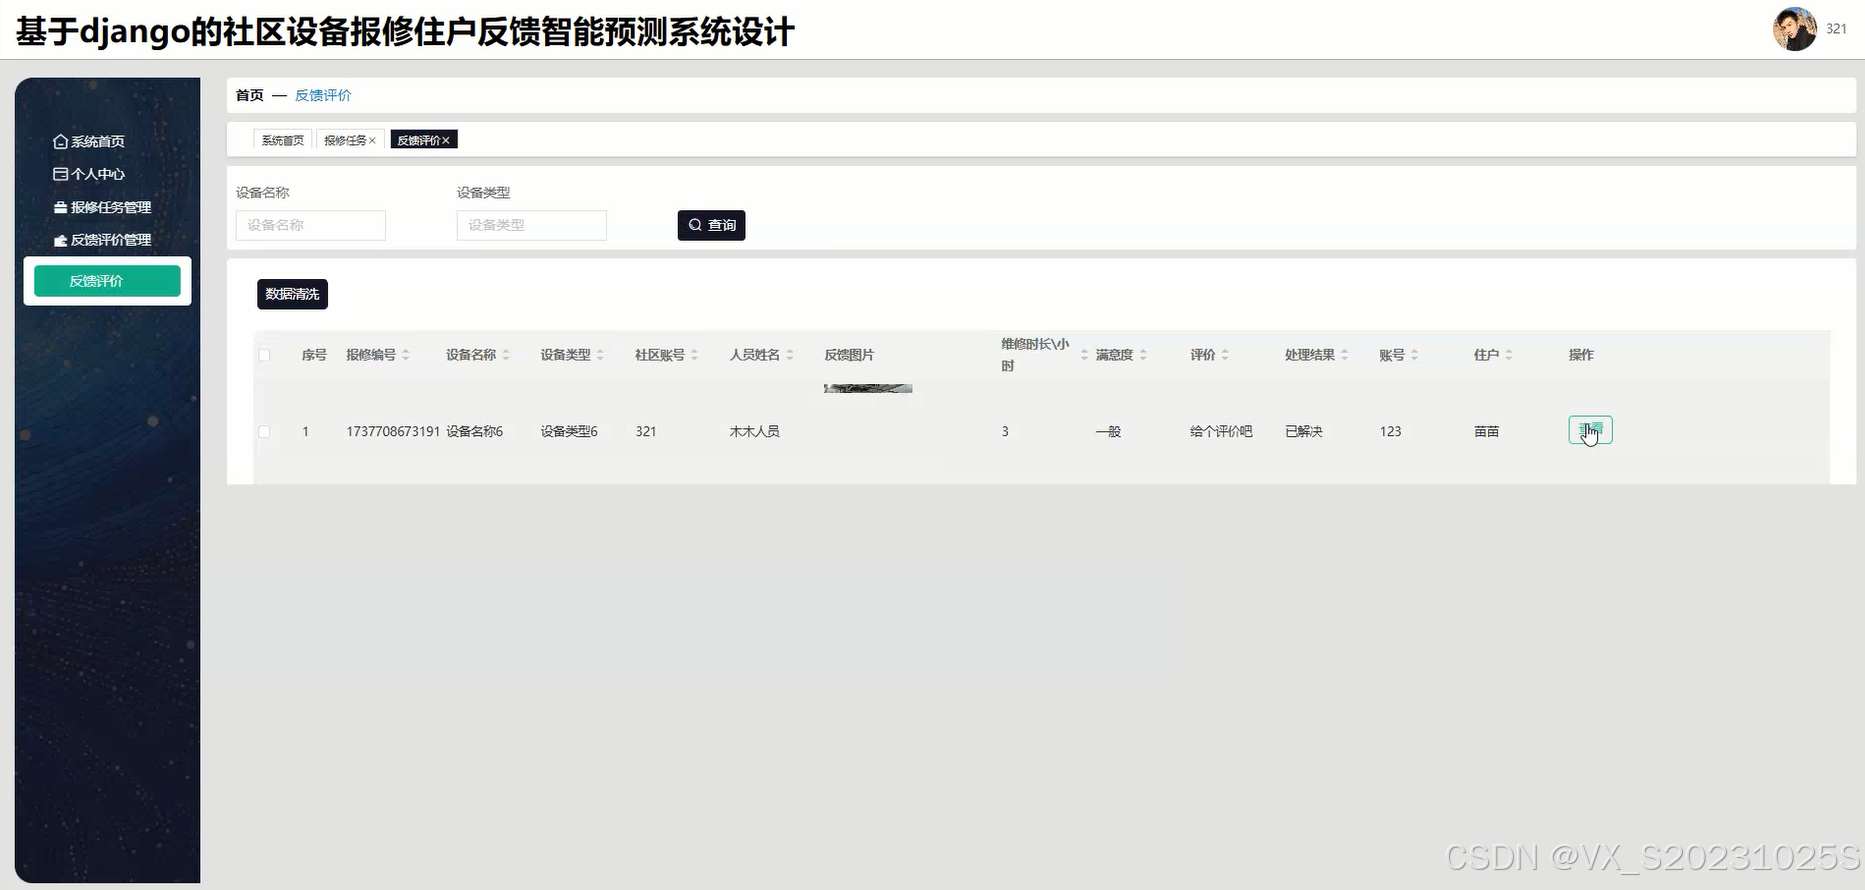
亮点(数据预测、Echarts可视化,智能推荐,数据清洗,数据预测)
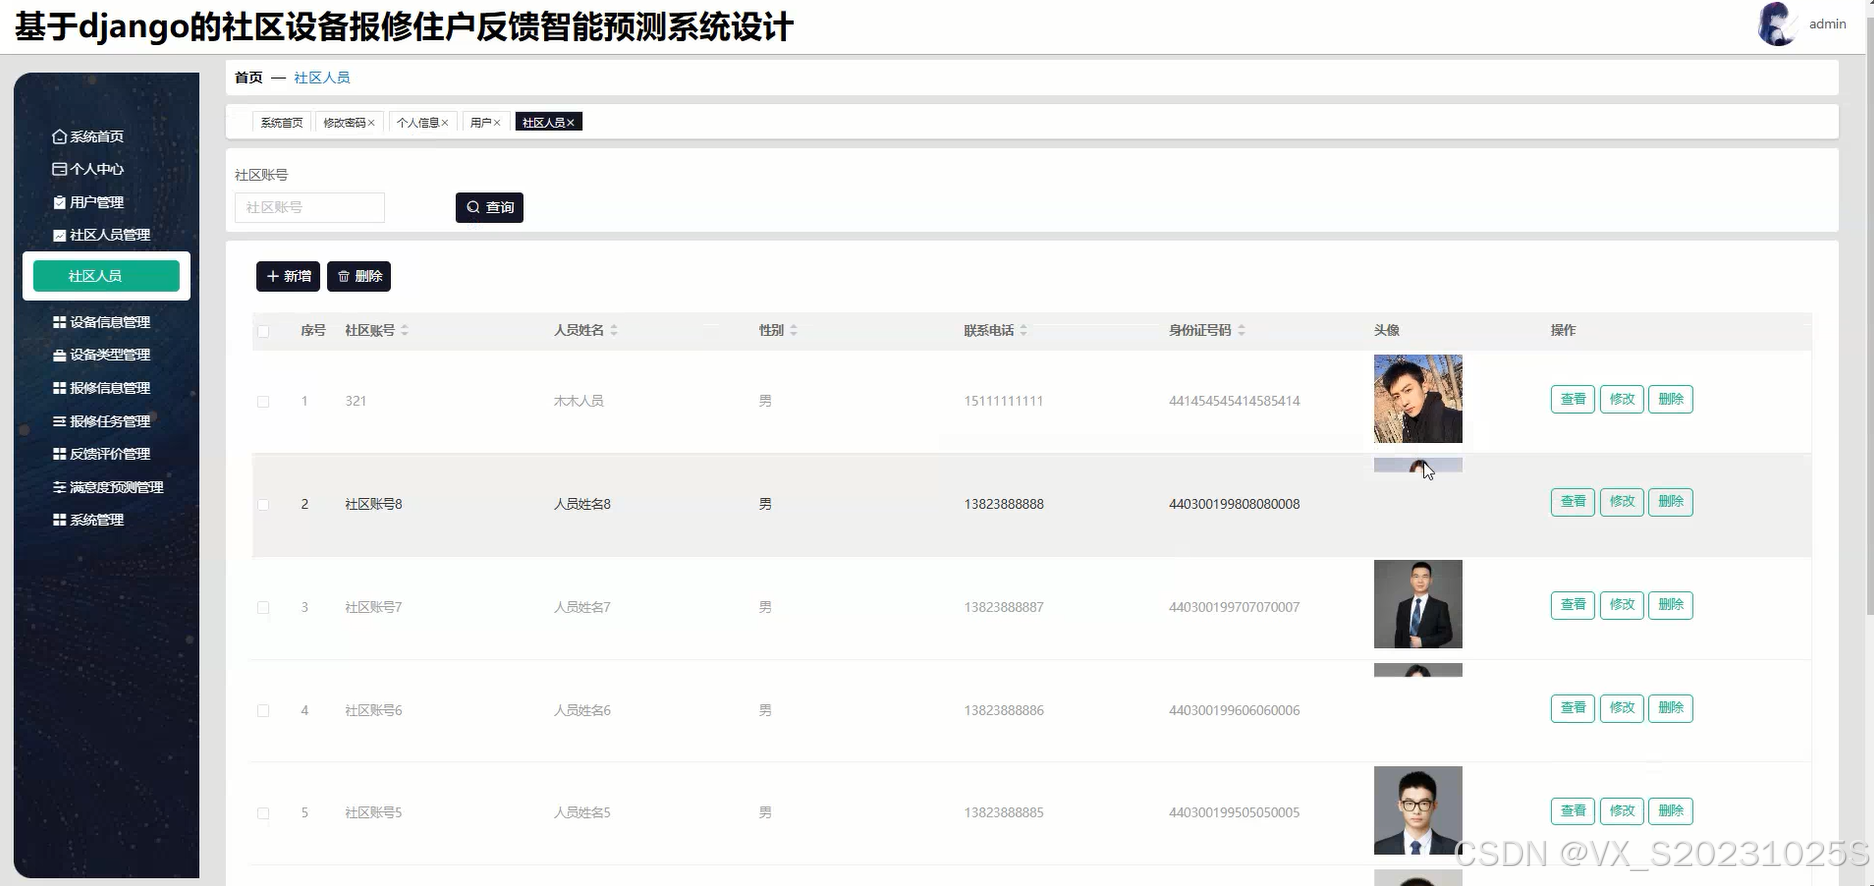
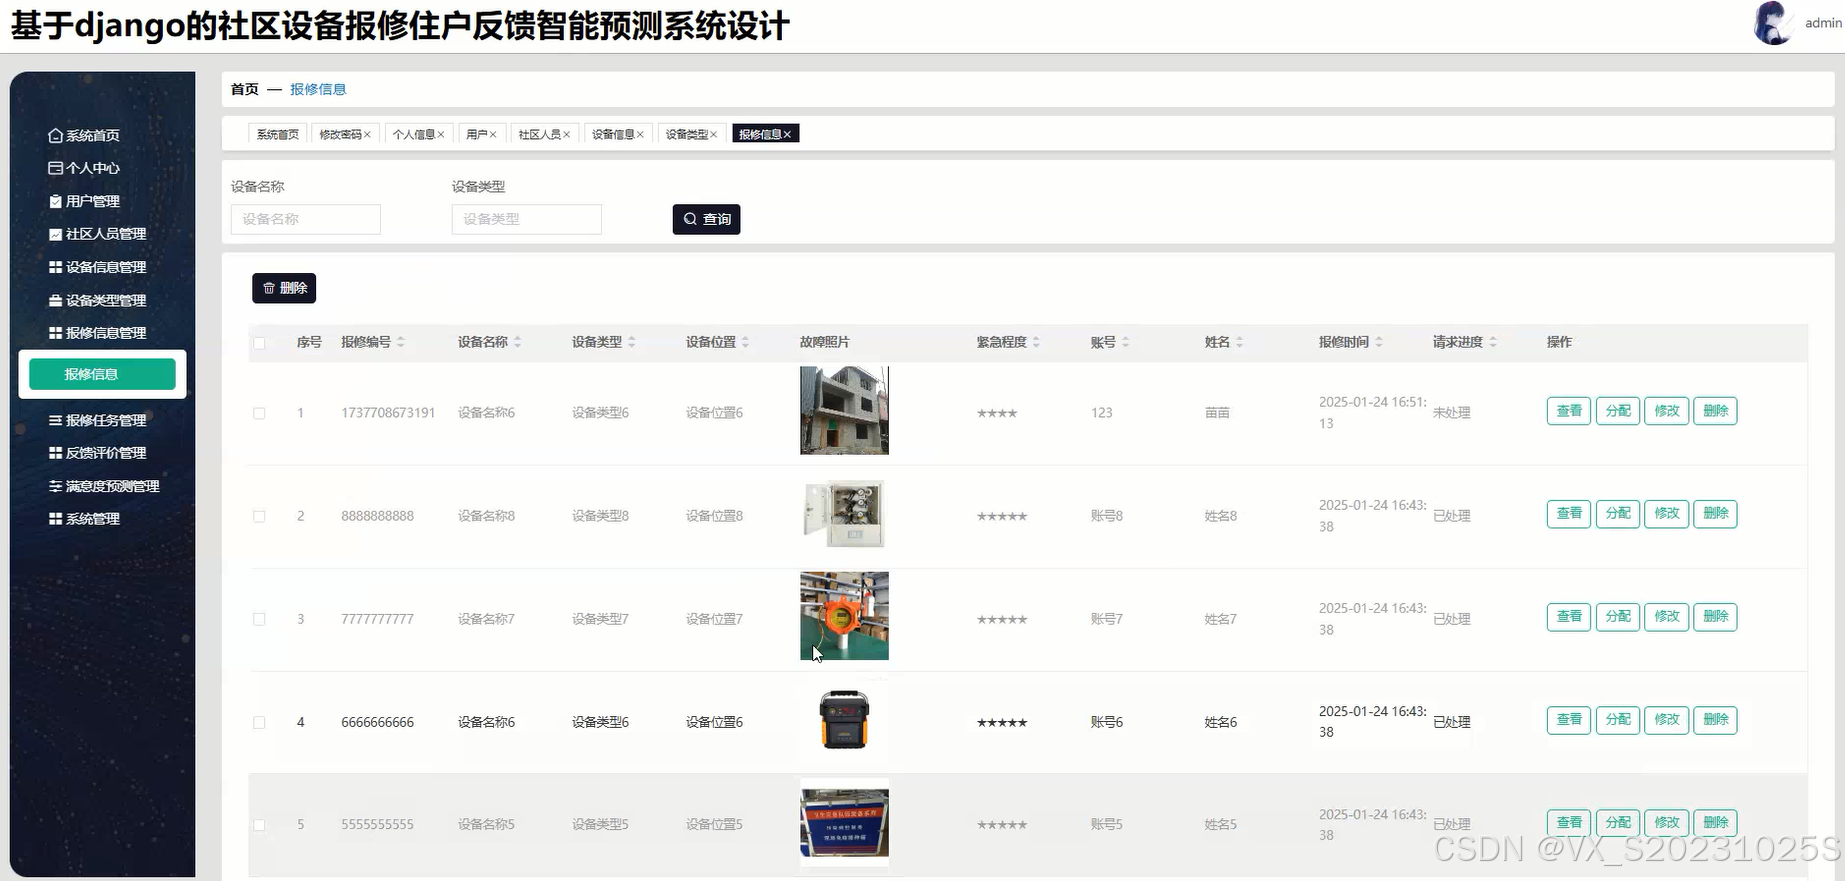
1、数据管理:后台信息列表展示。
2、数据存储:mysql数据库。
3、数据可视化:Echarts可视化图表展示
4、数据预测:根据名机器学习决策树算法预测。
5、智能推荐:根据用户浏览量或收藏量推荐
04图片展示
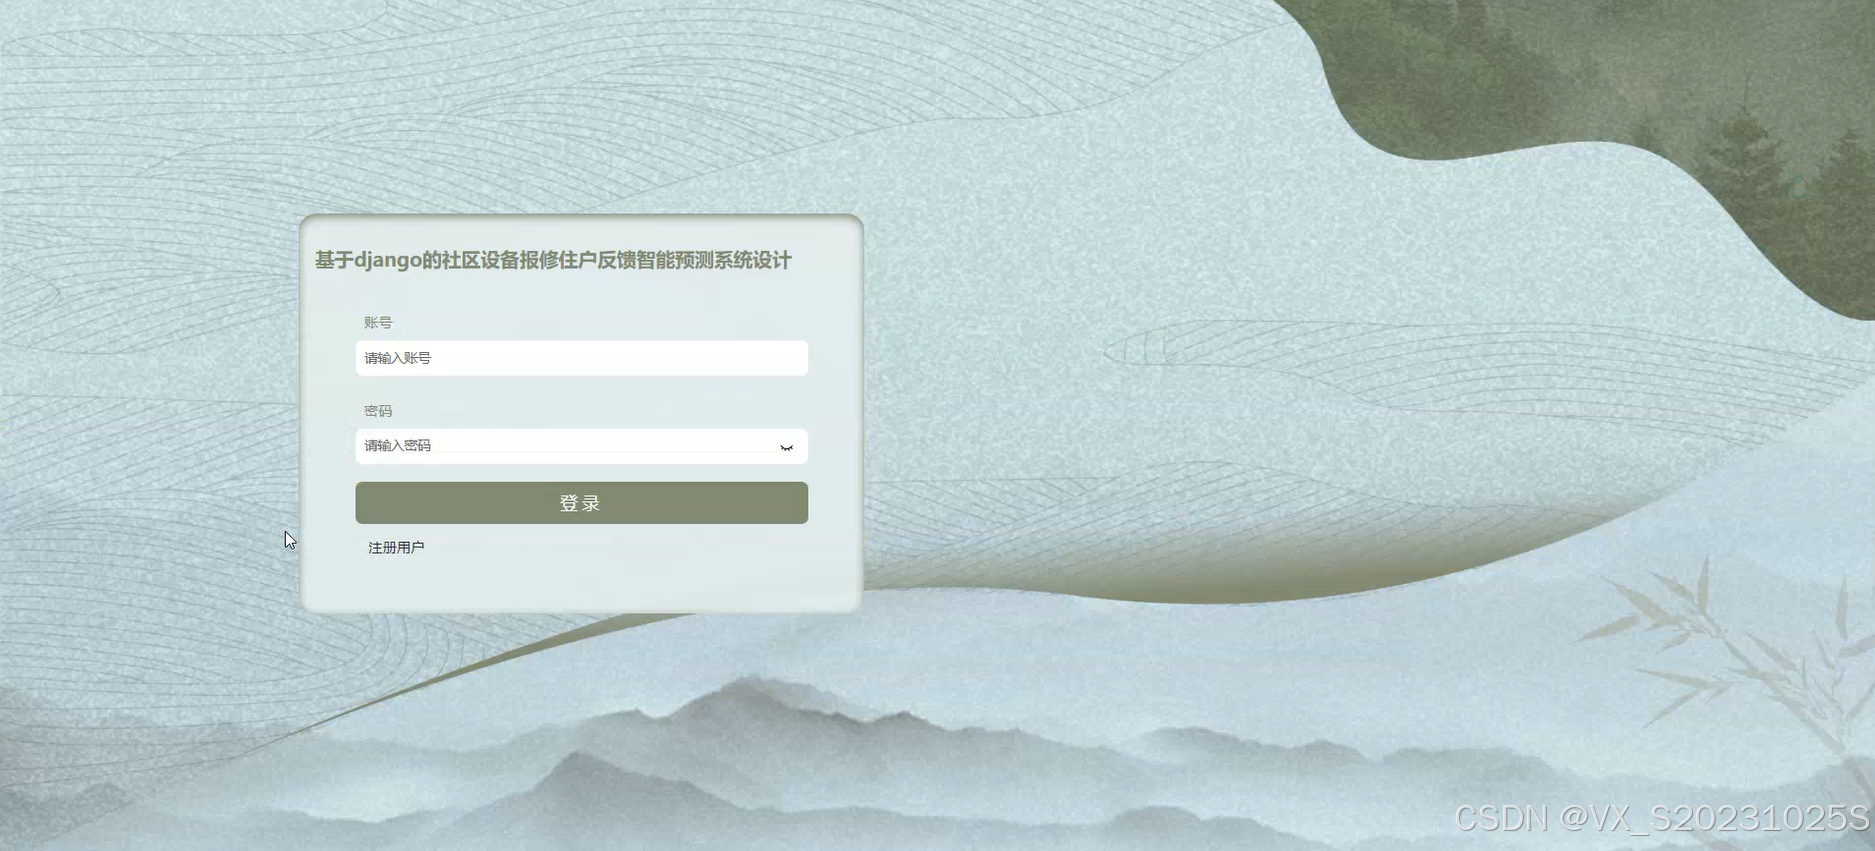
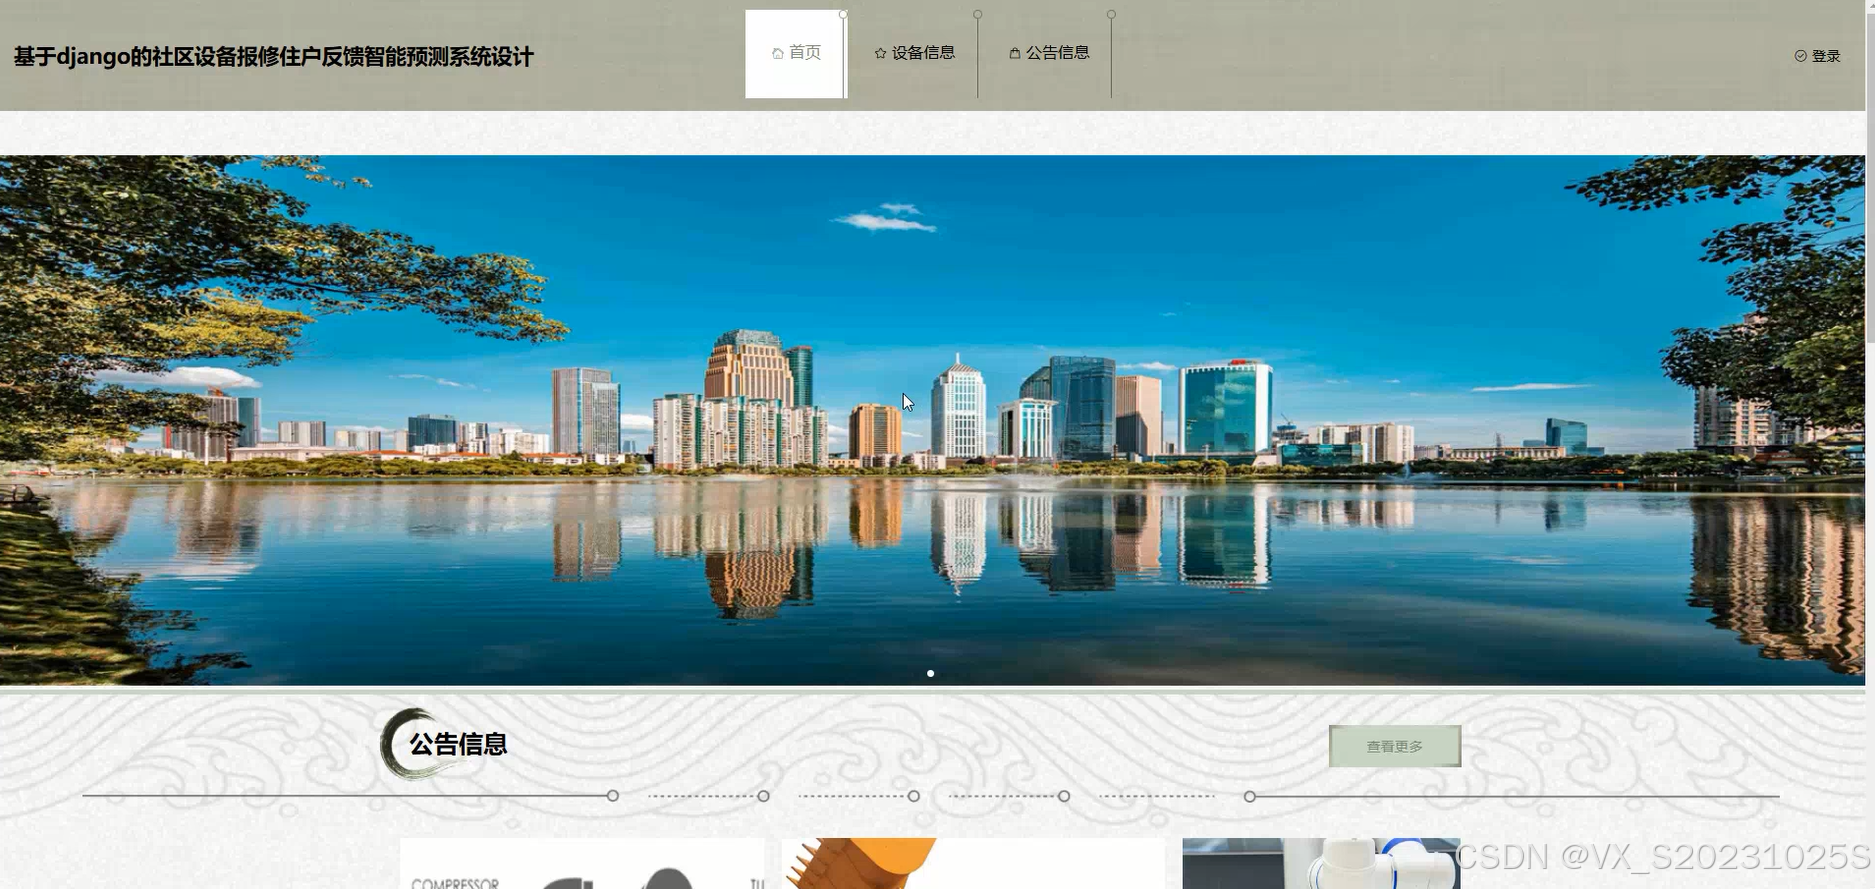
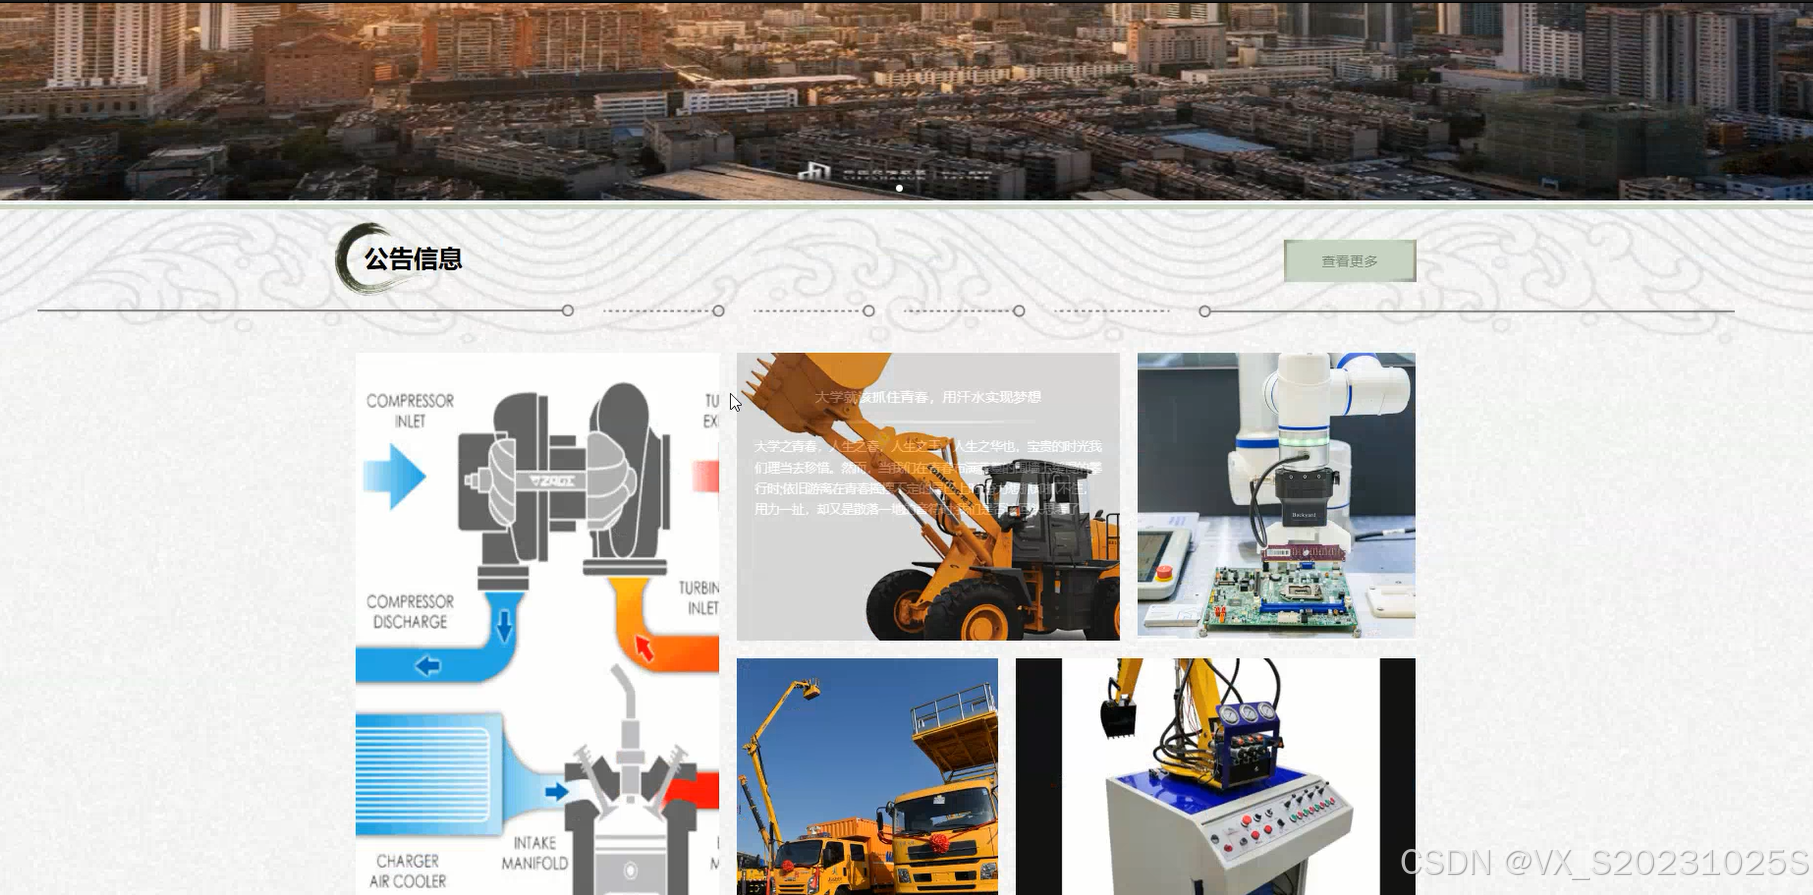
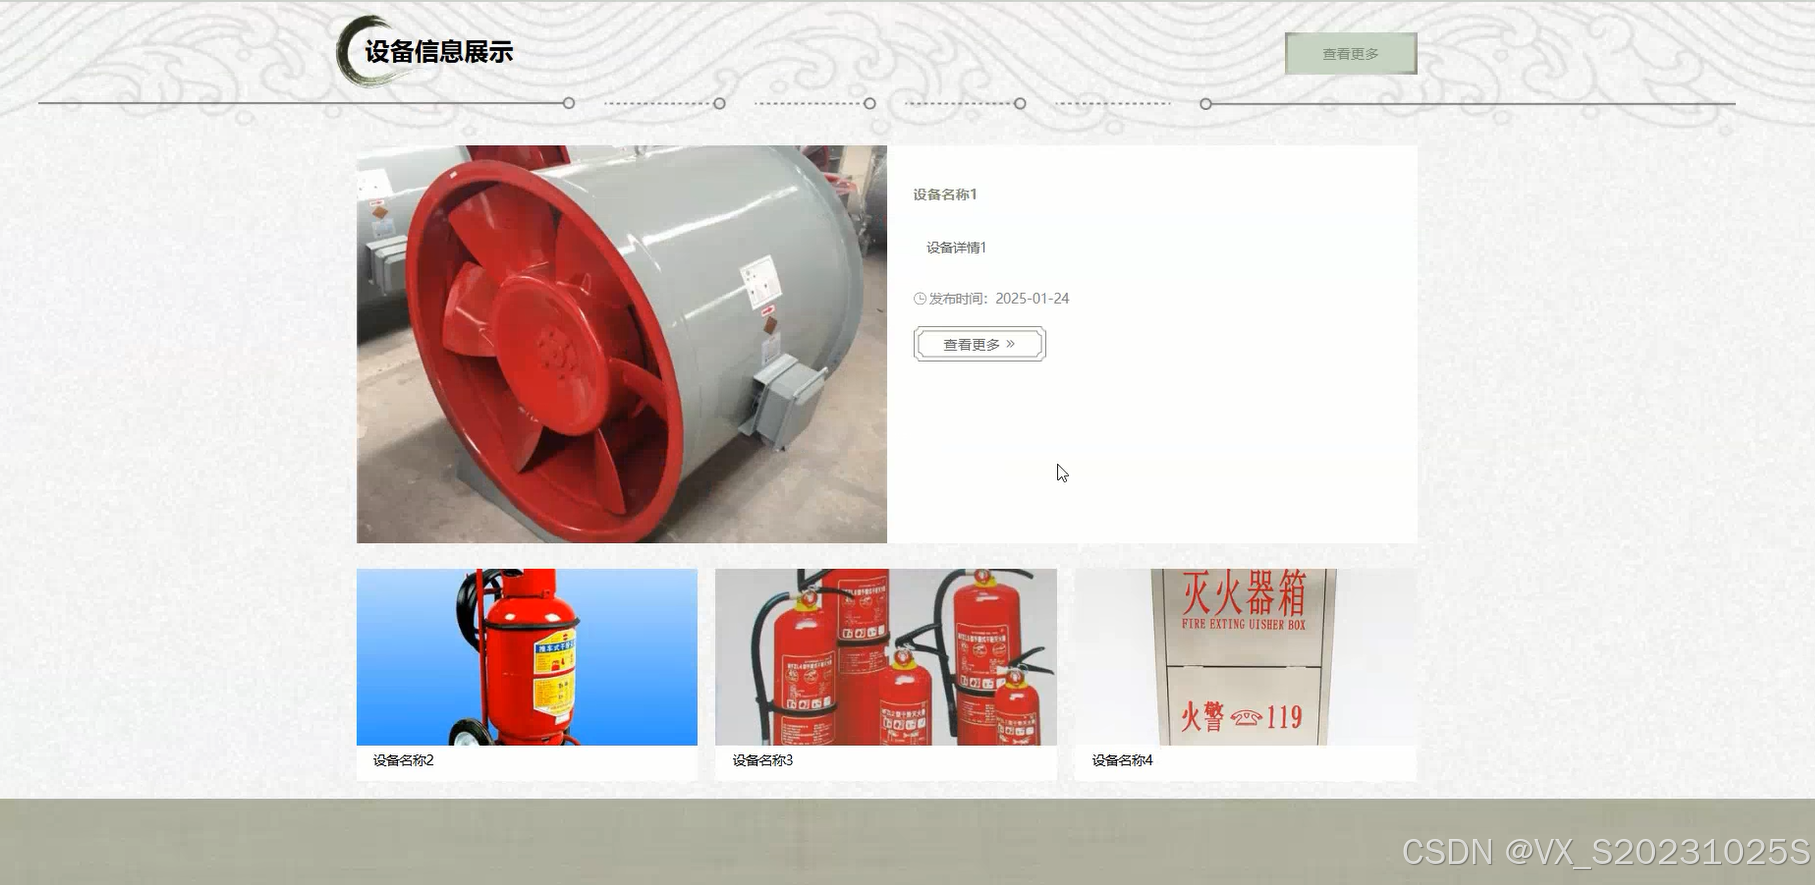
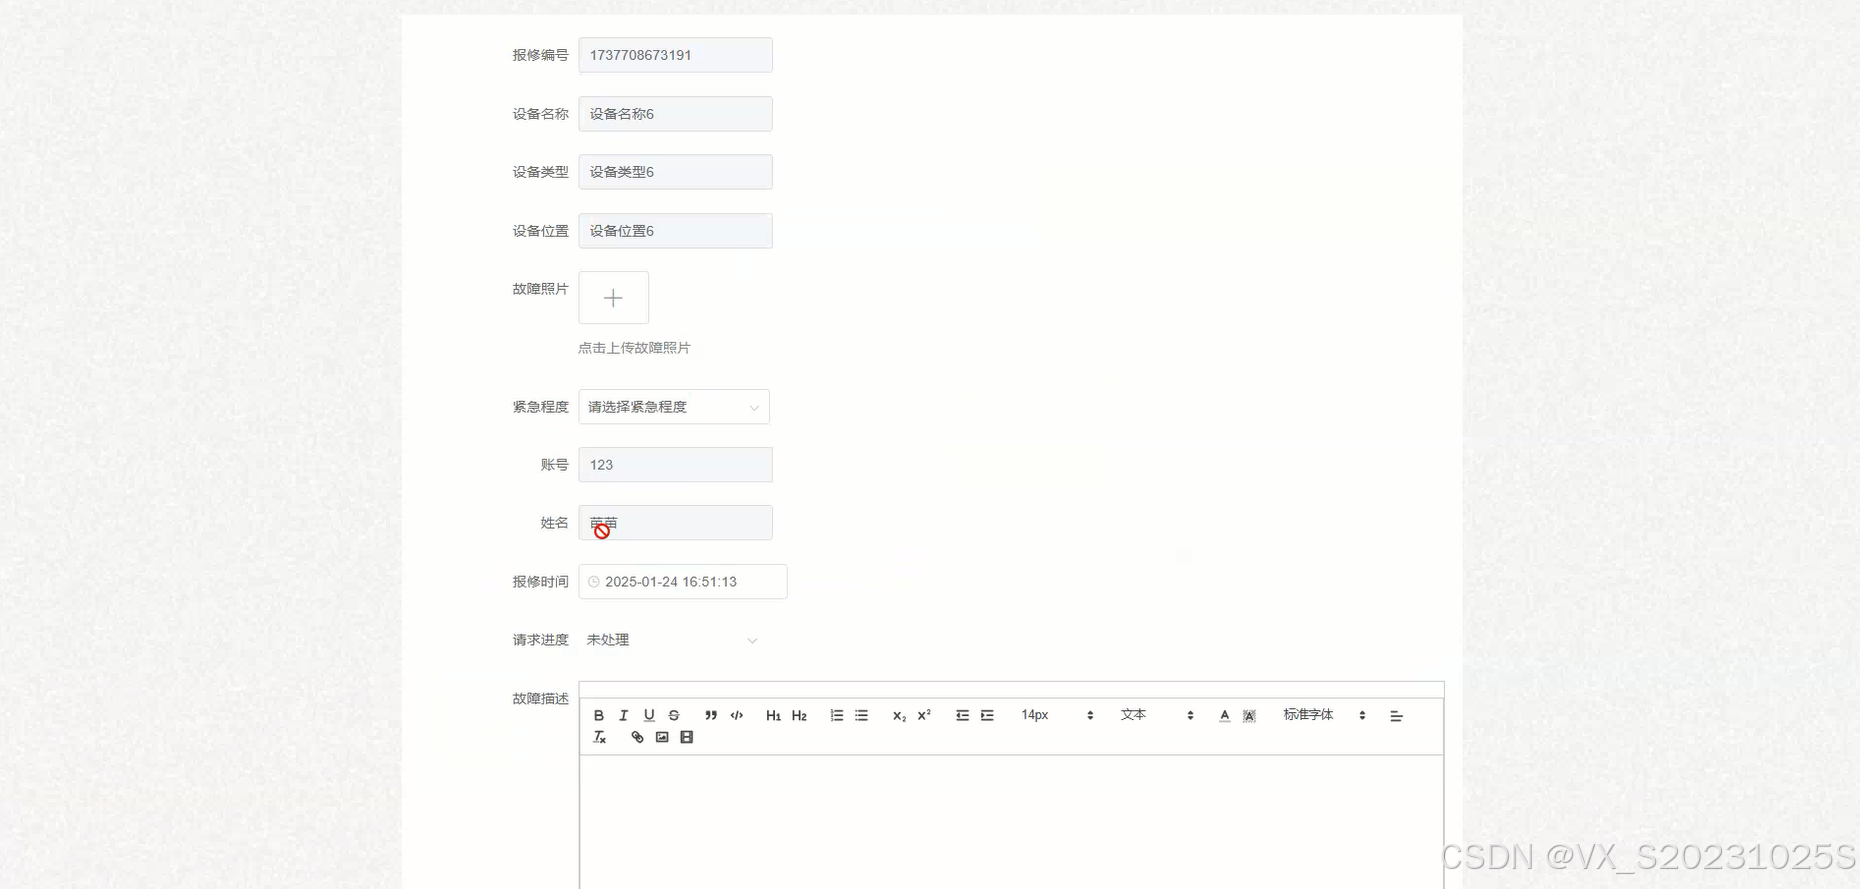
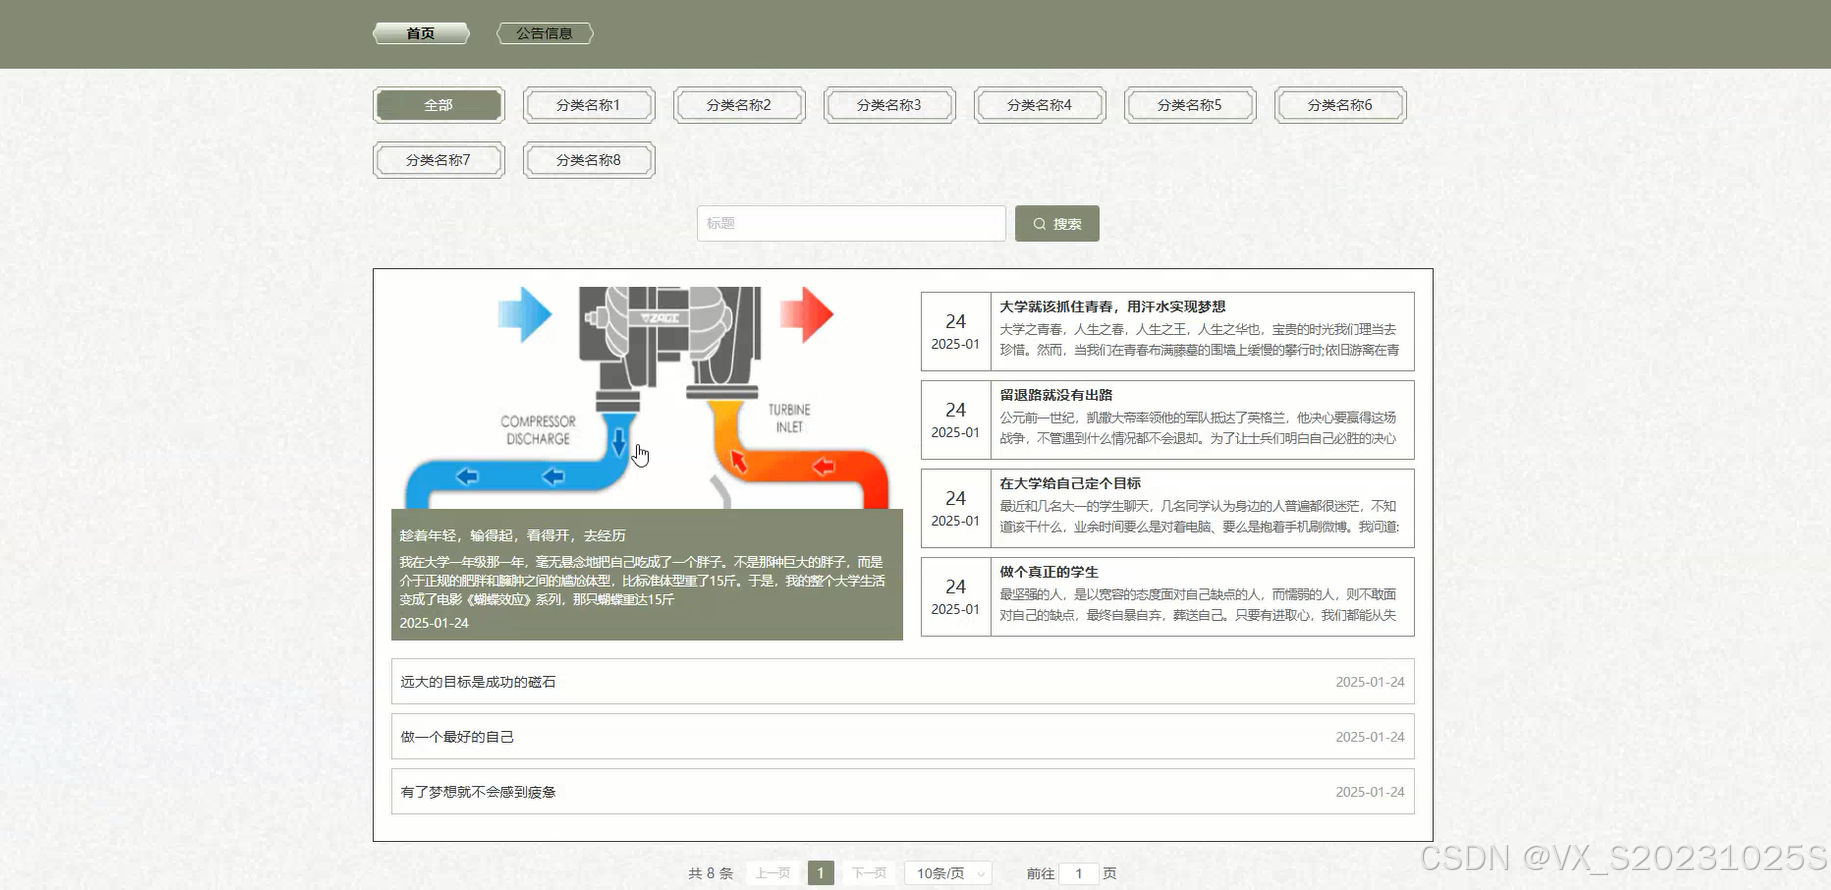
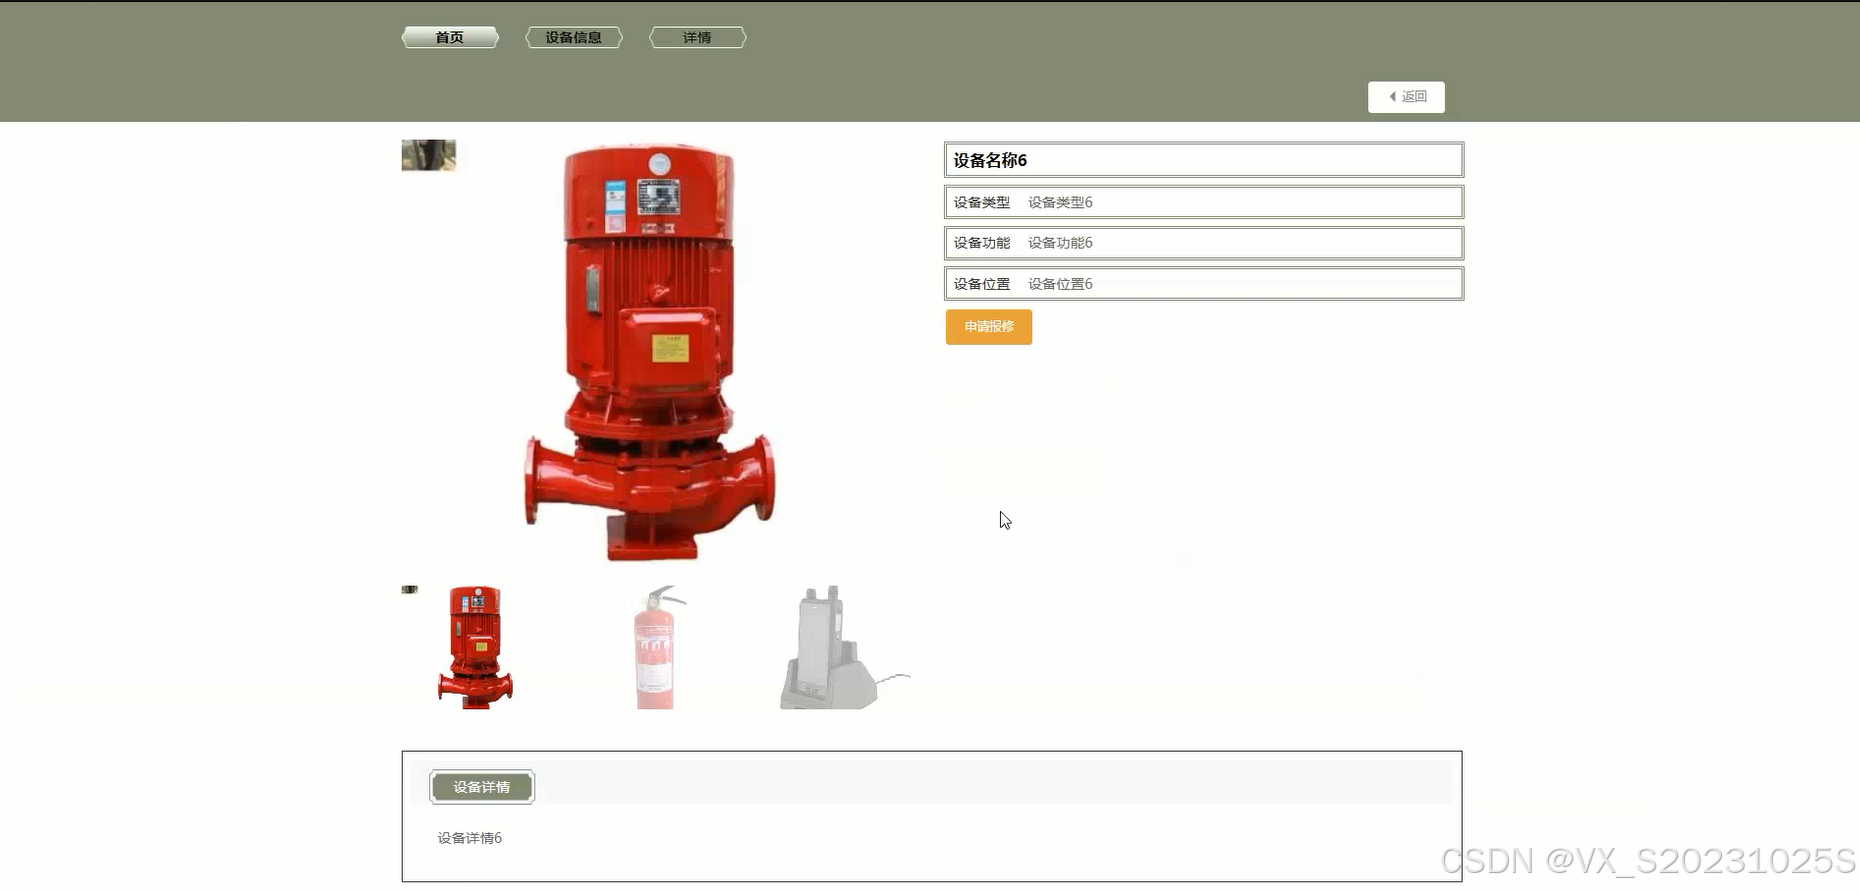
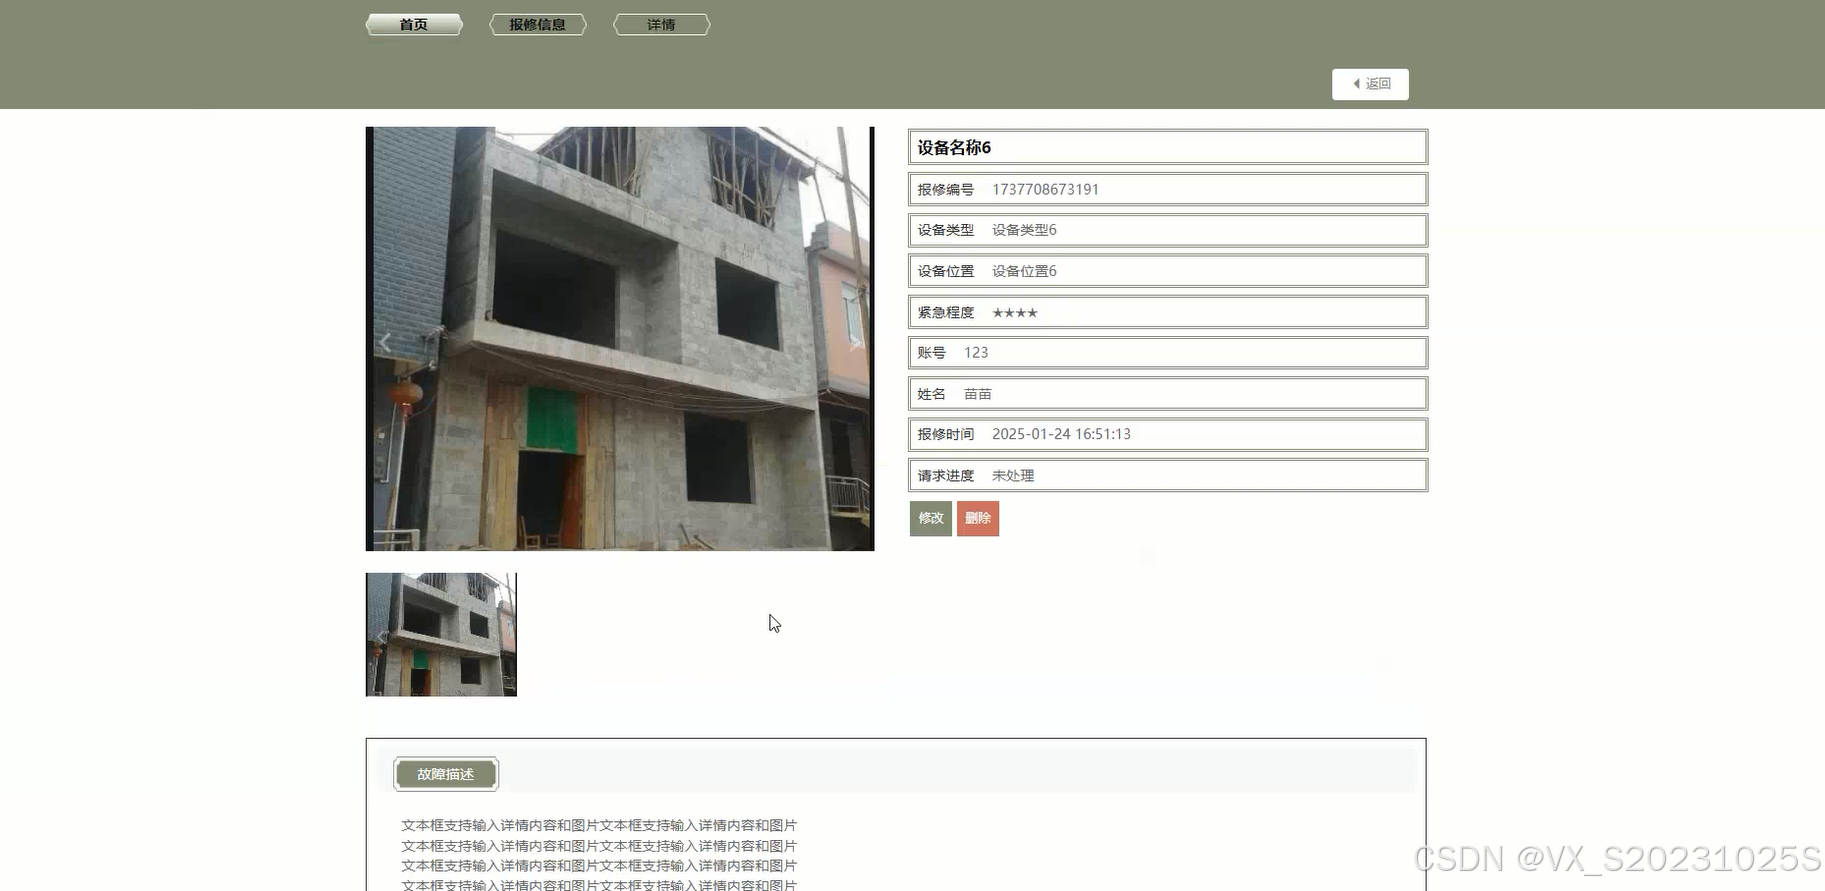
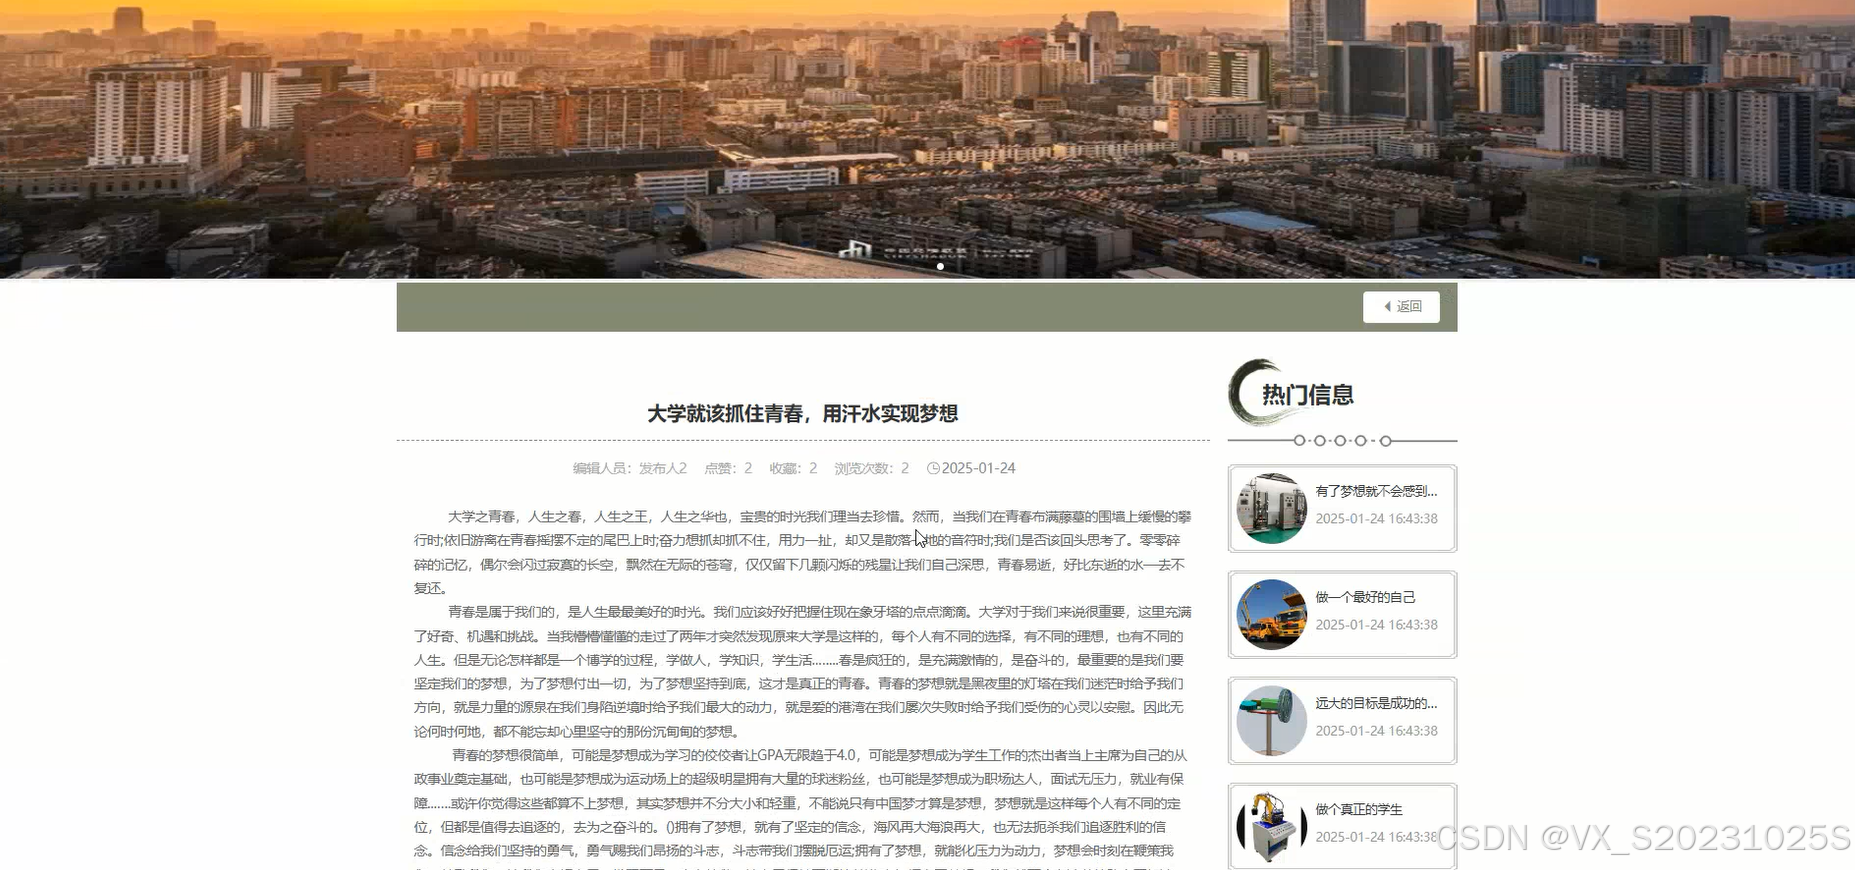
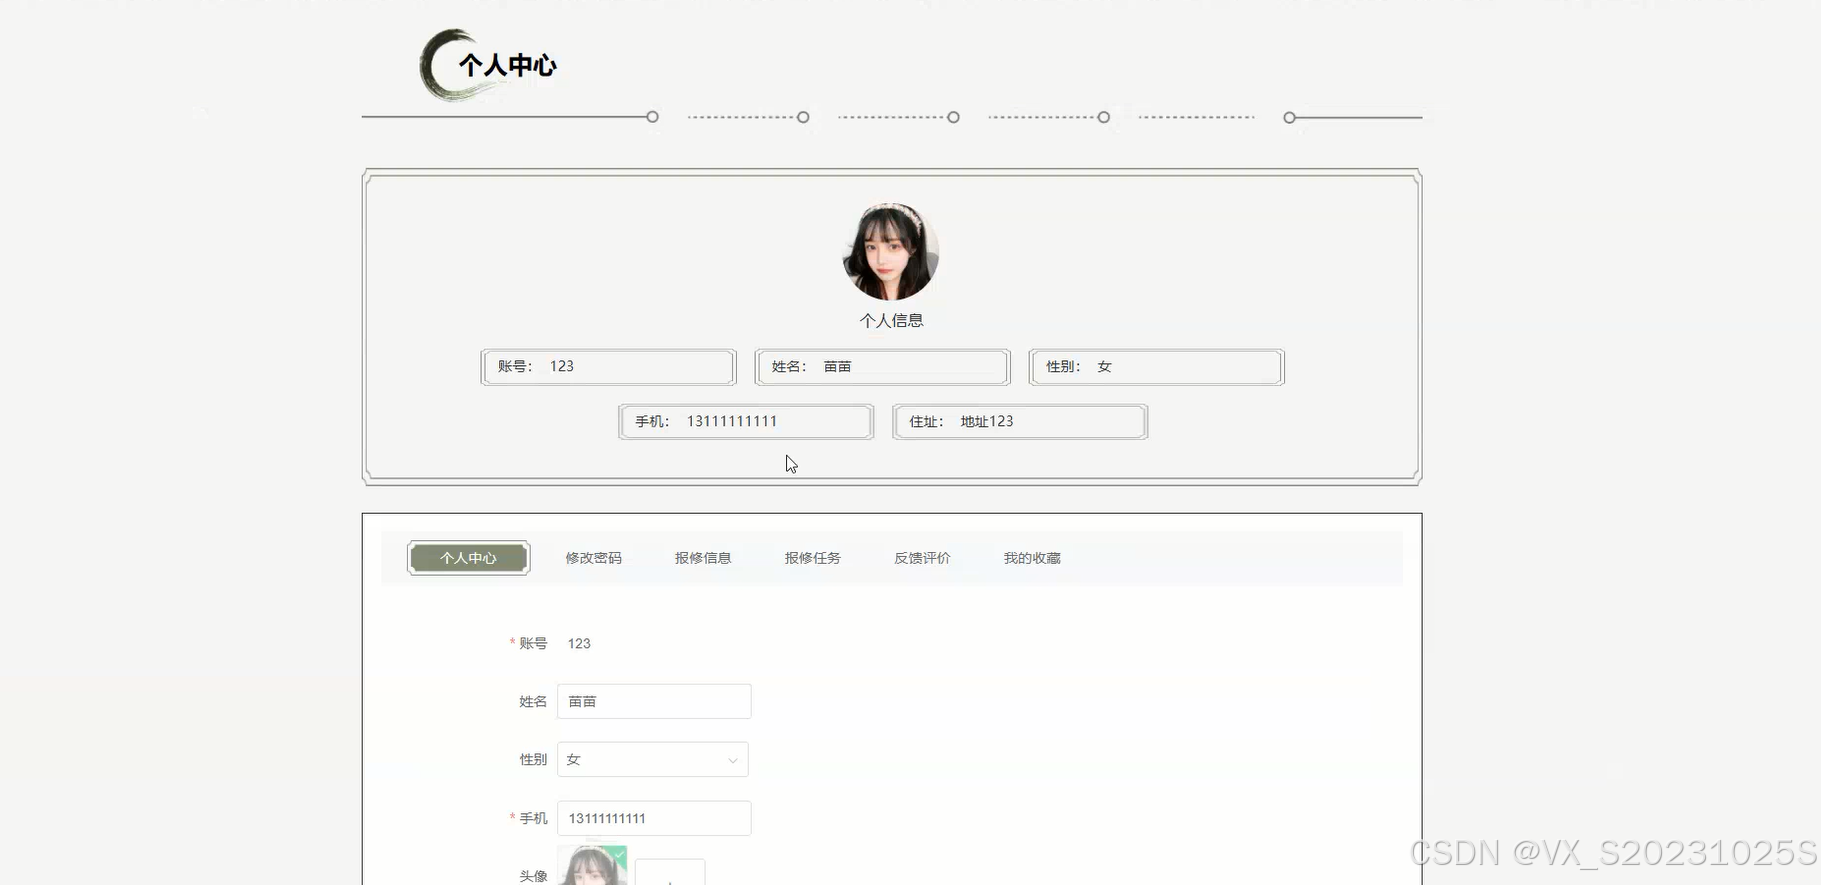
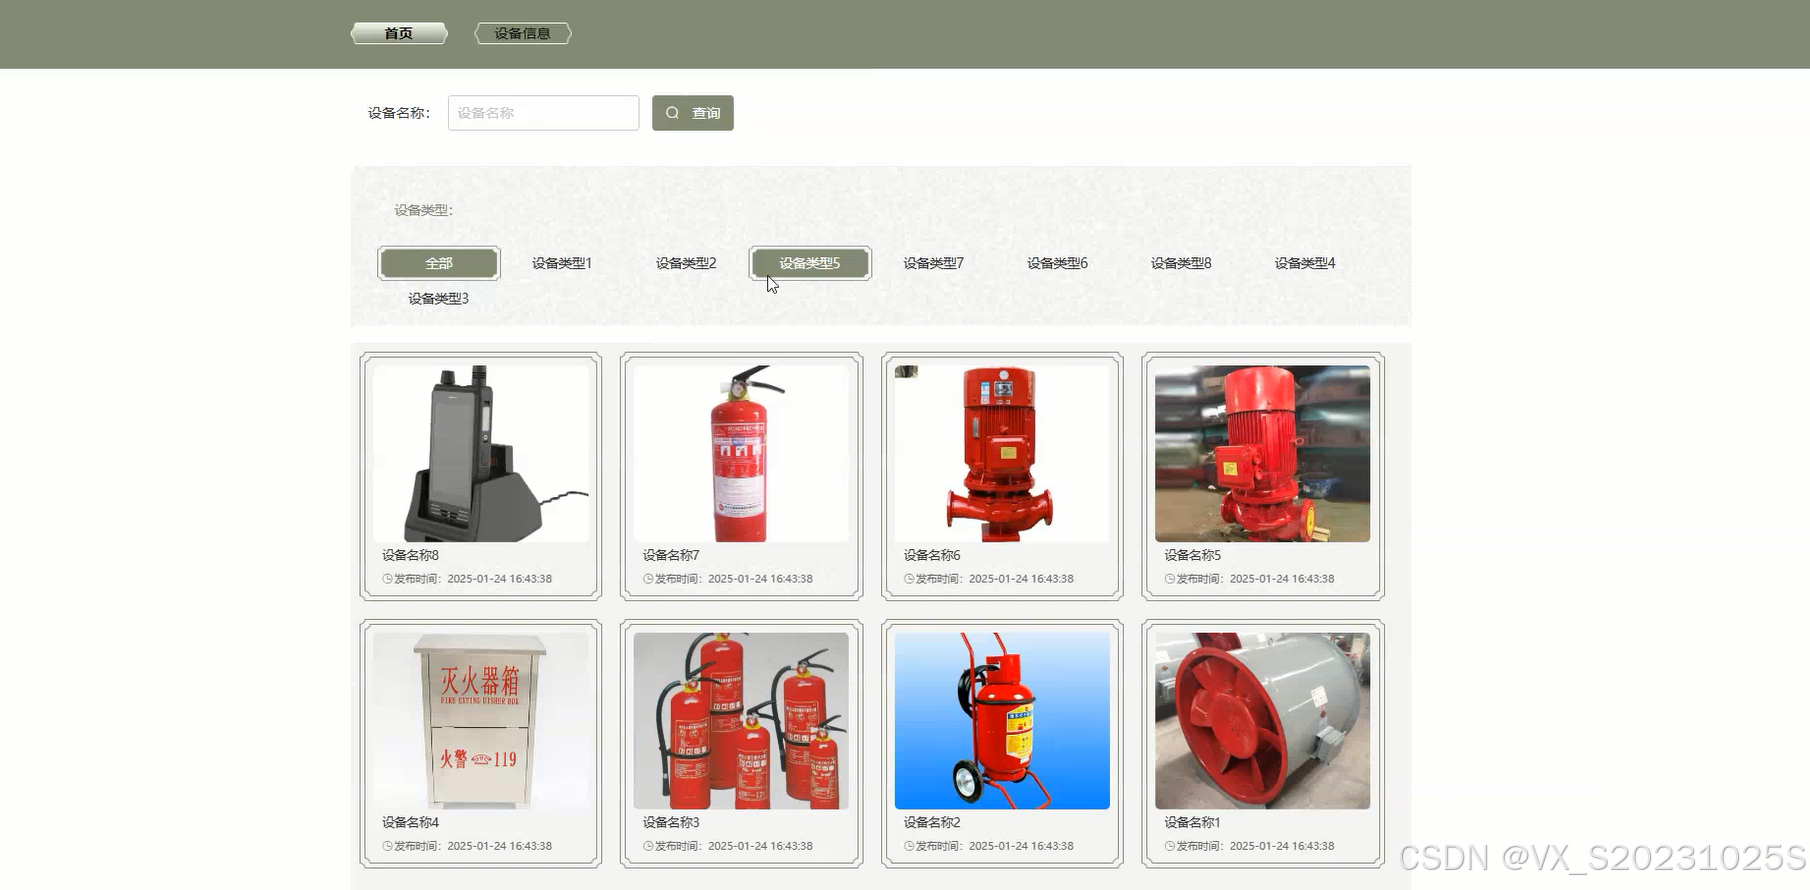
后台管理系统
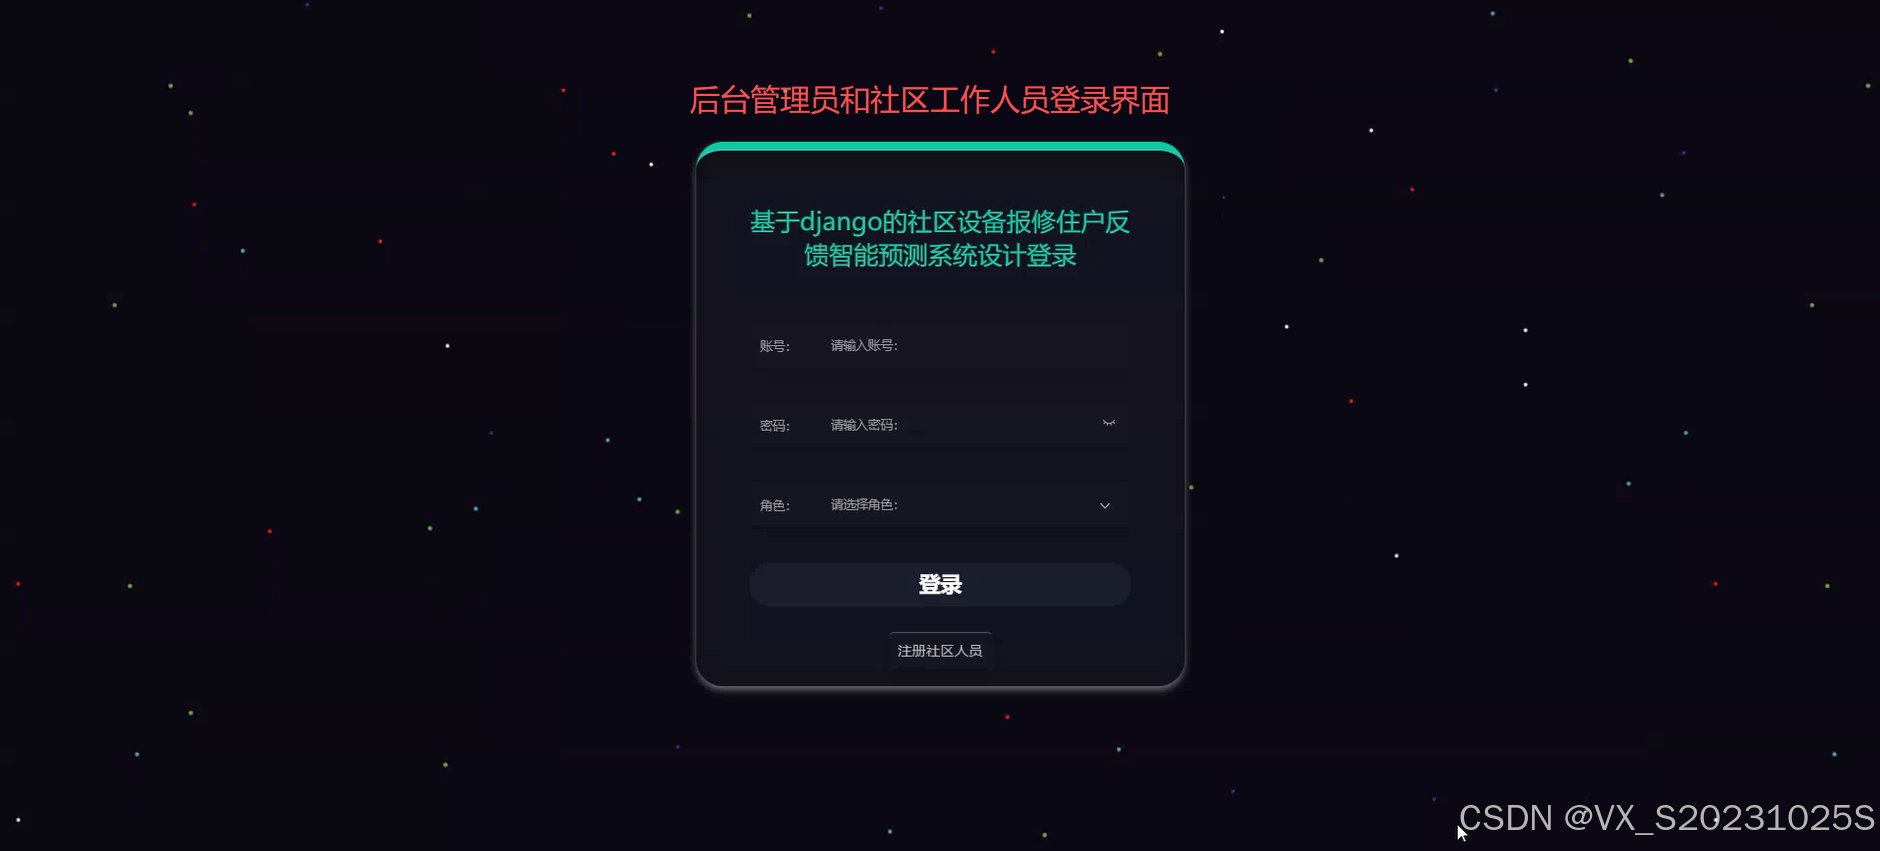
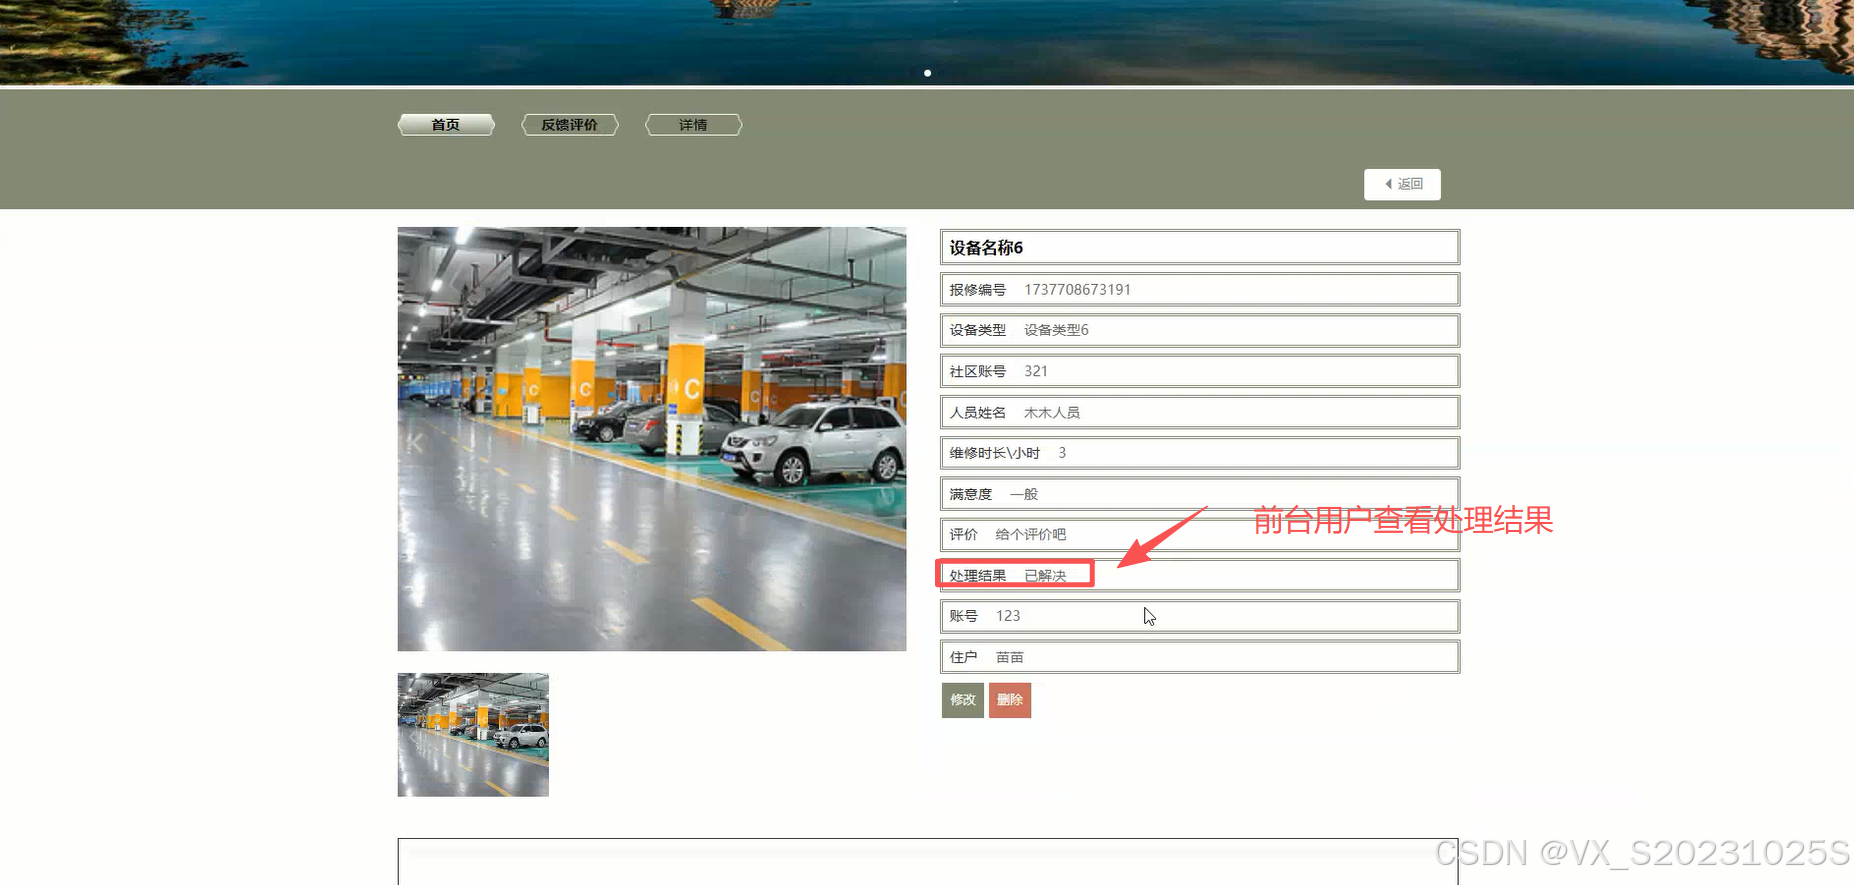
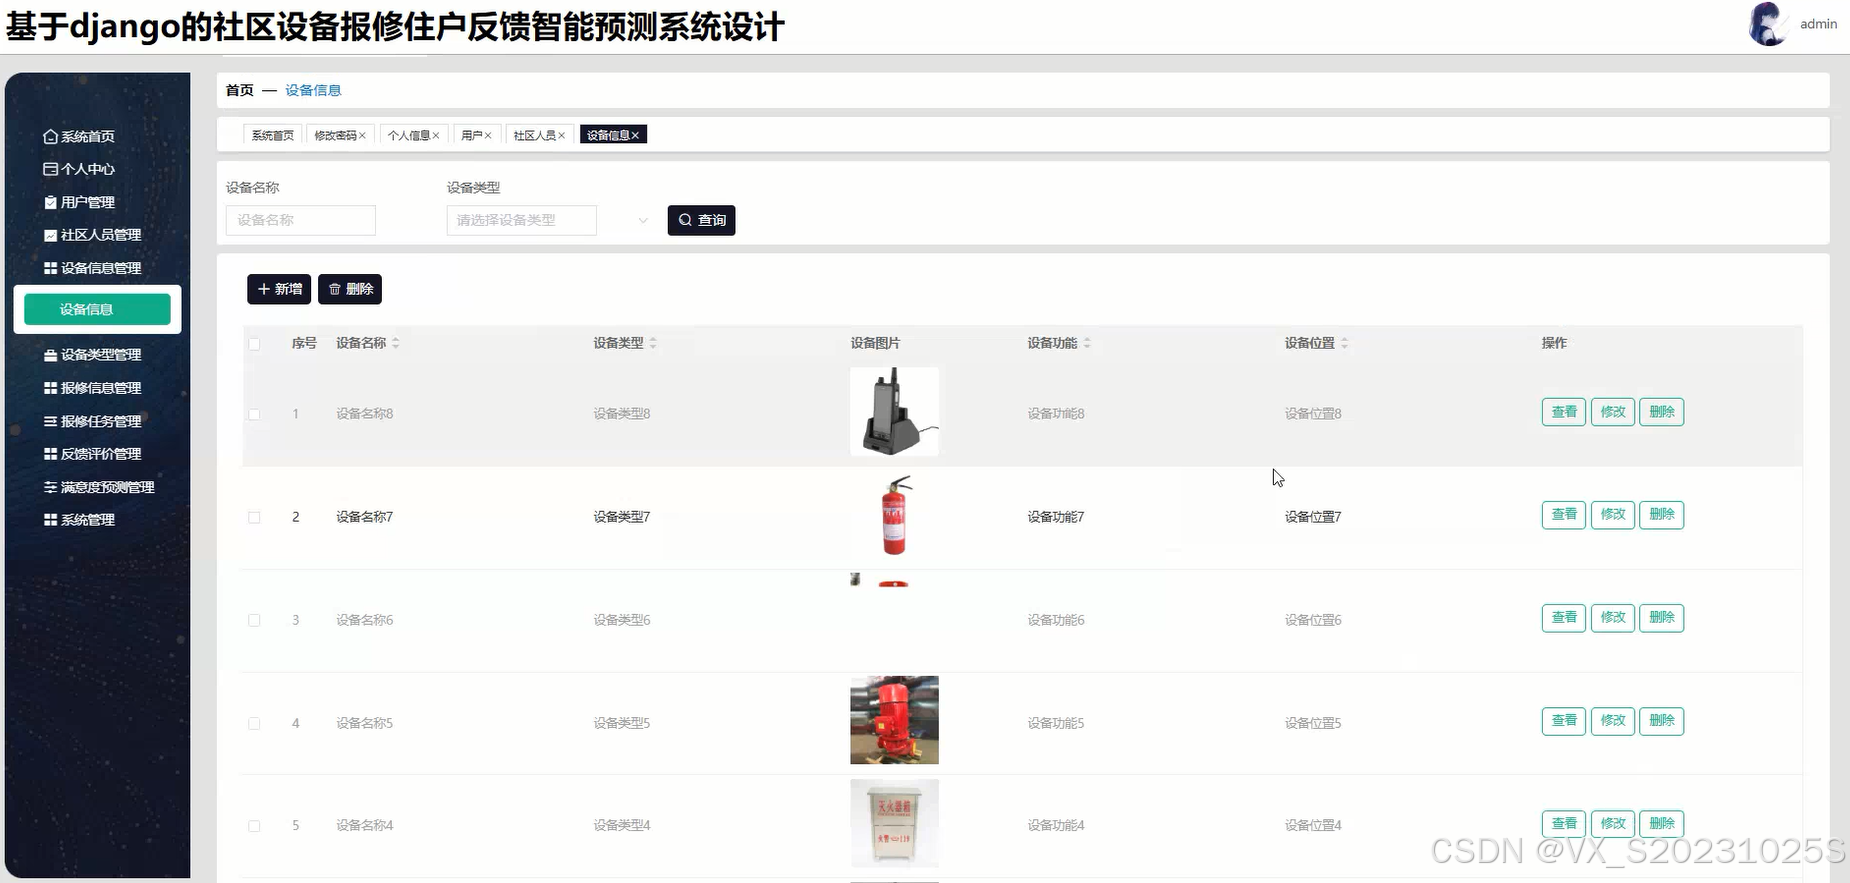
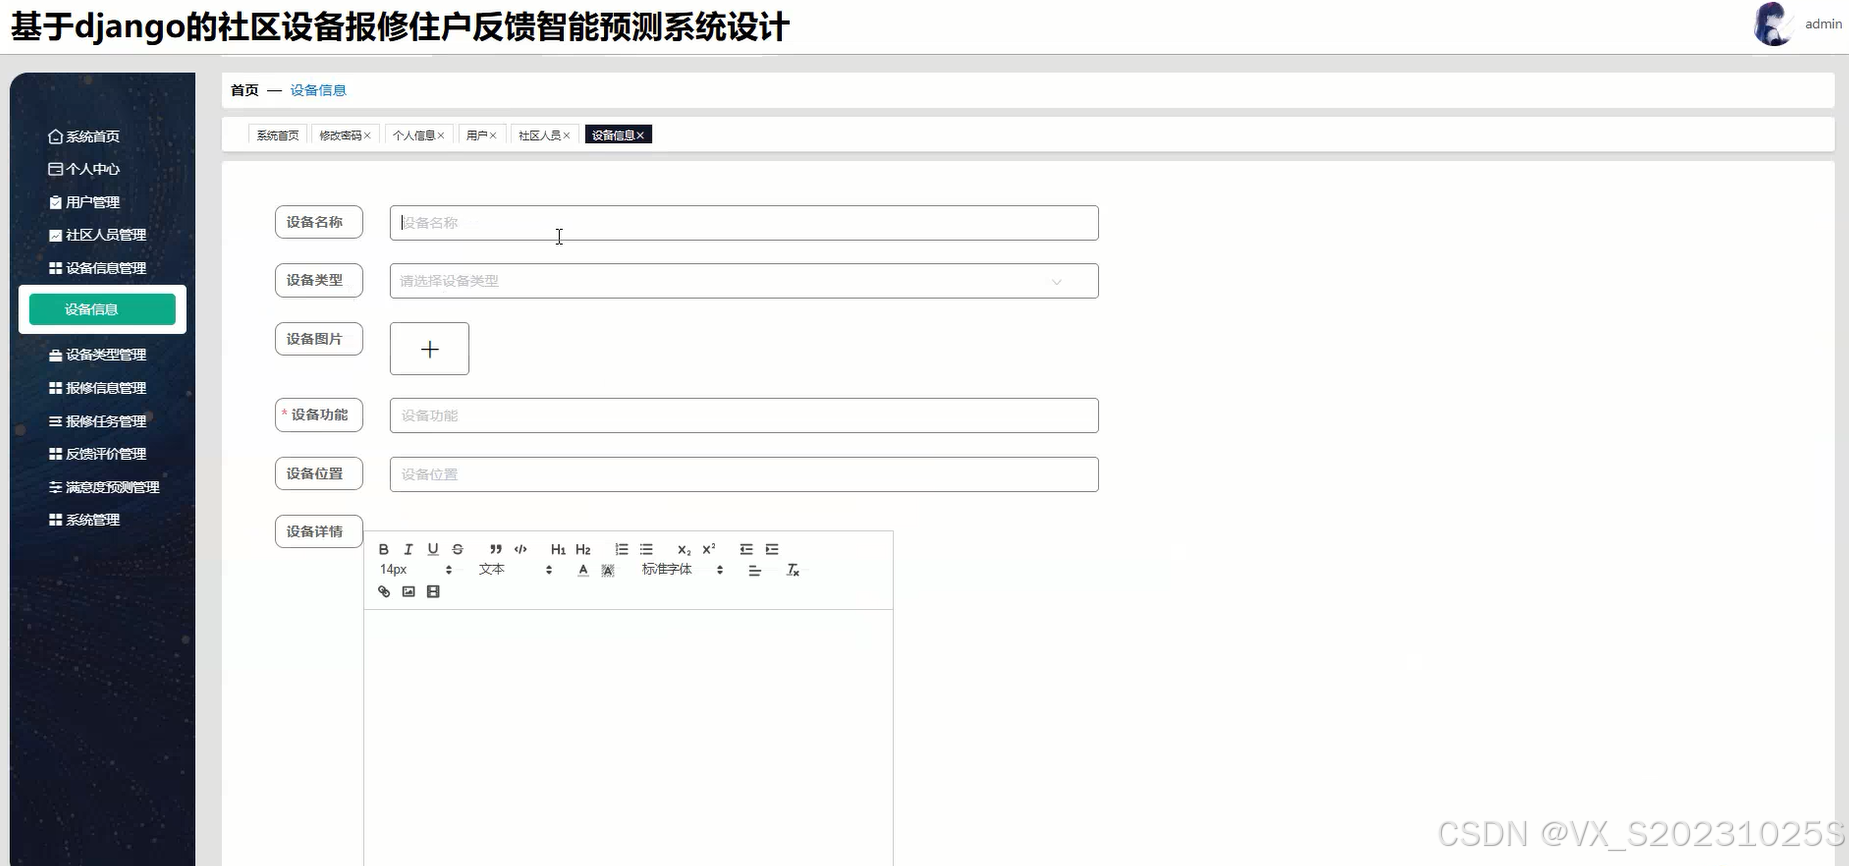
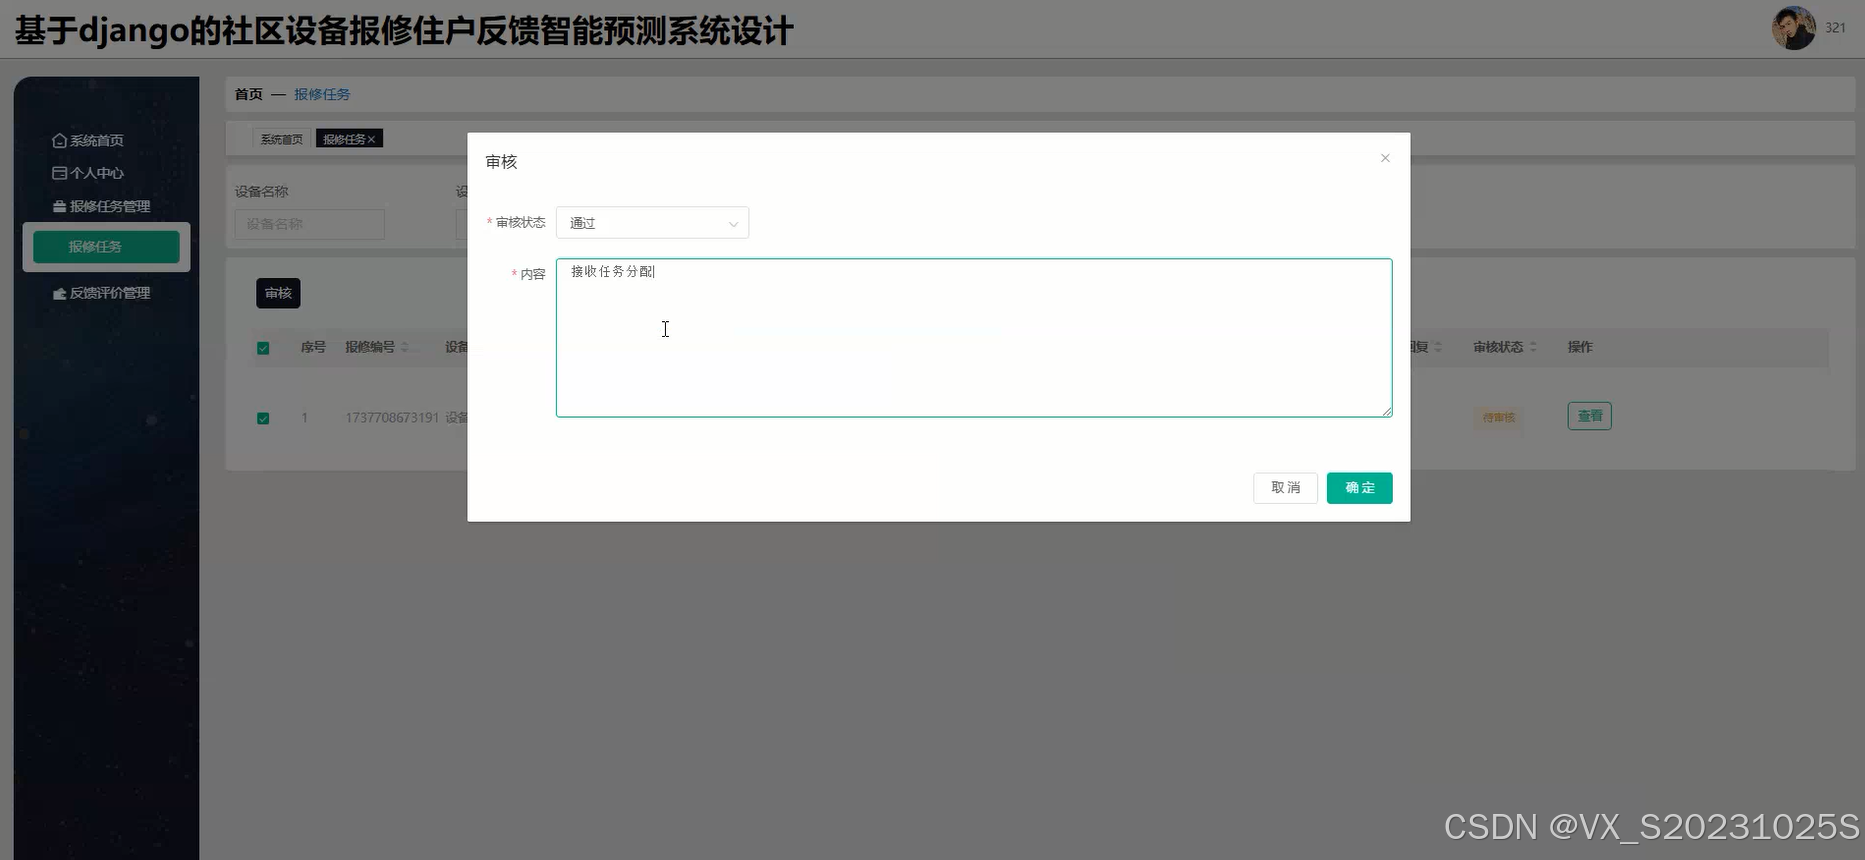
05系统文档、代码展示
5.1 系统文档
5.2 代码展示
#决策树预测代码(交流学习+vx:S20231025S )
def to_forecast(data,req_dict,value):
    if len(data) < 5:
        print(f"的样本数量不足: {len(data)}")
        return pd.DataFrame()
    #3.处理特征值和目标值
    labels={}
    for key in data.keys():
        if pd.api.types.is_string_dtype(data[key]):
            label_encoder = LabelEncoder()
            labels[key] = label_encoder
            data[key] = label_encoder.fit_transform(data[key])
    #4.数据集划分
    X = data[[
        'shebeiming',
        'weixiushichang',
    ]]
    y = data[[
        'score',
    ]]
    x_train, x_test, y_train, y_test = train_test_split(X, y,test_size=0.2, random_state=22)
    #5.构建预测特征值
    #根据输入的特征值去预测
    if req_dict:
        req_dict.pop('addtime',None)
        future_df = pd.DataFrame([req_dict])
        for key in future_df.keys():
           if key in labels:
               encoder = labels[key]
               values = future_df[key][0]
               try:
                   values = encoder.transform([values])[0]
               except ValueError as e: #处理未见过的标签
                   values = np.array([encoder.transform([v])[0] if v in encoder.classes_ else -1 for v in values]).sum()
               future_df[key][0] = values
    else:
        future_df = x_test
    #特征工程-标准化
    transfer = DictVectorizer(sparse=False)
    x_train = transfer.fit_transform(x_train.to_dict(orient="records"))
    x_test = transfer.fit_transform(x_test.to_dict(orient="records"))
    future_df = transfer.fit_transform(future_df.to_dict(orient="records"))
    estimator_file = os.path.join(parent_directory, "fankuipingjiaforecast.pkl")
    #6.决策树模型训练和模型评估
    estimator = DecisionTreeClassifier(criterion="entropy", max_depth=5)
    estimator.fit(x_train, y_train)
    #生成决策树,重复tree.dot文件内的内容到网址:http://webgraphviz.com/ 可查看图示结构
    export_graphviz(estimator, out_file="./tree.dot",feature_names=[
        'shebeiming',
        'weixiushichang',
    ])
    #保存模型
    joblib.dump(estimator, estimator_file)
    y_pred  = estimator.predict(x_test)
    comparison_df = pd.DataFrame({'实际值': y_test.values.flatten(), '预测值': y_pred.flatten()})
    comparison_df = comparison_df.sort_values(by='实际值')  # 按实际销量排序,方便可视化

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 5
 0
- 0


 已为社区贡献33条内容

所有评论(0)