《零基础学机器学习》学习笔记(二)--数学和python基础知识
书名《零基础学机器学习》 作者黄佳 人民邮电出版社 出版
2 数学与 Python 基础知识
2.1 函数
2.1.1 函数的定义
函数用于描述输入与输出之间的关系。一个输出值随着一个或多个输入值的变化而变化,体现了变量之间的依赖关系。
2.1.2 机器学习中的函数
机器学习本质上是一个寻找函数的过程。其目标是通过对训练数据的学习,建立一个从输入特征 ( x ) 到输出标签 ( y ) 的映射关系,即函数 ( f(x) = y )。利用该函数,模型可以对新的输入进行预测或分类。
在实际应用中,输入特征通常不止一个,记为x1, x2, …, xn。机器学习模型通过分析这些特征与标签之间的相关关系(而非因果关系),构建出一个尽可能准确的预测函数。
一个“好”的函数不仅要在训练集和验证集上表现良好,还应具备良好的泛化能力,即在测试集上也能保持较高的预测准确率。因此,机器学习的核心关注点从传统的“为什么”转向了更具实用性的“是什么”。
通过机器学习,尤其是深度学习,模型能够发现特征与标签之间复杂的非线性关系,从而实现更精准的预测。
常见的传统机器学习算法包括线性回归、逻辑回归、决策树、朴素贝叶斯等,而深度学习则通过构建多层神经网络,利用链式求导机制优化模型参数,实现对复杂函数的拟合。
无论是传统方法还是深度学习,最终得到的模型都是对训练数据中特征与标签关系的函数化表达。
1. 线性函数
线性函数是最基本的函数形式,通常表示为:y = ax + b
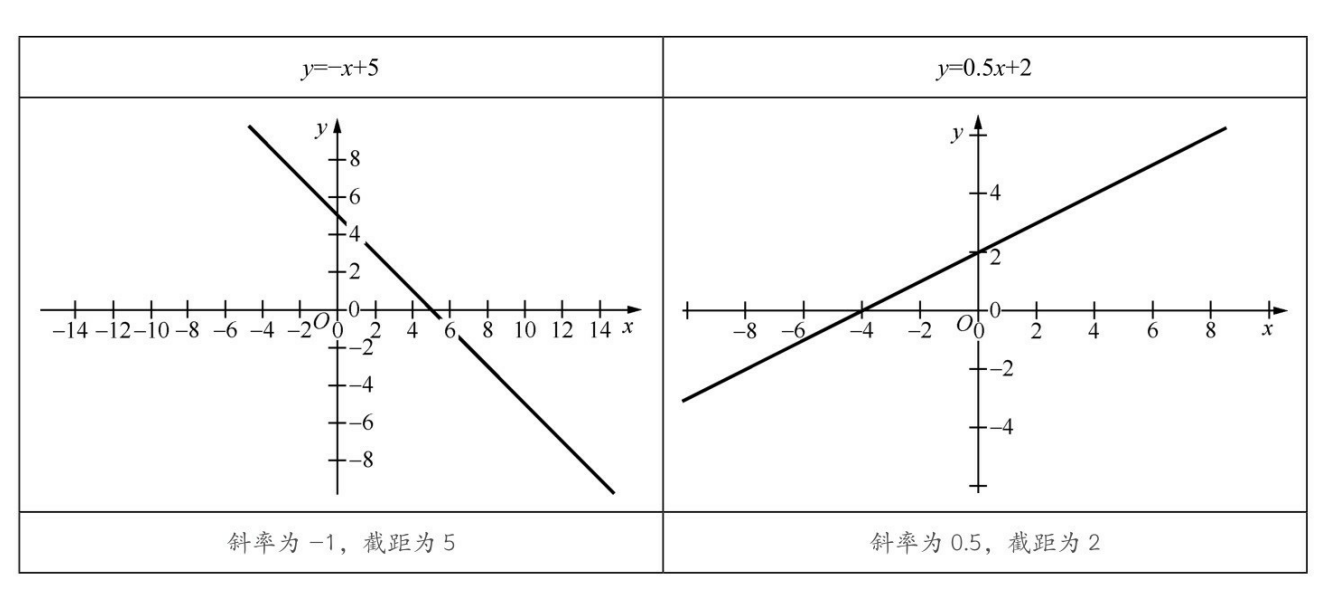
其图像为一条直线,适用于建模简单的线性关系。例如,房屋面积与售价之间可能存在线性关系。
2. 二次函数与多项式函数
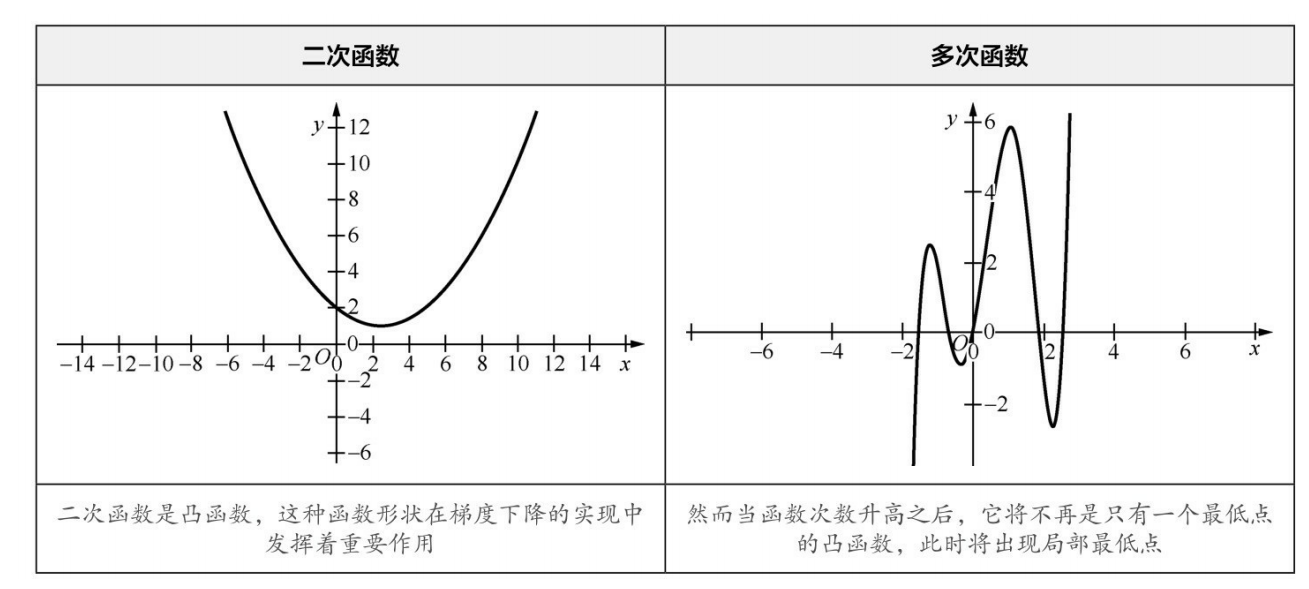
函数的最高次项决定了其次数。例如, y = ax^2 + bx + c 是二次函数。随着次数的增加,函数图像变得更加复杂,能够拟合更复杂的非线性关系。
3. 激活函数
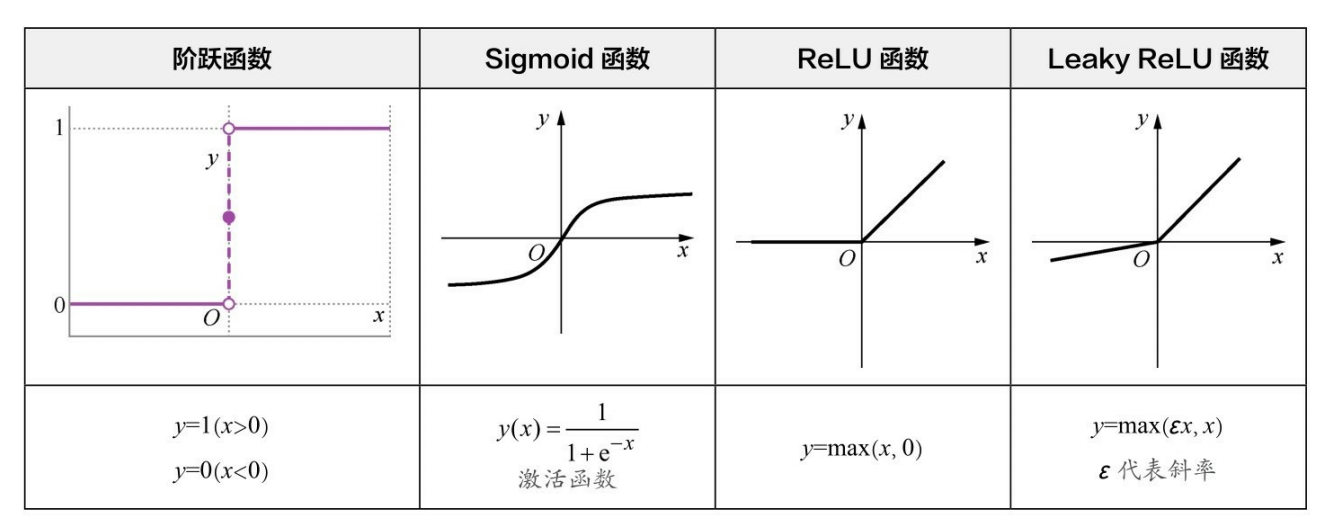
激活函数是神经网络中的关键组成部分,用于引入非线性变换。常见的激活函数包括 Sigmoid、ReLU、Tanh 等。
其中,Sigmoid函数在逻辑回归中广泛应用,输出值介于 0 和 1 之间,适合用于概率预测。
4. 对数函数
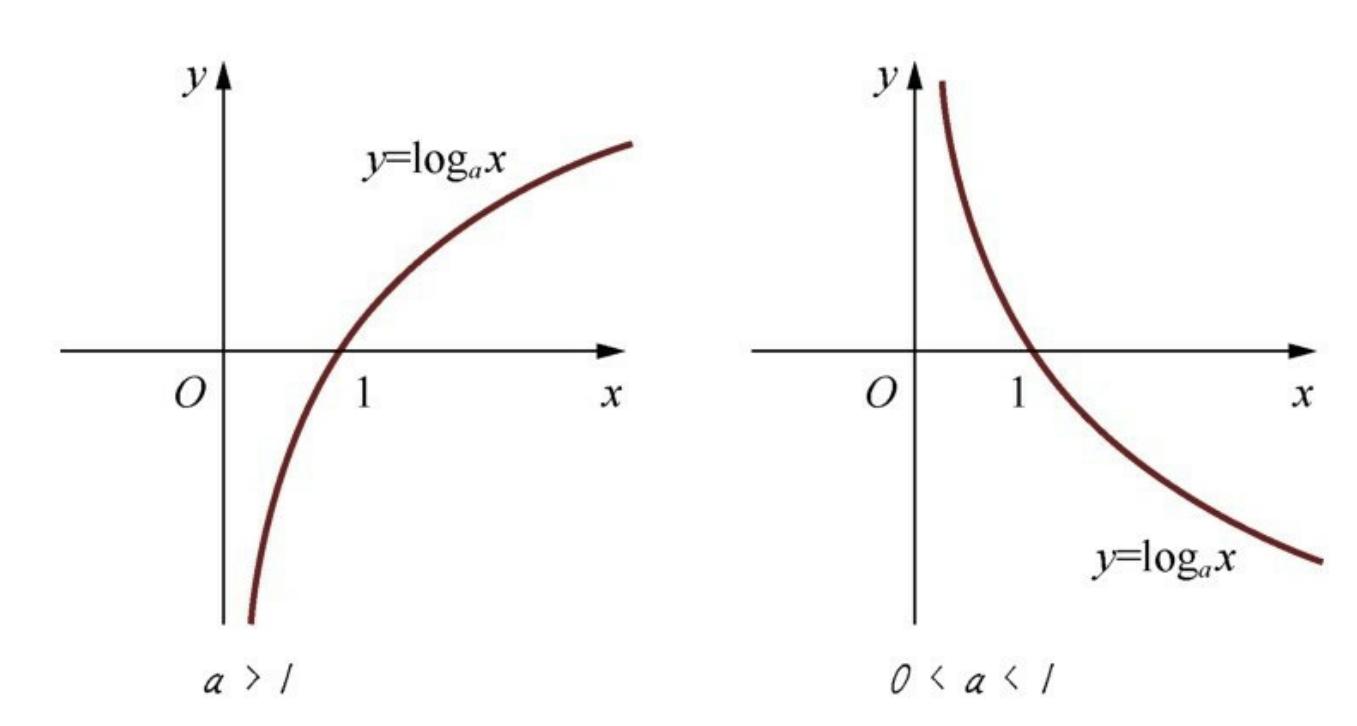
对数函数是指数函数的反函数,具有强烈的“压缩”作用,能够将大范围的数据映射到较小的区间。
若未指定底数,通常指自然对数,即以自然常数 e≈2.718 为底的对数函数,记作 ln(x)。在逻辑回归中,自然对数常用于构建损失函数(如对数似然损失)。
Python 示例代码:
import math

# 以10为底,计算log(100000000)
y = math.log(100000000, 10)
print("以10为底,求一亿的对数:", y)  # 输出:8.0
2.2 捕捉函数的变化趋势
在机器学习中,理解函数的变化趋势至关重要。我们关心的是:输出 y 如何随输入 x 的变化而变化。这一趋势通常通过**求导(微分)**来刻画。
2.2.1 连续性:求导的前提条件
连续性是函数可导的必要前提。
一个函数在某点连续,意味着当 x 发生微小变化时,y 也发生平滑、无跳跃的变化。并非所有函数都具备连续性。例如,阶跃函数在跳跃点处不连续,因此在这些点不可导。
在机器学习中,函数通常需要具备连续性,因为:
模型的学习过程本质上是对函数变化规律的拟合与优化。
若函数不连续,其变化趋势将无法通过导数有效捕捉。
2.2.2 导数:刻画函数的变化方向
导数(derivative)是衡量函数在某一点瞬时变化率的工具,仅对连续函数定义。
几何理解:
考虑函数图像上的两点 A 和 B ,它们之间的变化可用一条割线表示,其斜率为:dy/dx,也等价于从A点到B点的变化方向。
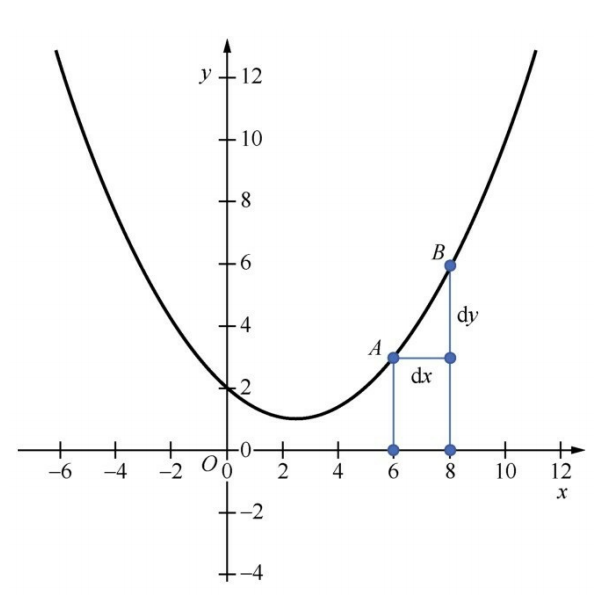
B→A(两点无限接近),逼近极限的时候,在即将重合而又未重合的一刹那,割线趋近于一条切线,其斜率即为函数在点 A 处的导数
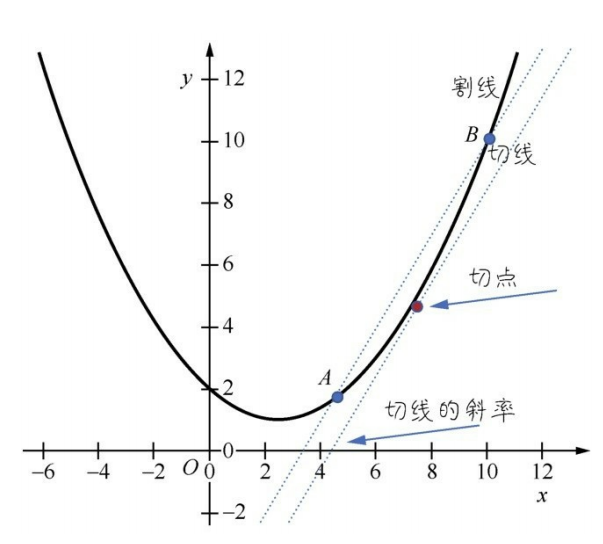
导数的意义:
- 若 ( f’(x) > 0 ):说明函数目前变化趋势是在上升
- 若 ( f’(x) < 0 ):说明函数目前变化趋势是在下降
- 若 ( f’(x) = 0 ):函数可能处于局部极值点(极大或极小)
导数实现了“以直代曲”,使我们能够用线性方式近似描述函数的局部变化趋势。
拓展:偏导数与全导数
- 偏导数:对于多元函数,固定其他变量,仅对某一变量求导
- 全导数:考虑所有变量同时变化时的总变化率
2.2.3 凸函数:保证全局最优解
在优化问题中,函数的凸性决定了是否能找到全局最优解。
凸函数的定义(直观理解):
- 函数图像连续、光滑
- 整个图像呈“碗状”,只有一个最低点
- 任意两点连线位于函数图像上方(数学定义)
非凸函数:
- 可能存在多个局部最低点
- 优化过程中容易陷入“局部最优”,无法达到全局最优
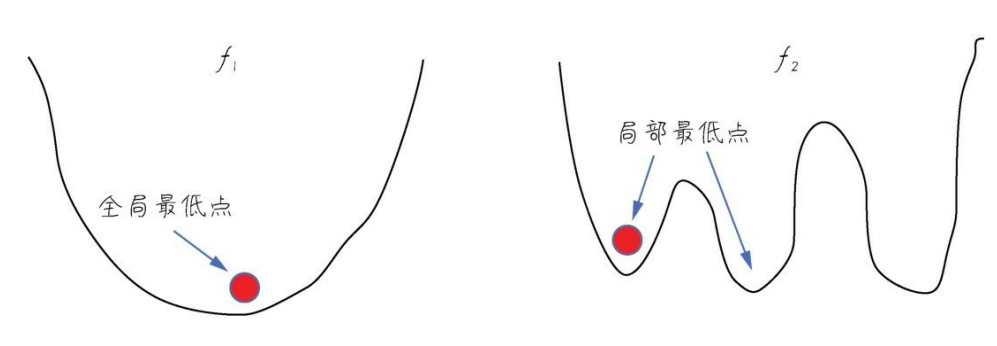
导数与极值点:
对于可导函数,局部或全局极值点处的导数为零(即切线水平)
在机器学习中的意义:
- 凸函数:无论初始点如何选择,梯度下降法都能收敛到全局最低点
- 非凸函数:可能卡在局部最低点,导致模型性能不佳
小结
| 概念 | 作用与意义 |
|---|---|
| 连续性 | 可导的前提,保证函数变化可追踪 |
| 导数 | 刻画函数变化趋势,指导优化方向 |
| 凸函数 | 保证优化过程能找到全局最优解 |
2.3 梯度下降:机器学习优化的核心驱动力
2.3.1 梯度——多元函数“变化最快”的方向向量
对多元函数 的每个自变量求偏导,并将所有偏导数按序排列成列向量,即得梯度(gradient):
具体来说,两个自变量的函数f(x1,x2),对应着机器学习数据集中的两个特征,如果分别对x1,x2求偏导数,那么求得的梯度向量就是
∇f=(∂f∂x1,∂f∂x2)T
\nabla f = \left( \frac{\partial f}{\partial x_1}, \frac{\partial f}{\partial x_2} \right)^T
∇f=(∂x1∂f,∂x2∂f)T
在数学上可以表示成Δf(x1,x2)。
几何意义:
- 梯度向量指向函数值增长最快的方向。
- 负梯度方向-Δf(x)则对应函数值下降最快的方向。
- 若在某点 x∗ 处 ∇f(x∗)=0,则该点为驻点(局部极值或鞍点)。
2.3.2 梯度下降法——沿着负梯度迭代寻优
算法思想(下山类比):
- 在当前位置计算梯度;
- 沿负梯度方向更新参数:
- 重复直至满足停止准则(梯度范数足够小或函数值变化低于阈值)。
收敛性保证:
- 若目标函数为凸函数,梯度下降理论上可收敛到全局最优解。
- 对于非凸函数,可能陷入局部最优或鞍点,需借助随机初始化、动量、自适应学习率等技巧缓解。
2.3.3 梯度下降的机器学习价值
| 任务 | 梯度下降的作用 |
|---|---|
| 模型训练 | 最小化损失函数 ,求得最优参数。 |
| 损失曲面 | 希望为凸函数,以保证全局最小值可达。 |
| 预测精度 | 通过迭代降低预测值与真值之间的误差,提升模型泛化性能。 |
简言之,梯度下降为机器学习提供了系统化的“减误差”路径,是连接“函数形式”与“数据表现”的桥梁。
2.4 机器学习的数据容器——张量(Tensor)
张量是机器学习中表示数字数据的标准结构,可视为“高维数组”。
- 矩阵 = 二维数组 = 2D 张量
- 轴(axis):张量的每个维度(等价于数学中的 x、y、z 轴)。
- 阶(rank):轴的个数,即“张量有多少维”。
- 形状(shape):列出每个轴上的元素个数,用元组表示,例如
(3, 4, 5)表示 3×4×5 的 3D 张量。
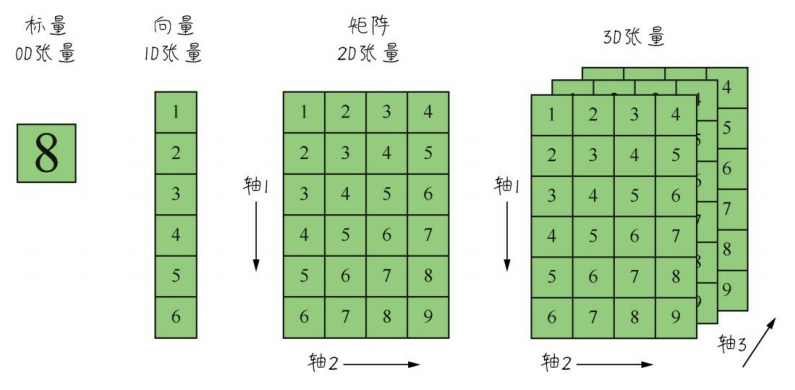
下文统一用“阶”表示张量的维度数目,用“形状”描述各阶长度,避免与“向量维度”混淆。
2.4.1 标量(Scalar)——0D 张量
仅含一个数字的张量,阶为 0,形状为 ()。
import numpy as np

x = np.array(5)          # 0D 张量
print(x)                 # 5
print(x.ndim)            # 0
print(x.shape)           # ()
print(x.dtype)           # int64
用途:超参数设置、循环计数、损失值汇总等。
2.4.2 向量(Vector)——1D 张量
一轴数组,阶为 1,形状 (n,)。
v = np.array([5, 6, 7, 8, 9])   # 1D 张量
print(v)                        # [5 6 7 8 9]
print(v.ndim)                   # 1
print(v.shape)                  # (5,)
注意:
- 5 个元素的向量常称 5 维向量(指沿轴的元素个数)。
- 不要把“5 维向量”与“5 阶张量”混为一谈;后者需 5 条轴。
向量数据在机器学习中的角色
- 一个样本 → 一个向量(特征向量)。
- 整个数据集 → 矩阵(2D 张量),每行一个样本。
- 标签集 → 向量(1D 张量)。
示例:波士顿房价数据集
from keras.datasets import boston_housing
(X_train, y_train), (_, _) = boston_housing.load_data()

print(X_train.shape)      # (404, 13)   ← 404 个样本,每样本 13 特征
print(X_train[0].shape)   # (13,)       ← 单个样本是 13 维向量
print(y_train.shape)      # (404,)      ← 404 个标签组成的向量
向量点积(Dot Product)
相同长度向量的对应元素相乘后求和,结果是一个标量。
向量的点积运算法则如下图所示。
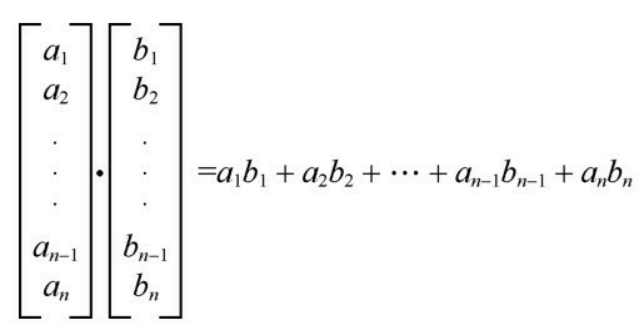
简单地说,就是两个相同维度的向量对应元素先相乘,后相加,形成等号右边的多项式。
weight = np.array([1, -1.8, 1, 1, 2])
x      = np.array([1, 6, 7, 8, 9])

y_hat = np.dot(x, weight)   # 或 x @ weight
print(y_hat)                # 23.2
要点
- 点积满足交换律。
- 结果维度:向量·向量 → 标量;后续矩阵-向量、矩阵-矩阵点积维度规则不同。
- 向量化运算避免 Python 层
for循环,效率远高于逐元素计算。
2.4.3 矩阵(2D 张量)
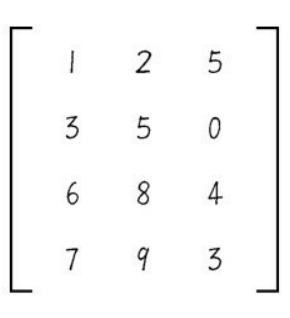
定义:矩阵 = 同一类型元素排成的矩形数组,阶数为 2,形状记为 (m, n)。
- 轴 0:行(样本方向);轴 1:列(特征方向)。
- 元素索引:传统记号
A[i, j](0-based)。
机器学习视角
样本×特征矩阵:每行一条样本,每列一个特征。
print(X_train)          # (404, 13) 矩阵
print(X_train[0])       # 第 0 号样本向量 (13,)
矩阵乘法(点积)
具体来说,是第一个矩阵的行向量,和第二个矩阵的列向量进行点积,然后把结果标量放进新矩阵,作为结果矩阵中的一个元素。这个规则如图所示。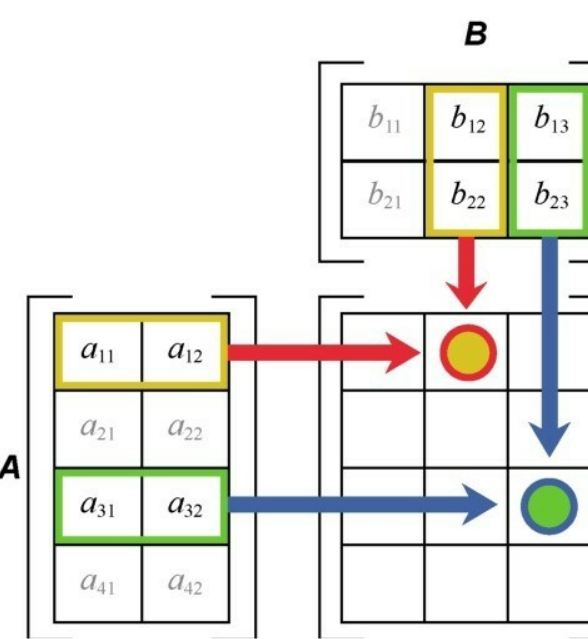
设 A 形状 (m, n),B 形状 (n, p),则结果 C 形状 (m, p)。NumPy 实现:
C = np.dot(A, B) # 或 A @ B
维度不符时,先用 reshape/transpose 调整,再相乘。
2.4.4 序列数据(3D 张量)
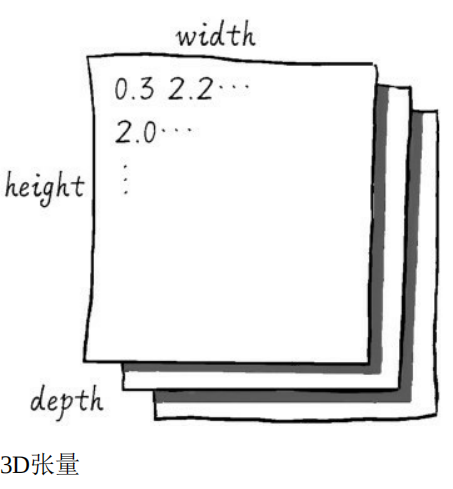
结构:(样本, 时间步, 特征)
典型场景:时间序列、语音、文本(字符/词级)。
示例:北京一年气象分钟级记录
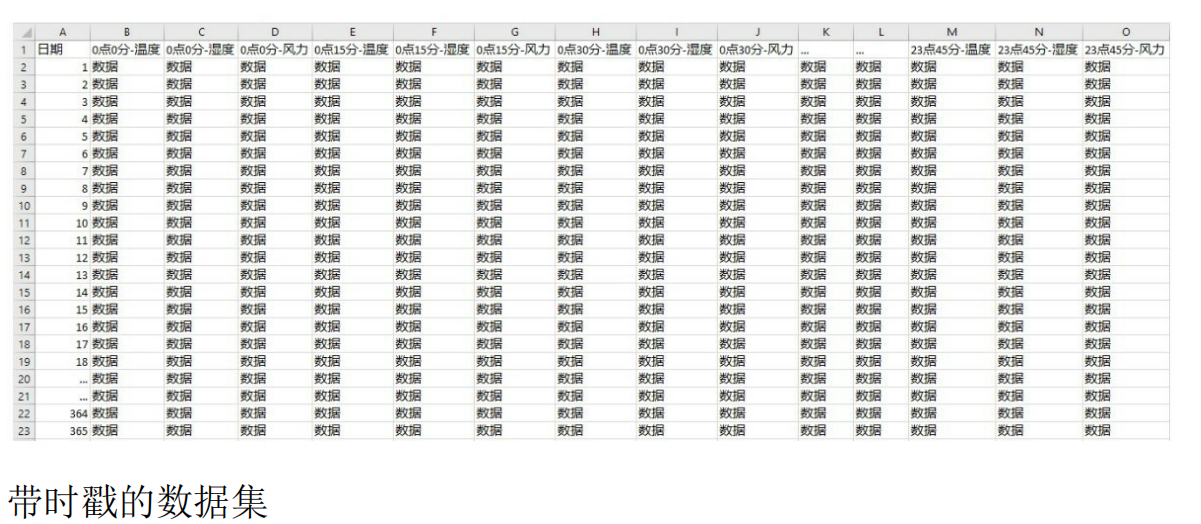
- 样本轴:365 天
- 时间步轴:每天 96 个 15-min 切片
- 特征轴:温度、湿度、风速
X = np.empty((365, 96, 3)) # 3D 张量
2.4.5 图像数据(4D 张量)
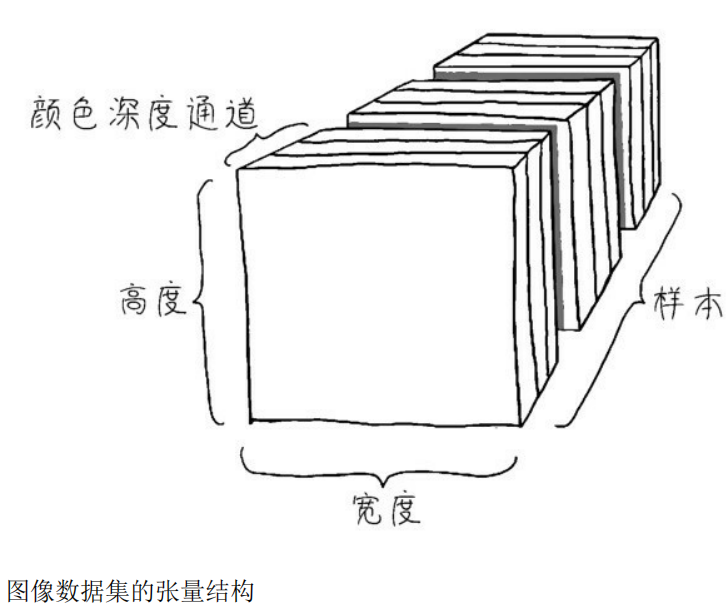
格式:(样本, 高, 宽, 通道)
- 灰度:通道 = 1
- RGB:通道 = 3
MNIST 实例
print(mnist_images.shape) # (60000, 28, 28, 1)
单批训练
batch = mnist_images[:64] # (64, 28, 28, 1)
2.4.6 视频数据(5D 张量)
组成:帧序列的图像集合
形状:(样本, 帧, 高, 宽, 通道)
示例
10 min@30 fps,RGB,224×224 → 单条视频
(1, 18000, 224, 224, 3) ≈ 6.8×10⁹ 元素(float32 约 25 GB)。
→ 必须降采样、分批次、用 3D-CNN/Transformer 等深度学习模型处理。
2.4.7 “数据维度”与“空间维度”辨析
| 概念 | 含义 | 示例 |
|---|---|---|
| 数据维度 | 某轴上的元素个数 | 10 000 特征 → 特征维 10 000;10 000 样本 → 样本维 10 000 |
| 空间维度 | 人类可感知的三维物理空间 | 绘图最多用 x-y-z 三轴 |
可视化限制
- 1 特征 + 1 标签 → 2-D 平面曲线
- 2 特征 + 1 标签 → 3-D 曲面(或 2-D 散点用颜色/符号编码第 3 维)
- ≥3 特征:需借助降维(t-SNE、UMAP、PCA)压缩到 2-D/3-D 才能绘制。
因此教材与论文常用“单特征或双特征”示例,并非问题本身仅有一两维,而是受限于人类视觉与纸张维度。
2.5 Python 张量运算
2.5.1 张量的创建
| 要点 | 规范表述 |
|---|---|
| 内存布局 | NumPy 数组在连续内存块中存储同类型元素,支持 CPU/GPU 向量化;Python list 存储对象指针,不支持向量化。 |
| 创建方式 | 1) 从序列转换:np.array(seq) 2) 工厂函数: np.arange, np.linspace, np.zeros, np.ones, np.random.* |
真实场景:先用 pandas 读取文件 → DataFrame →
df.to_numpy()得到张量。
2.5.2 张量索引与切片(规范化)
基本概念
| 术语 | 定义 |
|---|---|
| 索引(indexing) | 访问张量中单个元素。 |
| 切片(slicing) | 访问张量中连续子集,返回视图(共享内存)。 |
语法规则
| 维度 | 索引示例 | 切片示例 |
|---|---|---|
| 1D | arr[i] | arr[start:stop:step] |
| nD | arr[i, j, k] | arr[轴0, 轴1, 轴2] |
索引从 0 开始;负索引表示倒数。
代码示范
import numpy as np

# 1D 张量
a = np.arange(10)          # [0 1 2 3 4 5 6 7 8 9]
elem   = a[3]              # 索引 → 3
sub    = a[:4]             # 切片 → [0 1 2 3]
stride = a[0:12:4]         # 步长 → [0 4 8]

# 3D 张量(MNIST)
from keras.datasets import mnist
(X_train, _), _ = mnist.load_data()   # (60000, 28, 28)
subset = X_train[10000:15000, :, :]   # (5000, 28, 28)
形状敏感度训练
b = np.array([[1, 2, 3],
              [4, 5, 6]])   # (2, 3)

print(b[1:2])        # [[4 5 6]]  → 形状 (1, 3)  二维
print(b[1:2][0])     # [4 5 6]    → 形状 (3,)    一维
同样数据
4 5 6,括号层数决定阶数(rank)与形状(shape)。
在机器学习流水线中,时刻检查.shape是避免 bug 的第一习惯。
2.5.3 整体运算 vs 逐元素运算
| 类别 | 示例 | 结果 |
|---|---|---|
| 一元函数 | np.sqrt(arr) | 逐元素平方根 |
| 二元算术 | arr + 1 | 广播加 1 |
| 逻辑运算 | arr > 3 | 布尔数组 |
arr = np.array([[1, 2, 3], [4, 5, 6]])
arr += 1                 # 整体加 1
print(np.sqrt(arr))      # 逐元素平方根
2.5.4 变形与转置
| 方法 | 说明 | 示例 |
|---|---|---|
reshape | 返回视图(共享数据) | arr.reshape(3, 2) |
arr.T | 矩阵转置(轴 0↔1) | (2,3) → (3,2) |
a = np.arange(10)          # (10,)
b = a.reshape(10, 1)       # (10, 1)  阶数由 1→2
2.5.5 NumPy 广播机制
定义
广播(broadcasting)是 NumPy 对形状不同但兼容的张量进行逐元素运算的自动扩展机制;运算过程无数据复制,仅通过 strides 实现视图扩展,可充分利用 CPU/GPU 向量化加速。
广播规则
对两个数组从尾部维度开始逐阶比较:
- 维度相等 或
- 其中一维为 1
满足任一条件即可广播;否则抛出 ValueError: operands could not be broadcast together。
示例矩阵
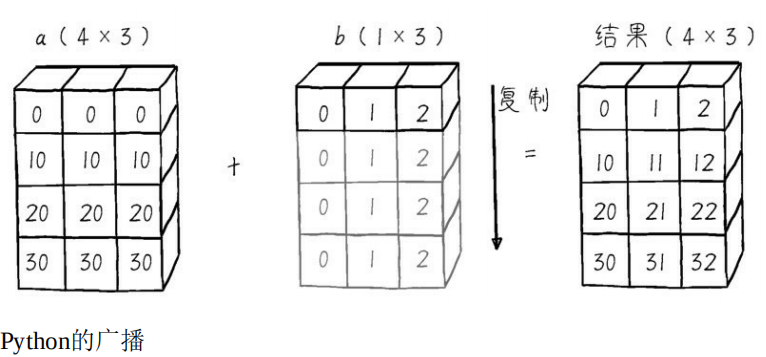
| 数组 | 形状 | 广播后形状 | 说明 |
|---|---|---|---|
A | (4, 3) | (4, 3) | 基准数组 |
B | (1, 3) | (4, 3) | 沿轴 0 复制 4 次 |
C | (4, 1) | (4, 3) | 沿轴 1 复制 3 次 |
D | (3,) | (4, 3) | 先补 1→(1,3)再复制 |
代码演示
import numpy as np

A = np.array([[0, 0, 0],
              [10, 10, 10],
              [20, 20, 20],
              [30, 30, 30]])        # (4, 3)

B1 = np.array([0, 1, 2])            # (3,)
C1 = np.array([[0], [1], [2], [3]]) # (4, 1)

print('A + B1 :\n', A + B1)
print('A + C1 :\n', A + C1)
输出:
A + B1 :
[[ 0  1  2]
 [10 11 12]
 [20 21 22]
 [30 31 32]]
A + C1 :
[[ 0  0  0]
 [11 11 11]
 [22 22 22]
 [33 33 33]]
常见陷阱与解决
- 不兼容形状:
(4,3) + (4,2)→ 报错
解决:事先reshape或pad使尾部维度一致。 - 0 维数组(标量)可与任何形状广播:
A + 1等价于A + np.array(1)。
性能提示
- 广播无显式复制,内存占用低;
- 仍应尽量避免过度大尺寸广播,防止 CPU Cache 不命中。
2.5.6 向量和矩阵的点积运算
向量点积维度规则与结果
| 左操作数 | 右操作数 | 结果形状 | 数学含义 |
|---|---|---|---|
(n,) | (n,) | () 标量 | 内积 ∑aᵢbᵢ |
(n,) | (n,1) | (1,) | 向量×列矩阵 |
(1,n) | (n,) | (1,) | 行矩阵×向量 |
(1,n) | (n,1) | (1,1) | 外积(标量) |
(n,1) | (1,n) | (n,n) | 外积矩阵 |
(1,n) | (1,n) | — | 报错:dim 1≠dim 0 |
(n,1) | (n,1) | — | 报错:dim 1≠dim 0 |
v1 = np.array([1, 2, 3])            # (3,)
v2 = np.array([[1], [2], [3]])      # (3, 1)
v3 = np.array([2])                  # (1,)
v4 = v2.reshape(1, 3)               # (1, 3)

print(np.dot(v1, v1))               # 14   标量
print(np.dot(v1, v2))               # [14] (1,)
print(np.dot(v4, v2))               # [[14]] (1,1)
print(np.dot(v2, v3))               # [[2] [4] [6]] (3,1)
注意:
- 结果形状差异仅由“矩阵维度”决定。
- 与标量
k运算等价于广播k*v,不是数学意义上的点积。
矩阵点积通用规则
对于 A (a, b) 与 B (b, c):
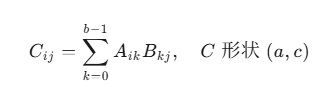
必要条件:A.shape[-1] == B.shape[0]
实现方式:A @ B 或 np.dot(A, B)
A = np.arange(6).reshape(2, 3)      # (2, 3)
B = np.arange(6).reshape(3, 2)      # (3, 2)

print(A @ B)                        # (2, 2) 合法
print(B @ A)                        # (3, 3) 合法
print(A @ A)                        # ValueError: 3 != 2
典型用途
- 向量内积:计算损失、相似度
- 矩阵乘:全连接层、线性变换
Y = XW + b - 外积:协方差、低秩更新
维度不符时,先用
reshape、transpose或插入np.newaxis使轴对齐,再进行点积。
2.6 机器学习的几何视角
2.6.1 特征空间与向量几何
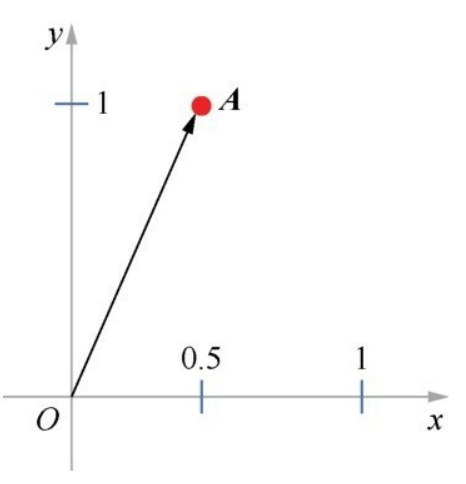
将每个样本表示为固定维度的向量,就把机器学习问题转换成了在高维向量空间中的几何问题。
-
向量即点。二维向量 A=(0.5,1) 可视为二维平面上从原点指向该点的箭头;推广到 d 维,向量就是 d 维欧氏空间的一个点。
-
运算即几何动作。
– 加法:平行四边形法则,和向量是对角线。
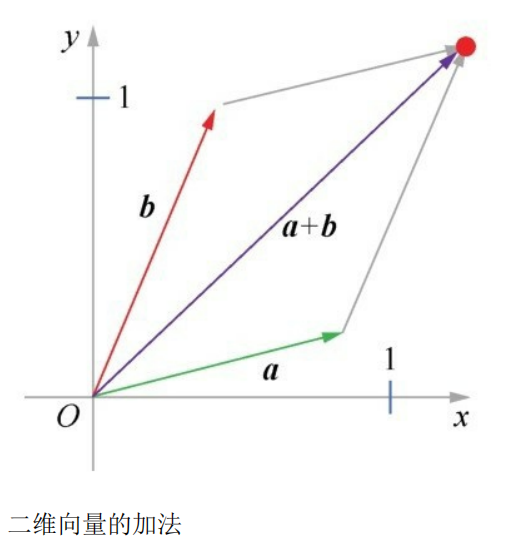
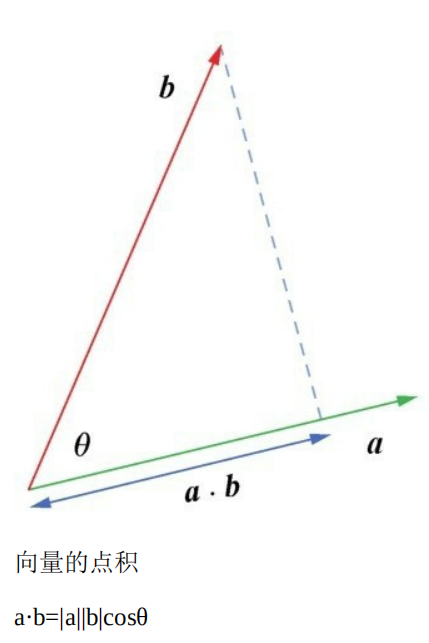
– 点积:a·b=|a||b|cosθ,同时给出夹角 θ 与投影长度 |a|cosθ。
-
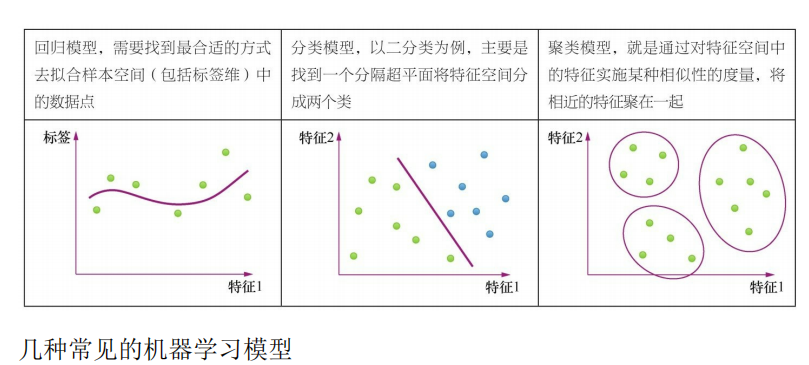
模型即变换。线性模型对应仿射变换,核方法对应隐式升维后的线性变换,决策树对应轴平行划分,神经网络则是一系列非线性弯曲与拉伸的复合。整个学习过程可概括为“在特征空间中寻找一条(或一块)能把点按标签分开的弯曲流形”。
几种常见的机器学习模型都可以通过特征空间进行几何描述,如下图所示。
2.6.2 深度学习与数据流形
高维原始特征往往存在冗余与扭曲,导致同类样本在欧氏距离下“近却不相似”、异类样本“远却同类”。流形假设认为:虽然表面维度很高,但数据实际分布在一个低维光滑流形上。
- 经典流形学习(LLE、Isomap、t-SNE 等)通过显式映射把卷曲的流形“铺平”到低维空间,保留局部邻域结构,方便后续分类或可视化。
- 深度网络的每一层可视为一次坐标变换。随着层数加深,网络通过可学习的非线性函数把原本缠绕、折叠的高维流形逐层展开,最终让不同类别的样本在顶层空间变成线性可分或更易度量。
- 几何隐喻:一张揉皱的纸写着数字,直接读取几乎不可能;深度网络就像一双看不见的手,把纸团无撕裂地缓缓展平,使墨迹重新排布成整齐行列。由此,特征提取与降维被“内化”到网络参数中,无需人工设计。
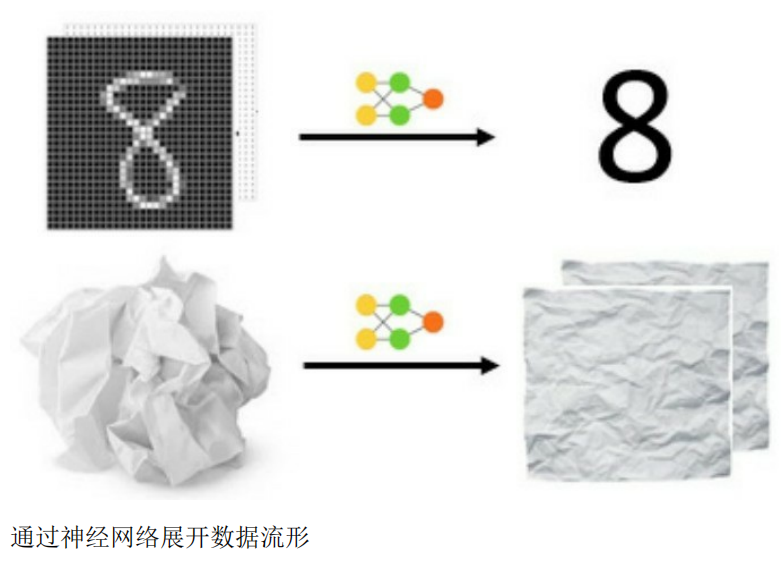
简言之,机器学习 = 在向量空间里做几何;深度学习 = 用多层非线性映射把扭曲的数据流形自动展开。
2.7 概率与统计研究了随机事件的规律
2.7.1 什么是概率
事件分为以下两种。
- 一种是确定性事件。确定性事件又分为以下两种。
- 必然事件:如太阳从东方升起,或者水在0℃会结冰。
- 不可能事件:如掷一个常规的六面骰子,得到的点数是7。
- 有大量事件在一定条件下能否发生,是无法确定的,它们是随机事件。比如,掷一枚硬币得到的是正面还是反面、明天大盘是涨还是跌等。
因此,对于随机事件,我们很想知道“这件事情会发生吗?”,然而很多情况下,答案是不确定的。而概率则回答的是“我们有多确定这件事情会发生?”,然后试图用0~1的数字来表示事件的确定程度。
表2-1给出了概率的定义和计算公式。
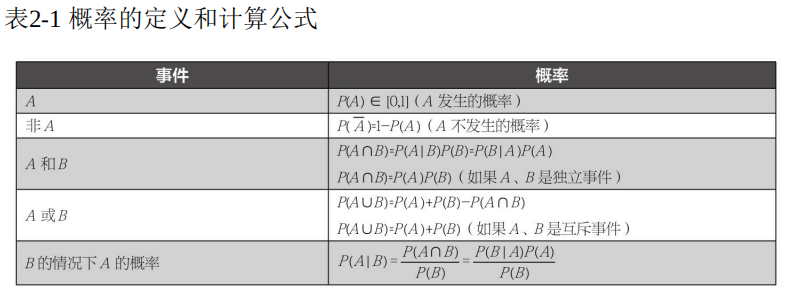
概率 P 把“发生的可能性”量化为 0–1 之间的实数。
对任意事件 A,有
0 ≤ P(A) ≤ 1,P(Ω)=1,P(∅)=0。
核心公式(离散情形)
- 加法:P(A∪B)=P(A)+P(B)−P(A∩B)
- 乘法:P(A∩B)=P(A)P(B|A)
- 条件概率 / 后验概率:
P(A|B)=P(A∩B)/P(B)=P(B|A)P(A)/P(B) (贝叶斯定理)
几率是该事件发生的概率和不发生概率的比值
2.7.2 正态分布
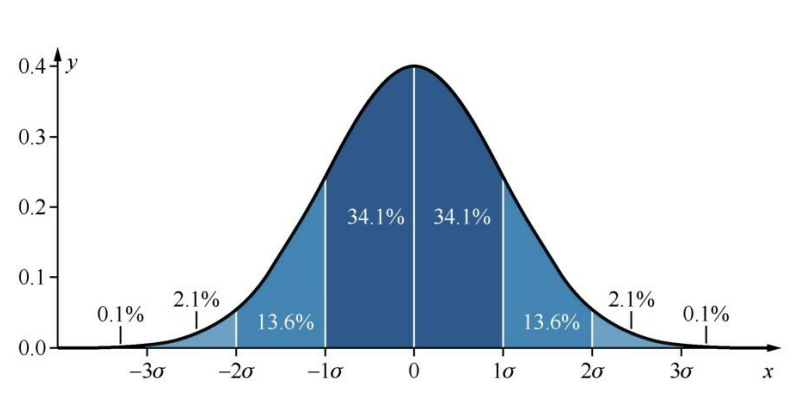
所谓分布就是一组概率的集合,是把一种常见的概率分布用连续的函数曲线显示出来的方式。而正态分布,又名高斯分布(Gaussian distribution),则是一个非常常见的连续概率分布。
正态分布也叫概率分布的钟形曲线(bell curve),因为曲线的形状就像一口悬挂的大钟,如下图所示。
2.7.3 标准差和方差
上面正态分布示意图中出现了一个奇怪的符号σ,这个符号代表标准差(Standard Deviation,SD),读作sigma。标准差,也称均方差(mean square error),是反映研究总体内个体之间差异程度的一种统计指标。
标准差是根据方差计算出来的。而方差(variance)是一组资料中各实际数值与其算术平均数(即均值(mean),也叫期望值)的差值做平方结果相加之后,再除以总数而得。标准差是方差的算术平方根。方差和标准差,描述的都是数据相对于其期望值的离散程度。
标准差在机器学习中也经常出现,比如,当进行数据预处理时,常常要涉及数据标准化。在该步骤中,最常见的做法就是对样本特征减去其均值,然后除以其标准差来进行缩放。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 20
 0
- 0


 已为社区贡献2条内容

所有评论(0)