机器学习——决策树
决策树是一种直观且易于解释的监督学习算法,广泛应用于分类和回归任务。它通过模拟人类决策过程,将复杂问题拆解为一系列简单的判断规则,最终形成类似 “树” 状的结构。以下从基础概念、原理、算法类型、优缺点及应用场景等方面展开详细介绍。
概念
决策树通过对训练样本的学习,并建立分类规则,然后依据分类规则,对新样本数据进行分类预测,属于有监督学习
核心
所有数据从根节点一步一步落到叶子节点
根节点:第一个节点
非叶子节点:中间节点
叶子节点:最终结果节点
需要考虑的问题:
1.哪个节点作为根节点?哪些节点作为中间节点?哪些节点作为叶子节点?
2.节点如何分裂?
3.节点分裂标准的依据?
决策树的分类标准
1.ID3算法
衡量标准:
熵值:表示随机变量不确定性的度量,或者说是物体内部的混乱程度
熵值计算公式:
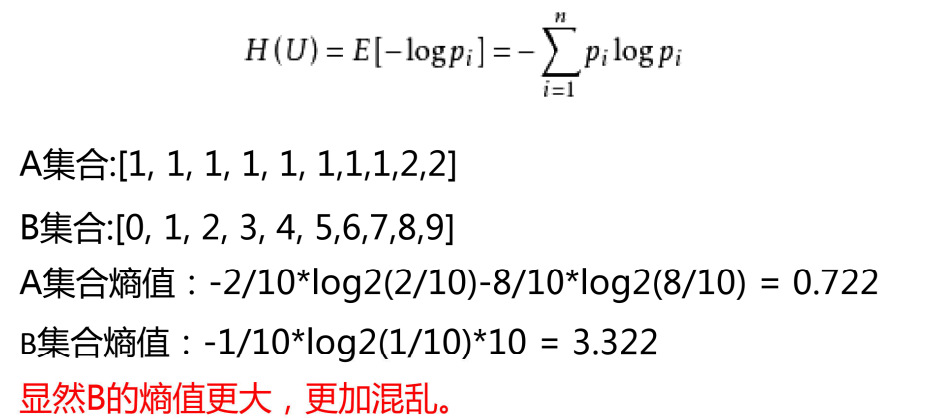
举例说明(数据如下图):
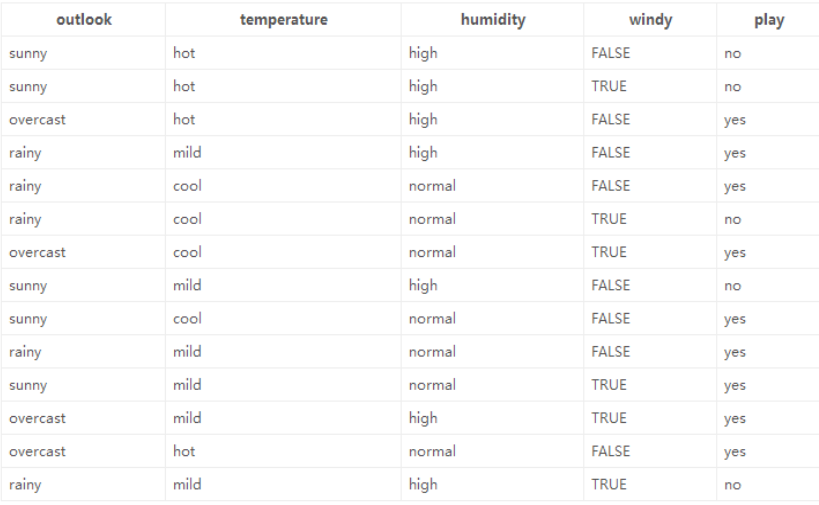
熵:熵值越小,该节点越“纯”。
第一遍遍历:
1.标签(结果是否外出打球)的熵(类别熵):
14天中,9天打球,5天不打球,熵为: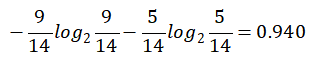
计算对数的Python程序:
import math
result = -9/14*math.log(9/14, 2) - 5/14*math.log(5/14, 2)
2.基于天气的划分
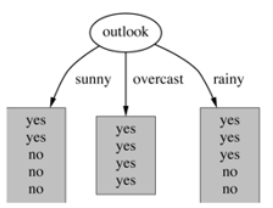
属性熵:
晴天【5天】的熵:
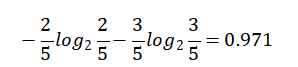
Overcast(阴天)【4天】的熵:
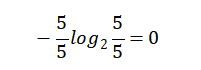
雨天【5天】的熵:
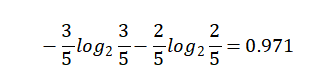
那么,天气对应标签结果的熵为:
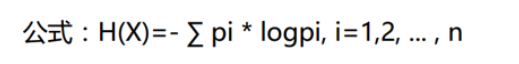
熵值计算:
5/14*0.971+4/14*0+5/14*0.971=0.693
则信息增益为:0.940-0.693=0.247
在决策树算法中,信息增益(information gain)是特征选择的一个重要指标。它描述的是一个特征能够为整个系统带来多少信息量(熵),用于度量信息不确定性减少的程度。
如果一个特征能够为系统带来最大的信息量,则该特征最重要,将会被选作划分数据集的特征。
3.基于温度的划分
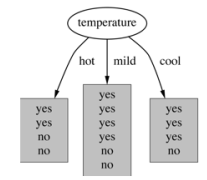
Hot【4天】的熵:
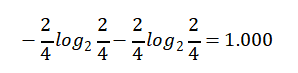
Mild【6天】的熵:
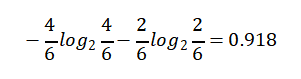
Cool【4天】的熵:
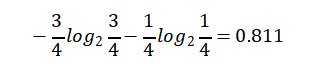
熵值计算:4/14*1+6/14*0.918+4/14*0.811=0.911
信息增益为:0.940 – 0.911 = 0.029
4.基于湿度的划分
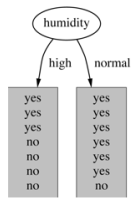
High【7天】的熵:
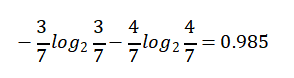
Normal【7天】的熵:
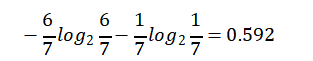
熵值计算:7/14*0.985+7/14*0.592=0.789
信息增益:0.940 – 0.789 =0.151
5.基于有风的划分
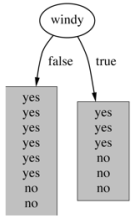
False【8天】的熵值:
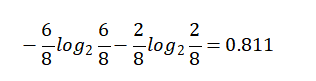
True【6天】的熵值:
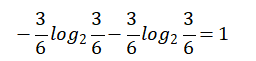
熵值计算:8/14*0.811 + 6/14*1 = 0.892
信息增益:0.940 - 0.892 = 0.048
综上:信息增益的大小:
天气:0.247
温度:0.029
湿度:0.151
有风:0.048
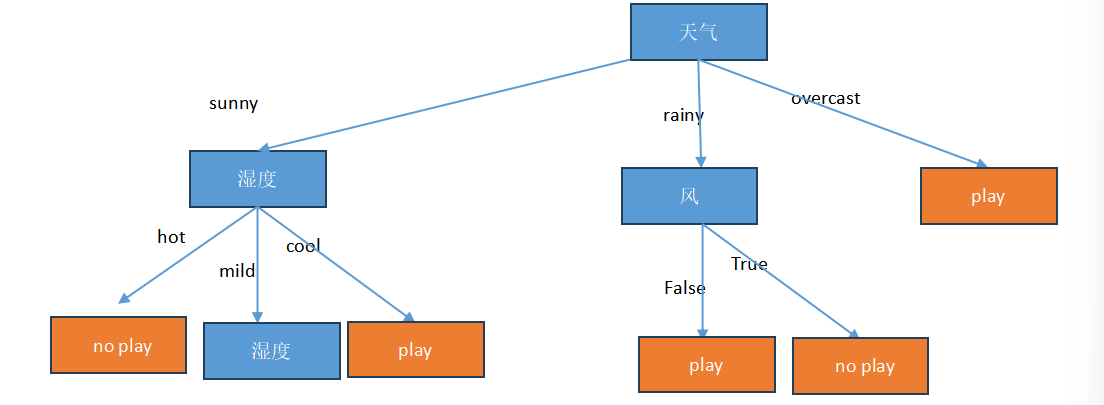
显然,信息增益最大的是: 天气 > 湿度 > 有风 > 温度
2.C4.5算法(解决稀疏向量的问题,例如编号)

衡量标准:信息增益率
C4.5算法是一种决策树生成算法,它使用信息增益比(gain ratio)来选择最优分裂属性,具体步骤如下:
1、计算所有样本的类别熵(H)。
2、对于每一个属性,计算该属性的熵【也为自身熵】(Hi)。
3、对于每一个属性,计算该属性对于分类所能够带来的信息增益(Gi = H - Hi)。
4、计算每个属性的信息增益比(gain ratio = Gi / Hi),即信息增益与类别自身熵的比值。
选择具有最大信息增益比的属性作为分裂属性。
第一遍计算:【找首要节点】
1.天气的信息增益为:0.247,
天气的自身熵值:

5天晴天、4天多云、5天有雨。
信息增益率:0.247/1.577 = 0.1566
2.温度的自身熵值:

信息增益率:0.029/1.557 = 0.0186
3.湿度的自身熵值:

信息增益率:0.048/0.985 = 0.049
4.有风的自身熵值:

信息增益率:0.048/0.985 = 0.049
信息增益率排序:天气(0.1566)湿度(0.151)有风(0.049) 温度(0.0186)
天气 >湿度>有风>温度
3.CART决策树(用Gini指数最小化准则来进行特征选择。)
衡量标注:基尼系数
用Gini指数最小化准则来进行特征选择。
基于基尼(GINI)指数

举例:


特征A1(年龄)的基尼系数:

青年(5人,2人贷款)的基尼系数:

如果是类别是二分类,则基尼系数:

非青年(10人,7人贷款)的基尼系数:

在A1=1(青年)条件下,D的基尼指数:

总公式:

在A1=2(中年)条件下,D的基尼指数:

在A1=3条件下,D的基尼指数:


决策树剪枝
为什么要剪枝:
防止过拟合
如何剪枝:
预剪枝和后剪枝
通常进行预剪枝,因为后剪枝虽然精确度高,但是速度慢
预剪枝策略:
1.限制树的深度
2.限制叶子节点的个数以及叶子节点的样本树
3.基尼系数
决策树的优缺点
优点
简单直观,容易理解
不需要特征标准化
可处理离散和连续特征
对缺失值不敏感
可用于分类与回归
缺点
容易过拟合
对小样本数据不稳定
对类别不平衡敏感
可解释性好但精度可能不如集成方法(如随机森林、XGBoost)
sklearn库中的决策树参数问题
class sklearn.tree.DecisionTreeClassifier(criterion=’gini’, splitter=’best’, max_depth=None, min_samples_split=2, min_samples_leaf=1, min_weight_fraction_leaf=0.0, max_features=None, random_state=None, max_leaf_nodes=None, min_impurity_decrease=0.0, min_impurity_split=None, class_weight=None, presort=False)
树模型参数:
- 1.criterion :gini or entropy 【采用基尼系数还是熵值衡量,默认基尼系数】
- 2.splitter: best or random 前者是在所有特征中找最好的切分点 后者是在部分特征中(数据量大的时候)【默认best,无需更改】
- 3.max_features:(表示寻找最优分裂时需要考虑的特征数量,默认为None,表示考虑所有特征。),log2,sqrt,N 特征小于50的时候一般使用所有的 【默认取所有特征,无需更改】
- 4.max_depth: 表示树的最大深度,数据少或者特征少的时候可以不管这个值,如果模型样本量多,特征也多的情况下,可以尝试限制下。如果没有设置,那么将会把节点完全展开,直到所有的叶子节点都是纯的,或者达到最小叶子节点的个数阈值设置。
- 5.min_samples_split :(表示分裂一个内部节点需要的最小样本数,默认为2),如果某节点的样本数少于min_samples_split,则不会继续再尝试选择最优特征来进行划分,如果样本量不大,不需要管这个值。如果样本量数量级非常大,则推荐增大这个值。【控制内部节点分裂的情况;假设<10,那么分裂的数量小于10就不会再次分裂了,默认2个】
- 6.min_samples_leaf :(叶子节点最少样本数),这个值限制了叶子节点最少的样本数,如果某叶子节点数目小于样本数,则会和兄弟节点一起被剪枝,如果样本量不大,不需要管这个值【先构成决策树,再剪枝,当小于某个设定值后,删除此节点以及此节点的分支节点】
- 7.min_weight_fraction_leaf:(叶子节点最小的样本权重和),这个值限制了叶子节点所有样本权重和的最小值,如果小于这个值,则会和兄弟节点一起被剪枝,默认是0,就是不考虑权重问题。一般来说,如果我们有较多样本有缺失值,或者分类树样本的分布类别偏差很大,就会引入样本权重,这时我们就要注意这个值了。
8.max_leaf_nodes :(最大叶子节点数),通过限制最大叶子节点数,可以防止过拟合,默认是"None”,即不限制最大的叶子节点数。如果加了限制,算法会建立在最大叶子节点数内最优的决策树。如果特征不多,可以不考虑这个值,但是如果特征分成多的话,可以加以限制具体的值可以通过交叉验证得到。【假设限制最大的叶子节点数为10个,那么就不会再次分裂了】
- 9. min_impurity_decrease :
- 10.min_impurity_split: 这个值限制了决策树的增长,如果某节点的不纯度(基尼系数,信息增益,均方差,绝对差)小于这个阈值则该节点不再生成子节点。即为叶子节点 。
- 11.class_weight 指定样本各类别的的权重,主要是为了防止训练集某些类别的样本过多导致训练的决策树过于偏向这些类别。这里可以自己指定各个样本的权重如果使用“balanced”,则算法会自己计算权重,样本量少的类别所对应的样本权重会高。
- random_state是用来设置决策树分枝中随机模式的参数。当数据集中的特征数量较少时,随机性不会很明显。但是,当特征数量较多时,随机性就会变得明显。random_state参数可以确保每次运行代码时都得到相同的结果。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 55
 0
- 0


 已为社区贡献4条内容

所有评论(0)