机器学习之朴素贝叶斯
·
一、朴素贝叶斯是什么?
朴素贝叶斯(Naive Bayes)是基于贝叶斯定理和特征条件独立假设的监督学习算法,广泛用于分类任务(如文本分类、垃圾邮件识别)。它的核心优势是简单高效、训练速度快,适合处理高维度稀疏数据,且对小规模数据集表现友好。
1.核心理论基础
贝叶斯定理描述了 “已知结果反推原因” 的概率关系,公式为:
其中:
P(Y∣X):后验概率,即已知特征 X 时,样本属于类别 Y的概率(模型最终要计算的目标);
P(Y):先验概率,即类别 Y在训练集中出现的概率(无任何特征信息时的类别概率);
P(X|Y):似然概率,即已知类别Y时,特征X出现的概率;
P(X):证据因子,即特征 X出现的总概率(对所有类别来说是常数,计算时可忽略)。
朴素贝叶斯的"朴素"之处在于给定类别Y时,假设所有特征条件独立:
若样本有n个特征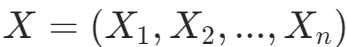 ,则似然概率可以拆解为:
值得注意的是,这个假设大幅降低了计算复杂度,让算法能处理高维特征,但也牺牲了一定的精度(现实中特征往往存在关联)。
二、实际案例
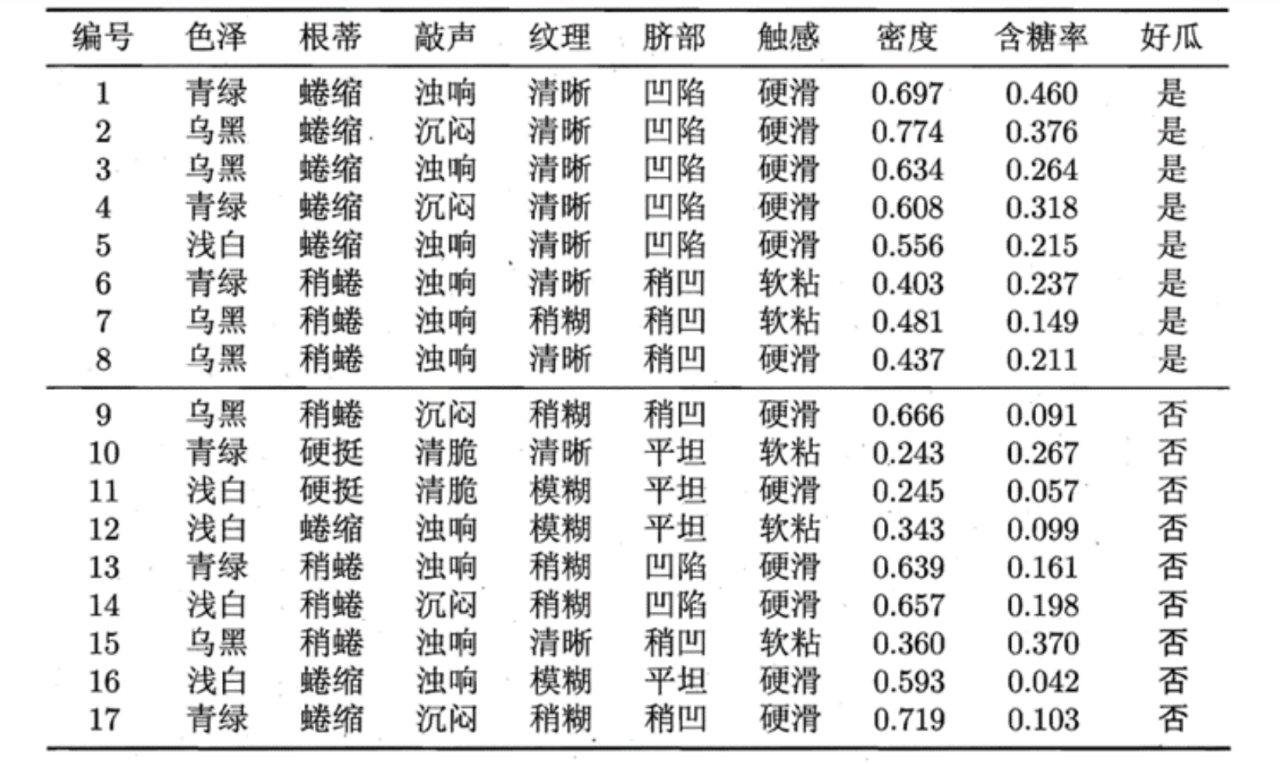
判断西瓜是“好瓜”还是“坏瓜”,下面是训练数据集
我们还给出测试样本: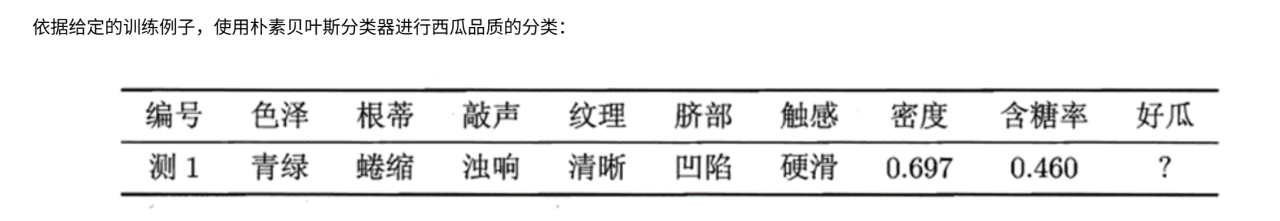
1.对于离散特征用统计频率估计
(1)计算先验概率
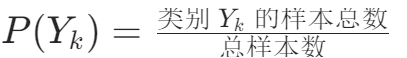
(2)计算似然概率
对于特征的某个取值x,我们计算在类别
中,特征
取值为x 的样本占比。
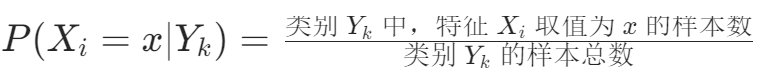
2.对于连续特征用高斯分布
高斯概率密度函数:
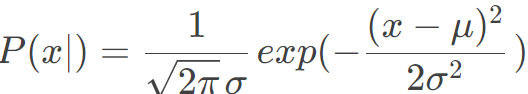
其中:
μ:均值
σ:标准差
3.代码实现
import pandas as pd
import numpy as np

# 数据
data = {
    '编号': [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17],
    '色澤': ['青绿', '乌黑', '乌黑', '青绿', '浅白', '青绿', '乌黑', '乌黑', '乌黑', '青绿', '浅白', '浅白', '青绿',
             '浅白', '乌黑', '浅白', '青绿'],
    '根蒂': ['蜷缩', '蜷缩', '蜷缩', '蜷缩', '蜷缩', '稍蜷', '稍蜷', '稍蜷', '稍蜷', '硬挺', '硬挺', '蜷缩', '稍蜷',
             '稍蜷', '稍蜷', '蜷缩', '蜷缩'],
    '敲声': ['浊响', '沉闷', '浊响', '沉闷', '浊响', '浊响', '浊响', '浊响', '沉闷', '清脆', '清脆', '浊响', '浊响',
             '沉闷', '浊响', '浊响', '沉闷'],
    '纹理': ['清晰', '清晰', '清晰', '清晰', '清晰', '清晰', '稍糊', '清晰', '稍糊', '清晰', '模糊', '模糊', '稍糊',
             '稍糊', '清晰', '模糊', '稍糊'],
    '脐部': ['凹陷', '凹陷', '凹陷', '凹陷', '凹陷', '稍凹', '稍凹', '稍凹', '稍凹', '平坦', '平坦', '平坦', '凹陷',
             '凹陷', '稍凹', '平坦', '稍凹'],
    '触感': ['硬滑', '硬滑', '硬滑', '硬滑', '硬滑', '软粘', '软粘', '硬滑', '硬滑', '软粘', '硬滑', '软粘', '硬滑',
             '硬滑', '软粘', '硬滑', '硬滑'],
    '密度': [0.697, 0.774, 0.634, 0.608, 0.556, 0.403, 0.481, 0.437, 0.666, 0.243, 0.245, 0.343, 0.639, 0.657, 0.360,
             0.593, 0.719],
    '含糖率': [0.460, 0.376, 0.264, 0.318, 0.215, 0.237, 0.149, 0.211, 0.091, 0.267, 0.057, 0.099, 0.161, 0.198, 0.370,
               0.042, 0.103],
    '好瓜': ['是', '是', '是', '是', '是', '是', '是', '是', '否', '否', '否', '否', '否', '否', '否', '否', '否']
}

df = pd.DataFrame(data)

# 提取特征和标签
features_discrete = ['色澤', '根蒂', '敲声', '纹理', '脐部', '触感']
features_continuous = ['密度', '含糖率']
label = '好瓜'

X_discrete = df[features_discrete]
X_continuous = df[features_continuous]
y = df[label]

# 确保离散列是字符串类型
for col in features_discrete:
    df[col] = df[col].astype(str)


class MixedNaiveBayesWithDetail:
    def __init__(self):
        self.priors = {}
        self.discrete_probs = {}
        self.continuous_params = {}

    def fit(self, X_discrete, X_continuous, y):
        total_samples = len(y)
        for c in y.unique():
            self.priors[c] = np.sum(y == c) / total_samples

        # 离散特征条件概率
        for col in X_discrete.columns:
            self.discrete_probs[col] = {}
            for val in X_discrete[col].unique():
                self.discrete_probs[col][val] = {}
                for c in y.unique():
                    count = np.sum((X_discrete[col] == val) & (y == c))
                    prob = count / np.sum(y == c)
                    self.discrete_probs[col][val][c] = prob

        # 连续特征高斯参数
        for col in X_continuous.columns:
            self.continuous_params[col] = {}
            for c in y.unique():
                data_c = X_continuous.loc[y == c, col]
                mean = data_c.mean()
                var = data_c.var(ddof=0)  # 总体方差(与教材一致)
                self.continuous_params[col][c] = (mean, var)

    def _gaussian_pdf(self, x, mean, var):
        if var == 0:
            return 1.0 if x == mean else 1e-10
        coeff = 1.0 / np.sqrt(2 * np.pi * var)
        exponent = -0.5 * ((x - mean) ** 2) / var
        return coeff * np.exp(exponent)

    def predict_with_detail(self, X_discrete_row, X_continuous_row):
        print("=" * 60)
        print("🔍 开始预测样本:")
        for col in X_discrete_row.index:
            print(f"  {col}: {X_discrete_row[col]}")
        for col in X_continuous_row.index:
            print(f"  {col}: {X_continuous_row[col]:.3f}")
        print("-" * 60)

        log_probs = {}
        probs = {}

        for c in self.priors.keys():
            prior = self.priors[c]
            log_prior = np.log(prior)
            log_prob = log_prior
            prob = prior

            print(f"\n类别: '{c}'")
            print(f"  先验概率 P({c}) = {prior:.4f} (log = {log_prior:.4f})")

            # 离散特征
            for col in X_discrete_row.index:
                val = X_discrete_row[col]
                if val in self.discrete_probs[col] and c in self.discrete_probs[col][val]:
                    p = self.discrete_probs[col][val][c]
                else:
                    p = 1e-10  # 平滑
                log_p = np.log(p)
                log_prob += log_p
                prob *= p
                print(f"  P({col}={val} | {c}) = {p:.4f} (log = {log_p:.4f})")

            # 连续特征
            for col in X_continuous_row.index:
                x = X_continuous_row[col]
                mean, var = self.continuous_params[col][c]
                p = self._gaussian_pdf(x, mean, var)
                log_p = np.log(p)
                log_prob += log_p
                prob *= p
                print(f"  P({col}={x:.3f} | {c}) = {p:.6f} (log = {log_p:.4f})")
                print(f"    → 高斯分布参数: μ={mean:.4f}, σ²={var:.4f}")

            log_probs[c] = log_prob
            probs[c] = prob
            print(f"  联合概率 P(样本|{c})P({c}) = {prob:.2e} (log = {log_prob:.4f})")

        print("\n" + "=" * 60)
        print(" 最终比较(使用对数概率避免下溢):")
        for c in log_probs:
            print(f"  log P({c} | 样本) ∝ {log_probs[c]:.4f}")

        best_class = max(log_probs, key=log_probs.get)
        print(f"\n 预测结果: '{best_class}'")
        return best_class


# 创建并训练模型
nb = MixedNaiveBayesWithDetail()
nb.fit(X_discrete, X_continuous, y)

# 测试样本:测1(即训练集第1个样本)
new_sample = {
    '色澤': '青绿',
    '根蒂': '蜷缩',
    '敲声': '浊响',
    '纹理': '清晰',
    '脐部': '凹陷',
    '触感': '硬滑',
    '密度': 0.697,
    '含糖率': 0.460
}

discrete_input = pd.Series([new_sample[f] for f in features_discrete], index=features_discrete)
cont_input = pd.Series([new_sample[f] for f in features_continuous], index=features_continuous)

pred = nb.predict_with_detail(discrete_input, cont_input)
运行结果: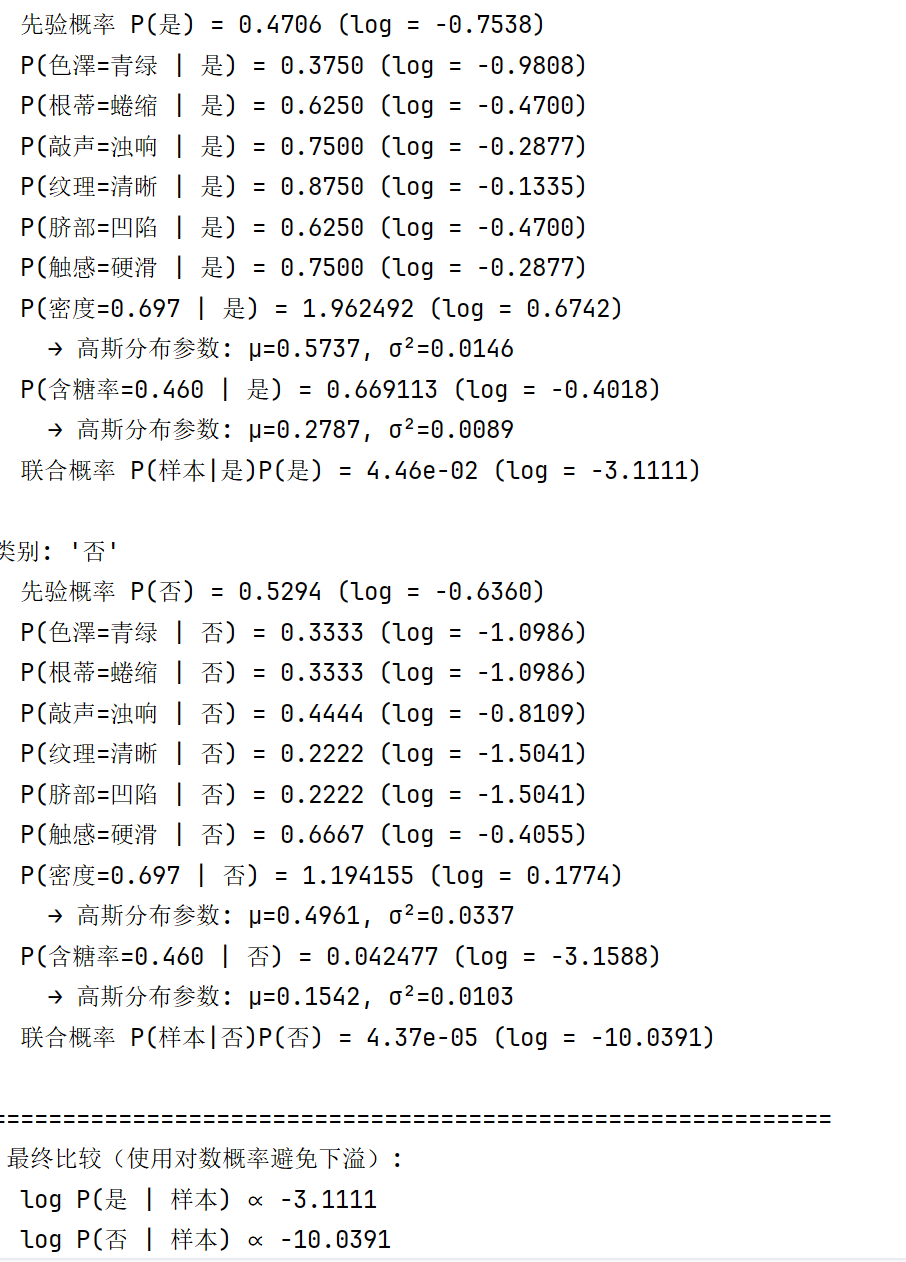

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)