机器学习中的线性回归
摘要:本文系统介绍了机器学习中的线性回归方法。首先定义了线性回归的基本概念,即通过建立自变量与因变量之间的线性关系进行预测的统计模型。然后详细阐述了两种回归类型:简单线性回归(单一自变量)和多元线性回归(多个自变量)。文章重点讲解了线性回归的工作原理,包括假设函数、损失函数(如均方误差)和梯度下降优化算法。同时指出了线性回归的关键假设条件,如线性关系、无多重共线性等。最后总结了评估指标(R平方、MSE等)、应用场景(房价预测、金融分析等)以及优缺点,并简要提及了过拟合、多重共线性等常见挑战和多项式回归作为替代方案。全文系统全面地介绍了线性回归的核心内容。
目录
机器学习中的线性回归被定义为一种统计模型,用于分析因变量与给定自变量集合之间的线性关系。变量之间的线性关系意味着,当一个或多个自变量的值发生变化(增加或减少)时,因变量的值也会相应变化(增加或减少)。
在机器学习中,线性回归用于基于学习到的线性关系预测新数据和未见数据的连续数值。它被用于预测建模、财务预测、风险评估等领域。
本章将详细讨论以下主题——
- 什么是线性回归?
- 线性回归的类型
- 线性回归是如何工作的?
- 线性回归的假设函数
- 寻找最佳贴合线
- 线性回归的损失函数
- 优化的梯度下降
- 线性回归的假设
- 线性回归的评估度量
- 线性回归的应用
- 线性回归的优点
- 线性回归的常见挑战
什么是线性回归?
线性回归是一种统计技术,用于估计一个因变量与一个或多个自变量之间的线性关系。在机器学习中,线性回归作为监督学习方法实现。在机器学习中,带标签的数据集包含输入数据(特征)和输出标签(目标值)。在机器学习中的线性回归中,我们将特征表示为自变量,目标值作为因变量。
为了简化,取以下数据(单一特征和单一目标)
| 平方英尺(x) | 房价(Y) |
|---|---|
| 1300 | 240 |
| 1500 | 320 |
| 1700 | 330 |
| 1830 | 295 |
| 1550 | 256 |
| 2350 | 409 |
| 1450 | 319 |
在上述数据中,目标房价由X表示,特征平方英尺由Y表示的自变量。输入特征(X)用于预测目标标签(Y)。因此,自变量也被称为预测变量,因变量称为响应变量。
那么,让我们在机器学习中定义线性回归如下:
在机器学习中,线性回归利用线性方程来建模因变量(Y)与一个或多个自变量(Y)之间的关系。
线性回归模型的主要目标是通过一组数据点找到最合适的直线(通常称为回归线)。
回归线
显示因变量与自变量之间关系的直线称为回归线或回归线。
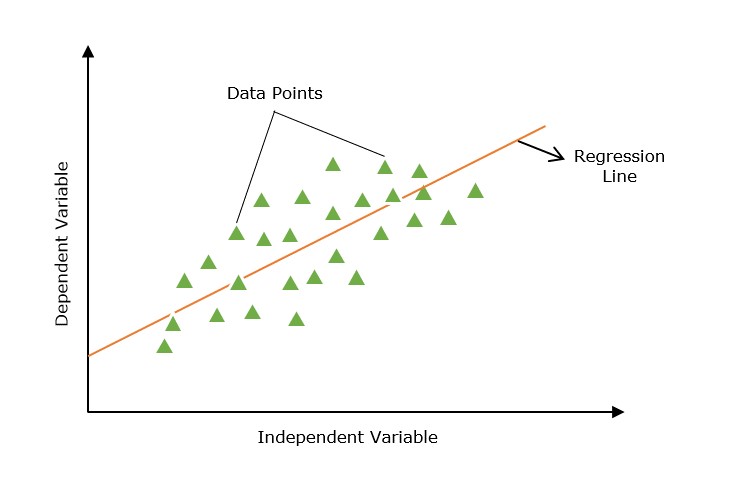
此外,线性关系可以是正的也可以是负的,如下文所述 −
1. 正线性关系
如果自变量和因变量都增加,则称线性关系为正。可以通过以下图 − 来理解
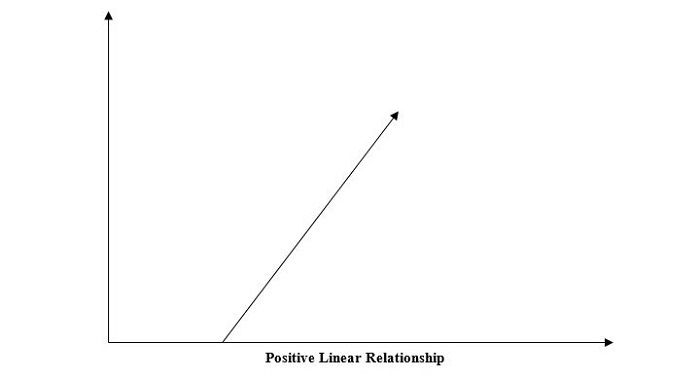
2. 负线性关系
如果自变量增加而因变量减少,则称线性关系为正。可以通过以下图 − 来理解
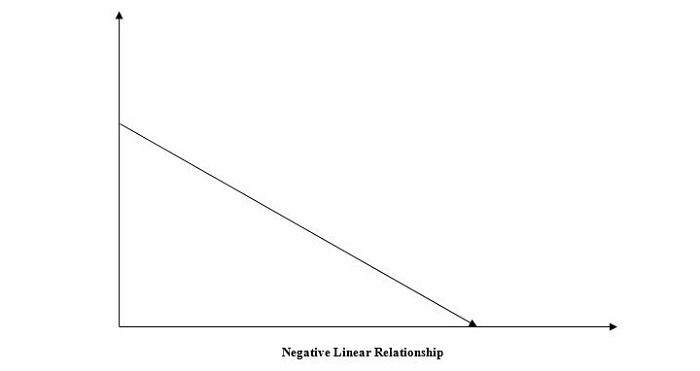
线性回归分为两种类型,“简单线性回归”和“多重线性回归”,我们将在本教程的接下来两章中讨论。
线性回归的类型
线性回归有以下两种类型 −
- 简单线性回归
- 多重线性回归
1. 简单线性回归
简单线性回归是一种回归分析方式,其中使用单个自变量(也称为预测变量)来预测因变量。换句话说,它模拟了因变量与单个自变量之间的线性关系。
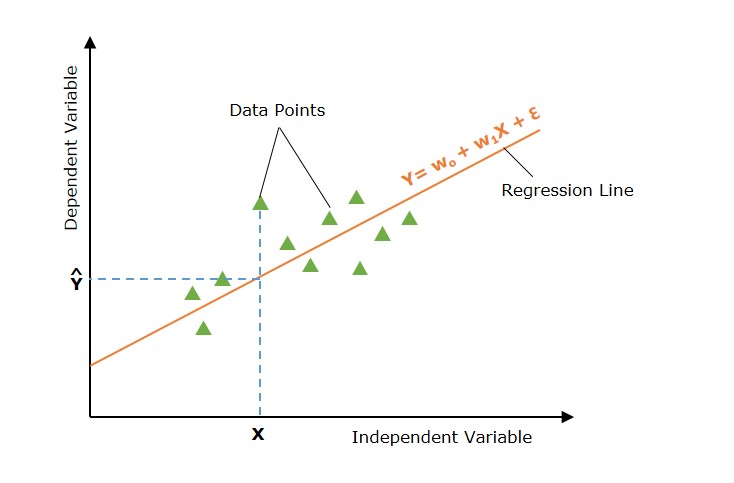
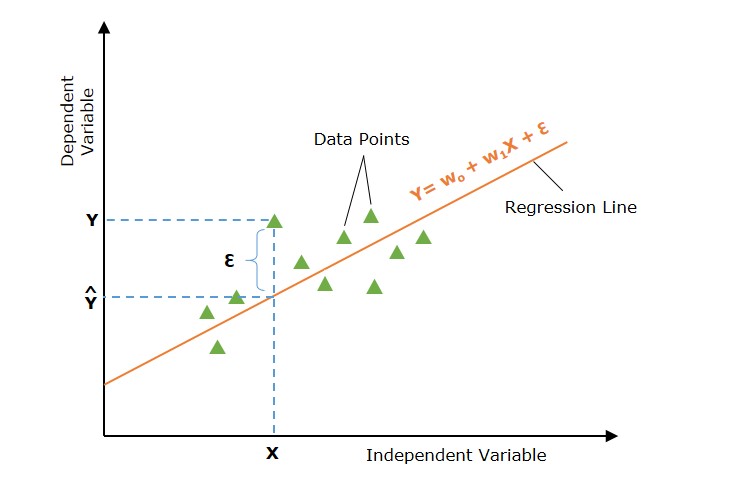
在上图中,直线表示简单线性回归线,其中 & Ycirc;是预测值,X是输入值。
数学上,该关系可建模为线性方程−
其中
- Y 是因变量(目标)。
- X 是自变量(特征)。
- w0是该直线的Y截距。
- w1是直线的斜率,代表X对Y的影响。
- Îμ 是误差项,捕捉了 Y 中无法被 X 解释的变异性。
2. 多元线性回归
多重线性回归基本上是简单线性回归的扩展,利用两个或多个特征预测一个响应。
当处理多个自变量时,我们将简单线性回归扩展为多重线性回归。该模型表达为:
多重线性回归将简单线性回归的概念扩展到多个自变量。该模型表达为:
其中
- X1, X2, ..., Xp是自变量(特征)。
- w0, w1, ..., wp是这些变量的系数。
- Îμ 是误差项。
线性回归是如何工作的?
线性回归的主要目标是通过一组数据点找到最佳拟合线,以最小化实际值与预测值之间的差异。所以已经完成了?这通过估计参数w来实现0, w1等等。
机器学习中线性回归的工作可以分解为多个步骤,具体如下 −
- 假设 − 我们假设输入与输出之间存在线性关系。
- 成本函数 − 定义损失或成本函数。成本函数量化模型的预测误差。成本函数将模型的预测值和实际值合并,返回一个代表模型预测成本的单一缩放器值。
- 优化 − 通过更新模型参数来优化(最小化)模型的成本函数。
它会持续更新模型参数,直到模型预测的成本或误差得到优化(最小化)。
让我们更详细地讨论上述三个步骤——
线性回归的假设函数
在线性回归问题中,我们假设输入特征(X)与预测值(Ŷ)之间存在线性关系。
假设函数返回给定输入值的预测值。通常我们用 h 表示假设w(X),并且等于 Ŷ。
简单线性回归的假设函数 −
多重线性回归的假设函数 −
对于不同参数(权重)值,我们可以找到许多回归线。主要目标是找到最合适的线条。我们以以下方式讨论——
寻找最佳贴合线
我们上文讨论过,不同的参数集会带来不同的回归线。然而,每条回归线并不代表输入和输出值之间的最优关系。主要目标是找到最合适的线。
如果实际值与预测值之间的误差最小,则回归线被称为最佳拟合线。
下图显示了输入数据点X处误差为Îμ的回归直线。误差计算涵盖所有数据点,我们的目标是最小化平均误差/损失。我们可以使用不同类型的损失函数,如均方误差(MSE)、平均误差(MAE)、L1损失,L2失去,等等。
那么,我们如何将实际值与预测值之间的误差最小化呢?让我们讨论一个重要的概念,即成本函数或损失函数。
线性回归的损失函数
实际值与预测值之间的误差可以通过成本函数的损失函数来量化。成本函数将模型的预测值和实际值合并,返回一个代表模型预测成本的单一缩放器值。我们的主要目标是最小化成本函数。
最常用的成本函数是均方误差函数。
- n 为数据点的数量。
- Yi为第 i 个数据点的观测值。
为第 i 个数据点的预测值。
优化的梯度下降
现在我们已经定义了损失函数。下一步是最小化它,并找到参数或权重的优化值。寻找参数的最优值以使损失或误差最小的过程被称为模型优化。
梯度下降是线性回归中最常用的优化技术之一。
为了找到参数的最优值,通常会使用梯度下降法,尤其是在数据集庞大的情况下。梯度下降会迭代调整参数,朝成本函数最陡峭的下降方向进行。
参数更新由下式给出
其中 α 是学习率,偏导数为:
这些梯度用于更新参数,直到达到收敛点(即当 变化w0以及w1变得微不足道)。
线性回归的假设
以下是线性回归模型对数据集的一些假设——
多重共线性− 线性回归模型假设数据中几乎不存在多重共线性。基本上,当自变量或特征对它们存在依赖时,就会发生多重共线性。
自相关性 − 线性回归模型假设数据中几乎没有或没有自相关性。基本上,自相关发生在残余误差之间存在依赖性时。
变量间关系 − 线性回归模型假设反应变量与特征变量之间的关系必须是线性的。
违反这些假设可能导致估计偏差或效率低下。验证这些假设对于确保模型准确性至关重要。
线性回归的评估度量
为了评估线性回归模型的性能,会使用多种评估指标——
R平方(R2)− 它衡量因变量方差中可由自变量预测的比例。
均方误差(MSE)− 它衡量预测值与实际值之间平方差之和的平均值。
均方误差根(RMSE)− 它衡量MSE的平方根。
平均绝对误差(MAE)− 它衡量预测值与实际值之间绝对值之和的平均值。
线性回归的应用
1. 预测建模
线性回归被广泛用于预测建模。例如,在房地产领域,基于大小、位置和卧室数量等特征预测房价,可以帮助买家、卖家和经纪人做出明智的决策。
2. 特征选择
在多元线性回归中,分析系数有助于特征选择。系数小或零的特征可能被认为不那么重要,可以省略以简化模型。
3. 财务预测
在金融领域,线性回归模型预测股票价格、经济指标和市场趋势。准确的预测可以指导投资策略和财务规划。
4. 风险管理
线性回归通过建模风险因素与财务指标之间的关系,有助于风险评估。例如,在保险领域,它可以建模保单持有人特征与理赔金额之间的关系。
线性回归的优点
- 可解释性 − 线性回归易于理解,这在解释模型如何做出决策时非常有用。
- 速度 − 线性回归比许多其他机器学习算法更快的训练。
- 预测分析 − 线性回归是预测分析的基本构建模块。
- 线性关系 − 线性回归是一种强大的统计方法,用于寻找变量间的线性关系。
- 简单性 − 线性回归易于实现和解释。
- 效率 − 线性回归计算效率高。
线性回归的常见挑战
1. 过拟合
当回归模型在训练数据上表现良好,但在测试数据上缺乏推广时,就会发生过拟合。过拟合导致对新数据的预测不佳。
2. 多重共线性
当因变量(预测变量或特征变量)相关时,这种情况被称为多线性。在这种情况下,参数(系数)的估计值可能存在不稳定。
3. 异类及其影响
离群值可能导致回归线对大多数数据点的拟合度差。
多项式回归:线性回归的替代方案
多项式线性回归是一种回归分析,其中将自变量与因变量之间的关系建模为n次多项式函数。多项式回归允许在简单线性回归和多重线性回归之外捕捉到更复杂的变量关系。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 26
 0
- 0


 已为社区贡献3条内容

所有评论(0)