机器学习笔记_西瓜书_04(决策树)
决策树学习笔记
1. 决策树:解决“复杂决策拆解”的树状模型
1.1 为什么需要决策树?
现实中很多分类/回归问题无法用单一规则解决(比如判断“是否为好瓜”,需同时看色泽、根蒂、敲声等多个属性),直接处理高维数据或复杂逻辑会导致模型混乱。决策树的核心价值是模拟人类“分步骤决策”的思维,将复杂问题拆解为一系列简单的“属性测试”子问题(如“先看纹理是否清晰→再看根蒂是否蜷缩”),降低决策难度,同时保证结果可解释。
1.2 定义与核心结构
决策树是一种基于树状拓扑实现“分而治之”(divide-and-conquer)的监督学习模型,由三类结点组成:
- 根结点:包含所有训练样本,是决策的起点(如“所有西瓜样本”);
- 内部结点:对应一个“属性测试”(如“纹理=清晰?”“密度≤0.381?”),每个测试将当前样本集划分为多个子集(子分支);
- 叶结点:对应最终决策结果(分类任务为类别标记,如“好瓜/坏瓜”;回归任务为实值输出,如“房价=150万”)。
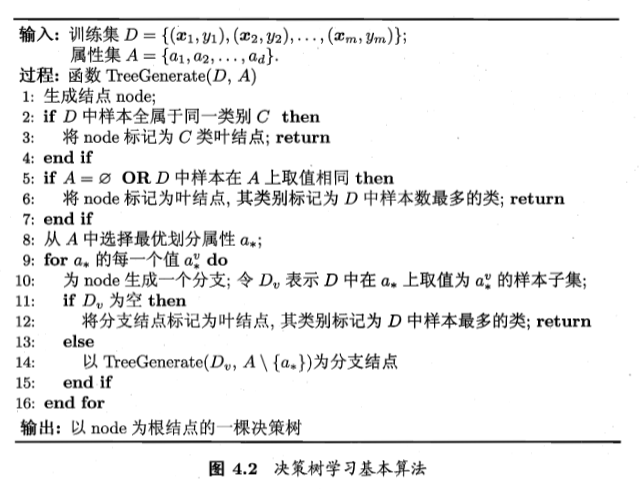
核心生成逻辑(递归终止条件)
决策树通过递归方式构建,当满足以下任一条件时停止划分,将结点标记为叶结点:
- 样本全同类别:当前结点所有样本属于同一类(如“全是好瓜”),无需进一步测试;
- 无可用属性/样本属性全同:属性已用尽,或所有样本在剩余属性上取值完全相同(如“所有西瓜都是青绿色、蜷缩根蒂”),此时叶结点类别取“样本数最多的类”(避免无意义划分);
- 样本为空:当前分支无样本(如“纹理=透明”的西瓜不存在),叶结点类别取“父结点样本数最多的类”(继承父结点的统计信息)。
1.3 作用与优势
- 可解释性极强:决策路径(如“纹理=清晰→根蒂=蜷缩→好瓜”)直观易懂,适合医疗(需解释诊断依据)、金融(需解释风控逻辑)等场景;
- 对数据友好:无需标准化/归一化,可直接处理离散属性(如色泽)和连续属性(如密度,需特殊处理),对噪声有一定容忍度;
- 适用范围广:同时支持分类(如西瓜好坏判断)和回归(如股价预测)任务,是集成学习(如随机森林)的核心基础组件。
2. 划分选择:如何选“最能提升纯度”的属性?
决策树的核心是“选对属性”——每次划分都要让子结点的样本“尽可能属于同一类”(纯度尽可能高)。但“纯度”是抽象概念,需要量化方法,因此诞生了三类经典划分准则:信息增益、增益率、基尼指数。
2.1 信息增益(ID3算法):用“信息熵”量化纯度提升
2.1.1 为什么需要信息增益?
早期决策树缺乏统一的“纯度衡量标准”,无法判断哪个属性划分效果更好。信息增益的核心是用“信息熵”量化样本集的混乱程度,通过计算“划分前后熵的减少量”,直接反映属性对纯度的提升效果——增益越大,划分后样本越“纯”。
2.1.2 核心概念与公式
-
信息熵(Entropy):衡量样本集“混乱程度”的指标(混乱程度越低=纯度越高)。
对样本集DDD,设第kkk类样本占比为pkp_kpk(k=1,2,...,∣Y∣k=1,2,...,|\mathcal{Y}|k=1,2,...,∣Y∣,∣Y∣|\mathcal{Y}|∣Y∣为类别数),则:
Ent(D)=−∑k=1∣Y∣pklog2pkEnt(D)=-\sum_{k=1}^{|\mathcal{Y}|}p_k\log_2p_kEnt(D)=−k=1∑∣Y∣pklog2pk- 含义:熵越小,样本类别越集中(如全是好瓜时Ent(D)=0Ent(D)=0Ent(D)=0);熵越大,类别越混杂(如好瓜、坏瓜各占50%时Ent(D)=1Ent(D)=1Ent(D)=1);
- 约定:若pk=0p_k=0pk=0(某类样本不存在),则pklog2pk=0p_k\log_2p_k=0pklog2pk=0(避免对数无意义)。
-
信息增益(Gain):划分后“信息熵的减少量”,即“纯度的提升量”。
对属性aaa(有VVV个取值{a1,a2,...,aV}\{a^1,a^2,...,a^V\}{a1,a2,...,aV}),划分后产生VVV个子集DvD^vDv(DvD^vDv是DDD中a=ava=a^va=av的样本),则:
Gain(D,a)=Ent(D)−∑v=1V∣Dv∣∣D∣Ent(Dv)Gain(D,a)=Ent(D)-\sum_{v=1}^V\frac{|D^v|}{|D|}Ent(D^v)Gain(D,a)=Ent(D)−v=1∑V∣D∣∣Dv∣Ent(Dv)- 关键项∣Dv∣∣D∣\frac{|D^v|}{|D|}∣D∣∣Dv∣:子样本集DvD^vDv的“权重”(样本占比),避免小样本子集对增益的影响过大;
- 逻辑:用划分前的总熵,减去划分后各子集熵的加权和,差值越大,说明划分对纯度的提升越显著。
2.1.3 如何解决问题?(示例:西瓜数据集2.0)
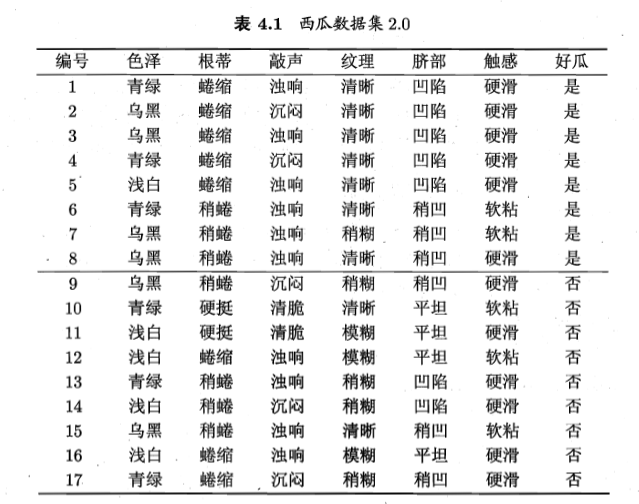
西瓜数据集2.0含17个样本(8好9坏),需选“纹理”“色泽”等属性中的最优者:
- 计算根结点总熵Ent(D)Ent(D)Ent(D):
p1=817p_1=\frac{8}{17}p1=178(好瓜占比),p2=917p_2=\frac{9}{17}p2=179(坏瓜占比),代入得Ent(D)≈0.998Ent(D)≈0.998Ent(D)≈0.998(混乱程度较高)。 - 计算“纹理”的信息增益:
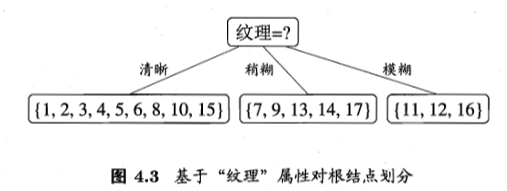
- “纹理=清晰”:9个样本(6好3坏),Ent(D1)≈0.918Ent(D^1)≈0.918Ent(D1)≈0.918;
- “纹理=稍糊”:5个样本(2好3坏),Ent(D2)≈0.971Ent(D^2)≈0.971Ent(D2)≈0.971;
- “纹理=模糊”:3个样本(0好3坏),Ent(D3)=0Ent(D^3)=0Ent(D3)=0;
加权和=917×0.918+517×0.971+317×0≈0.617\frac{9}{17}×0.918 + \frac{5}{17}×0.971 + \frac{3}{17}×0≈0.617179×0.918+175×0.971+173×0≈0.617,因此Gain(D,纹理)=0.998−0.617≈0.381Gain(D,纹理)=0.998-0.617≈0.381Gain(D,纹理)=0.998−0.617≈0.381。
- 对比其他属性:“色泽”增益≈0.109,“脐部”增益≈0.289,因此“纹理”是最优属性——它能最大程度降低样本混乱度。
2.1.4 局限与后续改进
信息增益对“取值数目多的属性”有偏好(如“编号”属性,每个取值对应1个样本,划分后熵为0,增益最大,但无泛化意义),因此需要增益率来修正。
2.2 增益率(C4.5算法):修正信息增益的偏好问题
2.2.1 为什么需要增益率?
信息增益的“多取值属性偏好”会导致决策树选择无意义的属性(如“编号”),增益率的核心是引入“固有值”惩罚取值过多的属性——取值越多的属性,固有值越大,增益率被修正得越小,从而避免偏好。
2.2.2 核心概念与公式
-
固有值(Intrinsic Value, IV):衡量属性“取值分散程度”的指标——属性取值越多、越分散,IV越大。
对属性aaa,有VVV个取值,则:
IV(a)=−∑v=1V∣Dv∣∣D∣log2∣Dv∣∣D∣IV(a)=-\sum_{v=1}^V\frac{|D^v|}{|D|}\log_2\frac{|D^v|}{|D|}IV(a)=−v=1∑V∣D∣∣Dv∣log2∣D∣∣Dv∣- 示例:“编号”属性(17个取值)的IV≈4.088IV≈4.088IV≈4.088,“纹理”属性(3个取值)的IV≈1.580IV≈1.580IV≈1.580,前者远大于后者。
-
增益率(Gain_ratio):用固有值修正信息增益,公式为:
Gain_ratio(D,a)=Gain(D,a)IV(a)Gain\_ratio(D,a)=\frac{Gain(D,a)}{IV(a)}Gain_ratio(D,a)=IV(a)Gain(D,a)- 逻辑:即使某属性信息增益高,若其IV大(取值多),增益率也会被拉低,从而抑制对多取值属性的偏好。
2.2.3 如何解决问题?(示例:对比“编号”与“纹理”)
- “编号”属性:信息增益≈0.998,IV≈4.088,增益率≈0.9984.088≈0.244\frac{0.998}{4.088}≈0.2444.0880.998≈0.244;
- “纹理”属性:信息增益≈0.381,IV≈1.580,增益率≈0.3811.580≈0.241\frac{0.381}{1.580}≈0.2411.5800.381≈0.241;
- 结果:两者增益率接近,但“纹理”是有实际意义的属性,“编号”无意义——增益率成功避免了选择“编号”。
2.2.4 补充:C4.5的启发式策略
增益率对“取值少的属性”有偏好(如二值属性IV小,增益率易偏高),因此C4.5不直接选增益率最大的属性,而是:
- 先筛选“信息增益高于平均水平”的属性(保证基础纯度提升);
- 再从这些属性中选“增益率最大”的(避免多取值偏好)。
2.3 基尼指数(CART算法):高效的纯度衡量指标
2.3.1 为什么需要基尼指数?
信息增益/增益率需要计算对数,在样本量大时计算效率低。基尼指数的核心是用“随机抽样类别不同的概率”量化纯度,无需对数运算,计算更快,同时支持分类和回归任务。
2.3.2 核心概念与公式
-
基尼值(Gini):衡量“随机抽取两个样本类别不同的概率”——**概率越小,纯度越高 **。
对样本集DDD,第kkk类样本占比为pkp_kpk,则:
Gini(D)=1−∑k=1∣Y∣pk2Gini(D)=1-\sum_{k=1}^{|\mathcal{Y}|}p_k^2Gini(D)=1−k=1∑∣Y∣pk2- 示例:全好瓜样本Gini(D)=0Gini(D)=0Gini(D)=0(抽两个样本类别必相同);好瓜、坏瓜各50%时Gini(D)=0.5Gini(D)=0.5Gini(D)=0.5(抽两个样本类别不同的概率50%)。
-
基尼指数(Gini_index):划分后各子结点基尼值的加权和,公式为:
Gini_index(D,a)=∑v=1V∣Dv∣∣D∣Gini(Dv)Gini\_index(D,a)=\sum_{v=1}^V\frac{|D^v|}{|D|}Gini(D^v)Gini_index(D,a)=v=1∑V∣D∣∣Dv∣Gini(Dv)- 逻辑:选择基尼指数最小的属性——指数越小,划分后子结点的“类别不同概率”越低,纯度越高。
2.3.3 如何解决问题?(示例:西瓜数据集2.0)
根结点DDD(8好9坏),计算“根蒂”的基尼指数:
- 根结点基尼值:Gini(D)=1−((817)2+(917)2)≈0.497Gini(D)=1-\left(\left(\frac{8}{17}\right)^2 + \left(\frac{9}{17}\right)^2\right)≈0.497Gini(D)=1−((178)2+(179)2)≈0.497;
- “根蒂”的三个子集:
- 蜷缩(8个样本:5好3坏):Gini(D1)=1−((58)2+(38)2)=0.469Gini(D^1)=1-\left(\left(\frac{5}{8}\right)^2 + \left(\frac{3}{8}\right)^2\right)=0.469Gini(D1)=1−((85)2+(83)2)=0.469;
- 稍蜷(6个样本:3好3坏):Gini(D2)=0.5Gini(D^2)=0.5Gini(D2)=0.5;
- 硬挺(3个样本:0好3坏):Gini(D3)=0Gini(D^3)=0Gini(D3)=0;
- 基尼指数:817×0.469+617×0.5+317×0≈0.376\frac{8}{17}×0.469 + \frac{6}{17}×0.5 + \frac{3}{17}×0≈0.376178×0.469+176×0.5+173×0≈0.376,低于其他属性(如“色泽”基尼指数≈0.44),因此“根蒂”是较优属性。
2.4 三种准则对比
| 准则 | 核心优势 | 核心局限 | 适用场景 |
|---|---|---|---|
| 信息增益 | 直观反映纯度提升 | 偏好多取值属性 | 样本量小、属性取值少的场景 |
| 增益率 | 修正多取值偏好 | 偏好少取值属性 | 属性取值差异大的场景 |
| 基尼指数 | 计算高效,支持分类/回归 | 对噪声较敏感 | 大规模数据、实时预测场景 |
3. 剪枝:解决决策树“过拟合”的核心手段
3.1 为什么需要剪枝?
决策树在训练时会“尽可能拟合训练数据”,导致分支过多(如为了拟合个别噪声样本增加多层分支),泛化性能下降(对新样本预测不准)。剪枝的核心是移除“冗余分支”,在“模型复杂度”和“泛化性能”间找平衡。
3.2 预剪枝:生成过程中“提前停止划分”
3.2.1 核心逻辑:避免“无效划分”
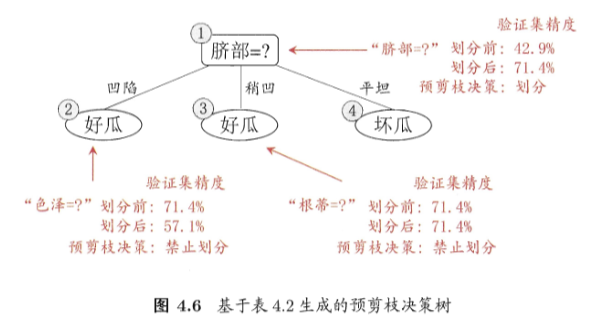
在每个非叶结点划分前,先用验证集评估:若“划分后验证集精度提升”,则执行划分;否则停止划分,将该结点标记为叶结点(类别取训练集多数类)——本质是“用验证集判断分支是否有用”,避免生成冗余分支。
3.2.2 如何解决问题?(示例:西瓜数据集2.0)
训练集:10个样本(6好4坏);验证集:7个样本(3好4坏),以根结点和“脐部”属性为例:
- 划分前:根结点标记为“好瓜”(训练集多数类),验证集所有样本预测为“好瓜”,精度=3/7≈42.9%;
- 划分后:“脐部”分3个分支(凹陷:4好→好瓜;稍凹:2好2坏→好瓜;平坦:2坏→坏瓜),验证集5个正确(2凹陷好瓜+1稍凹好瓜+2平坦坏瓜),精度=5/7≈71.4%;
- 决策:划分后精度提升,执行划分;后续对“脐部=凹陷”子结点,若用“色泽”划分后精度降至57.1%,则禁止划分——避免生成无效分支。
3.2.3 优缺点
- 优点:计算开销小(无需生成完整树),避免过拟合;
- 缺点:“贪心”本质可能错过“当前划分无效,但后续划分有效”的分支(如某分支当前精度无提升,但深层划分后精度显著提升),可能导致欠拟合。
3.3 后剪枝:生成完整树后“自底向上剪枝”
3.3.1 核心逻辑:先“充分拟合”再“优化”
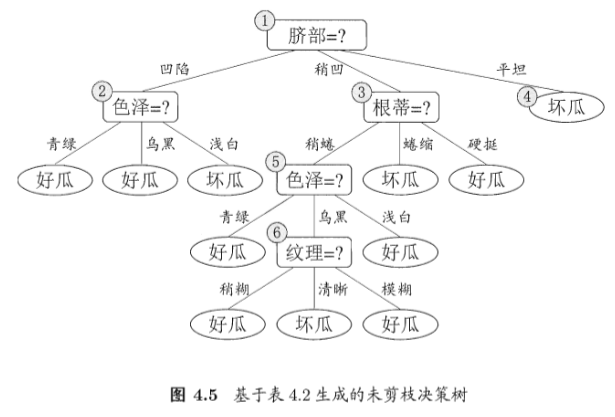
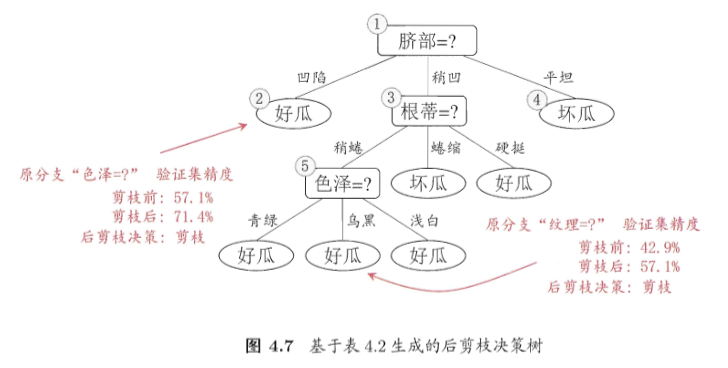
- 先生成完整决策树(所有可划分结点均划分,如西瓜数据集2.0的完整树验证集精度仅42.9%,过拟合严重);
- 自底向上考察每个非叶结点:模拟“剪除该结点所有子分支,替换为叶结点”(类别取该结点训练集多数类);
- 若剪枝后验证集精度提升或不变(说明分支是冗余的),则保留剪枝结果;否则不剪——本质是“用验证集判断分支是否冗余”,保留有用分支。
3.3.2 如何解决问题?(示例:西瓜数据集2.0的结点6剪枝)
- 结点6:底层内部结点,含训练样本{7,15}(全为好瓜),子分支为“纹理=稍糊”等;
- 剪枝前:结点6的子分支对验证集预测错误多,完整树精度42.9%;
- 剪枝后:结点6替换为“好瓜”叶结点,验证集正确分类数从3个增至4个,精度提升至57.1%;
- 决策:执行剪枝,继续考察上层结点(如结点5、结点2),最终树精度提升至71.4%——成功移除过拟合分支。
3.3.3 优缺点
- 优点:泛化性能更优(充分利用数据规律,避免欠拟合);
- 缺点:计算开销大(需生成完整树+逐个结点评估)。
3.4 预剪枝vs后剪枝对比
| 维度 | 预剪枝 | 后剪枝 |
|---|---|---|
| 核心逻辑 | 提前判断分支有效性 | 事后判断分支冗余性 |
| 泛化性能 | 可能欠拟合 | 更优(过拟合风险低) |
| 计算开销 | 小 | 大 |
| 适用场景 | 快速原型、小规模数据 | 高精度要求、大规模数据 |
4. 连续值处理:C4.5二分法(将连续属性“离散化”)
4.1 为什么需要特殊处理连续值?
连续属性(如密度、含糖率)取值无限,无法像离散属性(如色泽)那样“按每个取值划分”(会导致分支无限多)。C4.5的解决方案是将连续属性“二分法离散化”,转化为“≤t”和“>t”两个区间,从而适配决策树的划分逻辑。
4.2 核心步骤:生成候选划分点→选最优阈值
步骤1:生成候选划分点
对连续属性aaa,收集其在训练集DDD上的所有不同取值,排序为a1<a2<...<ana^1 < a^2 < ... < a^na1<a2<...<an,候选划分点为“相邻取值的中位点”:
Ta={ai+ai+12∣1≤i≤n−1}T_a=\left\{\frac{a^i+a^{i+1}}{2}\mid1\leq i\leq n-1\right\}Ta={2ai+ai+1∣1≤i≤n−1}
- 逻辑:区间[ai,ai+1)[a^i,a^{i+1})[ai,ai+1)内任取t,划分结果相同,因此只需用中位点作为候选(减少计算量);
- 示例:“密度”取值0.243、0.245、0.343…,候选点为0.244、0.294…共16个。
步骤2:选择最优划分点t*
对每个候选点t∈Tat\in T_at∈Ta,将样本分为Dt−={x∣a(x)≤t}D_t^-=\{x\mid a(x)\leq t\}Dt−={x∣a(x)≤t}和Dt+={x∣a(x)>t}D_t^+=\{x\mid a(x)>t\}Dt+={x∣a(x)>t},计算信息增益:
Gain(D,a,t)=Ent(D)−(∣Dt−∣∣D∣Ent(Dt−)+∣Dt+∣∣D∣Ent(Dt+))Gain(D,a,t)=Ent(D)-\left(\frac{|D_t^-|}{|D|}Ent(D_t^-) + \frac{|D_t^+|}{|D|}Ent(D_t^+)\right)Gain(D,a,t)=Ent(D)−(∣D∣∣Dt−∣Ent(Dt−)+∣D∣∣Dt+∣Ent(Dt+))
选择使Gain(D,a,t)Gain(D,a,t)Gain(D,a,t)最大的t∗t^*t∗作为最优划分点——本质是“找一个阈值t,让划分后纯度提升最大”。
步骤3:执行划分与关键特点
按“a≤t∗a\leq t^*a≤t∗”和“a>t∗a>t^*a>t∗”分两个子结点,后续递归处理。需注意:
- 连续属性可重复使用:与离散属性不同(划分后不可复用),连续属性的子结点可进一步细分(如父结点用“密度≤0.381”,子结点可用“密度≤0.6”)——因为每次划分仅覆盖部分区间,需进一步细分提升纯度。
4.3 示例:西瓜数据集3.0的“密度”处理
- 候选点t=0.381t=0.381t=0.381:
- Dt−D_t^-Dt−(密度≤0.381):5个样本(全坏),Ent(Dt−)=0Ent(D_t^-)=0Ent(Dt−)=0;
- Dt+D_t^+Dt+(密度>0.381):12个样本(8好4坏),Ent(Dt+)≈0.811Ent(D_t^+)≈0.811Ent(Dt+)≈0.811;
- 信息增益:Gain(D,密度,0.381)=0.998−(517×0+1217×0.811)≈0.262Gain(D,密度,0.381)=0.998 - \left(\frac{5}{17}×0 + \frac{12}{17}×0.811\right)≈0.262Gain(D,密度,0.381)=0.998−(175×0+1712×0.811)≈0.262,为所有候选点最大,因此t∗=0.381t^*=0.381t∗=0.381。
5. 缺失值处理:C4.5策略(不丢弃样本,利用有效信息)
5.1 为什么需要特殊处理缺失值?
现实数据常存在属性值缺失(如西瓜“色泽”脱落、患者“血压”未测量),直接丢弃缺失样本会浪费大量信息。C4.5的核心是用“样本权重”和“有效样本子集”,让缺失样本仍能参与决策树构建,不浪费有效信息。
5.2 核心问题与解决方案
缺失值场景需解决两个问题:“如何选划分属性”“如何划分缺失样本”,需先定义三个关键参数(解决“如何量化有效信息”):
关键参数定义(解决“信息量化”问题)
设总样本集DDD,待评估属性aaa,每个样本初始权重为1:
-
无缺失样本权重占比ρ\rhoρ:
ρ=∑x∈D~wx∑x∈Dwx\rho=\frac{\sum_{x\in\tilde{D}}w_x}{\sum_{x\in D}w_x}ρ=∑x∈Dwx∑x∈D~wx- D~\tilde{D}D~:DDD中“属性aaa无缺失”的有效样本子集;
- 作用:避免缺失样本高估属性重要性(如“色泽”缺失3个样本,ρ=14/17≈0.824\rho=14/17≈0.824ρ=14/17≈0.824,说明仅82.4%的样本能评估“色泽”)。
-
无缺失样本中第kkk类权重占比p~k\tilde{p}_kp~k:
p~k=∑x∈D~kwx∑x∈D~wx\tilde{p}_k=\frac{\sum_{x\in\tilde{D}_k}w_x}{\sum_{x\in\tilde{D}}w_x}p~k=∑x∈D~wx∑x∈D~kwx- D~k\tilde{D}_kD~k:D~\tilde{D}D~中第kkk类样本子集;
- 作用:计算有效样本的类别分布(如D~\tilde{D}D~中6好8坏,p~1=6/14≈0.429\tilde{p}_1=6/14≈0.429p~1=6/14≈0.429),用于计算信息熵。
-
无缺失样本中属性aaa取ava^vav的权重占比r~v\tilde{r}_vr~v:
r~v=∑x∈D~vwx∑x∈D~wx\tilde{r}_v=\frac{\sum_{x\in\tilde{D}^v}w_x}{\sum_{x\in\tilde{D}}w_x}r~v=∑x∈D~wx∑x∈D~vwx- D~v\tilde{D}^vD~v:D~\tilde{D}D~中“a=ava=a^va=av”的样本子集;
- 作用:按比例分配缺失样本(如“纹理”缺失样本,按r~清晰=7/15\tilde{r}_{清晰}=7/15r~清晰=7/15、r~稍糊=5/15\tilde{r}_{稍糊}=5/15r~稍糊=5/15分配权重)。
问题1:如何选择划分属性(修正信息增益)
仅用有效样本D~\tilde{D}D~计算信息增益,再用ρ\rhoρ加权修正(避免缺失样本影响):
Gain(D,a)=ρ×[Ent(D~)−∑v=1Vr~v⋅Ent(D~v)]Gain(D,a)=\rho×\left[Ent(\tilde{D}) - \sum_{v=1}^V\tilde{r}_v\cdot Ent(\tilde{D}^v)\right]Gain(D,a)=ρ×[Ent(D~)−v=1∑Vr~v⋅Ent(D~v)]
- 逻辑:用ρ\rhoρ体现“有效样本比例”,确保属性增益不被缺失样本高估,最终选增益最大的属性。
问题2:如何划分缺失样本(按比例分配权重)
对“属性aaa缺失”的样本xxx(权重wxw_xwx),不丢弃,而是按r~v\tilde{r}_vr~v比例分配到所有子结点:
- 样本xxx在“a=ava=a^va=av”子结点中的权重为wx×r~vw_x×\tilde{r}_vwx×r~v;
- 示例:“纹理”缺失样本(wx=1w_x=1wx=1),r~清晰=7/15≈0.467\tilde{r}_{清晰}=7/15≈0.467r~清晰=7/15≈0.467,则分配到“清晰”分支的权重=1×0.467≈0.467,后续计算用修正后权重——既利用了样本的其他属性信息,又不浪费数据。
5.3 核心优势
不丢弃缺失样本,最大限度保留数据信息(如“色泽缺失但根蒂=蜷缩”的样本,仍能通过根蒂参与后续划分),尤其适合样本量小、缺失率高的场景。
6. 多变量决策树:突破“轴平行边界”的进阶模型
6.1 为什么需要多变量决策树?
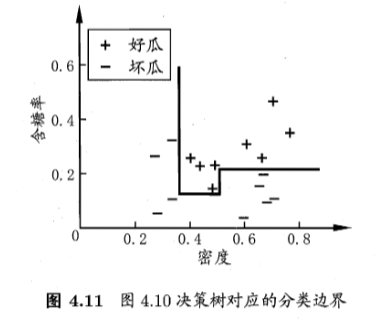
传统单变量决策树的划分边界“与坐标轴平行”(如“密度≤0.381”是竖线,“含糖率≤0.126”是横线),面对复杂非线性分布(如好瓜集中在“密度高、含糖率高”的斜向区域)时,需多次划分才能近似边界,导致树结构复杂(如4层分支),泛化性能下降。多变量决策树的核心是用“属性线性组合”实现“斜划分边界”,一次划分替代多次轴平行划分,简化模型。
6.2 核心定义:属性线性组合替代单个属性
6.2.1 划分规则
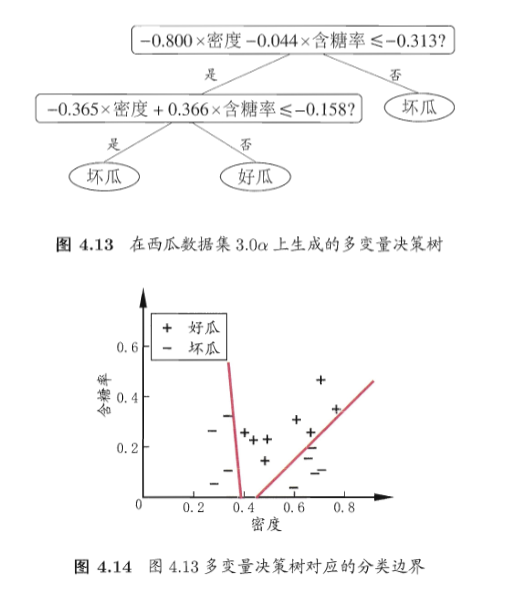
非叶结点不再测试“单个属性”,而是测试“属性的线性组合”,每个非叶结点是一个线性分类器:
∑i=1dwiai=t\sum_{i=1}^{d}w_ia_i=ti=1∑dwiai=t
- ddd:属性总数(如西瓜数据的“密度”“含糖率”,d=2d=2d=2);
- aia_iai:第iii个属性的取值(如密度=0.697,含糖率=0.460);
- wiw_iwi:属性aia_iai的权重(绝对值越大,影响越强,如w密度=−0.8w_{密度}=-0.8w密度=−0.8,w含糖率=−0.044w_{含糖率}=-0.044w含糖率=−0.044——密度对划分的影响远大于含糖率);
- ttt:划分阈值(如t=−0.313t=-0.313t=−0.313)。
6.2.2 划分逻辑
对样本xxx,计算线性组合结果z=∑i=1dwiai(x)z=\sum_{i=1}^dw_ia_i(x)z=∑i=1dwiai(x):
- 若z≤tz\leq tz≤t:进入左子结点;
- 若z>tz>tz>t:进入右子结点;
- 示例:西瓜样本(密度=0.697,含糖率=0.460),z=−0.8×0.697−0.044×0.460≈−0.592≤−0.313z=-0.8×0.697 -0.044×0.460≈-0.592\leq-0.313z=−0.8×0.697−0.044×0.460≈−0.592≤−0.313,进入左子结点(预测为好瓜)。
6.3 如何确定参数wiw_iwi和ttt?(参数学习)
wiw_iwi和ttt从当前结点样本中学习,核心是“以纯度最大化为目标,搜索最优参数”:
- 参数搜索范围:wiw_iwi在小范围(如[−1,1][-1,1][−1,1])采样候选值(如w1w_1w1取-0.8,-0.7,…,0.8),ttt从“线性组合结果”的中位点中选择;
- 纯度评估:对每个候选参数组合,计算划分后的信息增益/基尼指数;
- 最优选择:选择纯度最高的参数组合(如西瓜数据中,w密度=−0.8w_{密度}=-0.8w密度=−0.8、w含糖率=−0.044w_{含糖率}=-0.044w含糖率=−0.044、t=−0.313t=-0.313t=−0.313的组合划分后纯度最高)。
6.4 训练成本与模型简化的权衡
6.4.1 训练成本:确实更高
参数搜索空间远大于传统树(如2个属性需搜“w1×w2×tw_1×w_2×tw1×w2×t”,共数千组候选),一次性训练开销增加。
6.4.2 模型简化:收益远大于成本
- 树结构极大简化:用1次斜划分替代传统树多次轴平行划分(如西瓜数据的斜向分布,传统树需4层分支,多变量树仅需1层);
- 预测效率提升:预测时仅需计算1次线性组合+1次阈值比较,速度快(尤其适合大规模数据);
- 泛化性能更优:分支少,模型复杂度低,不易拟合训练集噪声(如传统树的深层分支可能拟合个别异常样本)。
6.5 示例:西瓜数据集3.0a的多变量树
西瓜数据集3.0a含“密度”“含糖率”两个属性,好瓜集中在“密度高、含糖率高”的斜向区域:
- 传统树:需“密度≤0.381→含糖率≤0.126→密度≤0.6”3次划分;
- 多变量树:1次划分“−0.8×密度−0.044×含糖率≤−0.313-0.8×密度 -0.044×含糖率 ≤-0.313−0.8×密度−0.044×含糖率≤−0.313”,直接分开好瓜(左子结点)和坏瓜(右子结点),树深度从3层降至1层——模型结构显著简化,泛化性能提升。
7. 实践验证:基于鸢尾花数据集 (Python/Sklearn)
为了验证上述理论(如划分准则差异、剪枝效果、轴平行边界),我们使用经典的鸢尾花(Iris)数据集在 Jupyter Notebook 环境下进行实验。
7.1 环境准备与数据加载
在构建树之前,需先理解数据结构并进行“训练集/测试集”划分,这是评估泛化能力的基础(对应 3.1 节)。
# 导入必要库
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
import pandas as pd

# 1. 加载数据
# 鸢尾花数据含4个连续特征:花萼/花瓣的长宽
iris = load_iris()
X = iris.data
y = iris.target

# 2. 划分数据集 (Hold-out Method)
# test_size=0.3: 预留30%数据作为“未见过的考题”,用于评估模型泛化性能
# random_state=42: 锁定随机种子,保证每次实验结果可复现
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
7.2 实验一:划分准则的较量 (Gini vs. Entropy)
验证目标:对比笔记 Section 2 中提到的 CART(基尼指数)与 ID3/C4.5(信息熵)的实际效果。
# 模型 A:使用基尼指数 (CART思路,sklearn默认)
# criterion='gini' 对应笔记 2.3
clf_gini = DecisionTreeClassifier(criterion='gini', random_state=42)
clf_gini.fit(X_train, y_train)

# 模型 B:使用信息熵 (ID3/C4.5思路)
# criterion='entropy' 对应笔记 2.1
clf_entropy = DecisionTreeClassifier(criterion='entropy', random_state=42)
clf_entropy.fit(X_train, y_train)

# 评估与对比
print(f"Gini Accuracy: {clf_gini.score(X_test, y_test)}")
print(f"Entropy Accuracy: {clf_entropy.score(X_test, y_test)}")
在 sklearn 中,默认使用
gini。虽然理论上两者计算逻辑不同(熵涉及对数运算,基尼仅涉及平方),但在鸢尾花这种小规模数据上,两者准确率通常持平。工程上优先选 Gini 以提升计算速度。
7.3 实验二:决策树结构可视化
验证目标:直观观察笔记 SectionSection 1.2** 提到的“根结点-内部结点-叶结点”结构及“递归生成”过程。
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree

plt.figure(figsize=(12, 8))
# filled=True: 颜色深浅代表纯度(颜色越深,Gini越接近0,纯度越高)
plot_tree(clf_gini,
          feature_names=iris.feature_names,
          class_names=iris.target_names,
          filled=True)
plt.title("Decision Tree Structure (CART)")
plt.show()
- 根结点的选择:观察树的最顶层,那是区分度最高的属性(即信息增益/基尼指数最优)。
- 连续值处理:所有节点判断条件均为
feature <= threshold,验证了笔记 Section 4.2 中的“二分法”策略。
7.4 实验三:剪枝与偏差-方差权衡 (Pruning)
验证目标:验证笔记 Section 3 中“剪枝”对模型过拟合/欠拟合的影响。
# --- 模型 C:完全生长 (无剪枝) ---
# max_depth=None: 允许树一直生长,直到叶子纯度为0
clf_full = DecisionTreeClassifier(max_depth=None, random_state=42)
clf_full.fit(X_train, y_train)

# --- 模型 D:预剪枝 (限制深度) ---
# max_depth=3: 强制树高不超过3层,模拟预剪枝
clf_pruned = DecisionTreeClassifier(max_depth=3, random_state=42)
clf_pruned.fit(X_train, y_train)

# 对比训练集与测试集表现
print("Full Tree Train/Test:", clf_full.score(X_train, y_train), clf_full.score(X_test, y_test))
print("Pruned Tree Train/Test:", clf_pruned.score(X_train, y_train), clf_pruned.score(X_test, y_test))
📝 关键现象解析(Bias-Variance Tradeoff):
实验中可能会观察到 剪枝后精度反而下降 的现象,需辩证分析:
- 训练精度下降:这是必然的。剪枝阻止了模型“死记硬背”训练集的噪声,导致训练分降低(偏差增加)。
- 测试精度下降:若测试分也下降,说明剪枝过重(Underfitting)。如
max_depth=3max_depth=3` 可能对当前数据来说太浅,没能学完数据的真实规律。
结论:剪枝是必须结论:剪枝是必须的,但“剪多少”需要通过超参数调优(如交叉验证)来寻找最佳平衡点。*
7.5 实验四:直观感受“轴平行边界”
验证目标:验证笔记 Section 6 中提到的单变量决策树局限性——决策边界只能是横平竖直的。
from sklearn.inspection import DecisionBoundaryDisplay

# 仅取两个特征以便二维绘图
X_2d = X[:, 2:] # 花瓣长度, 花瓣宽度
y_2d = y

# 训练简单模型
clf_2d = DecisionTreeClassifier(max_depth=4).fit(X_2d, y_2d)

# 绘制边界
plt.figure(figsize=(10, 6))
DecisionBoundaryDisplay.from_estimator(clf_2d, X_2d, cmap=plt.cm.coolwarm, alpha=0.8)
plt.scatter(X_2d[:, 0], X_2d[:, 1], c=y_2d, edgecolors='k')
plt.title("Decision Boundaries (Axis-Parallel Check)")
plt.show()
观察生成的图像,不同颜色区域的边界全是垂直或水平的直线(矩形切割)。如果数据分布是斜向的(如鸢尾花数据中 Versicolor 和 Virginica 的分界),决策树只能通过锯锯齿状的阶梯边界**去逼近,这解释了为什么在复杂数据上树会变得很深,也引出了对 多变量决策树 或 随机森林 的需求。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)