深度学习项目训练环境实操手册:PyTorch Distributed Checkpoint(FSDP)实践
深度学习项目训练环境实操手册:PyTorch Distributed Checkpoint(FSDP)实践
当你面对一个需要多张GPU才能跑起来的大模型时,是不是经常感到头疼?显存不够、训练中断后要从头再来、多卡之间的状态同步复杂……这些问题在分布式训练中尤为突出。
今天,我们就来彻底解决其中一个核心痛点:如何在完全分片数据并行(FSDP)训练中,实现可靠、高效的模型断点保存与恢复。我将手把手带你,在一个预配置好的深度学习环境中,实践PyTorch的Distributed Checkpoint功能,让你告别训练中断的焦虑,实现训练过程的“随时暂停、随时继续”。
1. 环境准备:开箱即用的训练基地
在开始任何实战之前,一个稳定、完备的环境是成功的基石。我们使用的镜像已经为你铺好了路。
1.1 核心环境一览
这个环境不是简单的PyTorch安装,而是为深度学习项目实战量身定制的。它基于我的《深度学习项目改进与实战》专栏,预装了从训练、评估到可视化的完整工具链。
- 深度学习核心:
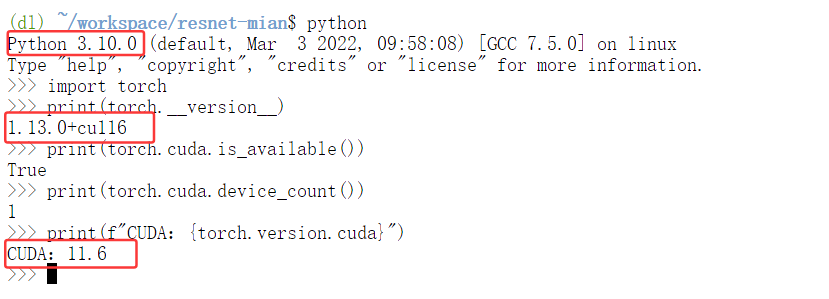
pytorch==1.13.0+CUDA 11.6。这个组合经过大量项目验证,在稳定性和性能之间取得了很好的平衡。 - 编程语言:
Python 3.10.0,兼顾了新特性和广泛的库兼容性。 - 关键依赖全家桶:
torchvision,torchaudio:与PyTorch核心版本严格对应,确保图像和语音处理功能正常。numpy,pandas:数据处理黄金搭档。opencv-python:图像加载和预处理必备。matplotlib,seaborn:训练曲线和结果可视化。tqdm:给你的训练循环加上美观的进度条。
这意味着,你上传博客提供的训练代码后,99%的基础依赖都已经就位。如果项目需要特殊的库,再用pip install补充即可,基础环境绝不会拖你后腿。
1.2 第一步:进入战斗状态
镜像启动后,你会看到一个干净的终端界面。首先,我们需要激活正确的Conda环境。
# 激活名为 ‘dl’ 的深度学习专用环境
conda activate dl
激活后,命令行提示符前通常会显示(dl),表明你已经进入了我们配置好的环境。
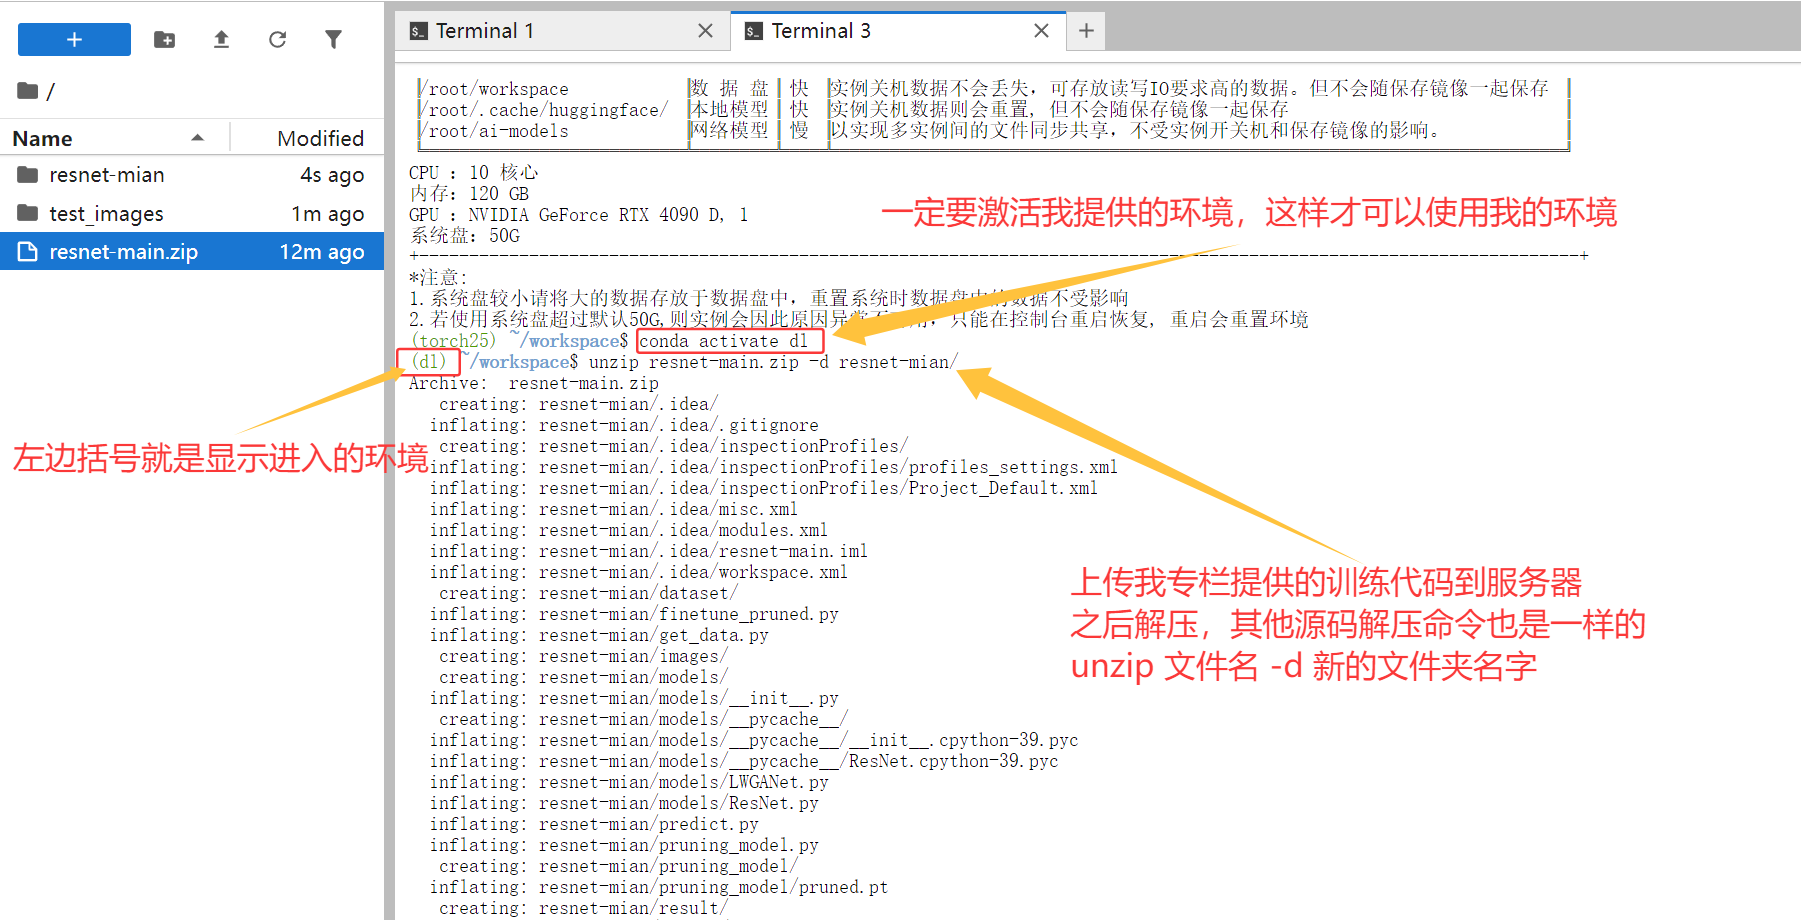
接下来,使用Xftp、WinSCP等工具,将专栏提供的训练代码和你自己的数据集上传到服务器。一个重要的建议是:将代码和数据都放在/root/workspace/或数据盘目录下,这样既方便管理,也避免系统盘空间不足。
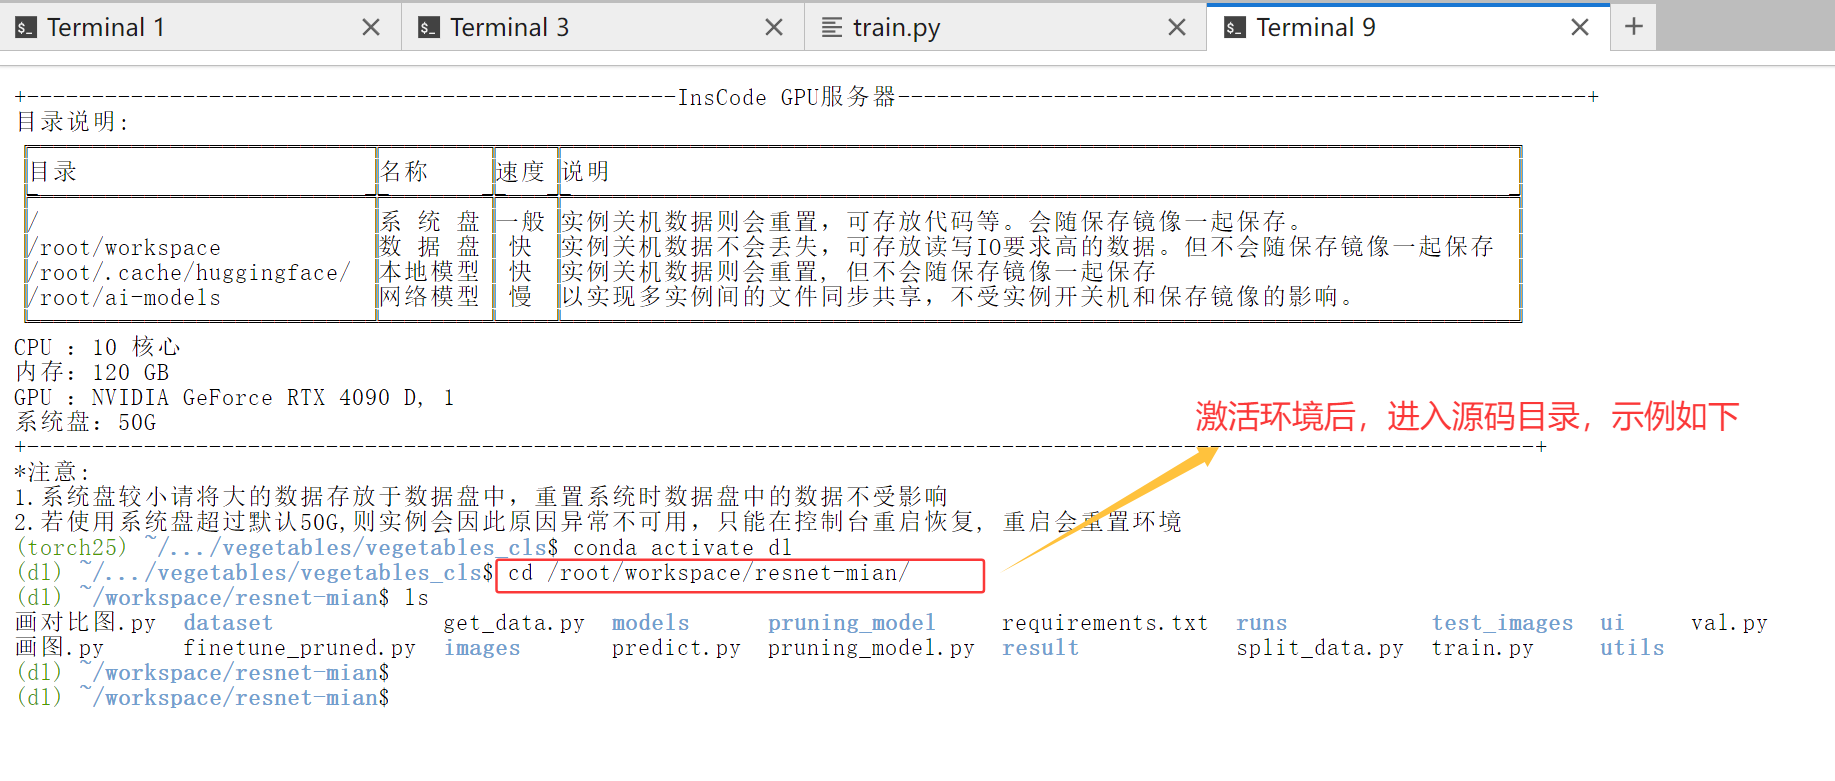
上传后,在终端切换到你的代码目录:
cd /root/workspace/你的项目文件夹名称
2. 从普通训练到FSDP分布式训练
在深入Distributed Checkpoint之前,我们先回顾一下普通训练和FSDP训练在代码上的关键区别,这能帮你理解为什么保存checkpoint会变复杂。
2.1 普通训练:单卡/DP模式下的Checkpoint
在普通的单GPU或DataParallel训练中,保存和加载模型状态非常简单。
保存checkpoint通常是这样:
# 普通训练的保存逻辑 (train.py 片段)
checkpoint = {
    'epoch': epoch,
    'model_state_dict': model.state_dict(),
    'optimizer_state_dict': optimizer.state_dict(),
    'scheduler_state_dict': scheduler.state_dict() if scheduler else None,
    'loss': best_loss,
}
torch.save(checkpoint, 'checkpoint.pth')
print(f"Checkpoint saved at epoch {epoch}")
加载checkpoint恢复训练:
# 普通训练的加载逻辑
checkpoint = torch.load('checkpoint.pth', map_location='cuda')
model.load_state_dict(checkpoint['model_state_dict'])
optimizer.load_state_dict(checkpoint['optimizer_state_dict'])
start_epoch = checkpoint['epoch'] + 1
这种方式直观易懂,因为整个模型都存在于一个地方(单卡或多卡中的主卡)。
2.2 FSDP训练:模型被“分片”了
FSDP的核心思想是将模型参数、梯度和优化器状态进行分片,每张GPU只保存一部分。这极大地节省了显存,允许训练更大的模型。但这也带来了挑战:没有任何一张GPU拥有完整的模型状态。
这时,再用torch.save(model.state_dict())只会保存当前GPU上的那个分片,而不是完整的模型。因此,我们需要一个能理解这种分布式状态的保存/加载机制。
这就是 PyTorch Distributed Checkpoint (DCP) 出场的原因。它专为FSDP、Tensor Parallel等分布式训练场景设计,可以正确地聚合和保存分散在各处的状态。
3. PyTorch Distributed Checkpoint 实战详解
理论说再多不如动手试。下面我们来看如何在FSDP训练代码中集成DCP功能。
3.1 改造你的训练脚本:集成保存逻辑
假设你已经有一个使用FullyShardedDataParallel包装模型的训练脚本。我们需要修改它的保存和加载部分。
首先,确保导入必要的模块:
import torch
import torch.distributed as dist
from torch.distributed.fsdp import FullyShardedDataParallel as FSDP
from torch.distributed.fsdp import StateDictType
from torch.distributed.checkpoint import FileSystemReader, FileSystemWriter
from torch.distributed.checkpoint.default_planner import DefaultSavePlanner, DefaultLoadPlanner
# 注意:在PyTorch 1.13中,DCP API可能在 torch.distributed._shard.checkpoint 下
# 请根据你的实际PyTorch版本调整import路径
接下来,我们编写一个保存checkpoint的函数:
def save_fsdp_checkpoint(model, optimizer, epoch, save_path, rank):
    """保存FSDP模型的分布式checkpoint"""
    # 告诉FSDP我们准备使用分布式状态字典
    with FSDP.state_dict_type(model, StateDictType.SHARDED_STATE_DICT):
        # 1. 收集分片的状态字典
        model_state_dict = model.state_dict()
        optimizer_state_dict = FSDP.optim_state_dict(model, optimizer)

        # 2. 准备要保存的完整状态
        state_dict = {
            "model": model_state_dict,
            "optimizer": optimizer_state_dict,
            "epoch": epoch,
        }

        # 3. 使用Distributed Checkpoint保存
        # FileSystemWriter会将状态字典根据分片信息,保存到save_path目录下
        writer = FileSystemWriter(save_path)
        torch.distributed.checkpoint.save_state_dict(
            state_dict=state_dict,
            storage_writer=writer,
            planner=DefaultSavePlanner(),
        )

    if rank == 0: # 只在主进程打印信息
        print(f"[Rank {rank}] Checkpoint saved to {save_path} at epoch {epoch}")
关键点解析:
FSDP.state_dict_type(model, StateDictType.SHARDED_STATE_DICT):这是关键配置,它告诉FSDP在获取state_dict时,保持其分片状态,而不是收集到主进程。FSDP.optim_state_dict(model, optimizer):专门用于获取FSDP优化器的分片状态字典。FileSystemWriter:DCP的写入器,负责将分片的状态写入指定的文件系统路径(save_path)。每个rank会将自己的分片写入save_path/rank_{rank}这样的子目录。torch.distributed.checkpoint.save_state_dict:执行保存操作的核心函数。
3.2 从Checkpoint恢复训练
训练中断后,我们需要一个函数来加载之前保存的状态,并精准地恢复到断点。
def load_fsdp_checkpoint(model, optimizer, load_path, rank):
    """从分布式checkpoint加载并恢复训练状态"""
    # 同样,使用分片状态字典类型
    with FSDP.state_dict_type(model, StateDictType.SHARDED_STATE_DICT):
        # 1. 初始化一个空的状态字典结构,用于加载
        model_state_dict = model.state_dict() # 获取当前模型的分片结构
        optimizer_state_dict = FSDP.optim_state_dict(model, optimizer) # 获取优化器结构

        state_dict = {
            "model": model_state_dict,
            "optimizer": optimizer_state_dict,
            "epoch": 0, # 占位符,实际值会从checkpoint加载
        }

        # 2. 使用Distributed Checkpoint加载
        reader = FileSystemReader(load_path)
        torch.distributed.checkpoint.load_state_dict(
            state_dict=state_dict,
            storage_reader=reader,
            planner=DefaultLoadPlanner(),
        )

        # 3. 将加载的状态字典设置回模型和优化器
        model.load_state_dict(state_dict["model"])
        optimizer.load_state_dict(state_dict["optimizer"])

        start_epoch = state_dict["epoch"] + 1 # 接下来要训练的epoch

    if rank == 0:
        print(f"[Rank {rank}] Checkpoint loaded from {load_path}, resuming from epoch {start_epoch}")
    return start_epoch
关键点解析:
- 加载前也需要设置
StateDictType.SHARDED_STATE_DICT,确保加载器理解分片结构。 - 我们先获取当前模型和优化器的
state_dict,这主要目的是获取其分片结构。然后DCP会根据这个结构,从load_path下各rank的目录中读取对应的分片数据填充进去。 load_state_dict完成后,state_dict中的内容就被更新为checkpoint中的值了,再通过model.load_state_dict和optimizer.load_state_dict应用回去。
3.3 在训练循环中调用
最后,将这两个函数集成到你的主训练循环中。
# 在你的主函数中
def main():
    # ... 初始化分布式环境,rank = dist.get_rank()
    # ... 构建模型、优化器,并用FSDP包装模型
    # model = FSDP(model, ...)
    # optimizer = torch.optim.Adam(model.parameters(), ...)

    start_epoch = 0
    checkpoint_dir = "./fsdp_checkpoints"

    # --- 加载检查点(如果存在)---
    if os.path.exists(checkpoint_dir) and resume_training:
        start_epoch = load_fsdp_checkpoint(model, optimizer, checkpoint_dir, rank)

    for epoch in range(start_epoch, total_epochs):
        # 训练一个epoch...
        train_one_epoch(model, train_loader, optimizer, epoch)

        # --- 定期保存检查点 ---
        if epoch % save_every == 0:
            # 每个rank都会参与保存,但数据只会保存自己负责的分片
            save_fsdp_checkpoint(model, optimizer, epoch, f"{checkpoint_dir}/epoch_{epoch}", rank)
            # 清理旧的checkpoint,只保留最新的N个(可选)
            if rank == 0:
                cleanup_old_checkpoints(checkpoint_dir, keep=5)
这样,你就拥有了一个具备强大容错能力的FSDP训练脚本。无论是计划内的暂停,还是意外的中断,你都可以从容地从最近的checkpoint恢复,宝贵的计算资源一点都不会浪费。
4. 实战演练:运行与验证
理论代码有了,我们把它在准备好的环境里跑起来。
4.1 准备数据集与代码
- 上传数据集:将你的数据集(例如ImageNet分类数据集)上传到服务器数据盘。如果数据集是压缩包,使用以下命令解压:
# 对于 .tar.gz 文件 tar -zxvf your_dataset.tar.gz -C /path/to/your/data/ # 对于 .zip 文件 unzip your_dataset.zip -d /path/to/your/data/ - 修改代码配置:打开你的
train.py,确保数据加载路径指向你上传的数据集位置。同时,将上面介绍的DCP保存/加载函数集成进去,并调整FSDP的初始化配置。# 在train.py中,确保有类似的数据加载 train_dataset = YourDataset(root='/path/to/your/data/train', ...) # 以及FSDP初始化 model = FSDP(model, auto_wrap_policy=..., ...)
4.2 启动分布式训练
使用torchrun来启动多进程分布式训练,这是PyTorch推荐的方式。
# 假设使用4张GPU进行训练
torchrun --nproc_per_node=4 --nnodes=1 --node_rank=0 --master_addr=127.0.0.1 --master_port=29500 train.py
参数解释:
--nproc_per_node=4:每个节点(服务器)上启动4个进程,对应4张GPU。--nnodes=1:总共1个节点。--master_addr和--master_port:指定主进程的地址和端口,用于进程间通信。
4.3 观察Checkpoint的生成
训练开始后,根据你设置的save_every频率,会在checkpoint_dir(例如./fsdp_checkpoints)下生成类似epoch_10的目录。
ls -la ./fsdp_checkpoints/epoch_10/
你会看到类似下面的结构,每个rank都有自己的子目录,里面保存了该rank所负责的模型和优化器状态分片。
epoch_10/
├── rank_0/
│   ├── __0_0.distcp
│   └── metadata.pth
├── rank_1/
│   ├── __0_0.distcp
│   └── metadata.pth
├── rank_2/
│   └── ...
└── rank_3/
    └── ...
4.4 模拟中断与恢复
- 让训练跑几个epoch,生成一些checkpoint。
- 然后手动中断训练(按
Ctrl+C)。 - 修改你的
train.py脚本或通过命令行参数,设置resume_training=True,并确保checkpoint_dir指向最新的那个checkpoint目录(例如./fsdp_checkpoints/epoch_10)。 - 再次用相同的
torchrun命令启动训练。 - 观察日志,你应该会看到类似“Checkpoint loaded from ..., resuming from epoch 11”的输出,并且训练loss会从上次中断的地方平滑地接续下去,而不是从头开始陡降。
5. 总结与最佳实践
通过本次实践,我们不仅学会了如何使用PyTorch Distributed Checkpoint,更重要的是掌握了在分布式训练中保障数据安全和控制训练周期的核心方法。
5.1 核心收获回顾
- 环境是基础:一个预集成、版本匹配的深度学习环境(如我们使用的镜像)能避免大量依赖冲突问题,让你专注于算法和工程逻辑。
- 理解分片是前提:FSDP通过分片节省显存,但也改变了模型状态的存储方式。传统的
torch.save/load不再适用。 - DCP是解决方案:PyTorch Distributed Checkpoint API(
save_state_dict,load_state_dict配合FileSystemWriter/Reader)是专门为加载和保存分片状态字典而设计的工具。 - 流程是关键:保存和加载时,必须使用
FSDP.state_dict_type(..., StateDictType.SHARDED_STATE_DICT)上下文管理器,并配合FSDP.optim_state_dict来正确处理优化器状态。
5.2 给你的实践建议
- 定期保存,但别太频繁:保存checkpoint涉及磁盘I/O和进程间同步,过于频繁(如每个iteration)会拖慢训练速度。根据你的训练时长,每1个或几个epoch保存一次是比较好的平衡。
- 管理checkpoint磁盘空间:像示例中一样,实现一个简单的清理逻辑,只保留最新的N个checkpoint,避免磁盘被撑满。
- 验证checkpoint有效性:在恢复训练后,可以快速跑几个iteration,观察loss是否正常,以确保checkpoint加载正确。
- 结合验证集性能保存最佳模型:除了定期保存,你仍然应该根据验证集指标(如准确率)保存最好的模型。这个“最佳模型”的保存,通常可以使用
FULL_STATE_DICT类型收集到主进程再保存为一个单独的文件,便于后续的部署和推理。
分布式训练是驾驭大模型的必由之路,而可靠的Checkpoint机制则是这条路上的“安全带”和“存档点”。希望这份实操手册能让你在接下来的深度学习项目探索中,训练得更安心、更高效。
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)