Python基于大数据的图书推荐系统的协同过滤算法的爬虫 数据可视化分析系统9w4u33nr
文章目录
基于大数据的图书推荐系统概述
该系统结合协同过滤算法、网络爬虫和数据可视化技术,构建一个完整的图书推荐与分析平台。核心目标是通过用户行为数据和图书属性,实现个性化推荐,并通过可视化展示分析结果。
协同过滤算法实现
协同过滤分为用户基(User-Based)和物品基(Item-Based)两种方法。用户基通过相似用户偏好推荐图书,物品基通过相似图书被同一用户喜欢的历史记录推荐。算法通常使用余弦相似度或皮尔逊相关系数计算相似性。
余弦相似度公式:
[
\text{similarity}(A, B) = \frac{A \cdot B}{|A| \times |B|}
]
皮尔逊相关系数公式:
[
r = \frac{\sum (X_i - \bar{X})(Y_i - \bar{Y})}{\sqrt{\sum (X_i - \bar{X})^2} \sqrt{\sum (Y_i - \bar{Y})^2}}
]
数据爬虫设计
爬虫模块负责从图书网站(如豆瓣、Amazon)抓取图书信息和用户评论。使用Scrapy或BeautifulSoup框架实现,关键字段包括:
- 图书标题、作者、ISBN
- 用户评分、评论内容
- 用户ID及历史行为数据
示例代码片段(Scrapy爬虫):
import scrapy

class BookSpider(scrapy.Spider):
    name = 'book_spider'
    start_urls = ['https://example.com/books']

    def parse(self, response):
        for book in response.css('div.book-item'):
            yield {
                'title': book.css('h2::text').get(),
                'author': book.css('.author::text').get(),
                'rating': book.css('.rating::text').get()
            }
数据可视化分析
可视化模块使用Matplotlib、Seaborn或Plotly展示分析结果,包括:
- 用户评分分布直方图
- 热门图书词云图
- 用户-图书交互热力图
示例代码(Matplotlib评分分布图):
import matplotlib.pyplot as plt
import pandas as pd

data = pd.read_csv('book_ratings.csv')
plt.hist(data['rating'], bins=5)
plt.xlabel('Rating')
plt.ylabel('Frequency')
plt.title('Book Rating Distribution')
plt.show()
系统架构与流程
- 数据采集层:爬虫抓取原始数据并存储至数据库(如MySQL或MongoDB)。
- 数据处理层:清洗数据并计算用户/图书相似度矩阵。
- 推荐引擎:根据协同过滤算法生成推荐列表。
- 可视化界面:通过Web框架(如Flask)展示推荐结果和分析图表。
技术栈建议
- 编程语言:Python 3.x
- 爬虫工具:Scrapy、Requests
- 数据分析库:Pandas、NumPy
- 机器学习库:Surprise(推荐系统专用)、scikit-learn
- 可视化库:Plotly Dash(交互式图表)
该系统需注意数据稀疏性和冷启动问题,可结合混合推荐(如内容过滤)优化效果。
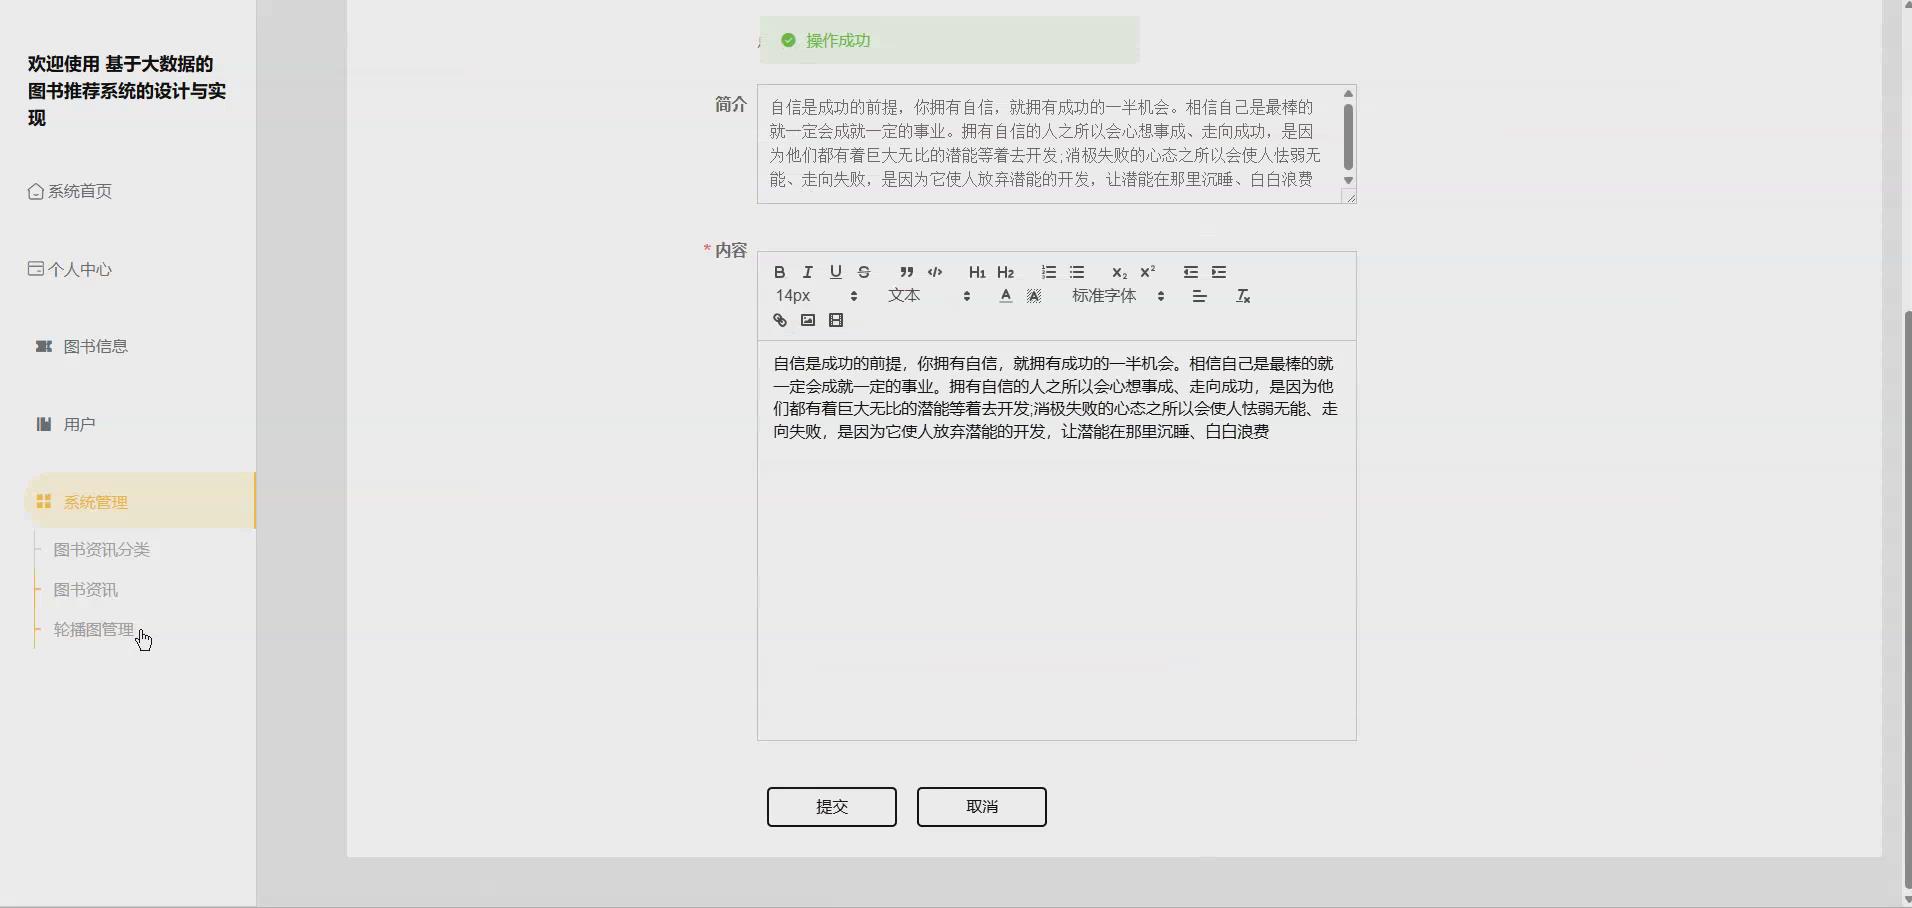
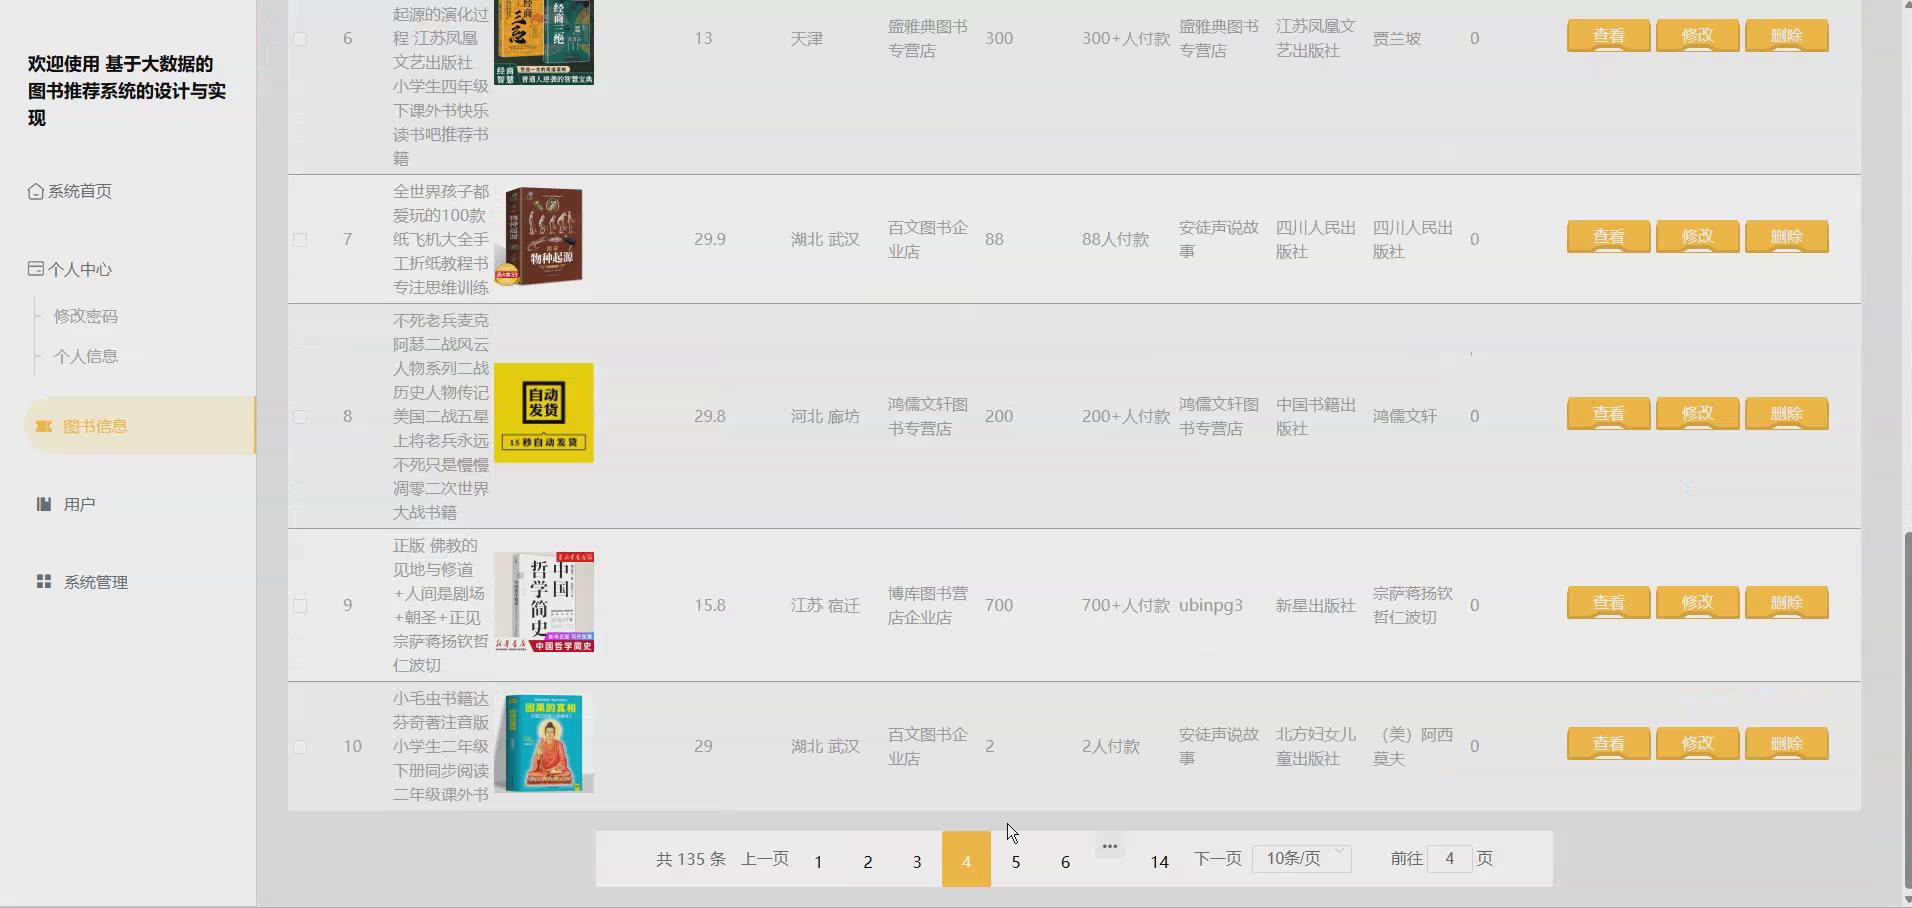
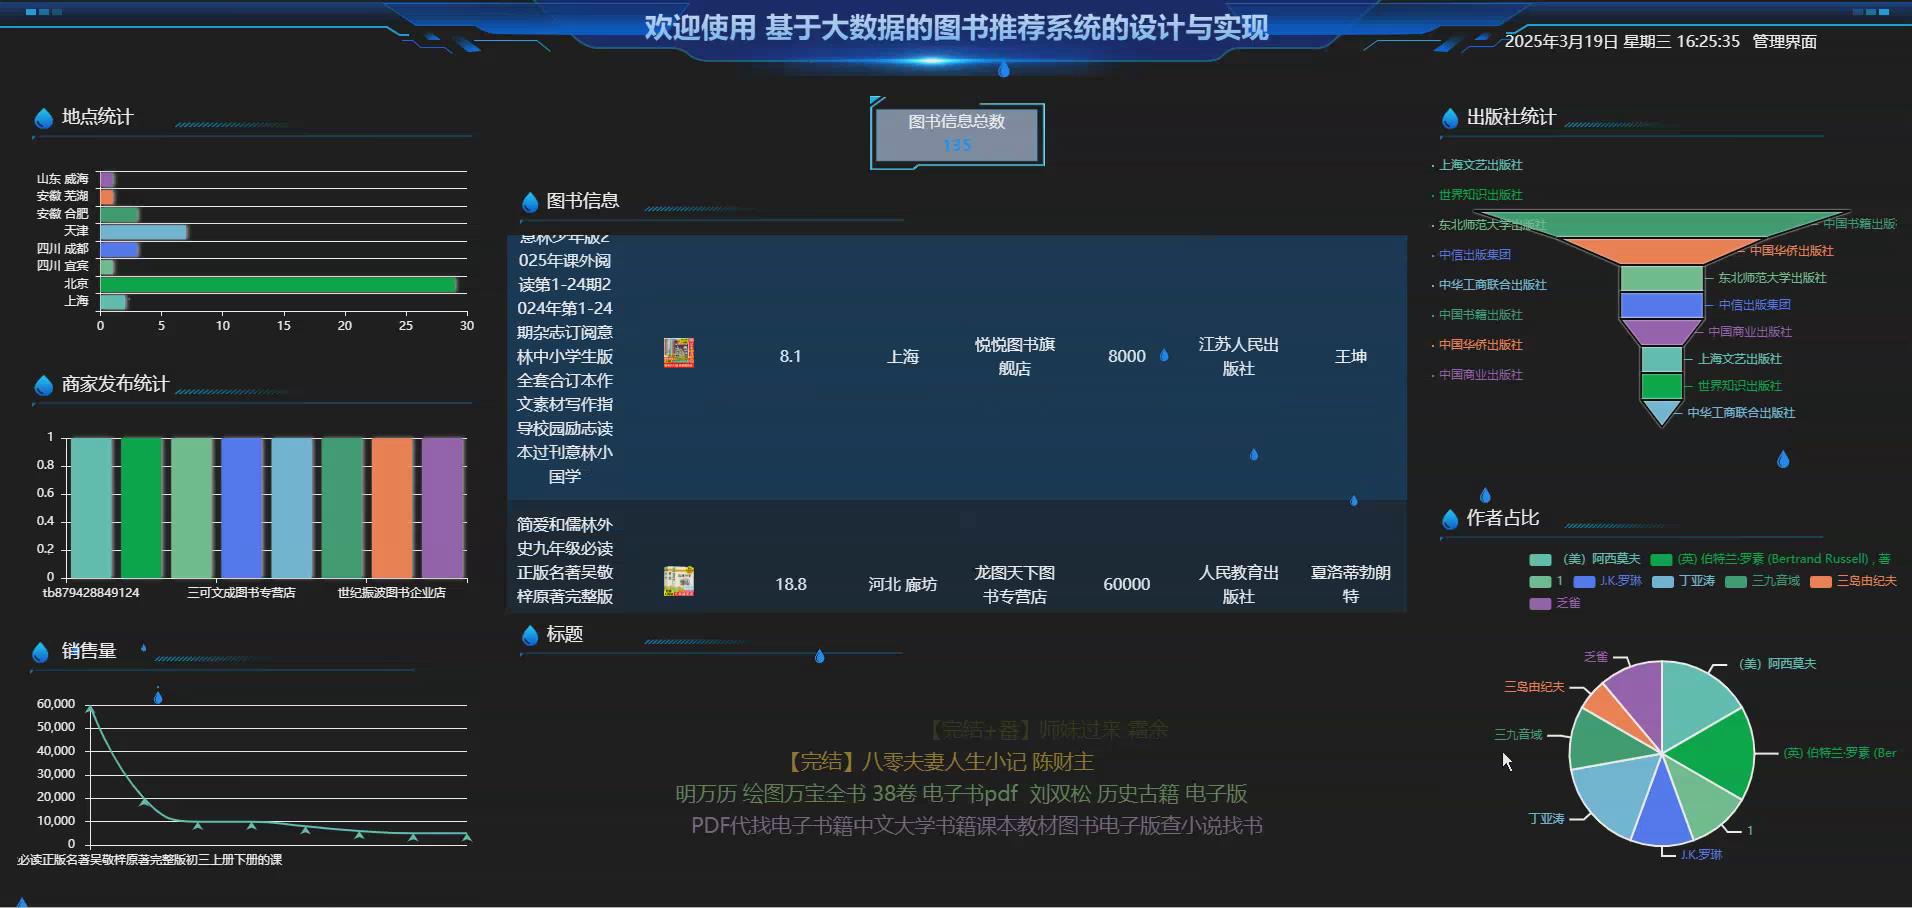
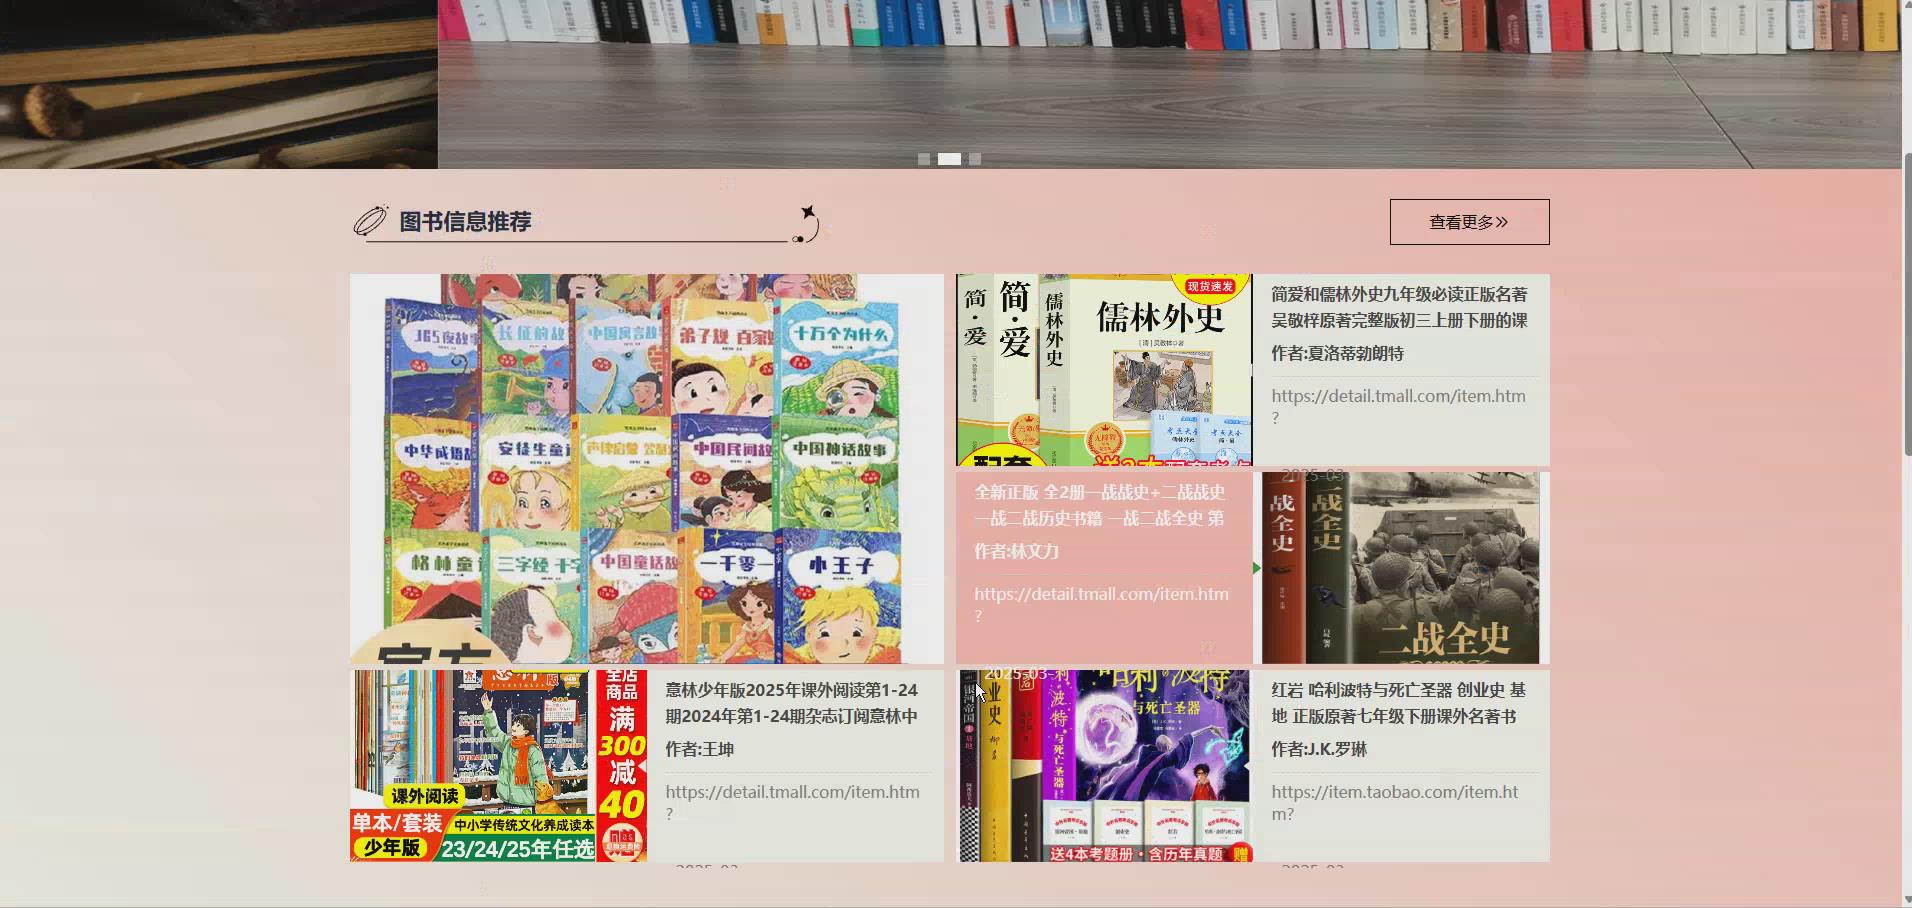
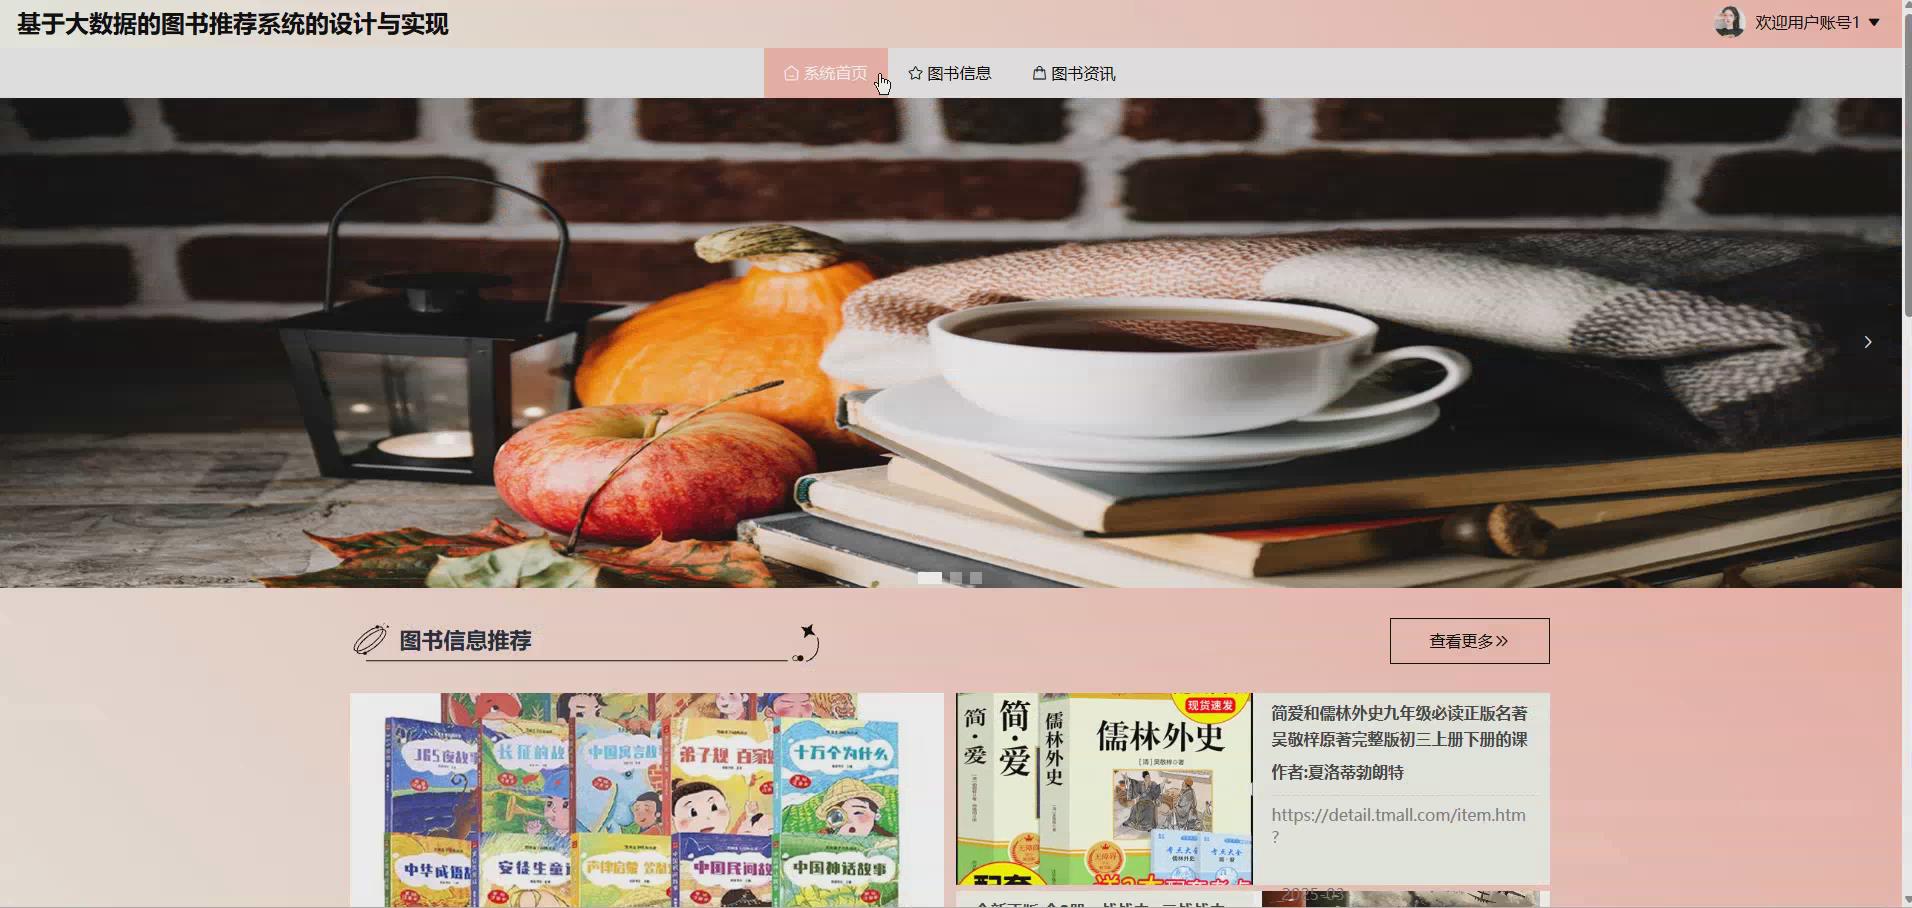
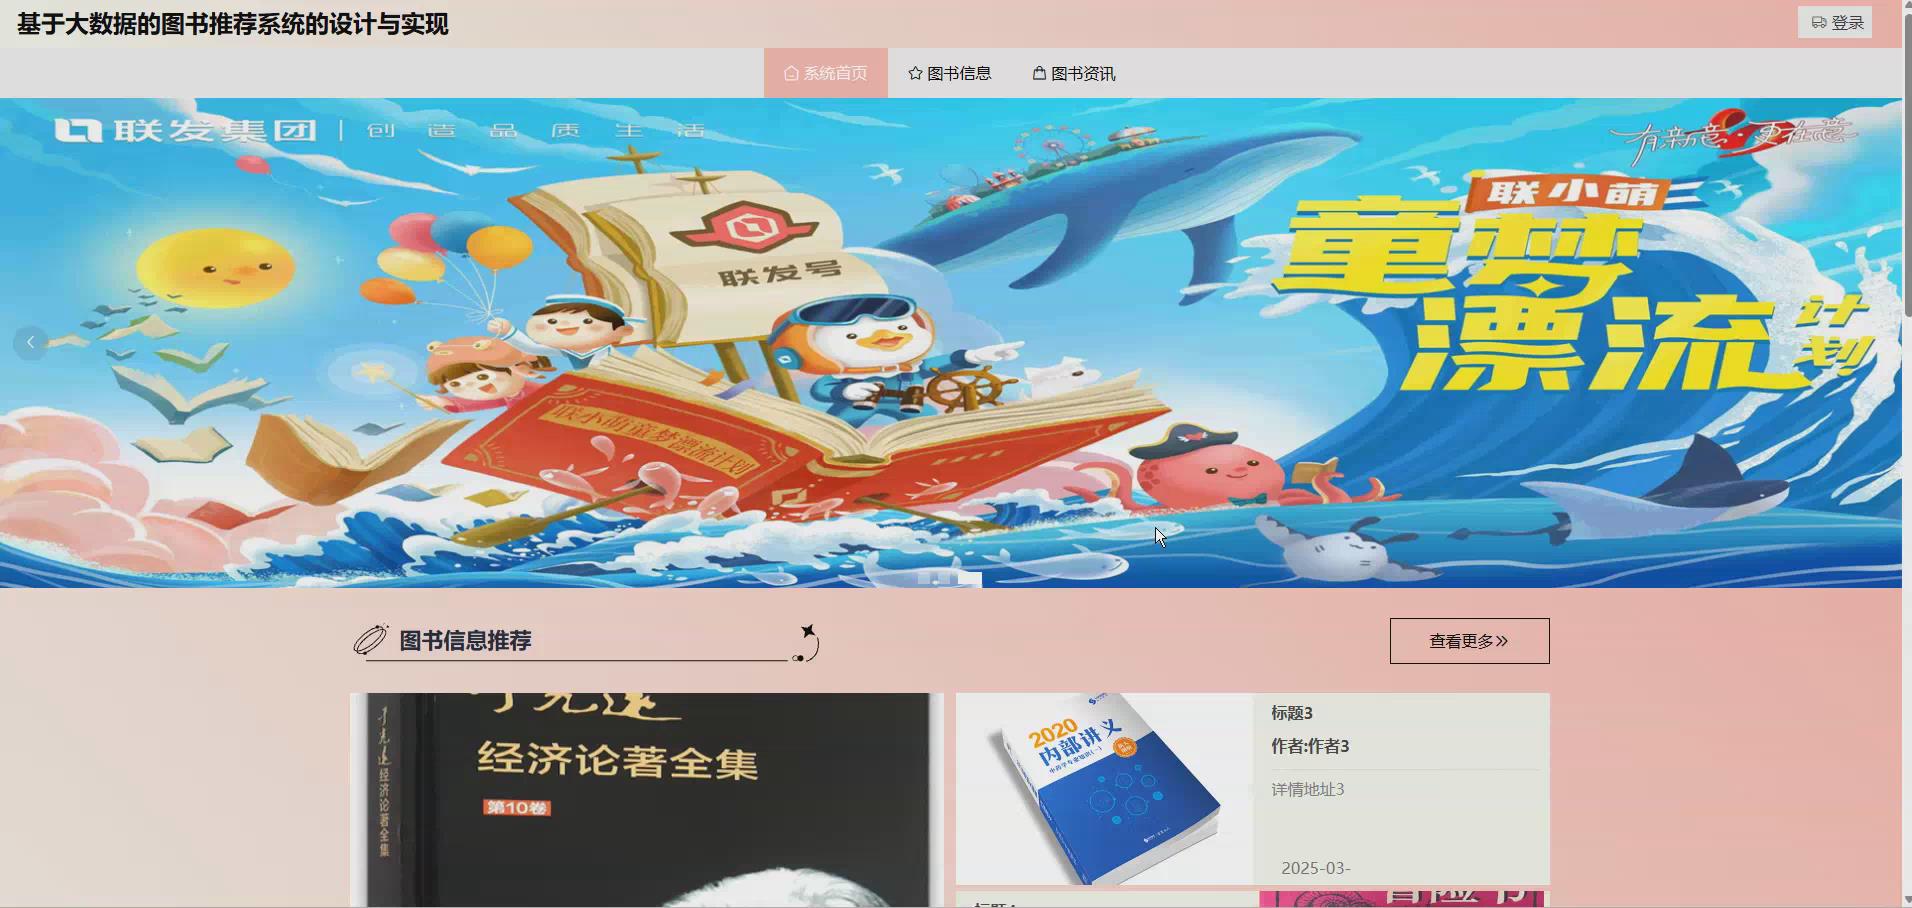
大数据系统开发流程
Python版本:python3.7+
前端:vue.js+elementui
框架:django/flask都有,都支持
后端:python
数据库:mysql
数据库工具:Navicat
开发软件:PyCharm
Scrapy作为高性能的网络爬虫框架,负责从各类目标网站上抓取数据,为系统提供丰富的数据源。Pandas则用于数据的清洗、整理和分析,它能够处理复杂的数据操作,确保数据的准确性和可靠性。在数据可视化方面,Echarts和Vue.js发挥重要作用。Echarts提供直观、生动、可交互的数据可视化图表,帮助用户更好地理解数据背后的价值;Vue.js作为一种流行的前端开发框架,为数据可视化提供了强大的支持,使界面更加友好和易用。Flask框架和django框架用于搭建系统的后端服务,提供基本的路由、模板和静态文件服务功能。MySQL数据库则用于存储和管理从爬虫获取的数据、用户信息以及分析结果等,为系统提供高效的数据存储和查询能力。
爬虫原理
基本上所有Python爬虫初学者都会接触到两个工具库,requests和BeautifulSoup,这二者作为最为常见的基础库,其使用方式也截然不同,其中request工具库主要是用来获取网页的源代码,其需要向服务器发送url请求指令;而beautifulsoup则主要用来对网页的源语言,包括且不限于HTML\xml进行读取和解析,提取重要信息。这两个库模拟了人们访问网页、阅读网页以及复制粘贴相应信息的过程,可以批量快速抓取数据。
数据清洗
数据清洗技术主要是通过使用python语言中的正则表达式技术,通过其大量收集目标数据,并进一步进行提取。2、数据转换技术主要是通过加载法,将源数据中收集到的字符串按照相应的规则和序列转换成字典。3、数据去重即用unique方法,返回没有重复元素的数组或列表。 预处理后保存到CSV文件中。
数据挖掘
数据挖掘主要是通过运用设计好的算法对已有的数据进行分析和汇总,并按照数据的特征进行情感分析。统计数据过程中多使用snownlp类库来实现这一基本的情感分析的操作,通过计算弹幕的数据值,来分析其中的倾向性。情感分析中长用sentiment来指明实际的情感值。其中,数据一旦越靠近1则越表明其正面属性,越接近0越负面,相关的结果数据可以作为情感分析的基础数据而得到。
数据可视化大屏分析
数据可视化模块主要采用饼图、词云和折线图等手段来实现最终的数据可视化。并通过matplotlib库等技术来进一步地研究和分析数据的特点,最终通过图表的模式来展示数据的深层含义。可视化模块包括各时段视频播放量比例图、热词统计图、每周不同时间视频播放量线图、情绪比例图等可视化图形。
主要运用技术介绍
Python语言
Python 是一个高层次的结合了解释性、编译性、互动性和面向对象的脚本语言,其设计具有很强的可读性,相比其他语言经常使用英文关键字,其他语言的一些标点符号,它具有比其他语言更有特色语法结构。
Flask框架
Flask 是一个轻量级的 Web 框架,使用 Python 语言编写,较其他同类型框架更为灵活、轻便且容易上手,小型团队在短时间内就可以完成功能丰富的中小型网站或 Web 服务的实现。
Flask 具有很强的定制性,用户可以根据自己的需求来添加相应的功能,在保持核心功能简单的同时实现功能的丰富与扩展,其强大的插件库可以让用户实现个性化的网站定制,开发出功能强大的网站。
Djiango框架
源码文档获取定制开发/同行可拿货,招校园代理 :文章底部获取博主联系方式!
需要成品或者定制,加我们的时候,不满意的可以定制
文章最下方名片联系我即可~ 所有项目都经过测试完善,本系统包修改时间和标题,包安装部署运行调试

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 8
 0
- 0


 已为社区贡献13条内容

所有评论(0)