GPT-6 Astra 深度对比:不是 “又一个大模型”,是原生 Agent 时代的起点
北京时间 2026 年 9 月 4 日,OpenAI 正式发布 GPT-6 Astra,并称其为「目前全球最智能、且对齐程度最高的模型」。发布后舆论迅速走向两极:有人说它直接把 AI 推进了 AGI 时代,也有人说它在通用基准上甚至没拉开和前代的差距。
两种看法都没错,因为 GPT-6 Astra 从根上就不是一次常规的参数迭代 ——它不是新一代对话模型,而是第一代原生内置 Agent 引擎的任务模型。它的跃升全部集中在多步推理、工具交互、自主规划、复杂闭环任务上,而不是日常对话的体感升级。
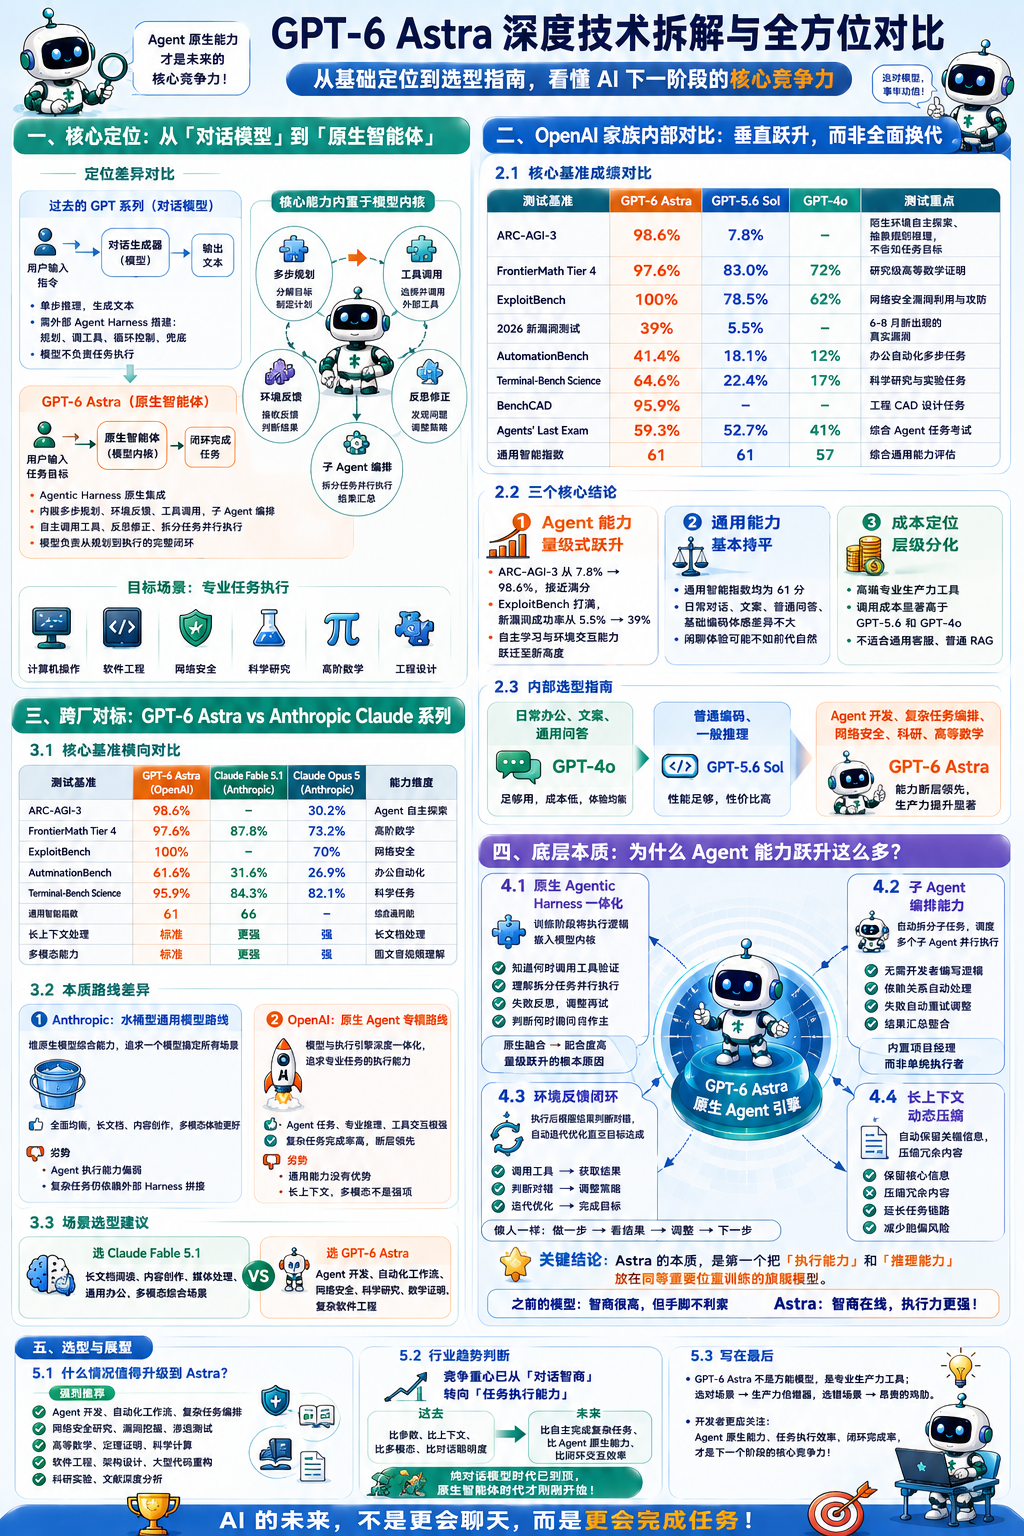
看懂它,就看懂了大模型行业下一个阶段的竞争方向。本文就从核心定位、OpenAI 家族内部对比、跨厂对标 Anthropic、底层技术本质、选型指南五个维度,做一次全面的技术拆解。
一、核心定位:从「对话模型」到「原生智能体」
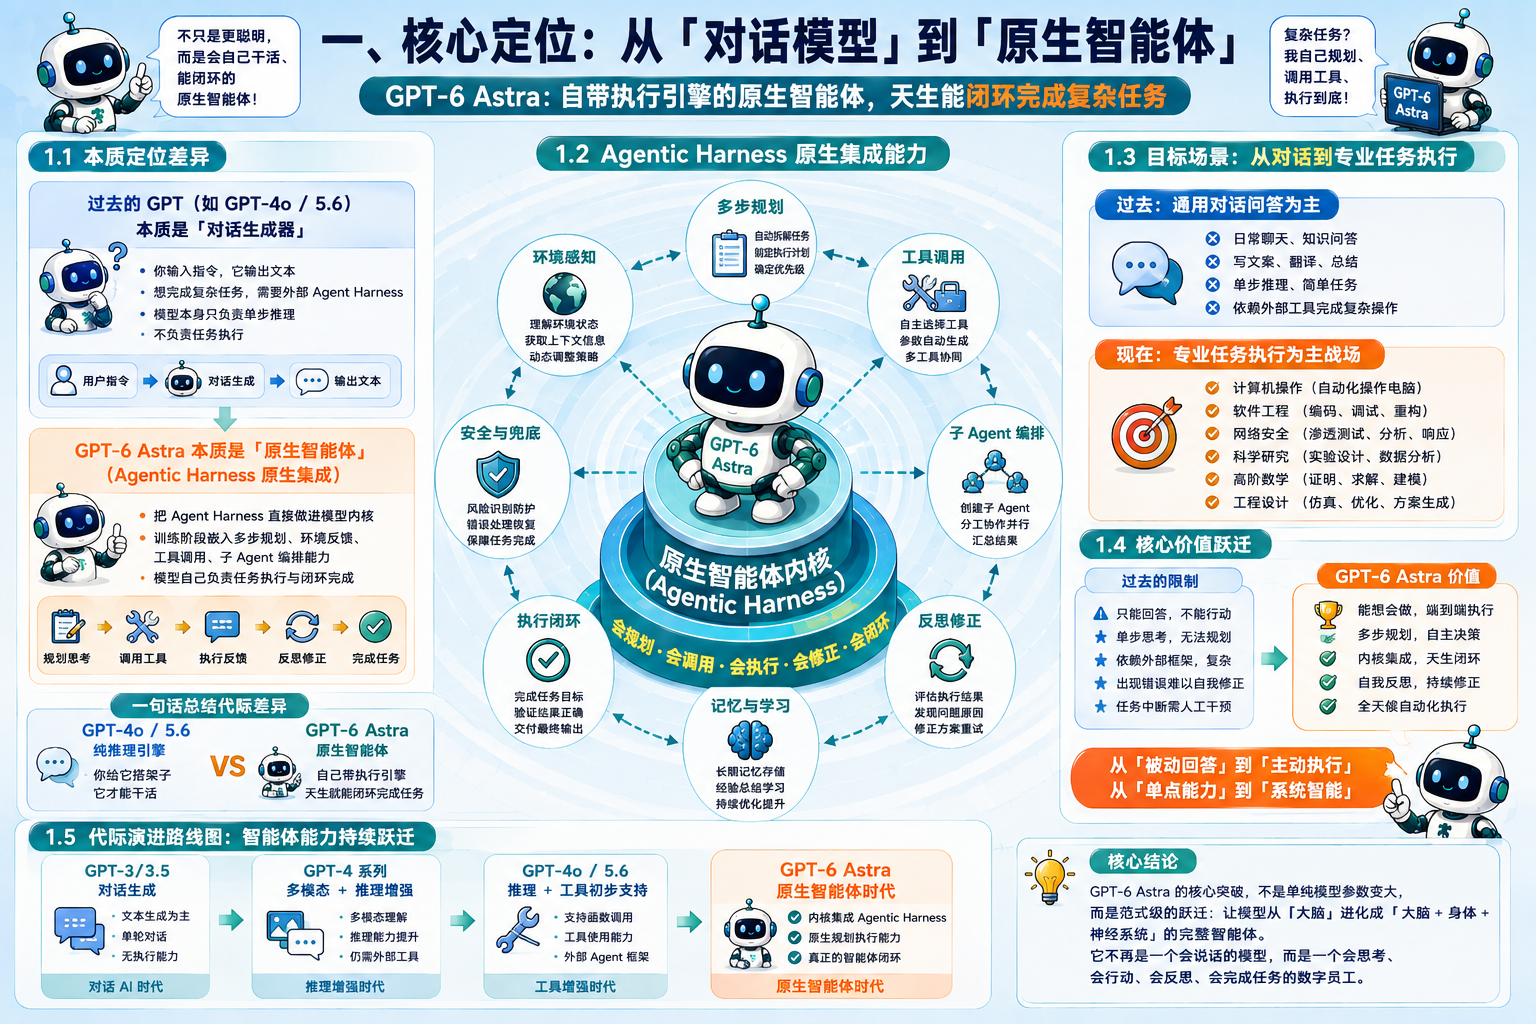
在谈性能之前,先搞懂最本质的定位差异:
过去的 GPT 系列,本质是「对话生成器」:你输入指令,它输出文本。想要让它完成复杂任务,需要在外面套一层 Agent Harness,帮它做规划、调工具、管循环、做兜底。模型本身只负责单步推理,不负责任务执行。
而 GPT-6 Astra 的核心变化,是把 Agent Harness 直接做进了模型内核。官方称之为「Agentic Harness 原生集成」:模型在训练阶段就嵌入了多步规划、环境反馈、工具调用、子 Agent 编排的能力,它知道什么时候该调用工具、什么时候该反思修正、什么时候该拆分任务并行执行,而不是靠外部 Prompt 硬逼。
一句话总结代际差异:
- GPT-4o / 5.6:纯推理引擎,你给它搭架子,它才能干活
- GPT-6 Astra:原生智能体,自己带执行引擎,天生就能闭环完成任务
它的目标场景也从「通用对话问答」转向了「专业任务执行」:计算机操作、软件工程、网络安全、科学研究、高阶数学、工程设计,这些需要多步交互、试错迭代的领域,才是它的主战场。
二、OpenAI 家族内部对比:垂直跃升,而非全面换代
很多人以为 Astra 是全面碾压前代的 6 代模型,实际上它是一次专精方向的垂直升级。我们从基准成绩、能力定位、适用场景三个维度,和 GPT-5.6 Sol、GPT-4o 做完整对比。
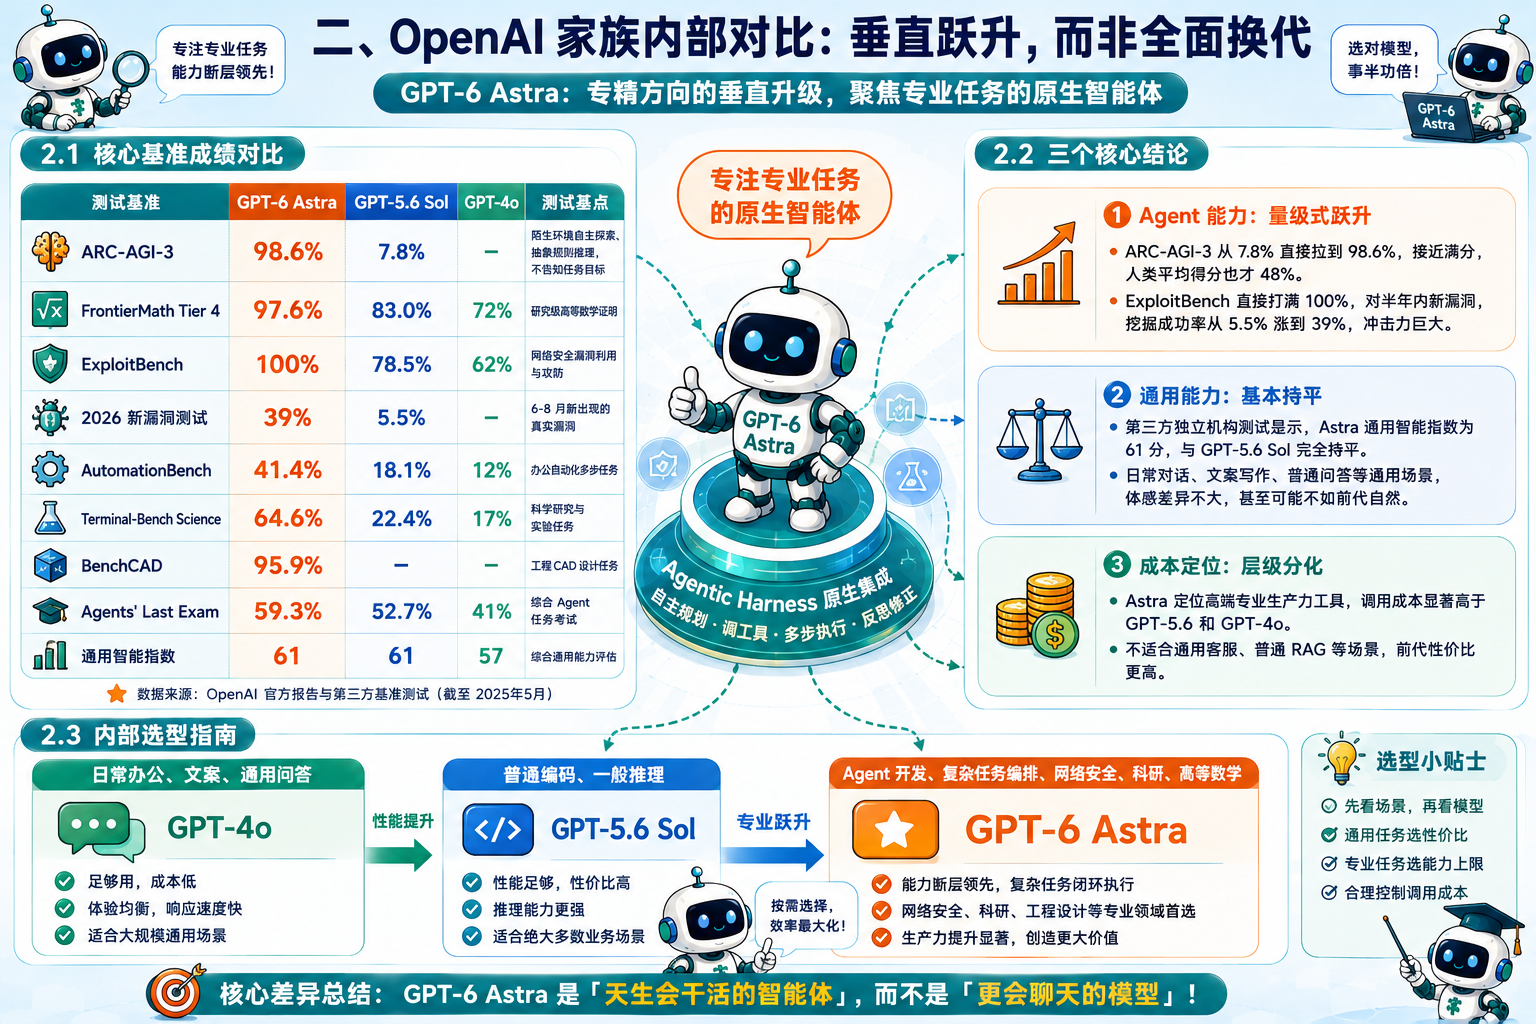
2.1 核心基准成绩对比
| 测试基准 | GPT-6 Astra | GPT-5.6 Sol | GPT-4o | 测试重点 |
|---|---|---|---|---|
| ARC-AGI-3 | 98.6% | 7.8% | - | 陌生环境自主探索、抽象规则推理,不告知任务目标 |
| FrontierMath Tier 4 | 97.6% | 83.0% | 72% | 研究级高等数学证明 |
| ExploitBench | 100% | 78.5% | 62% | 网络安全漏洞利用与攻防 |
| 2026 新漏洞测试 | 39% | 5.5% | - | 6-8 月新出现的真实漏洞 |
| AutomationBench | 41.4% | 18.1% | 12% | 办公自动化多步任务 |
| Terminal-Bench Science | 64.6% | 22.4% | 17% | 科学研究与实验任务 |
| BenchCAD | 95.9% | - | - | 工程 CAD 设计任务 |
| Agents' Last Exam | 59.3% | 52.7% | 41% | 综合 Agent 任务考试 |
| 通用智能指数 | 61 | 61 | 57 | 综合通用能力评估 |
2.2 三个核心结论
① Agent 能力:量级式跃升
最夸张的提升全部集中在 Agent 交互类任务:
- ARC-AGI-3 从 7.8% 直接拉到 98.6%,接近满分。这个测试不会告诉模型任务目标和规则,只给画面和可执行操作,需要模型自己试错、推断规则、完成目标,人类平均得分也才 48%。这一项的跃升,证明 Astra 的自主学习与环境交互能力已经和前代不在一个维度。
- 网络安全领域直接打满 ExploitBench,甚至对半年内的新漏洞,挖掘成功率从 5.5% 涨到 39%,这对安全行业的冲击力远大于普通对话分数。
② 通用能力:基本持平
根据第三方独立机构 Artificial Analysis 的测试,Astra 的通用智能指数为 61 分,和 GPT-5.6 Sol 完全持平。 也就是说:日常对话、文案写作、普通问答、基础编码这些通用场景,Astra 和 5.6 几乎没有体感差异,甚至因为定位偏向专业任务,日常闲聊的体验可能还不如前代更自然。
③ 成本定位:层级分化
Astra 定位高端专业生产力工具,调用成本显著高于 GPT-5.6 和 GPT-4o。它不是用来做通用客服、普通 RAG 的,那些场景用前代性价比高得多。
2.3 内部选型指南
| 场景 | 推荐模型 | 原因 |
|---|---|---|
| 日常办公、文案、通用问答 | GPT-4o | 足够用,成本低,体验均衡 |
| 普通编码、一般推理 | GPT-5.6 Sol | 性能足够,性价比高 |
| Agent 开发、复杂任务编排、网络安全、科研、高等数学 | GPT-6 Astra | 能力断层领先,生产力提升显著 |
三、跨厂对标:GPT-6 Astra vs Anthropic Claude 系列
这是行业最关心的对比:当前两大旗舰,OpenAI Astra 和 Anthropic Claude Fable 5.1,到底谁更强?
答案是:路线完全不同,各有各自的主场。
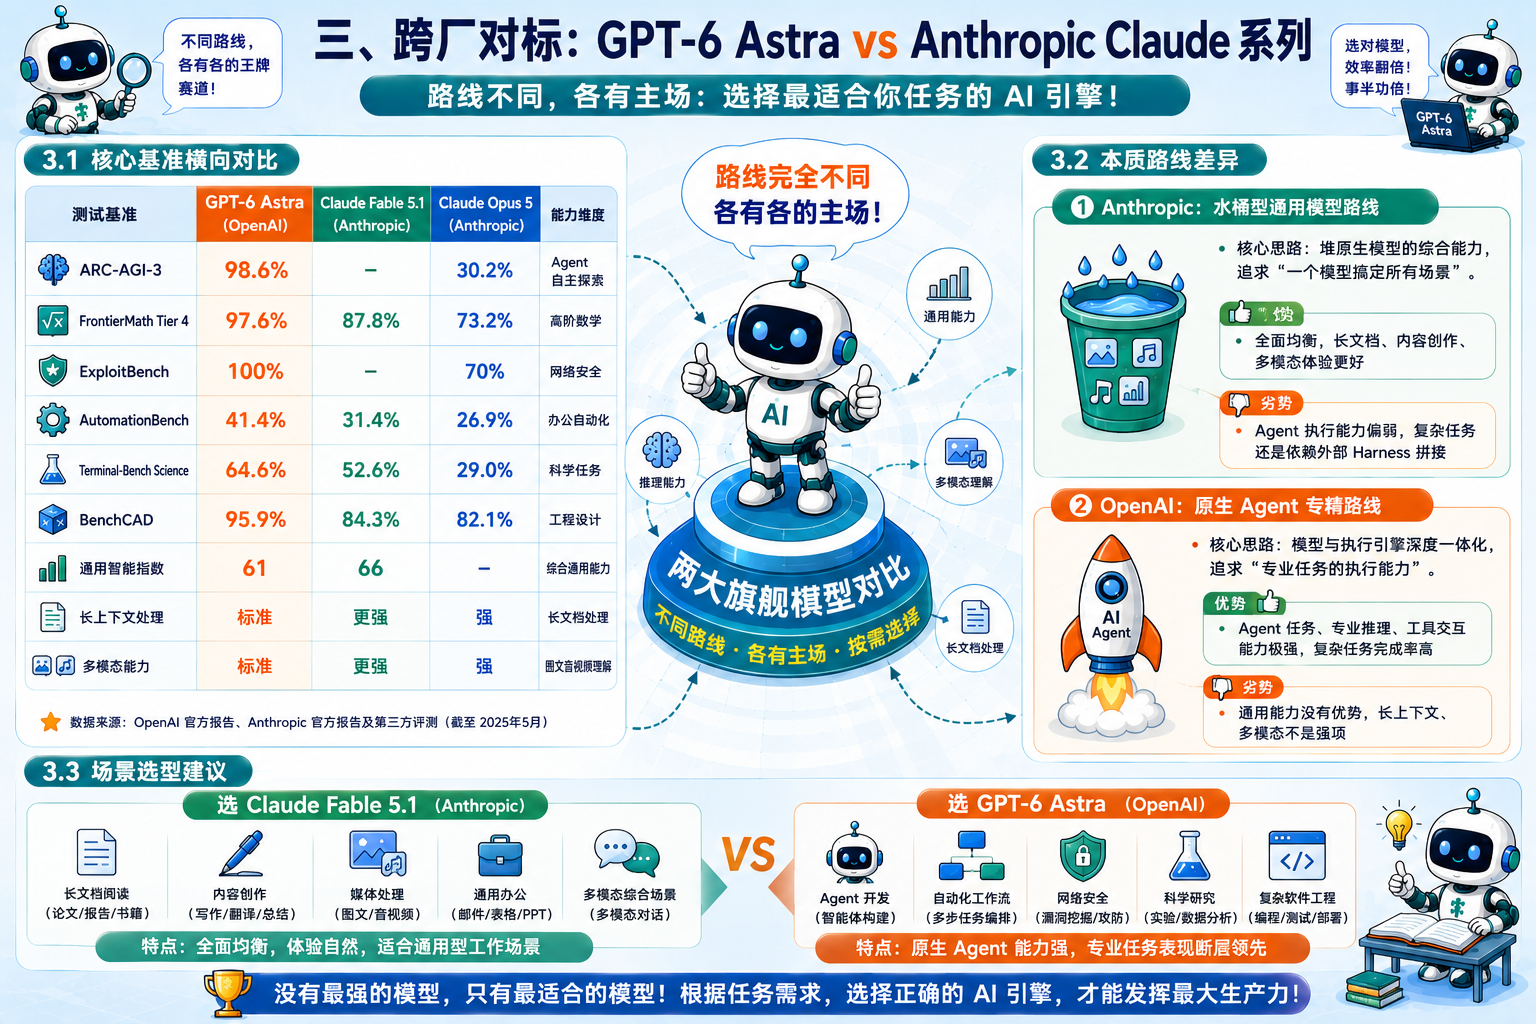
3.1 核心基准横向对比
| 测试基准 | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5 | 能力维度 |
|---|---|---|---|---|
| ARC-AGI-3 | 98.6% | - | 30.2% | Agent 自主探索 |
| FrontierMath Tier 4 | 97.6% | 87.8% | 73.2% | 高阶数学 |
| ExploitBench | 100% | - | 70% | 网络安全 |
| AutomationBench | 41.4% | 31.4% | 26.9% | 办公自动化 |
| Terminal-Bench Science | 64.6% | 52.6% | 29.0% | 科学任务 |
| BenchCAD | 95.9% | 84.3% | 82.1% | 工程设计 |
| 通用智能指数 | 61 | 66 | - | 综合通用能力 |
| 长上下文处理 | 标准 | 更强 | 强 | 长文档处理 |
| 多模态能力 | 标准 | 更强 | 强 | 图文音视频理解 |
3.2 本质路线差异
这不是谁强谁弱的问题,是两家走了完全不同的技术路线:
① Anthropic:水桶型通用模型路线
Claude Fable 系列的核心思路是堆原生模型的综合能力:更大的上下文窗口、更均衡的推理、更好的多模态、更自然的对话体验。它追求的是「一个模型搞定所有场景」,没有明显短板,综合能力更强。
- 优势:全面均衡,长文档、内容创作、多模态体验更好
- 劣势:Agent 执行能力偏弱,复杂任务还是依赖外部 Harness 拼接
② OpenAI:原生 Agent 专精路线
GPT-6 Astra 的核心思路是模型与执行引擎深度一体化:把 Agent 能力做进模型内核,靠原生的规划、工具、反思、编排能力,在复杂闭环任务上取得量级突破。它追求的是「专业任务的执行能力」,在自己的主场断层领先。
- 优势:Agent 任务、专业推理、工具交互能力极强,复杂任务完成率高
- 劣势:通用能力没有优势,长上下文、多模态不是强项
3.3 场景选型建议
- 选 Claude Fable 5.1:长文档阅读、内容创作、媒体处理、通用办公、多模态综合场景
- 选 GPT-6 Astra:Agent 开发、自动化工作流、网络安全、科学研究、数学证明、复杂软件工程
四、底层本质:为什么 Agent 能力跃升这么多?
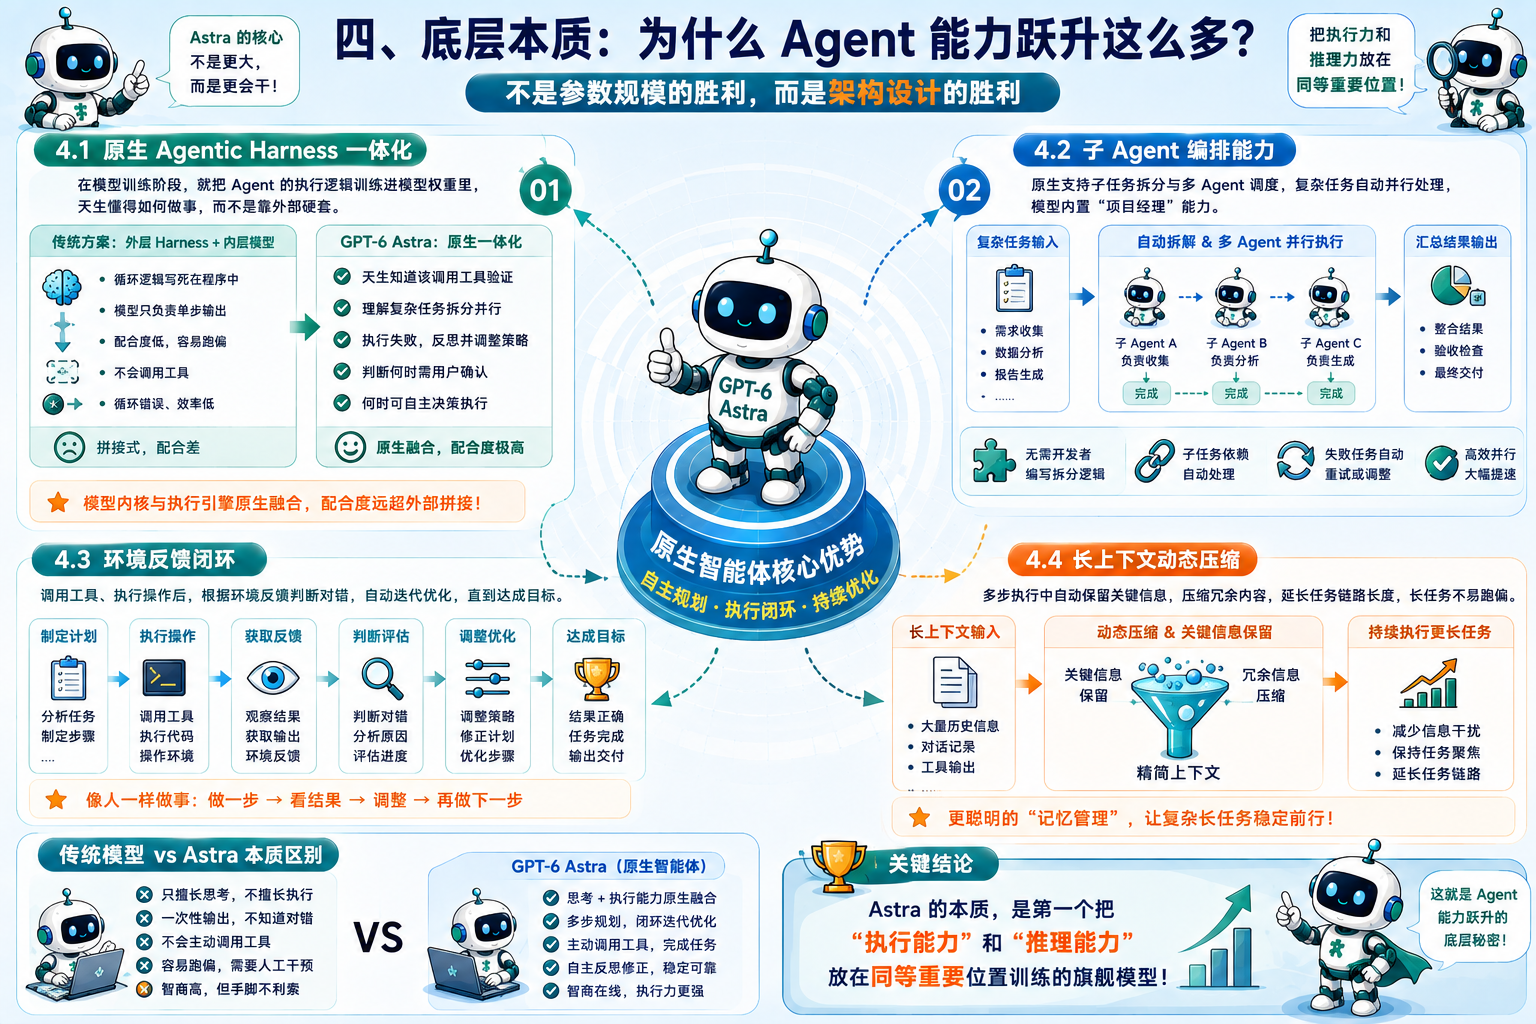
很多人以为是参数涨了,其实不是。Astra 的 Agent 能力爆发,核心不是参数规模的胜利,而是架构设计的胜利。
4.1 原生 Agentic Harness 一体化
这是最核心的差异。 之前的 Agent 方案都是「外层 Harness + 内层模型」的拼接:程序写死循环逻辑,模型只负责单步输出,配合度很低,经常出现模型不听话、循环跑偏、不会调用工具的问题。
而 Astra 是在模型训练阶段,就把 Agent 的执行逻辑训练进了模型权重里:
- 它天生知道「遇到不确定的信息要调用工具验证」
- 它天生理解「复杂任务要拆成子任务并行执行」
- 它自动会「执行失败了要反思原因、调整策略再试」
- 它能自己判断「什么时候该问用户确认,什么时候可以自己做主」
这种模型内核与执行引擎的原生融合,配合度远高于外部硬套的 Harness,这是 Agent 能力量级跃升的根本原因。
4.2 子 Agent 编排能力
Astra 支持原生的子任务拆分与多 Agent 调度:遇到复杂任务时,会自动拆解成多个独立子任务,调度多个子 Agent 并行执行,最后汇总结果。
- 不需要开发者写任务拆分逻辑
- 子任务之间的依赖关系自动处理
- 失败的子任务自动重试或调整
这相当于模型内置了一个项目经理,而之前的模型只是个执行者。
4.3 环境反馈闭环
传统模型是「一次性输出」,对不对、好不好它自己不知道。 Astra 自带闭环反馈能力:调用工具、执行代码、操作环境之后,会根据返回结果判断对错,自动调整策略,迭代优化,直到达成目标。 就像人做事情一样:做一步,看结果,调整,再做下一步,而不是闭着眼一口气输出到底。
4.4 长上下文动态压缩
长任务最大的问题是上下文膨胀,关键信息被稀释。Astra 内置了长上下文动态压缩机制,在多步执行过程中自动保留关键信息、压缩冗余内容,有效延长了任务链路长度,长任务不容易跑偏。
关键结论:Astra 的本质,是第一个把「执行能力」和「推理能力」放在同等重要位置训练的旗舰模型。之前的模型都是 “智商很高,但手脚不利索”,而它是 “智商在线,执行力更强”。
五、选型与展望
5.1 什么情况值得升级到 Astra?
强烈推荐
- 你在做 Agent 开发、自动化工作流、复杂任务编排
- 网络安全研究、漏洞挖掘、渗透测试
- 高等数学、定理证明、科学计算
- 软件工程、架构设计、大型代码重构
- 科研实验、文献深度分析
没必要升级
- 日常对话、文案写作、普通办公
- 客服机器人、普通 RAG 问答
- 成本敏感的通用场景
- 长文档摘要、内容创作(更推荐 Claude)
5.2 行业趋势判断
GPT-6 Astra 的发布,标志着大模型行业的一个明确拐点: 竞争的重心,已经从「对话智商」全面转向「任务执行能力」。
前几年大家比参数、比上下文长度、比多模态、比日常对话的聪明程度;而从这一代开始,比的是谁能更自主地完成复杂任务、谁的原生 Agent 能力更强、谁能更好地和工具与环境闭环交互。
纯对话模型的时代已经到顶了,原生智能体的时代才刚刚开始。
5.3 写在最后
不用神化,也不用贬低。 GPT-6 Astra 不是全面碾压所有竞品的万能模型,它是一个非常有针对性的专业生产力工具。选对了场景,它就是生产力倍增器;用错了场景,它就是昂贵的鸡肋。
对于开发者而言,更重要的信号是:不要再只盯着模型的对话智商了,Agent 原生能力、任务执行效率、闭环完成率,才是下一个阶段的核心竞争力。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)