不再踩坑!Spark on YARN 资源本地化:原理、配置与生产环境最佳实践!
1.资源本地化概念
我们知道Spark on YARN模式下,不需要在YARN集群上的每一个NodeManager上都部署Spark及其他依赖文件,只需要在Spark作业提交的客户端所在的物理机上有一套完整的Spark环境即可,但是Spark在运行的时候是需要这些依赖文件的,那么Spark on YARN究竟是怎么做到的呢?
我们知道,Container 启动过程主要分为四个阶段:通知 NM 启动 Container、资源本地化、启动并运行 Container、资源清理。
资源本地化主要是指分布式缓存机制完成的工作,功能包括初始化各种服务组件、创建工作目录、从 HDFS 下载运行所需的各种资源(比如文本文件、JAR 包、可执行文件)等,Container 本地化则是创建工作目录,从 HDFS 下载各类文件资源。
所以我们一般Spark on YARN运行的资源放在HDFS上,这样每个Container在启动的时候从HDFS上拉取程序运行时必备的资源,这样的话我就不需要在YARN集群上的每一个NodeManager上都部署Spark及其他依赖文件,需要的文件直接从HDFS上拉取。
2.相关参数
这里主要会涉及到三个重要的参数
1、spark.yarn.jars:配置将所有${SPARK_HOME}/jars/目录下的jar上传到HDFS指定的目录,该配置项一般在spark-defaults.conf文件中配置,如:spark.yarn.jars=hdfs:///user/spark3/3-4-4-versionJars/*
hdfs dfs -mkdir -p hdfs:///user/spark3/3-4-4-versionJars
hdfs dfs -put /opt/cloudera/parcels/CDH/lib/spark3/jars/* hdfs:///user/spark3/3-4-4-versionJars/
2、spark.yarn.archive:${SPARK_HOME}/jars/目录下的所有jar使用zip打包,打包要注意所有的jar都在zip包的根目录中,然后将该zip打包文件上传到HDFS的指定的目录,该配置项一般在spark-defaults.conf文件中配置,如:spark.yarn.archive=hdfs:///user/spark3/zip/spark_jars.zip
zip -q -r spark_jars.zip /opt/cloudera/parcels/CDH/lib/spark3/jars/*
hdfs dfs -mkdir -p hdfs:///user/spark3/zip/
hdfs dfs -put spark_jars.zip hdfs:///user/spark3/zip/
备注:以上参数一般至少会设置其中一个,如果两个都设置的话,那么spark.yarn.archive的优先级会比spark.yarn.jars高,后面会代码说明。
3、spark.yarn.stagingDir:系统会先找到HDFS上的目录,然后会自动在该目录下创建目录,然后针对不同的应用又会在目录下自动创建{appId}目录,最终形成完整功能的目录结构:{appId},该配置项一般在spark-defaults.conf文件中配置,如:spark.yarn.stagingDir=hdfs:///user/spark3/stage/,如果该配置项没有配置的话,会使用HDFS上”/user/${提交作业的用户}“作为spark.yarn.stagingDir的值。
// Client.scala
// private[spark] val STAGING_DIR = ConfigBuilder("spark.yarn.stagingDir")
val appStagingBaseDir = sparkConf.get(STAGING_DIR)
    .map { new Path(_, UserGroupInformation.getCurrentUser.getShortUserName) }
    .getOrElse(FileSystem.get(hadoopConf).getHomeDirectory())
stagingDirPath = new Path(appStagingBaseDir, getAppStagingDir(appId))


// val SPARK_STAGING: String = ".sparkStaging"
private def getAppStagingDir(appId: ApplicationId): String = {
  buildPath(SPARK_STAGING, appId.toString())
}
该目录在spark-submit在程序提交的时候,会上传以下几个部分到该目录下:
-
如果没有配置spark.yarn.jars,也没有配置spark.yarn.archive,则会把目录下的所有打包上传到{spark.yarn.stagingDir}/.sparkStaging/${appId}目录下,并把打包文件命令为__spark_libs__.zip;
-
会把目录下的所有的配置文件打包上传到{spark.yarn.stagingDir}/.sparkStaging/${appId}目录下,并把打包文件命令为__spark_conf__.zip
-
会把--files、--py-files、--archives、--jars参数指定的相关文件上传到{appId}目录下;
-
同时会把用户的jar上传到{appId}目录下。
以上所有的上传动作都是由系统自动完成的,不需要我们去上传,我们唯一能做的就是配置spark.yarn.stagingDir
说明:整个spark-submit任务提交过程中会涉及到三种jar类型,一类是${SPARK_HOME}/jars/下的所有的Spark系统的jar;一类是支撑程序运行的第三方jar;一类是用户编写代码之后打的jar
另外,spark-submit在提交任务的时候有四个参数,分别是:--files、--py-files、--archives(YARN-only)、--jars、,这四个参数总体处理的逻辑是一样
// SparkSubmitArguments.scala
case FILES =>
  files = Utils.resolveURIs(value)
case PY_FILES =>
  pyFiles = Utils.resolveURIs(value)
case ARCHIVES =>
  archives = Utils.resolveURIs(value)
case JARS =>
  jars = Utils.resolveURIs(value)
这四个参数通常用来加载外部资源文件,方便其在Driver和Executor进程中进行访问。其中:
-
--files:以逗号分隔的文件列表
-
--py-files:以逗号分隔的.zip、.egg或.py文件列表,用于放置Python应用程序的Python应用程序。
-
--archives:以逗号分隔的archive列表
-
--jars:以逗号分隔的jar列表
这四个参数附带的文件都会上传到{appId}目录下,通常可支持多种协议:file://、hdfs://、http://、ftp://、local:,多个路径之间用逗号隔开
3.实现原理
以下面这个案例为例
[whujian8888@ds-bigdata-005 ~]$ sspark-submit --class org.apache.spark.examples.SparkPi --master yarn --deploy-mode cluster --files aa.log --py-files abc.py --archives abc.zip --jars abc.jar /opt/cloudera/parcels/CDH/lib/spark3/examples/jars/spark-examples_2.12-3.4.4.jar 200000
此时是没有设置spark.yarn.jars和spark.yarn.archive,所以程序运行时会把目录下的所有打包上传到{spark.yarn.stagingDir}/.sparkStaging/目录下,同时会把其他的一些文件同样也会上传到{spark.yarn.stagingDir}/.sparkStaging/${appId}目录下,通过日志可以看出:
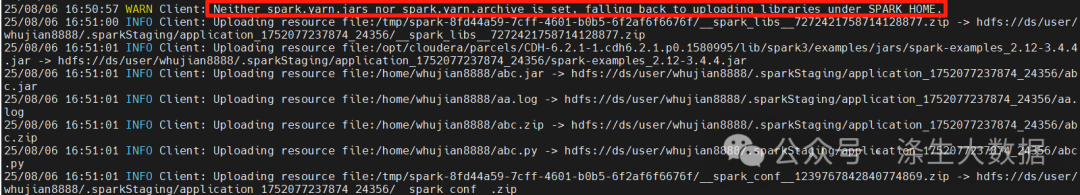
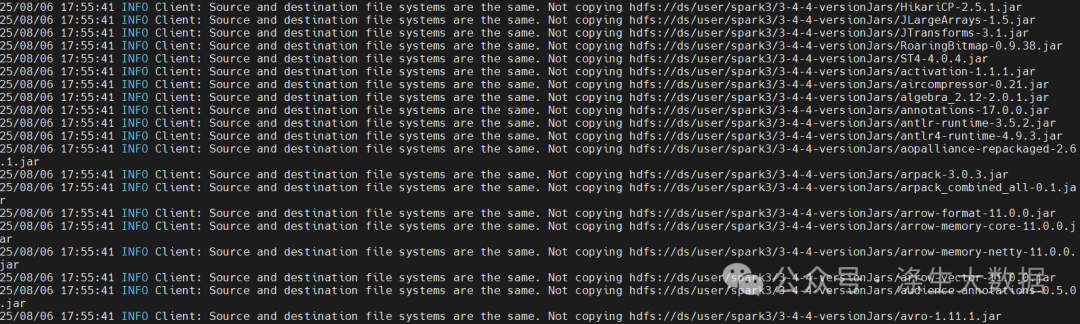
当没有设置spark.yarn.jars和spark.yarn.archive,优先会采用archive的方式。我们可以看出每次通过spark-submit提交任务到YARN时,总是有一段时间将本地的Spark相关的系统包上传到hdfs,这部分大小在200~300M之间,如果提交的任务比较多,那么spark-submit所在的机器就会占用了太多的网络资源以及cpu。所以,通过配置spark.yarn.archive或spark.yarn.jars来避免Spark系统jar包每次都要上传,从而减少启动时间。所以实际生产中强烈建议配置spark.yarn.archive或spark.yarn.jars,一个大大的优化项。比如指定了spark.yarn.jars,那么如下,启动任务的时候就不需要上传Spark相关依赖包。
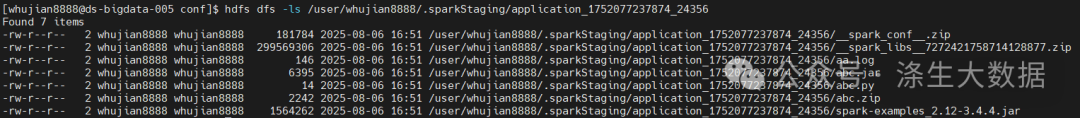
同时,通过HDFS上的文件目录我们也可以看到,这些文件均上传到了{appId}目录下。
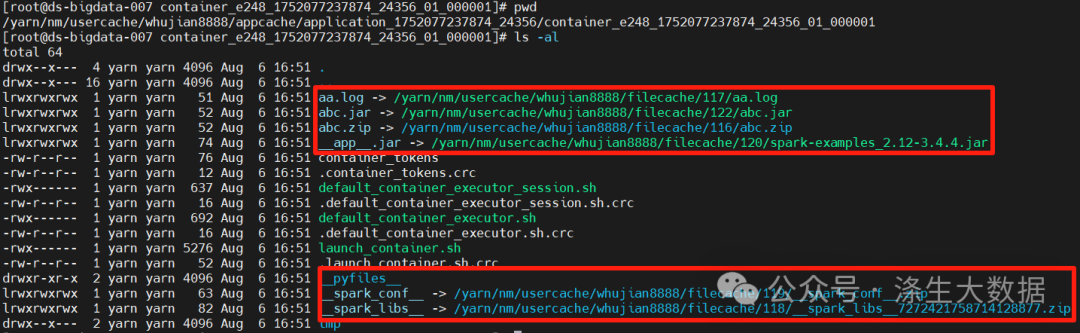
然后Container在运行的时候,就需要将这些文件拉到工作目录,工作目录的路径前文已经说到,这里不再赘述。工作目录有了这些Spark运行时所依赖的文件,所以才可以正常运行起来。
说明:
-
如果配置spark.yarn.archive或spark.yarn.jars,Container会到上述位置拉取到目录__spark_libs__.zip;如果没有配置这两个,直接拉取{appId}目录下的__spark_libs__.zip文件并解压该文件到目录__spark_libs__.zip,切记__spark_libs__**.zip这里是个目录,同理__pyfiles__、__spark_conf__.zip都是目录,然后软连接到容器目录中。
-
会把用户的jar包软连接成__app__.jar
// Client.scala
// Alias for the user jar
val APP_JAR_NAME: String = "__app__.jar"
-
--jars可以传入本地的jar,也可以 --jars 传入HDFS的jar包(--files、--py-files、--archives)类似,两者的区别就是前者会在任务提交的时候将本地的jar上传到{appId}目录下,后者并不会,后者直接将HDFS上的jar下载到Container的工作路径下,因为每个Container都是可以访问HDFS的。
-
--jars主要用于上传我们需要的依赖,spark.yarn.jars 主要传入spark环境相关的jar包,例如 spark.core,spark.sql等等
以上均是我们的实验所得,我们在分析SparkSubmit源码的时候,在submitApplication()方法中调用了createContainerLaunchContext(),而该方法又调用了prepareLocalResources方法,那么该方法就是上述知识点的核心源码所在。这里我们做简单的剖析:
// 先判断有没有定义SPARK_ARCHIVE,即spark.yarn.archive,所有它的优先级更高
val sparkArchive = sparkConf.get(SPARK_ARCHIVE)
// 如果定义了
if (sparkArchive.isDefined) {
  val archive = sparkArchive.get
  // spark.yarn.archive配置项不支持local
  require(!Utils.isLocalUri(archive), s"${SPARK_ARCHIVE.key} cannot be a local URI.")
  // 负责分发到LOCALIZED_LIB_DIR,__spark_libs__,这里其实使用使用了Spark中的ClientDistributedCacheManager,其中的核心方法addResource是将资源添加到分布式缓存资源列表中。此列表可以发送给ApplicationMaster,也可能发送给Executor,以便将其下载到Hadoop分布式缓存中供此应用程序使用
  distribute(Utils.resolveURI(archive).toString,
    resType = LocalResourceType.ARCHIVE,
    destName = Some(LOCALIZED_LIB_DIR))
// 如果没有定义
} else {
    // 先判断有没有定义SPARK_JARS,即spark.yarn.jars
  sparkConf.get(SPARK_JARS) match {
    case Some(jars) =>
      // Break the list of jars to upload, and resolve globs.
      val localJars = new ArrayBuffer[String]()
      jars.foreach { jar =>
       if (!Utils.isLocalUri(jar)) {
          val path = getQualifiedLocalPath(Utils.resolveURI(jar), hadoopConf)
          val pathFs = FileSystem.get(path.toUri(), hadoopConf)
          val fss = pathFs.globStatus(path)
          if (fss == null) {
            throw new FileNotFoundException(s"Path ${path.toString} does not exist")
          }
          fss.filter(_.isFile()).foreach { entry =>
            val uri = entry.getPath().toUri()
            statCache.update(uri, entry)
            // 负责分发到LOCALIZED_LIB_DIR,__spark_libs__
            distribute(uri.toString(), targetDir = Some(LOCALIZED_LIB_DIR))
          }
        } else {
          localJars += jar
        }
      }

      // Propagate the local URIs to the containers using the configuration.
      sparkConf.set(SPARK_JARS, localJars.toSeq)

   // 如果以上两个参数都没有设置的话
   case None =>
      // No configuration, so fall back to uploading local jar files.
      logWarning(s"Neither ${SPARK_JARS.key} nor ${SPARK_ARCHIVE.key} is set, falling back " + "to uploading libraries under SPARK_HOME.")
      val jarsDir = new File(YarnCommandBuilderUtils.findJarsDir(sparkConf.getenv("SPARK_HOME")))
      // 在spark-submit提交所在的机器的临时目录/tmp下生成__spark_libs__**.zip文件
      val jarsArchive = File.createTempFile(LOCALIZED_LIB_DIR, ".zip",new File(Utils.getLocalDir(sparkConf)))
      val jarsStream = new ZipOutputStream(new FileOutputStream(jarsArchive))
      try {
        jarsStream.setLevel(0)
        jarsDir.listFiles().foreach { f =>
          if (f.isFile && f.getName.toLowerCase(Locale.ROOT).endsWith(".jar") && f.canRead) {
            jarsStream.putNextEntry(new ZipEntry(f.getName))
            Files.copy(f.toPath, jarsStream)
            jarsStream.closeEntry()
          }
        }
      } finally {
        jarsStream.close()
      }
      // 负责分发到LOCALIZED_LIB_DIR,__spark_libs__
      distribute(jarsArchive.toURI.getPath,
        resType = LocalResourceType.ARCHIVE,
        destName = Some(LOCALIZED_LIB_DIR))
      jarsArchive.delete()
   }
}
其他的文件处理也是类似的方式,比如Spark相关的配置文件等,这里就不在赘述。
现在比如再遇到此类问题:
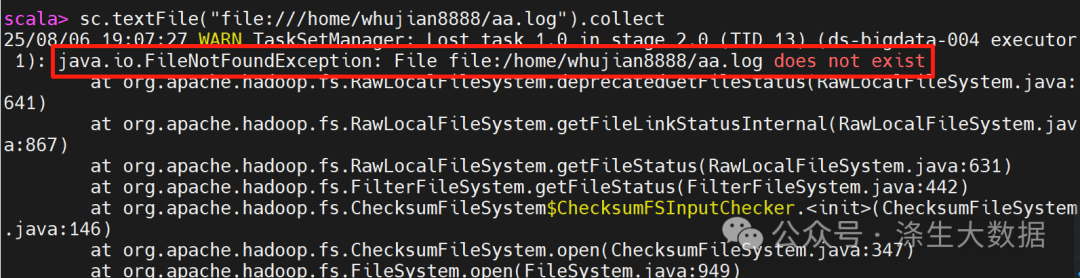
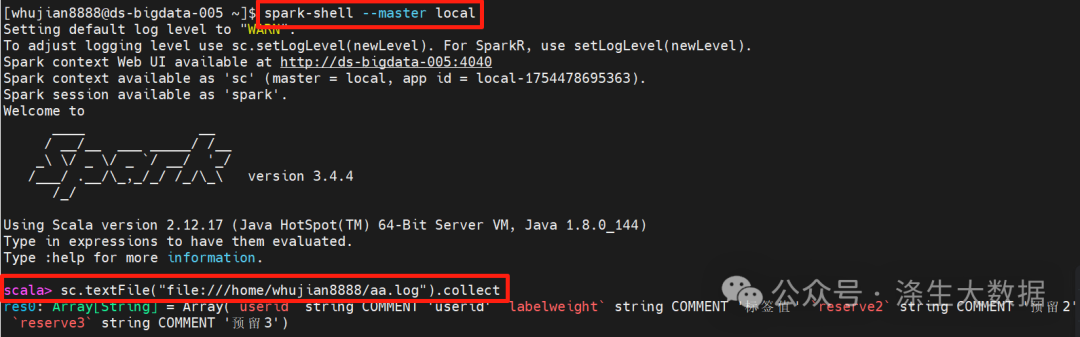
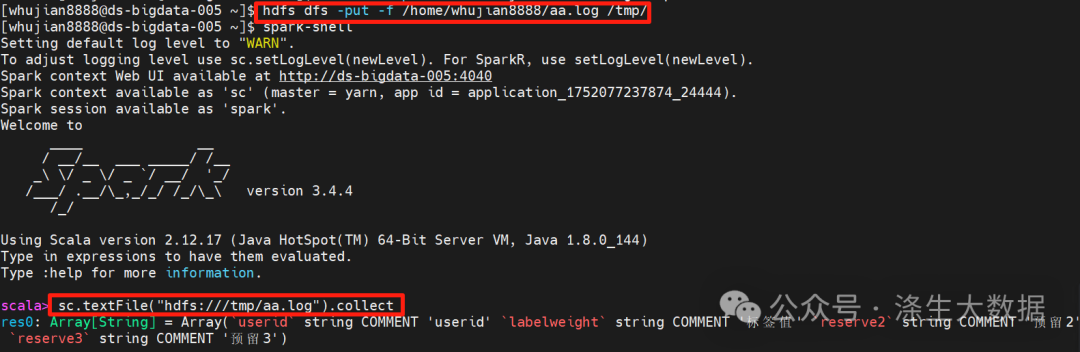
明明我本机有这个文件,为什么会找不到呢?原来我们涤生配置的Spark的环境默认是Spark on YARN,那么程序就会在Container上执行,至于在哪台NodeManager上执行,这是YARN调度的事,而这台NodeManager上未必有这个文件,所以报错FileNotFoundException
解决办法有很多,这里罗列两个:
-
不适用Spark on YARN模式,直接使用local模式,如:spark-shell --master local
-
将该文件上传到HDFS上,而任何一个Container都是可以访问到HDFS资源的

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 19
 0
- 0


 已为社区贡献4条内容

所有评论(0)