【深度学习】融合深度学习与计算机视觉的交通标志自动识别系统
目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
选题指导:
大家好,这里是海浪学长毕设专题,本次分享的课题是
🎯融合深度学习与计算机视觉的交通标志自动识别系统
设计思路
一、课题背景与意义
交通标志自动识别系统的背景源于城市化进程加快和机动车数量激增导致的交通安全问题。传统的交通标志识别依赖人工巡逻,效率低且容易受人为因素影响。近年来,深度学习技术的发展为自动化识别提供了有效解决方案,能够在复杂环境中精准识别交通标志。该系统的意义在于提高交通安全,减少因识别错误导致的事故;增强智能驾驶技术,为自动驾驶车辆提供必要的环境信息;提高交通管理效率,快速响应交通变化;支持数据分析与决策,帮助交通管理部门制定科学的政策;推动智能交通系统的发展,实现更高效、智能的城市交通管理。
二、算法理论原理
2.1 注意力机制
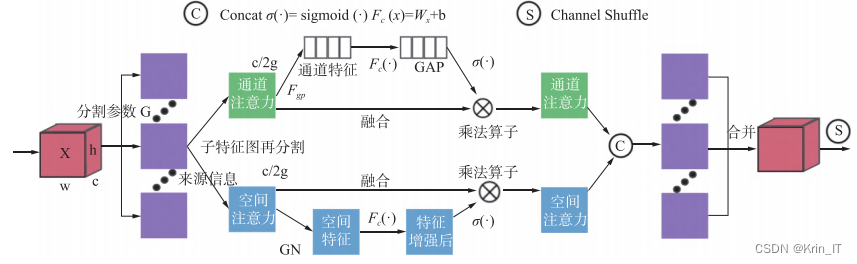
SA模块通过将特征图沿通道分割为多个子特征图分支,使得每个分支能够独立并行计算。这种方法显著减轻了计算负担,允许模型在不同上下文条件下提取更加丰富和多样化的特征信息。每个子特征图分支专注于不同的特征维度,从而可以捕捉到更细致的特征表示,提升模型的整体表现。通过引入Shuffle单元,SA模块有效地提取各分支之间的特征依赖关系,确保信息在不同子特征图之间的流动与交互。这种设计不仅提高了模型的计算效率,还增强了特征的表达能力,使其在复杂视觉任务中表现得更加优越,能够灵活适应各种环境与条件。此外,这种并行计算的方式也为后续的模型训练提供了更快的反馈,促进了模型的优化过程。
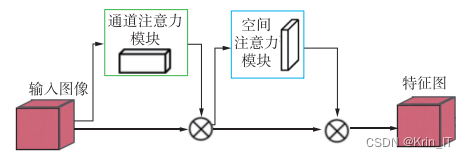
CBAM是一种轻量级的注意力模块,旨在通过沿通道和空间生成注意力区域,显著增强特征图的表示能力。CBAM的设计分为两个主要阶段:首先计算通道注意力,以识别和强化重要的特征通道,确保模型更加关注对任务有用的特征;然后,计算空间注意力,进一步突出关键的空间区域,以便在特征图中强调重要信息。这种顺序运算机制使得CBAM能够逐步聚焦于最相关的特征,强调重要信息并抑制冗余信息。尽管CBAM在注意力生成方面展现出了较高的灵活性,其顺序运算相较于SA的并行计算在速度上可能较慢,这在处理大规模数据时可能会影响整体性能。然而,CBAM的简单结构和易于集成的特点使其在许多视觉任务中仍然非常有效,是提升模型性能的一个重要工具。
SA和CBAM的设计理念各有侧重点,适合不同的网络架构和应用需求。在特征提取阶段,SA因其并行计算的优势,更适合应用在Backbone网络中,这一阶段通常需要快速处理大量的特征信息,以保证模型的实时性和效率。SA的并行处理方式能够显著加快特征提取的速度,减少计算瓶颈,尤其在深度神经网络中,能够显著提升整体计算效率。相比之下,在Neck部分,主要进行上下采样和不同特征图之间的拼接,此时生成注意力区域时,CBAM的顺序运算更为合适。由于CBAM的结构相对简单,它能够更容易地集成到特征融合过程中,从而有效提升特征的相关性和完整性。通过结合SA和CBAM的优势,模型在不同阶段实现高效的特征提取与融合,进而提升整体性能与效率,为复杂的视觉任务提供更加可靠和高效的解决方案。
2.2 YOLOv5算法
YOLOv5 是一种面向实时目标检测的单阶段框架,整体追求在速度和精度之间的折中。它把整个检测流程划分为输入预处理、初始特征提取、主干特征网络、感受野增强与多尺度特征融合,以及预测与后处理五个相互协作的部分。工程实现上通过减少重复计算、改善梯度流和适当的归一化与激活设计,在保证检测精度的同时显著缩减了模型体积并加速了推理过程,便于在边缘设备上部署。
- 在输入阶段,模型不仅对图像做统一缩放和归一化,还依赖丰富的数据增强策略来提升泛化能力。常用的增强包括跨批拼接增强、随机裁剪、颜色扰动和混合增强等,这些能够增加小目标和稀有类别的样本多样性。YOLOv5 引入一种高效的初始特征抽取方式,通过将原始图像在像素上重排并在通道上拼接来替代一次下采样卷积,从而在保持计算量不变的情况下保留更多局部细节,使后续网络更容易学习到丰富的低级特征。
- 主干网络基于一种分段残差的设计思想,将特征划分为若干路径,一部分直接短路传递,另一部分经过多层残差变换后再合并,这样既保留了深层表示的表达能力,又减少了重复梯度流带来的计算冗余。该设计通过分割与拼接策略降低了参数量并改善了训练稳定性。网络在不同深度上做若干次下采样,输出多个尺度的特征图,为后续的多尺度融合提供语义强弱不同的表征。激活函数采用一种平滑且非单调的函数以提升收敛速度,批量归一化或实例归一化的混合使用有助于不同训练批次和不同分布数据下保持鲁棒性。
- 在主干网络的深层通常加入感受野增强模块,通过多尺度池化对深层特征进行并行池化并拼接,扩展网络对大尺度上下文的感知能力,这对检测大目标或遮挡场景尤为重要。多尺度特征融合部分采用自顶向下与自底向上的信息流结合方式:自顶向下路径将深层的语义信息上采样并与浅层位置精确的特征融合,自底向上路径则将浅层的定位细节重新传回深层以增强边界定位能力。这样的双向融合既保证了语义一致性又强化了定位精度,常见实现由上采样、下采样、通道拼接和轻量残差块交替构成。
在预测与后处理阶段,网络在多个尺度的特征图上分别做密集预测,每个位置输出边框回归、目标置信度与类别概率。边框回归采用考虑重叠度和形状的损失函数改进版本以提升回归精度,目标置信度和类别分支通常用平衡的二元交叉熵或均方差损失进行训练。训练时通过自动聚类的方法设计先验框,以提升正负样本的匹配效果并加速收敛。推理阶段将网络原始输出解码为图像坐标并先按置信度过滤,然后用基于重叠度的非极大值抑制合并重复检测。工程上还会采用多尺度推理、模型蒸馏、剪枝与量化等手段在不同硬件上优化速度和功耗。
对于远处交通标志被遮挡、距离过远像素不够清晰的情况对原网络结构中替换第一个 BottleneckCSP模块为 SA 模块,可以立即提取二倍下采样特征图中的特征信息,弱化原始输入图像中的干扰,CBAM 在Neck 中依据 Backbone 的特征图再次加强注意力区域.而对于 Head 的三个不同尺度的特征图,因为感受野的缘故,前两个 Head 对微小物体更敏感,因此放置两个CBAM在前两个Head 分支中。
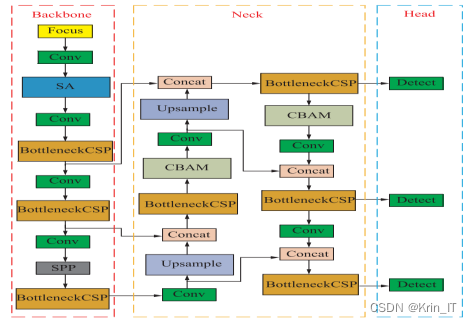
远处或被遮挡的交通标志往往在图像中占比很小、边界模糊且局部上下文不足,传统浅层卷积有时难以聚焦到这些微弱且有语义价值的信号。替换第一个 BottleneckCSP 为 SA(可理解为空间/自注意力)模块的目的,是在网络的早期(通常是下采样两倍后的高分辨率语义层)引入全局或长距依赖建模能力,让网络能在较高分辨率上就捕捉到跨区域的关联信息(例如被遮挡部分与未遮挡相邻区域之间的关系),从而弱化原始输入噪声和背景干扰,提高远小目标的特征可辨识性。Neck 中依据 Backbone 输出再加入 CBAM(先通道注意,再空间注意)可以在不同尺度的融合过程中强化语义重要通道与显著空间区域,加权融合时更加突出目标响应。Head 层由于三个尺度中前两个尺度对应的 feature map 分辨率更高、感受野相对小目标更合适,因此在这两条 Head 分支各自加入轻量 CBAM 可以在最终预测前进一步放大微弱目标的特征响应,改善分类置信与定位精度。
三、检测的实现
3.1 数据集
数据采集首先要明确任务目标和场景分布:明确需要覆盖的目标类别、拍摄角度、光照、天气、分辨率与设备类型(手机、车载、监控等),并在采集计划里按场景比例分配样本。采集方式可混合真实拍摄、公开数据集与合成数据。标注前先制定详细标注规范:类别定义与层级、框/分割/关键点的标注规则、最小可标注尺寸、遮挡或模糊的处理方式、边界框是否应裁至目标外扩或紧贴目标等。常用标注工具包括 LabelImg、LabelMe 等,标注格式应选定为训练框架友好的标准(COCO JSON、Pascal VOC XML、YOLO txt),并在初期对一小批样本进行交叉校验以校准标注员。为降低人工成本和提高一致性,可采用半自动标注流程:先用预训练模型自动预测,再由人工校正;对困难样本组织多轮审查与仲裁。
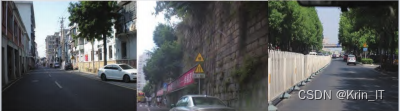
预处理步骤包括统一尺寸与分辨率(或保留原分辨率并采用 tiling 切片策略处理大图)、颜色与几何归一化(统一色彩空间、去除 EXIF 引起的方向问题)、噪声与压缩处理(模拟或修正压缩伪影)、以及按模型需求做像素归一化(例如 -1..1 或 ImageNet 均值方差归一化)。增强策略分为离线增强(扩增数据集后存盘)与在线增强(训练时实时变换)。常用几何与光度变换包括随机裁剪/缩放/翻转/旋转、色彩抖动、亮度/对比度/饱和度调整、模糊/噪声、混合增强(mixup、mosaic、cutmix、copy-paste)以及语义保持的遮挡仿真(用于提升抗遮挡性)。针对小目标与远距目标,建议使用多尺度训练、随机放大小目标区域的采样策略、图像金字塔或滑窗切片增强,同时可利用超分辨或去模糊预处理来改善低像素目标表征。所有增强操作应记录在配置文件中以保证可复现。
数据集划分应包含训练集、验证集与独立测试集(或多折交叉验证),划分时注意场景与时间的分布一致性或有意保留域差(用于验证泛化)。对于时间序列或视频数据,要按序列分割以避免泄露。质量控制包括自动校验(检测空标签、超出边界的 box、重复/冲突标注格式)、可视化抽样检查、并用少量人工验证样本计算标注一致性指标(inter-annotator agreement)。处理类不平衡可用过采样少数类、类别加权损失或基于难度的采样策略。扩展数据集的方法:合成数据(基于渲染或图像合成)、领域自适应(无监督域适配)、和数据标注流水化(active learning:模型建议并优先标注高信息样本)。最后建立版本控制与元数据管理(记录每次采集/清洗/增强/划分的版本号、脚本、配置和随机种子),并编写数据说明文档(数据集规模、类分布、采集设备、标注规范、使用许可和隐私考虑)。
import argparse
import os
import random
import shutil
from pathlib import Path
from collections import defaultdict

IMG_EXTS = {'.jpg', '.jpeg', '.png', '.bmp', '.tif', '.tiff'}

def find_images(img_dir):
    imgs = []
    for p in Path(img_dir).iterdir():
        if p.suffix.lower() in IMG_EXTS:
            imgs.append(p)
    return sorted(imgs)

def group_by_sequence(img_paths):
    # 简单按文件名前缀分组,例如 /seq01_frame0001.jpg -> seq01
    groups = defaultdict(list)
    for p in img_paths:
        name = p.stem
        # 按下划线或连字符分割,取第一个 token 作为 sequence id(可按需改写)
        seq = name.split('_')[0]
        groups[seq].append(p)
    return list(groups.values())

def copy_pair(src_img, src_label, dst_dir):
    dst_img = dst_dir / src_img.name
    shutil.copy2(src_img, dst_img)
    if src_label and src_label.exists():
        shutil.copy2(src_label, dst_dir / src_label.name)
3.2 实验环境搭建
该实验软件环境包括 Pytorch1.10.0、CUDA11.3以及编程语言采用python3.8.硬件环境:CPU为AMD EPYC 7543,内存32 GB,GPU为NVIDIA RTX A5000,显存 24 GB。
3.3 实验及结果分析
环境准备与依赖说明:
确认 PyTorch、CUDA、相关依赖(torchvision、albumentations、pycocotools、tqdm、tensorboard 等)版本兼容;准备 GPU 驱动、cuDNN;设置随机种子以保障可复现性;配置日志与输出目录(模型检查点、tensorboard、训练配置)。若需要分布式训练提前配置 NCCL 和分布式初始化脚本。
import os, random, datetime
import numpy as np
import torch

def setup_env(seed=42, cudnn_benchmark=True, out_dir='runs'):
    os.makedirs(out_dir, exist_ok=True)
    random.seed(seed)
    np.random.seed(seed)
    torch.manual_seed(seed)
    torch.cuda.manual_seed_all(seed)
    torch.backends.cudnn.benchmark = cudnn_benchmark
    run_name = datetime.datetime.now().strftime('%Y%m%d_%H%M%S')
    run_dir = os.path.join(out_dir, run_name)
    os.makedirs(run_dir, exist_ok=True)
    return run_dir

# 使用示例
run_dir = setup_env(seed=123, out_dir='output')
print("Outputs will be saved to:", run_dir)
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
数据集与 Dataloader(预处理与增强):
实现 Dataset 支持 YOLO 风格或 COCO 风格;在训练时使用在线增强(mosaic、mixup、多尺度),验证时仅做 resize/normalize。使用合理的 batch size、num_workers;如果图像尺寸很大考虑 tile/patch 策略或动态 batch。对小目标/远距样本可以增加采样权重或专门裁剪策略。
from torch.utils.data import Dataset, DataLoader
import albumentations as A
import cv2
import torch

class DetectionDataset(Dataset):
    def __init__(self, image_paths, annos, img_size=640, transforms=None):
        self.image_paths = image_paths
        self.annos = annos  # list of annotations per image (x1,y1,x2,y2,cls)
        self.img_size = img_size
        self.transforms = transforms

    def __len__(self):
        return len(self.image_paths)

    def __getitem__(self, idx):
        img = cv2.imread(self.image_paths[idx])[:,:,::-1]  # BGR->RGB
        boxes = np.array(self.annos[idx][:,:4], dtype=np.float32)
        labels = np.array(self.annos[idx][:,4], dtype=np.int64)
        if self.transforms:
            augmented = self.transforms(image=img, bboxes=boxes, class_labels=labels)
            img = augmented['image']
            boxes = np.array(augmented['bboxes'], dtype=np.float32)
            labels = np.array(augmented['class_labels'], dtype=np.int64)
        # convert to tensor and prepare target dict for model
        img = torch.from_numpy(img).permute(2,0,1).float() / 255.0
        target = {'boxes': torch.from_numpy(boxes), 'labels': torch.from_numpy(labels)}
        return img, target
模型构建:
载入标准骨干网络权重(例如 pretrained backbone),把第一个 BottleneckCSP 替换为轻量 SA 模块,Neck 与 Head 指定位置插入 CBAM。建议使用模块化接口(配置文件或 class 参数)以便在训练时开关这些注意力模块。初次训练可先冻结大部分 backbone 仅训练新增模块,然后逐步解冻全网微调。
import torch.nn as nn

# 假设你已有一个 YOLOLikeModel 类,下面演示如何替换/插入模块
class SA_Block(nn.Module):
    def __init__(self, channels, r=8):
        super().__init__()
        self.reduce = nn.Conv2d(channels, channels//r, 1, bias=False)
        self.q = nn.Conv2d(channels//r, channels//r, 1, bias=False)
        self.k = nn.Conv2d(channels//r, channels//r, 1, bias=False)
        self.v = nn.Conv2d(channels//r, channels//r, 1, bias=False)
        self.proj = nn.Conv2d(channels//r, channels, 1, bias=False)

    def forward(self, x):
        b,c,h,w = x.shape
        y = self.reduce(x)
        q = self.q(y).reshape(b,-1,h*w).permute(0,2,1)  # (b,hw,c')
        k = self.k(y).reshape(b,-1,h*w)
        attn = torch.softmax(torch.bmm(q, k) / (q.size(-1)**0.5), dim=-1)
        v = self.v(y).reshape(b,-1,h*w).permute(0,2,1)
        out = torch.bmm(attn, v).permute(0,2,1).reshape(b, -1, h, w)
        out = self.proj(out)
        return x + out  # residual

# 将 SA 插入到模型
model = YOLOLikeModel(cfg)
# 替换第一个 BottleneckCSP(示例)
model.backbone.stage1 = nn.Sequential(
    nn.Conv2d(3, 64, 3, 2, 1, bias=False),
    nn.BatchNorm2d(64),
    nn.SiLU(),
    SA_Block(64)
)
model.to(device)
损失函数与度量:
目标检测常用的损失包括边框回归(GIoU/CIoU)、目标置信(BCE)、分类(BCE或CE)。针对小目标可以按目标面积分桶增加损失权重或对正样本采样进行重加权;也可使用 focal loss 缓解类别不平衡。度量上建议记录 mAP(总体和 small),Recall、Precision、AP per class、远距/遮挡子集指标。
import torch.nn.functional as F

def bbox_giou_loss(pred_boxes, target_boxes):
    # placeholder: 使用一个简单的 IoU-based surrogate
    # pred_boxes, target_boxes: tensors Nx4 (x1,y1,x2,y2)
    # 返回标量 loss
    # 实际应使用成熟实现,如 torchvision.ops.generalized_box_iou
    iou = compute_iou(pred_boxes, target_boxes)  # 自行实现或调用库
    loss = 1.0 - iou.mean()
    return loss

def detection_loss(preds, targets, small_area_weight_fn=None):
    # preds: model raw output structure
    # targets: list of target dicts
    # 这里示例合并三部分 loss
    loss_obj = F.binary_cross_entropy_with_logits(preds['obj'], targets['obj_targets'], reduction='none')
    loss_cls = F.binary_cross_entropy_with_logits(preds['cls'], targets['cls_targets'], reduction='none')
    loss_box = bbox_giou_loss(preds['boxes'], targets['boxes'])
    # 小目标加权(按面积)
    if small_area_weight_fn is not None:
        weights = small_area_weight_fn(targets['boxes'])
        loss_obj = (loss_obj * weights).mean()
        loss_cls = (loss_cls * weights).mean()
    total_loss = loss_box + 0.5 * loss_obj + 0.5 * loss_cls
    return total_loss
优化器、学习率调度与混合精度策略:
建议使用 AdamW 或 SGD+momentum;通常对预训练 backbone 使用较小学习率。学习率调度可用余弦退火、step 或 OneCycle。推荐混合精度训练(torch.cuda.amp)以加速并节省显存,同时使用梯度累积或梯度裁剪(clip grad)稳定训练。若训练大模型考虑 EMA(指数滑动平均)来平滑权重用于推理。
import torch.optim as optim
from torch.cuda.amp import GradScaler, autocast

# optimizer with backbone lower LR
base_lr = 1e-3
params = [
    {'params': [p for n,p in model.named_parameters() if 'backbone' in n], 'lr': base_lr*0.1},
    {'params': [p for n,p in model.named_parameters() if 'backbone' not in n], 'lr': base_lr}
]
optimizer = optim.AdamW(params, lr=base_lr, weight_decay=1e-4)
# scheduler
scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=50, eta_min=1e-6)
scaler = GradScaler()

# EMA
class EMA:
    def __init__(self, model, decay=0.9999):
        self.shadow = {k: v.clone().detach() for k,v in model.state_dict().items()}
        self.decay = decay
    def update(self, model):
        for k,v in model.state_dict().items():
            self.shadow[k].mul_(self.decay).add_(v.detach(), alpha=1-self.decay)
ema = EMA(model)
训练循环
核心训练过程包括正向、反向、优化、调度、EMA 更新、周期性验证与保存检查点。建议每 N 步记录 loss、lr、GPU 使用率、示例可视化(输入+预测框+gt);使用 tqdm 或 wandb/tensorboard 做实时监控。对大 batch/显存不足可使用梯度累积。
from tqdm import tqdm

def train_one_epoch(model, dataloader, optimizer, scheduler, scaler, ema, device, epoch, accum_steps=1):
    model.train()
    optimizer.zero_grad()
    running_loss = 0.0
    pbar = tqdm(enumerate(dataloader), total=len(dataloader))
    for i, batch in pbar:
        imgs, targets = zip(*batch)  # 因为 collate_fn 返回列表
        imgs = torch.stack(imgs).to(device)
        # convert targets to model expected form here...
        with autocast():
            preds = model(imgs)
            loss = detection_loss(preds, prepare_targets(targets))
            loss = loss / accum_steps
        scaler.scale(loss).backward()
        if (i + 1) % accum_steps == 0:
            scaler.unscale_(optimizer)
            torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=10.0)
            scaler.step(optimizer)
            scaler.update()
            optimizer.zero_grad()
            if ema is not None:
                ema.update(model)
        running_loss += loss.item() * accum_steps
        pbar.set_description(f"Epoch {epoch} Loss {running_loss/(i+1):.4f} LR {scheduler.get_last_lr()[0]:.2e}")
    scheduler.step()
    return running_loss / len(dataloader)
验证与评估(mAP, small AP, recall 计算)
在验证集上关闭增强,仅做 resize/center crop/normalize;使用模型(EMA 权重若存在)进行推理,解码预测框并进行 NMS;使用 COCO API 或自实现方法计算 mAP(包括 small/medium/large 分桶)以及 class-wise AP。建议对远距/被遮挡子集单独评估并保存可视化结果用于分析。
from pycocotools.coco import COCO
from pycocotools.cocoeval import COCOeval
import json

def evaluate_coco(model, val_loader, device, iou_type='bbox', use_ema=False, ema=None):
    model_eval = model
    if use_ema and ema is not None:
        # load ema weights to a temp model copy
        tmp = copy.deepcopy(model).to(device)
        tmp.load_state_dict(ema.shadow)
        model_eval = tmp
    model_eval.eval()
    results = []
    for imgs, targets in tqdm(val_loader):
        imgs = torch.stack(imgs).to(device)
        with torch.no_grad():
            preds = model_eval(imgs)
        # decode preds -> list of dicts in COCO format: image_id, category_id, bbox, score
        detections = decode_and_nms(preds)
        results.extend(detections)
    # write results to json and run COCO eval
    res_file = 'results.json'
    with open(res_file, 'w') as f:
        json.dump(results, f)
    cocoGt = COCO(val_coco_ann_file)
    cocoDt = cocoGt.loadRes(res_file)
    cocoEval = COCOeval(cocoGt, cocoDt, iou_type)
    cocoEval.evaluate()
    cocoEval.accumulate()
    cocoEval.summarize()
    return cocoEval.stats  # array of metrics
创作不易,欢迎点赞、关注、收藏。
毕设帮助,疑难解答,欢迎打扰!
最后

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 28
 0
- 0


 已为社区贡献6条内容

所有评论(0)