数据仓库面试题目-数据倾斜
下边图片是我看文档没懂的地方,所以我就找AI给我解答了下,我感觉AI说的够清楚的,其实在学些数据倾斜的时候,我们始终要对map、shuffle、reduce这三个阶段会产生什么样式的数据了解清楚
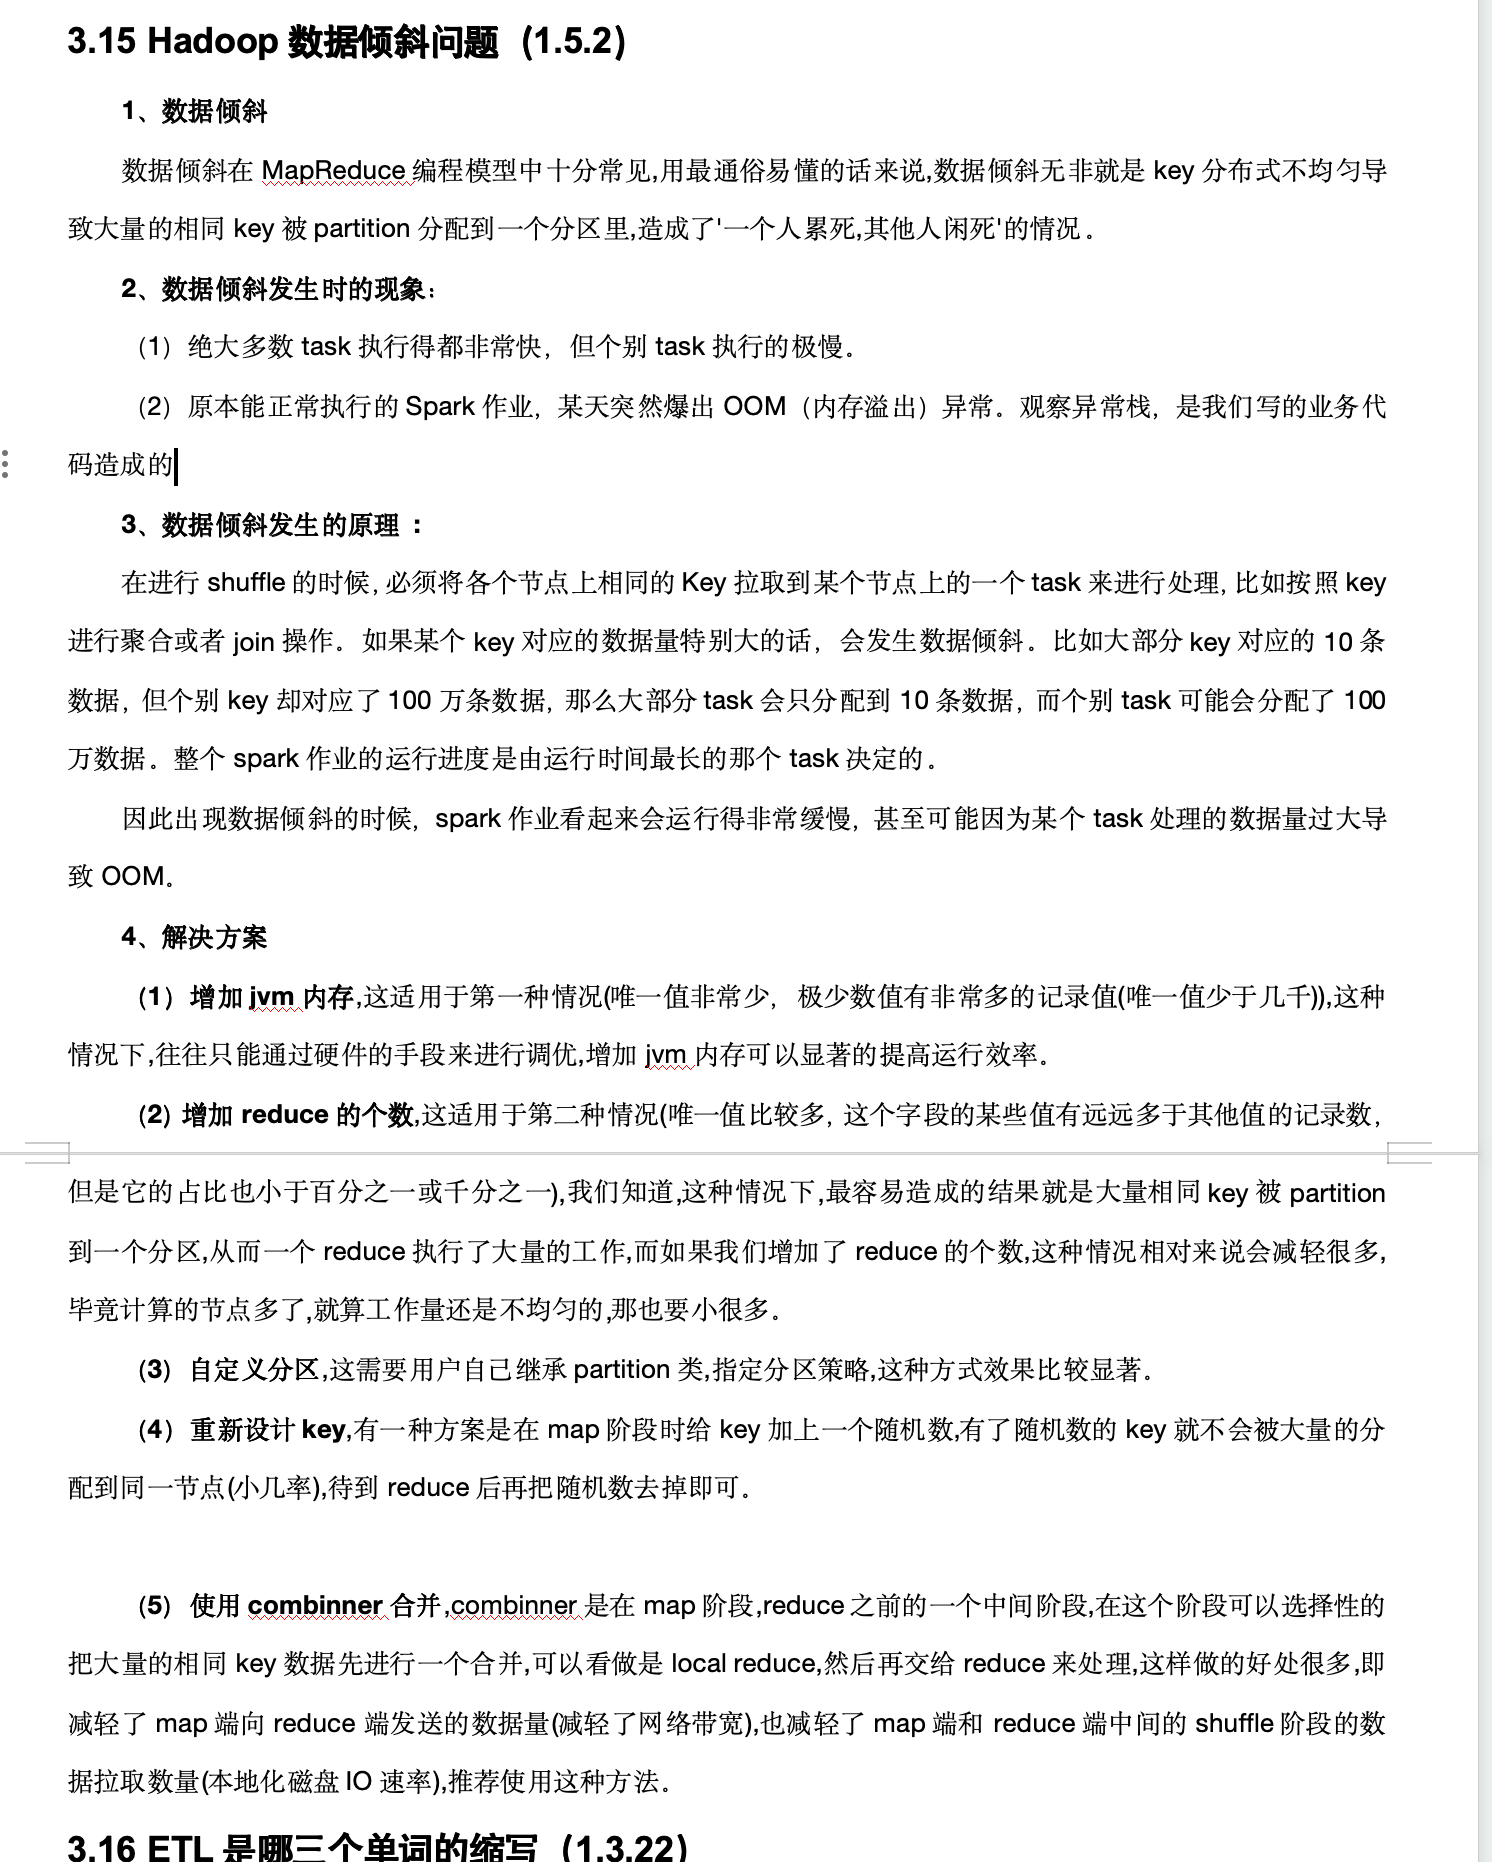
好的,完全没有问题。我们用一个非常经典的“单词计数”例子来生动地说明数据倾斜问题。
场景设定
假设我们有一个超大的文本文件,需要统计每个单词出现的次数。这就是典型的 WordCount 任务。
正常的数据分布可能是这样的:
- 单词 “the” 出现了 10,000 次
- 单词 “and” 出现了 8,000 次
- 单词 “hello” 出现了 1,500 次
- 单词 “world” 出现了 1,200 次
- … 还有成千上万个其他单词,出现次数从 1 次到几百次不等。
虽然 “the” 和 “and” 数量很大,但其他单词也很多,任务会被相对均匀地分配给不同的 Reduce 任务去处理。整个作业会平稳运行。
发生数据倾斜的场景
现在,我们考虑一个极端情况。我们不仅要统计单词,还要统计用户ID的访问次数。
假设我们有一个网站,记录了用户的访问日志。其中99%的用户都是普通用户,访问量不大。但有一个用户是一个疯狂爬虫或者热点明星/网红。
数据分布变成了这样:
- 用户ID
robot_bot_007出现了 10,000,000 次 (这就是导致倾斜的Key) - 用户ID
user_123出现了 150 次 - 用户ID
user_456出现了 120 次 - 用户ID
user_789出现了 80 次 - … 还有其他 10,000 个真实用户,访问次数都在 100 次左右。
在MapReduce过程中会发生什么?
-
Map阶段:每个Map任务读取一部分日志,输出形如
(user_id, 1)的键值对。这个阶段很快,因为大家处理的数据量差不多。 -
Shuffle阶段:这是问题的根源。系统必须把所有相同的Key(即用户ID)发送到同一个Reduce任务上去做最终求和。
- 系统发现
robot_bot_007这个Key有 10,000,000 条记录需要发送到同一个Reduce任务(假设是Reduce任务#3)。 - 而其他Reduce任务(比如#0, #1, #2, #4…)可能只收到了几千条记录,它们需要处理的是
user_123,user_456等这些大量但每个数据量都很小的Key。
- 系统发现
-
Reduce阶段:
- Reduce任务 #0, #1, #2, #4…:它们每个可能只分配到了几千条数据,在几秒钟内就完成了计算,然后…没事干了,进入空闲状态。
- Reduce任务 #3:它需要处理 10,000,000 条记录!它要执行
10,000,000次加法运算。这个过程非常缓慢,可能需要几个小时,并且非常消耗内存(容易导致OOM)。
结果就是你描述的现象:
- 绝大多数task执行得都非常快,但个别task执行的极慢:其他Reduce任务都秒级完成,只有处理
robot_bot_007的那个任务在“吭哧吭哧”地跑。 - 整个作业的运行时间被这个最慢的Reduce任务#3拖垮了。集群的资源也出现了巨大浪费(其他节点早早就空闲了)。
结合你提供的解决方案,我们可以这样处理:
-
增加Reduce个数:比如从默认的5个增加到100个。这样可能把
robot_bot_007的1000万条记录分散到多个Reduce任务中去?很遗憾,对于同一个Key,它必须去同一个Reduce任务,所以这个方法是无效的。 它只对Key很多但单个Key数据量不大的情况有效。 -
自定义分区:我们可以写一个分区算法,比如不是按
user_id本身分区,而是按user_id的哈希值再取模。但同一个Key的哈希值相同,所以还是去同一个分区。这个方法通常用于让数据更均匀,但无法解决这种单个超大Key的问题。 -
重新设计Key(加盐):这是最有效的办法之一。
- Map阶段:我们不给
robot_bot_007发送(robot_bot_007, 1),而是给它加上一个随机前缀(盐),比如变成(robot_bot_007_1, 1),(robot_bot_007_2, 1),(robot_bot_007_3, 1)… 这样,原本要发送到一个Reduce任务的巨大数据量,就被均匀地分散到了多个Reduce任务上。 - 第一次Reduce:这些任务会分别计算出局部结果,比如
robot_bot_007_1的总和是250万,robot_bot_007_2的总和是250万… - 第二次MapReduce:我们再启动一个作业,对所有去掉随机前缀的Key(即
robot_bot_007)进行最终的汇总求和。这样,就把一个巨大的任务拆成了多个小任务并行处理,最终再合并结果。
- Map阶段:我们不给
-
使用Combiner:这是一个非常好的优化手段。在Map端本地就先对数据进行一次合并。
- 比如一个Map任务里
robot_bot_007出现了10万次,Combiner会先在本地把这10万次相加,变成(robot_bot_007, 100000)。 - 这样,Shuffle阶段需要从Map端拉取到Reduce端的数据量就从 10,000,000 条原始记录 变成了 (来自各个Map任务的)几十个局部合计数,极大地减少了网络传输和Reduce端的压力。但它不能完全避免数据倾斜,因为最终这些局部合计数还是要在Reduce端汇总,那个Reduce任务仍然要处理,只是数据量小了几个数量级。
- 比如一个Map任务里
希望通过这个具体的例子,能让你对数据倾斜有一个更直观和深刻的理解!
现在我们用SQL来形象的看下上边的文字
好的,完全没问题。我们使用 SQL(特别是 Hive SQL 或 Spark SQL 的语法)来模拟数据倾斜的场景和解决方案,这样会非常直观。
1. 准备测试数据
首先,我们创建两张表来模拟场景。
表1: 用户访问日志表 (user_visits)
这张表包含一个极其不均匀的 user_id 字段。
-- 创建表
CREATE TABLE user_visits (
    visit_time STRING,
    user_id STRING,
    page_url STRING
);

-- 模拟插入数据
-- 我们假设 'robot_bot_007' 这个异常用户有 1000 万条记录
-- 而其他 10000 个正常用户总共只有 100 万条记录
-- (在现实中,你可以通过 INSERT ... VALUES 插入少量测试数据来模拟)
表2: 用户信息表 (user_info)
这是一张普通的维度表。
CREATE TABLE user_info (
    user_id STRING,
    username STRING,
    age INT
);

-- 插入数据,包含 'robot_bot_007' 和其他用户的信息
2. 数据倾斜的现象 (一个典型的JOIN或GROUP BY)
假设我们需要统计每个用户的总访问次数和他们的年龄。
引发倾斜的SQL:
SELECT
    u.user_id,
    u.age,
    COUNT(1) AS visit_count
FROM user_visits v
JOIN user_info u ON v.user_id = u.user_id
GROUP BY u.user_id, u.age;
在这个查询中会发生什么?
- JOIN
ON v.user_id = u.user_id:Shuffle 过程需要将所有user_visits表和user_info表中相同user_id的数据发送到同一个 Reduce 任务上进行关联。 - GROUP BY u.user_id:关联后的数据,还需要按
user_id分组计数,这又需要一次 Shuffle。 - 倾斜发生:由于
user_visits表中user_id = 'robot_bot_007'的数据量极其巨大(1000万条),承载处理这个 Key 的 Reduce 任务需要接收、处理这 1000 万条记录,以及其他可能分到它的少量其他用户的数据。而其他 Reduce 任务可能只处理几千条记录,很快就完成了。最终作业的完成时间取决于最慢的那个任务。
3. 解决方案的SQL体现
解决方案1:增加Reduce数量
- 思路:对于GROUP BY操作,增加reduce任务数可能让分配更均匀(但对JOIN和大Key问题效果有限)。
- SQL:这通常不是一个SQL语法,而是一个运行时配置。
-- 在Hive或Spark中设置,增加Reduce阶段并行度
SET mapreduce.job.reduces = 200; -- Hive
SET spark.sql.shuffle.partitions = 200; -- Spark

-- 然后运行同样的查询
SELECT ... FROM ... GROUP BY ...;
注意:对于 robot_bot_007 这种单个超大Key,增加Reduce数无效,因为它必须被发送到同一个Reduce任务。此法适用于大量Key的数据分布不均,但没有超级热点的场景。
解决方案2 & 4:重新设计Key(加盐扩散)+
解决方案5:局部聚合(Combiner的思想)
- 思路:将单一大Key打散成多个随机的小Key,进行局部聚合,然后再全局聚合。
- SQL:这是一个非常有效且常见的策略。
-- 第一步:对倾斜的Key进行加随机数(打散),进行局部聚合
SELECT
    -- 如果是倾斜的Key,给它加上一个随机前缀(0-9)
    CASE WHEN v.user_id = 'robot_bot_007'
         THEN CONCAT(v.user_id, '_', CAST(CEIL(RAND() * 9) AS STRING))
         ELSE v.user_id
    END AS modified_user_id,
    u.age,
    COUNT(1) AS partial_visit_count
FROM user_visits v
JOIN user_info u ON v.user_id = u.user_id
GROUP BY (
    CASE WHEN v.user_id = 'robot_bot_007'
         THEN CONCAT(v.user_id, '_', CAST(CEIL(RAND() * 9) AS STRING))
         ELSE v.user_id
    END),
    u.age;

-- 将上一步结果存入临时表
CREATE TABLE tmp_partial_agg AS ...;

-- 第二步:对临时表的数据,去除随机前缀,进行全局聚合
SELECT
    -- 将打散的Key恢复原状
    CASE WHEN INSTR(user_id, '_') > 0
         THEN SUBSTR(user_id, 1, INSTR(user_id, '_') - 1)
         ELSE user_id
    END AS original_user_id,
    age,
    SUM(partial_visit_count) AS total_visit_count
FROM tmp_partial_agg
GROUP BY (
    CASE WHEN INSTR(user_id, '_') > 0
         THEN SUBSTR(user_id, 1, INSTR(user_id, '_') - 1)
         ELSE user_id
    END),
    age;
过程解释:
- 第一次MR/Spark作业:将
robot_bot_007随机变成了robot_bot_007_1,robot_bot_007_2, …robot_bot_007_9。这9个新Key会被分散到不同的Reduce任务上去进行局部计数(partial_visit_count)。这就把1个超大任务拆成了9个小任务并行执行。 - 第二次MR/Spark作业:将所有打散的Key(
robot_bot_007_1,robot_bot_007_2, …)恢复成原来的robot_bot_007,然后对这个Key的所有局部结果进行SUM操作,得到最终的总数。
通过这种方式,原本由一个Reduce任务处理的1000万条记录,被均匀地分摊给了9个任务先处理,完美解决了数据倾斜。
总结
| 现象 | 问题SQL | 思路 | 解决SQL示例 |
|---|---|---|---|
| 单个Key数据量巨大 | 直接 JOIN 或 GROUP BY 倾斜字段 | 加盐打散 | 使用 CASE...WHEN... 和 RAND() 修改Key,进行两阶段聚合 |
| 大量Key分布不均 | 直接 GROUP BY | 增加并行度 | 设置 set spark.sql.shuffle.partitions=1000; |
希望这些SQL示例能让你更直观地理解数据倾斜的解决之道!在实际操作中,你需要先分析数据,找到那个倾斜的Key,然后再应用对应的解决方案。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)