多实例微服务共享Kafka Topic消费方案:基于group.id的配置与验证全流程
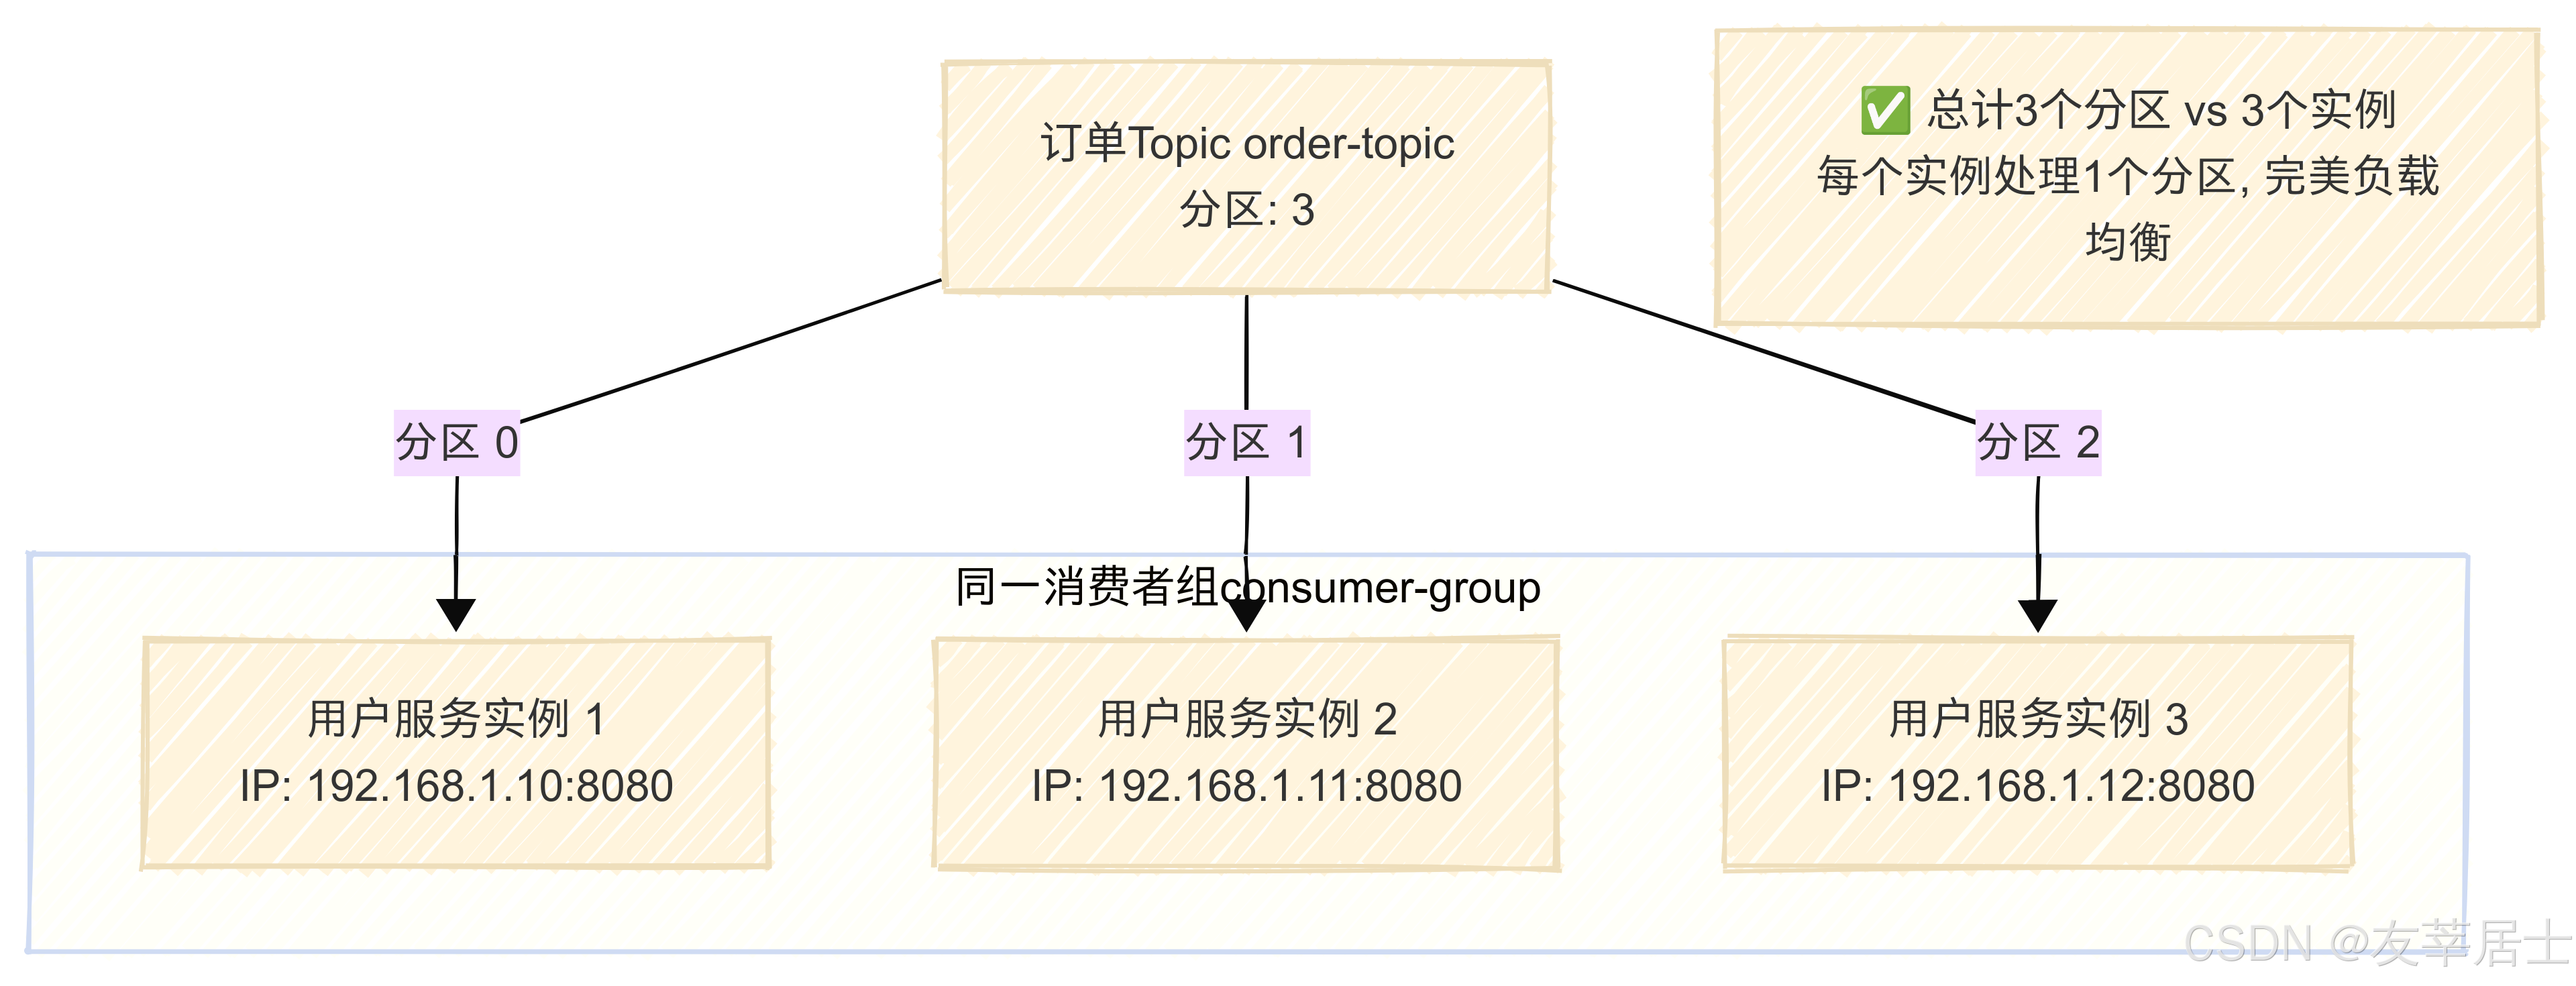
当你有多套功能相同的微服务实例(例如:用户服务部署了3个实例),并且希望它们协同工作来消费同一个Topic,而不是每个实例都消费全部消息时,正确的配置至关重要。
一、核心原则:共享组ID
答案非常简单:让所有功能相同的微服务实例使用完全相同的 group.id。
工作原理:
- 同一组,共协作:Kafka 认为所有使用相同
group.id的消费者实例属于同一个逻辑消费者组。 - 分区瓜分:Kafka 会确保 Topic 的每个分区在某一时刻只被该组内的一个消费者实例消费。
- 自动负载均衡:当组内实例增加或减少时,Kafka 会自动触发再平衡(Rebalance),重新分配分区,实现无缝的伸缩。
二、具体配置与实践
假设你有一套“订单处理服务”(order-service),部署了 3 个实例。
第 1 步:在公共配置中设置组ID(最关键!)
所有实例的 application.yml(或配置中心)中必须使用相同的 group-id。
order-service 的 application.yml
spring:
  application:
    name: order-service # 应用名相同,标识是同一套服务
  kafka:
    bootstrap-servers: localhost:9092
    consumer:
      # 核心配置:所有实例使用相同的组ID
      group-id: ${spring.application.name}-order-process-group
      # 最终解析为: order-service-order-process-group
      auto-offset-reset: earliest
      key-deserializer: org.apache.kafka.common.serialization.StringDeserializer
      value-deserializer: org.apache.kafka.common.serialization.StringDeserializer
    producer:
      # ... 生产者配置
为什么这样设置?
${spring.application.name}:确保组ID与应用名关联,避免不同服务的组ID冲突。-order-process-group:清晰说明这个组是用于处理“订单”的。
第 2 步:编写消费代码(所有实例代码相同)
所有实例都运行同样的代码,监听相同的Topic。
@Service
@Slf4j
public class OrderConsumerService {

    @KafkaListener(topics = "order-topic")
    // 不在这里写groupId,而是使用配置文件中的全局设置
    public void processOrder(OrderEvent orderEvent) {
        log.info("实例 {} 收到订单消息: {}", getInstanceId(), orderEvent.getOrderId());
        // 处理订单的业务逻辑...
    }

    // 一个简单的方法用于标识当前实例(可选,用于日志调试)
    private String getInstanceId() {
        try {
            return InetAddress.getLocalHost().getHostAddress() + ":" + serverPort;
        } catch (UnknownHostException e) {
            return "unknown";
        }
    }

    @Value("${server.port}")
    private String serverPort;
}
三、部署与验证
- 打包部署:将同一个
order-service的应用 JAR 包,在三个不同的服务器或容器中启动。 - 查看分配情况:使用 Kafka 命令工具查看消费者组的状态。
kafka-consumer-groups.sh --bootstrap-server localhost:9092 \
    --group order-service-order-process-group --describe
期望的输出:
GROUP                          TOPIC           PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG   CONSUMER-ID
order-service-order-process-group order-topic   0          12345           12345           0     consumer-1-...
order-service-order-process-group order-topic   1          23456           23456           0     consumer-2-...
order-service-order-process-group order-topic   2          34567           34567           0     consumer-3-...
你会看到 Topic 的 3 个分区被分配给了 3 个不同的 CONSUMER-ID(即你的3个服务实例)。
- 动态伸缩测试:
- 扩容:启动第4个实例。观察日志,Kafka 会触发再平衡,但因为只有3个分区,所以第4个实例会处于空闲状态,直到有实例下线或其他分区被释放。
- 缩容:关闭1个实例。Kafka 会再次触发再平衡,将这个实例负责的分区自动转移给剩余的两个实例处理。服务整体依然可用,不会丢失消息。
四、重要注意事项与最佳实践
-
分区数 >= 实例数:理想情况下,Topic 的分区数应该大于等于最大可能的消费者实例数,这样才能充分发挥水平扩展的能力。如果分区数是3,你启动4个实例,那么1个实例会空闲。
-
谨慎处理再平衡:再平衡期间消费会短暂暂停。如果你的消费逻辑是批处理或耗时很长,需要配置合理的
max.poll.interval.ms参数,防止因为处理太慢而被误认为消费者失效而触发不必要的再平衡。spring: kafka: consumer: properties: max.poll.interval.ms: 300000 # 5分钟,根据你的处理时间调整 -
偏移量提交:默认是自动提交。如果业务要求至少一次处理或精确一次处理,建议采用手动提交模式,并在业务逻辑成功完成后提交偏移量。
spring:
  kafka:
    consumer:
      enable-auto-commit: false # 关闭自动提交
@KafkaListener(topics = "order-topic") public void processOrder(OrderEvent event, Acknowledgment ack) { try { // 业务逻辑 doSomeWork(event); // 手动提交偏移量 ack.acknowledge(); } catch (Exception e) { // 处理异常,不提交偏移量,消息会重新消费 } } -
无状态服务:要这样部署,你的微服务必须是无状态的(Stateless)。即任何实例处理消息的能力和结果都应该是一样的,不能依赖本地内存状态。状态应存储在外部数据库、Redis等共享中间件中。
总结
让多套相同功能的微服务协同消费同一分组,只需一步:
在所有实例的配置文件中,设置完全相同的 spring.kafka.consumer.group-id。
这样,Kafka 就会自动为你完成负载均衡、故障转移和动态伸缩,你的微服务集群就具备了高可用和高并发的消费能力。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 5
 0
- 0


 已为社区贡献4条内容

所有评论(0)