我们是如何为 ClickHouse 列式存储构建快速 UPDATE 的 Part3/3:基准测试 1000 倍提速

本文字数:19684;估计阅读时间:50 分钟
作者:Tom Schreiber
本文在公众号【ClickHouseInc】首发

TL;DR
标准 SQL UPDATE 功能登陆 ClickHouse:借助轻量级补丁分区更新机制,性能可比传统变更(mutation)快 1,000 倍。
本文是 ClickHouse 快速 UPDATE 系列的第三篇:
介绍 ClickHouse 如何通过基于插入的引擎(如 ReplacingMergeTree、CollapsingMergeTree 和 CoalescingMergeTree)避免低效的行级更新。
讲述我们如何利用补丁分区机制,以极低的额外开销将标准 UPDATE 语法引入 ClickHouse。
-
本篇:基准测试与结果
全面对比多种更新方式的性能,其中包括声明式 UPDATE,实际测得最高可达 1,000 倍的加速效果。
ClickHouse 中的快速 SQL 更新:基准测试与咖啡因加持下的松鼠
想象一只松鼠,身形灵巧,在不同储藏点之间来回穿梭,不停地放入新坚果。
再想象这只松鼠喝了浓缩咖啡——速度快到惊人,眨眼间就能在储藏点间完成往返。
这就是 ClickHouse 轻量级更新 的体验:在数据分区间飞快穿梭,投递微小补丁,即刻生效,同时保持查询性能稳定。
剧透:这些是真正的标准 SQL UPDATE,通过轻量级补丁分区机制实现。在我们的基准测试中,一次批量标准 SQL UPDATE 从 100 秒缩短到 60 毫秒,比经典变更快 1,600 倍,而在最差情况下,查询性能几乎与完全重写数据时相当。
本文是 ClickHouse 快速 UPDATE 深度解析的第 3 部分,重点介绍基准测试结果。
(如果想了解背后的实现细节,请参考 第 2 部分:SQL 语法的 UPDATE。)
在这里,我们将并列对比多种 UPDATE 方法:
-
经典变更与即时执行的变更
-
轻量级更新(补丁分区)
-
ReplacingMergeTree 插入
我们将重点关注两个方面:
- 更新速度与可见性 – 不同方法应用更改的速度差异
2. 合并前的查询性能影响 – 在数据合并前更新对延迟的影响
所有测试均可完整复现,我们已开源全部脚本和查询。
接下来,我们将介绍数据集和基准测试配置,然后逐步分析测试结果。
数据集与基准测试配置
数据集
在 第 1 部分和 第 2 部分 中,我们曾用一个小型订单表来演示基础更新场景。
在本次基准测试中,我们继续沿用“订单”主题,但将规模大幅提升,选用 TPC-H(https://clickhouse.com/docs/getting-started/example-datasets/tpch) 数据集中的 lineitem 表,该表模拟了客户订单中的商品条目。这是一个典型的更新场景,数量、价格或折扣在最初插入后可能会发生变化。
CREATE TABLE lineitem (
    l_orderkey       Int32,
    l_partkey        Int32,
    l_suppkey        Int32,
    l_linenumber     Int32,
    l_quantity       Decimal(15,2),
    l_extendedprice  Decimal(15,2),
    l_discount       Decimal(15,2),
    l_tax            Decimal(15,2),
    l_returnflag     String,
    l_linestatus     String,
    l_shipdate       Date,
    l_commitdate     Date,
    l_receiptdate    Date,
    l_shipinstruct   String,
    l_shipmode       String,
    l_comment        String)
ORDER BY (l_orderkey, l_linenumber);
我们使用的是该表的 规模因子 100(scale factor 100) 版本,包含约 6 亿行数据(约 1.5 亿个订单中的 6 亿个商品),压缩后大小约 30 GiB(未压缩约 60 GiB)。
在基准测试中,lineitem 表以单个 数据 part(https://clickhouse.com/docs/parts) 形式存储。其压缩大小约 30 GiB,远低于 ClickHouse 150 GiB 压缩合并 阈值(https://clickhouse.com/docs/operations/settings/merge-tree-settings#max_bytes_to_merge_at_max_space_in_pool)——该阈值以内,后台合并会自动将多个较小的 part 合并为一个。这意味着该表会自然保持为一个完全合并的单 part,能够很好地模拟实际的更新场景。
下面是我们用于所有基准测试运行的 lineitem 基表(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/init.sh#L68) 概览,确认其为单个数据 part。
SELECT
    formatReadableQuantity(sum(rows)) AS row_count,
    formatReadableQuantity(count()) AS part_count,
    formatReadableSize(sum(data_uncompressed_bytes)) AS size_uncomp,
    formatReadableSize(sum(data_compressed_bytes)) AS size_comp
FROM system.parts
WHERE active AND database = 'default' AND `table` = 'lineitem_base_tbl_1part';
┌─row_count──────┬─part_count─┬─size_uncomp─┬─size_comp─┐
│ 600.04 million │ 1.00 │ 57.85 GiB │ 26.69 GiB │
└────────────────┴────────────┴─────────────┴───────────┘硬件与操作系统
测试运行环境为一台 AWS m6i.8xlarge EC2 实例(32 核 CPU、128 GB 内存),搭配 gp3 EBS 卷(16k IOPS,最大吞吐量 1000 MiB/s),运行 Ubuntu 24.04 LTS。
ClickHouse 版本
所有测试均基于 ClickHouse 25.7 进行。
如何自行运行
你可以使用我们在 GitHub 提供的基准测试脚本(https://github.com/ClickHouse/examples/tree/main/blog-examples/clickhouse-fast-updates)复现所有结果。
该代码仓库包含:
-
批量更新和单行更新的 SQL 语句集
-
用于运行基准测试并记录耗时的脚本
-
检查数据 part 大小和分析查询性能影响的辅助工具
在测试环境与数据集准备就绪后,我们从批量更新开始探索不同更新方法的表现,因为批量更新是大多数批处理流水线的核心场景。
批量 UPDATE
批量更新是批处理数据管道的基础,也是经典 mutation 最常见的工作负载。因此我们首先对其进行评测。
我们针对 10 个典型的批量更新场景 进行了基准测试,采用三种方法(GitHub 上均提供了对应的 SQL 脚本):
- Mutation(变更)(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/SMALL/mutation_updates.sql)
– 对受影响的数据 part 执行完整重写。
2. 轻量级更新(Lightweight updates)(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/SMALL/lightweight_updates.sql) – 只向磁盘写入小型补丁 part。
(依然使用 标准 SQL UPDATE 语句](https://www.w3schools.com/sql/sql_update.asp);“轻量级”仅指底层采用了高效的补丁 part 实现。)
3. On-the-fly mutation(读取时应用的变更)(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/SMALL/mutation_updates.sql) – 使用与 mutation 相同的语法,但仅将更新表达式保存在内存中,并在查询时动态应用;完整列的重写在后台异步进行。
注意:
-
本文仅比较声明式更新(declarative updates)。像 ReplacingMergeTree 这类专用引擎没有参与多行更新的基准测试,因为逐行插入的批量更新在实践中并不可行。(后续我们会针对这些引擎单独评测单行更新性能。)
-
我们没有单独对 DELETE 做基准测试。DELETE 要么是经典 mutation,会 重写(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#stage-15-lightweight-deletes-still-mutations-but-faster)_row_exists 列,要么是 轻量级补丁(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#featherweight-deletes) 来修改该掩码。这两种机制已在本文所涵盖的测试方法中体现。
(接下来有图表!如果你只关心结果,可以跳过每节中的“How we measured”部分。)
测量方法 – 批量更新运行时间
-
删除(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/run_updates_sequential.sh#L84) lineitem 表(如已存在)。
2. 克隆(https://clickhouse.com/blog/clickhouse-release-24-10#table-cloning) 一个新的 lineitem 表,基于基表创建。
3. 执行更新并记录运行时间(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/run_updates_sequential.sh#L96)。
每种方法重复 3 次,计算平均耗时。
上述流程会对 全部 10 个批量更新场景 重复执行。
批量更新在查询中可见所需的时间
对于这 10 个批量 UPDATE 的每一种情况,下方的图表展示了从发出 UPDATE 到更新结果对查询可见所耗费的时间,并对比了三种方法的差异。
同时,图表还显示了轻量级更新相较于经典 mutation 的加速百分比。经典 mutation 必须等受影响的数据 part 重写完成,查询才能看到更新,而轻量级更新则可即时生效。
图表中的关键指标包括:
Rows upd / Cols upd:此次 UPDATE 涉及的行数与列数
Full cols size:经典 mutation 需重写的列数据总字节数
Upd data size:轻量级更新实际写入的字节数

-
On-the-fly mutation(读取时应用的变更)— 将更新表达式存储在内存中(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#stage-2-on-the-fly-updates-for-instant-visibility),可在查询数据时即时生效。
-
经典 mutation(Classic mutations)— 最慢的方式;在查询看到新数据之前,每次更新都要将完整列写回磁盘(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#stage-1-classic-mutations-and-column-rewrites)。
-
轻量级更新(Lightweight updates)— 通过写入微小的补丁 part(patch parts)(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#how-patch-parts-work),可实现高达 1,700 倍的加速,这些补丁能立即在查询中生效。
完整的基准测试 JSON 结果可在 GitHub(https://github.com/ClickHouse/examples/tree/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/results) 查看。
后续的深度解析中,我们会详细解释这些方法在速度差异背后的原因。
更新速度固然重要,但更关键的是不能牺牲查询性能。接下来看看不同方法对查询的影响。
批量更新后查询的最坏执行时间
一旦数据完全物化(materialization)后,无论采用哪种更新方式,查询性能都完全一致。
当后台处理完成后,表的数据 part 已全部更新,无论使用哪种 UPDATE 方法,查询都能以基准速度运行:
-
Mutation – 数据 part 会立即被重写(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#stage-1-classic-mutations-and-column-rewrites)。
-
On-the-fly mutation – 后台列重写最终会将内存中的更新表达式物化(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#stage-2-on-the-fly-updates-for-instant-visibility)到磁盘。
-
轻量级更新 – 补丁 part 会在常规后台合并中并入(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#how-patch-parts-work)主数据 part。
因此,我们重点报告更新后最坏情况下的查询耗时,这是最保守的性能评估方式,指的是在数据尚未物化到磁盘前,查询命中刚更新行时的运行时间。
接着,我们会计算这种情况下相对于基准耗时(经典 mutation 完成所有磁盘写入后执行相同查询的耗时)的性能下降比例(即耗时增加百分比)。
测量方法 – 批量更新后的最坏查询耗时
• 用 10 个分析型查询(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/SMALL/analytical_queries.sql),与 10 个更新一一对应。
• 每次更新后,运行对应的查询 3 次(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/run_updates_sequential.sh#L141),记录平均运行时间和峰值内存使用量。
补充说明:
-
每个查询至少会访问更新的行和列,但不少查询会扫描更大范围的数据,以模拟真实分析场景。
-
为捕捉最坏延迟,测试过程中会禁用后台合并(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/run_updates_sequential.sh#L92):
-
-
On-the-fly mutation 会将更新完全保存在内存中;
-
轻量级更新依赖“读取时应用补丁(Patch-on-read)”,相当于隐式执行 FINAL 查询。
-
接下来的图表展示了在每种批量 UPDATE 方法下,10 个查询(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/SMALL/analytical_queries.sql)的最坏查询耗时,并与完全物化的基准性能进行比较:
图表中的关键指标包括:
Slowdown %:相对于完全物化(mutation 基准)的耗时增加百分比
Memory (MiB):查询的峰值内存使用量
Memory Δ (%):与基准相比的内存使用变化百分比
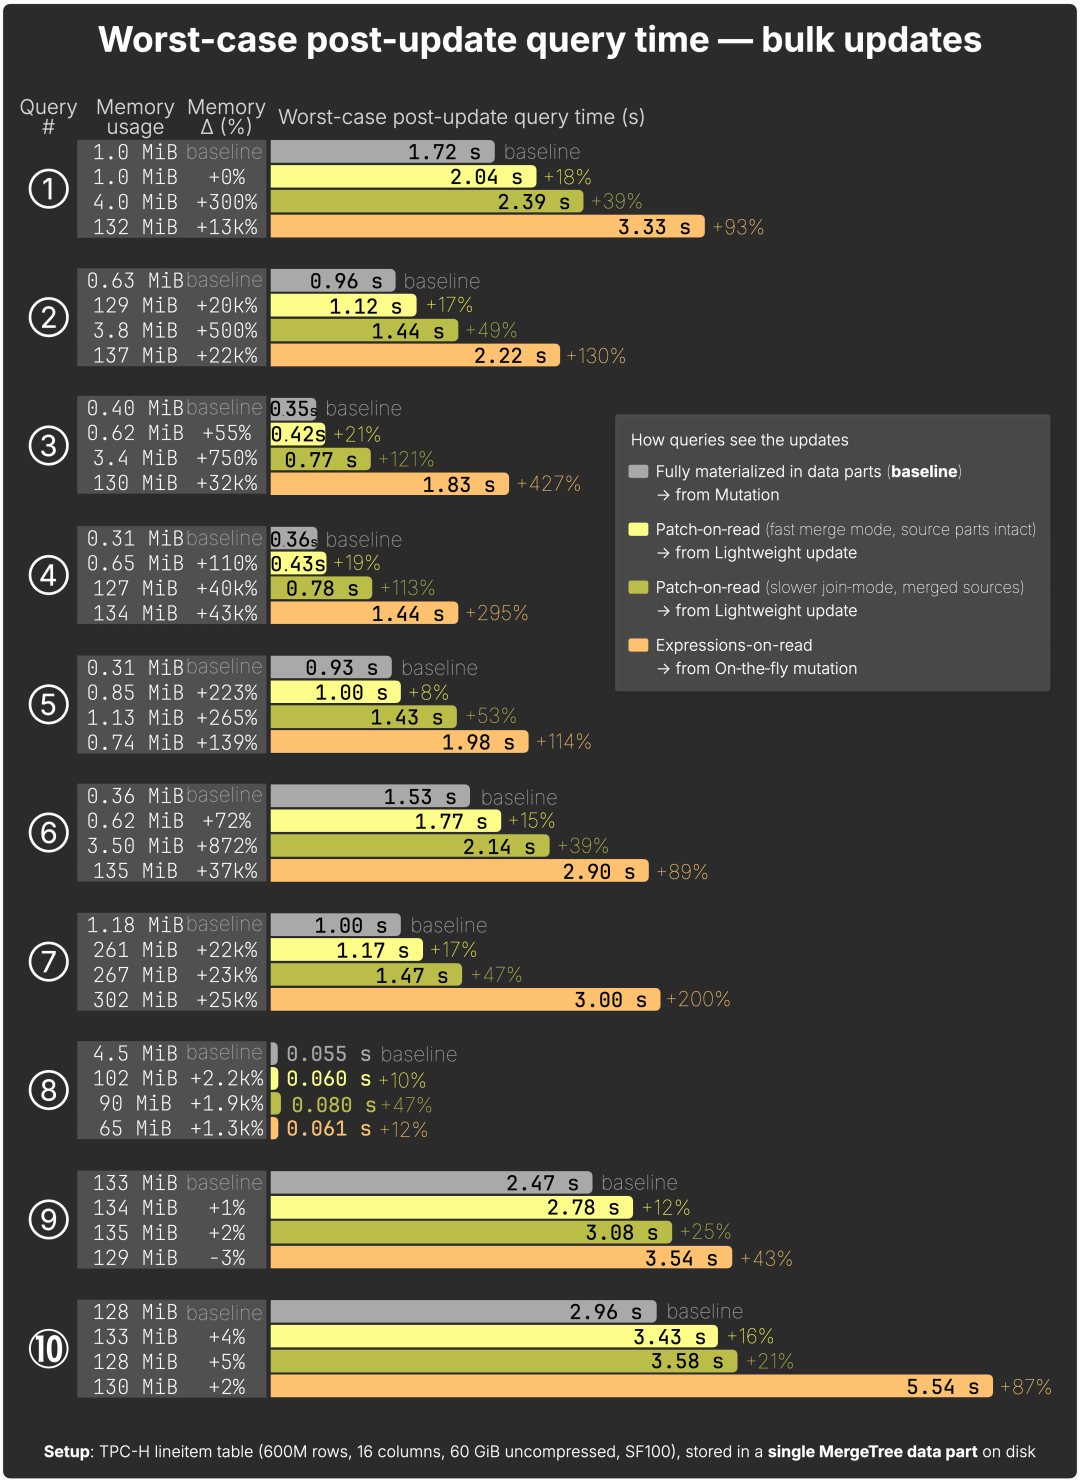
-
经典 mutation(基准) → 指同步 mutation 完成受影响数据 part 的磁盘重写后,查询的运行时间。
-
轻量级更新(Lightweight updates) → 默认情况下开销极低(平均 15%);在快速合并模式(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#fast-source-part-matching-via-index)下,性能下降仅为 8–21%。
-
轻量级更新的少见降级模式 → 当源数据 part 在补丁创建过程中被合并时,会进入较慢的 join 模式(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#patch-application-via-join-on-block-based-system-columns),性能下降可达 39–121%。
-
On-the-fly mutation(即时变更) → 虽能即时生效,但会带来最高的性能下降(12–427%,平均 149%)。
内存影响 → On-the-fly 模式的峰值内存可从约 0.7 MiB 飙升至约 302 MiB;轻量级更新的内存占用则保持极低水平。
完整的基准测试结果可在此查看 →(https://github.com/ClickHouse/examples/tree/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/results)
这些性能差异和内存变化背后的原理将在后续的深度解析部分详细介绍。
批量更新是批处理数据管道的基石,但许多实际业务场景依赖频繁的单行更新。接下来,我们对比不同方法在单行更新下的表现。
单行更新
我们对单行更新进行了基准测试,这类场景常见于 ReplacingMergeTree 或 CoalescingMergeTree。
-
此处的 10 个更新 与批量更新测试相同,但每次仅更新1 行(而不是数千行)。查看 SQL 示例 →(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/10x1)
-
对于 ReplacingMergeTree,每次更新都会插入一条新记录,未更新的列重复原值。Replacing 插入示例 →(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/10x1)
-
(CoalescingMergeTree 可以避免重复未更新列,但要求所有更新列为 Nullable(https://clickhouse.com/docs/sql-reference/data-types/nullable#storage-features)。)
说明: 本测试中仅选择 ReplacingMergeTree 作为 第 1 部分 中专用更新引擎的代表。CoalescingMergeTree 和 CollapsingMergeTree 在此类单行更新中的性能表现相近。
为了将 ReplacingMergeTree 的 UPDATE 性能 与其他方法对比,我们还将同一组 10 个单行更新分别实现为 经典 mutation、On-the-fly mutation 和 轻量级更新(标准 SQL UPDATE 语法(https://www.w3schools.com/sql/sql_update.asp),底层基于补丁 part 实现)。查看 SQL 示例 →(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/10x1)
测量方法 – 单行更新运行时间
单行(精确定位)更新的测试流程与批量更新相同:删除(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/run_updates_sequential.sh#L84)并克隆(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/run_updates_sequential.sh#L86)测试表 → 执行(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/run_updates_sequential.sh#L103)更新 → 测量(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/run_updates_sequential.sh#L153)运行时间三次取平均值。每种方法均执行 10 次更新。
单行(点)更新在查询中可见所需的时间
与批量更新类似,下方的图表展示了这 10 个单行 UPDATE 从发出到查询可见的耗时对比,涵盖四种方法。
同时,图表中还显示了轻量级更新和 Replacing 插入相较于经典 mutation 的加速百分比。经典 mutation 需要等所有受影响的 part 重写完成后,更新结果才能对查询可见。
图表中的关键指标包括:
Rows upd / Cols upd:UPDATE 涉及的行数与列数
Full cols size:经典 mutation 会重写的列数据总字节数
Upd data size:轻量级更新实际写入的字节数
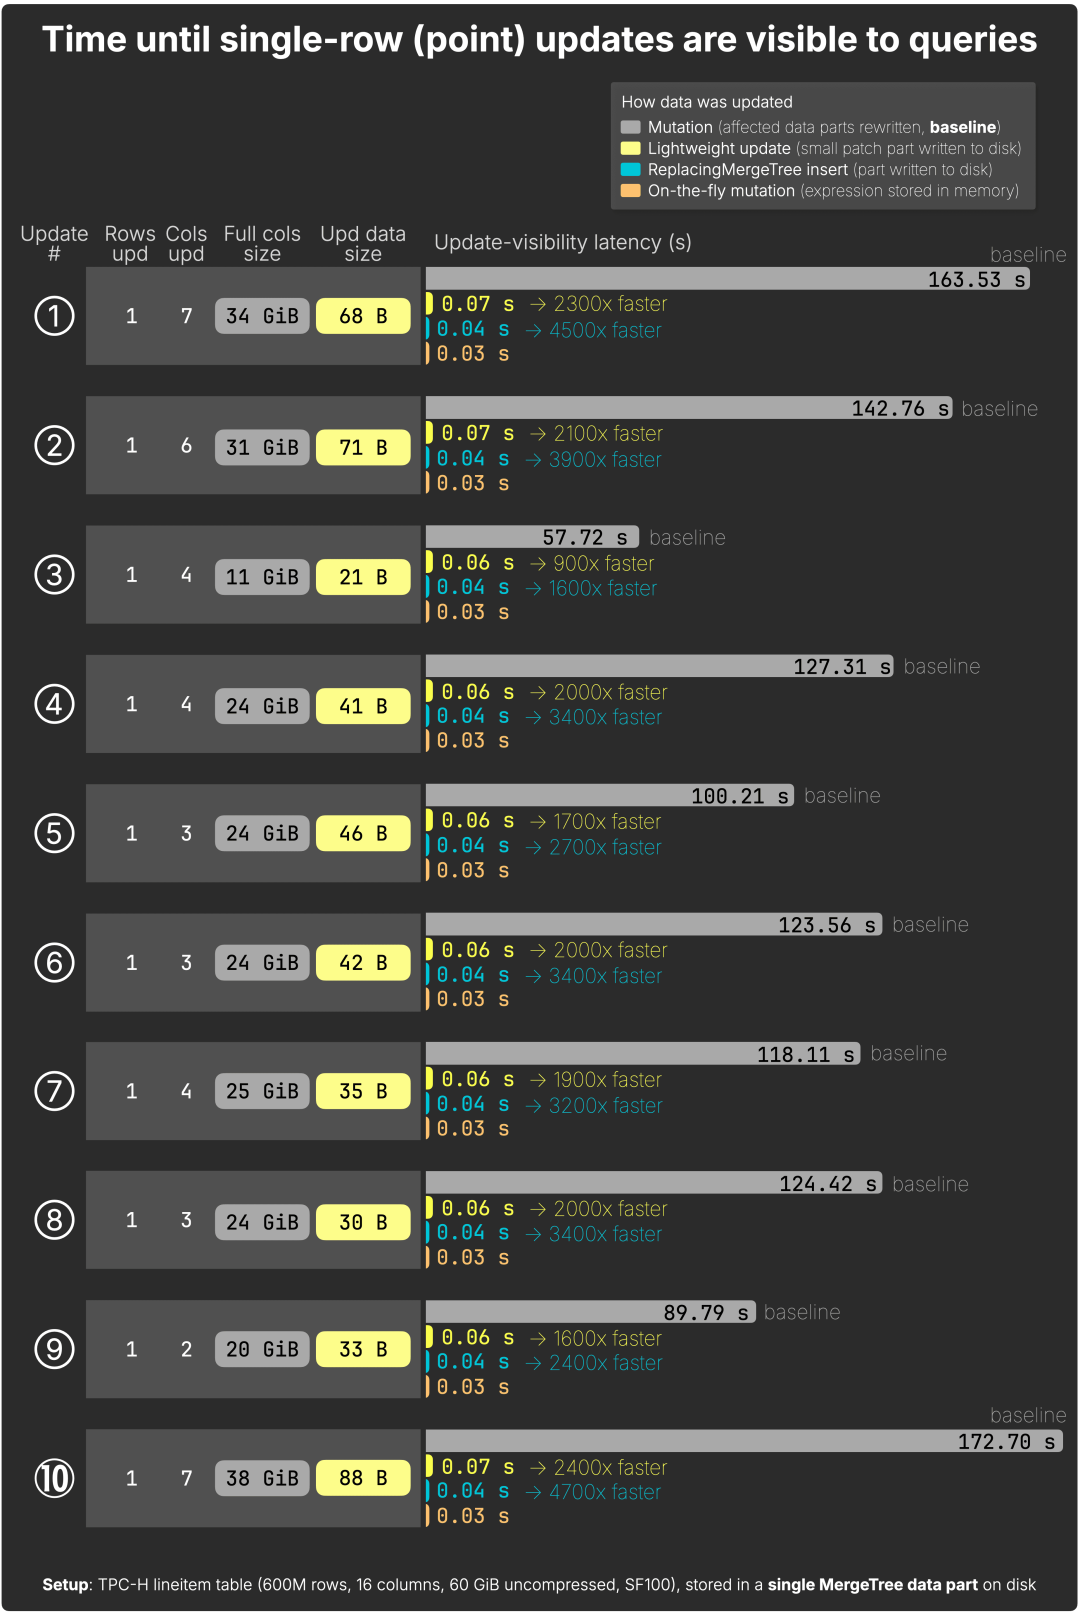
-
On-the-fly mutation(即时变更) → 更新表达式仅保存在内存中,因此几乎可立即可见(约 0.03 秒);完整的列重写在后台异步执行。
-
ReplacingMergeTree 插入 → 只写入新增行即可达到最快速度(0.03–0.04 秒),比经典 mutation 快 4,700 倍;无需行查找,但在后台合并完成前,查询需要处理同一行的多个版本。
-
轻量级更新(Lightweight updates) → 速度几乎同样快(0.04–0.07 秒),比经典 mutation 快 2,400 倍,通过写入微小补丁 part(patch parts)实现;因涉及行查找稍慢,但在查询性能上更高效。
-
经典 mutation → 最慢(90–170 秒),即便只更新一行,也会重写所有受影响列。
完整基准结果见此 →(https://github.com/ClickHouse/examples/tree/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/results)
和批量更新一样,我们会在后续的深度解析中解释这些性能差异的原因。
更新速度只是一个方面,我们还需要评估单行更新对查询性能的影响。
单行更新后查询的最坏执行时间
在单行测试中,我们复用了多行测试中的同一组 10 个分析型查询(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/10x1/analytical_queries.sql)。
本节与批量更新相同,测试的指标是更新后最坏查询耗时——即查询命中尚未完全物化(materialization)到磁盘的更新行时的执行时间,并计算相对于经典 mutation 完全物化后的运行时间(基准)的性能下降百分比。
测量方法 – 单行更新的最坏查询耗时
• 每个查询与其对应的更新一一配对;每次运行三次取平均值,记录运行时间与峰值内存。
补充说明:
• 每个查询至少命中更新的行和列,但很多查询会扫描更大范围以模拟真实分析场景。
• 为捕捉最坏延迟,测试禁用了后台合并(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/run_updates_sequential.sh#L99):
-
-
On-the-fly mutation 完全保留在内存中;
-
轻量级更新依赖 Patch-on-read(隐式 FINAL);
-
ReplacingMergeTree 查询使用显式 FINAL(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/run_updates_sequential.sh#L148)。
-
下图展示了 10 个分析型查询(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/10x1/analytical_queries.sql) 在四种方法下的最坏查询耗时,并与经典 mutation 的完全物化基准进行比较:
图表中的其他关键指标
减速百分比(Slowdown %):相较于完全物化(mutation)基线的额外运行时间
内存(MiB):查询过程中使用的峰值内存
内存变化百分比(Memory Δ %):相较基线的内存使用变化
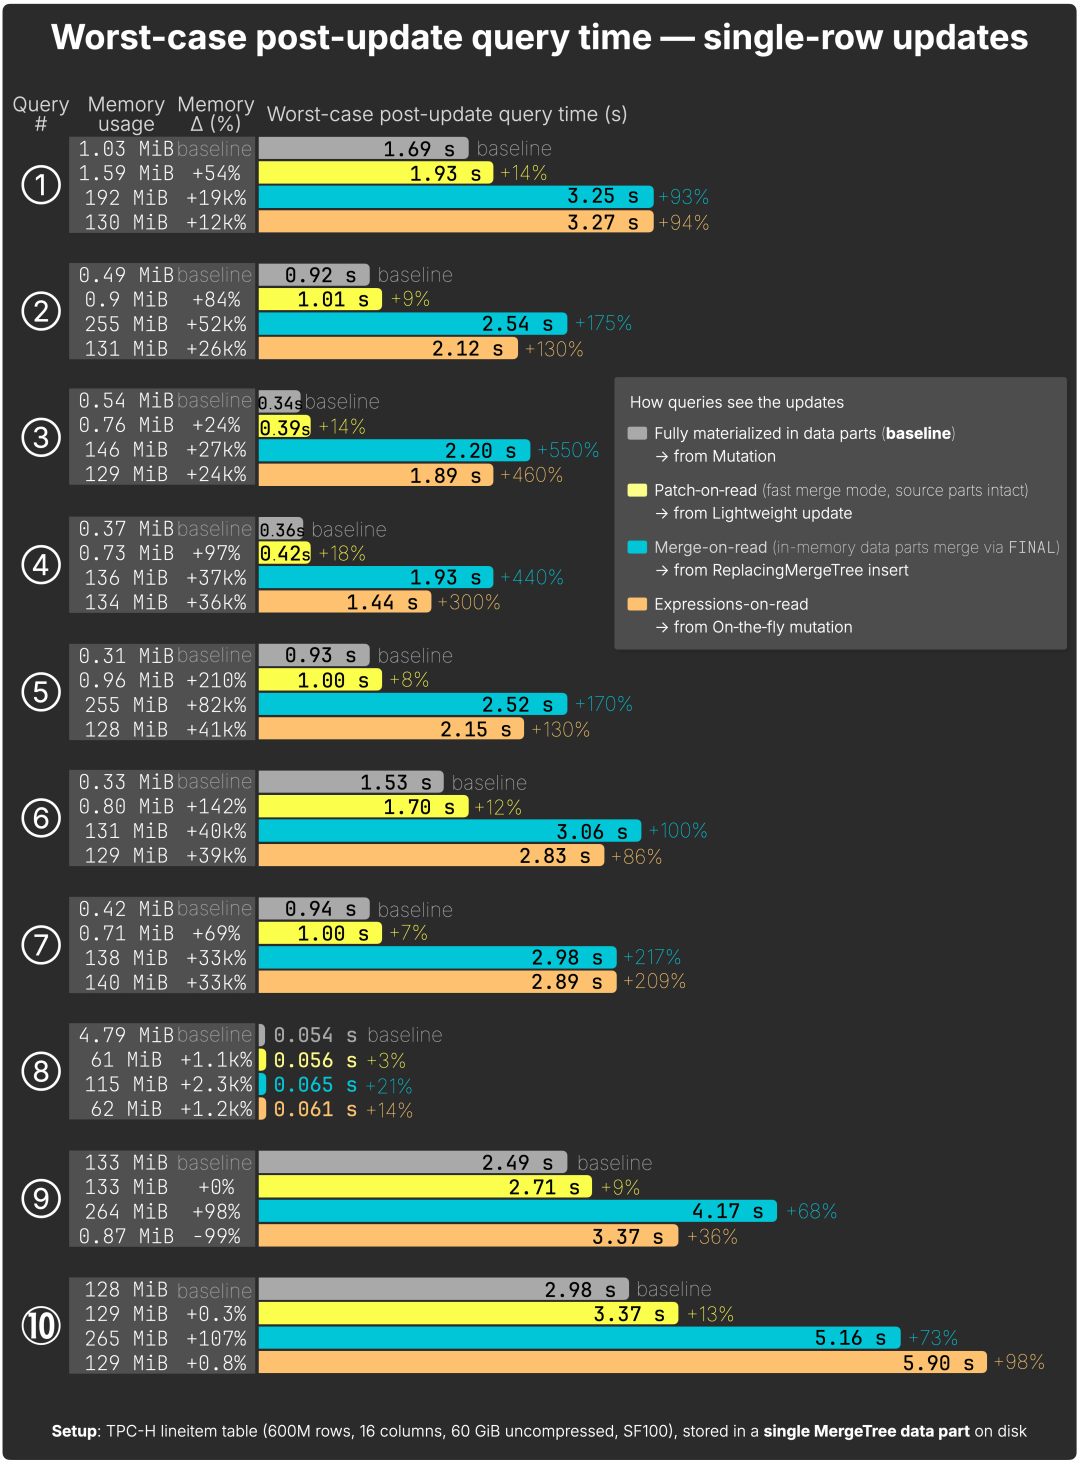
-
经典 mutation(基准) → 同步重写受影响 part 后的查询时间
-
轻量级更新 → 对查询最友好,性能下降 7–18%(平均约 12%),内存增加 20%–210%(仅展示快速合并模式以保证图表可读性)
-
On-the-fly mutation → 即时可见,通常比 ReplacingMergeTree + FINAL 快,但当内存中累积大量更新时性能会明显下降(此处未展示)
-
ReplacingMergeTree + FINAL → 查询最重,性能下降 21–550%(平均约 280%),内存消耗是基准的 20–200 倍,因为需要读取所有行版本
完整基准结果见此 →(https://github.com/ClickHouse/examples/tree/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/single-row-updates/results)
从结果看,差异非常明显。接下来,我们深入分析 ClickHouse 内部的执行机制。
深入解析:为什么结果会是这样
第 1 部分 和 第 2 部分 已介绍了经典 mutation、轻量级更新和 ReplacingMergeTree 等的底层实现。
本节会将这些方法进行并排对比,解释基准结果背后的原因,以及 ClickHouse 内部到底发生了什么。
为什么轻量级更新看起来更像插入操作
虽然名字不同,这些操作都是普通的 SQL UPDATE 语句(https://www.w3schools.com/sql/sql_update.asp),ClickHouse 只是通过写入补丁 part(patch parts)而非重写完整列来进行优化。
轻量级更新只写入补丁 part(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#how-patch-parts-work),不重写完整列。
查询在内存中叠加这些补丁(patch-on-read)(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#how-patch-on-read-work),因此应用小改动的速度几乎与插入新行一样快。
具体来说,轻量级更新写入的补丁 part 仅包含:
-
更新后的值
-
一小段行定位元数据(targeting metadata(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#patch-parts-at-scale-tracking-targeting-merging)):_part、_part_offset、_block_number、_block_offset、_data_version
这些元数据精确指向需要更新的行,因此 ClickHouse 可以避免扫描或重写无关数据。
这种更新的性能大致等同于一次 INSERT INTO … SELECT(https://clickhouse.com/docs/sql-reference/statements/insert-into#inserting-the-results-of-select),只写入变更的值和对应行的元数据。
-- Lightweight update statement:

UPDATE lineitem
SET l_discount = 0.045, l_tax = 0.11, ...
WHERE l_commitdate = '1996-02-01' AND l_quantity = 1;
≈
-- Roughly equivalent:

INSERT INTO patch
SELECT 0.045 as l_discount, 0.11 as l_tax, ...,
       _part, _part_offset, _block_number, _block_offset

FROM lineitem
WHERE l_commitdate = '1996-02-01' AND l_quantity = 1;
这正是轻量级更新能像小规模插入一样快的原因——它避免了扫描或重写无关数据。
由于其机制刻意基于 ClickHouse 高效的插入流程,你可以像插入数据一样频繁地执行轻量级更新。
什么时候适合使用轻量级更新(什么时候不适合)
轻量级更新主要针对频繁的小规模变更(不超过表总量的约 10%)。
当你希望更新几乎即时生效,并且在更新后最坏情况下(https://clickhouse.com/blog/updates-in-clickhouse-3-benchmarks#worst-case-post-update-query-time--bulk-updates)对查询性能几乎没有影响时,它是理想选择。
轻量级更新特别适合小范围且高频率的修正,例如一次只更新表中几个百分点的行。
但对于大规模更新,它会生成较大的补丁 part(patch parts),这些补丁:
-
在合并前必须在每次查询时加载到内存中(patch-on-read 机制),
-
在物化前会增加额外的 CPU 与内存开销,
-
最终会被合并到源数据 part 中。
在这种情况下,补丁物化前的查询速度可能明显下降。此时更好的做法是直接运行一次经典 mutation(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#stage-1-classic-mutations),一次性等待更新完成重写,然后后续查询都能恢复基准性能。
你可以把轻量级更新类比成便利贴——非常适合快速、精准的小改动。但如果要整面墙都重贴,新壁纸(mutation)会更快更干净。
我们用两张示意图来说明这种权衡关系。
图 1 – 更新延迟
图 1 展示了随着被修改行比例增加,更新延迟的变化趋势:
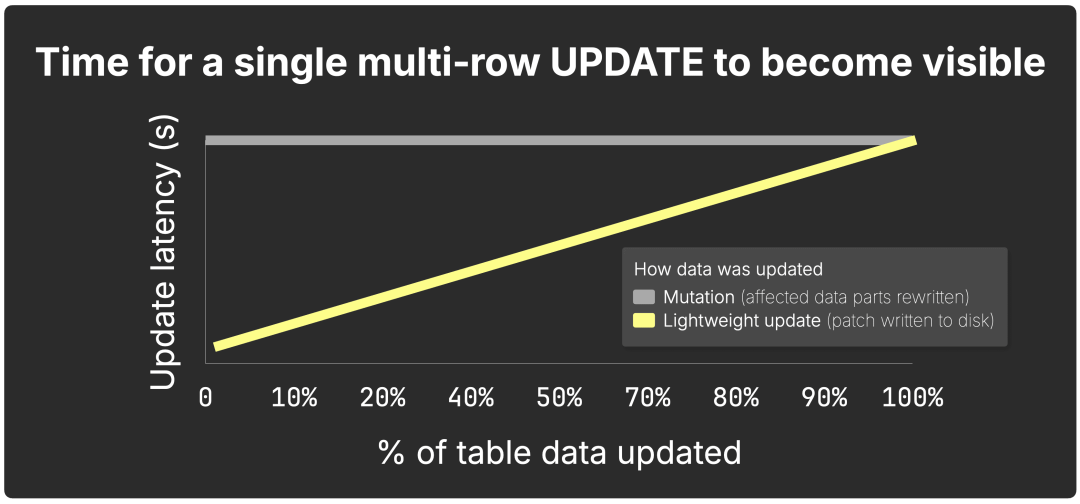
-
Mutation(灰线) 会重写所有受影响列,因此延迟保持恒定;
-
轻量级更新(黄线) 只写入补丁 part,对小改动最快,随着更新范围扩大,其延迟逐渐接近 mutation。
图 2 – 批量更新后的查询运行时间
图 2 估算了在一次批量更新尚未完全物化前,一个典型查询的变慢幅度:
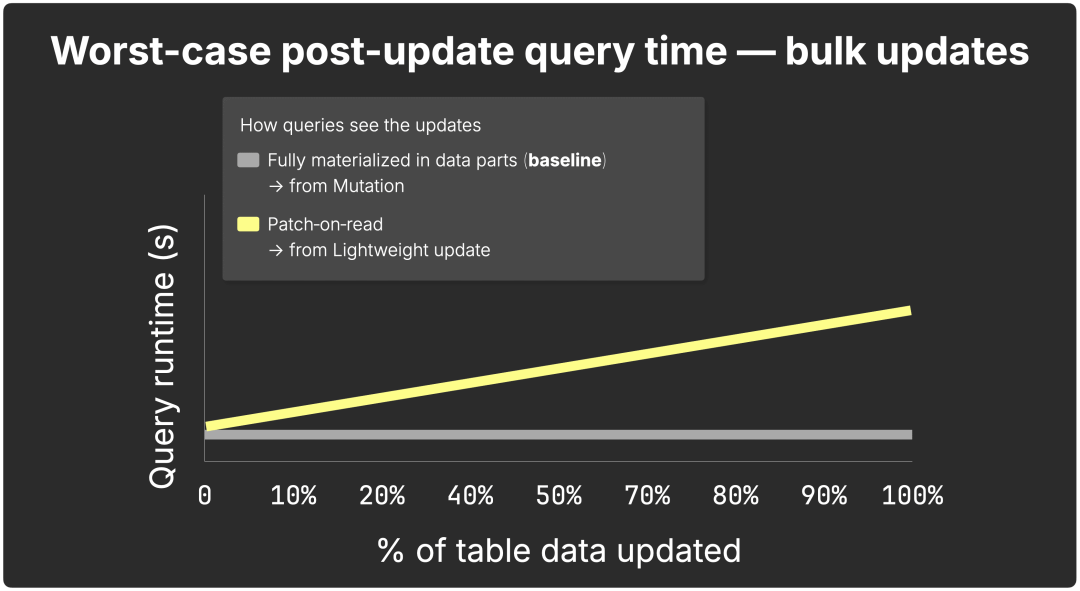
-
同步 mutation 会在查询运行前完成重写,因此耗时稳定;
-
patch-on-read 会在执行时叠加补丁,补丁越大,查询越慢。
结论:对于小规模且频繁的批量更新(最多约占表的 10%),轻量级更新是最佳选择——虽然 patch-on-read 会在补丁变大时增加延迟,但一旦后台合并完成,就能恢复基准性能。对于更大范围的更新,应优先选择经典(同步)mutation
读取时打补丁模式:快速路径与关联回退的对比
正如我们前文(https://clickhouse.com/blog/updates-in-clickhouse-3-benchmarks#worst-case-post-update-query-time--bulk-updates)所示,在数据集上,如果补丁 part 在快速合并模式(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#fast-source-part-matching-via-index)下通过 patch-on-read 应用(即原始源 part 仍然存在),查询减速在 8% 到 21% 之间,平均 15.3%。
第 2 部分解释过,在大多数情况下,补丁的源 part 会一直存在,直到下一次后台合并将其物化;如果合并前有查询访问,会直接通过 patch-on-read 在内存中应用。
极少数情况下,会出现无害的时间重叠:补丁是基于UPDATE 开始时源 part 的快照创建的,但如果这些 part 在补丁写入过程中被合并,那么补丁就会指向已不再活跃的源 part(在快速合并模式的 patch-on-read 中)。
当出现这种情况时,ClickHouse 会自动回退到 patch-on-read 的慢速 join 模式(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#patch-application-via-join-on-block-based-system-columns)。正如我们前文(https://clickhouse.com/blog/updates-in-clickhouse-3-benchmarks#worst-case-post-update-query-time--bulk-updates)所示,这种模式的开销更大:在基准测试中,查询耗时增加 39%–121%,平均 68%。该模式会在内存中将补丁与合并后的数据进行连接(join)。
测量方法 – 慢速 join 模式 patch-on-read
为明确测量这一场景,我们强制触发表的单个数据 part 自合并(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/run_updates_sequential.sh#L126),并关闭(https://github.com/ClickHouse/examples/blob/71456ae42e3bd75d23b41f5636fa7e593b941b16/blog-examples/clickhouse-fast-updates/multi-row-updates/run_updates_sequential.sh#L121)了 apply_patches_on_merge(https://clickhouse.com/docs/operations/settings/merge-tree-settings#apply_patches_on_merge) 设置。这样,合并会用新名称重写该 part,使补丁的源索引(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#patch-part-indexes)失效,并在查询时触发慢速 join 模式。
为什么 ReplacingMergeTree 的插入操作在原始速度上表现优异
ReplacingMergeTree 将更新视为插入新行(https://clickhouse.com/blog/updates-in-clickhouse-1-purpose-built-engines#replacingmergetree-replace-rows-by-inserting-new-ones),只将新行写入磁盘:
-
无需查找旧行,因此在实际应用中通常是最快的更新方式;
-
在基准测试中,更新耗时通常为 0.03–0.04 秒,比经典 mutation 快 4,700 倍。
轻量级更新的速度几乎一样快
对于单行精确 UPDATE,轻量级更新会向磁盘写入一个极小的补丁 part(patch part),通常只有几十个字节:
-
首先,ClickHouse 会在原始 part 中定位待更新的行,生成其行定位元数据(targeting metadata):_part、_part_offset、_block_number、_block_offset、_data_version;
-
然后,只写入更新后的值和这段小型元数据补丁。
由于多了一步定位操作,轻量级更新比 ReplacingMergeTree 插入稍慢,但在查询阶段效率更高,因为 patch-on-read 能精确知道要覆盖哪些行。
我们将在下一节将这种行为与 ReplacingMergeTree 的执行机制进行对比。
为什么 FINAL 比读取时打补丁模式更慢
FINAL(https://clickhouse.com/blog/updates-in-clickhouse-1-purpose-built-engines#getting-up-to-date-results-with-final) 查询必须查找最新行;而 patch-on-read(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#how-patch-on-read-works) 查询已知这些行的具体位置。
两张图快速展示两者差异
图 1 – FINAL: ClickHouse 无法直接判断哪个 part 拥有最新行,因此需要先加载相关 part,在内存中即时合并(https://clickhouse.com/docs/merges#replacing-merges),并在查询引擎(https://clickhouse.com/docs/optimize/query-parallelism)继续处理数据前,仅保留每个排序键下最新的行。
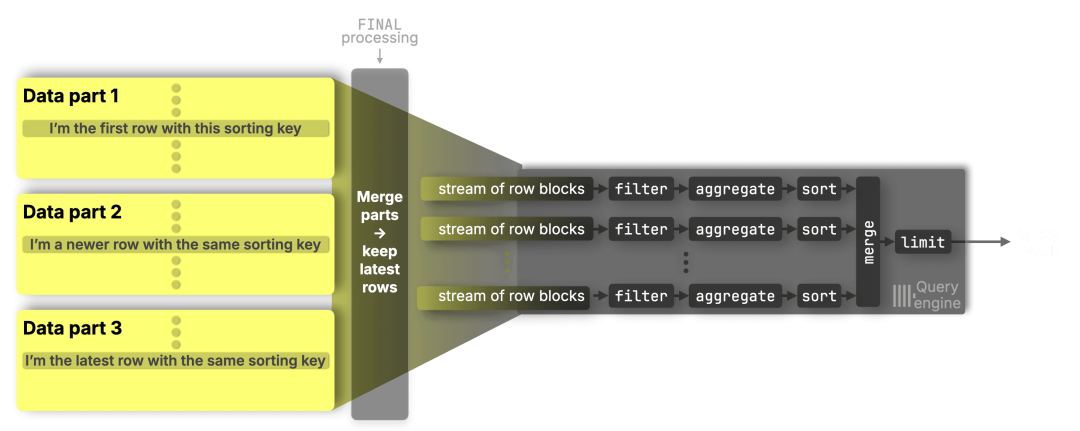
近年来,FINAL 合并过程已得到大量优化(https://clickhouse.com/blog/clickhouse-release-23-12#optimizations-for-final),并有最佳实践(https://clickhouse.com/docs/guides/replacing-merge-tree#exploiting-partitions-with-replacingmergetree)可降低合并的工作量。
图 2 – patch-on-read: 补丁 part 会准确告诉 ClickHouse 哪些行被修改,因此只需在内存中直接覆盖(https://clickhouse.com/blog/updates-in-clickhouse-2-sql-style-updates#how-patch-on-read-works)这些行,而无需进行大范围合并。
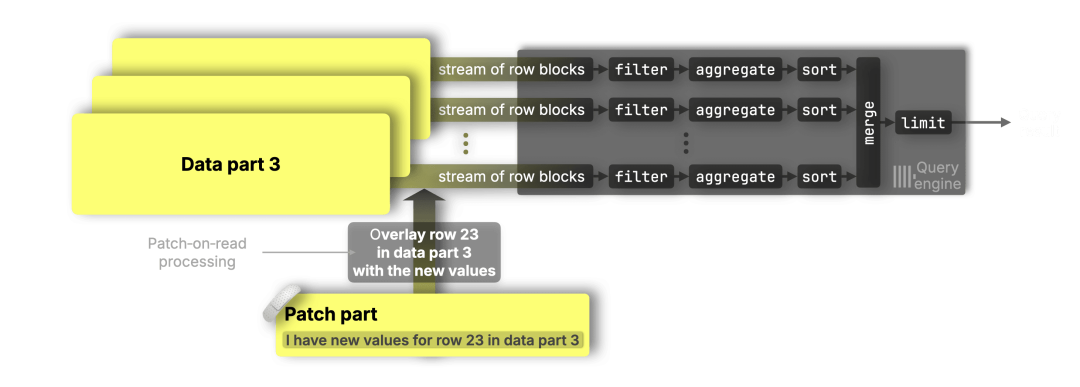
补丁 part(patch parts)通过 _part、_part_offset、_block_number 和 _block_offset 精确定位目标行,实现了真正“外科手术”式的精确覆盖。
快速总结表
| FINAL(ReplacingMergeTree) | Patch-on-read(轻量级更新) |
| 无法判断哪些 part 含有最新行版本。 | 精确知道哪些行被更新以及所在位置(补丁 part)。 |
| 必须合并所有候选范围,并按排序键和插入时间解析最新版本。 | 补丁 part 直接引用其目标行(_part、_part_offset、_block_number、_block_offset)。 |
| 行版本解析是大范围、探索式的,计算量大。 | 合并是精准且针对性的,只叠加已知的目标行。 |
| 过去相比普通读取慢很多;虽然已大幅优化,但仍重于 patch-on-read。 | 高效、轻量且性能可预测。 |
在弄清楚原理之后,下面是一个快速对比回顾,用来串联整个内容。
UPDATE 方法总览
在机制已经解释清楚后,这里做一个简明的对比回顾:
-
经典 mutation(Classic mutations) — 最慢路径;更新需先重写整列数据,查询才能看到结果。
-
On-the-fly mutation(即时变更) — 结果即时可见;更新存于内存中,但可能拖慢查询。
-
ReplacingMergeTree + FINAL — 写入速度快,但查询需执行 FINAL,代价较高。
-
轻量级更新(Lightweight updates) — 速度接近 INSERT,同时保持查询开销低。
速查表: 各种更新方式的最佳适用场景与代价
| 方法 | 最适用场景 | 极端情况下的查询影响 | 注意事项 |
| Mutation | 大批量且低频更新 | 基准性能 | 更新耗时长 |
| On-the-fly mutation | 需要即时可见的大规模临时更新 | ↑ 12–427% | 后台仍需重写分区;堆积过多更新会拖慢查询 |
| ReplacingMT + FINAL | 高频单行更新 | ↑ 21–550% | 查询需显式使用 FINAL |
| Lightweight update(补丁 part) | 高频小规模更新(≤ 表的 10%) | ↑ 7–21% | 如果源 part 已合并,将触发慢速 join 模式 |
通过上述机制与结果对比,可以看出不同更新方式在真实业务中的最佳应用场景与取舍。
ClickHouse 更新速度提升 1,000 倍:关键总结
ClickHouse 现已支持标准 SQL UPDATE,通过使用补丁分区(patch parts)的轻量级更新实现,这一方案最终填补了列式存储在更新性能上的长期空白。
在我们的基准测试中:
-
批量 SQL UPDATE 比经典 mutation 快 1,700 倍
-
单行 SQL UPDATE 比经典 mutation 快 2,400 倍
-
即使在最坏情况下,查询开销也依然很低
这意味着:
-
可以直接用熟悉的 SQL 语法进行高频小规模更新(high-frequency small updates),而不会显著拖慢查询
-
变更可即时可见,满足实时和流式场景的需求
-
能构建可扩展的更新管道,无缝结合批处理与交互式更新
如今,ClickHouse 能够胜任此前通常需要行存储才能支持的更新模式,同时依旧保持其在分析型工作负载中的强项。
所有基准测试脚本和查询可在 GitHub 获取(https://github.com/ClickHouse/examples/tree/main/blog-examples/clickhouse-fast-updates)。
至此,我们的 ClickHouse 列存储快速 UPDATE 三部曲到此结束。
如果错过了前两篇,可以查看 Part 1: Purpose-built engines 和 Part 2: SQL-style UPDATEs。
征稿启示
面向社区长期正文,文章内容包括但不限于关于 ClickHouse 的技术研究、项目实践和创新做法等。建议行文风格干货输出&图文并茂。质量合格的文章将会发布在本公众号,优秀者也有机会推荐到 ClickHouse 官网。请将文章稿件的 WORD 版本发邮件至:Tracy.Wang@clickhouse.com

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 8
 0
- 0


 已为社区贡献11条内容

所有评论(0)