大数据概念及生态系统架构基础知识
大数据:
| 大 数 据 | 概念 | 在一定时间范围内不能以常规软件工具处理(存储和计算)的大而复杂的数据集 | ||
| 特性 | 数据量大、高速接收和处理数据、数据类型多样化、数据真实性、数据价值 | |||
| 大数据的存储系统通常采用分布式存储架构,以解决数据量庞大所带来的存储挑战 | ||||
| 处 理 工 具 | hadoop | 分布式处理架构;Hadoop通过分布式计算和存储解决了大规模数据处理问题,标志着大数据技术的成熟;Hadoop通常是指一个更广泛的概念——Hadoop生态圈。 | ||
| HDFS (Hadoop Distributed File System) | HDFS是Hadoop生态系统中的分布式文件系统。它将数据分割成多个块并分布存储在集群中的不同节点上,提供高容错性和高吞吐量的数据访问。高容错性、高伸缩性、高效性等优点。是一个用于存储文件的文件系统。解决海量数据存储的问题,最大的缺点是不支持单条数据的修改操作,不是数据库。 | |||
| MapReduce | Hadoop最经典的计算模型,通过将任务分解成多个Map任务和Reduce任务,在集群中并行执行。MapReduce适用于批处理任务,但在实时处理能力上存在局限。一种编程模型用于大规模数据集的并行运算。 | |||
| spark | Spark是一个快速、通用的大数据处理框架,相较于MapReduce,Spark提供了更高效的内存计算能力,支持批处理、实时流处理和机器学习等任务。通用计算引擎。 | |||
| HIVE | Hive是建立在Hadoop之上的数据仓库,在某种程度上看成是用户编程接口,本身并不存储和处理数据,依赖于HDFS存储数据,依赖MR处理数据。 | |||
| Hbase (Hadoop Database) | 分布式的、面向列的开源数据库;适合于存储大表数据并且对大表数据的读写访问可以达到实时级别;利用HDFS作为其文件存储系统,提供实时读写的分布式数据库系统。高可靠性、高性能、面向列、可伸缩的分布式存储系统。 | MySQL、Oracle数据库按行存储。行存储是数据按行的方式存储在底层文件中,通常每一行会自动的分配一个固定的空间。 | ||
| Hbase是按列进行存储的,对于没有的信息可以为空并且不占用空间。数据以列为单位,列按照文件夹方式存储。 | ||||
| Flink | Flink是一个分布式流处理框架,适用于实时数据流的处理。与Spark相比,Flink具有更低的延迟和更高的吞吐量,广泛用于流数据处理场景。 | |||
大数据生态系统架构基础知识:
大数据生态系统组件构成:数据生成工具、数据收集平台、数据处理框架、数据分析工具。
大数据处理流程:数据采集、数据清洗、数据转换、数据分析和数据存储等。
构建分布式存储系统的关键技术:数据的分布式存储、冗余存储、容错容灾以及扩展性。
分布式存储系统的层次:硬件层、数据管理层和服务层。
分布式文件系统需要解决数据分布的一致性、可用性和分区容忍性的问题。
数据质量控制措施:数据清洗、数据校验、数据监控。以确保数据的准确性、可靠性、完整性和一致性。
参考:https://blog.csdn.net/weixin_35749796/article/details/150348412
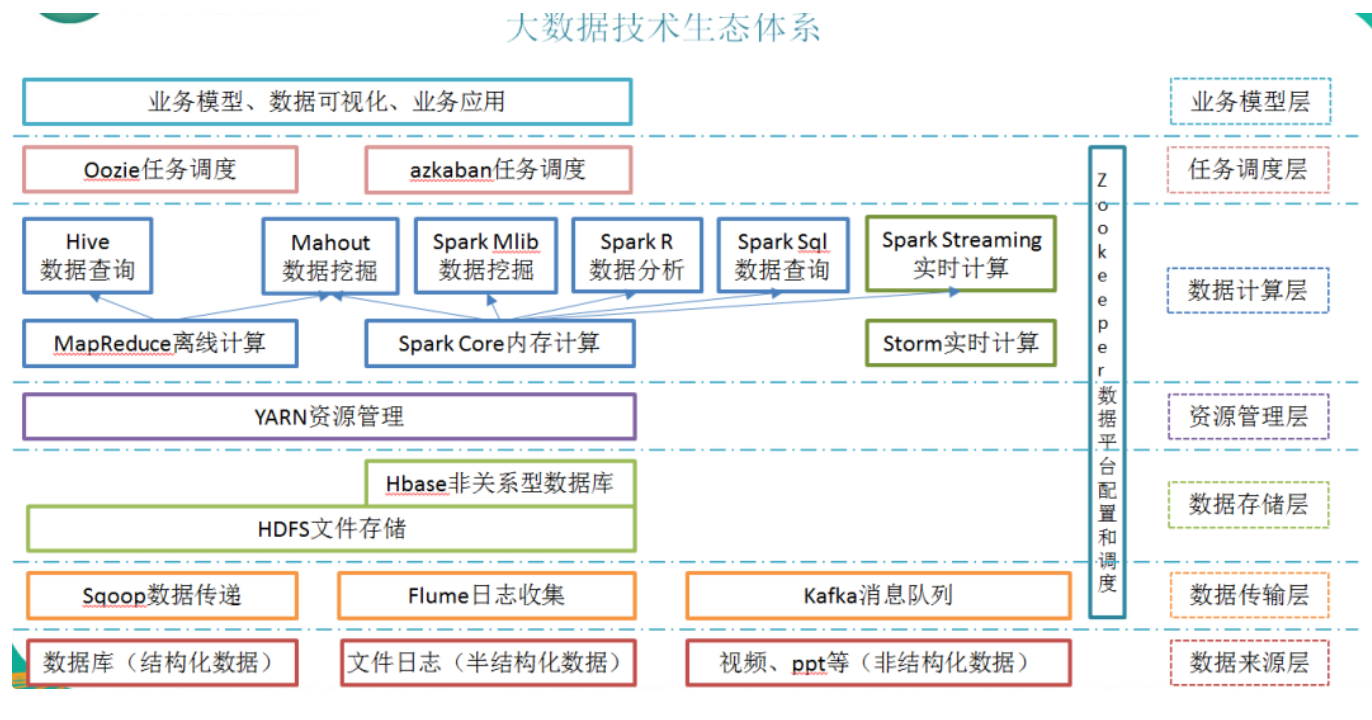
参考:https://cloud.tencent.com/developer/article/2313111
大数据生态圈的核心技术:
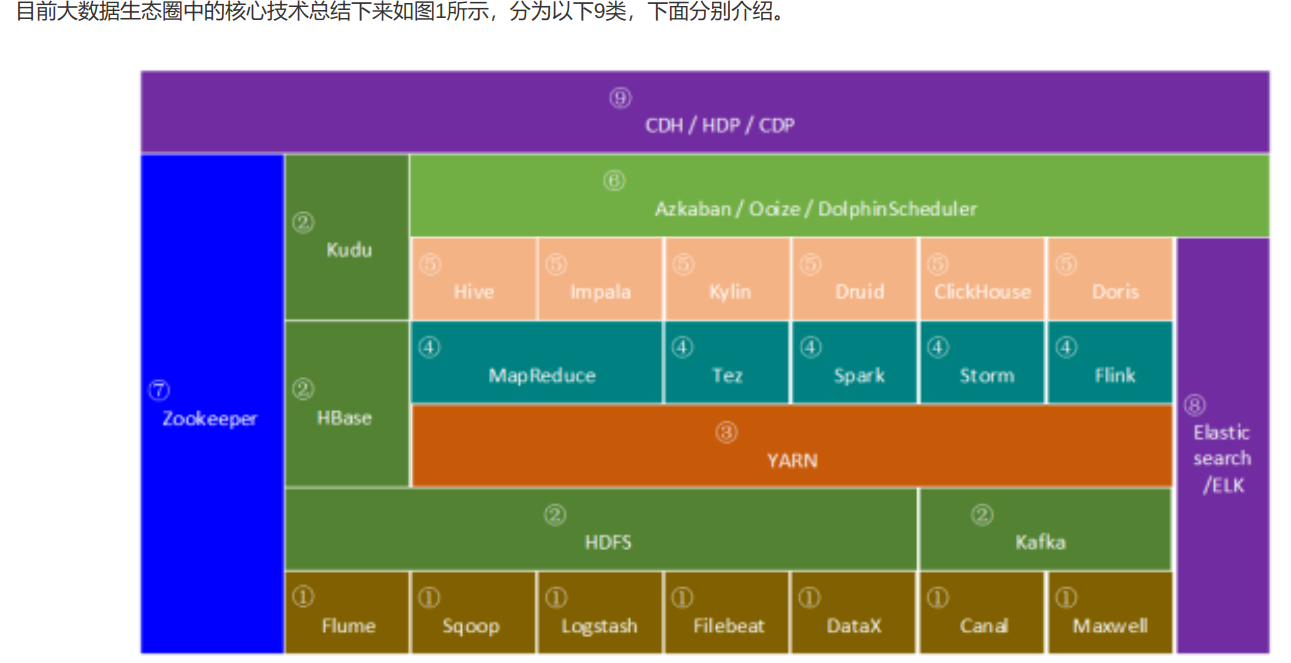

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 3
 0
- 0


 已为社区贡献2条内容

所有评论(0)