主机windows虚拟机centos的hadoop调试mapreduce访问hdfs文件
现在的场景是:
🖥️ 主机(Windows)装了 IDEA
🖧 VMware 里跑着一个 CentOS 虚拟机,虚拟机里部署了 Hadoop 集群
💡 目标:在主机的 IDEA 中调试运行 MapReduce 程序,让它访问虚拟机里的 Hadoop 文件(HDFS)
🧠 核心思路
主机上的 IDEA 只是写代码、打 jar 包,实际运行时通过 网络访问虚拟机里的 Hadoop 服务。
要做到这一点,只要 保证主机可以访问虚拟机的 Hadoop 集群(namenode、datanode),并且在代码中指定正确的 HDFS 地址即可。
🧩 一、配置 VMware 网络
-
打开 VMware → 选择你的 CentOS 虚拟机 → 设置 → 网络适配器
-
把网络模式改成:
-
桥接(Bridged)模式:虚拟机和主机处于同一网段(推荐)
-
或者 NAT 模式:虚拟机通过主机上网,也行,但主机访问虚拟机需要设置端口转发
-
-
启动 CentOS 虚拟机,执行命令获取虚拟机 IP:
ip addr show记住它的 IP(如
192.168.1.120) -
在主机命令行测试能不能 ping 通虚拟机:
ping 192.168.176.130
⚙️ 二、确认 Hadoop 服务可远程访问
在虚拟机 CentOS 里,启动 Hadoop:
start-dfs.sh
start-yarn.sh
查看 namenode 地址:
hdfs getconf -confKey fs.defaultFS

一般会返回:
hdfs://localhost:9000
你需要把它改成虚拟机的实际 IP,例如:
<!-- /opt/hadoop/etc/hadoop/core-site.xml -->
<configuration>
  <property>
    <name>fs.defaultFS</name>
    <value>hdfs://192.168.176.130:9000</value>
  </property>
</configuration>
即使使用将192.168.176.130改为localhost也能访问192.168.176.130的ip的webui页面。
<!-- /opt/hadoop/etc/hadoop/core-site.xml -->
<configuration>
  <property>
    <name>fs.defaultFS</name>
    <value>hdfs://localhost:9000</value>
  </property>
</configuration>
然后重启 Hadoop:
stop-dfs.sh
start-dfs.sh
现在你主机浏览器打开:
http://192.168.176.130:9870/
如果还是访问不了,就是虚拟机centos操作系统的防火墙没有允许端口开放。
sudo firewall-cmd --add-port=9864/tcp --permanent
sudo firewall-cmd --reload
sudo firewall-cmd --list-ports
列出所有防火墙允许的端口:
sudo firewall-cmd --list-ports
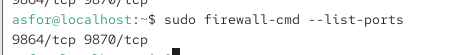
添加允许的端口:
sudo firewall-cmd --add-port=9864/tcp --permanent
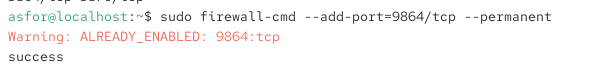
其中的warning表示已经开放端口了。
只有运行接下来的命令才开始生效。
sudo firewall-cmd --reload
还有第二种方法:
直接关闭防火墙:
测试前可以临时关闭防火墙:
sudo systemctl stop firewalld
启动防火墙:
sudo systemctl start firewalld
应该能看到 Hadoop Web 界面,说明主机已经能访问虚拟机里的 Hadoop。
📝 三、主机 IDEA 访问虚拟机 Hadoop
-
主机 IDEA 创建 Java / Maven 项目
-
添加 Hadoop 依赖(参考我上条信息的做法)
-
在代码中这样写:
Configuration conf = new Configuration();
conf.set("fs.defaultFS", "hdfs://192.168.1.120:9000"); // 虚拟机 Hadoop IP
conf.set("mapreduce.framework.name", "yarn");
conf.set("yarn.resourcemanager.address", "192.168.1.120:8032");
conf.set("mapreduce.jobhistory.address", "192.168.1.120:10020");
-
运行参数:
/user/asfor/input /user/asfor/output
-
运行时 VM options(可选):
-DHADOOP_USER_NAME=asfor
📁 四、调试时访问虚拟机的 HDFS 文件
虚拟机中准备输入文件:
hdfs dfs -mkdir -p /user/asfor/input
hdfs dfs -put /test/hadoopput/text.txt /user/asfor/input
主机上运行 MapReduce 时,它会自动通过网络访问虚拟机中的 /user/asfor/input 和 /user/asfor/output。
📌 五、整体流程图
+-----------------------+        网络访问        +-------------------------+
|     主机 Windows      | <--------------------> |  VMware 中的 CentOS     |
|  IDEA 写代码+调试     |                       |  Hadoop (namenode等)     |
+-----------------------+                       +-------------------------+
          |                                                   ↑
          | Hadoop 配置中写虚拟机 IP                          |
          └──────────────────────────────────────────────────┘
⚡ 六、常见问题排查
| 问题 | 原因 | 解决 |
|---|---|---|
访问 HDFS 报 Connection refused | 虚拟机 IP 写成了 localhost | 改成 192.168.x.x |
| ping 不通虚拟机 | 网络模式不对 | 用桥接模式 |
| 主机无法访问 Hadoop Web | Hadoop 没启动 | start-dfs.sh、start-yarn.sh |
| 权限不足 | 没指定 Hadoop 用户 | -DHADOOP_USER_NAME=asfor |
📝 示例代码:写入 HDFS 文件
java代码如下:
package org.example;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FSDataOutputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;

import java.io.OutputStreamWriter;
import java.io.BufferedWriter;

public class HDFSWriteFile {
    public static void main(String[] args) throws Exception {
        // 1. 创建 Hadoop 配置
        Configuration conf = new Configuration();
        conf.set("fs.defaultFS", "hdfs://192.168.176.130:9000");  // 这里写你的 NameNode 地址
        conf.set("dfs.client.use.datanode.hostname", "true");

        // 2. 获取 HDFS 文件系统对象
        FileSystem fs = FileSystem.get(conf);

        // 3. 定义 HDFS 路径
        Path path = new Path("/user/asfor/hello.txt");

        // 4. 如果文件已存在,先删除(可选)
        if (fs.exists(path)) {
            fs.delete(path, true);
        }

        // 5. 创建文件并写入数据
        FSDataOutputStream out = fs.create(path);
        BufferedWriter writer = new BufferedWriter(new OutputStreamWriter(out, "UTF-8"));
        writer.write("你好,HDFS!\n");
        writer.write("这是一段写入 HDFS 的测试内容。\n");
        writer.close();

        // 6. 关闭文件系统
        fs.close();

        System.out.println("文件已写入到 HDFS: " + path);
    }
}

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 14
 0
- 0


 已为社区贡献5条内容

所有评论(0)