Flink核心知识体系与项目实践
引言
Apache Flink已成为实时计算领域的核心引擎,本文基于项目的实战经验,深度剖析Flink的架构设计、状态管理、精确一次语义等核心技术,并分享千万级实时计算体系的业务场景。
一、Flink架构与核心概念
1.1 流批一体架构
- 运行时统一:Flink采用同一套运行时同时支持流处理和批处理,通过DataSet API(批)和DataStream API(流)提供统一编程模型
- 有界/无界数据:批处理作为流处理的特例(有界流),底层通过检查点机制保证一致性
- 执行模式:
- STREAMING模式(持续处理无界数据)
- BATCH模式(优化有界数据处理)
- AUTOMATIC模式(自动判断)
1.2 核心组件
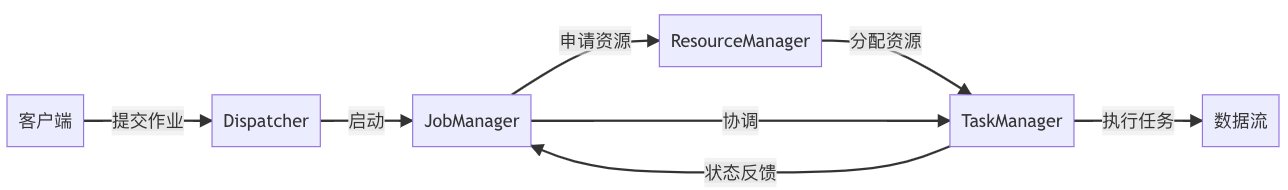
- JobManager:协调中心,负责调度、故障恢复、检查点触发
- TaskManager:执行单元,包含Task Slot资源隔离容器
- ResourceManager:资源管理(YARN/K8s/Mesos集成)
- Dispatcher:REST接口服务,提交作业入口
1.3 编程模型四要素
- 数据源(Source):Kafka/Socket/File等
- 转换操作(Transformation):map/filter/keyBy/window等
- 数据汇(Sink):Kafka/JDBC/Redis等
- 执行环境(ExecutionEnvironment):本地/集群环境配置
核心转换算子
| 类型 | 功能 | 典型应用场景 |
| map | 元素级转换 | 字段提取/格式转换 |
| filter | 条件过滤 | 数据清洗/去重 |
| keyBy | 按键分组 | 聚合/窗口计算 |
| window | 时间/计数窗口 | 实时统计/滑动分析 |
| join | 流式连接 | 多流关联/事件匹配 |
二、状态管理与容错机制
2.1 状态类型
- Keyed State:与Key绑定的状态,包括:
- ValueState<T>:单值状态
- ListState<T>:列表状态
- MapState<UK,UV>:映射状态
- ReducingState<T>:聚合状态
- AggregatingState<IN,OUT>:高级聚合状态
- Operator State:算子级别状态,包括:
- ListState<T>:均匀分割
- UnionListState<T>:全量广播
状态使用场景对比
| 特性 | Keyed State | Operator State |
| 作用范围 | 每个键独立 | 整个算子实例共享 |
| 并行度影响 | 随key分布 | 需显式处理 |
| 典型应用 | 键相关计算 | 全局配置/元数据 |
| 恢复机制 | 自动按key恢复 | 需自定义分配策略 |
| 性能 | 高(并行处理) | 相对较低 |
2.2 状态后端(State Backend)
概述:状态后端决定了Flink如何存储和管理应用程序的状态数据,主要包括:
- 状态数据的存储方式
- 状态访问的性能特性
- 状态持久化的可靠性
主要状态后端类型:
- HashMapStateBackend(内存状态后端)
- EmbeddedRocksDBStateBackend(RocksDB状态后端)
状态后端对比
| 特性 | HashMapStateBackend | EmbeddedRocksDBStateBackend |
| 存储位置 | JVM堆内存 | 本地磁盘(RocksDB) |
| 状态大小限制 | 受JVM堆限制 | 仅受磁盘限制 |
| 吞吐量 | 高 | 中等 |
| 延迟 | 低 | 中等 |
| 可靠性 | 一般 | 高 |
| 适用场景 | 开发测试 | 生产环境 |
2.3 Checkpoint机制
核心概念
Checkpoint是Flink实现容错机制的核心技术,它通过定期快照的方式记录应用程序的精确状态,确保在发生故障时能够从最近的一致状态恢复。
关键特性
- 一致性保证:提供exactly-once语义
- 异步执行:不影响正常数据处理
- 自动触发:可配置周期自动执行
- 状态存储:支持多种状态后端(RocksDB/FS等)
工作原理

核心组件
- Checkpoint Coordinator:协调检查点过程
- Barrier:流中的特殊标记,标识检查点边界
- State Backend:存储状态快照的组件
- Checkpoint Storage:存储检查点元数据
2.4 Savepoint与恢复
- 与Checkpoint区别:
| 特性 | Checkpoint | Savepoint |
| 主要目的 | 故障恢复 | 计划维护/版本升级 |
| 触发方式 | 自动周期性触发 | 手动触发 |
| 存储格式 | 二进制格式 | 标准化(HDFS/S3等) |
| 保留策略 | 自动清理(可配置) | 长期保存 |
| 使用场景 | 系统自动容错 | 人工干预场景 |
| 生命周期 | 短期有效 | 长期有效 |
- 操作命令:
# 触发Savepoint
flink savepoint <jobId> [targetDirectory]
# 从Savepoint恢复
flink run -s :savepointPath [:runArgs]
三、Exactly-Once语义实现
Exactly-Once语义是Flink提供的最高级别数据处理保证,确保每条数据被精确处理一次,即使在故障恢复时也不会重复或丢失。
3.1核心实现技术
实现架构:

3.1.1 分布式快照(Checkpoint)
- Barrier机制:在数据流中插入特殊标记
- 状态一致性:所有算子对齐Barrier后做快照
- 异步持久化:不影响正常数据处理性能
3.2.2 两阶段提交协议(2PC)
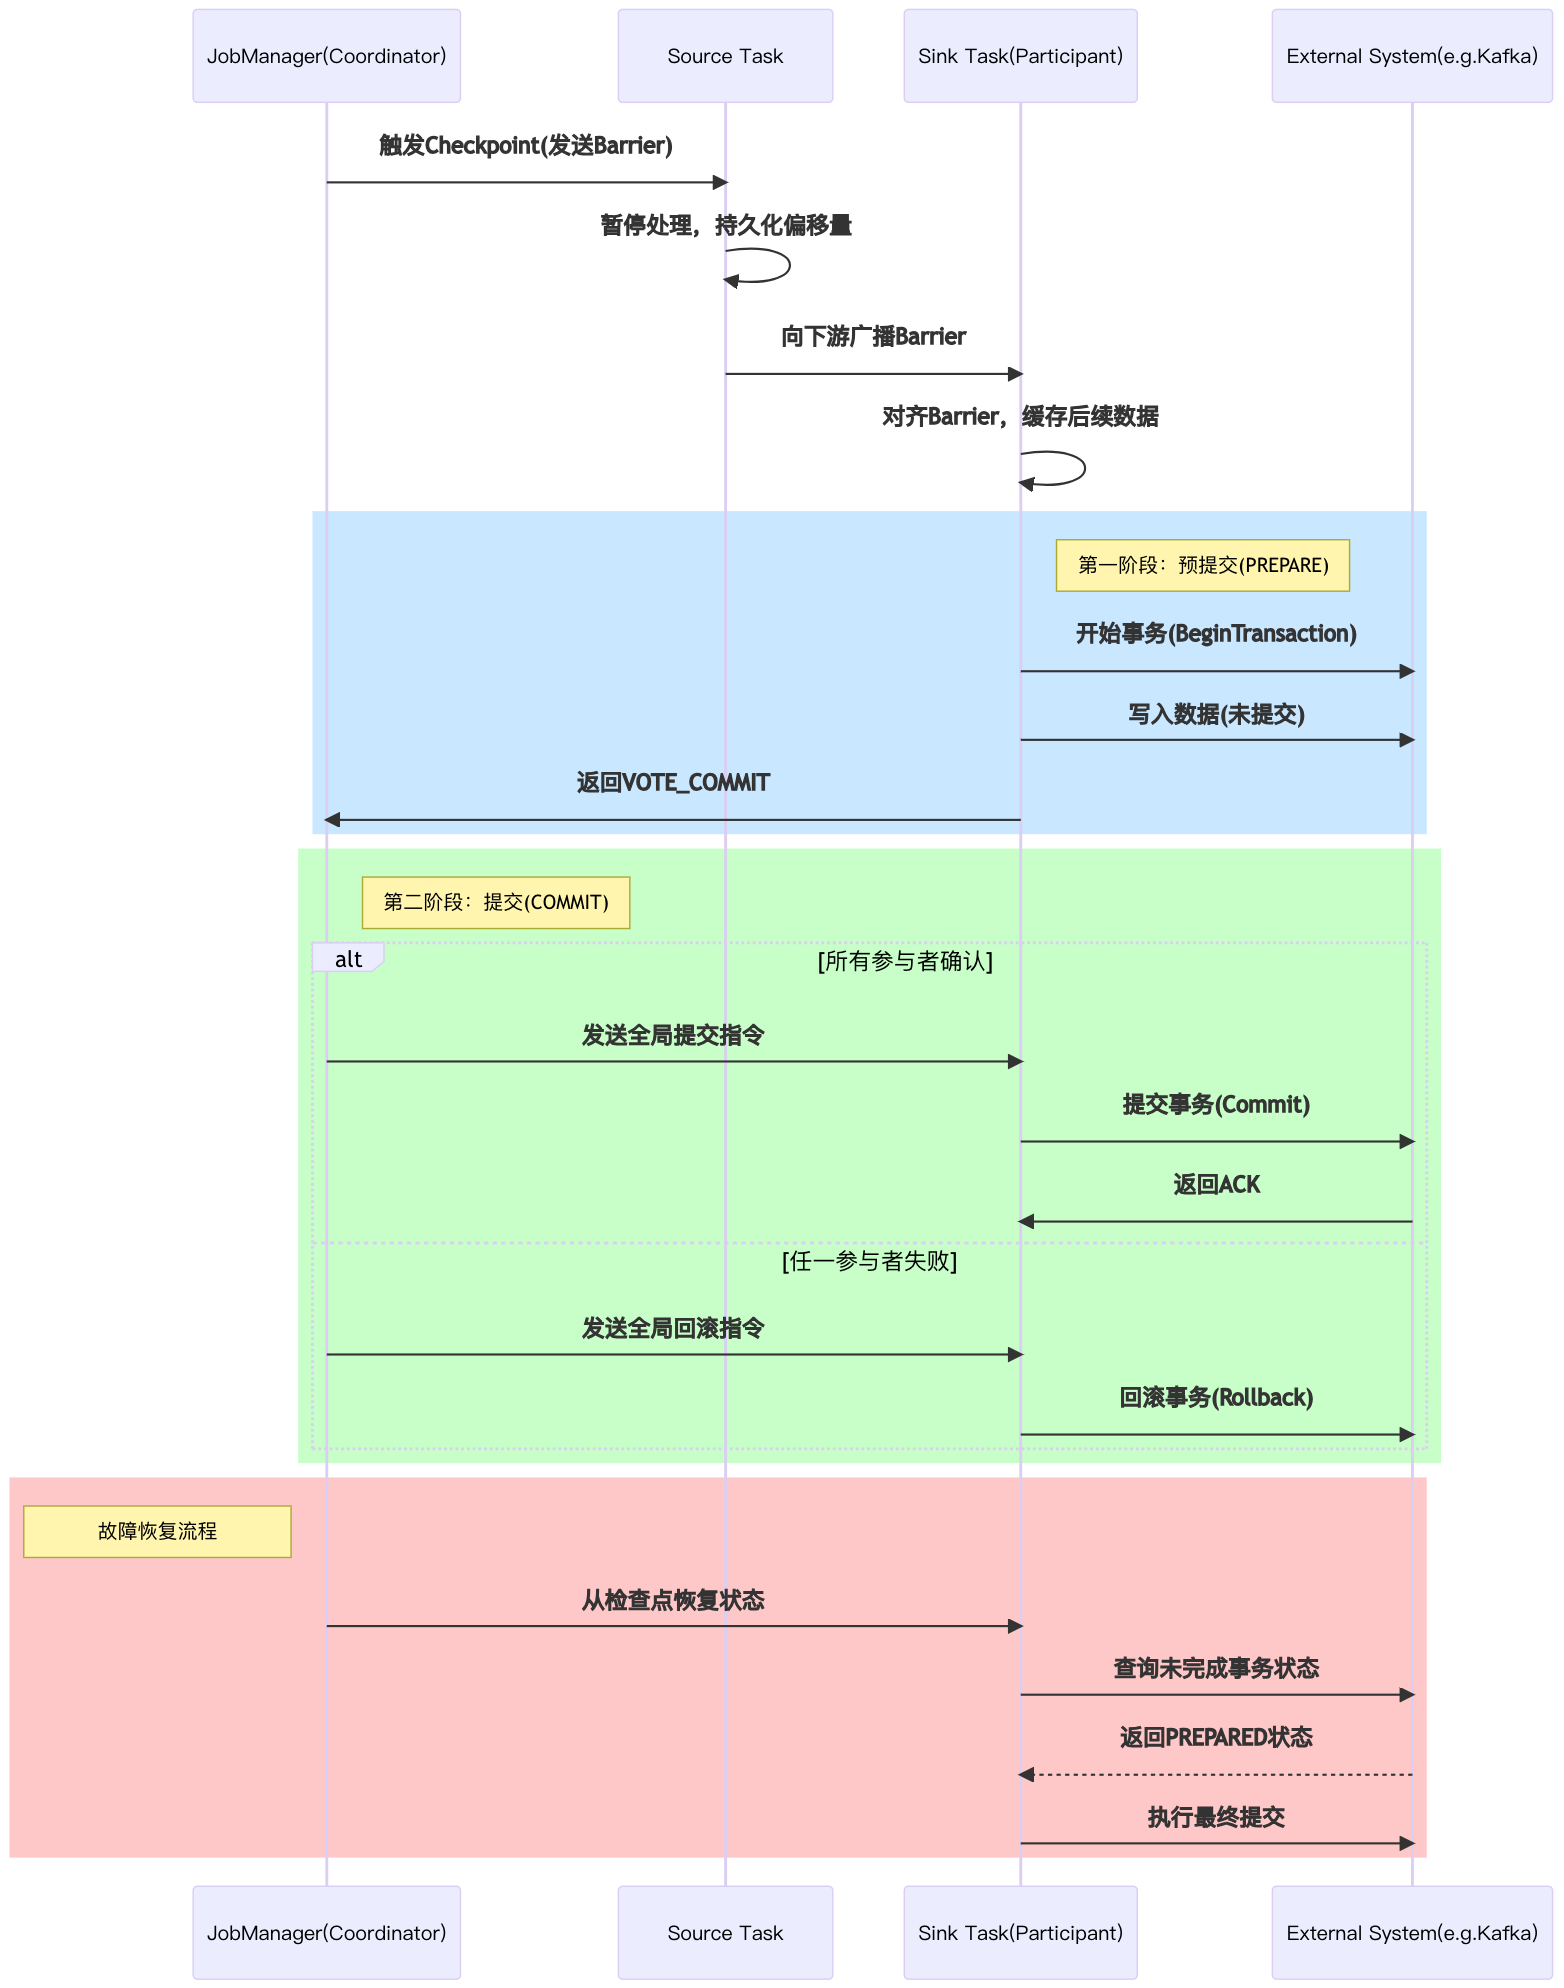
说明:External System(e.g.Kafka) - 外部系统(如Kafka)
- 预提交阶段:
- JobManager发起检查点请求
- 所有算子完成状态快照
- Sink准备外部系统事务
2. 提交阶段:
- 所有节点确认快照完成
- Sink提交外部系统事务
- 检查点标记为完成
3.2 端到端实现
3.2.1 Source端保证
- 可重放数据源(支持数据重置读取位置的外部系统):Kafka/RabbitMQ等
- 偏移量保存:与状态一起保存到检查点
3.2.2 处理过程保证
- 算子状态一致性:通过检查点保证
- 精确一次计算:基于确定性状态恢复
3.2.3 Sink端保证
| Sink类型 | 实现方式 |
| 幂等写入 | 依赖外部系统幂等性 |
| 事务写入 | 两阶段提交协议 |
| WAL写入 | 预写日志+重试 |
四、时间语义与窗口计算
4.1 时间类型
| 时间类型 | 定义 | 来源 | 特点 | 典型应用场景 |
| 事件时间(Event Time) | 数据产生时的时间戳 | 数据本身携带的时间字段 | 反映真实事件发生时间,处理乱序数据 | 需要精确时间分析的场景,如金融交易、用户行为分析 |
| 处理时间(Processing Time) | 数据被Flink处理时的时间 | 系统时钟 | 简单易用,但受系统时间影响 | 对时间精度要求不高的实时统计 |
| 摄入时间(Ingestion Time) | 数据进入Flink系统的时间 | Source函数记录 | 介于事件时间和处理时间之间 | 需要记录数据进入时间的场景 |
4.2 水位线(Watermark)
核心概念:它本质上是一个特殊的时间戳,表示"在某个时间点之前的所有事件都已到达"。
4.2.1 作用
- 处理乱序事件的机制
- 定义事件时间的进度
- 触发窗口计算
4.2.2 生成策略
- 内置生成器
- 有序流生成器:适用于数据基本有序的场景
- 乱序流生成器:适用于数据乱序场景,可设置最大延迟时间
- 自定义生成器
- 周期性生成:定期生成水位线
- 事件驱动生成:基于特定事件生成水位线
4.3 窗口类型
| 窗口类型 | 说明 | 适用场景 |
| 滚动窗口(Tumbling Window) | 固定大小,不重叠 | 固定时间间隔统计 |
| 滑动窗口(Sliding Window) | 固定大小,可重叠 | 需要重叠统计的场景 |
| 会话窗口(Session Window) | 动态大小,基于活动间隔 | 用户行为分析 |
| 全局窗口(Global Window) | 无边界 | 需要手动触发计算 |
五、项目实战案例解析
5.1 实时ETL管道实现
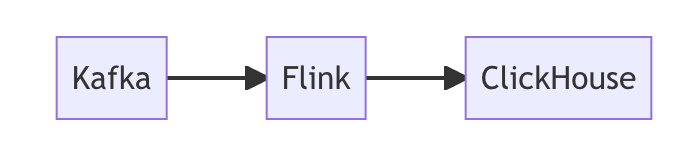
- 技术要点:
- 使用KafkaSource消费JSON格式订单数据
- 通过JSONKeyValueDeserializationSchema反序列化
- 关联维度表(商品/用户信息)使用Async I/O
- 窗口聚合后通过JDBC Sink写入ClickHouse
5.2 异常检测模块实现
5.2.1 业务价值
- 实时业务监控:对佣金结算、广告投放等关键指标进行毫秒级监控,发现异常波动立即告警。
- 风险预警:通过阈值检测机制,提前识别刷单、恶意点击等欺诈行为
- 数据质量保障:捕捉数据管道中的脏数据(如负值佣金、空值订单ID)
5.2.2功能的java实现示例
检测设备指标超过阈值且持续时间超过容忍窗口的异常情况
/**
 * 实时异常检测处理器(KeyedProcessFunction实现)
 * 功能:检测设备指标超过阈值且持续时间超过容忍窗口的异常情况
 * @param <String> 设备ID作为Key
 * @param <MetricEvent> 输入事件(包含设备指标值)
 * @param <AlertEvent> 输出告警事件
 */
public class AbnormalDetectionProcess
    extends KeyedProcessFunction<String, MetricEvent, AlertEvent> {

    // 状态声明:记录设备最后一次正常指标的时间戳
    private ValueState<Long> lastNormalTimeState;

    // 业务配置参数(实际项目通过Configuration动态注入)
    private final long threshold;  // 指标阈值
    private final long timeout;    // 容忍持续时间(ms)

    public AbnormalDetectionProcess(long threshold, long timeout) {
        this.threshold = threshold;
        this.timeout = timeout;
    }

    /**
     * 初始化状态(每个KeyedProcessFunction实例调用一次)
     */
    @Override
    public void open(Configuration parameters) {
        // 定义状态描述符(名称+类型)
        ValueStateDescriptor<Long> descriptor =
            new ValueStateDescriptor<>(
                "lastNormalTime",  // 状态名称
                Long.class         // 状态类型
            );

        // 配置状态TTL(生产环境建议添加)
        StateTtlConfig ttlConfig = StateTtlConfig
            .newBuilder(Time.days(1))
            .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)
            .build();
        descriptor.enableTimeToLive(ttlConfig);

        // 获取状态引用
        lastNormalTimeState = getRuntimeContext().getState(descriptor);
    }

    /**
     * 核心处理逻辑(每条输入事件触发调用)
     * @param event 输入指标事件
     * @param ctx 上下文(可访问时间戳、定时器等)
     * @param out 输出收集器
     */
    @Override
    public void processElement(
        MetricEvent event,
        Context ctx,
        Collector<AlertEvent> out
    ) throws Exception {

        long currentTime = ctx.timestamp(); // 获取事件时间

        // 1. 阈值检测:判断当前指标是否超过阈值
        if (event.getValue() > threshold) {
            // 2. 获取该设备上次正常时间(可能为null)
            Long lastNormalTime = lastNormalTimeState.value();

            // 3. 异常持续判断:首次异常或超过容忍窗口
            if (lastNormalTime == null ||
                currentTime - lastNormalTime > timeout) {

                // 4. 生成告警事件(设备ID+异常值)
                out.collect(new AlertEvent(
                    event.getDeviceId(),
                    event.getValue()
                ));
            }
        } else {
            // 5. 指标正常时更新时间戳状态
            lastNormalTimeState.update(currentTime);
        }
    }
}六、常见问题排查
| 问题类型 | 典型症状 | 排查步骤 | 解决方案 |
| 资源不足 | TaskManager OOM/调度延迟/吞吐量下降 | 1. 检查YARN/K8s资源分配 2. 查看Web UI的TaskManager页 3. 分析GC日志 | - 增加内存配置 - 调整并行度 - 优化状态大小 |
| 反压问题 | 任务延迟增加/背压指标变红/吞吐量下降 | 1. 查看Backpressure指标 2. 使用flink list-tasks 3. 分析算子日志 | - 增加并行度 - 优化窗口触发 - 调整网络缓冲区 |
| 检查点失败 | 检查点超时/状态恢复失败/任务重启 | 1. 检查配置参数 2. 分析检查点日志 3. 验证存储路径 | - 延长超时时间 - 启用增量检查点 - 优化状态序列化 |
| 状态后端异常 | 状态恢复失败/任务启动异常/状态大小异常 | 1. 检查状态后端类型 2. 验证存储目录 3. 分析序列化日志 | - 切换RocksDB后端 - 设置状态TTL - 优化TypeSerializer |
总结
本文系统性地构建了Flink技术认知体系:
- 架构层面:解析流批一体运行时与状态后端选型策略
- 可靠性层面:详解Checkpoint/Savepoint机制与2PC事务实现
- 实战层面:还原异常检测模块、实时ETL管道等生产级代码实现
扩展阅读
📚 我的技术博客导航:[点击进入一站式查看所有干货]

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 29
 0
- 0


 已为社区贡献3条内容

所有评论(0)