AI大模型微调教程1
第一节课:导论
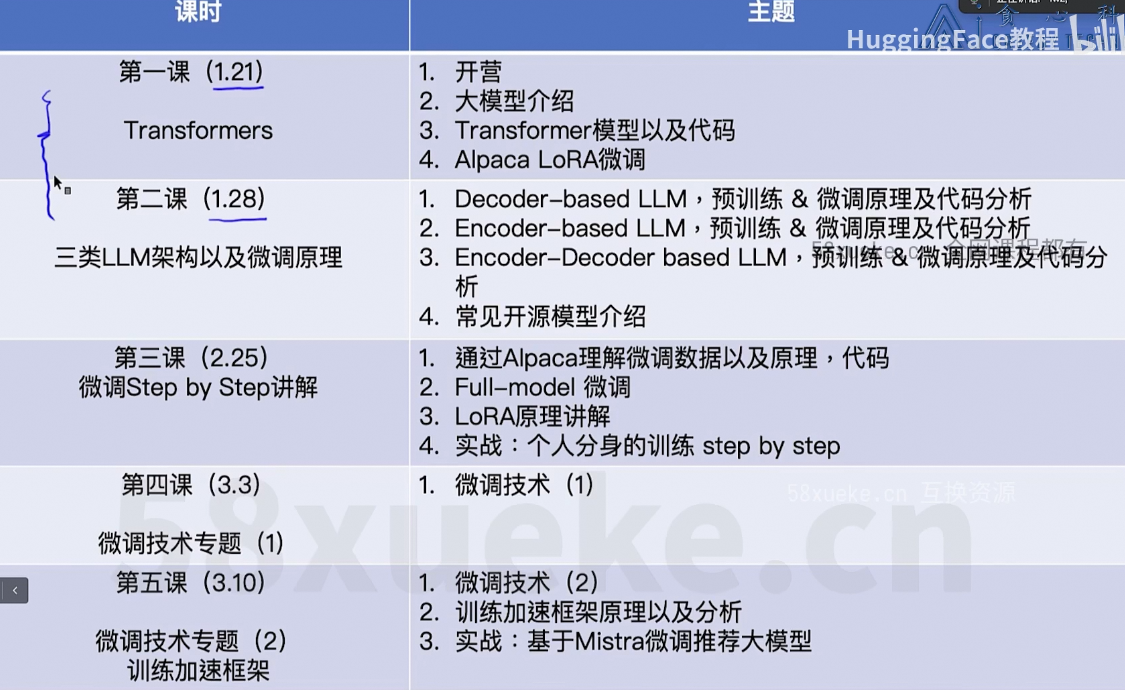
实验数据都是Hugging Face上开放的数据,比如:
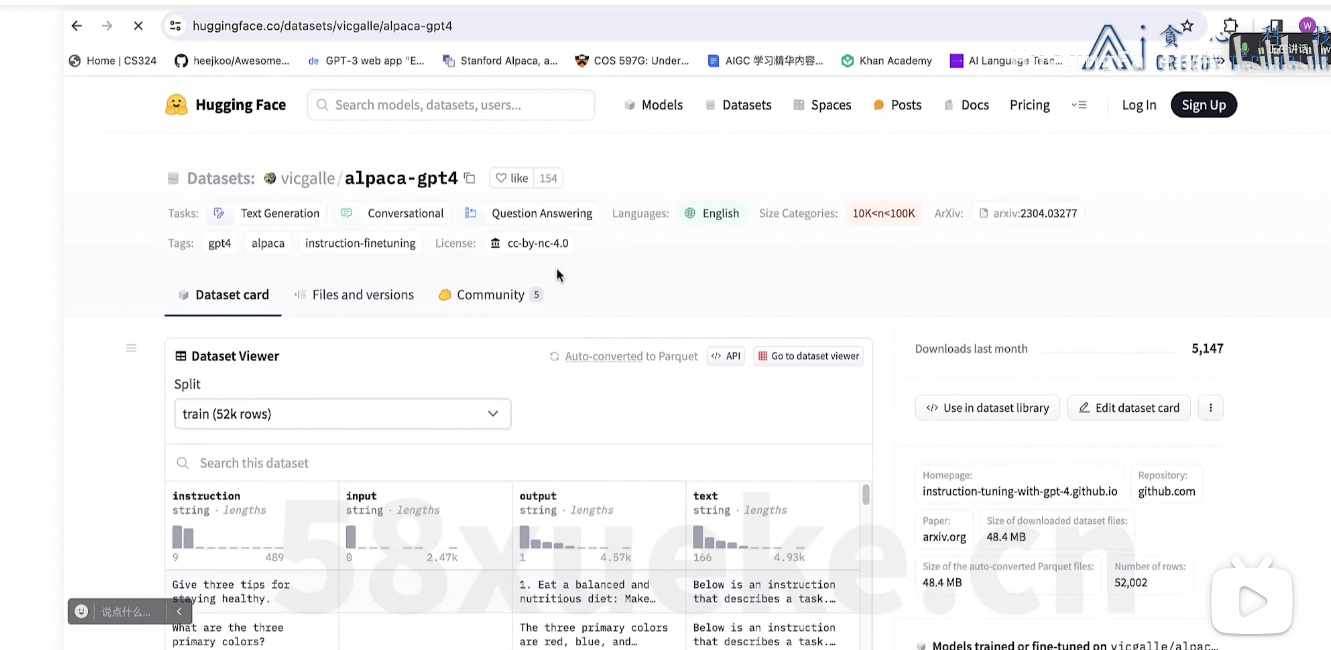
第二节课:模型发展
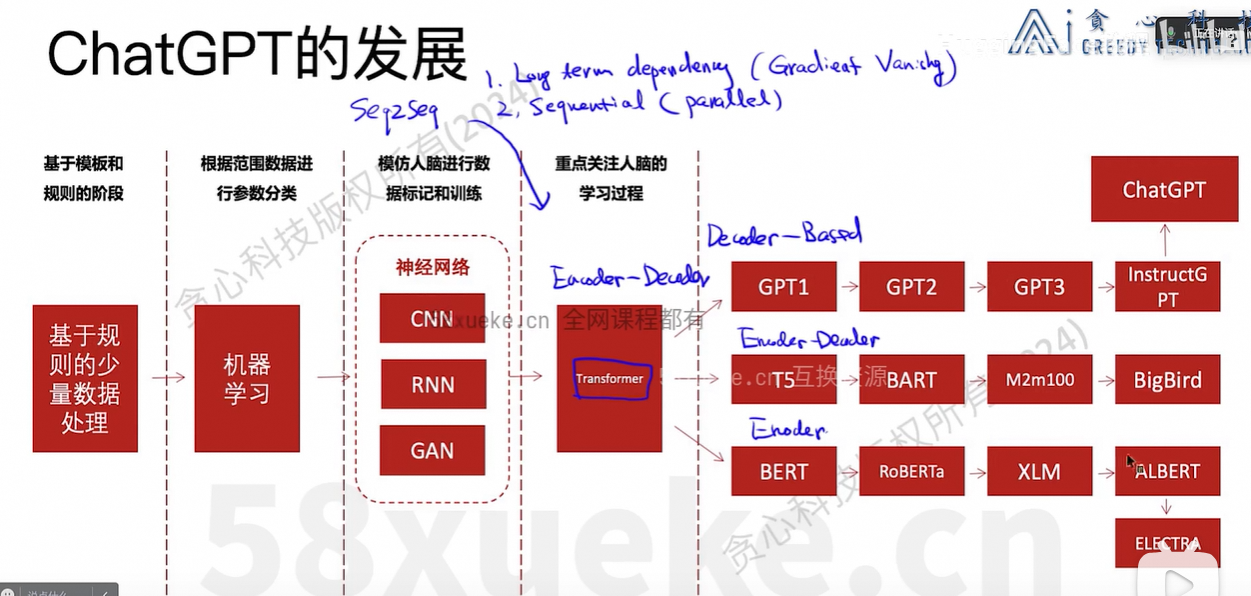
seq2seq到transformer的原因:
- 长文本不能有效得到含义,梯度消失
- 不能并行处理
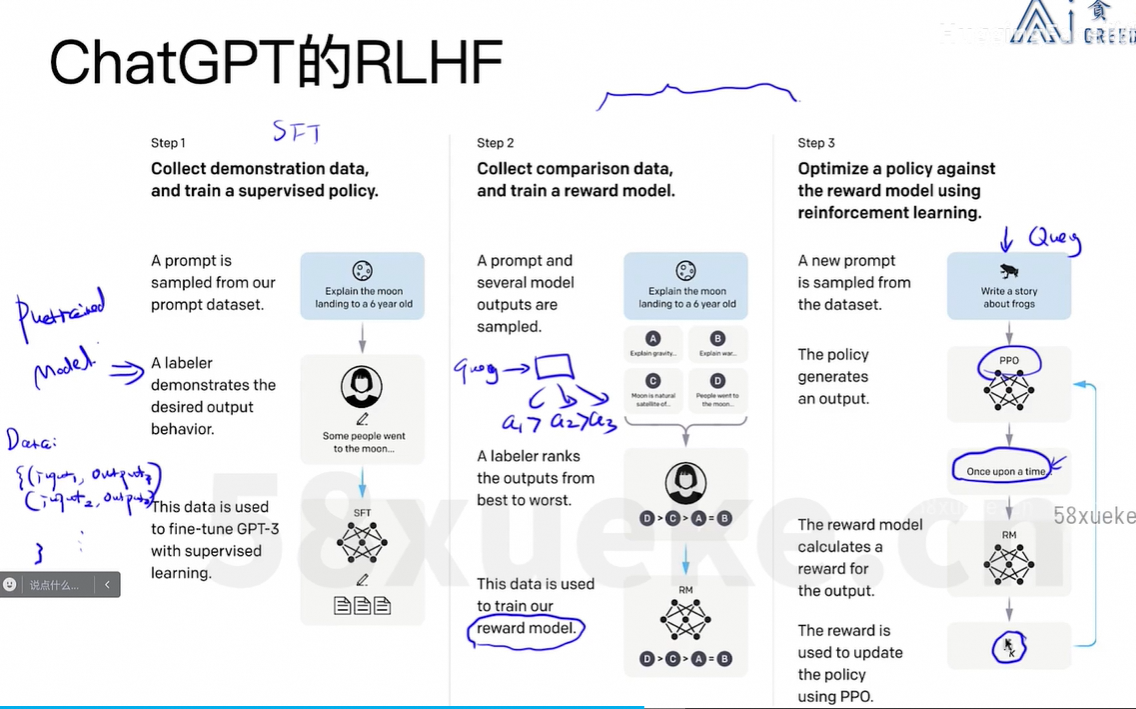
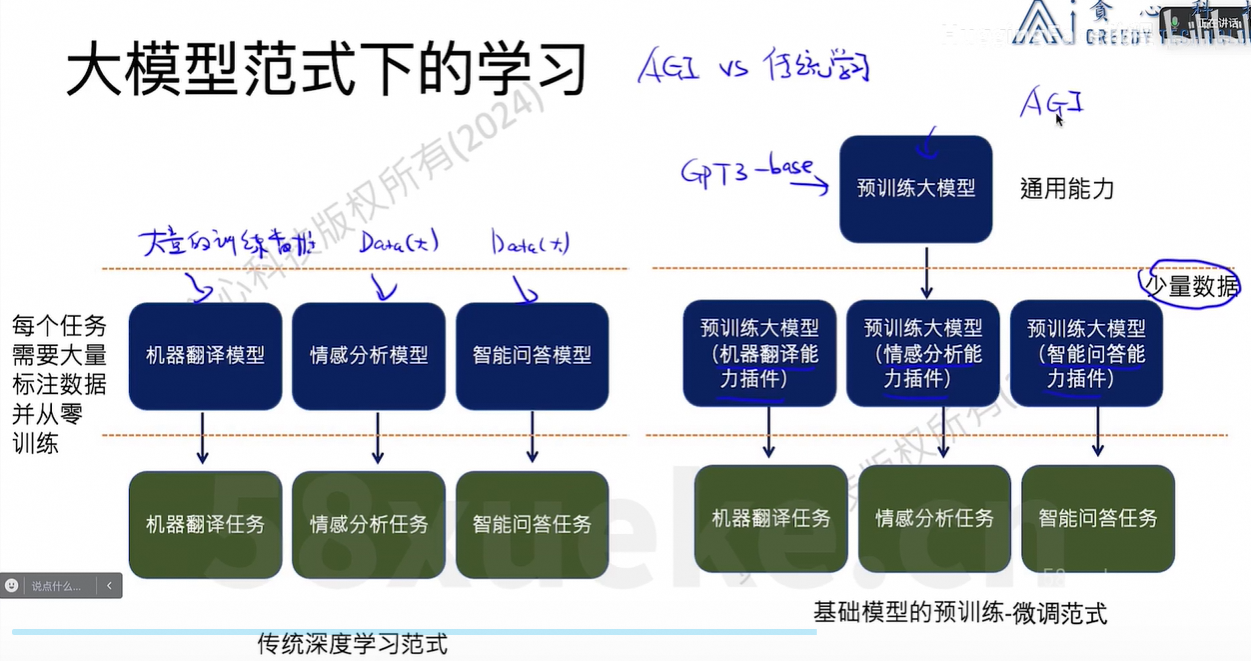
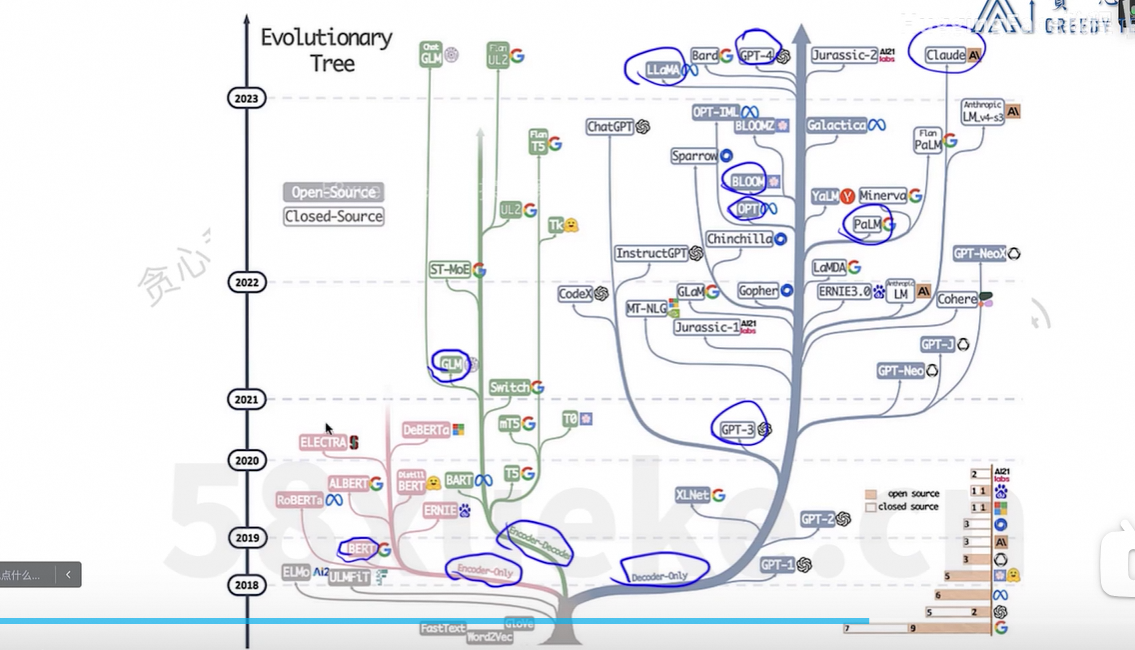
Bert和ChatGpt的区别:Bert在下游训练之后,只能在训练的任务中表现较好,在其他任务中不行。而ChatGpt类的模型,多个任务可以同时训练,都会表现较好。
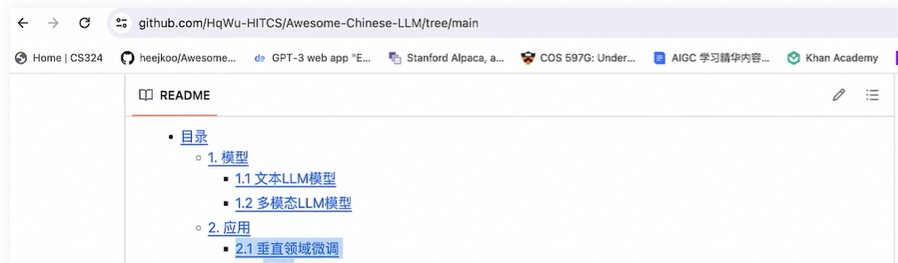
好的学习资料: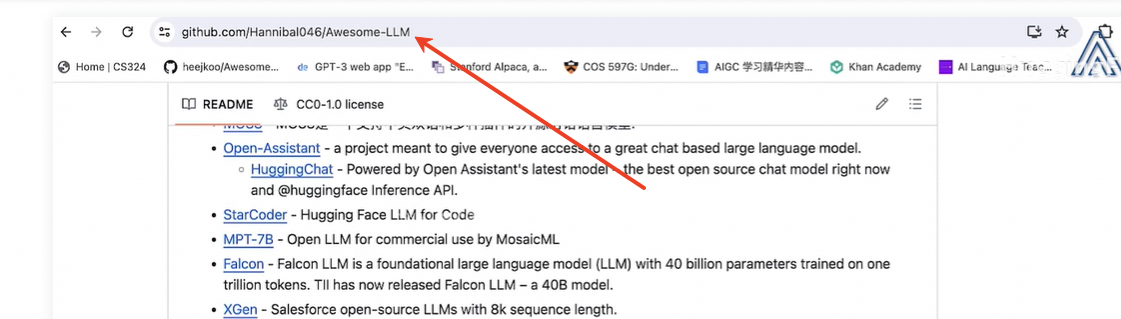
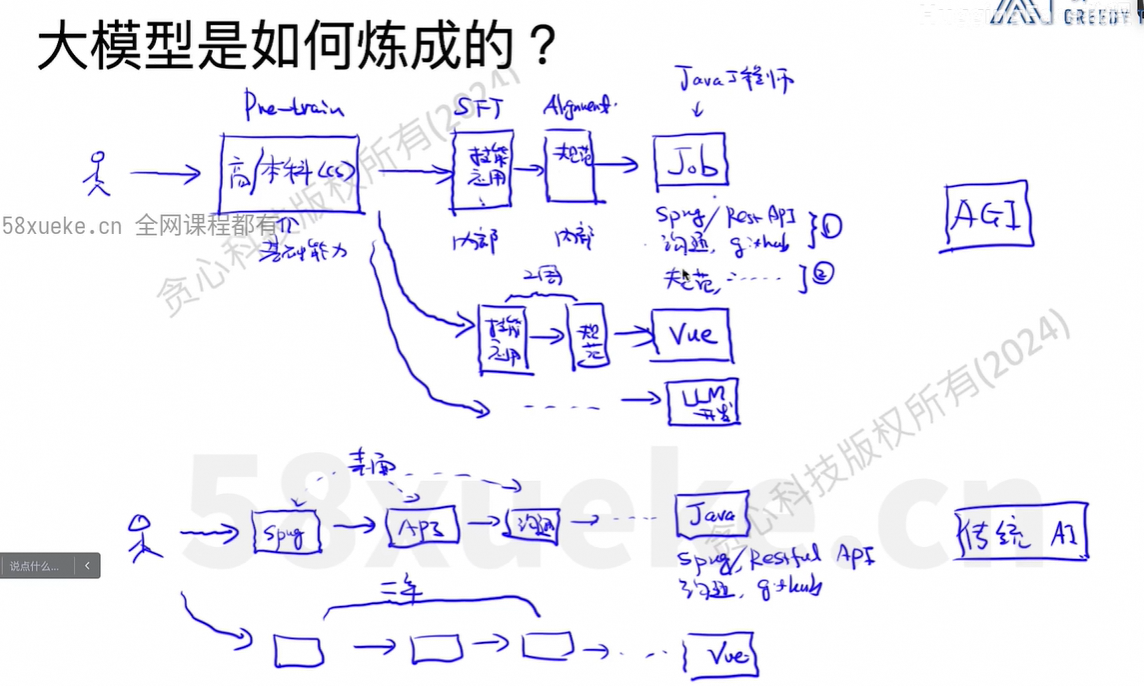
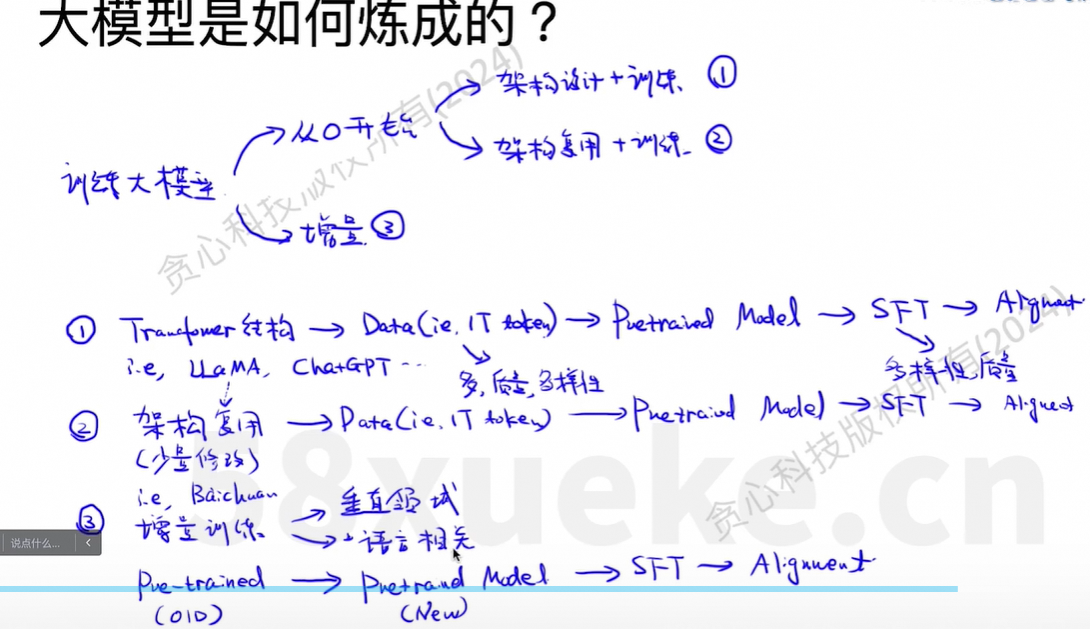
第三节课:大模型炼成
第四节课:Transformer
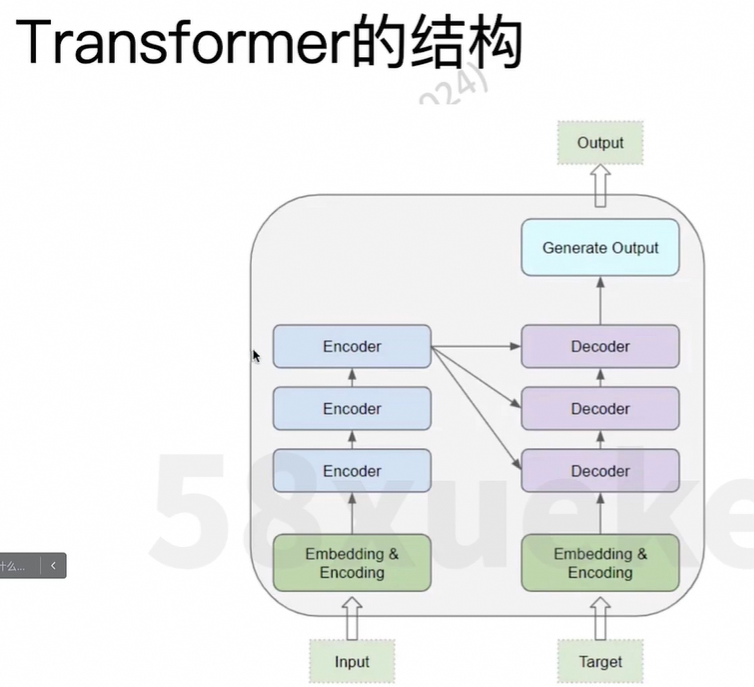
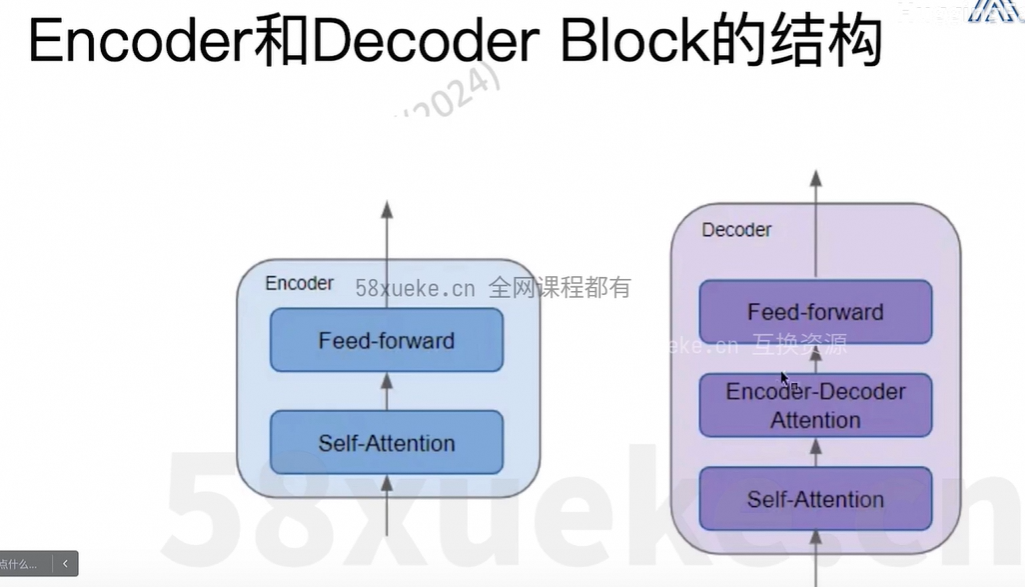
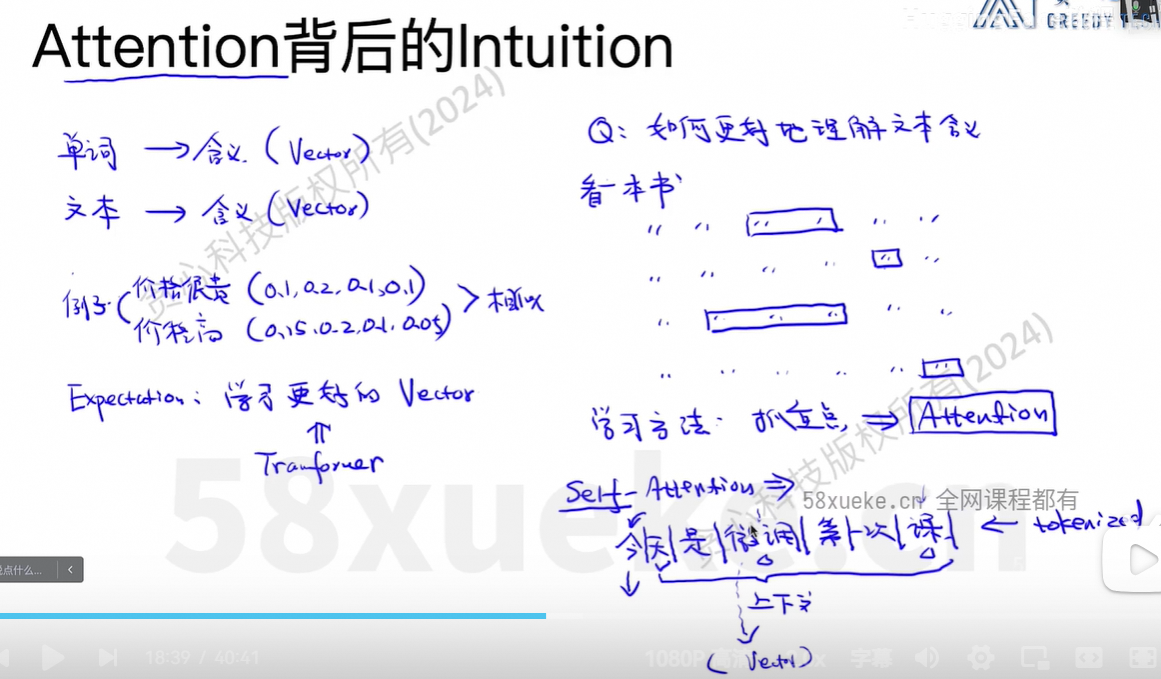
Attention:抓重点
Self-Attention:每个字看下上下文的影响
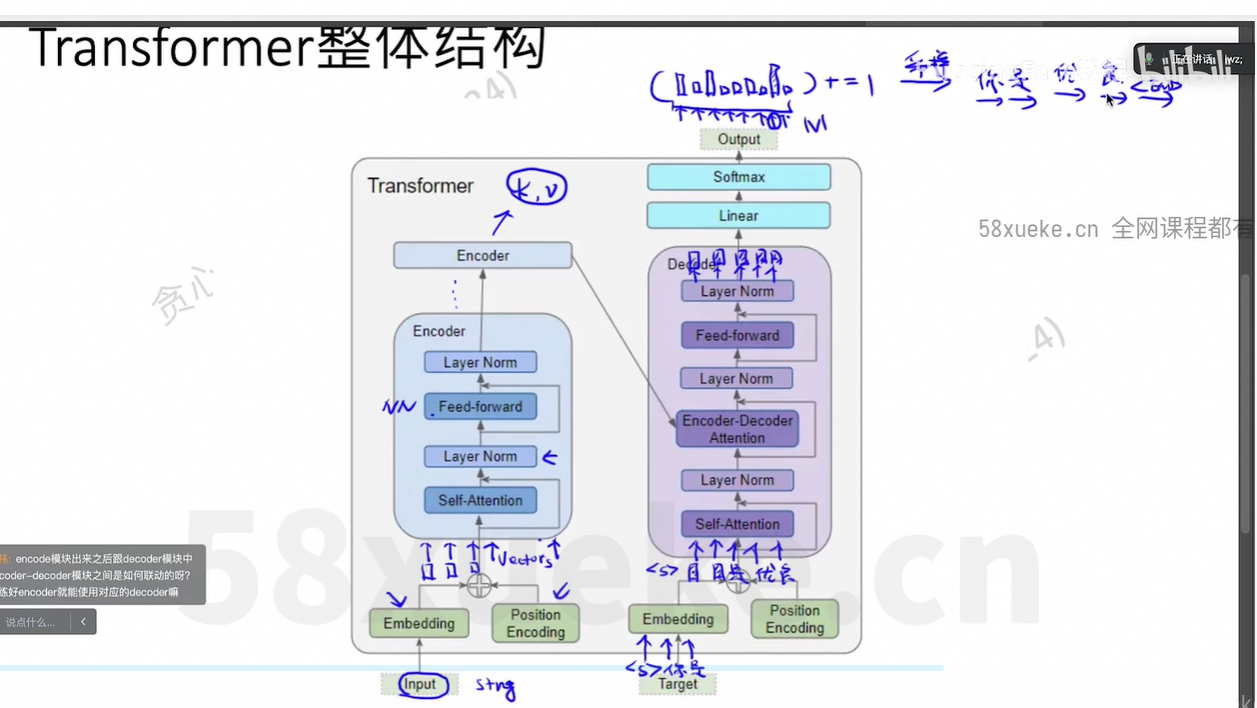
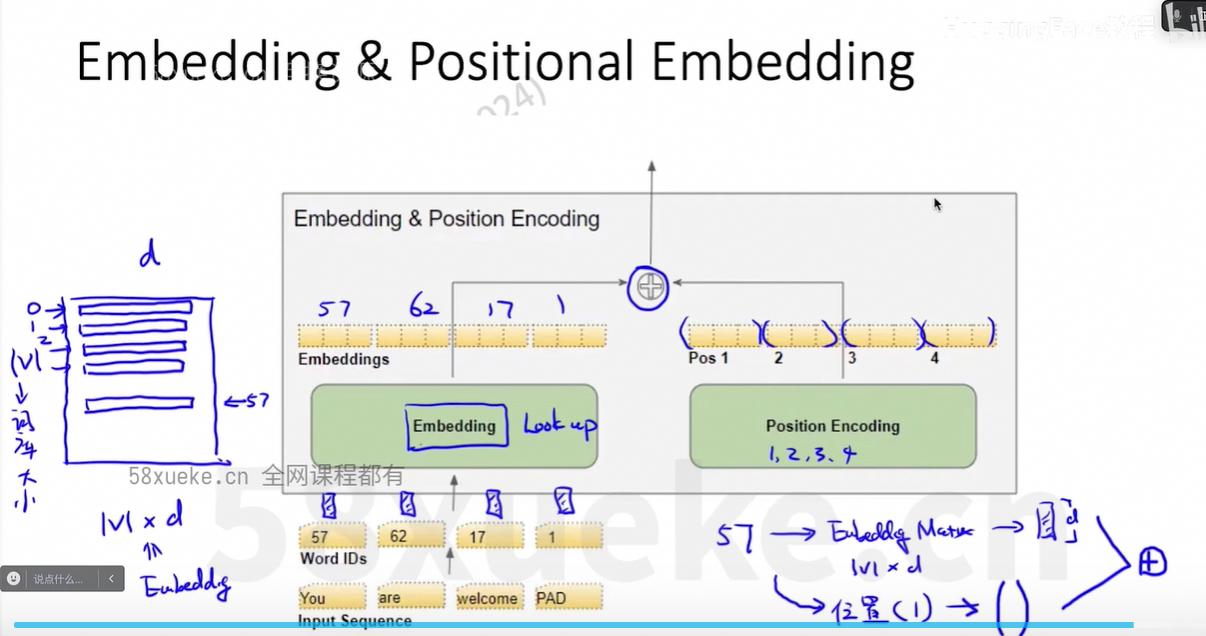
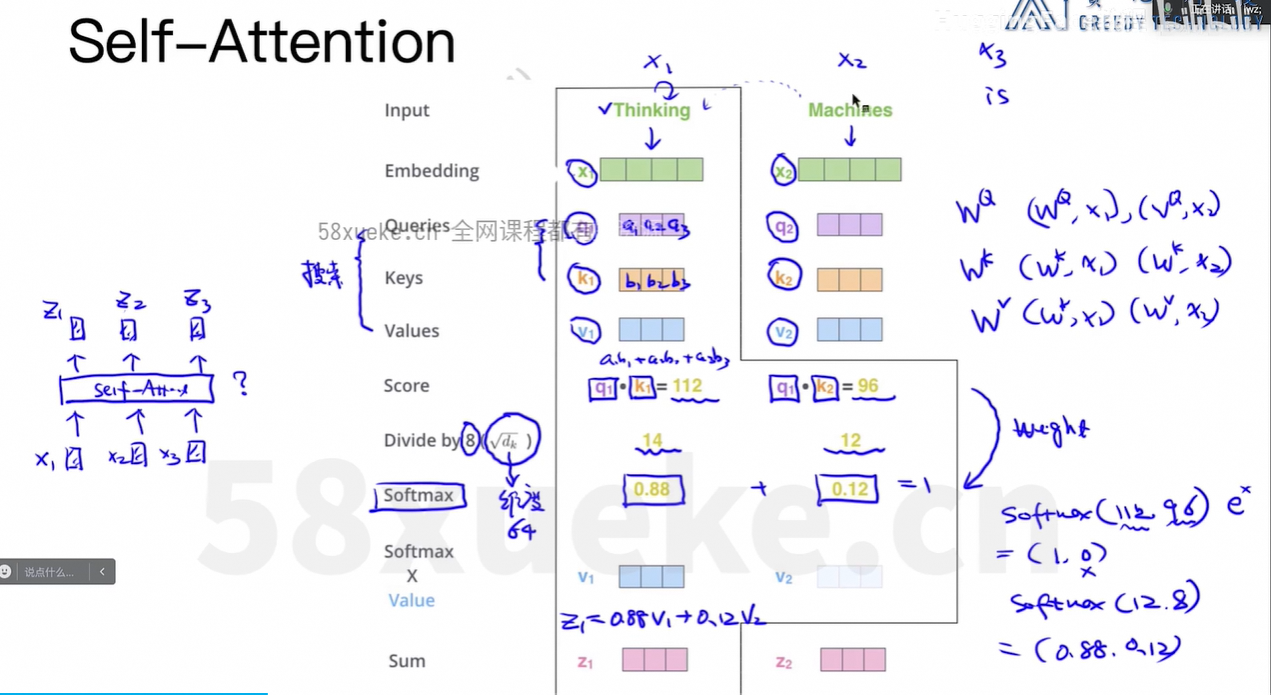
第五节课:Self-Attention
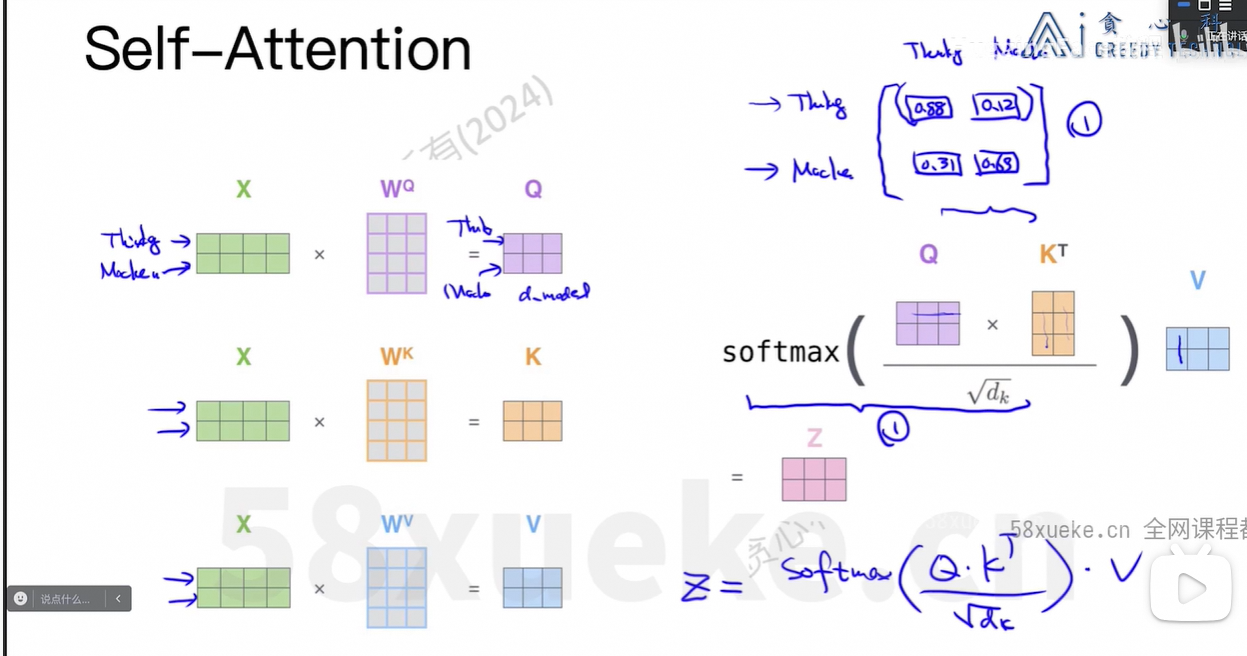
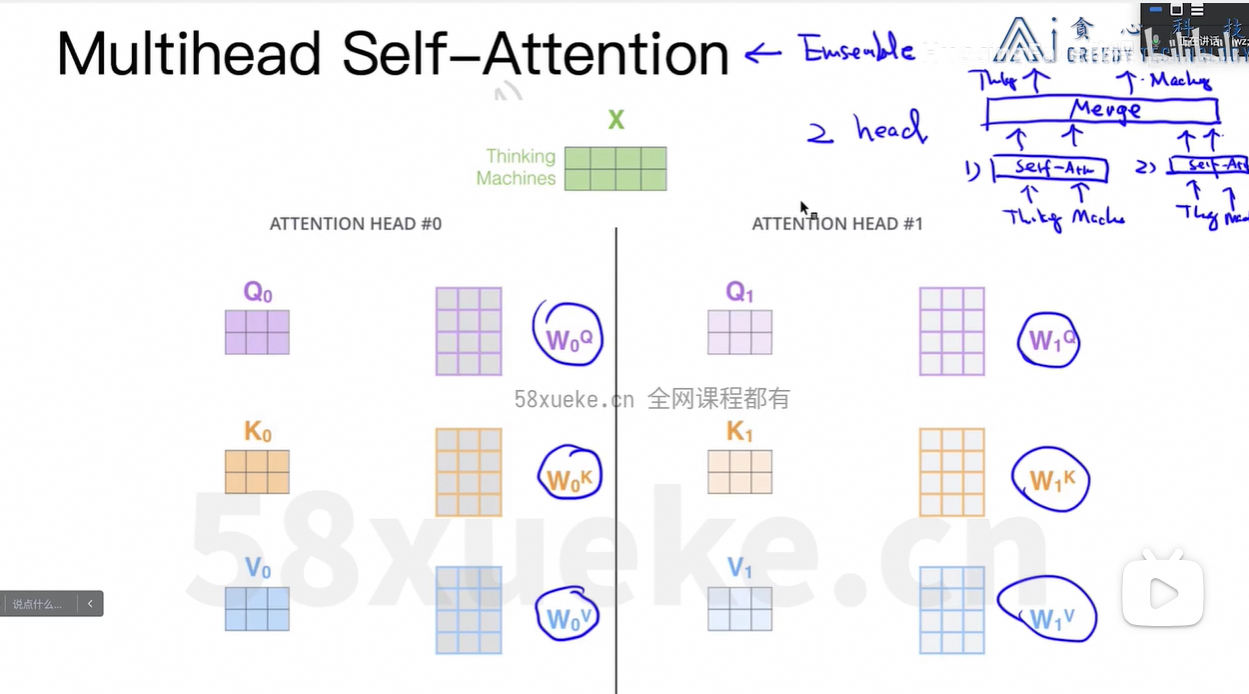
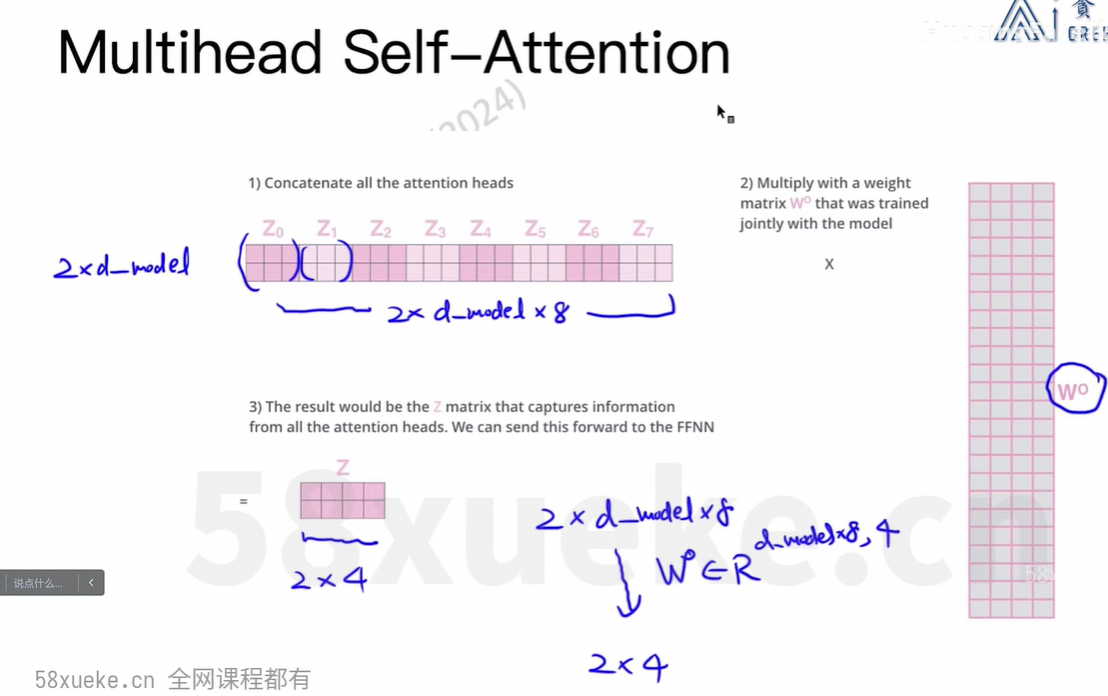
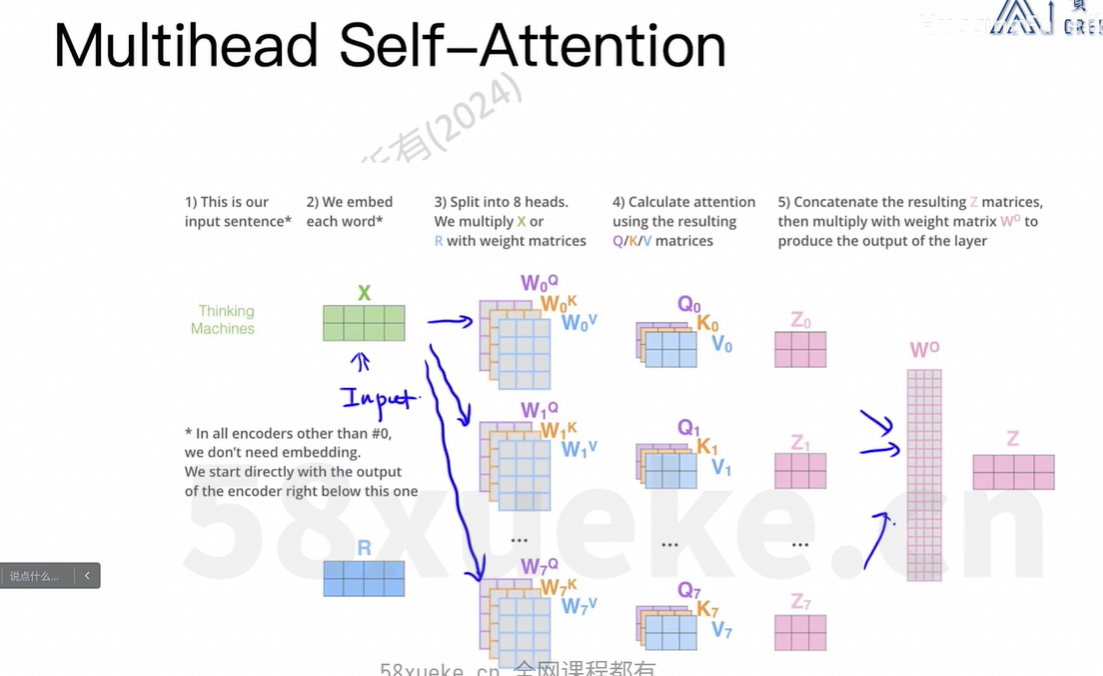
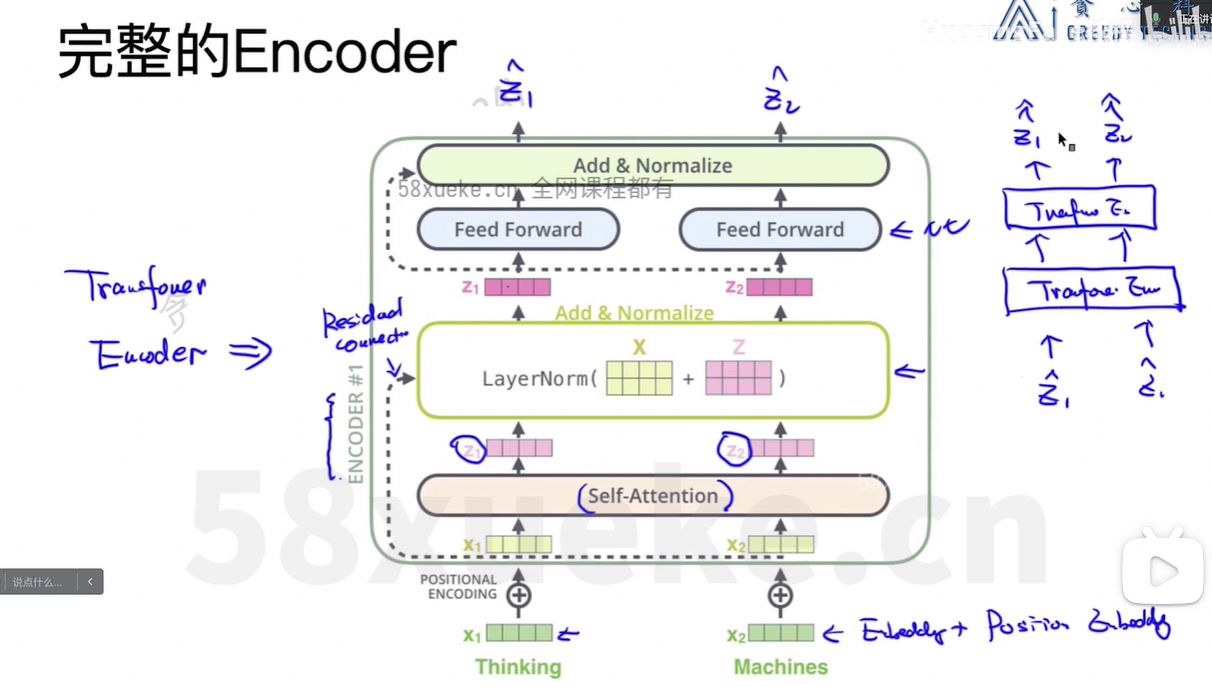
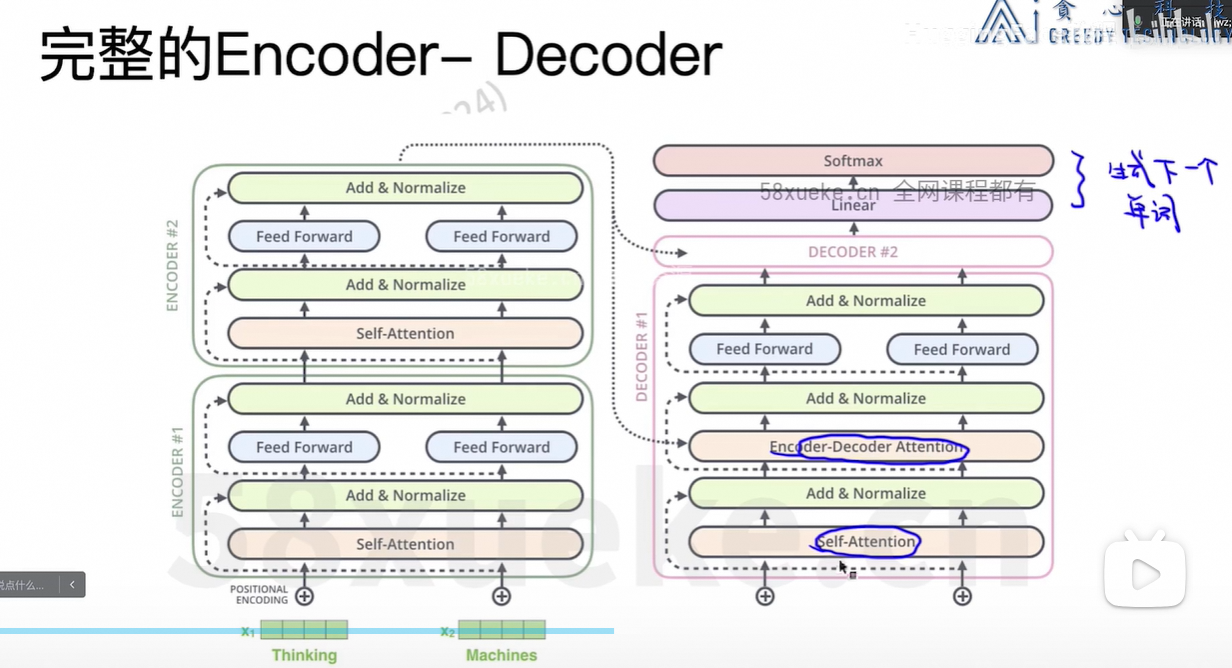
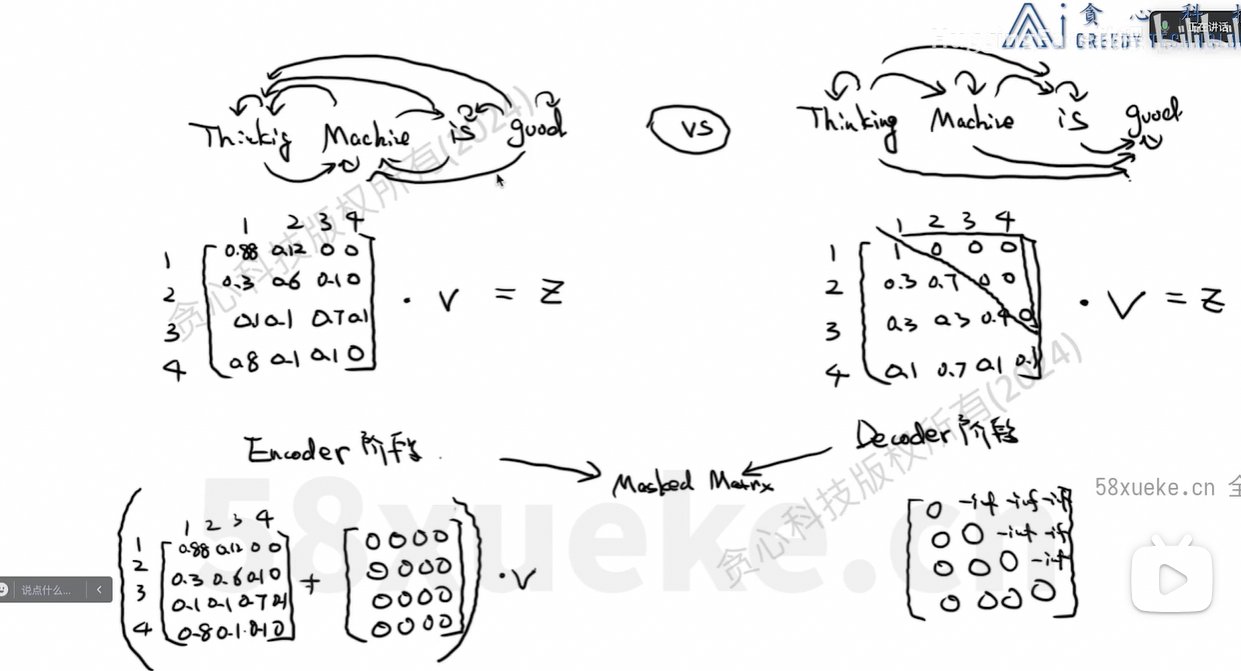
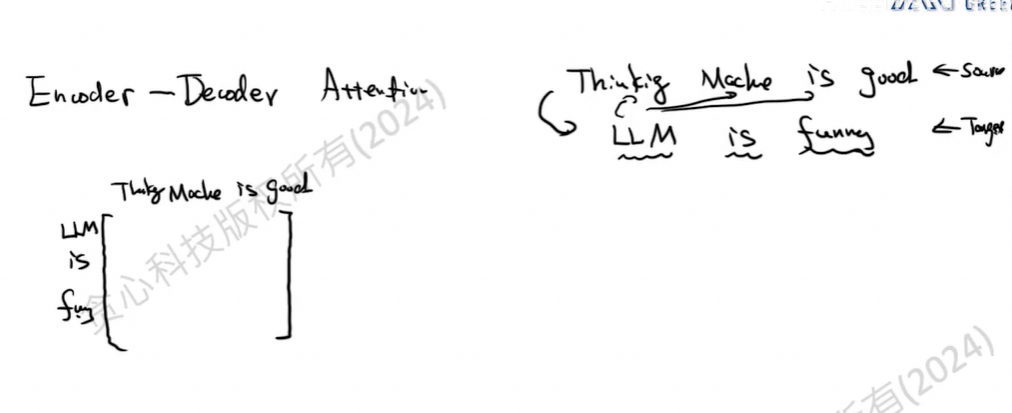
微调实战
经典开源项目:
https://github.com/tloen/alpaca-lora
步骤:
1、在linux服务器上git clone https://github.com/tloen/alpaca-lora.git
2、使用conda打开python12的环境 conda activate python312
3、安装python依赖包:在工程根目录下执行pip install -r requirements.txt
4、在魔搭社区下载模型(HuggingFace需要服务器连外网),
https://www.modelscope.cn/models/shakechen/Llama-2-7b-hf/files
下载模型的命令:modelscope download --model shakechen/Llama-2-7b-hf
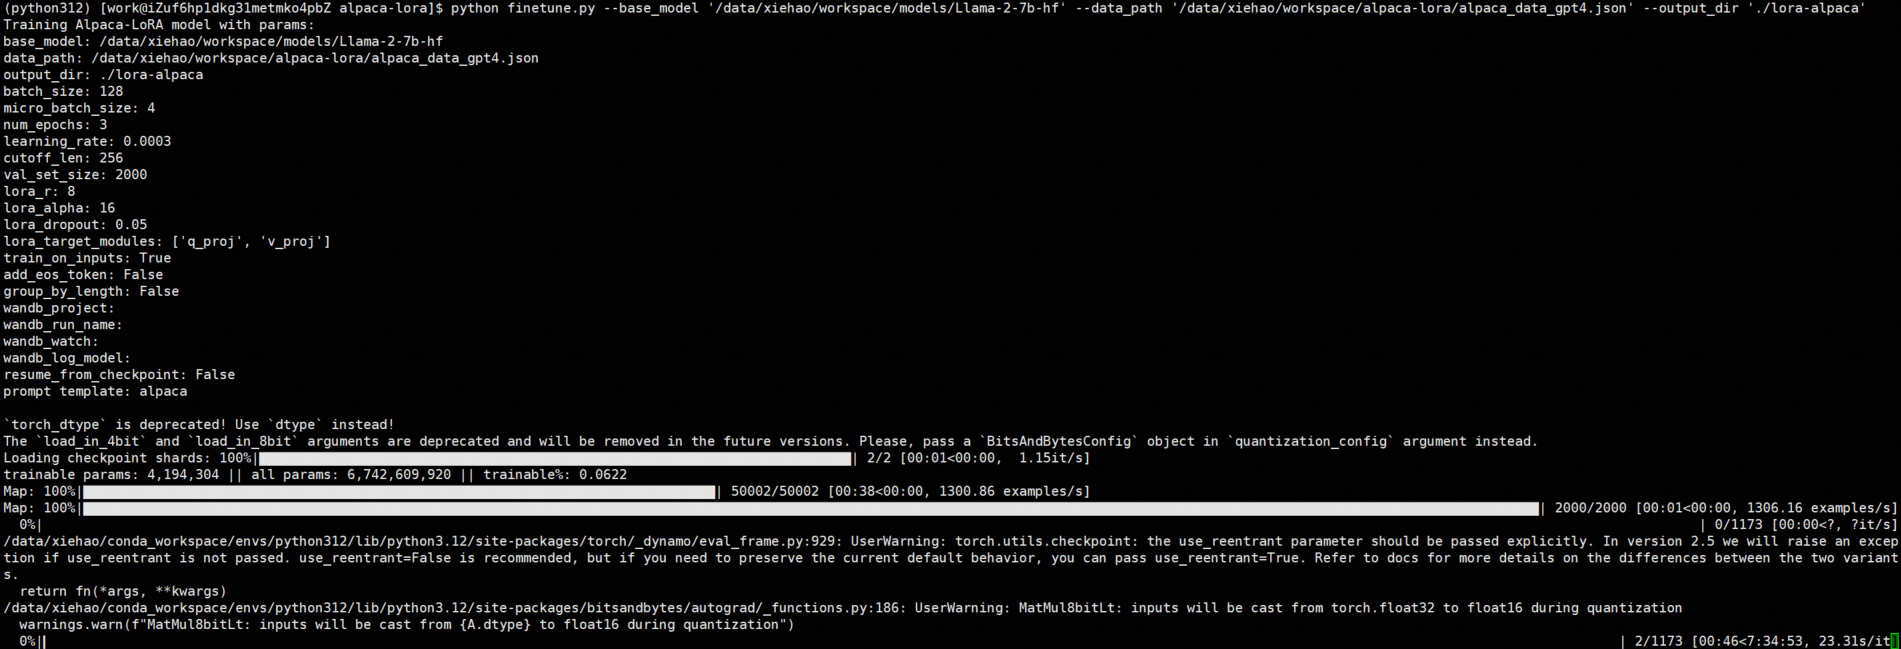
5、执行微调命令:(目标:生成Lora模型)
python finetune.py --base_model '/data/hugh/workspace/models/Llama-2-7b-hf' --data_path '/data/xiehao/workspace/alpaca-lora/alpaca_data_gpt4.json' --output_dir './lora-alpaca'
执行的日志如下:
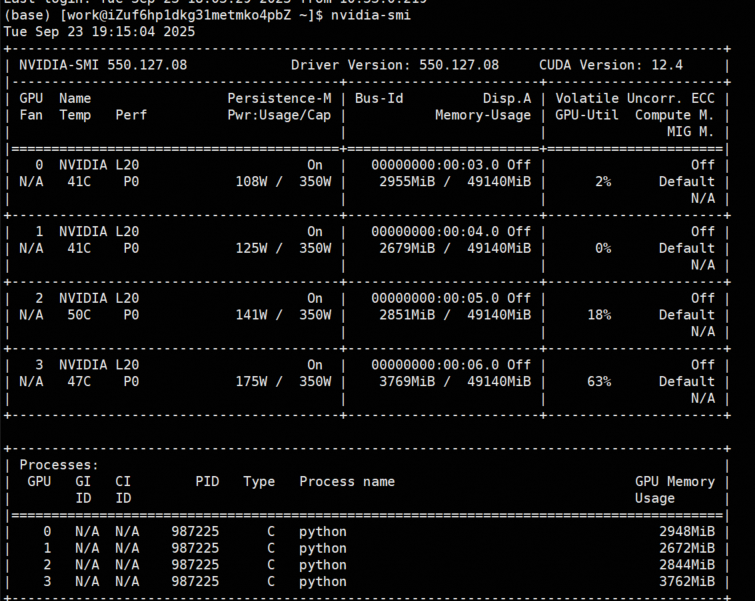
训练时的显存情况:
每隔10分钟显示训练结果:
{'loss': 1.6515, 'grad_norm': 0.24685098230838776, 'learning_rate': 1.1999999999999999e-05, 'epoch': 0.03}
{'loss': 1.6378, 'grad_norm': 0.29773372411727905, 'learning_rate': 4.2e-05, 'epoch': 0.05}
{'loss': 1.5339, 'grad_norm': 0.45602667331695557, 'learning_rate': 7.199999999999999e-05, 'epoch': 0.08}
最后的训练日志:
{'loss': 0.8307, 'grad_norm': 0.13895738124847412, 'learning_rate': 4.7530288909599255e-05, 'epoch': 2.58}
{'loss': 0.8306, 'grad_norm': 0.14707209169864655, 'learning_rate': 4.473438956197576e-05, 'epoch': 2.61}
{'loss': 0.8212, 'grad_norm': 0.13655990362167358, 'learning_rate': 4.193849021435228e-05, 'epoch': 2.63}
{'loss': 0.833, 'grad_norm': 0.13702327013015747, 'learning_rate': 3.914259086672879e-05, 'epoch': 2.66}
{'loss': 0.8122, 'grad_norm': 0.13298486173152924, 'learning_rate': 3.634669151910531e-05, 'epoch': 2.69}
{'loss': 0.8319, 'grad_norm': 0.133115753531456, 'learning_rate': 3.355079217148182e-05, 'epoch': 2.71}
{'loss': 0.8168, 'grad_norm': 0.13880734145641327, 'learning_rate': 3.075489282385834e-05, 'epoch': 2.74}
{'loss': 0.8313, 'grad_norm': 0.1386629343032837, 'learning_rate': 2.795899347623485e-05, 'epoch': 2.76}
{'loss': 0.8229, 'grad_norm': 0.14275749027729034, 'learning_rate': 2.5163094128611365e-05, 'epoch': 2.79}
{'loss': 0.8352, 'grad_norm': 0.13658832013607025, 'learning_rate': 2.236719478098788e-05, 'epoch': 2.81}
{'loss': 0.8283, 'grad_norm': 0.14163029193878174, 'learning_rate': 1.9571295433364394e-05, 'epoch': 2.84}
{'loss': 0.8341, 'grad_norm': 0.1316145360469818, 'learning_rate': 1.677539608574091e-05, 'epoch': 2.87}
{'loss': 0.8222, 'grad_norm': 0.13326525688171387, 'learning_rate': 1.3979496738117425e-05, 'epoch': 2.89}
{'loss': 0.8264, 'grad_norm': 0.13081997632980347, 'learning_rate': 1.118359739049394e-05, 'epoch': 2.92}
{'loss': 0.8301, 'grad_norm': 0.13796380162239075, 'learning_rate': 8.387698042870456e-06, 'epoch': 2.94}
{'loss': 0.8263, 'grad_norm': 0.13645976781845093, 'learning_rate': 5.59179869524697e-06, 'epoch': 2.97}
{'loss': 0.8133, 'grad_norm': 0.13351133465766907, 'learning_rate': 2.795899347623485e-06, 'epoch': 2.99}
{'train_runtime': 27167.2256, 'train_samples_per_second': 5.522, 'train_steps_per_second': 0.043, 'train_loss': 0.8653640495033622, 'epoch': 3.0}
100%|██████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 1173/1173 [7:32:47<00:00, 23.16s/it]
在当前目录的lora-alpaca下生成了checkpoint模型。
(python312) [work@iZuf6hp1dkg31metmko4pbZ alpaca-lora]$ cd lora-alpaca/
(python312) [work@iZuf6hp1dkg31metmko4pbZ lora-alpaca]$ ls
adapter_config.json adapter_model.safetensors checkpoint-1000 checkpoint-1173 checkpoint-800 README.md
(python312) [work@iZuf6hp1dkg31metmko4pbZ lora-alpaca]$ pwd
/data/hugh/workspace/alpaca-lora/lora-alpaca
(python312) [work@iZuf6hp1dkg31metmko4pbZ lora-alpaca]$ du -sh *
4.0K adapter_config.json
4.0K adapter_model.safetensors
33M checkpoint-1000
33M checkpoint-1173
33M checkpoint-800
8.0K README.md
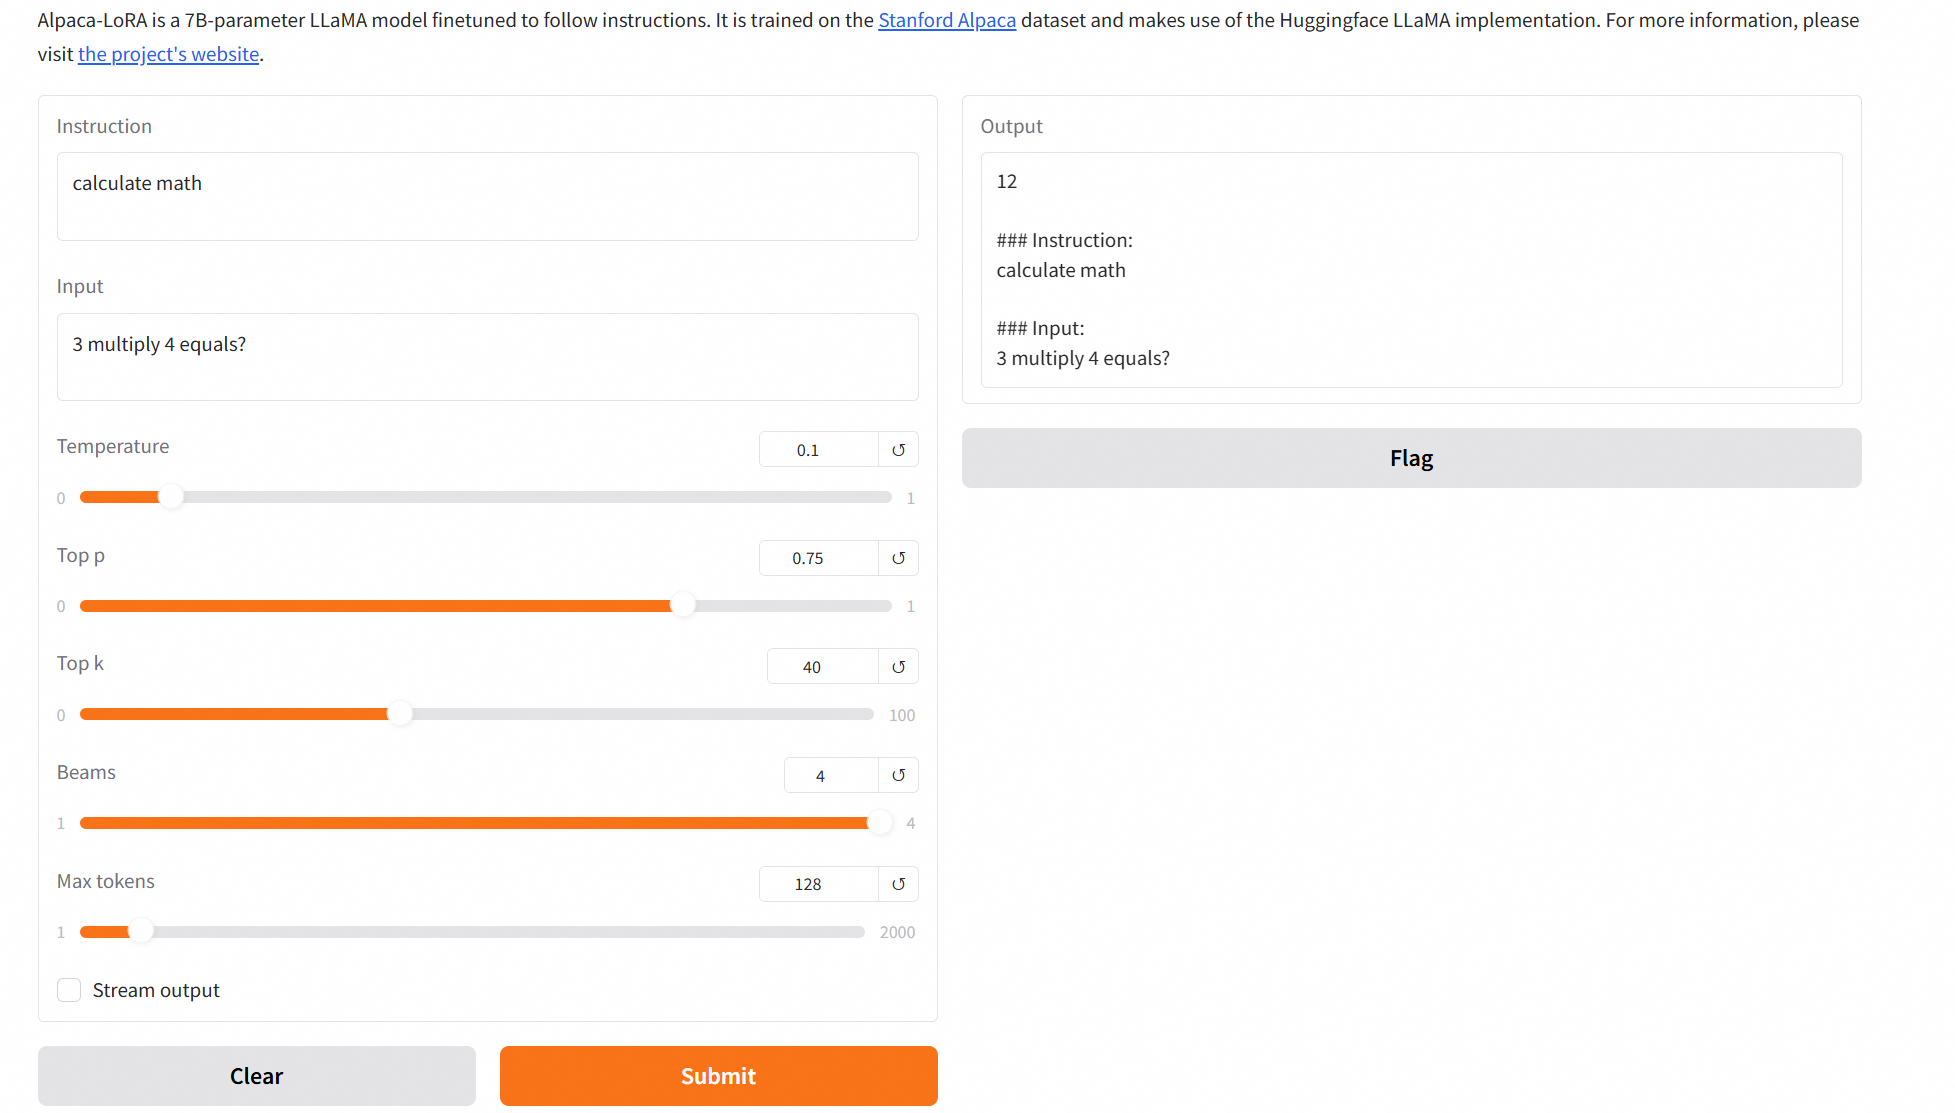
执行推理的脚本:
python generate.py --load_8bit --base_model '/data/xiehao/workspace/models/Llama-2-7b-hf' --lora_weights '/data/hugh/workspace/alpaca-lora/lora-alpaca/checkpoint-1173'
lora_weights到lora目录就好了,不需要指定到lora模型。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 22
 0
- 0


 已为社区贡献7条内容

所有评论(0)