Django+协同过滤图书推荐系统 双算法+Echarts可视化 大数据项目 毕业设计✅
·
博主介绍:✌全网粉丝10W+,前互联网大厂软件研发、集结硕博英豪成立工作室。专注于计算机相关专业项目实战6年之久,选择我们就是选择放心、选择安心毕业✌
> 🍅想要获取完整文章或者源码,或者代做,拉到文章底部即可与我联系了。🍅🍅感兴趣的可以先收藏起来,点赞、关注不迷路,大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助同学们顺利毕业 。🍅
1、毕业设计:2025年计算机专业毕业设计选题汇总(建议收藏)✅
2、大数据毕业设计:2025年选题大全 深度学习 python语言 JAVA语言 hadoop和spark(建议收藏)✅
1、项目介绍
技术栈:Python语言、MySQL数据库、Django框架、Echarts可视化、协同过滤推荐算法(基于用户+基于图书)、HTML
研究背景:纸质书向电子书迁移,用户面临“选书难”与信息过载。利用协同过滤算法(基于用户+基于图书)分析用户评分、收藏、点赞行为,结合Django+Echarts构建可视化图书社区,可在秒级完成“行为采集-相似度计算-推荐生成”闭环,为读者提供个性化书单,为平台提升留存与转化。
研究意义:系统全程本地部署,保障数据隐私;模块化代码支持接入其他推荐模型,适合作为“推荐系统”“Web开发”课程实践与毕业设计模板,推动协同过滤算法在教学与产业中的落地应用。
2、项目界面
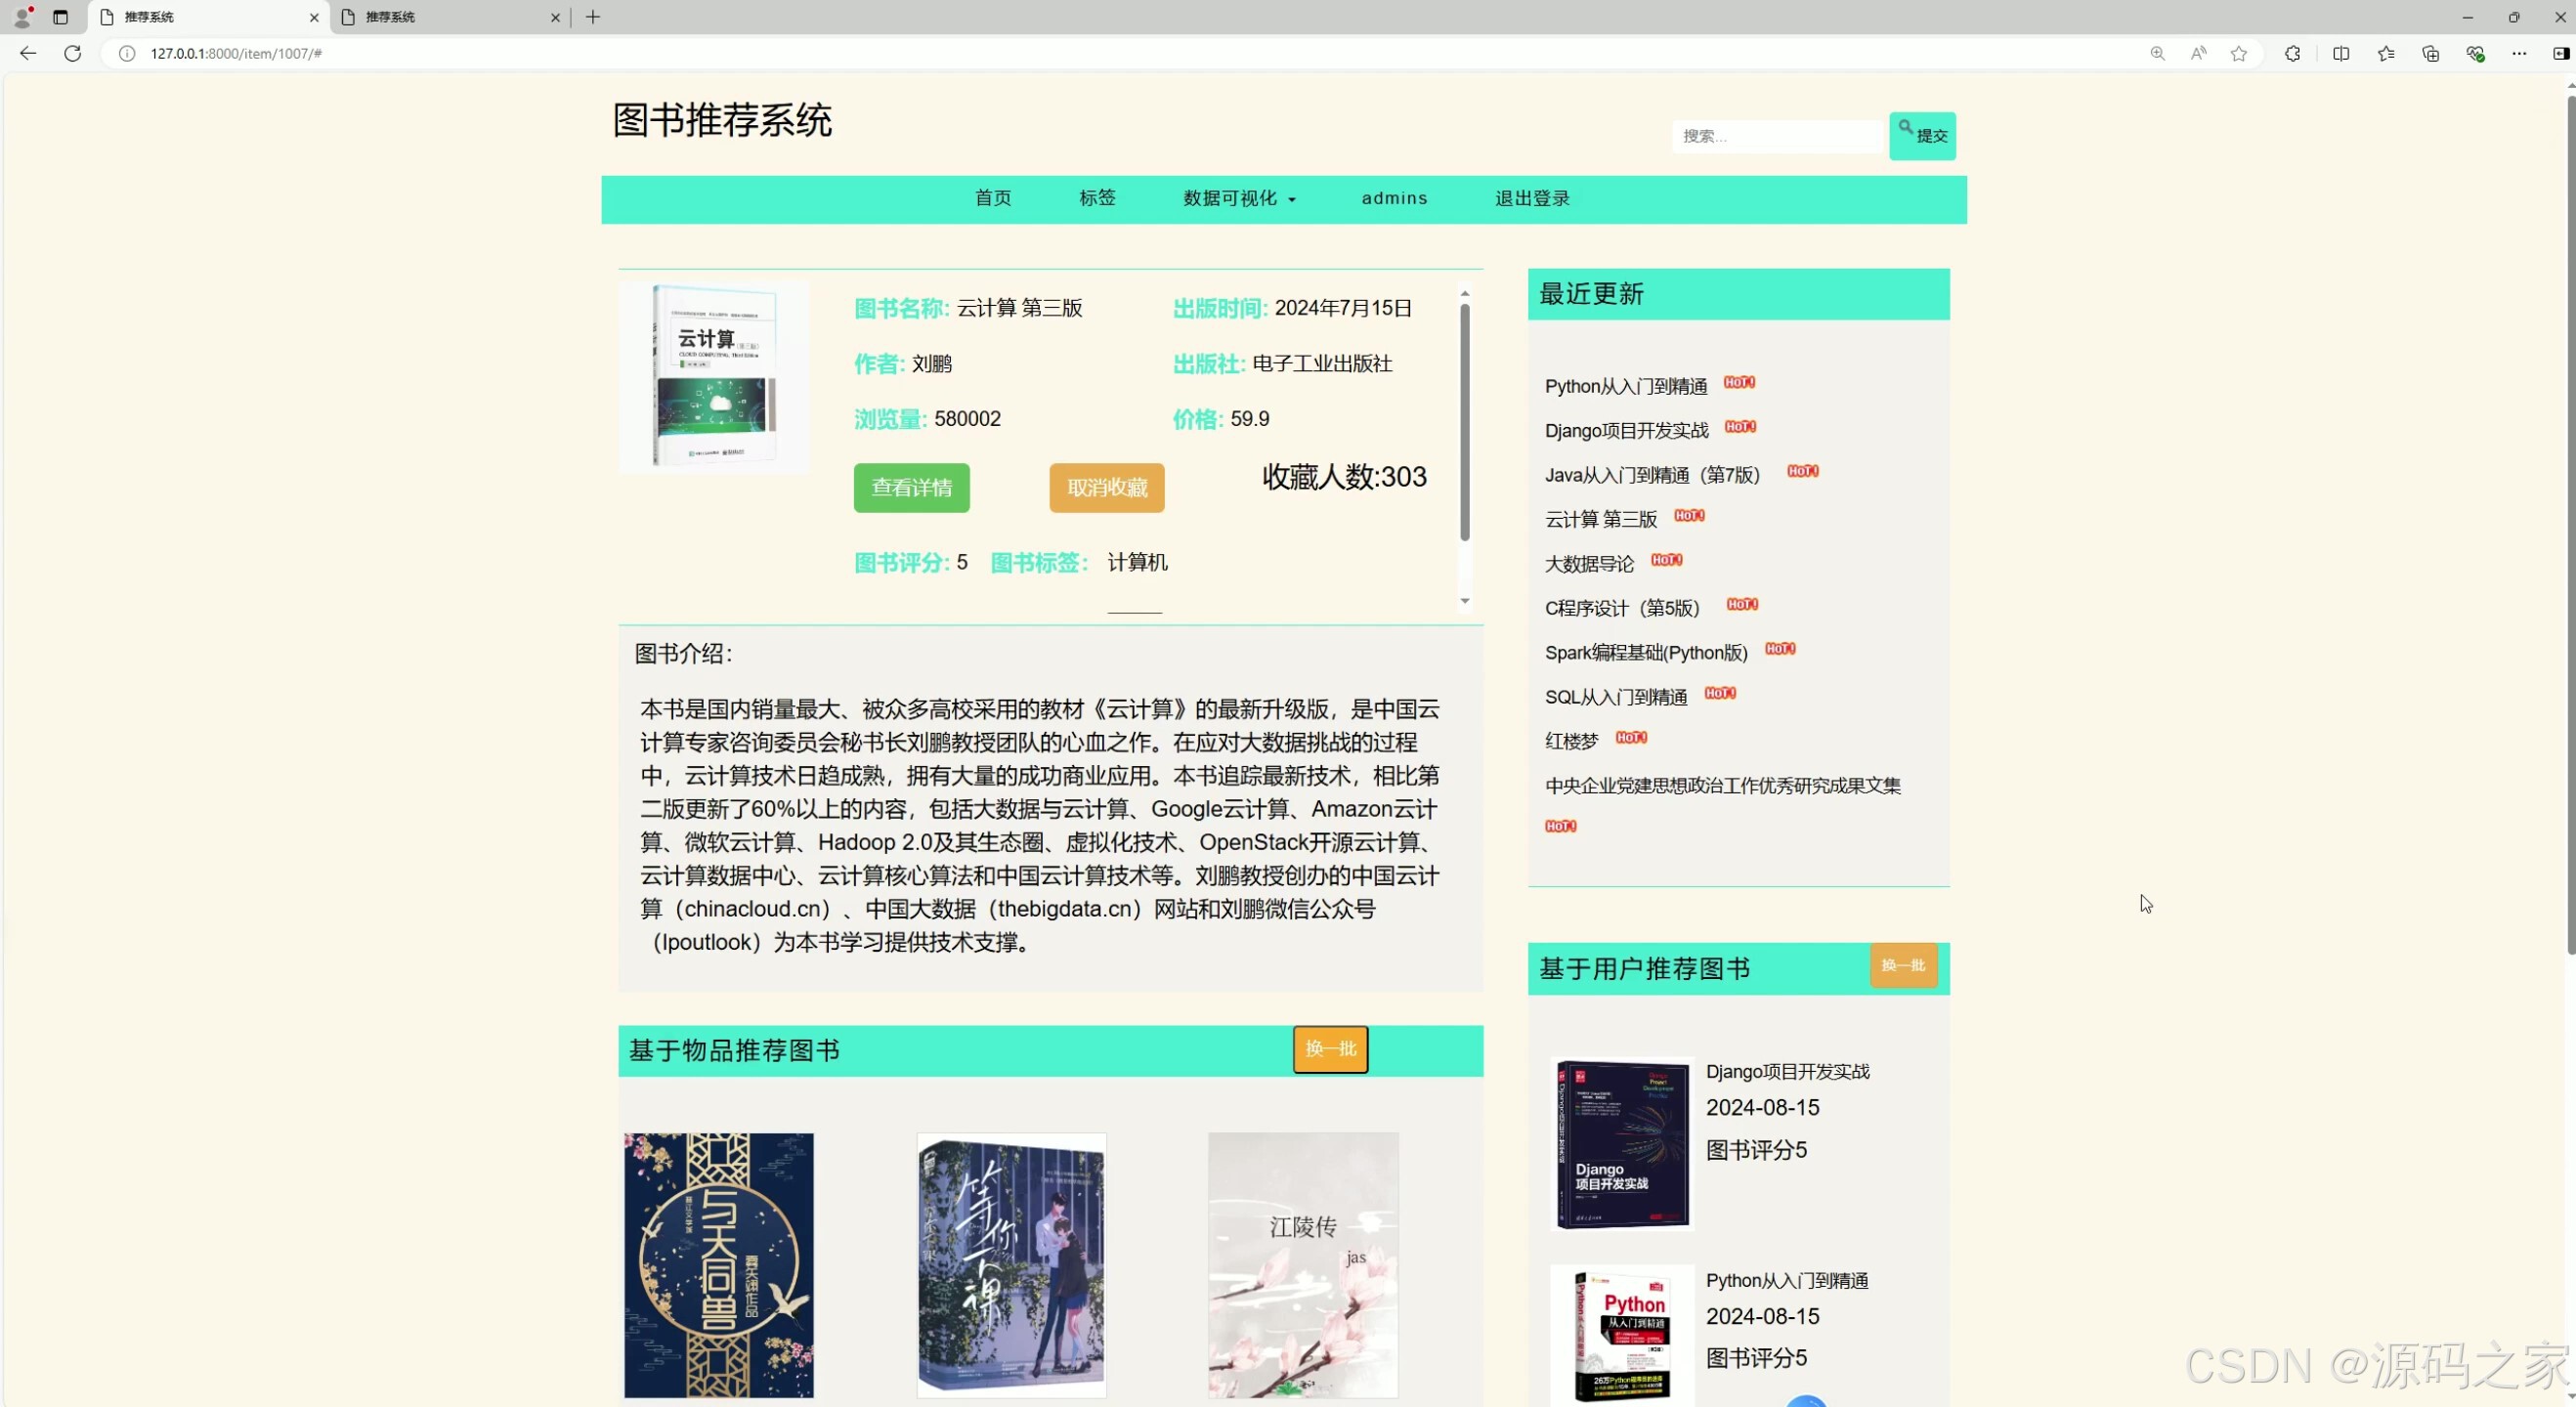
(1)图书详情页
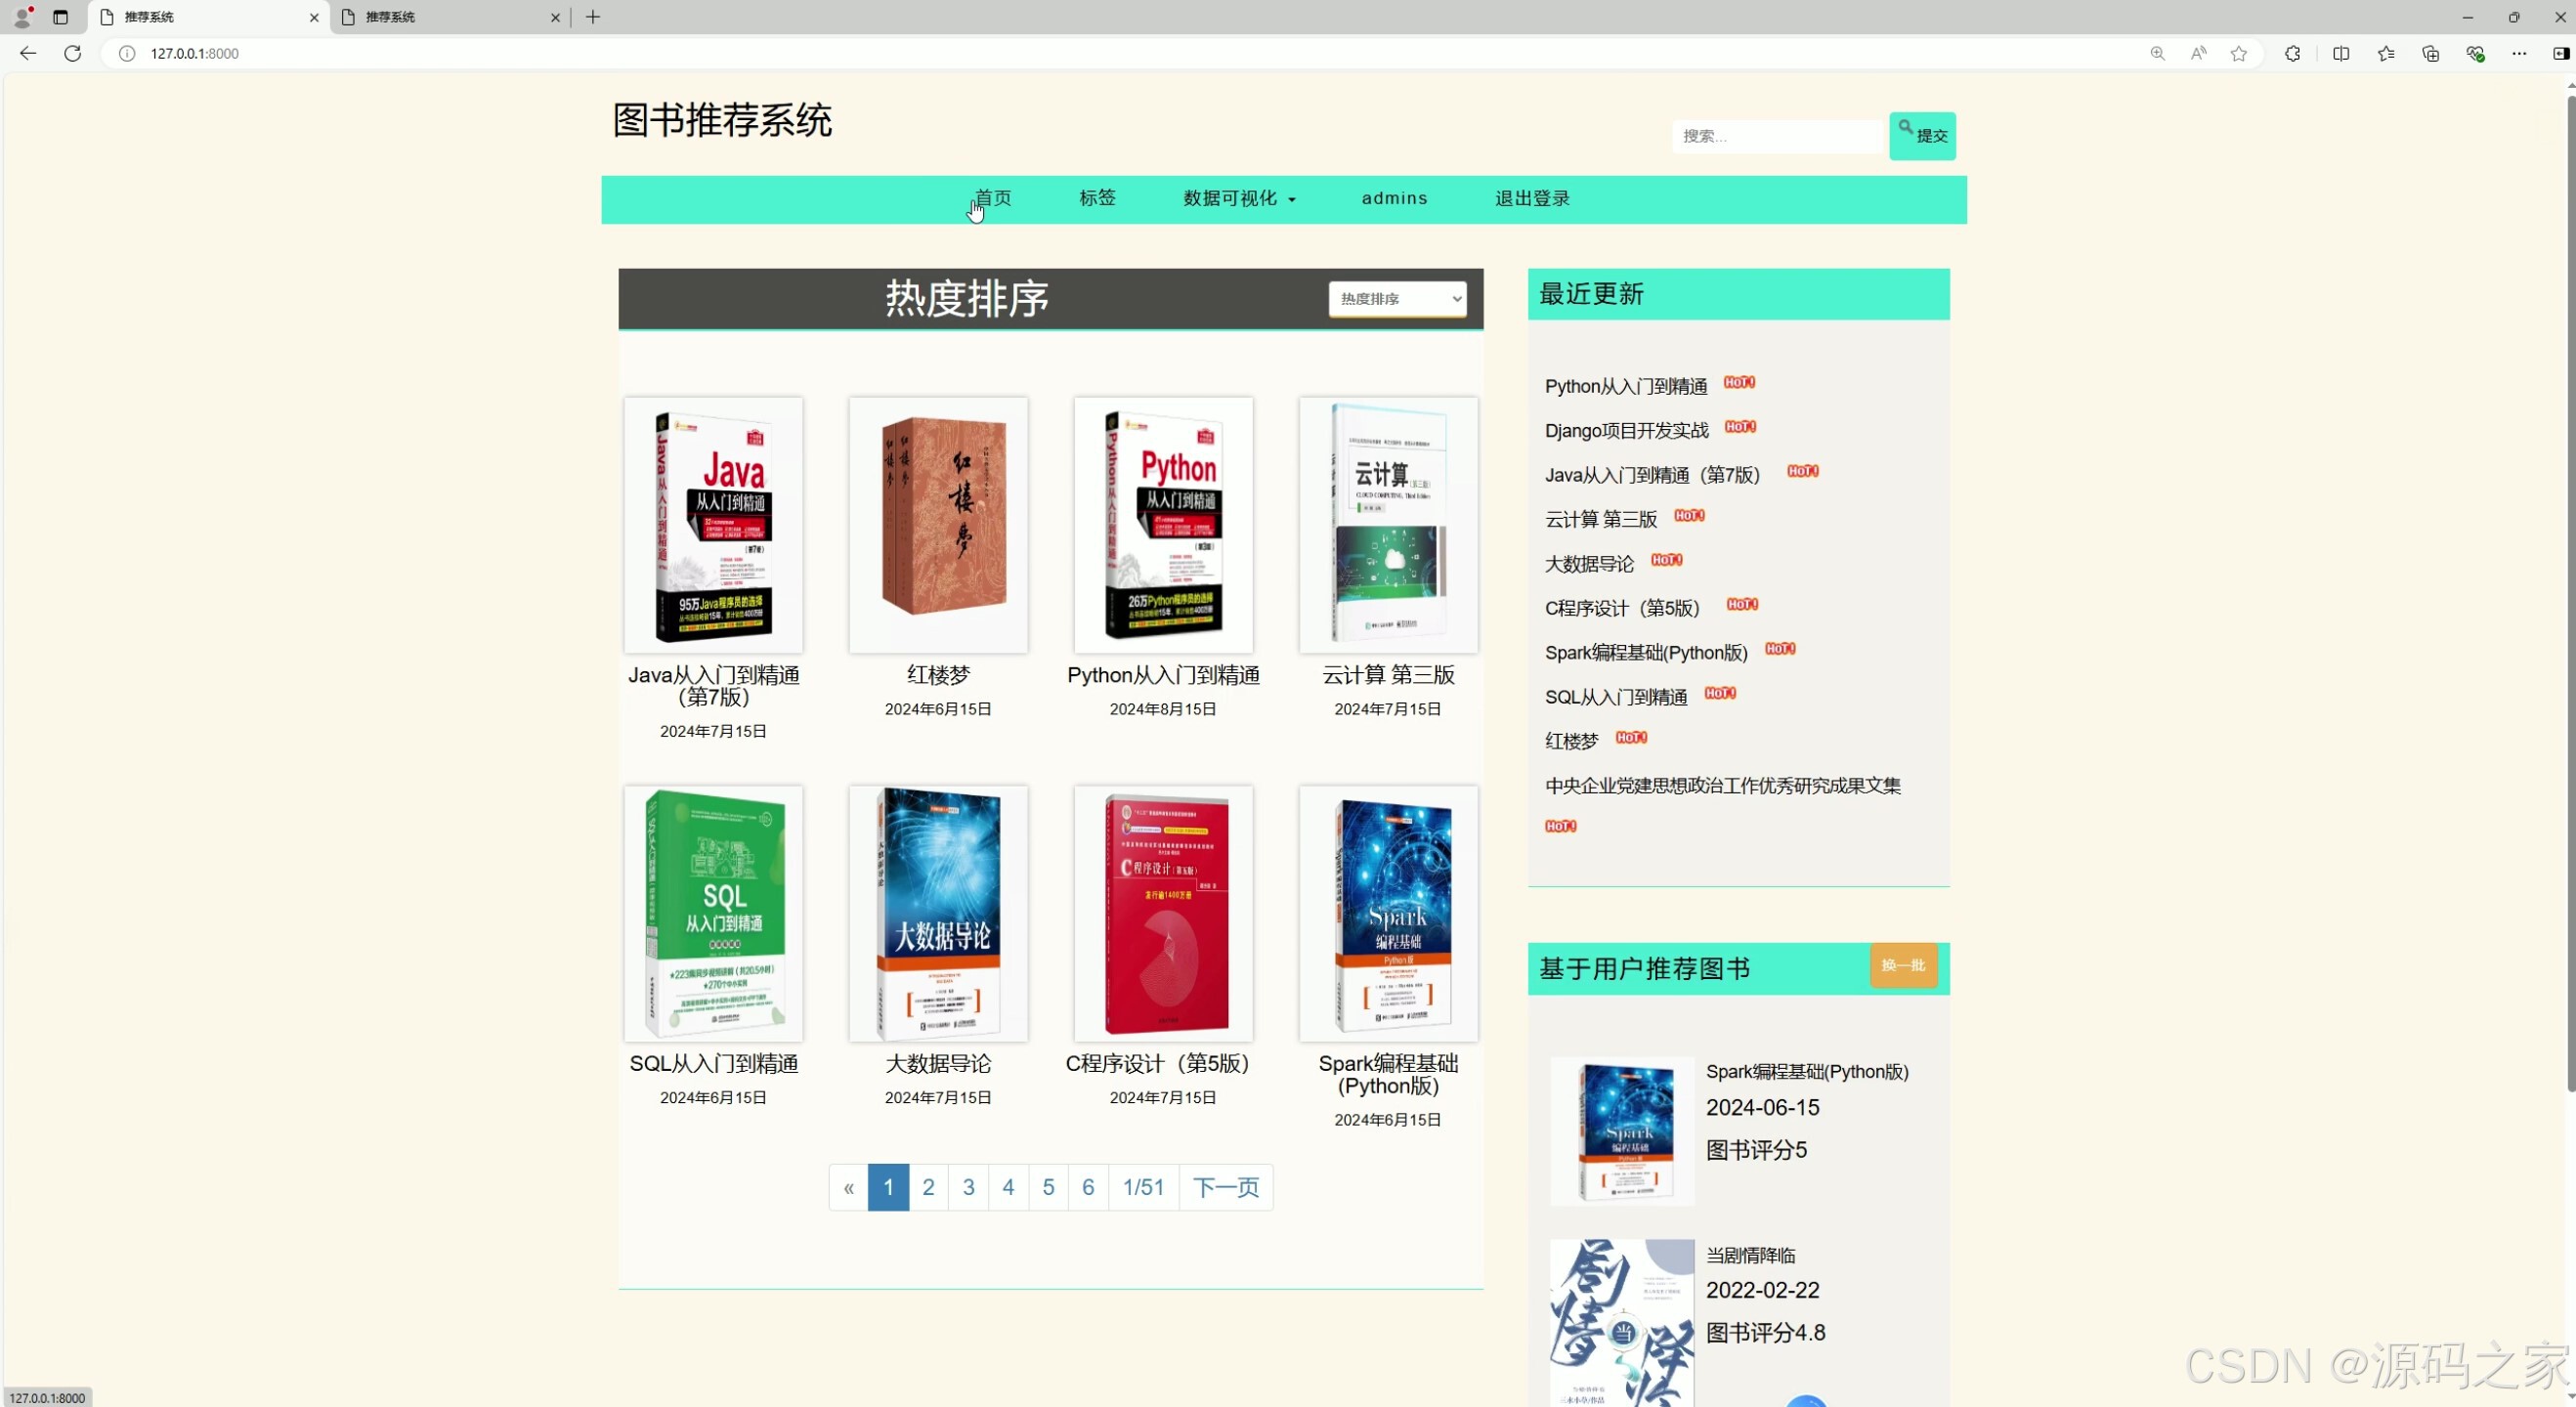
(2)图书信息列表
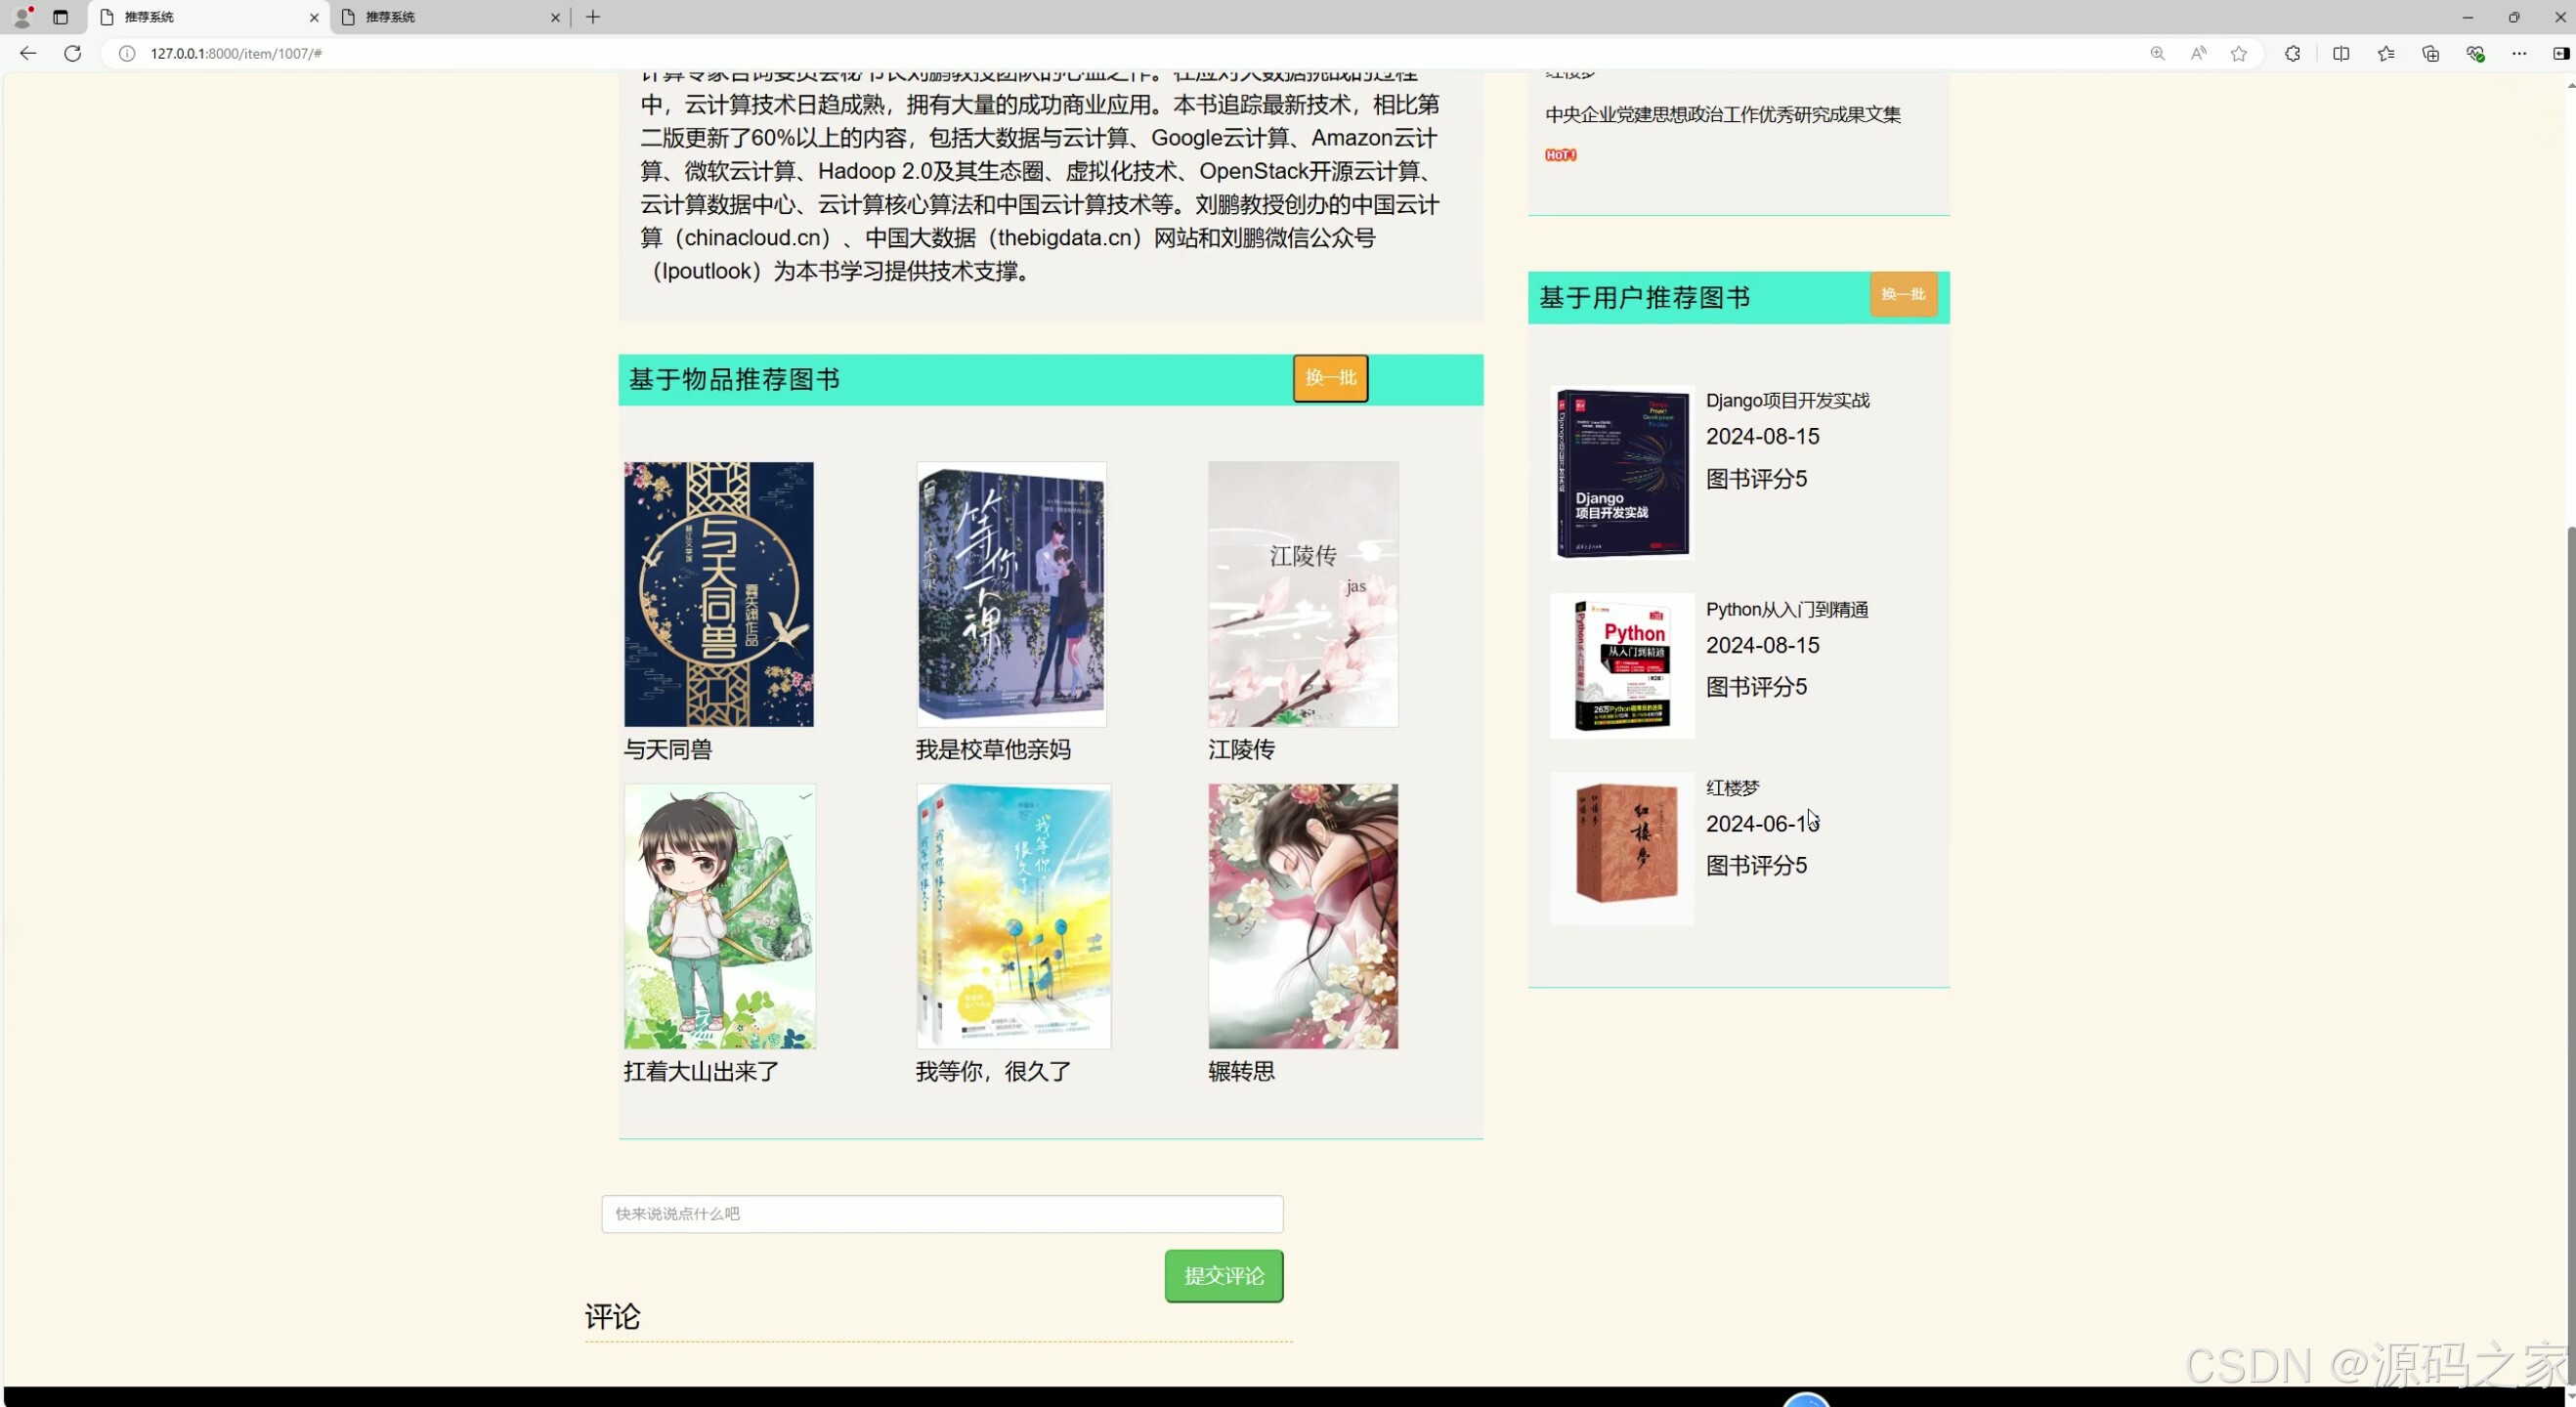
(3)图书推荐(基于用户+基于图书)
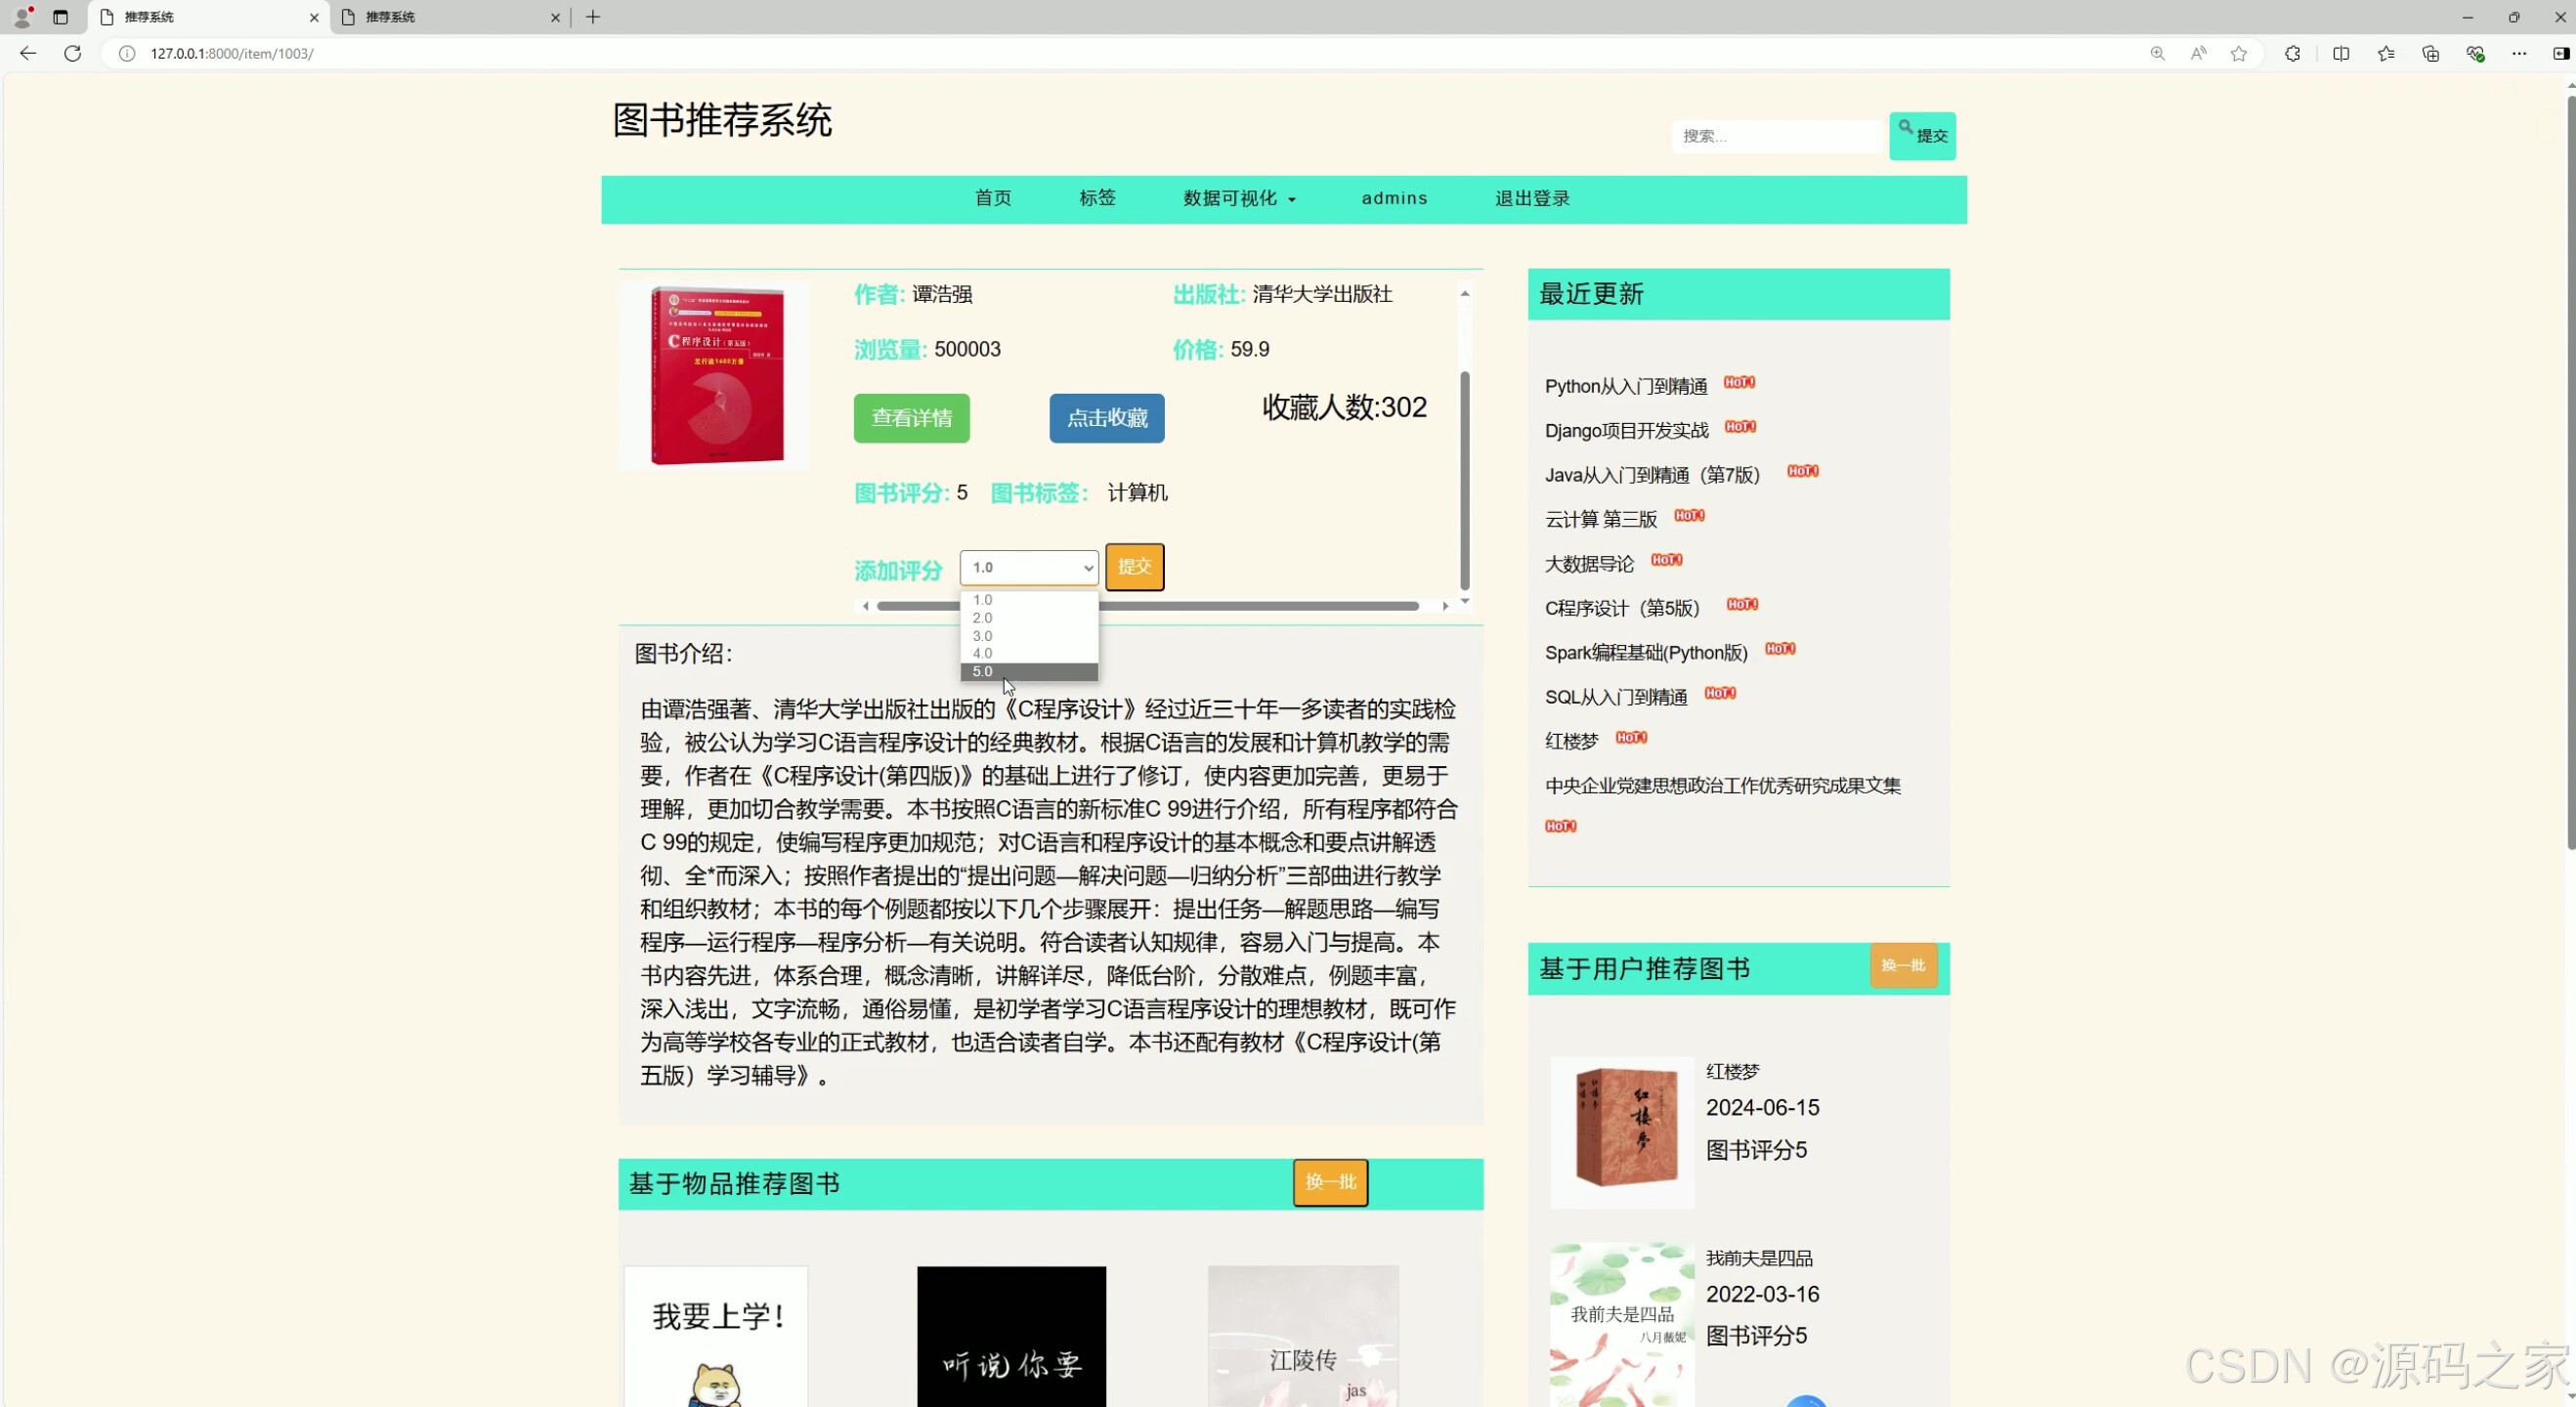
(4)图书点赞收藏、评分
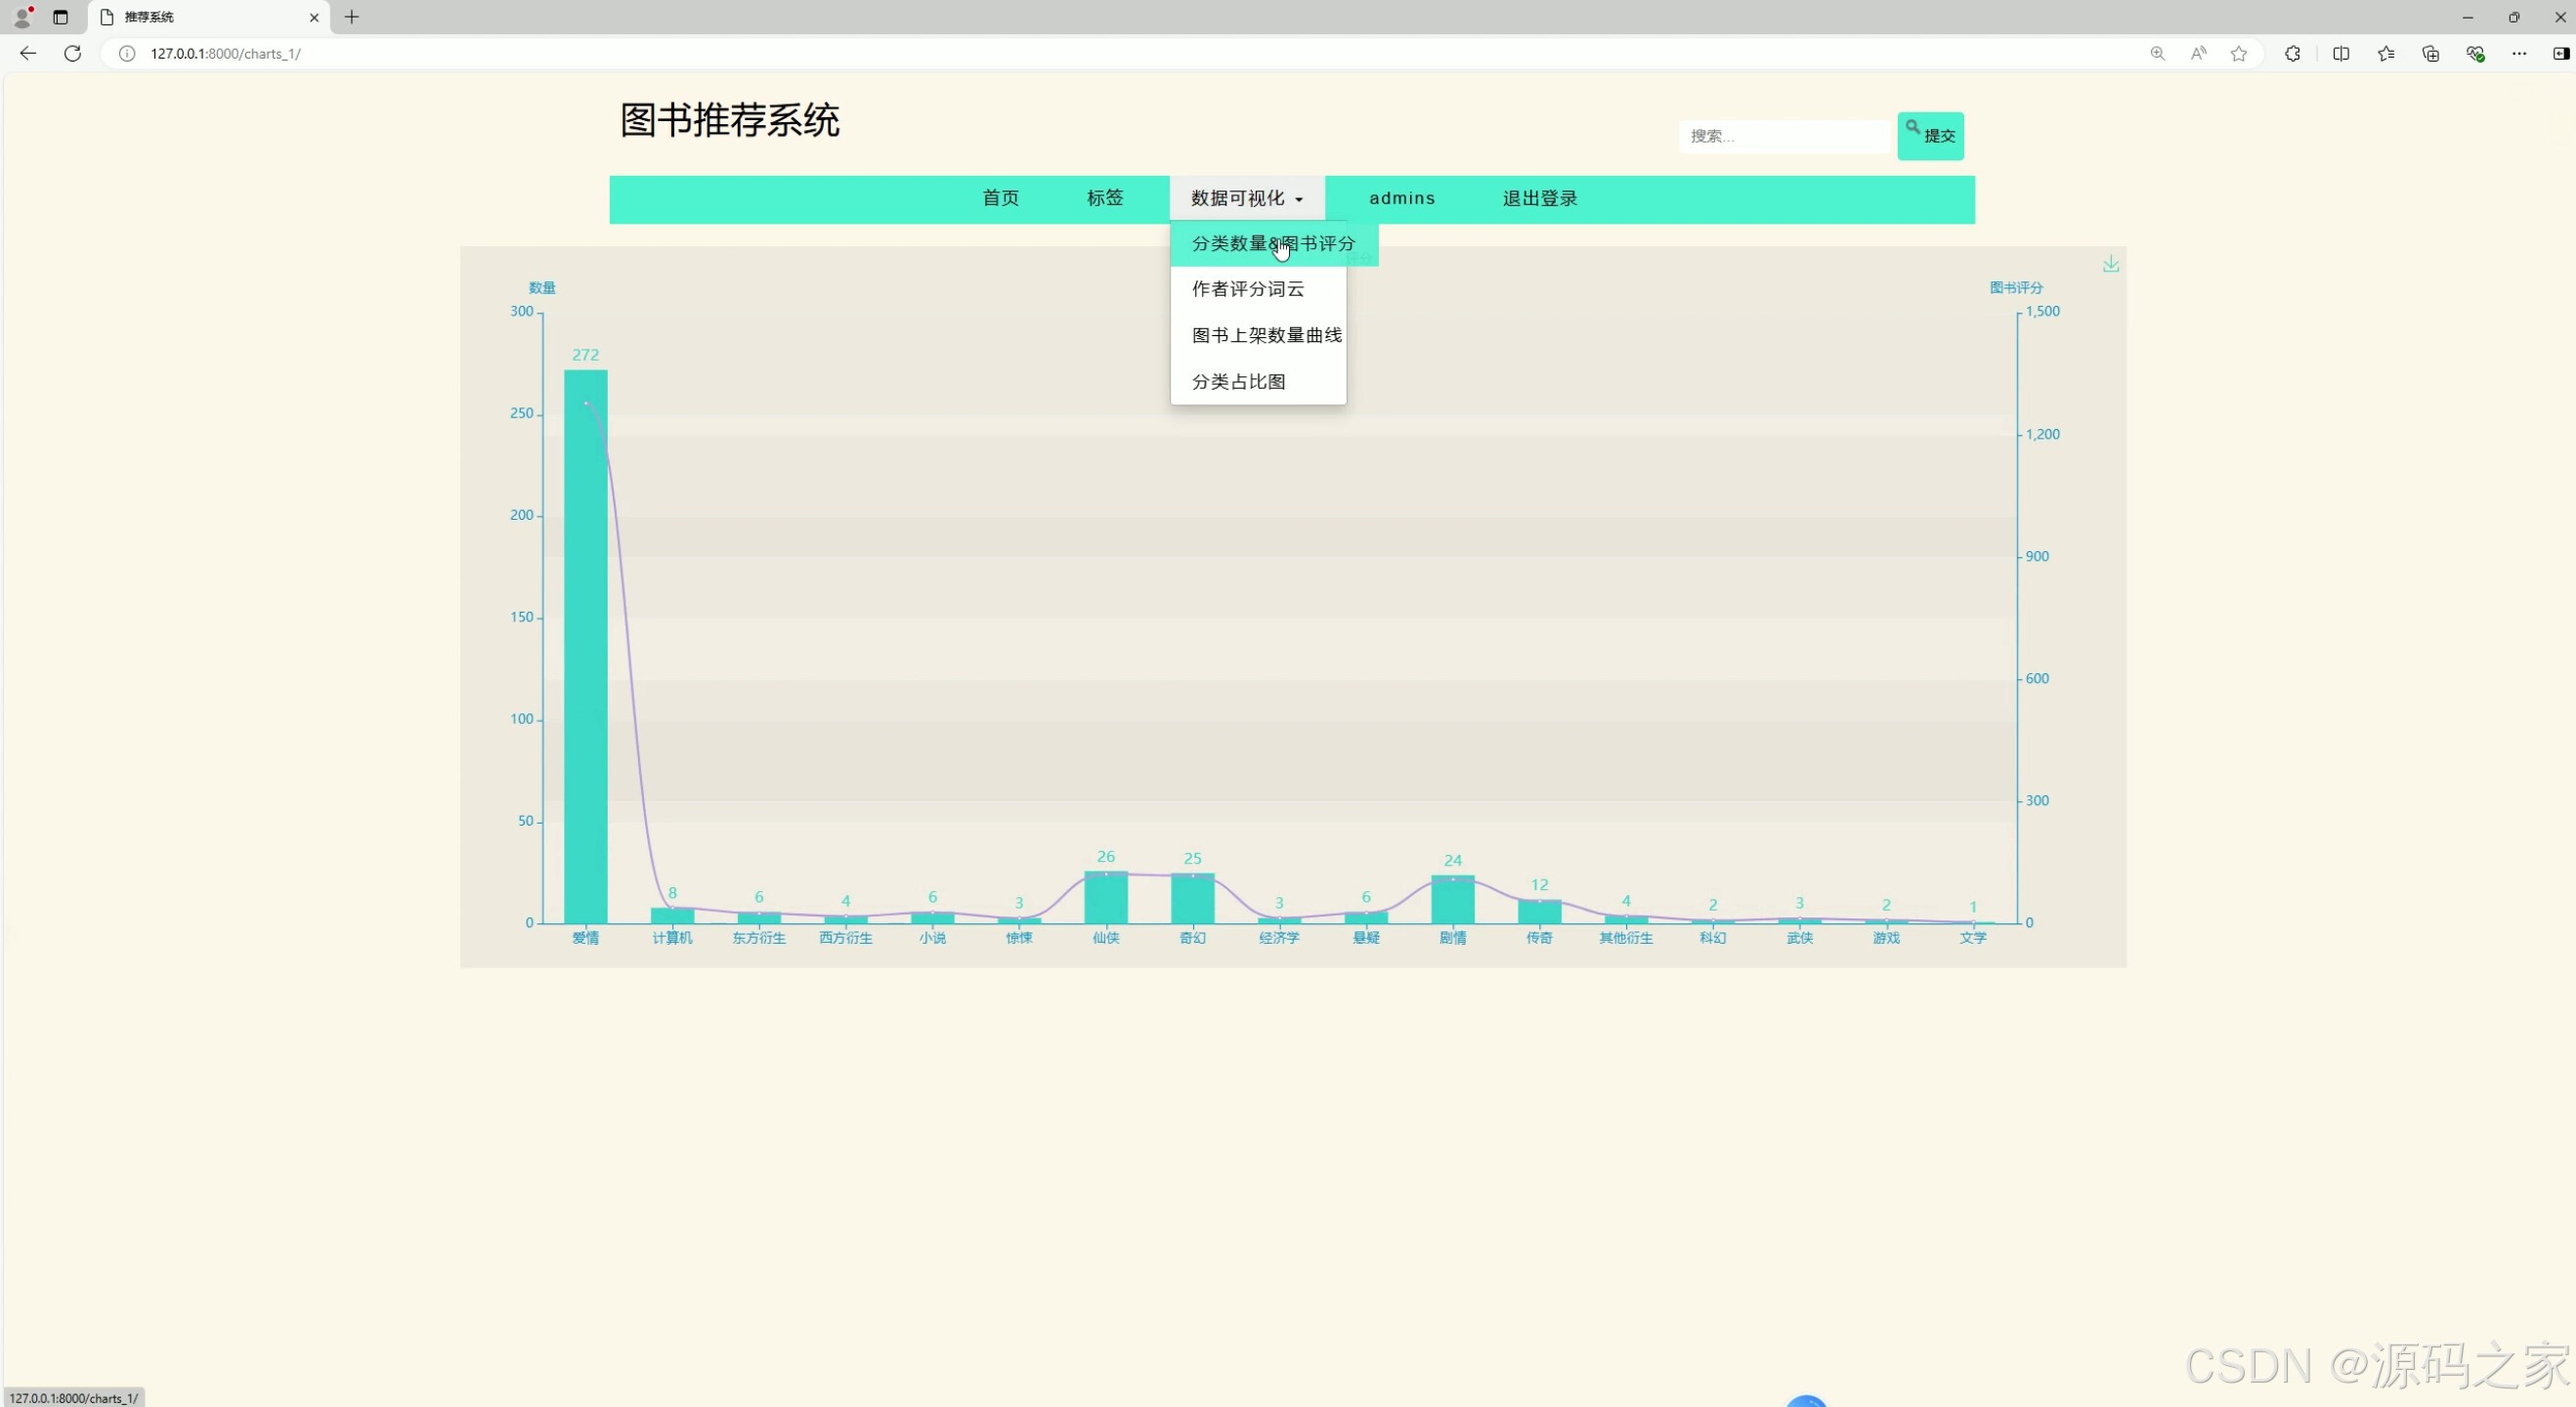
(5)可视化分析1----图书分类数量与图书评分
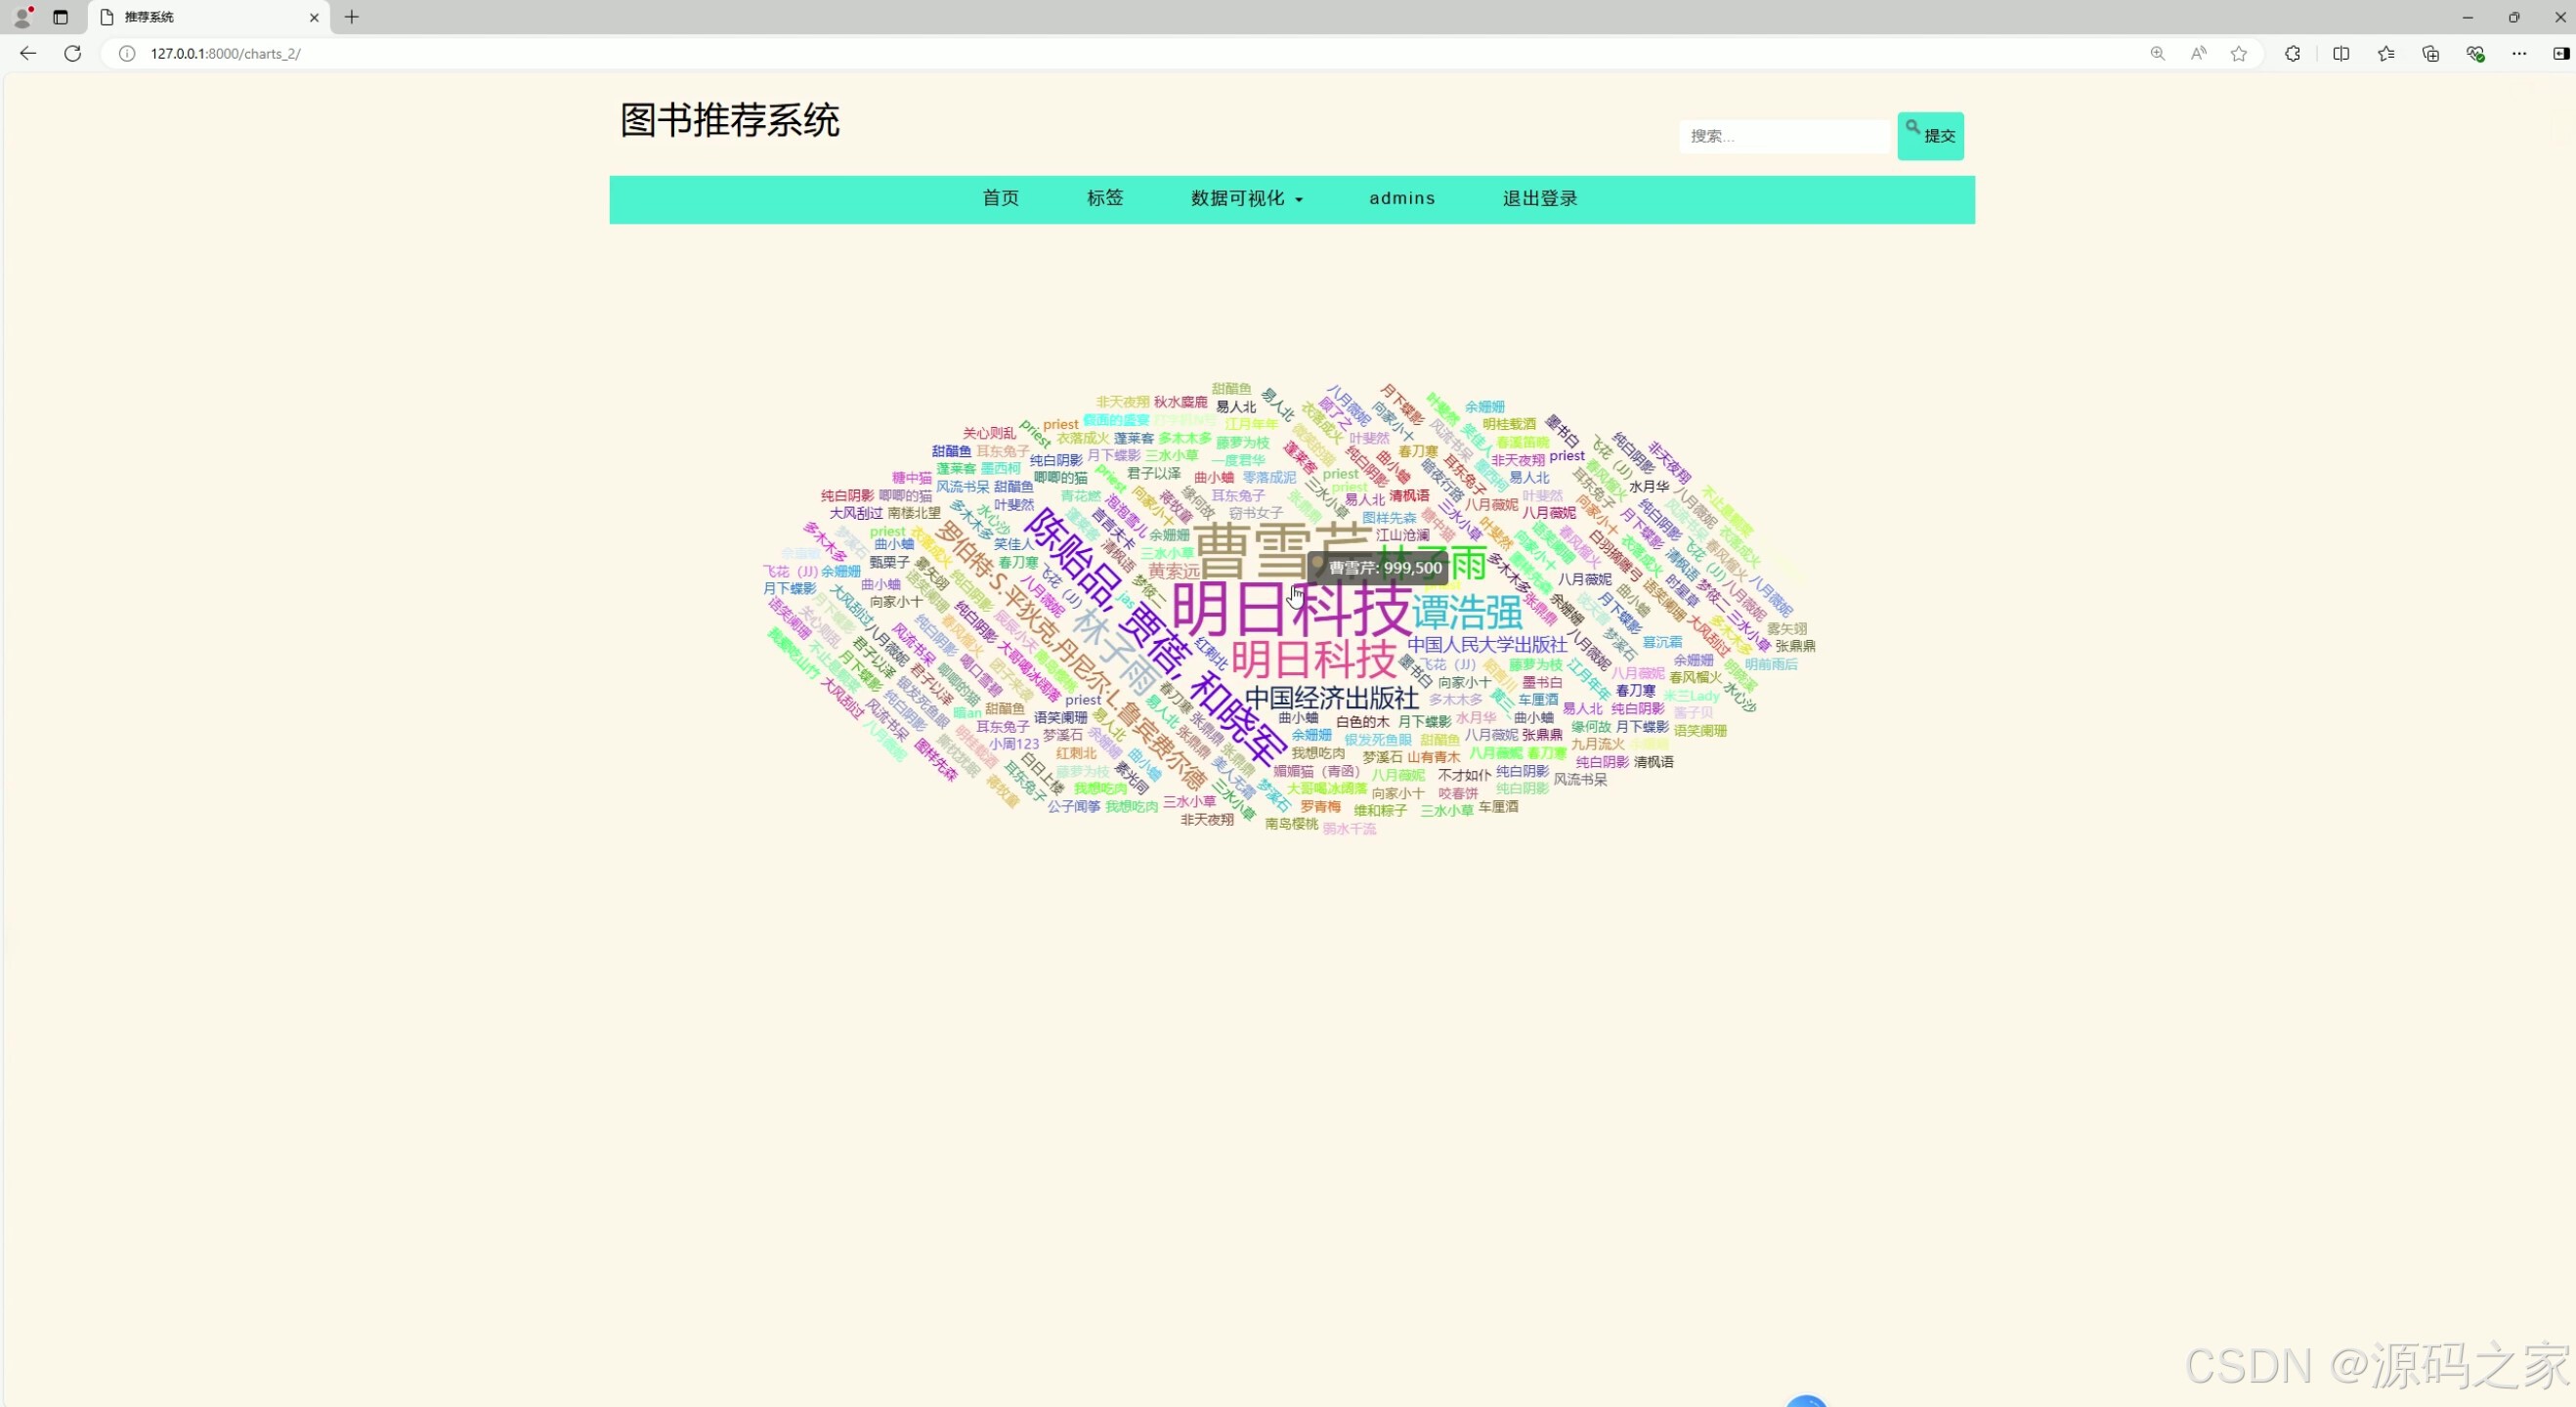
(6)可视化分析2----词云图分析
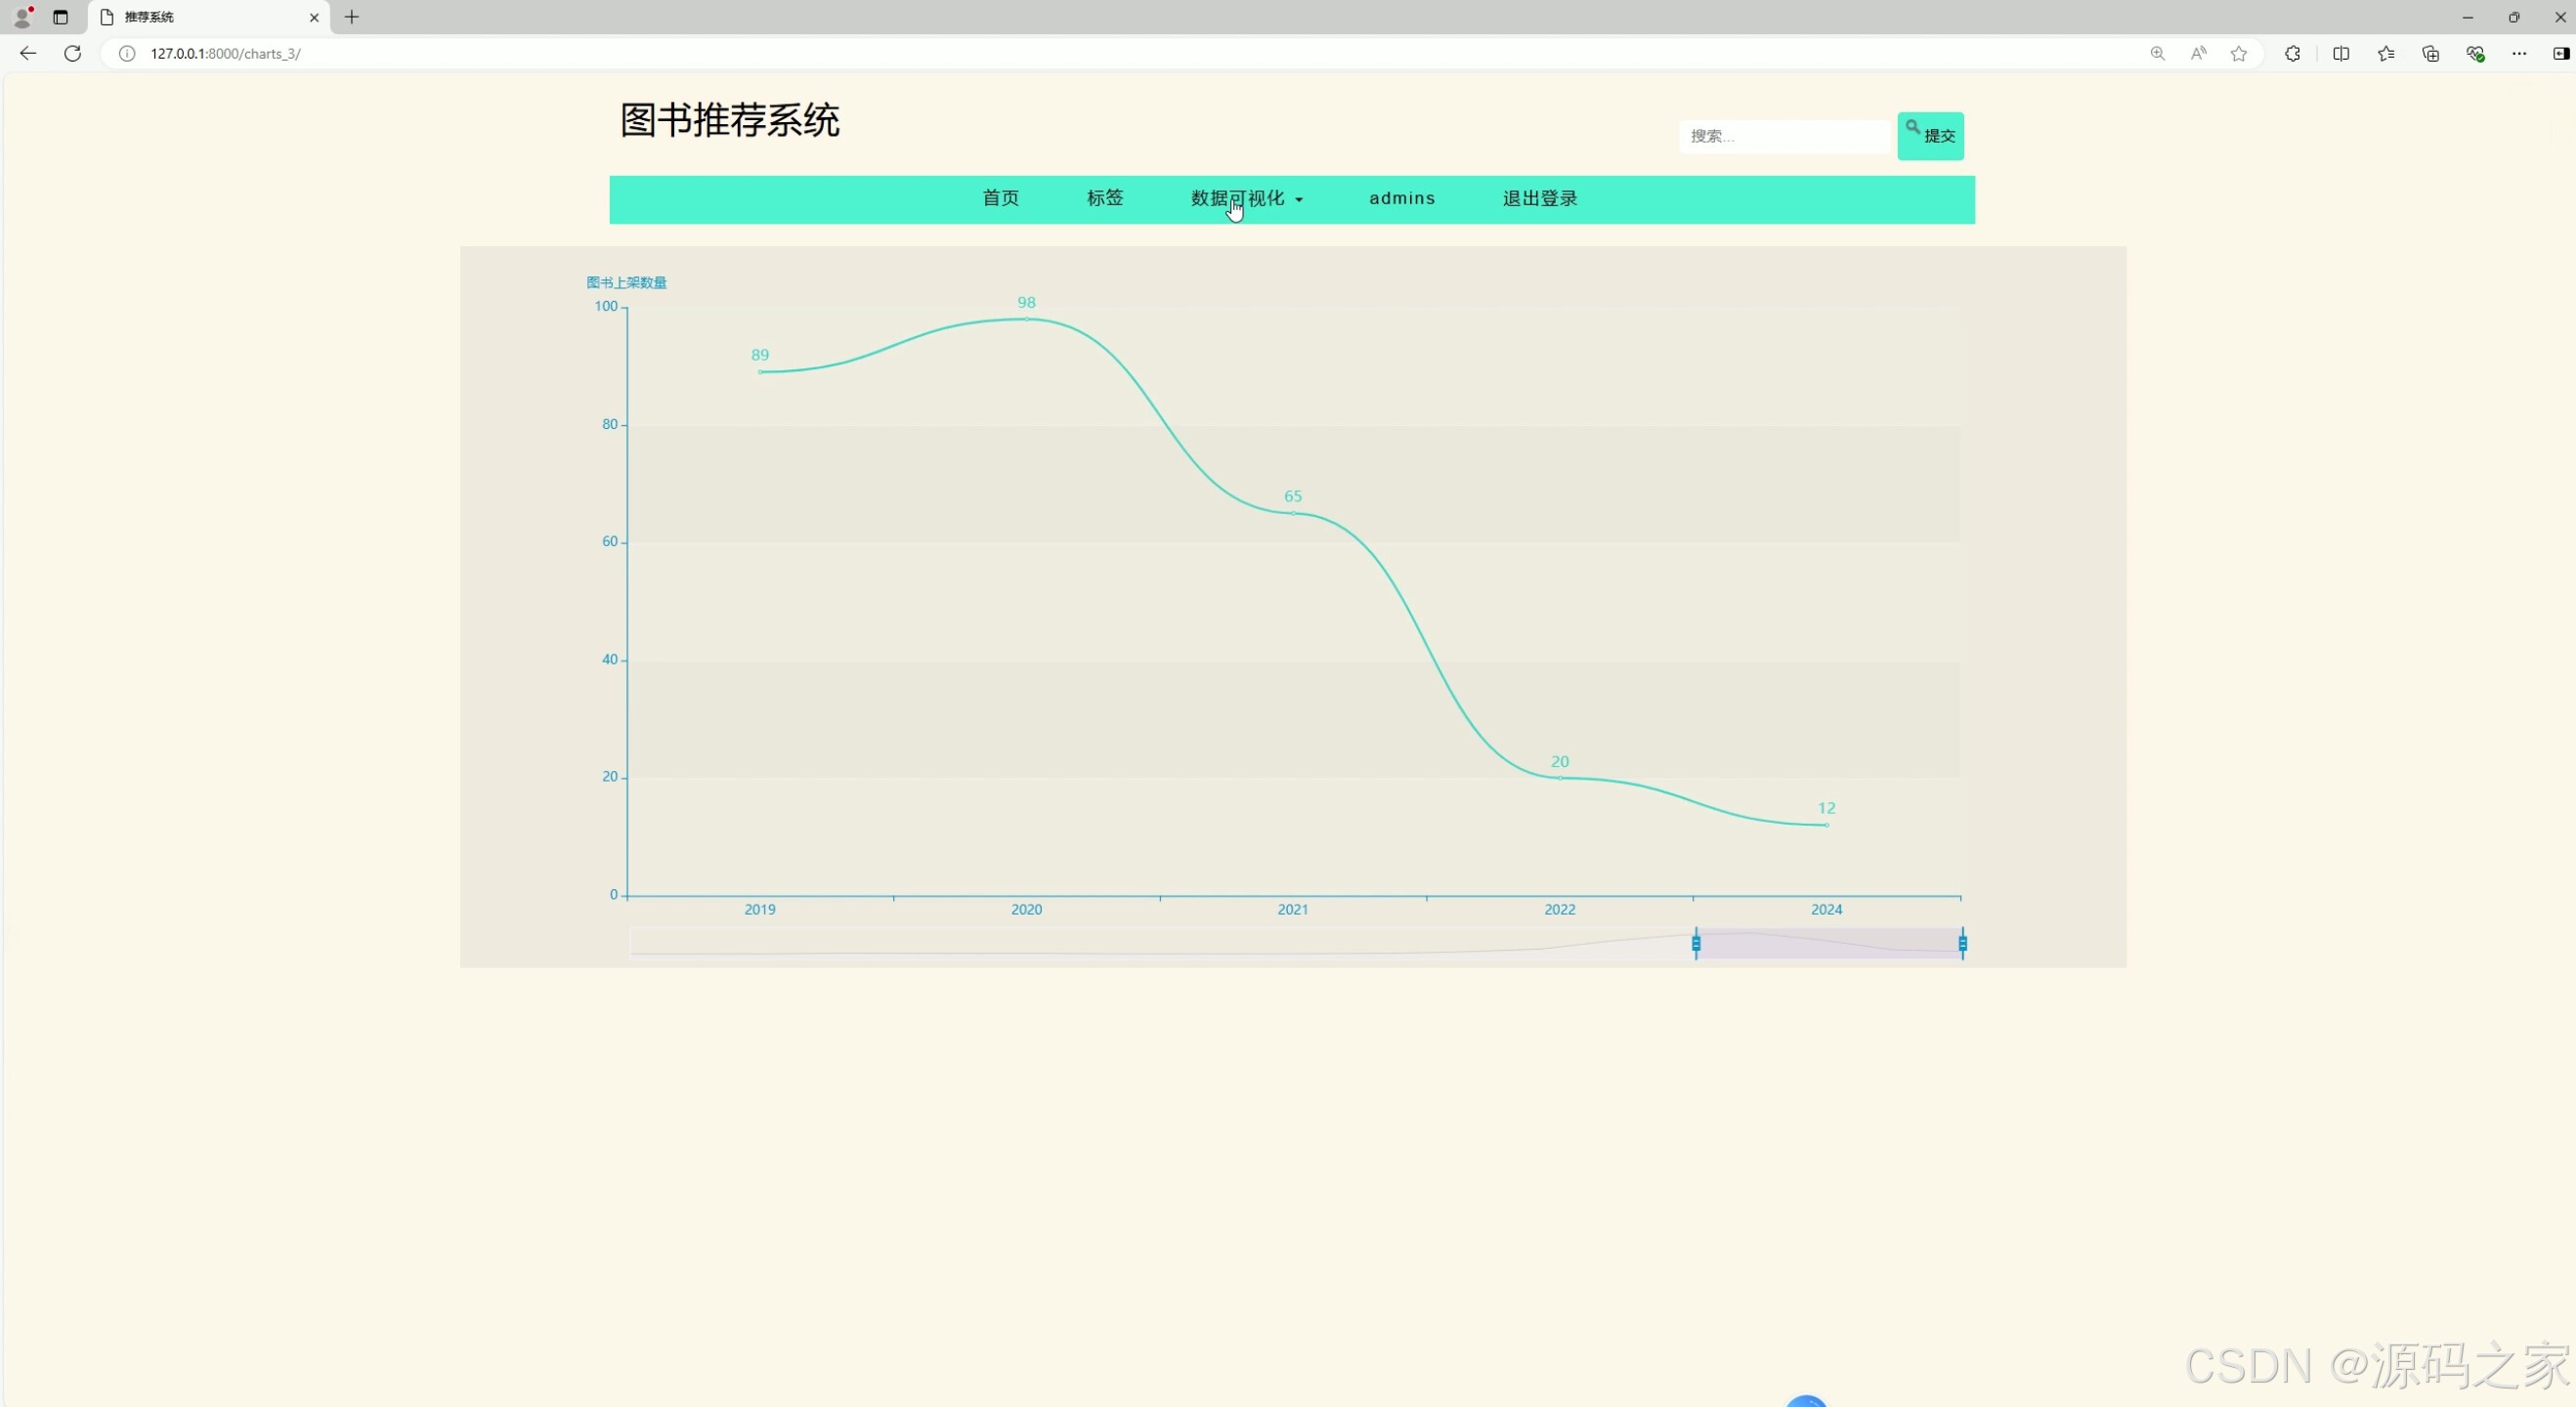
(7)图书上架数量分析
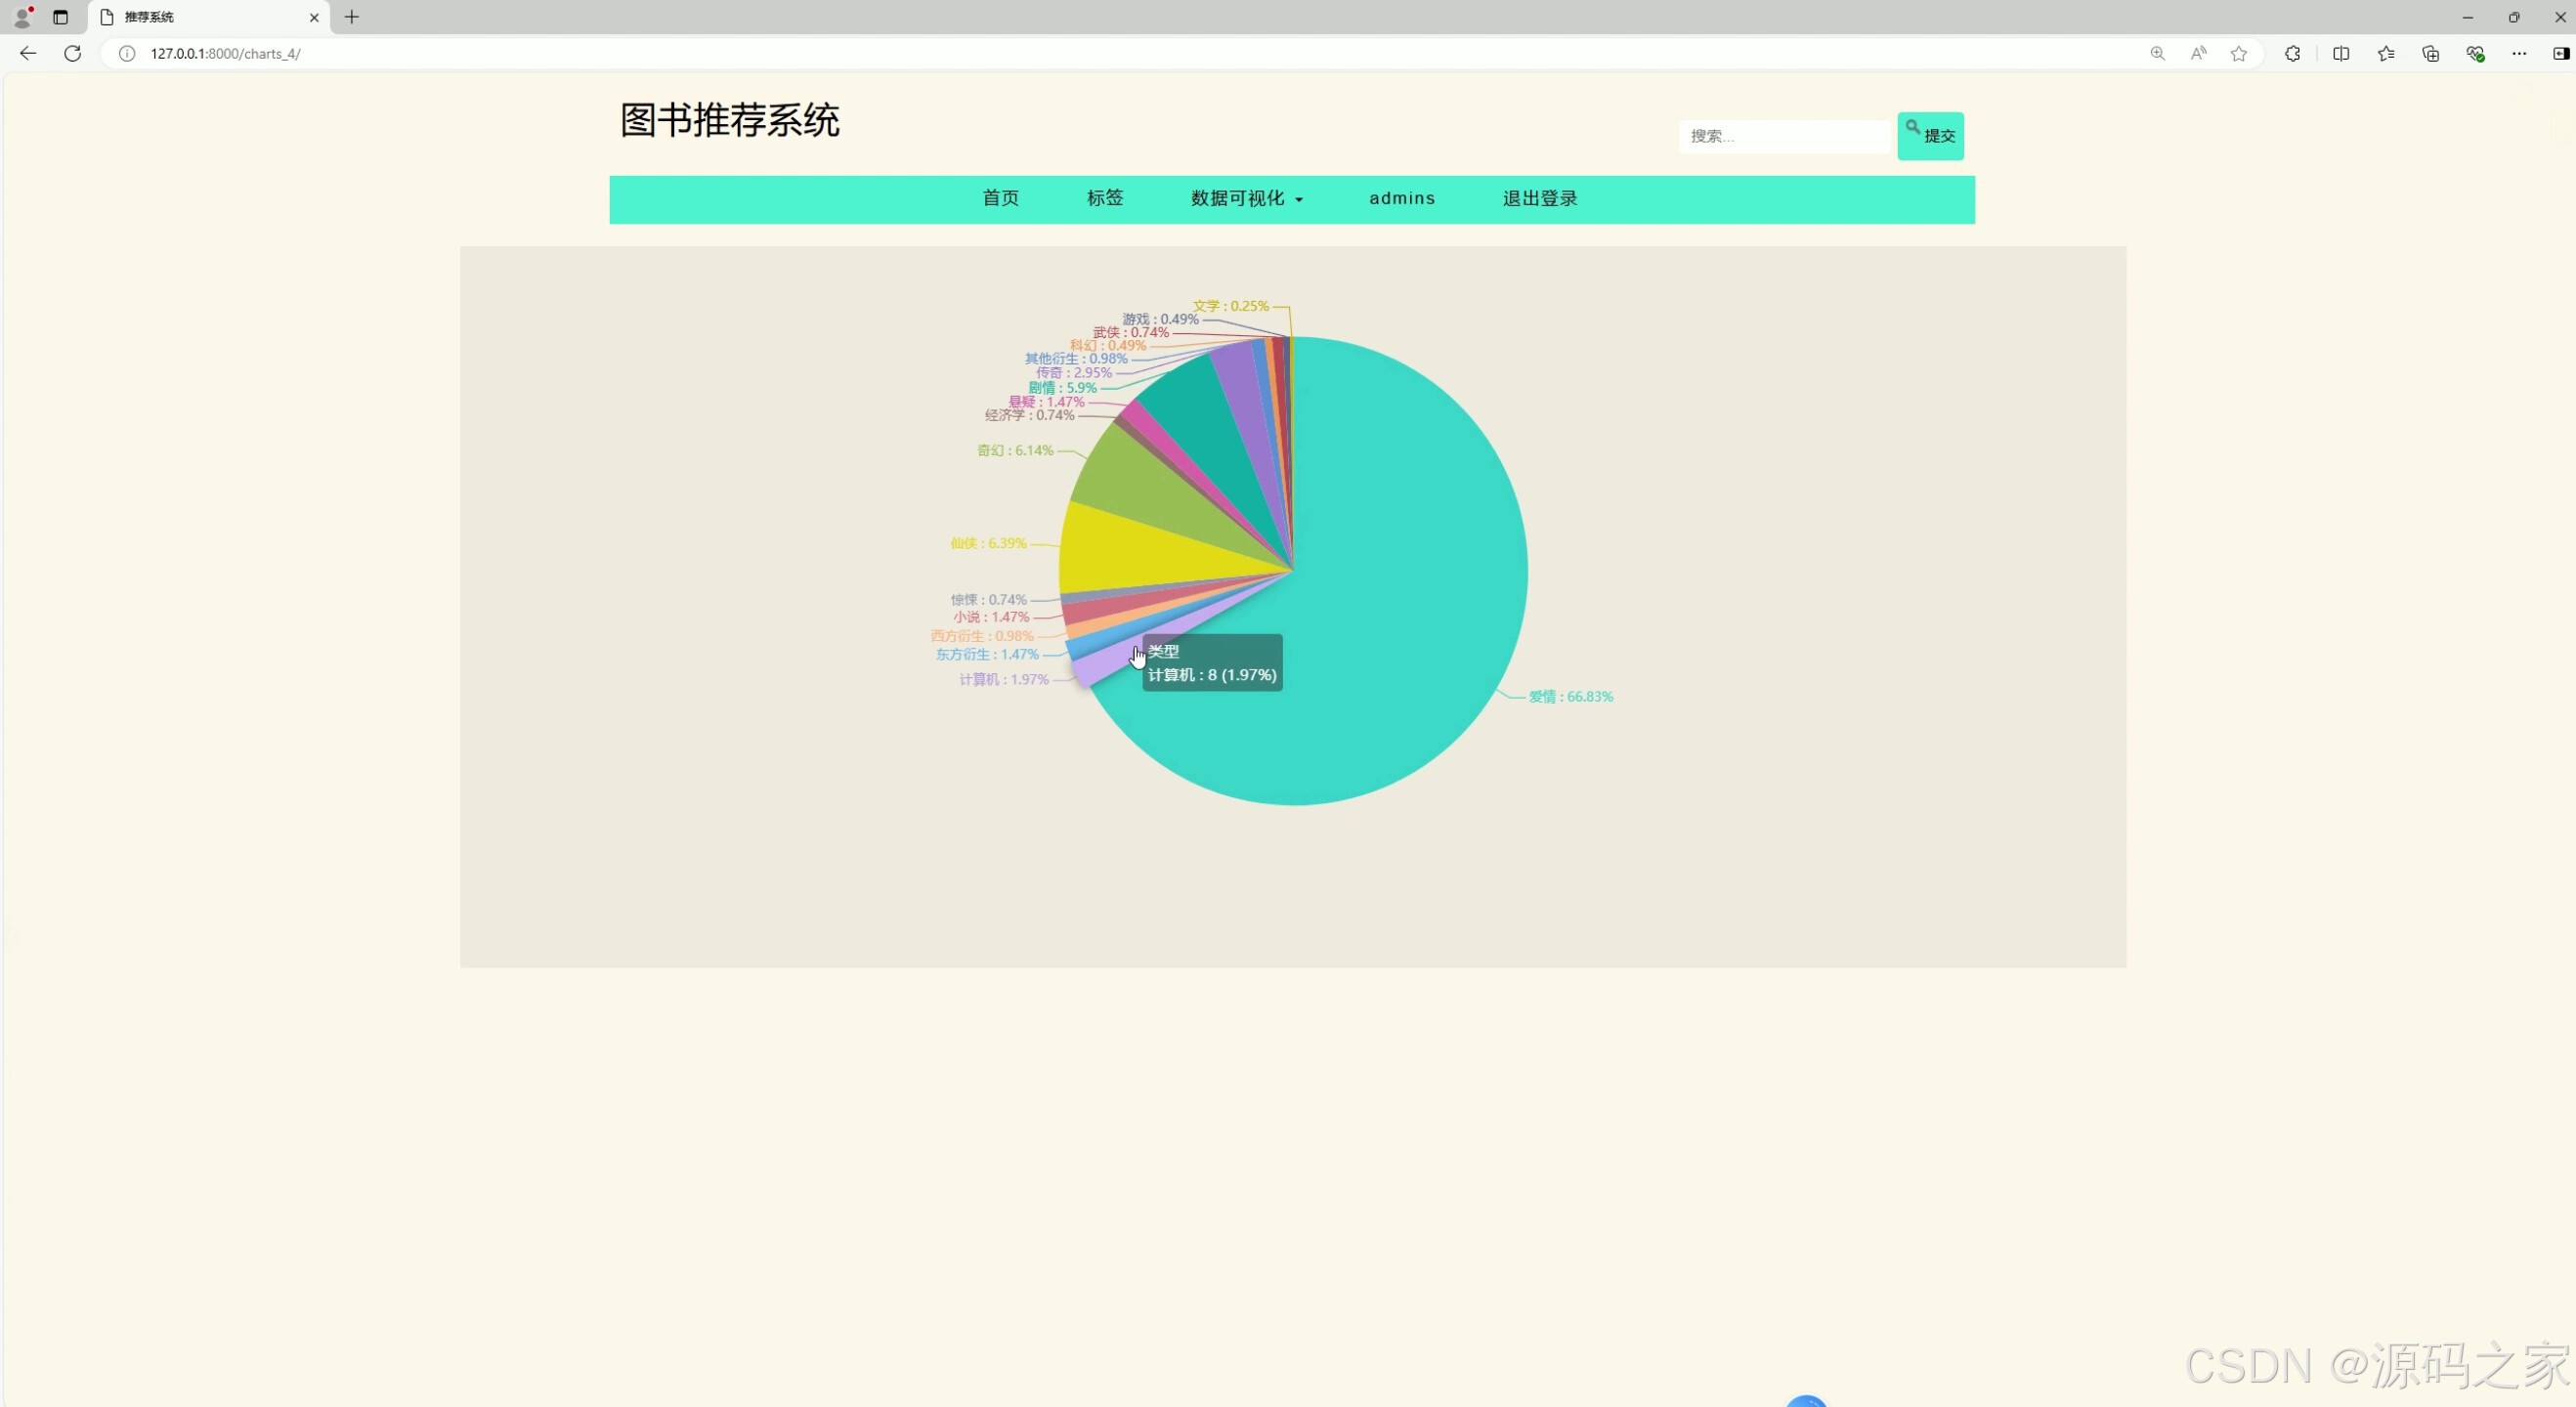
(8)图书类型占比分析
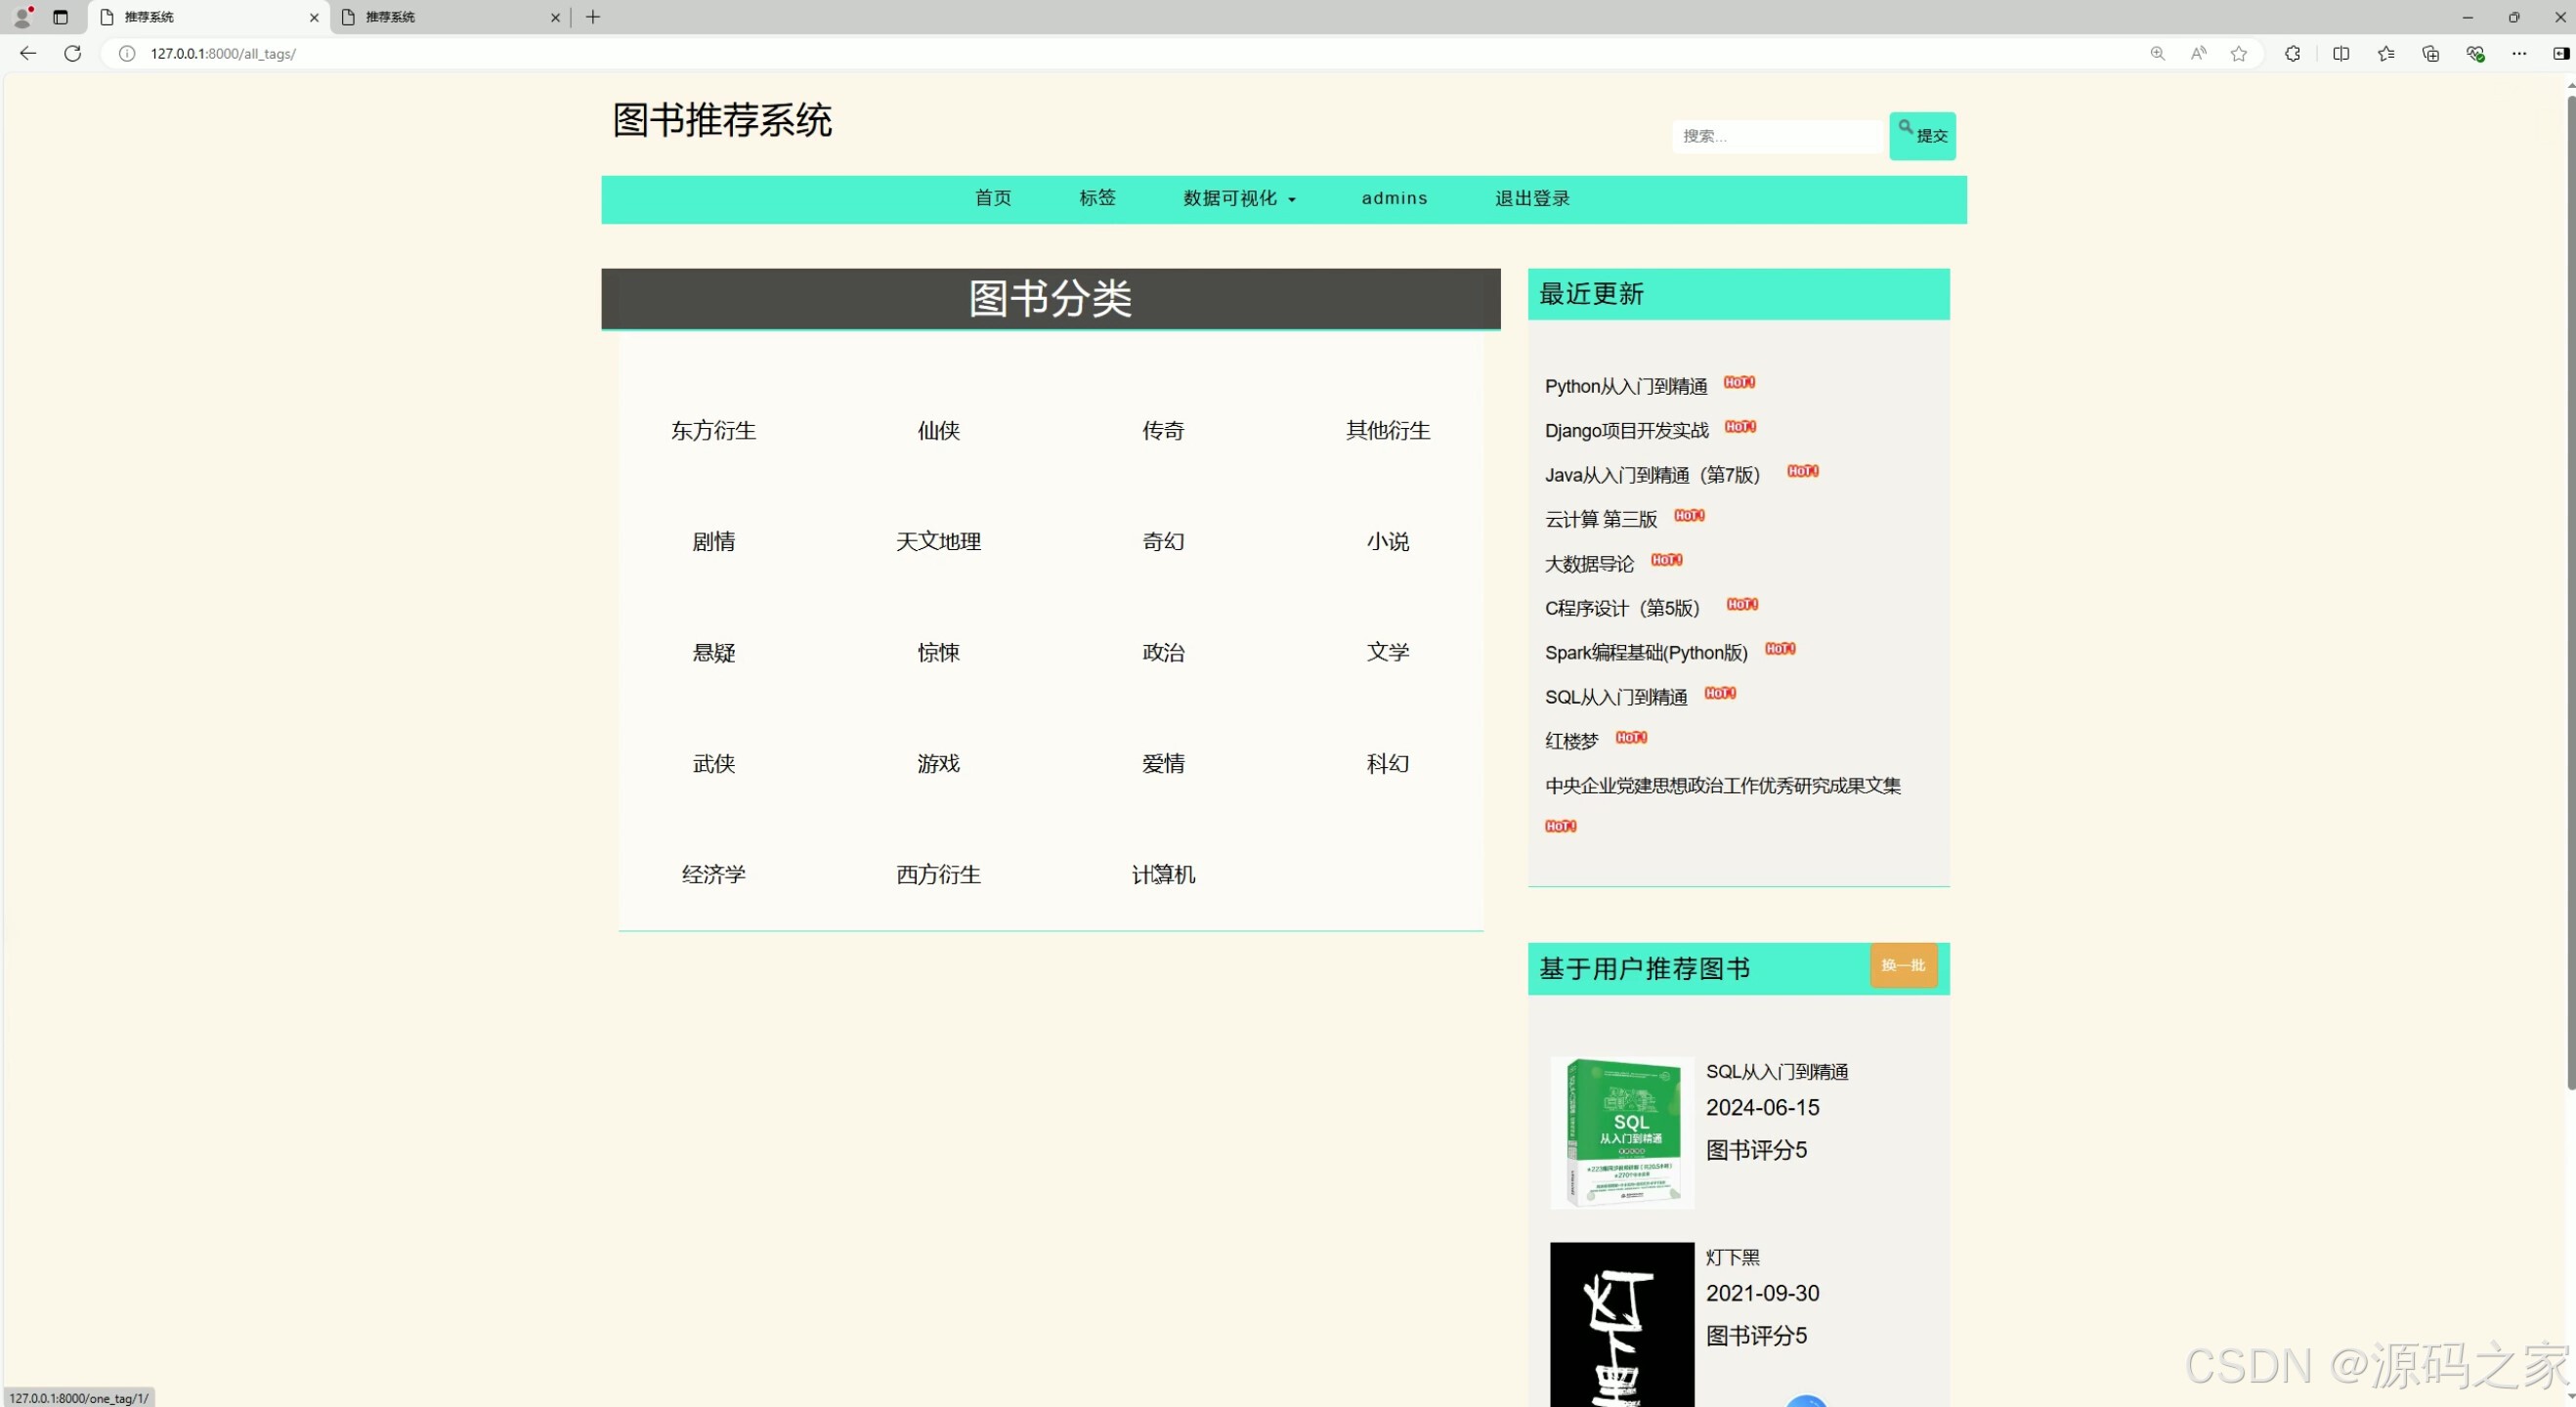
(9)图书分类
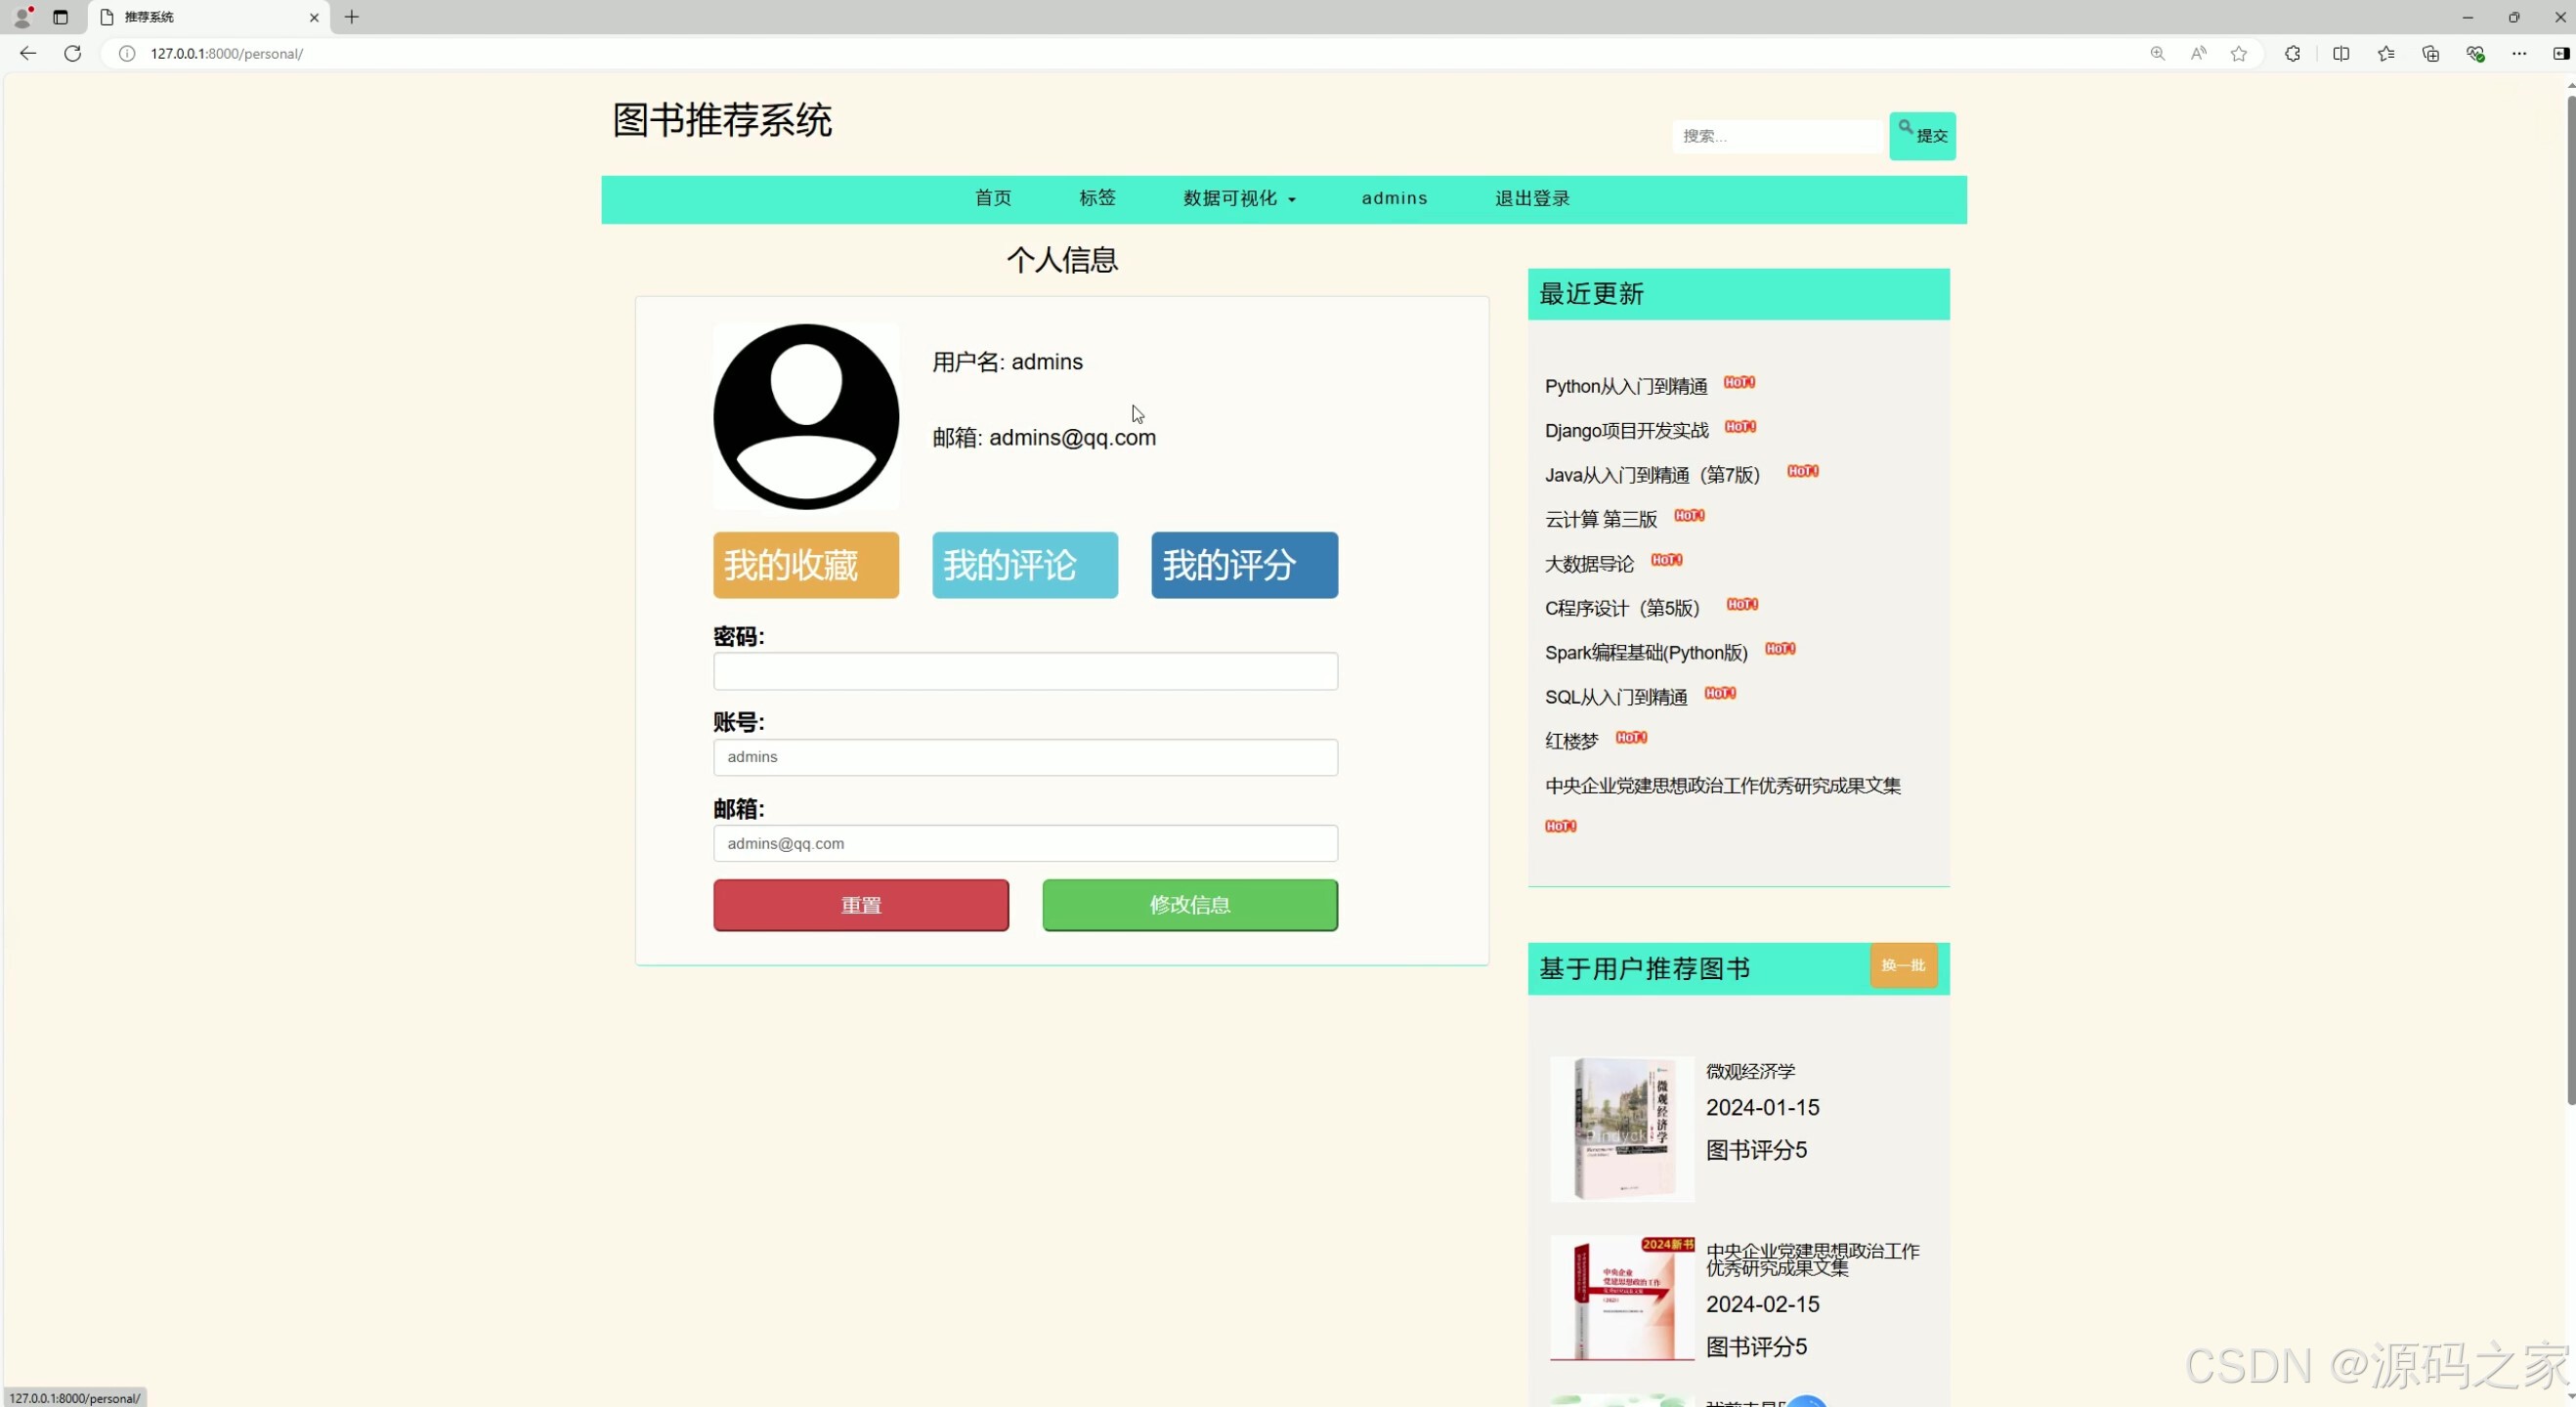
(10)个人信息-----我的收藏、评论、评分
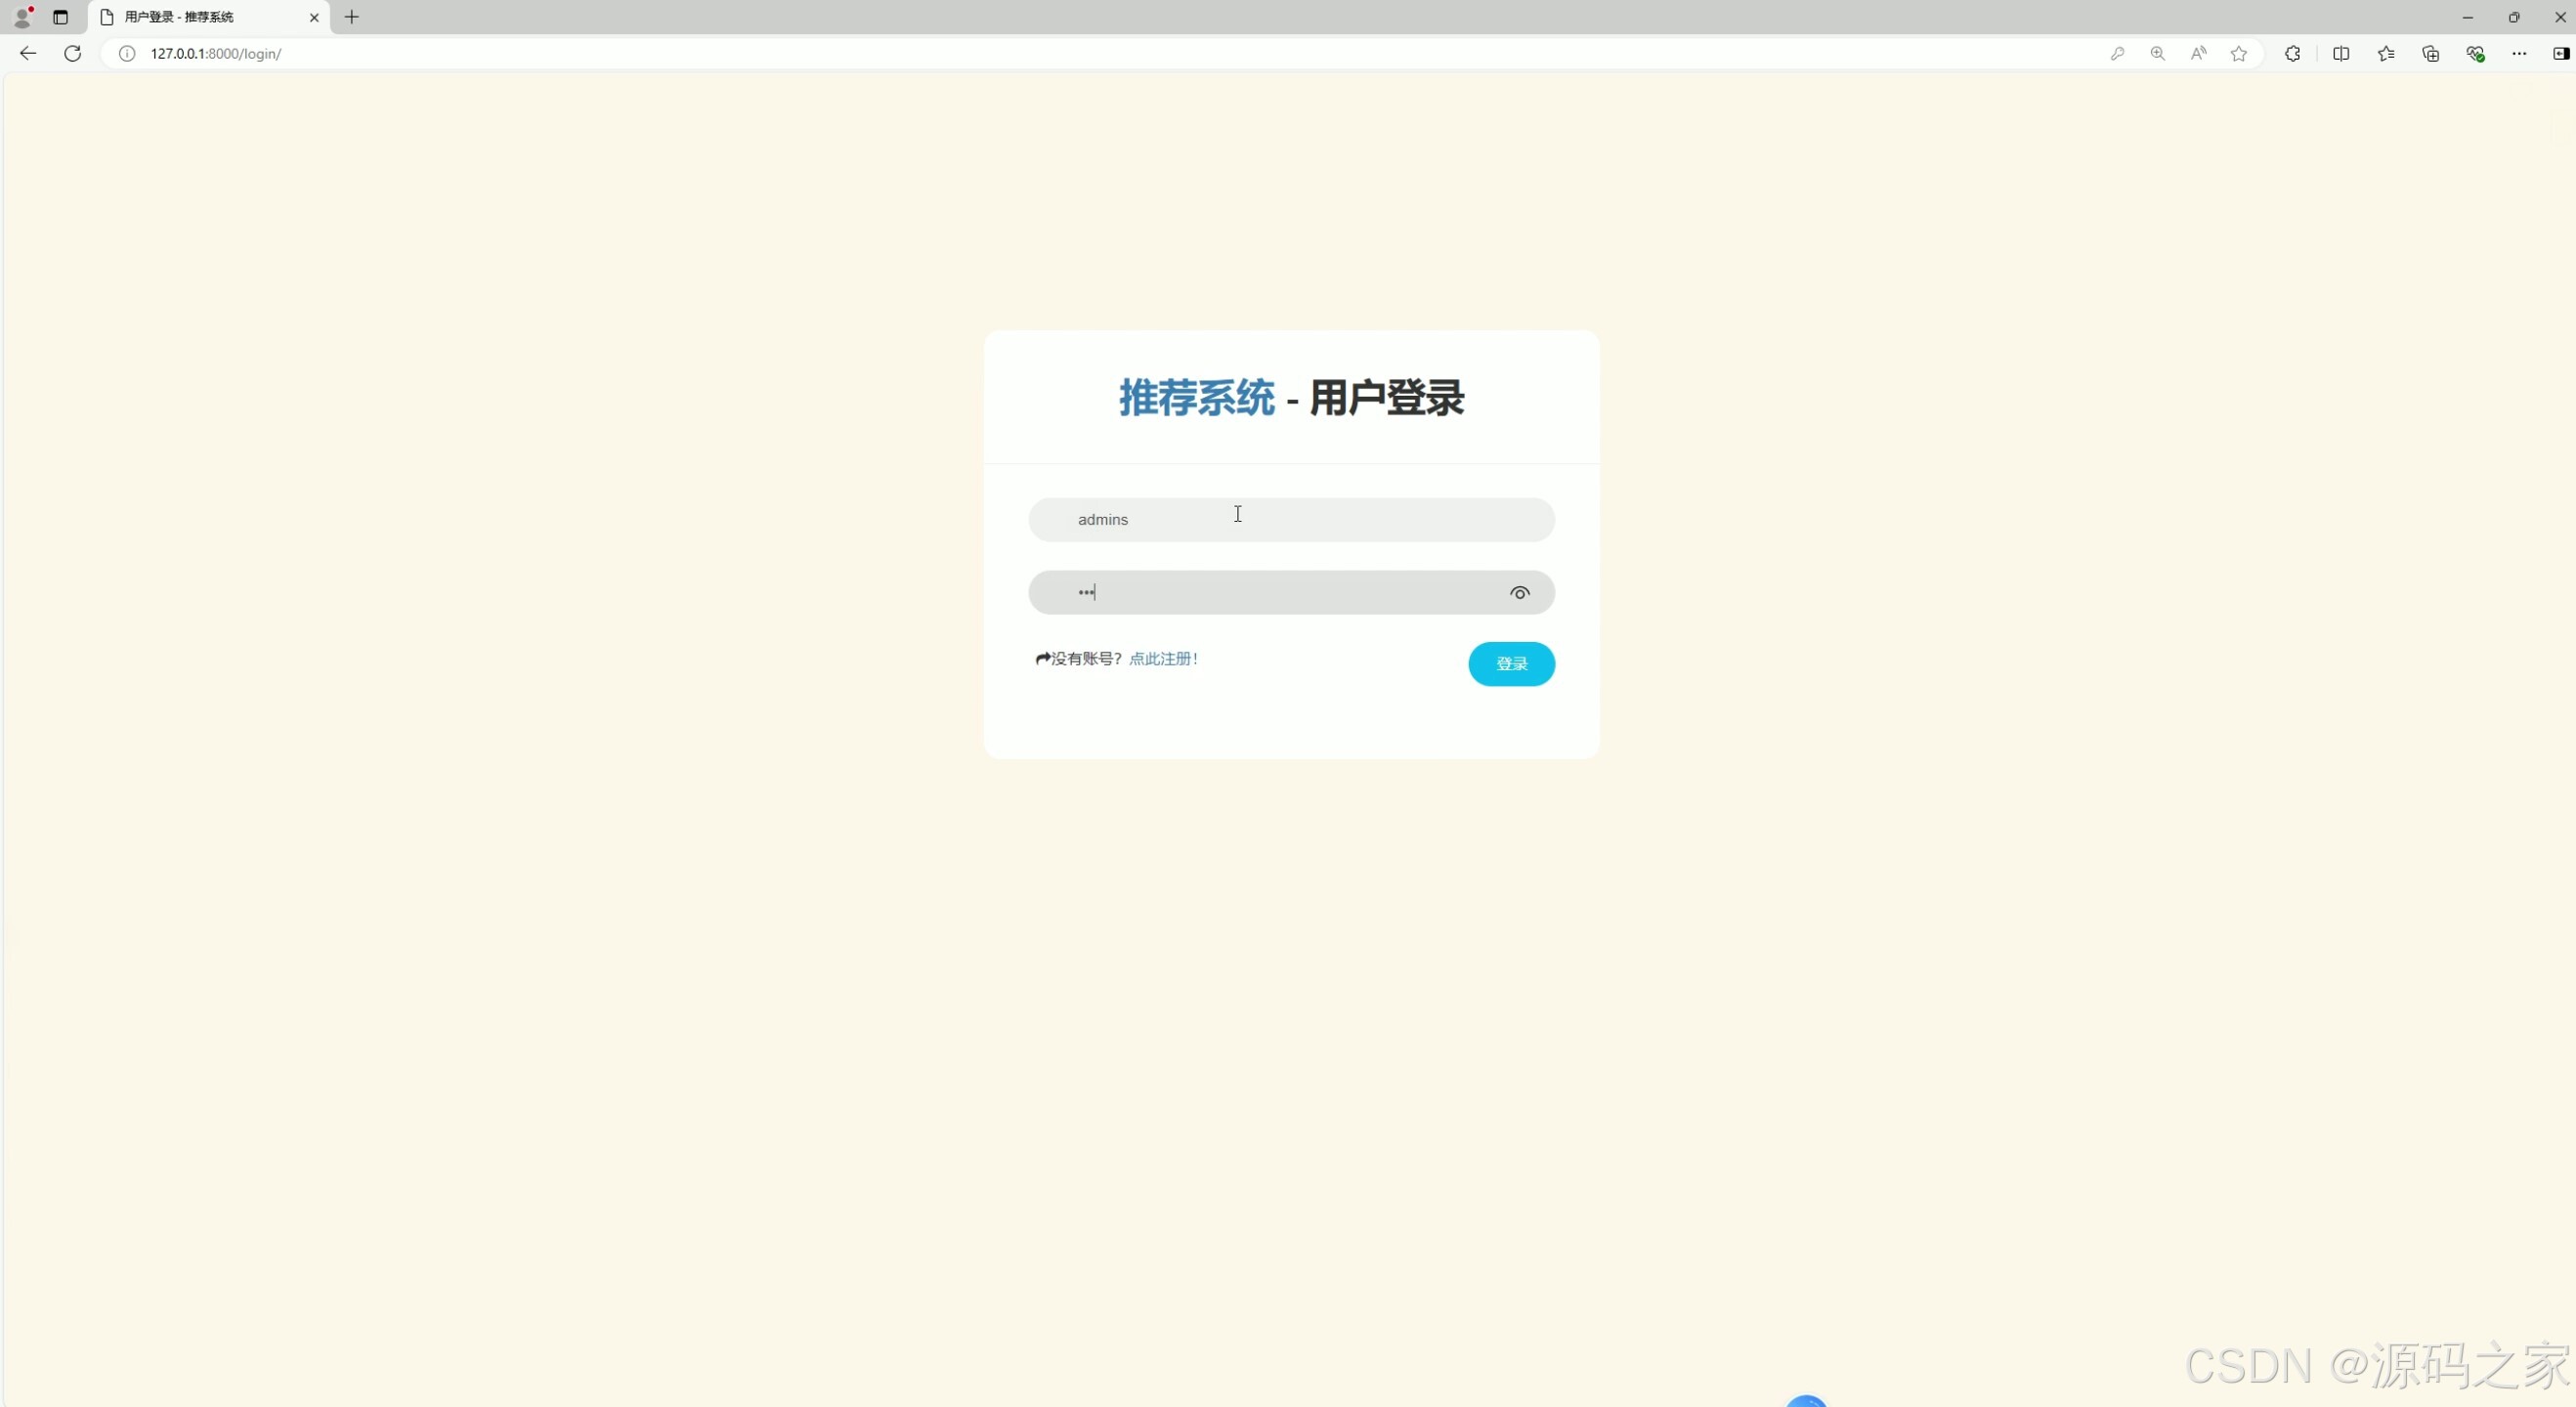
(11)注册登录
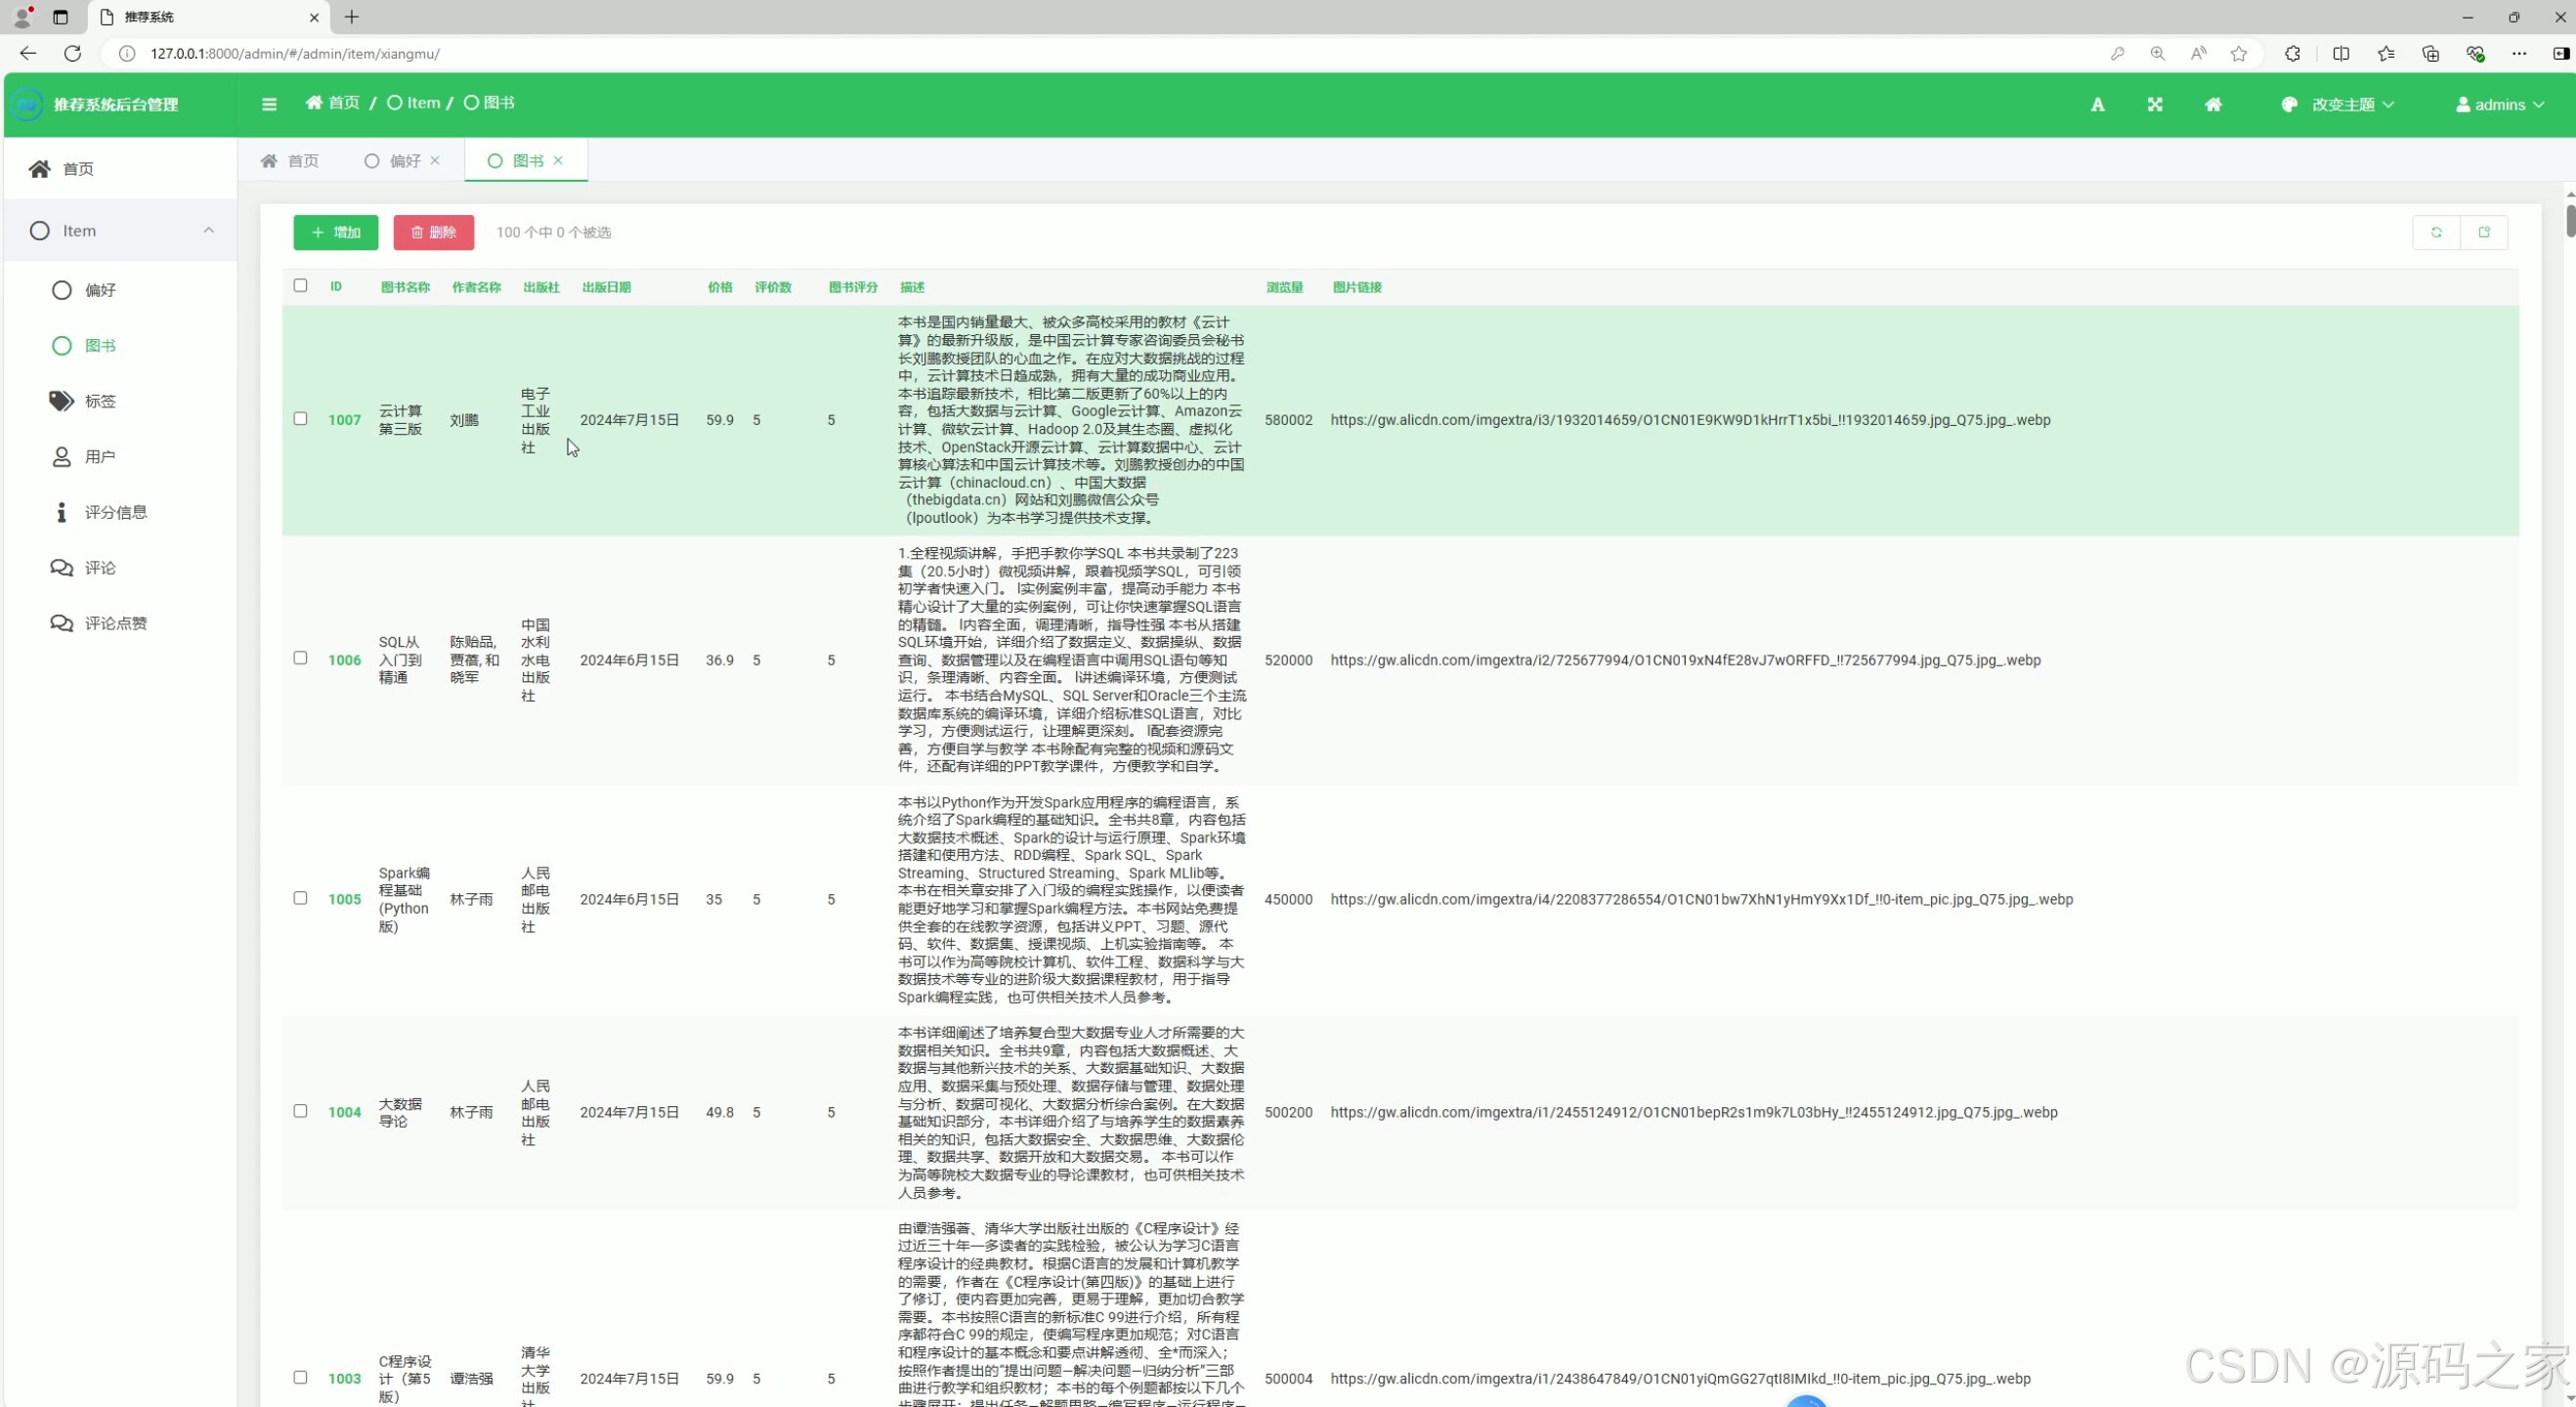
(12)后台数据管理
3、项目说明
基于协同过滤的图书推荐系统采用Django MVT+Bootstrap前端:MySQL存储用户、图书、评分、收藏等多维数据,后端集成“基于用户+基于物品”双协同过滤算法,实时计算Top-N推荐;Echarts实现图书分类数量、评分分布、词云、上架趋势等多维可视化。用户可在线评分、收藏、点赞,系统根据行为记录实时更新推荐列表;管理员可在后台完成图书上下架、用户权限管理等操作。
推荐模块采用余弦相似度计算用户-用户和物品-物品矩阵,冷启动用户采用“热门+最新”混合填充;搜索支持书名、作者模糊查询,结果高亮显示。系统全程本地运行,不依赖外网,既保护隐私又降低运维成本;代码开源、注释详尽,配套部署文档与演示数据,适合作为“推荐系统”“Web开发”课程与毕业设计模板,也可用于书店、图书馆、阅读APP等场景,推动协同过滤算法在教学与产业中的快速落地。
4、核心代码
# -*-coding:utf-8-*-
import os

os.environ["DJANGO_SETTINGS_MODULE"] = "recommend.settings"
import django

django.setup()
from item.models import *
from math import sqrt, pow
import operator
from django.db.models import Subquery, Q, Count


# from django.shortcuts import render,render_to_response
class UserCf:

    # 获得初始化数据
    def __init__(self, all_user):
        self.all_user = all_user

    # 通过用户名获得列表,仅调试使用
    def getItems(self, username1, username2):
        return self.all_user[username1], self.all_user[username2]

    # 计算两个用户的皮尔逊相关系数
    def pearson(self, user1, user2):  # 数据格式为:房源id,浏览此
        sum_xy = 0.0  # user1,user2 每项打分的成绩的累加
        n = 0  # 公共浏览次数
        sum_x = 0.0  # user1 的打分总和
        sum_y = 0.0  # user2 的打分总和
        sumX2 = 0.0  # user1每项打分平方的累加
        sumY2 = 0.0  # user2每项打分平方的累加
        for movie1, score1 in user1.items():
            if movie1 in user2.keys():  # 计算公共的浏览次数
                n += 1
                sum_xy += score1 * user2[movie1]
                sum_x += score1
                sum_y += user2[movie1]
                sumX2 += pow(score1, 2)
                sumY2 += pow(user2[movie1], 2)
        if n == 0:
            # print("p氏距离为0")
            return 0
        molecule = sum_xy - (sum_x * sum_y) / n  # 分子
        denominator = sqrt((sumX2 - pow(sum_x, 2) / n) * (sumY2 - pow(sum_y, 2) / n))  # 分母
        if denominator == 0:
            return 0
        r = molecule / denominator
        return r

    # 计算与当前用户的距离,获得最临近的用户
    def nearest_user(self, current_user, n=1):
        distances = {}
        # 用户,相似度
        # 遍历整个数据集
        for user, rate_set in self.all_user.items():
            # 非当前的用户
            if user != current_user:
                distance = self.pearson(self.all_user[current_user], self.all_user[user])
                # 计算两个用户的相似度
                distances[user] = distance
        closest_distance = sorted(
            distances.items(), key=operator.itemgetter(1), reverse=True
        )
        # 最相似的N个用户
        print("closest user:", closest_distance[:n])
        return closest_distance[:n]

    # 给用户推荐房源
    def recommend(self, username, n=3):
        recommend = {}
        nearest_user = self.nearest_user(username, n)
        for user, score in dict(nearest_user).items():  # 最相近的n个用户
            for movies, scores in self.all_user[user].items():  # 推荐的用户的房源列表
                if movies not in self.all_user[username].keys():  # 当前username没有看过
                    if movies not in recommend.keys():  # 添加到推荐列表中
                        recommend[movies] = scores*score
        # 对推荐的结果按照房源
        # 浏览次数排序
        return sorted(recommend.items(), key=operator.itemgetter(1), reverse=True)


# 基于用户的推荐
def recommend_by_user_id(user_id):
    user_prefer = UserTagPrefer.objects.filter(user_id=user_id).order_by('-score').values_list('tag_id', flat=True)
    current_user = User.objects.get(id=user_id)
    # 如果当前用户没有打分 则看是否选择过标签,选过的话,就从标签中找
    # 没有的话,就按照浏览度推荐15个
    if current_user.rate_set.count() == 0:
        if len(user_prefer) != 0:
            movie_list = xiangmu.objects.filter(tags__in=user_prefer)[:15]
        else:
            movie_list = xiangmu.objects.order_by("-c9")[:15]
        return movie_list
    # 选取评分最多的10个用户
    users_rate = Rate.objects.values('user').annotate(mark_num=Count('user')).order_by('-mark_num')
    user_ids = [user_rate['user'] for user_rate in users_rate]
    user_ids.append(user_id)
    users = User.objects.filter(id__in=user_ids)#users 为评分最多的10个用户
    all_user = {}
    for user in users:
        rates = user.rate_set.all()#查出10名用户的数据
        rate = {}
        # 用户有给房源打分 在rate和all_user中进行设置
        if rates:
            for i in rates:
                rate.setdefault(str(i.movie.id), i.mark)#填充房源数据
            all_user.setdefault(user.username, rate)
        else:
            # 用户没有为房源打过分,设为0
            all_user.setdefault(user.username, {})

    user_cf = UserCf(all_user=all_user)
    recommend_list = [each[0] for each in user_cf.recommend(current_user.username, 15)]
    movie_list = list(xiangmu.objects.filter(id__in=recommend_list).order_by("-c9")[:15])
    other_length = 15 - len(movie_list)
    if other_length > 0:
        fix_list = xiangmu.objects.filter(~Q(rate__user_id=user_id)).order_by('-collect')
        for fix in fix_list:
            if fix not in movie_list:
                movie_list.append(fix)
            if len(movie_list) >= 15:
                break
    return movie_list


# 计算相似度
def similarity(movie1_id, movie2_id):
    movie1_set = Rate.objects.filter(movie_id=movie1_id)
    # movie1的打分用户数
    movie1_sum = movie1_set.count()
    # movie_2的打分用户数
    movie2_sum = Rate.objects.filter(movie_id=movie2_id).count()
    # 两者的交集
    common = Rate.objects.filter(user_id__in=Subquery(movie1_set.values('user_id')), movie=movie2_id).values('user_id').count()
    # 没有人给当前房源打分
    if movie1_sum == 0 or movie2_sum == 0:
        return 0
    similar_value = common / sqrt(movie1_sum * movie2_sum)#余弦计算相似度
    return similar_value


#基于物品
def recommend_by_item_id(user_id, k=15):
    # 前三的tag,用户评分前三的房源
    user_prefer = UserTagPrefer.objects.filter(user_id=user_id).order_by('-score').values_list('tag_id', flat=True)
    user_prefer = list(user_prefer)[:3]
    print('user_prefer', user_prefer)
    current_user = User.objects.get(id=user_id)
    # 如果当前用户没有打分 则看是否选择过标签,选过的话,就从标签中找
    # 没有的话,就按照浏览度推荐15个
    if current_user.rate_set.count() == 0:
        if len(user_prefer) != 0:
            movie_list = xiangmu.objects.filter(tags__in=user_prefer)[:15]
        else:
            movie_list = xiangmu.objects.order_by("-c9")[:15]
        print('from here')
        return movie_list
    # most_tags = Tags.objects.annotate(tags_sum=Count('name')).order_by('-tags_sum').filter(movie__rate__user_id=user_id).order_by('-tags_sum')
    # 选用户最喜欢的标签中的房源,用户没看过的30部,对这30部房源,计算距离最近
    un_watched = xiangmu.objects.filter(~Q(rate__user_id=user_id), tags__in=user_prefer).order_by('?')[:30]  # 看过的房源
    watched = Rate.objects.filter(user_id=user_id).values_list('movie_id', 'mark')
    distances = []
    names = []
    # 在未看过的房源中找到
    for un_watched_movie in un_watched:
        for watched_movie in watched:
            if un_watched_movie not in names:
                names.append(un_watched_movie)
                distances.append((similarity(un_watched_movie.id, watched_movie[0]) * watched_movie[1], un_watched_movie))#加入相似的房源
    distances.sort(key=lambda x: x[0], reverse=True)
    print('this is distances', distances[:15])
    recommend_list = []
    for mark, movie in distances:
        if len(recommend_list) >= k:
            break
        if movie not in recommend_list:
            recommend_list.append(movie)
    # print('this is recommend list', recommend_list)
    # 如果得不到有效数量的推荐 按照未看过的房源中的热度进行填充
    print('recommend list', recommend_list)
    return recommend_list


if __name__ == '__main__':
    # similarity(2003, 2008)
    print(recommend_by_item_id(1799))
5、源码获取方式
biyesheji0005 或 biyesheji0001 (绿色聊天软件)
🍅由于篇幅限制,获取完整文章或源码、代做项目的,查看我的【用户名】、【专栏名称】、【顶部选题链接】就可以找到我啦🍅
感兴趣的可以先收藏起来,点赞、关注不迷路,下方查看👇🏻获取联系方式👇🏻

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 16
 0
- 0


 已为社区贡献72条内容

所有评论(0)