AI大模型微调教程5
·
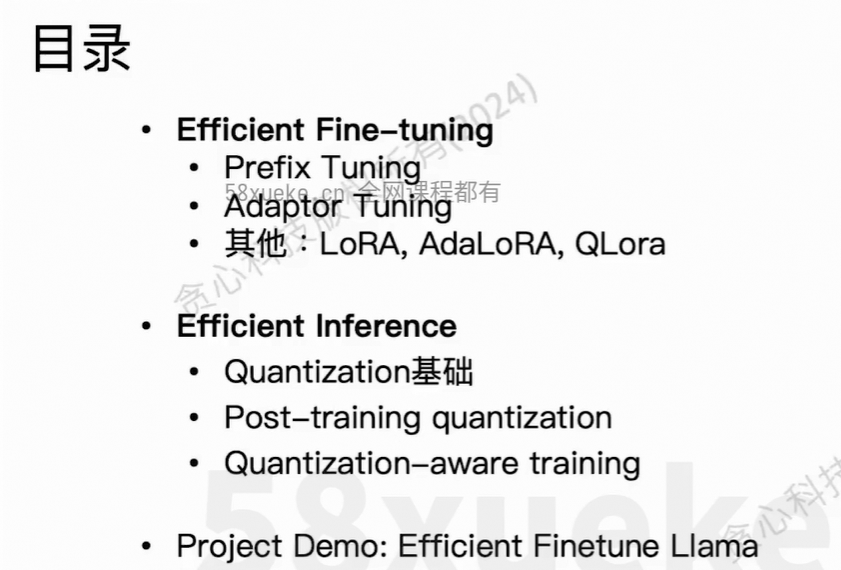
1、目录
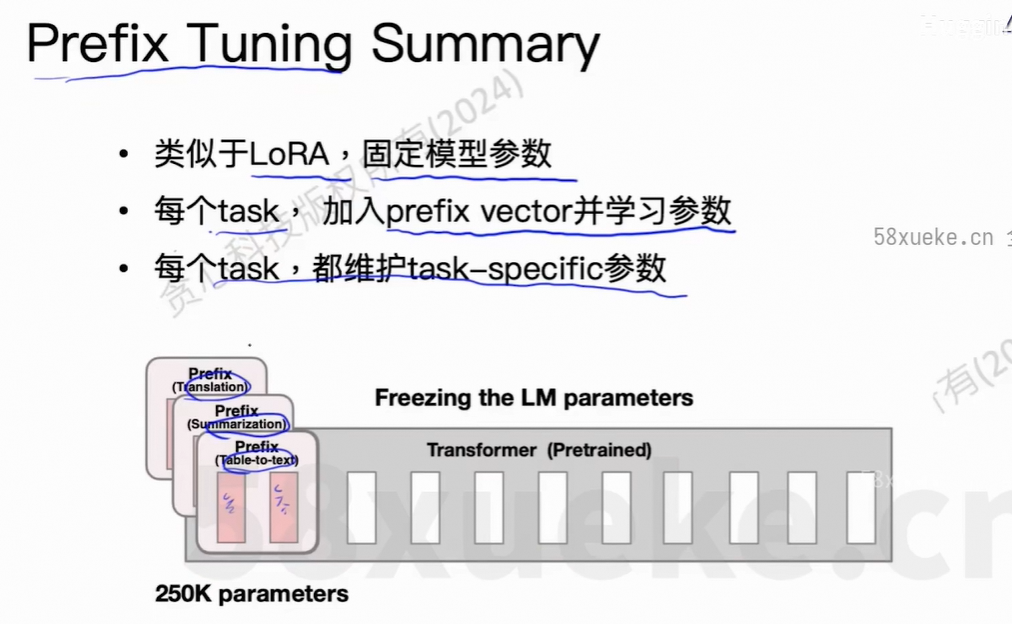
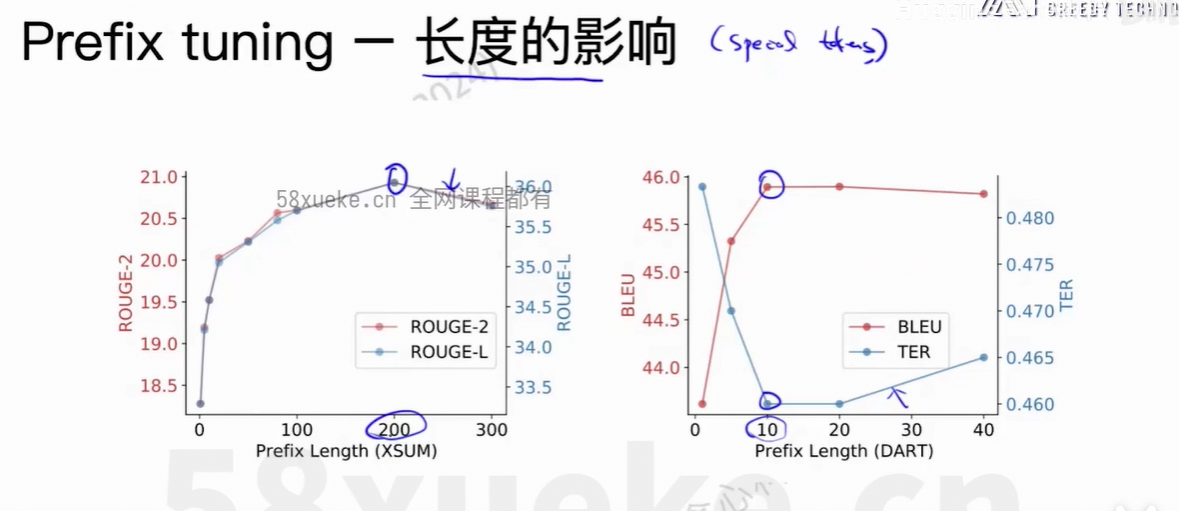
2、Prefix Tuning
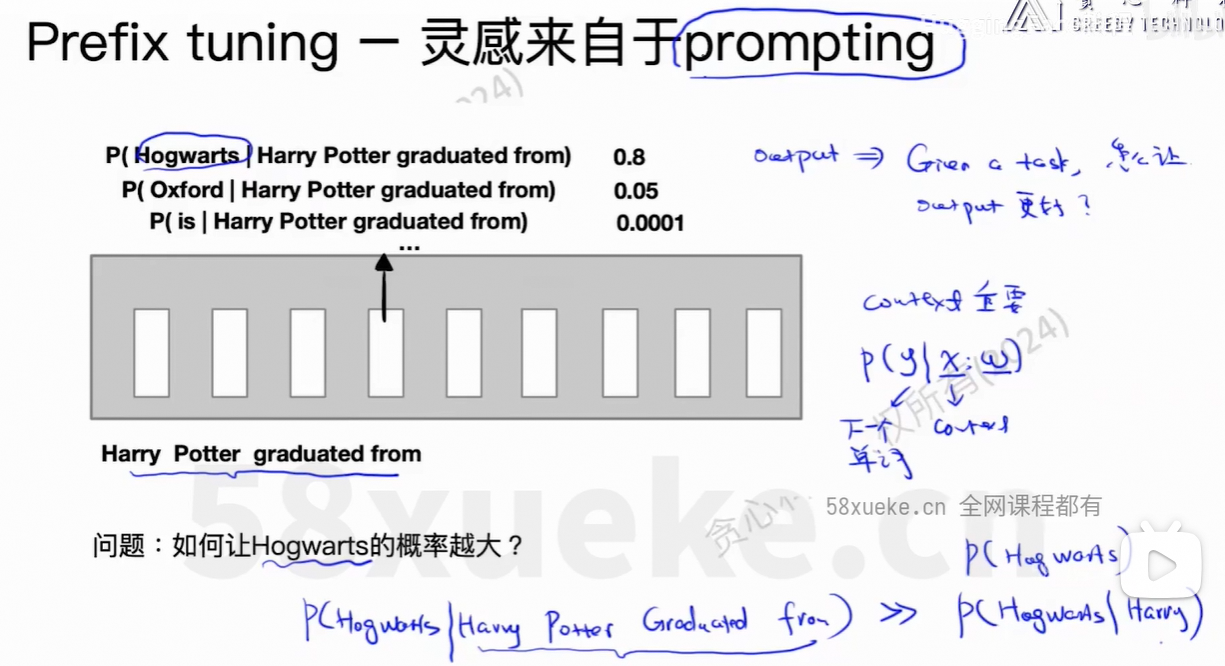
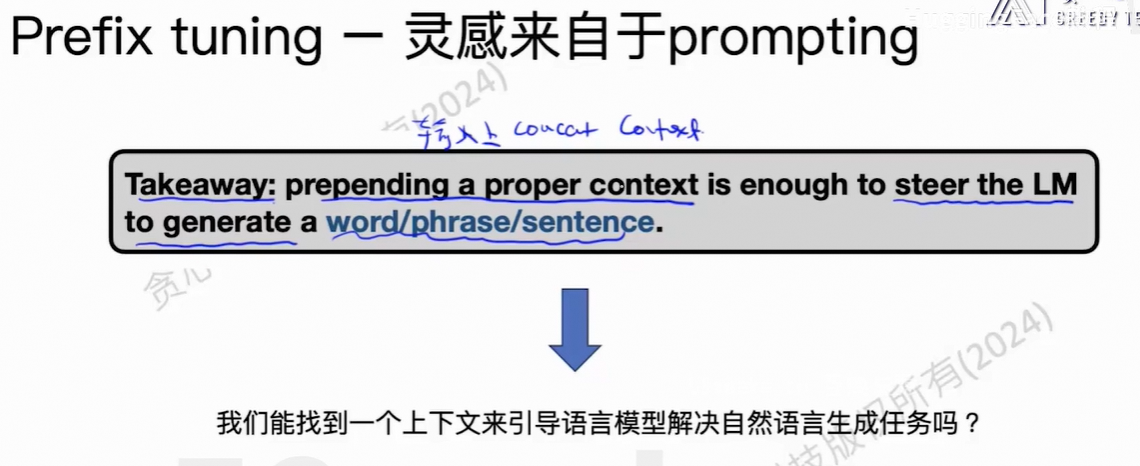
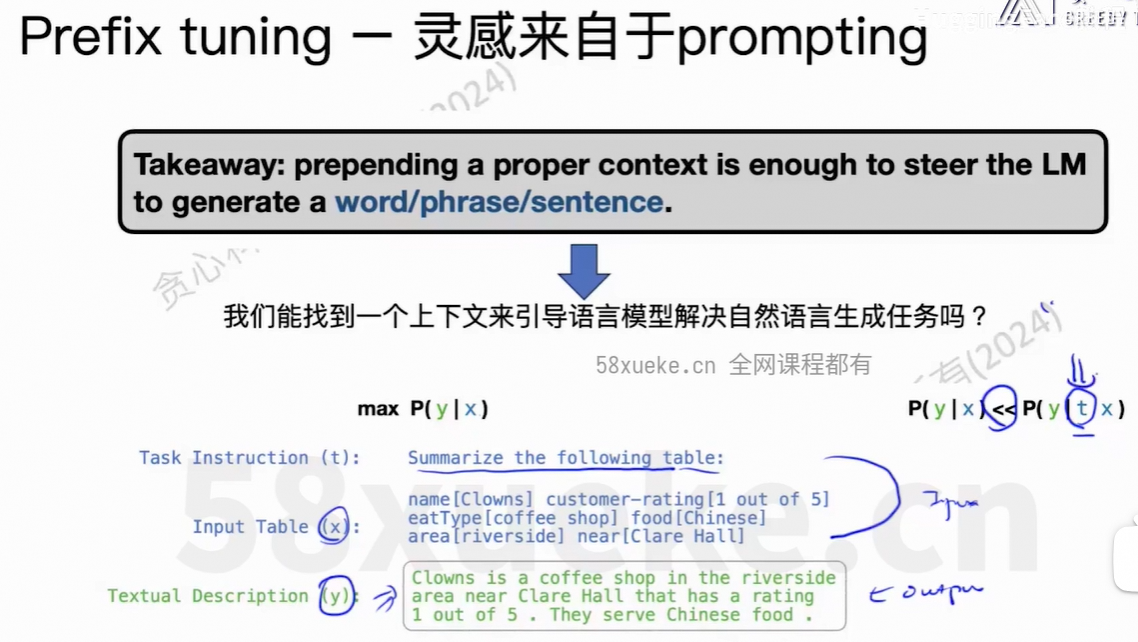
自己学习出Instruction。
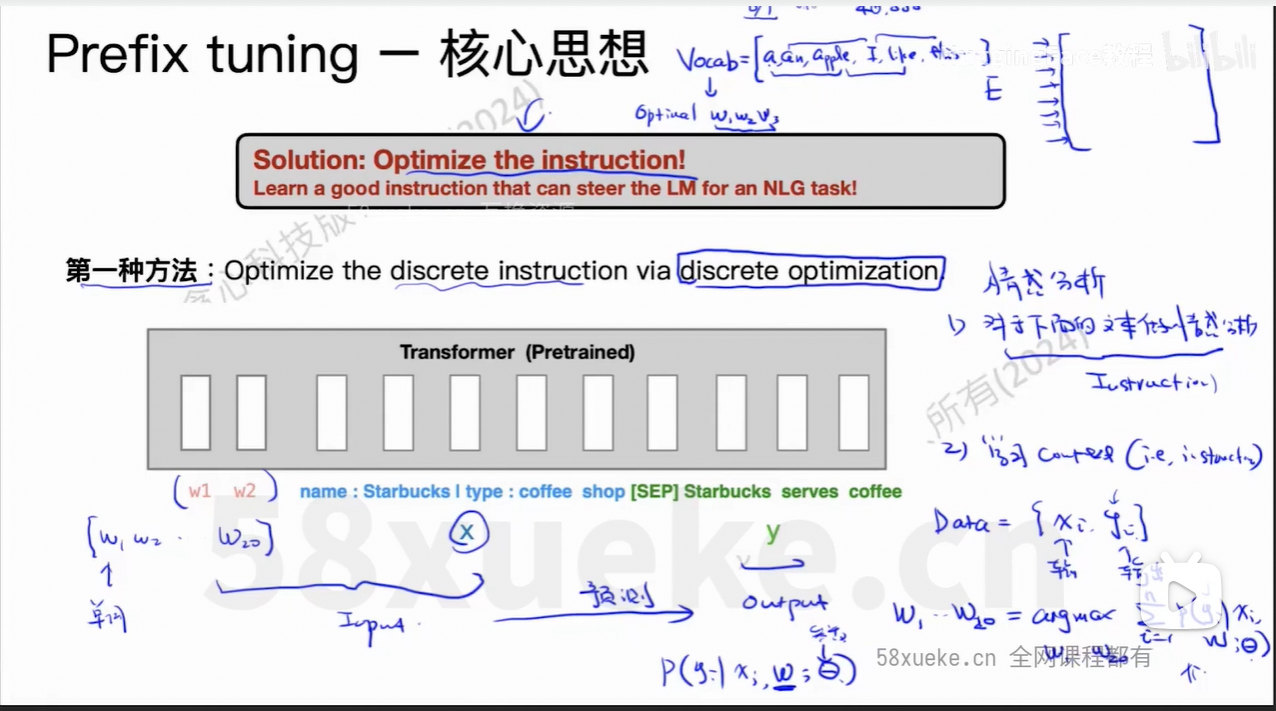
给出一个vocabulary,然后每个token进行0/1预测,离散型的值。
上面方法的缺点:离散型,没有办法很好的优化(梯度下降)。
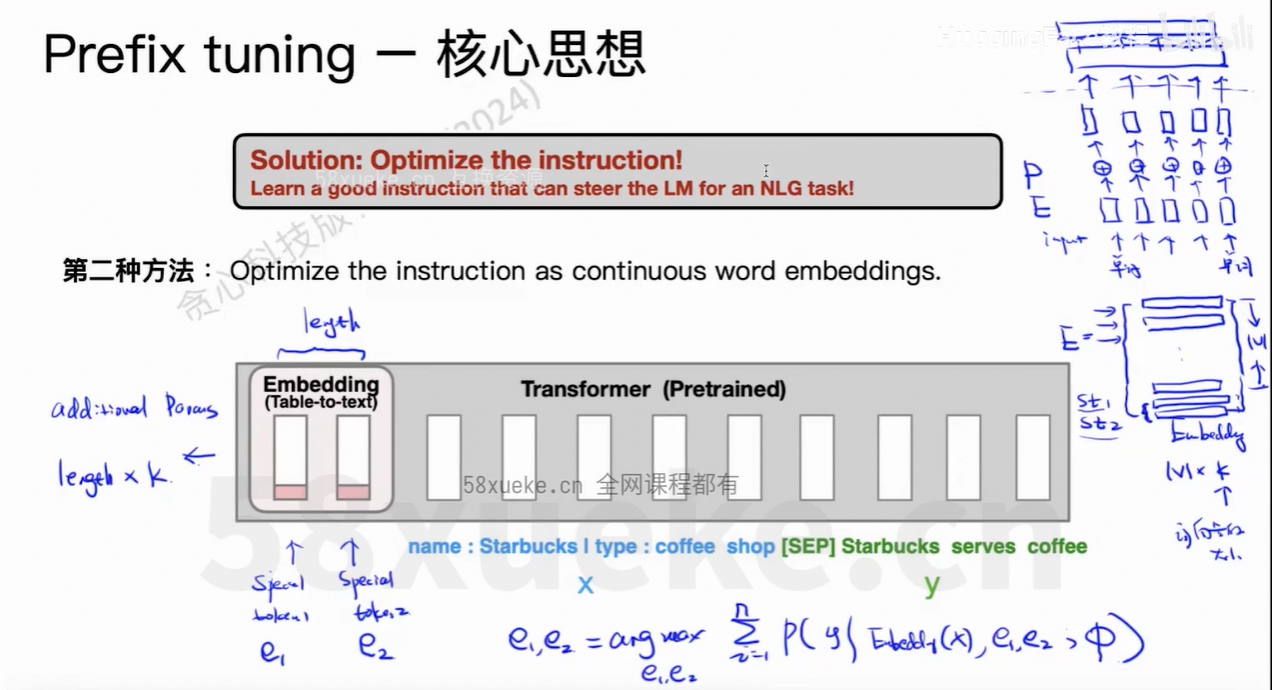
第二种方法,增加了N个词库。
第一种逻辑是搜索,第二种逻辑是优化。
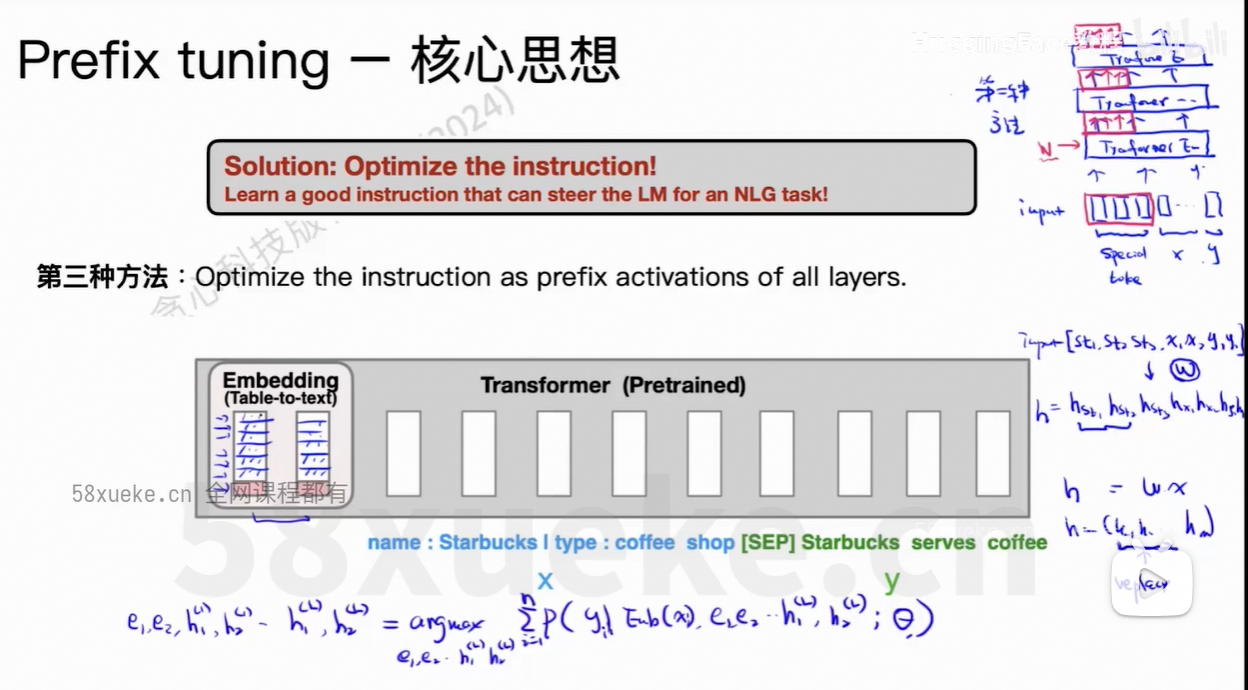
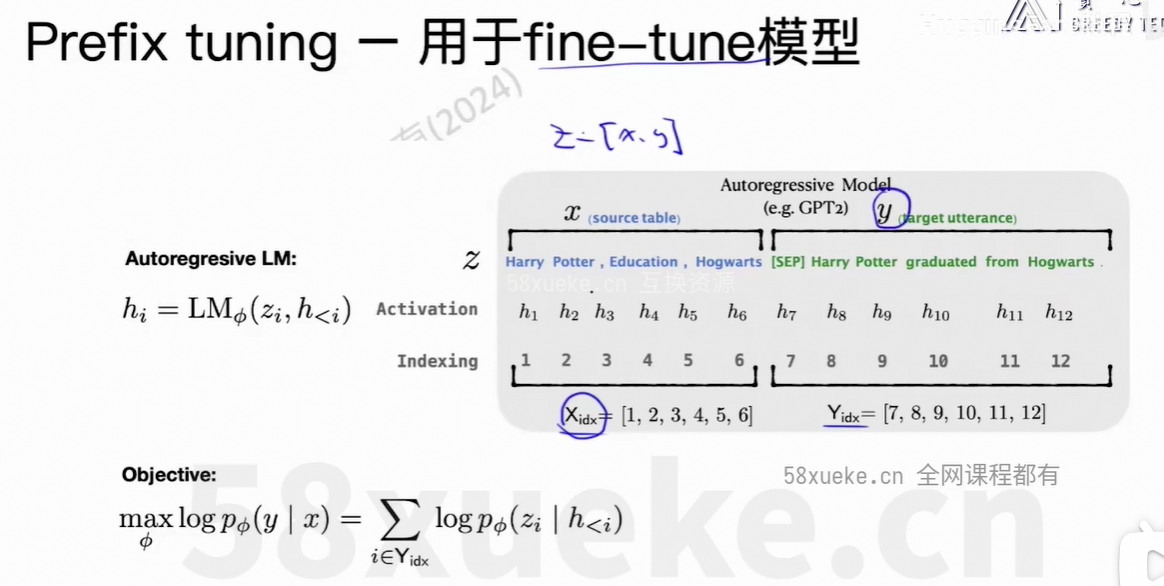
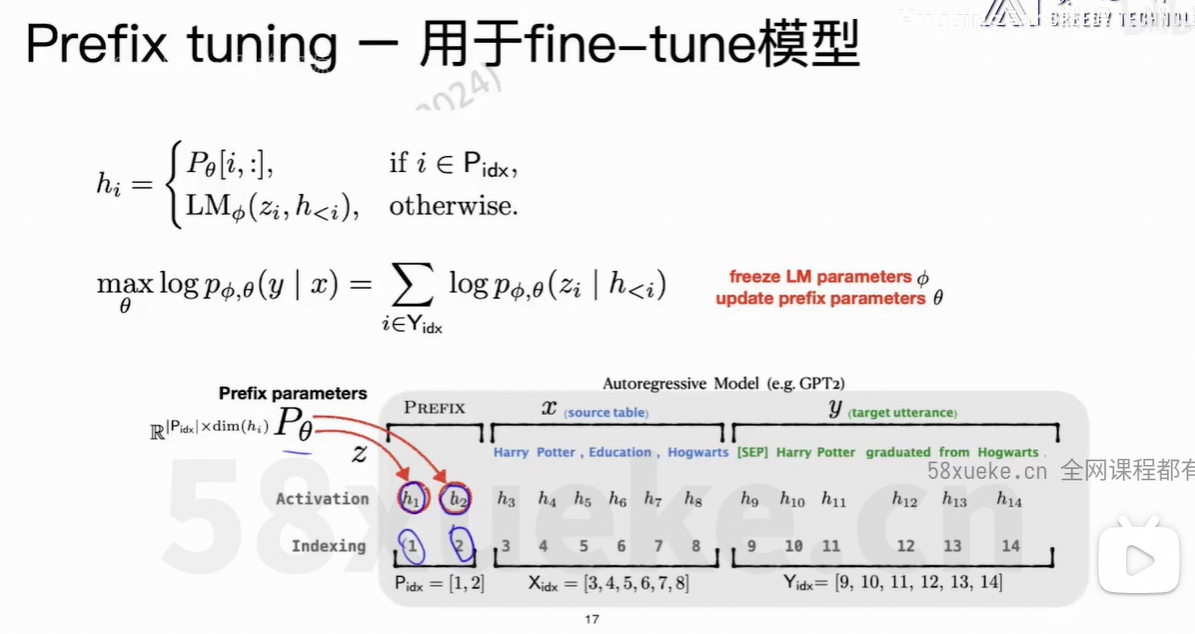
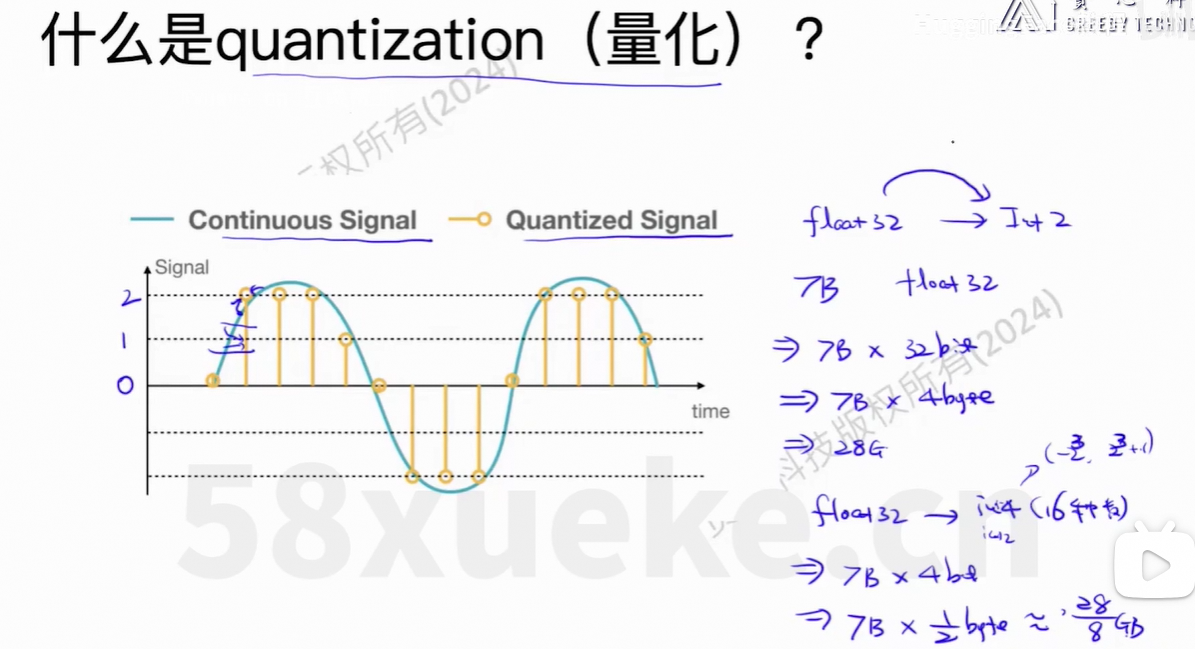
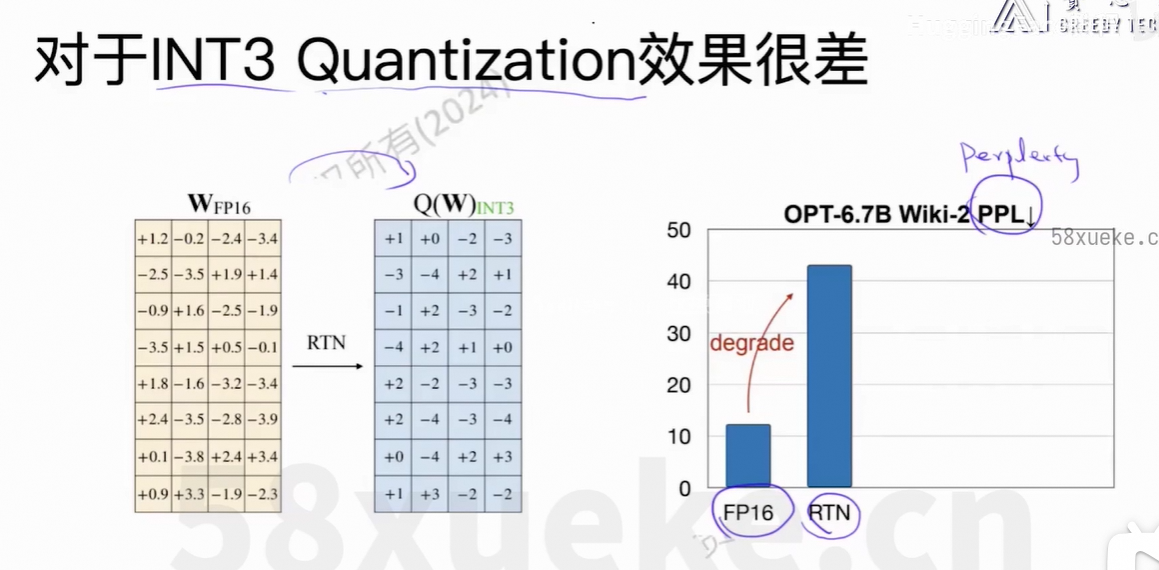
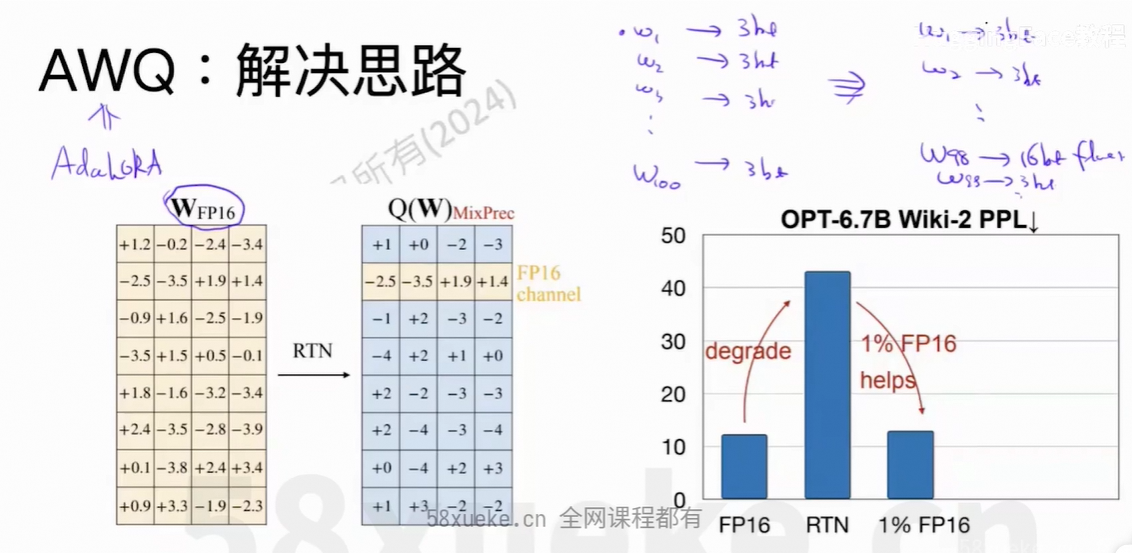
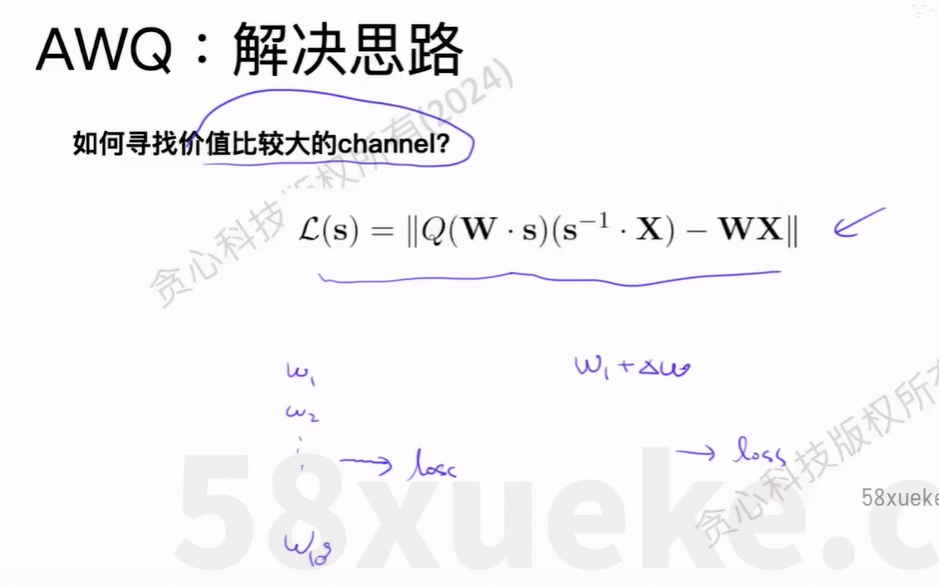
3、Quantization
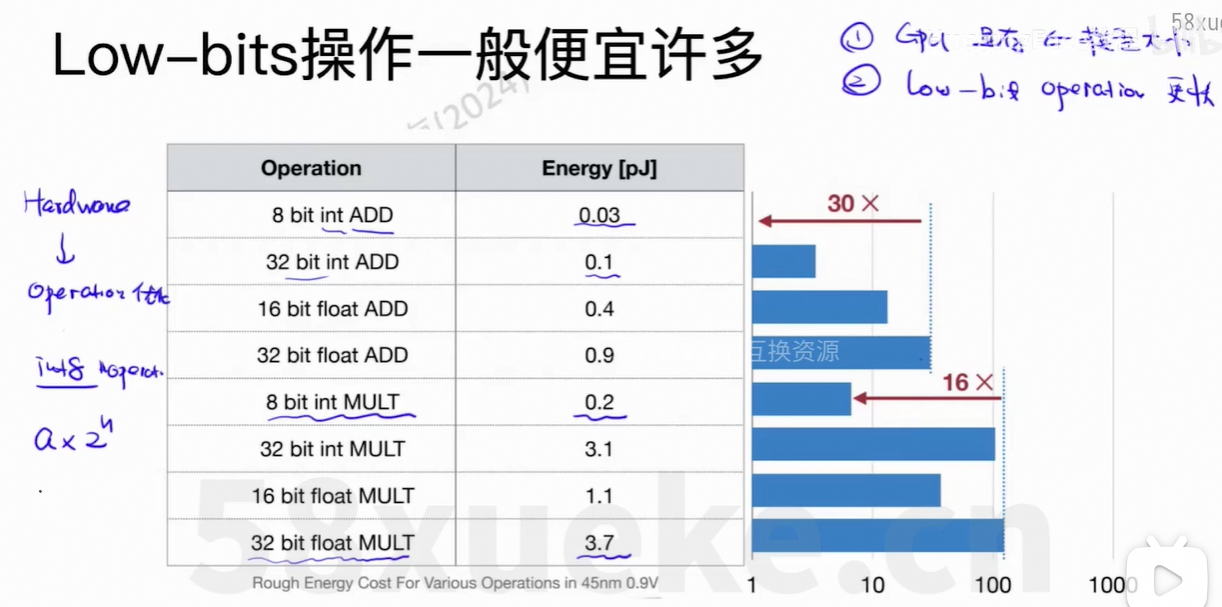
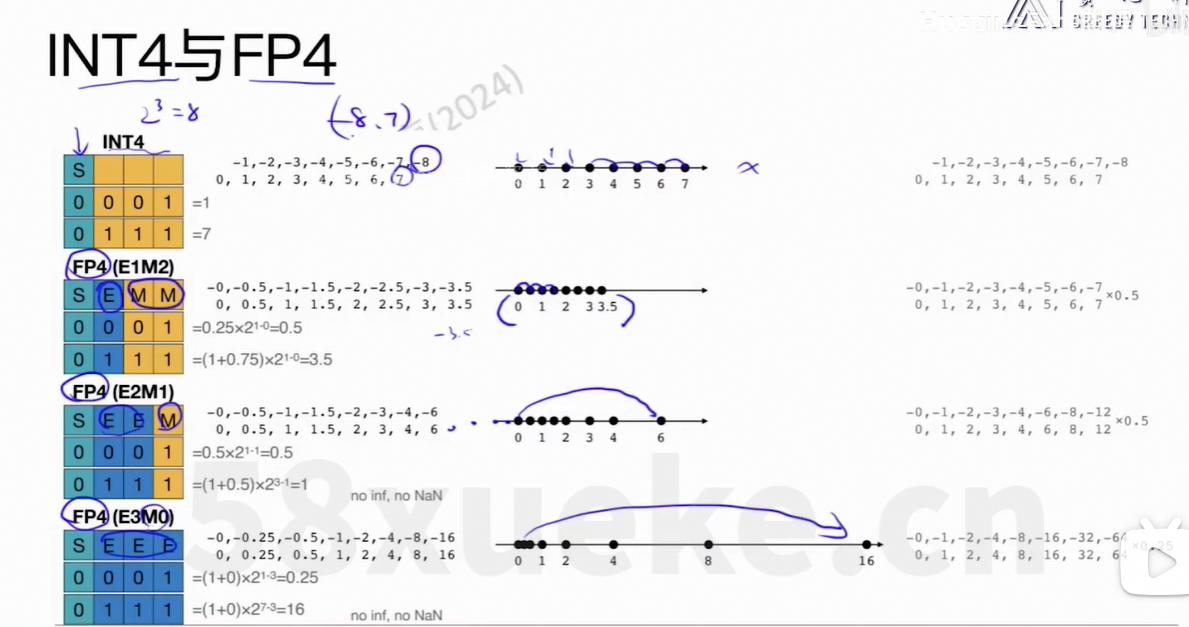
(1)数据类型
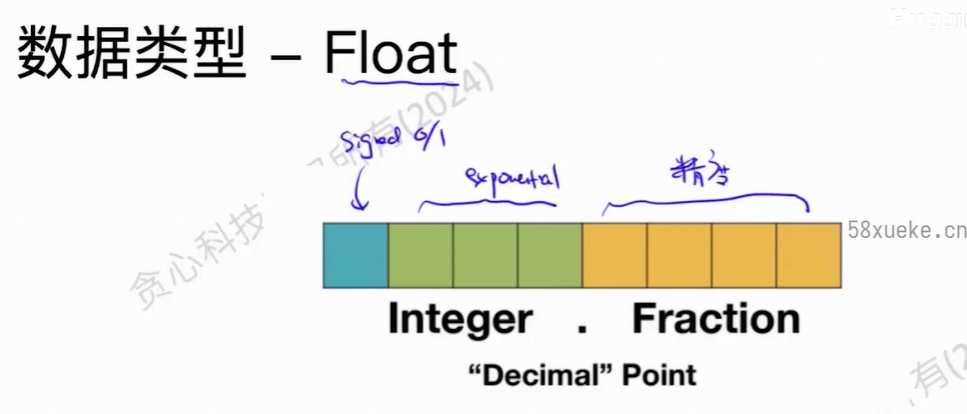
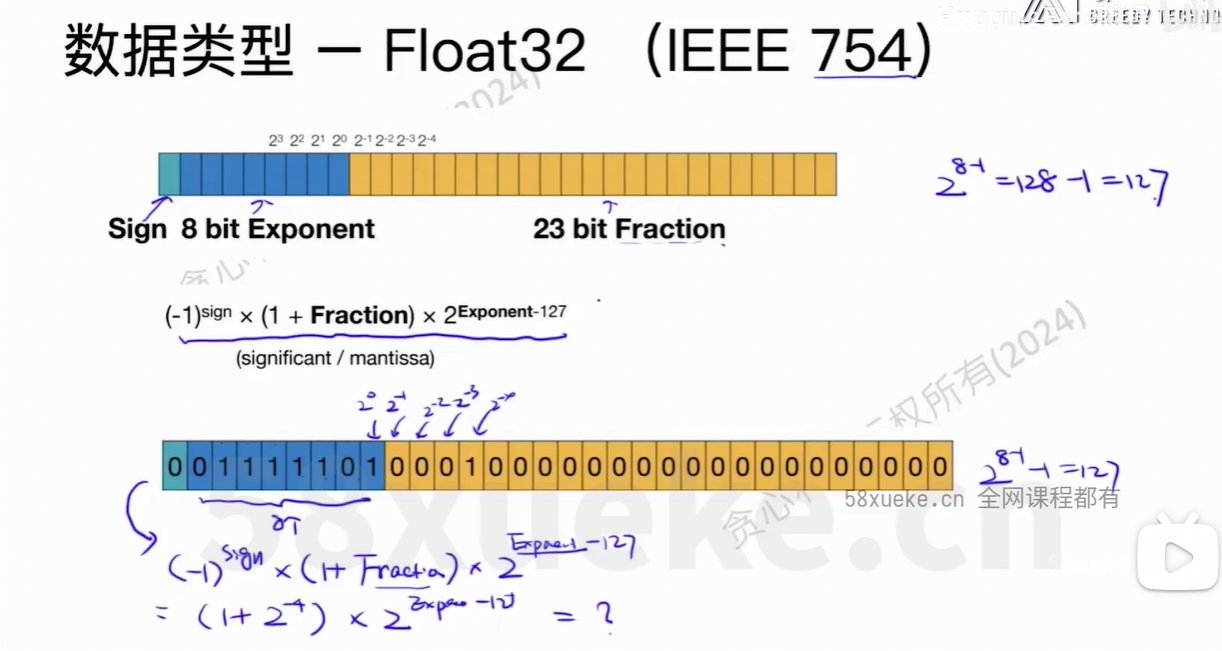
上述方式无法表示0。
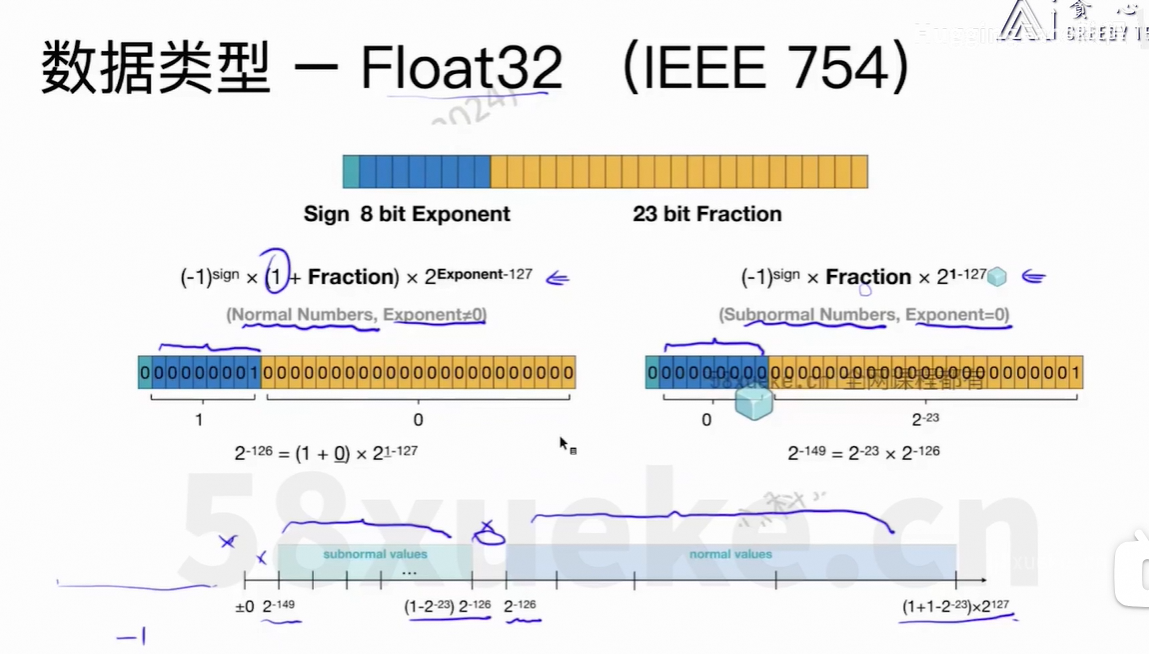
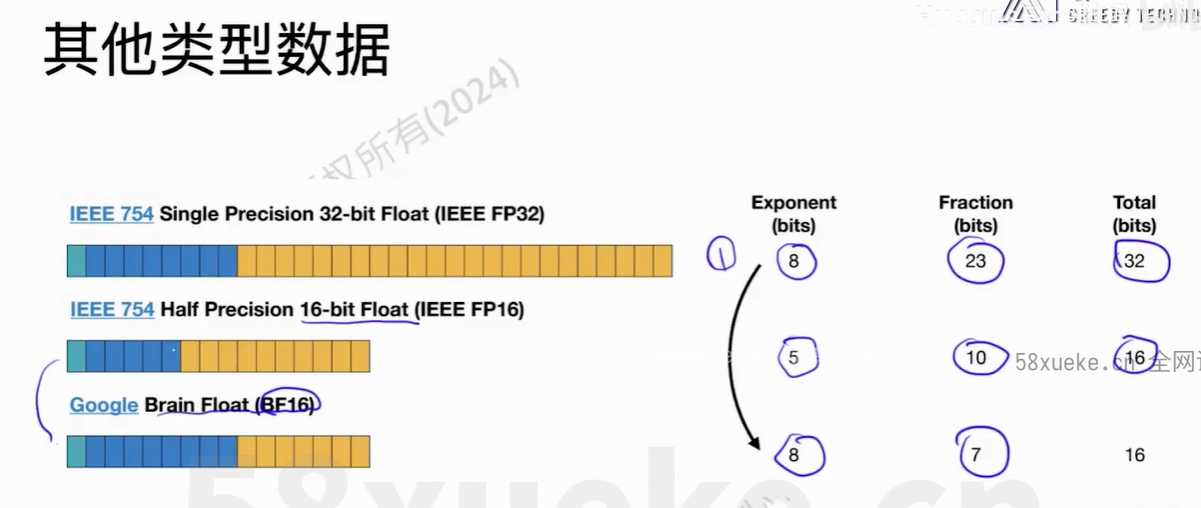
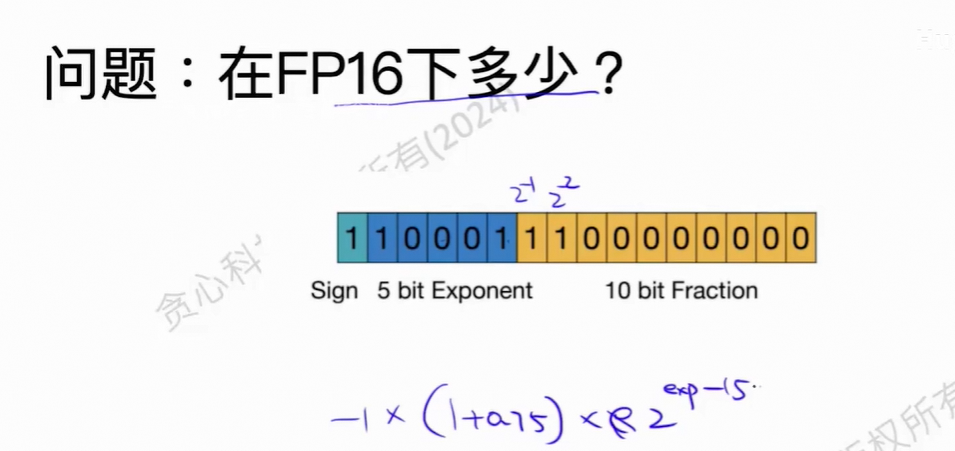
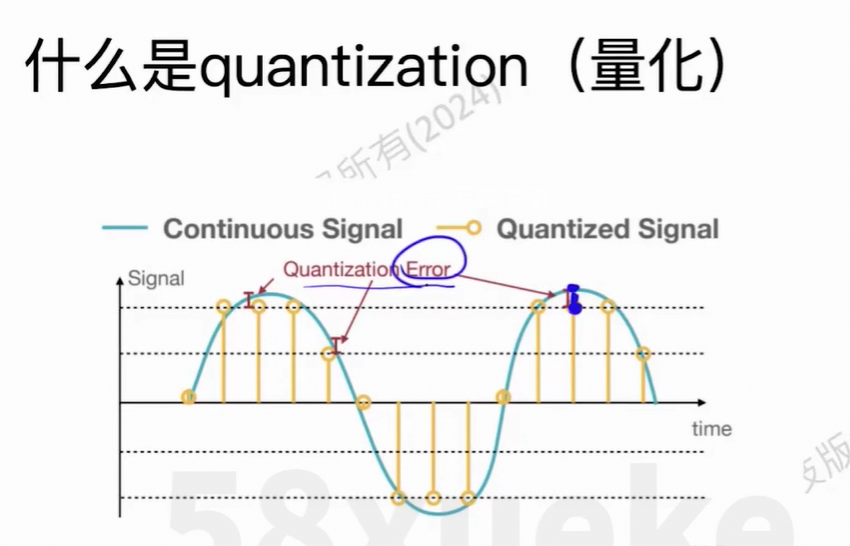
(2)量化
用最小的量化,使误差最小
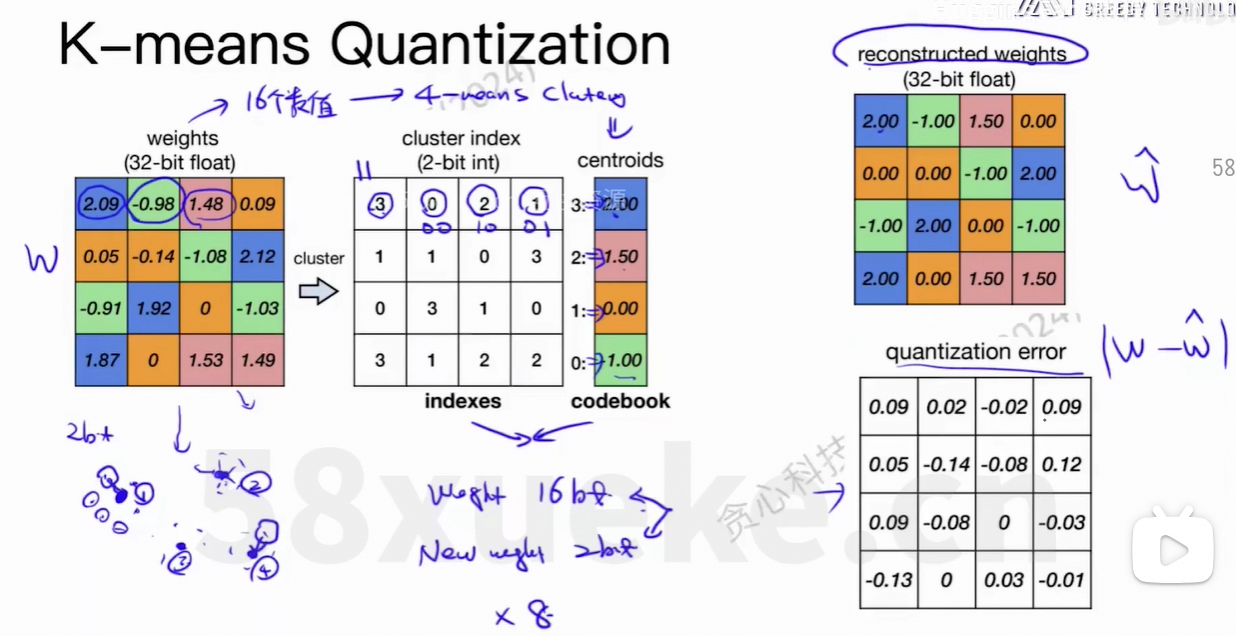
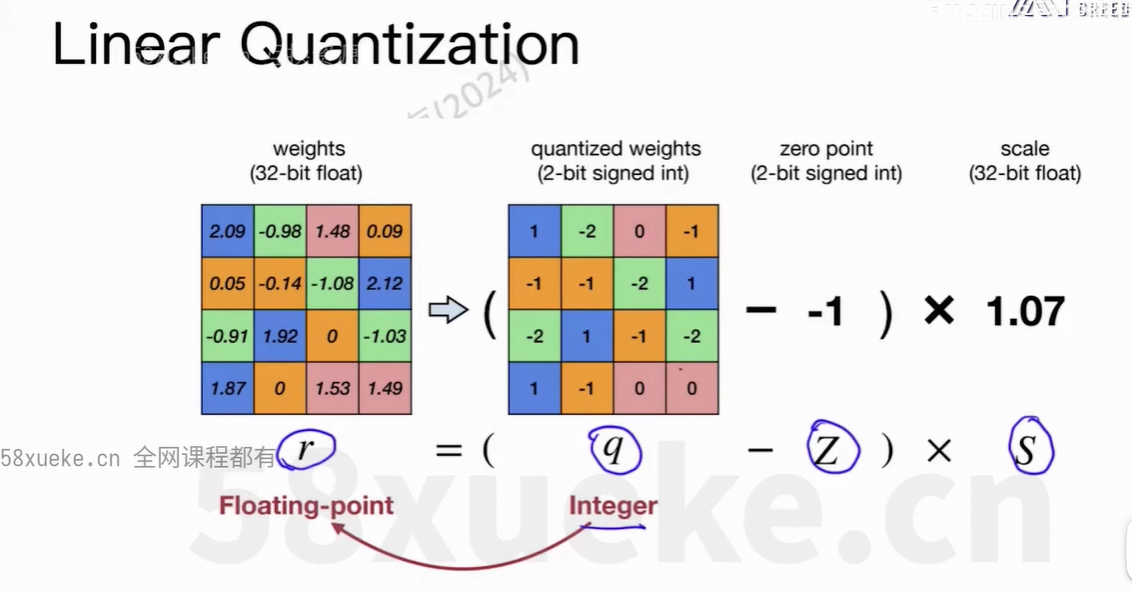
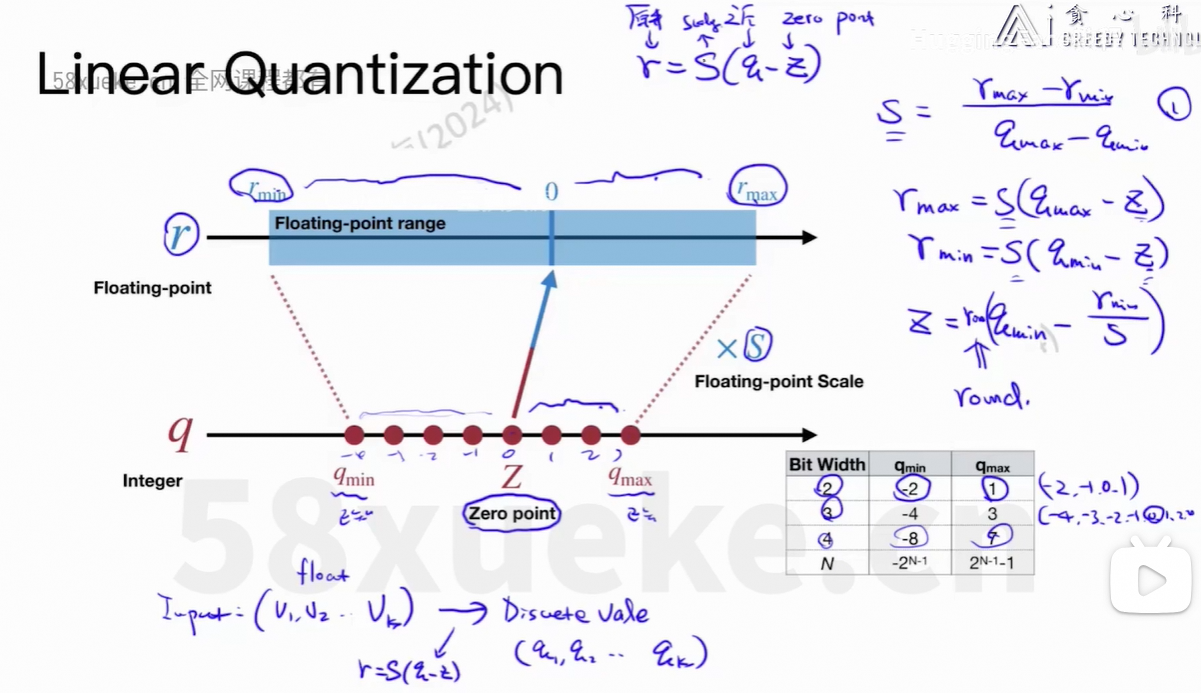
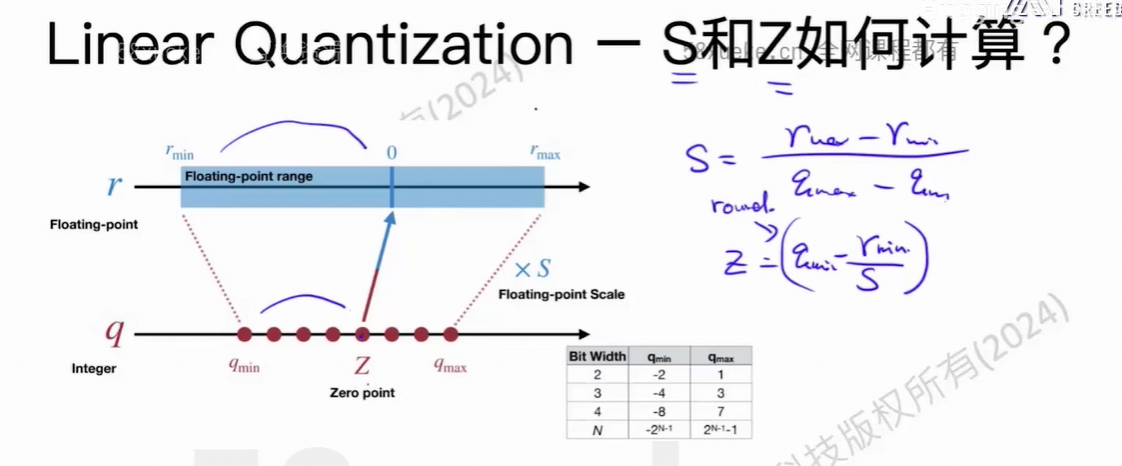
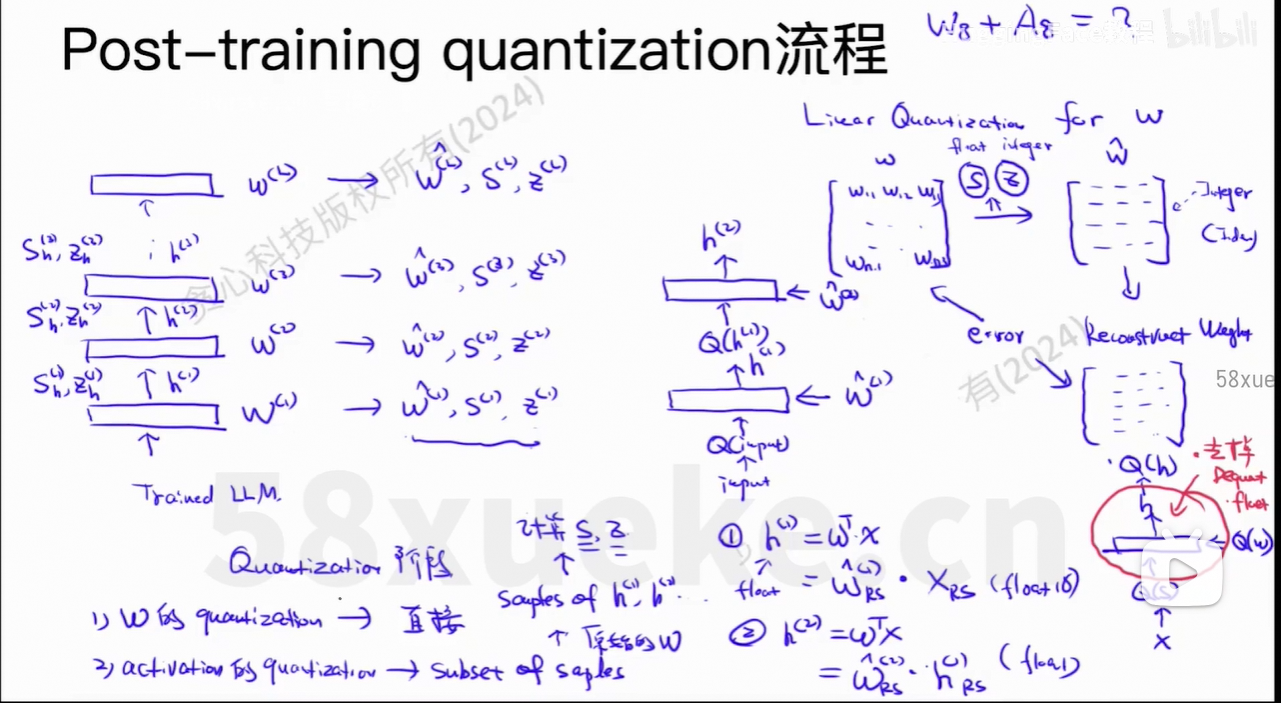
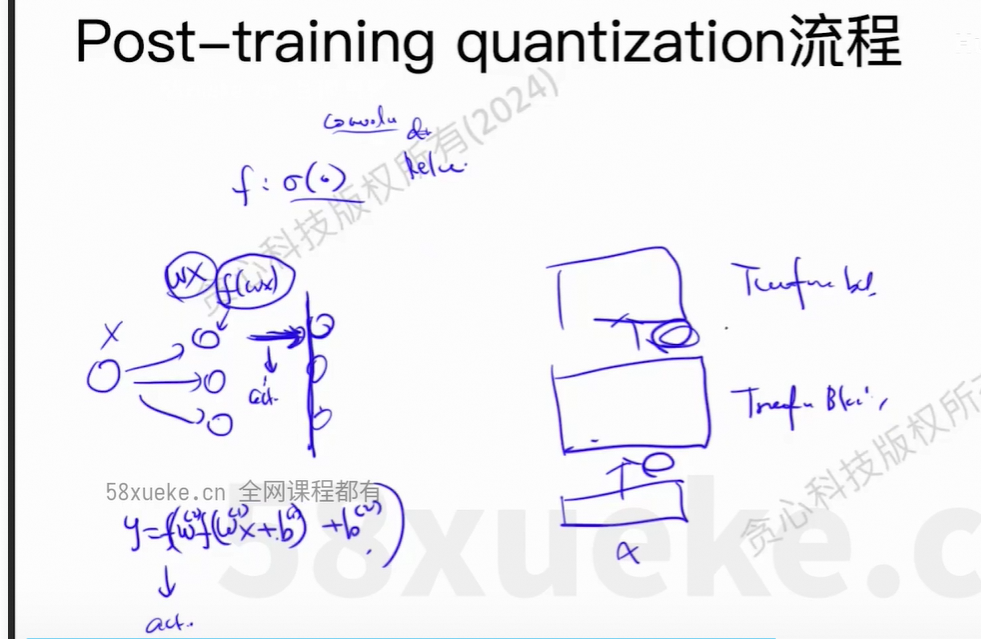
(3)Post-Training quantization
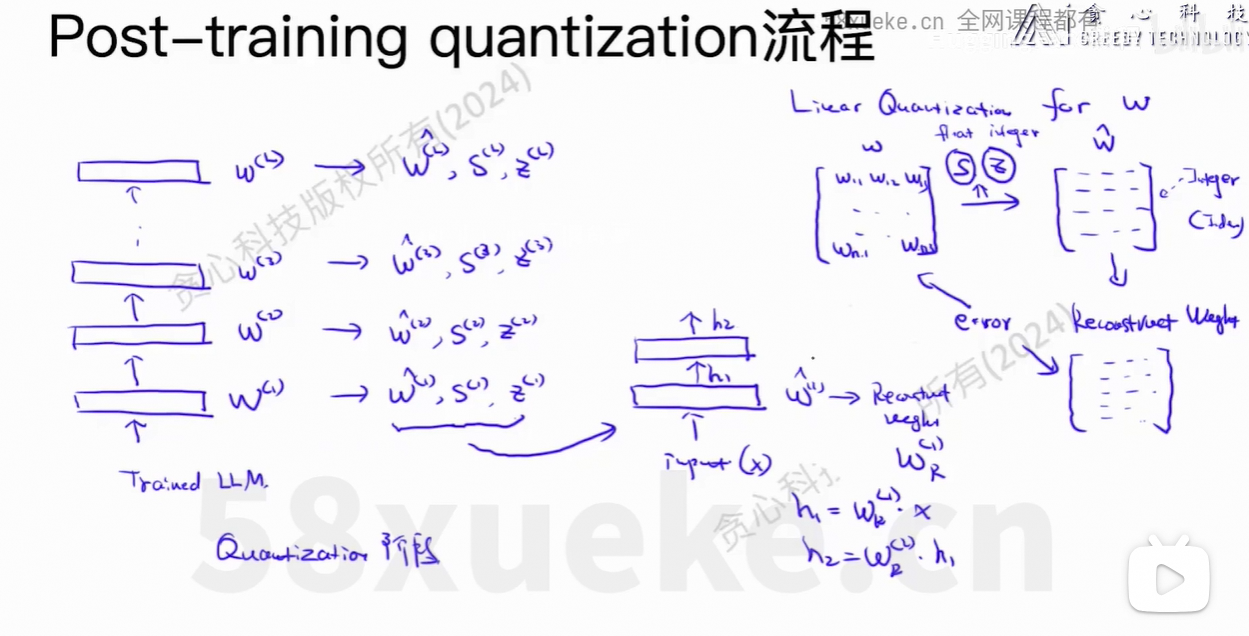
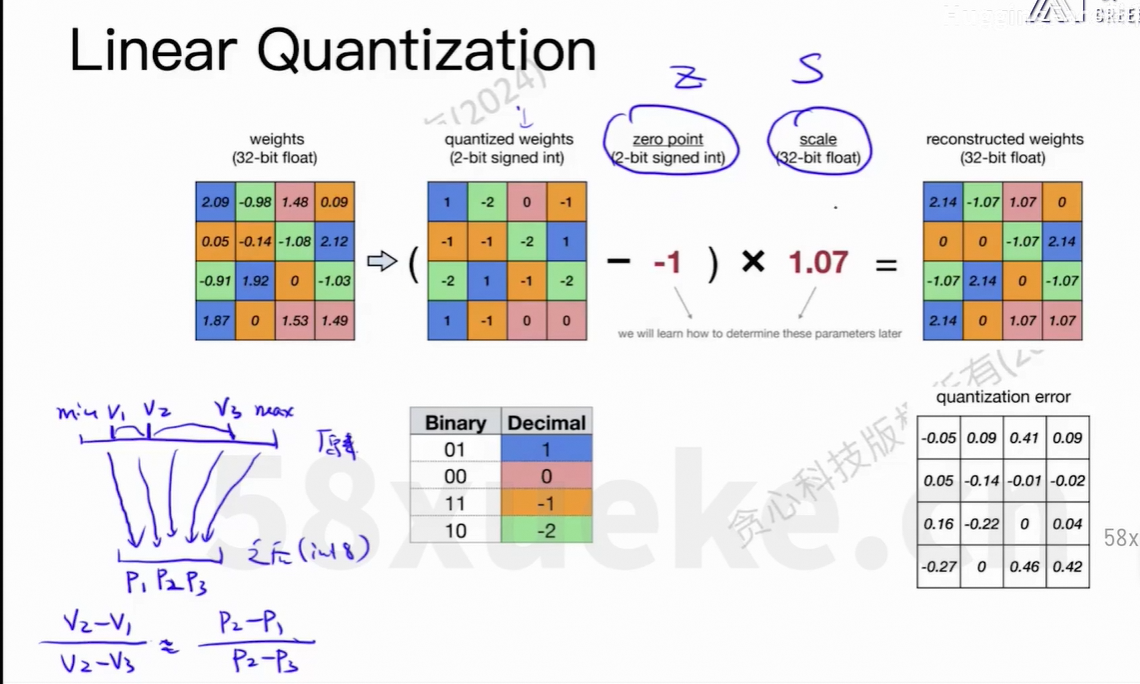
如果是Linear Quantization:
量化阶段:模型量化之后weight变为了index,同时需要在模型中保存S和Z的值。
推理阶段:需要根据index、S和Z的值,还原回weight的值
两次转化的过程会存在精度的缺失。
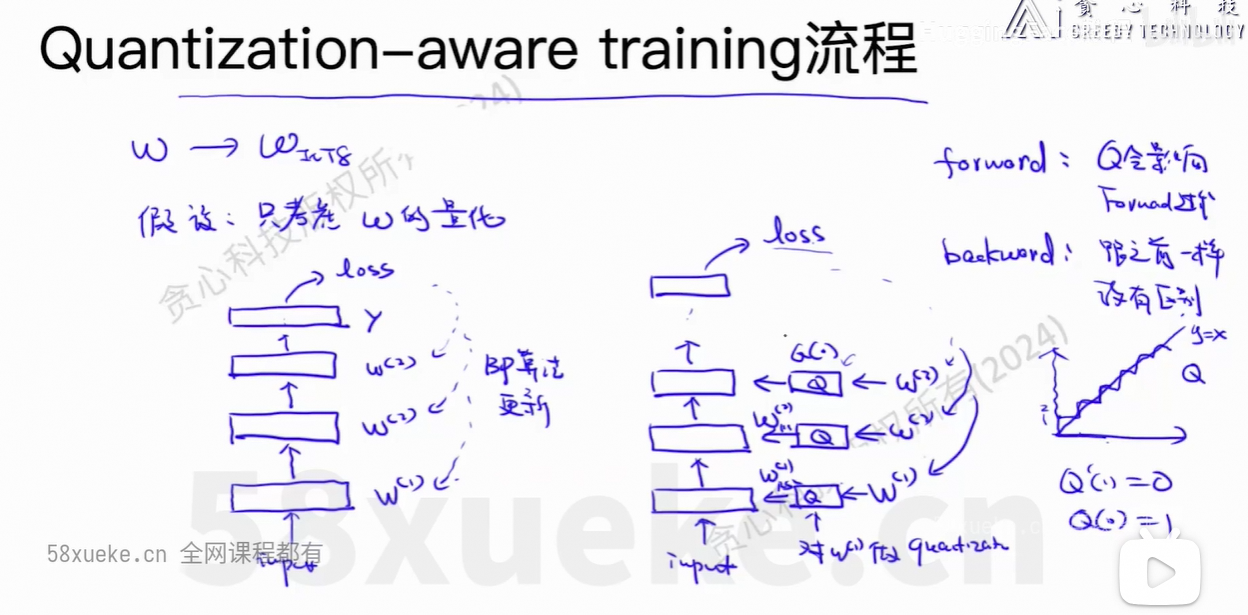
改变了模型结构,需要全量训练。
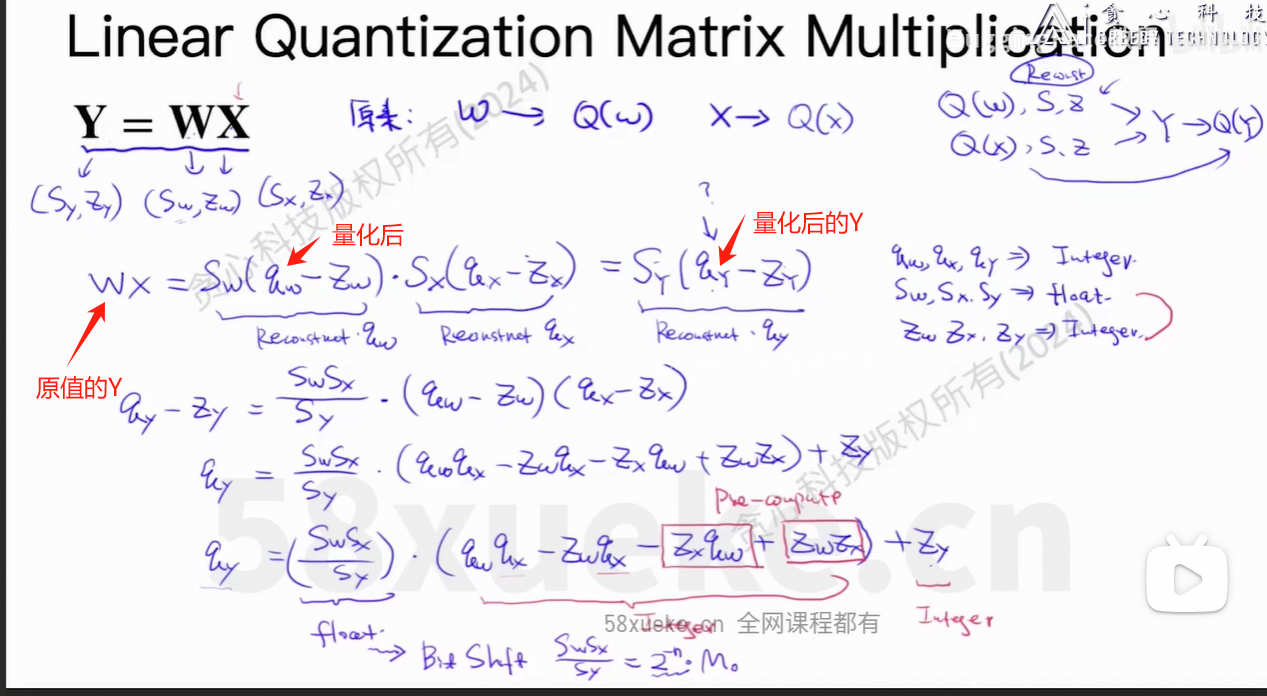
每层间从量化后直接到量化后的方法,而不是量化后的值deconstruct到原值(float)进行矩阵乘法计算后再进行量化。
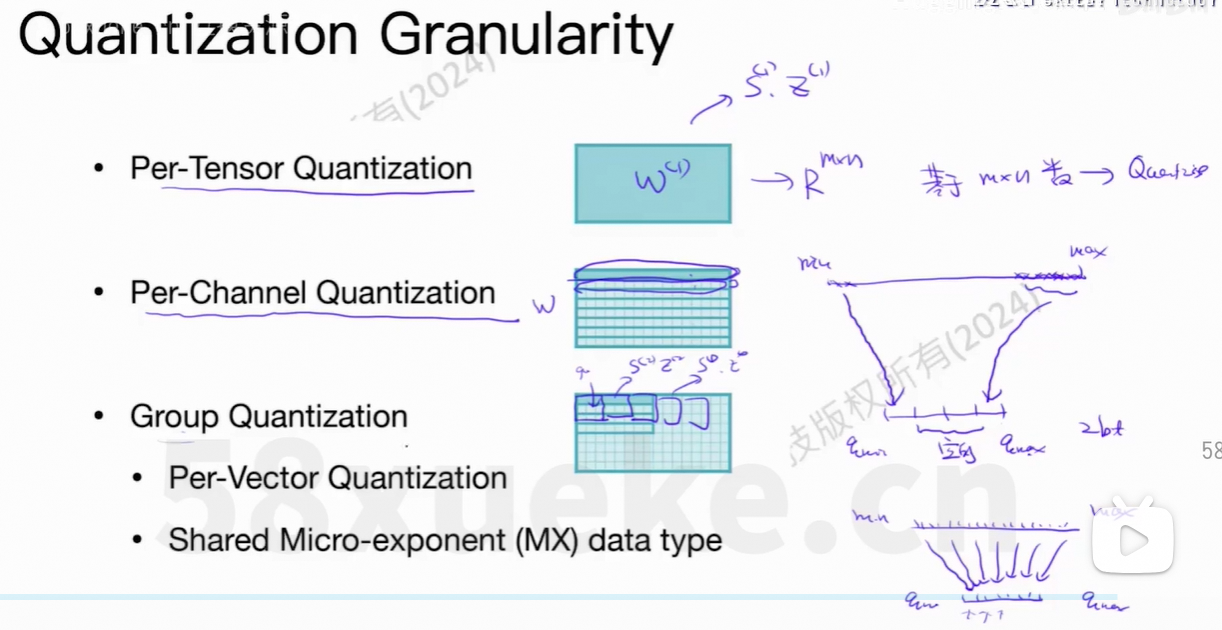
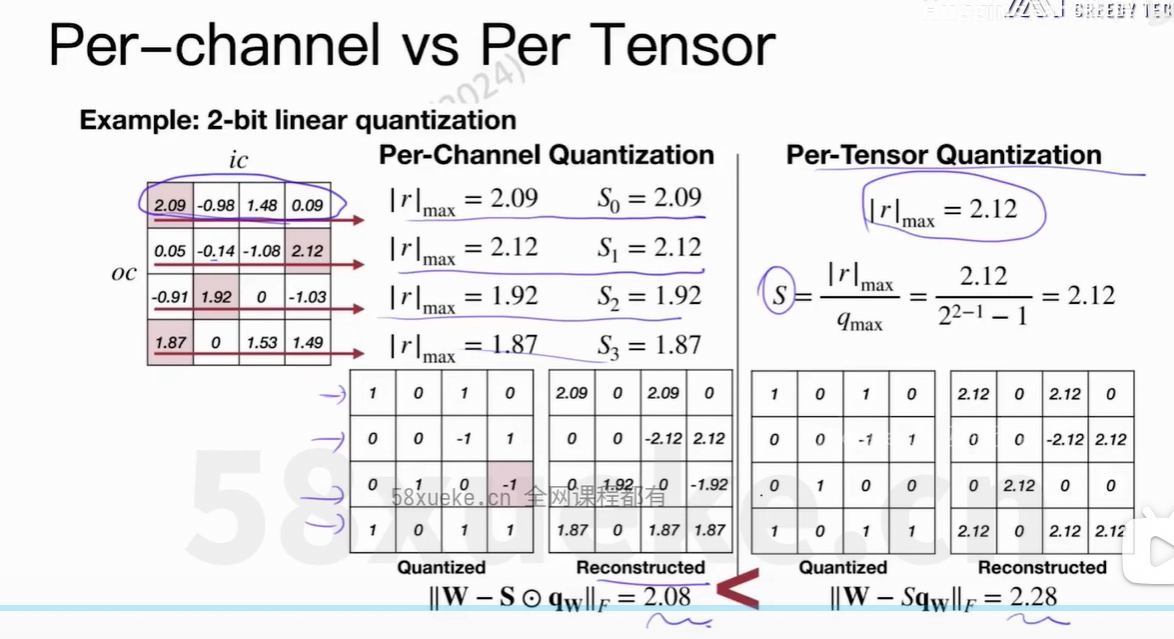
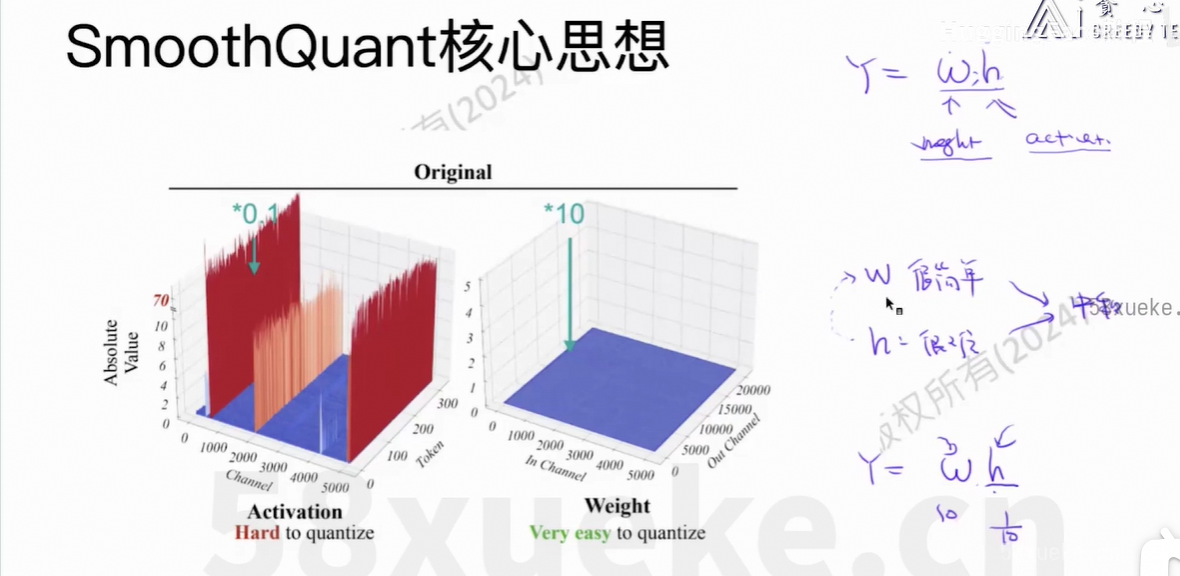
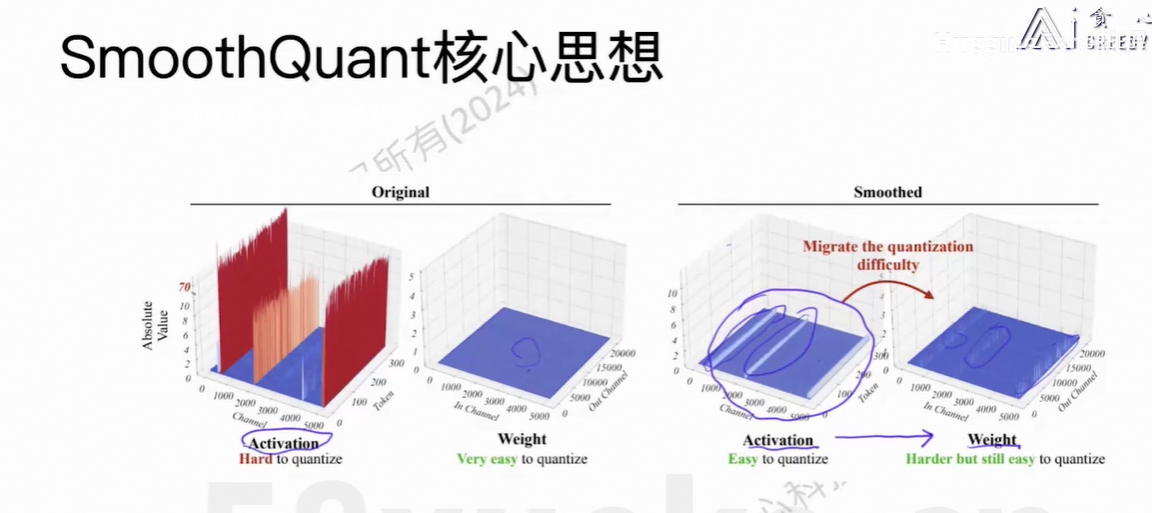
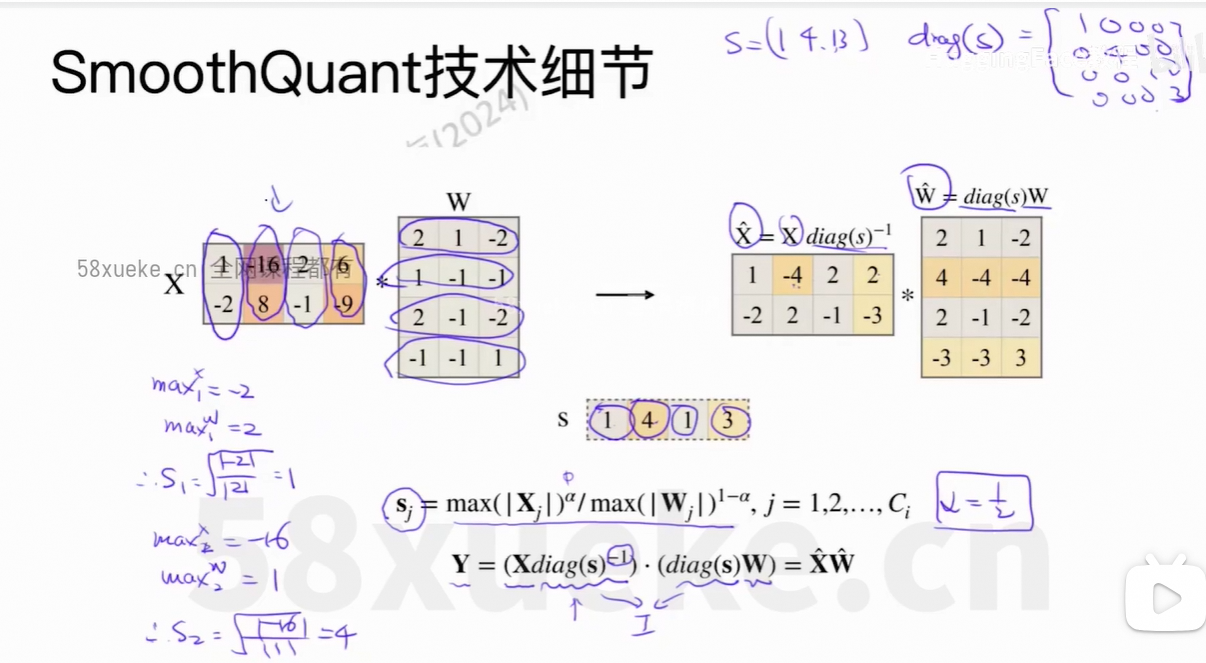
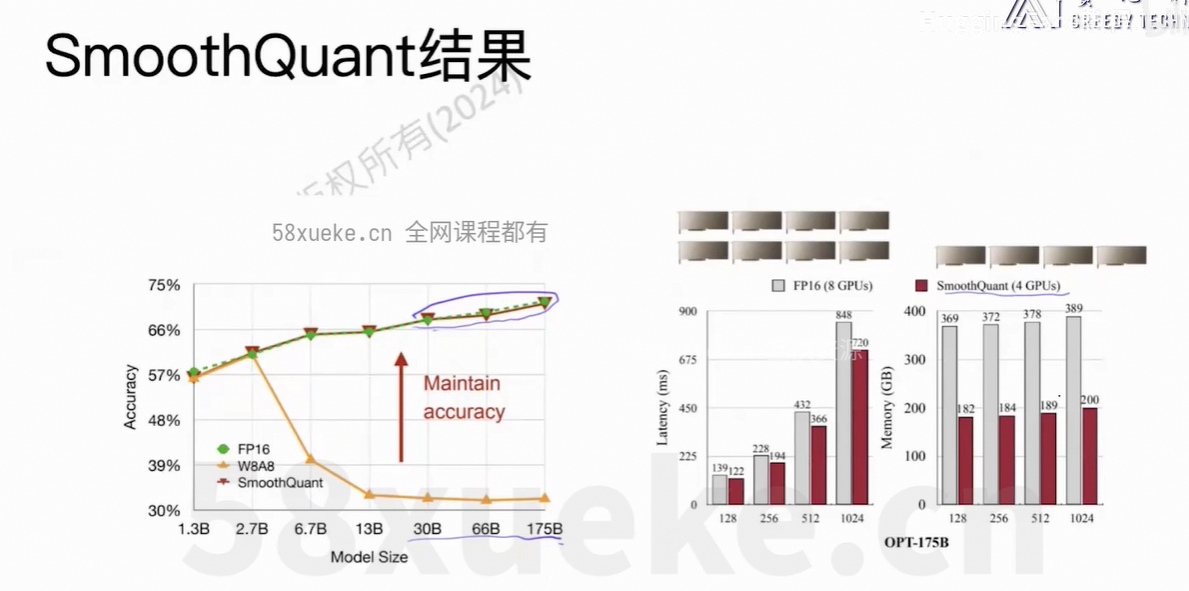
(4)SmoothQuant
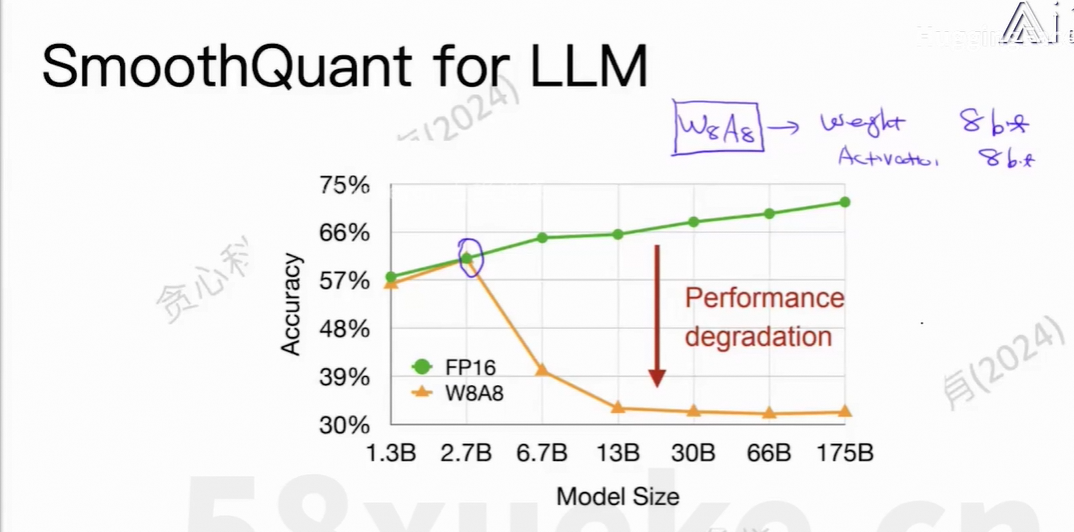
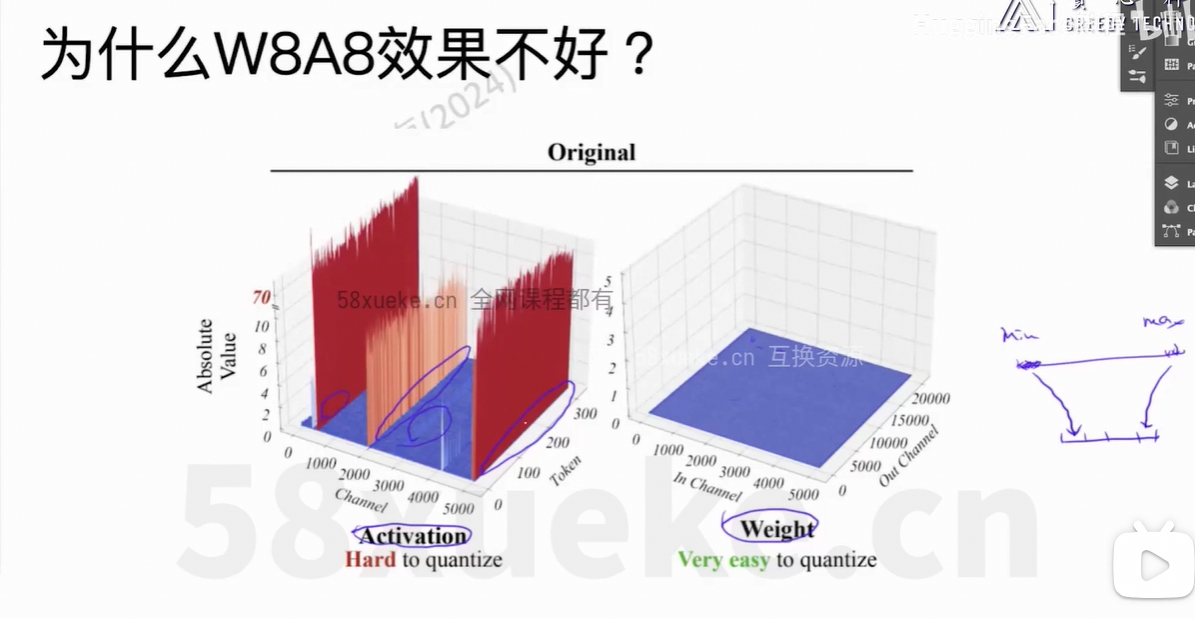
原因:有些Activation的值特别大,导致量化后分布不均衡。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 10
 0
- 0


 已为社区贡献7条内容

所有评论(0)