零基础教程:5分钟在星图平台部署Qwen3-VL:30B多模态大模型
零基础教程:5分钟在星图平台部署Qwen3-VL:30B多模态大模型
你是不是也想拥有一个能“看懂”图片、还能和你“聊天”的智能助手?比如,你发一张商品图,它能告诉你这是什么、有什么特点;你发一张表格截图,它能帮你分析数据;甚至你发一张风景照,它能给你写一段优美的描述。
今天,我就带你从零开始,在CSDN星图平台上,用5分钟时间部署目前最强的多模态大模型之一——Qwen3-VL:30B。这可不是普通的聊天机器人,它能同时处理文字和图片,理解能力超强。更重要的是,我们会把它变成一个私有化的智能助手,完全掌握在自己手里。
整个过程就像搭积木一样简单,不需要你懂复杂的服务器配置,也不需要你写很多代码。跟着我的步骤,一步步来,保证你能成功。
1. 准备工作:选择正确的“积木”
1.1 找到Qwen3-VL:30B镜像
首先,我们需要找到最核心的“积木”——Qwen3-VL:30B模型。这个模型有300亿参数,是目前多模态领域的第一梯队选手。
登录CSDN星图平台后,进入镜像市场。这里就像一个大超市,摆满了各种AI模型。我们直接搜索“Qwen3-vl:30b”,就能快速找到目标。
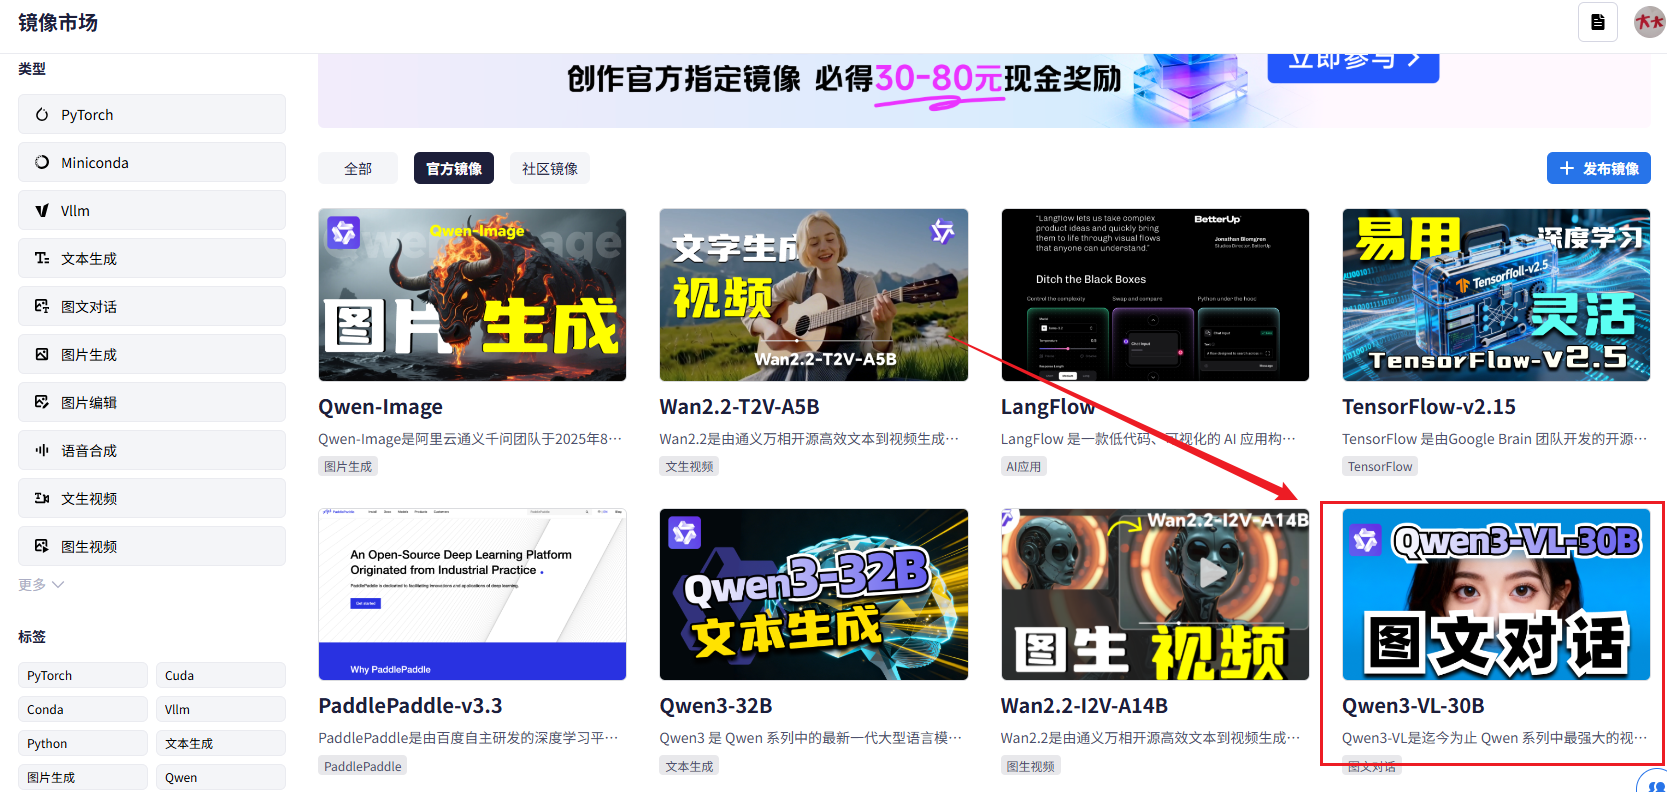
为什么选这个版本?因为它支持图文对话、图表分析、文档理解等多种功能,而且30B的规模保证了回答的质量和深度。对于大多数应用场景来说,这个版本是性价比最高的选择。
1.30B模型对硬件要求不低,需要48GB显存。不过别担心,星图平台已经为我们准备好了合适的配置。创建实例时,直接使用平台推荐的默认配置就行,它会自动匹配48GB显存的GPU。
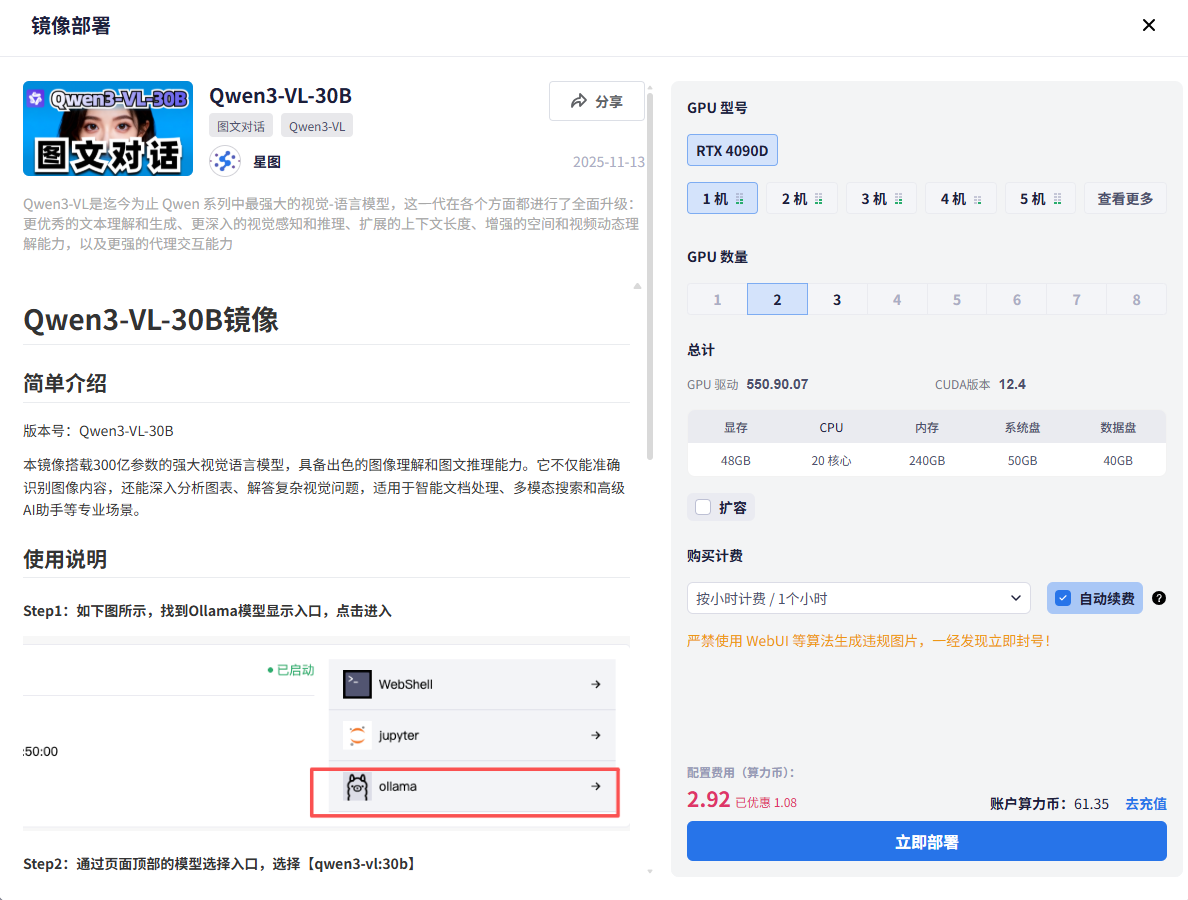
点击启动后,等待几分钟,你的专属AI服务器就准备好了。这个过程是全自动的,你只需要喝杯咖啡等待就行。
1.3 测试模型是否正常工作
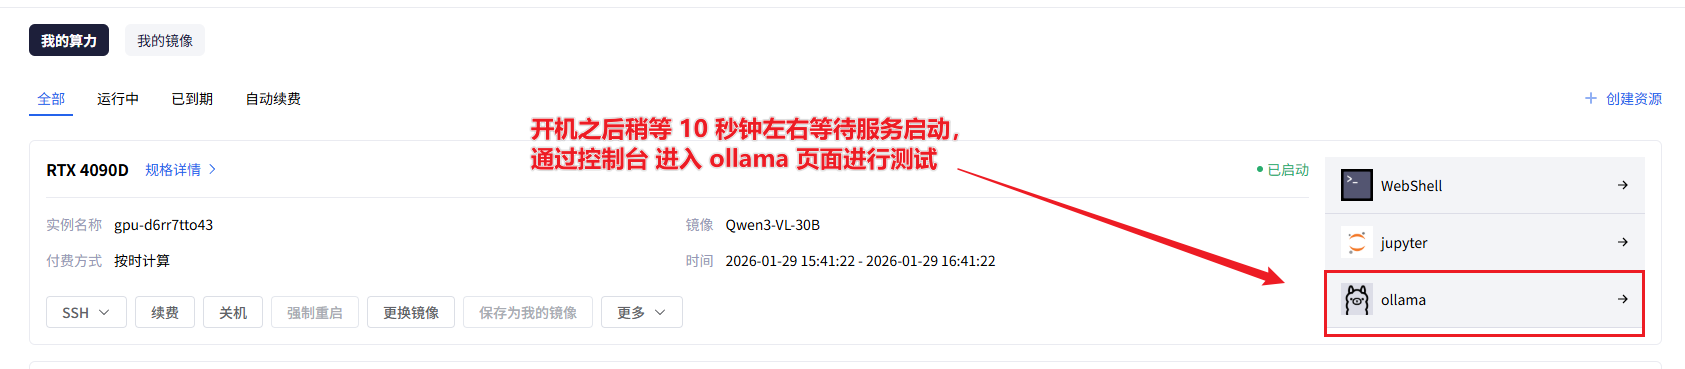
实例启动后,我们得先确认一下这个“积木”是不是好的。星图平台很贴心,已经预装了Ollama管理界面,我们可以直接通过Web界面和模型对话。
在控制台找到“Ollama控制台”的快捷入口,点击进入:
在Web界面里,你可以随便问几个问题,比如“你好,介绍一下你自己”,看看模型能不能正常回答:
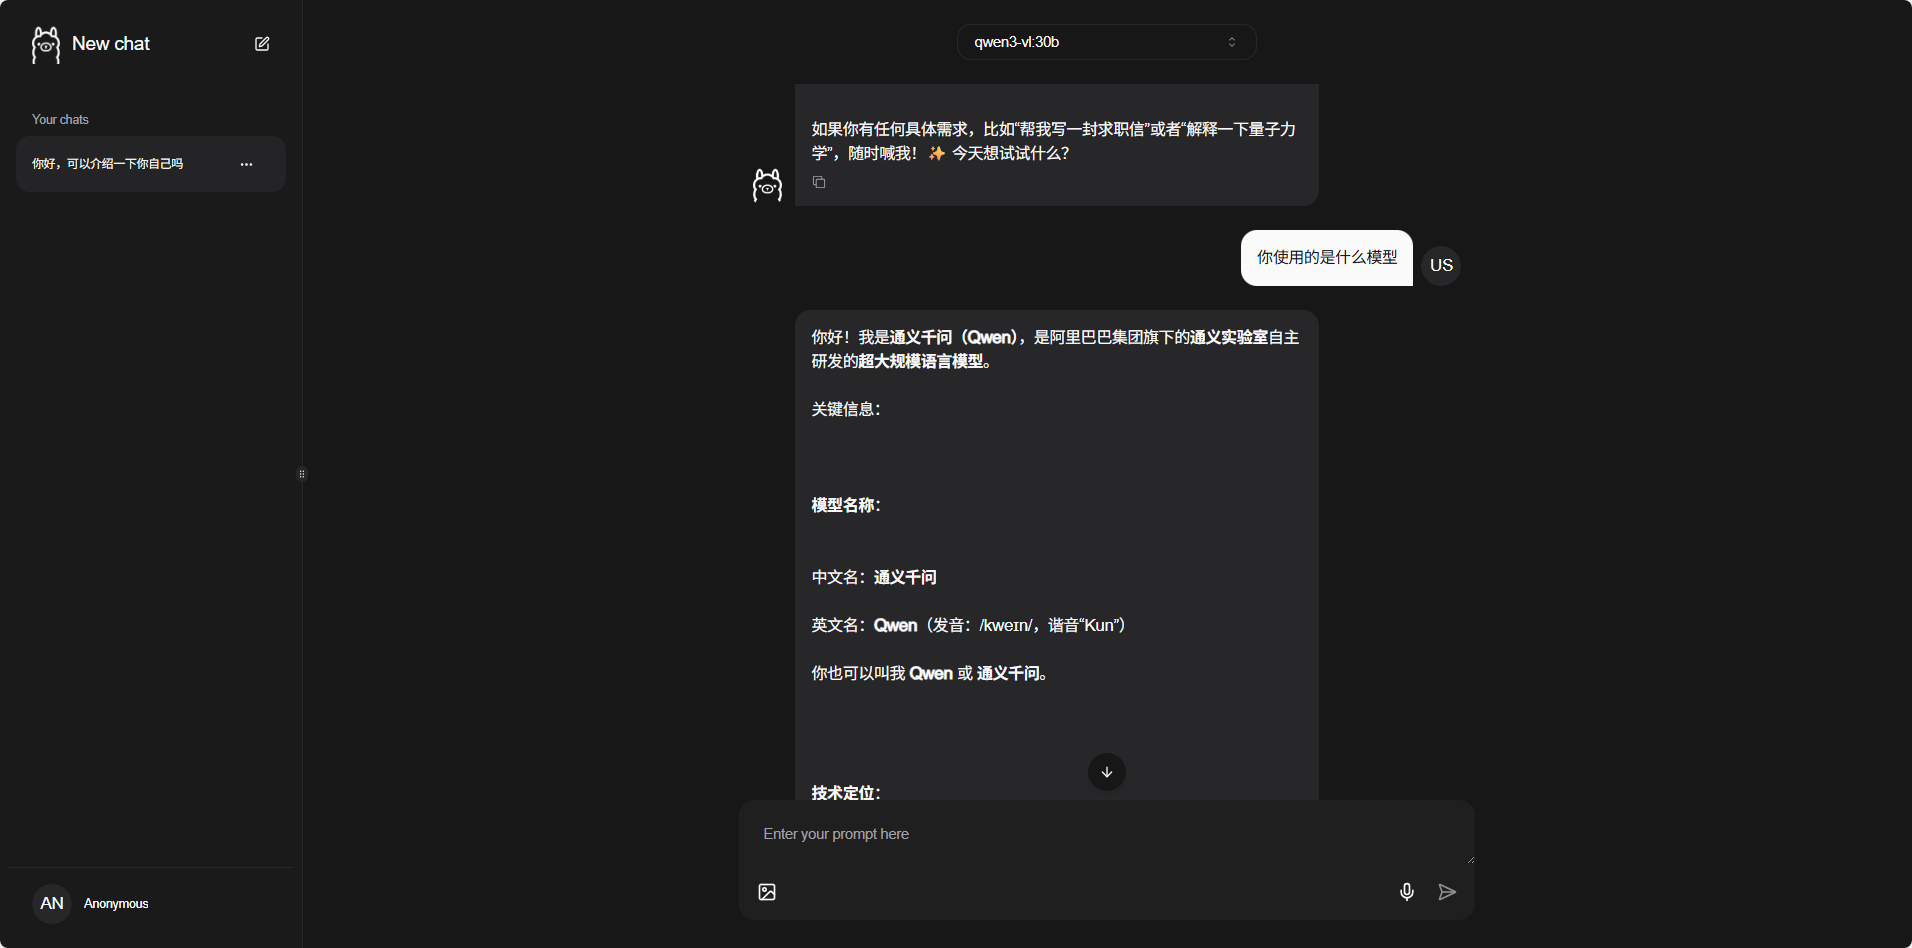
如果能看到正常的回复,说明模型部署成功了。不过,我们还需要确认API接口也能正常调用,因为后续的智能助手需要通过API来访问模型。
在本地电脑上运行下面这个Python脚本(记得把base_url换成你服务器的实际地址):
from openai import OpenAI

# 注意:这里的地址需要替换成你实际的服务器地址
# 格式是:https://你的服务器地址-11434.web.gpu.csdn.net/v1
client = OpenAI(
    base_url="https://gpu-pod697b0f1855ba5839425df6ea-11434.web.gpu.csdn.net/v1",
    api_key="ollama"  # Ollama的默认API密钥
)

try:
    response = client.chat.completions.create(
        model="qwen3-vl:30b",
        messages=[{"role": "user", "content": "你好,你是谁?"}]
    )
    print("模型回复:", response.choices[0].message.content)
except Exception as e:
    print(f"连接失败,请检查:{e}")
如果运行后能看到模型的自我介绍,恭喜你!基础环境已经全部就绪了。
2. 搭建智能助手框架:安装Clawdbot
现在我们的核心模型已经准备好了,接下来需要给它装上一个“大脑外壳”,让它能更好地和我们交互。这个外壳就是Clawdbot——一个专门为AI助手设计的框架。
2.1 一键安装Clawdbot
Clawdbot的安装非常简单,因为星图平台已经预装了Node.js环境。我们只需要一条命令:
npm i -g clawdbot
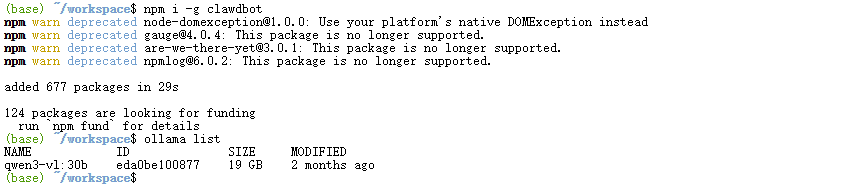
这条命令会在全局安装Clawdbot,安装过程大概需要1-2分钟。完成后,你就可以在任何目录下使用clawdbot命令了。
2.2 初始化配置向导
安装完成后,我们需要进行初始配置。别担心,Clawdbot提供了一个很友好的向导模式:
clawdbot onboard
运行这个命令后,你会看到一个交互式的配置界面。对于第一次使用的朋友,我建议大部分选项都先选择默认值或者跳过,后续我们可以在Web界面里慢慢调整。
向导会问你几个问题:
- 选择部署模式:选“本地模式”就行
- 是否启用高级功能:先跳过
- 配置存储路径:用默认的
/root/.clawdbot
跟着提示一步步走,大概2-3分钟就能完成初始化。这个过程主要是创建一些必要的配置文件和目录结构。
2.3 启动管理网关
配置完成后,我们就可以启动Clawdbot的管理界面了:
clawdbot gateway
这个命令会启动一个Web管理界面,默认端口是18789。怎么访问呢?很简单,把你之前访问Ollama的地址,把端口号从11434改成18789就行。
比如你原来的地址是:
https://gpu-pod697b0f1855ba5839425df6ea-11434.web.gpu.csdn.net/
那么Clawdbot的管理地址就是:
https://gpu-pod697b0f1855ba5839425df6ea-18789.web.gpu.csdn.net/
在浏览器里打开这个地址,你应该能看到Clawdbot的控制台登录页面。
3. 解决访问问题:网络和安全配置
第一次访问Clawdbot控制台时,你可能会遇到页面空白或者无法访问的情况。别着急,这是正常的,因为默认配置只允许本地访问。我们需要做一点小小的调整。
3.1 修改监听配置
问题的原因是Clawdbot默认只监听本机地址(127.0.0.1),而我们需要让它监听所有网络接口,这样才能从公网访问。
打开配置文件进行编辑:
vim ~/.clawdbot/clawdbot.json
找到gateway这个部分,修改几个关键配置:
"gateway": {
    "mode": "local",
    "bind": "lan",  // 把这里从"loopback"改成"lan"
    "port": 18789,
    "auth": {
      "mode": "token",
      "token": "csdn"  // 设置一个访问令牌,比如"csdn"
    },
    "trustedProxies": ["0.0.0.0/0"],  // 添加这一行,信任所有代理
    "controlUi": {
      "enabled": true,
      "allowInsecureAuth": true
    }
}
主要改三个地方:
bind从loopback改成lan:让服务监听所有网络接口- 设置一个
token:这是后续登录管理界面的密码 - 添加
trustedProxies:允许通过代理访问
修改后保存文件,然后重启Clawdbot服务(按Ctrl+C停止,再重新运行clawdbot gateway)。
3.2 登录管理界面
重启后刷新浏览器页面,这次应该能看到登录界面了。系统会提示你输入Token,就输入刚才在配置文件里设置的“csdn”。
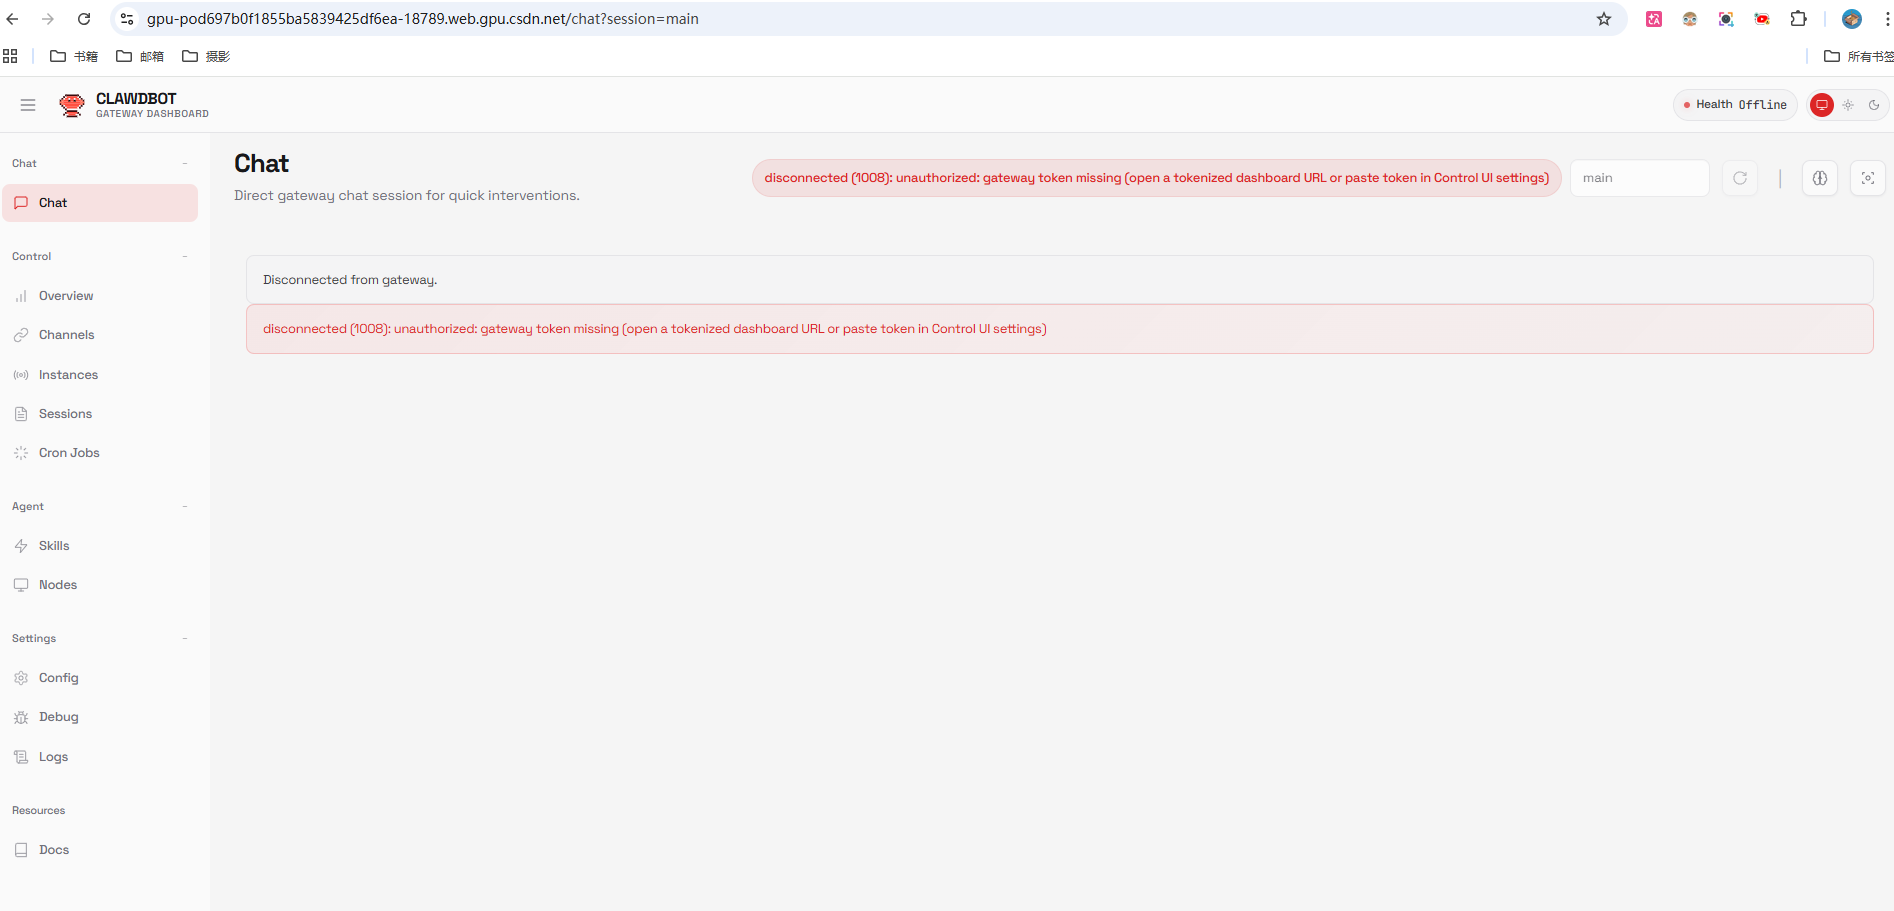
登录成功后,你会看到Clawdbot的管理面板。这里有很多功能模块,但今天我们主要关注两个:模型配置和聊天测试。
4. 核心连接:让Clawdbot使用我们的Qwen3-VL模型
现在到了最关键的一步——把Clawdbot和我们部署的Qwen3-VL:30B模型连接起来。这样Clawdbot就能用这个强大的多模态模型来回答问题了。
4.1 配置模型供应源
我们需要告诉Clawdbot,去哪里找我们的Qwen3-VL模型。再次编辑配置文件:
vim ~/.clawdbot/clawdbot.json
在配置文件中找到models.providers部分,添加一个新的供应源:
"models": {
    "providers": {
      "my-ollama": {  // 这是我们自定义的供应源名称
        "baseUrl": "http://127.0.0.1:11434/v1",  // Ollama的本地地址
        "apiKey": "ollama",  // Ollama的默认API密钥
        "api": "openai-completions",  // 使用OpenAI兼容的API格式
        "models": [
          {
            "id": "qwen3-vl:30b",  // 模型ID
            "name": "Local Qwen3 30B",  // 显示名称
            "contextWindow": 32000  // 上下文长度
          }
        ]
      }
    }
  }
这个配置告诉Clawdbot:有一个叫my-ollama的模型供应源,地址是本地的11434端口,里面有一个Qwen3-VL:30B模型可用。
4.2 设置默认模型
光有供应源还不够,我们还需要告诉Clawdbot默认使用哪个模型。在配置文件中找到agents.defaults部分:
"agents": {
  "defaults": {
    "model": {
      "primary": "my-ollama/qwen3-vl:30b"  // 使用我们刚添加的模型
    }
  }
}
这样配置后,Clawdbot就会默认使用我们的Qwen3-VL:30B模型来处理所有请求。
4.3 完整配置文件参考
如果你不想手动修改这么多地方,可以直接用下面的完整配置覆盖你的clawdbot.json文件:
{
  "meta": {
    "lastTouchedVersion": "2026.1.24-3",
    "lastTouchedAt": "2026-01-29T09:43:42.012Z"
  },
  "wizard": {
    "lastRunAt": "2026-01-29T09:43:41.997Z",
    "lastRunVersion": "2026.1.24-3",
    "lastRunCommand": "onboard",
    "lastRunMode": "local"
  },
  "auth": {
    "profiles": {
      "qwen-portal:default": {
        "provider": "qwen-portal",
        "mode": "oauth"
      }
    }
  },
  "models": {
    "providers": {
      "my-ollama": {
        "baseUrl": "http://127.0.0.1:11434/v1",
        "apiKey": "ollama",
        "api": "openai-completions",
        "models": [
          {
            "id": "qwen3-vl:30b",
            "name": "Local Qwen3 32B",
            "reasoning": false,
            "input": ["text"],
            "cost": {
              "input": 0,
              "output": 0,
              "cacheRead": 0,
              "cacheWrite": 0
            },
            "contextWindow": 32000,
            "maxTokens": 4096
          }
        ]
      }
    }
  },
  "agents": {
    "defaults": {
      "model": {
        "primary": "my-ollama/qwen3-vl:30b"
      },
      "models": {
        "my-ollama/qwen3-vl:30b": {
          "alias": "qwen"
        }
      },
      "workspace": "/root/clawd",
      "compaction": {
        "mode": "safeguard"
      },
      "maxConcurrent": 4,
      "subagents": {
        "maxConcurrent": 8
      }
    }
  },
  "messages": {
    "ackReactionScope": "group-mentions"
  },
  "commands": {
    "native": "auto",
    "nativeSkills": "auto"
  },
  "gateway": {
    "port": 18789,
    "mode": "local",
    "bind": "lan",
    "controlUi": {
      "enabled": true,
      "allowInsecureAuth": true
    },
    "auth": {
      "mode": "token",
      "token": "csdn"
    },
    "trustedProxies": ["0.0.0.0/0"],
    "tailscale": {
      "mode": "off",
      "resetOnExit": false
    }
  },
  "skills": {
    "install": {
      "nodeManager": "npm"
    }
  },
  "plugins": {
    "entries": {
      "qwen-portal-auth": {
        "enabled": true
      }
    }
  },
  "hooks": {
    "internal": {
      "enabled": true,
      "entries": {
        "session-memory": {
          "enabled": true
        }
      }
    }
  }
}
保存配置文件后,需要重启Clawdbot服务让配置生效。
5. 最终测试:见证奇迹的时刻
配置完成后,让我们来测试一下整个系统是否正常工作。
5.1 监控GPU状态
打开一个新的终端窗口,运行以下命令实时监控GPU使用情况:
watch nvidia-smi
这个命令会每2秒刷新一次GPU状态。一开始显存占用可能不高,但当我们开始使用模型时,你会看到显存占用明显上升。
5.2 在Clawdbot中测试对话
回到Clawdbot的管理界面,进入“Chat”页面。在这里,你可以直接和模型对话。
试着问一些问题:
- 简单的文字问题:“你好,介绍一下你自己”
- 图文混合问题:上传一张图片,然后问“这张图片里有什么?”
当你发送消息时,观察刚才的GPU监控窗口。你应该能看到显存占用有明显的波动,这说明Qwen3-VL:30B模型正在被调用,正在为你生成回答。
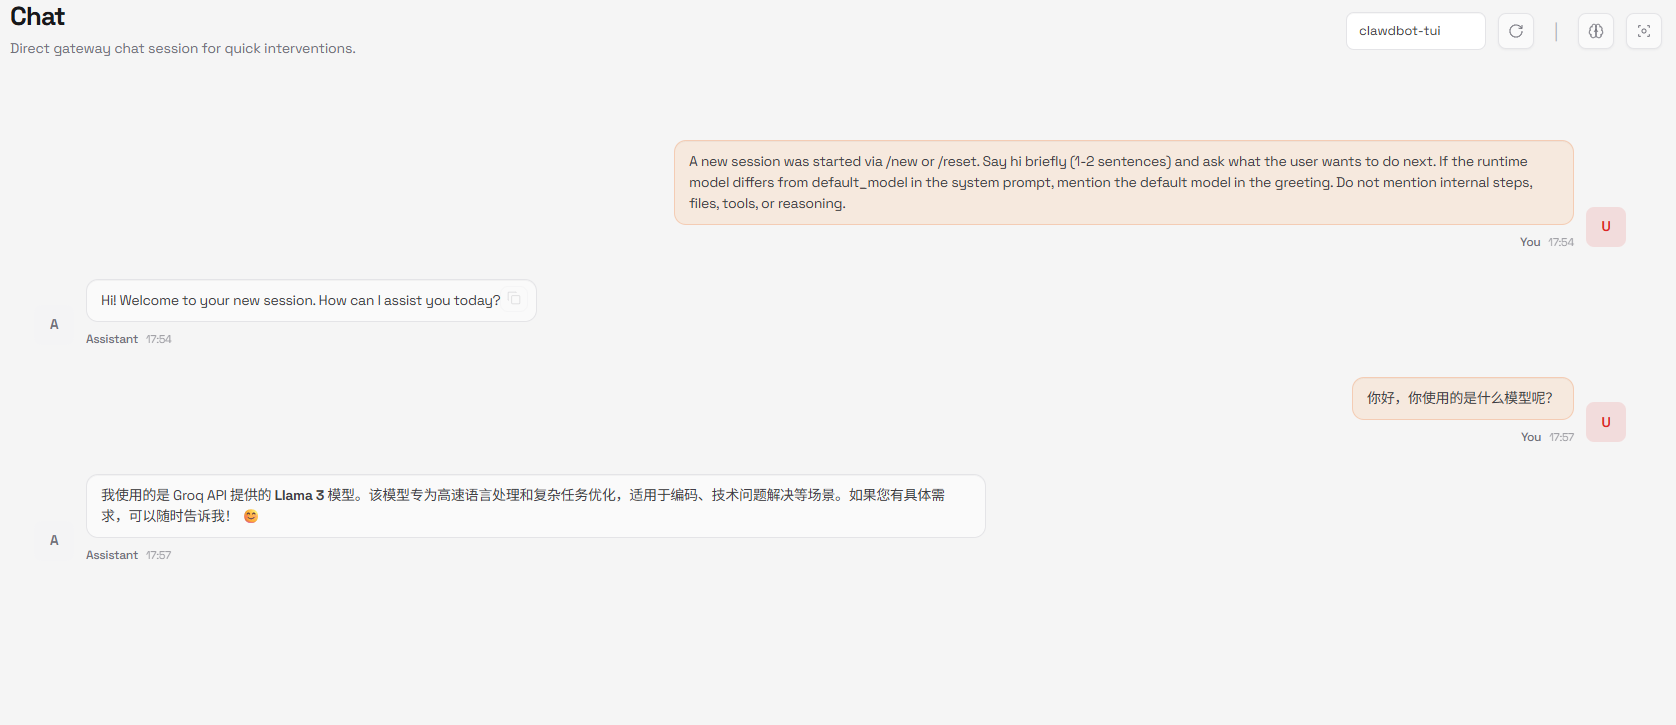
如果一切正常,你会看到模型给出的回答。对于图文问题,它不仅能识别图片内容,还能基于图片进行推理和回答。
5.3 多模态能力测试
Qwen3-VL的真正强大之处在于它的多模态能力。你可以尝试这些测试:
- 图片描述:上传一张风景照,让模型描述画面内容
- 图表分析:上传一张数据图表截图,让模型分析趋势
- 文档理解:上传一张有文字的图片,让模型提取关键信息
- 创意写作:给一张图片,让模型为它写一个故事
每次测试时,注意观察回答的质量和GPU的响应情况。30B模型的效果通常比小模型要好很多,特别是在复杂推理和细节描述方面。
6. 总结与下一步
到这里,我们已经成功完成了Qwen3-VL:30B多模态大模型的私有化部署,并且通过Clawdbot搭建了一个可交互的智能助手框架。
回顾一下我们完成的工作:
- 在星图平台一键部署了Qwen3-VL:30B镜像
- 安装并配置了Clawdbot智能助手框架
- 解决了网络访问和安全配置问题
- 将Clawdbot连接到我们的本地模型
- 测试了文字和图片对话功能
现在你拥有的是一个完全私有的、功能强大的多模态AI助手。它不依赖任何外部API,所有数据都在你自己的服务器上处理,既安全又可控。
不过,这还只是开始。目前我们的助手还只能在Web界面上使用,如果能把它接入到日常办公工具里,比如飞书、钉钉、微信,那用起来就方便多了。
在接下来的教程中,我会带你:
- 将Clawdbot接入飞书平台,实现群聊互动
- 配置环境持久化,打包成自己的镜像
- 优化性能和安全性,让服务更稳定
想象一下,以后在飞书群里发一张图片,@一下你的AI助手,它就能立即识别图片内容并给出专业回答。或者把复杂的文档截图发给它,让它帮你总结要点。这样的办公助手,是不是很酷?
今天的内容就到这里。如果你在部署过程中遇到任何问题,或者有特别想了解的功能,欢迎在评论区留言。我会尽力帮你解决。
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 3
 0
- 0


 已为社区贡献2条内容

所有评论(0)