AI大模型RAG与Agent开发学习
·
OpenAI基础使用
0penAI库是OpenAI官方推出的Python SDK,核心作用是让开发者能简单、高效地调用 OpenAI的各类API(如GPT聊天、DALL·E绘图、语音转文字等),无需手动处理HTTP请求、身份验证等底层细节。由于其发布较早且比较易用,现如今许多模型服务商(如阿里云百炼平台)均兼容0penAI SDK的调用。
基础使用
主要使用流程:
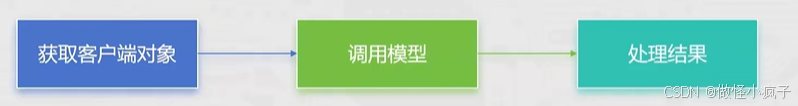
获取客户端对象
from openai import OpenAI
import os

client = OpenAI(
    # 如果没有配置环境变量,请用阿里云百炼API Key替换:api_key="sk-xxx"
    # api_key="xxx",
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    # base_url="http://localhost:11434/v1",
)
主要是使用两个参数:
api_key:模型服务商提供的APIKEY密钥base_url:模型服务商的API接入地址- 主要基于此参数来切换不同的模型服务商(比如OpenAI、阿里云、腾讯云等)
调用模型
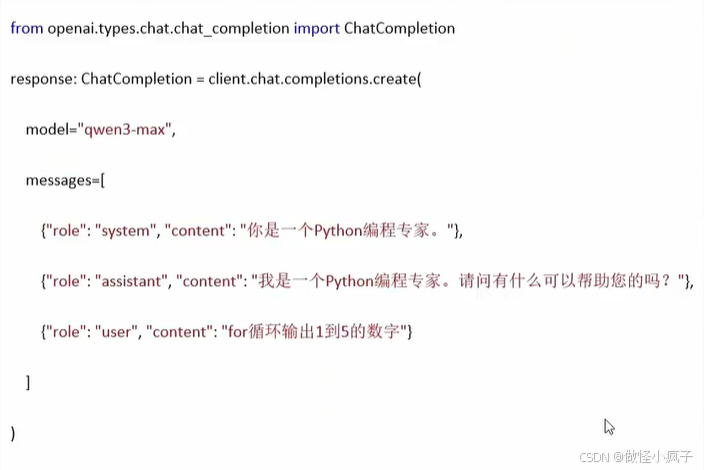
client.chat.completions.create创建ChatCompletion对象
主要参数有2个:
model:选择所用模型,如代码的qwen3.5-plusmessages:提供给模型的消息- 类型:list,可以包含多个字典消息
- 每个字典消息包含2个key(role:角色、content:内容
- system角色:设定助手的整体行为、角色和规则,为对话提供上下文框架(如指定助手身份、回答风格、核心要求),是全局的背景设定,影响后续所有交互。
- assistant角色:代表AI助手的回答,可以在代码中认为设定
- user角色:代表用户,发送问题、指令或需求
处理结果
response变量就是 ChatCompletion对象,包含内容信息如下:
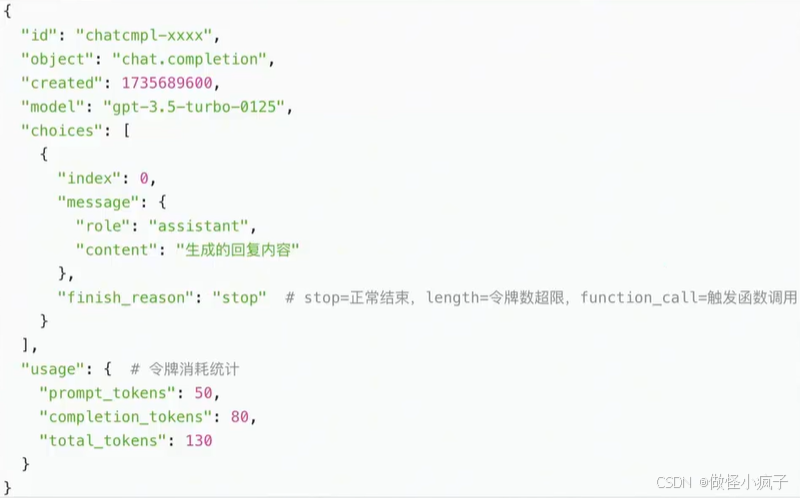
可通过 print(response.choices[0].message.content)输出模型给出的回答信息
尝试写代码:
# 1.获取client对象
# 创建一个 openAI的;类对象
from openai import OpenAI
client = OpenAI(
    base_url='https://dashscope.aliyuncs.com/compatible-mode/v1'
)

# 2.调用模型
response = client.chat.completions.create(
    model='qwen3.5-plus',
    messages=[
        {"role": "system", "content": "你是一个python编程专家,并且不说废话简单回复"},
        {"role": "assistant", "content": "好的,我是编程专家,并且话不多,你要问什么?"},
        {"role": "user", "content": "使用python代码,输出1-10"}
    ]
)
# 3.处理回复
print(response.choices[0].message.content)
结果如下:
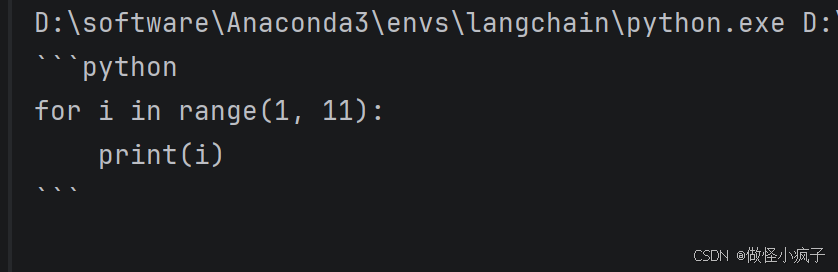
流式输出模式
可以设定结果输出为stream模型(流式输出),获得更好的使用体验 (就是我们看到的模型会一个字一个字进行输出)
开启流式输出的两个步骤:
- 在client.chat.comletions.create()调用模型的时候设定参数:
stream=True - for循环response对象,并在循环内输出内容
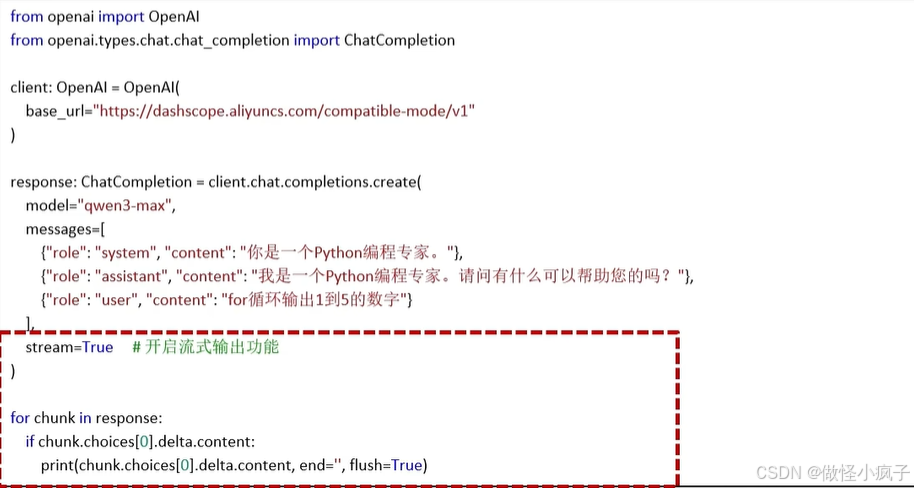
# 1.获取client对象
# 创建一个 openAI的;类对象
from openai import OpenAI
client = OpenAI(
    base_url='https://dashscope.aliyuncs.com/compatible-mode/v1'
)

# 2.调用模型
response = client.chat.completions.create(
    model='qwen3-max',
    messages=[
        {"role": "system", "content": "你是一个python编程专家,并且话很多"},
        {"role": "assistant", "content": "好的,我是编程专家,并且话很多,你要问什么?"},
        {"role": "user", "content": "使用python代码,输出1-10"}
    ],
    stream=True # 开启流式输出的功能
)
# 3.处理回复
# print(response.choices[0].message.content)

for chunk in response:
    print(
        chunk.choices[0].delta.content,
        end=" ", # 每一段以空格分隔
        flush=True # 立刻刷新缓冲区
    )
附带历史消息调用模型
调用模型传入的参数message,其要求是list对象,即表明其支持非常多的消息在内,可以基于此,将历史消息填入,让模型知晓对话的上下文,更好的回答。
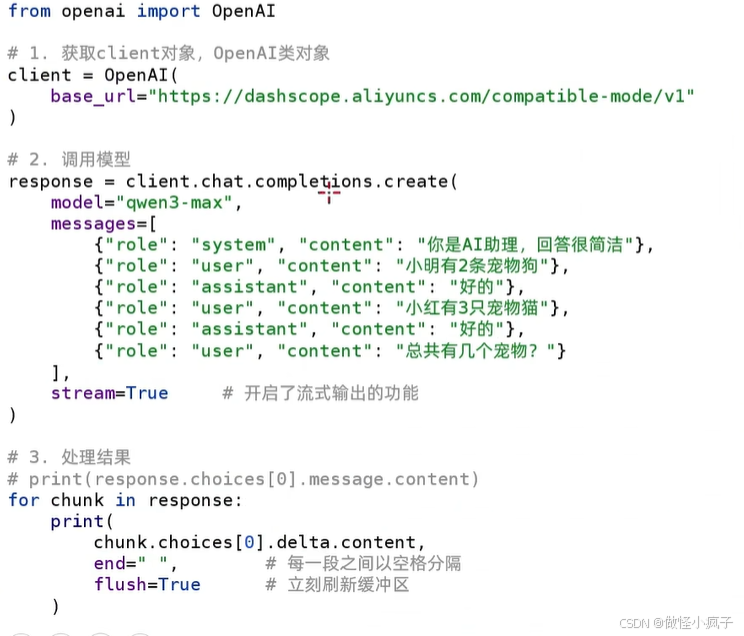
# 1.获取client对象
# 创建一个 openAI的;类对象
from openai import OpenAI
client = OpenAI(
    base_url='https://dashscope.aliyuncs.com/compatible-mode/v1'
)

# 2.调用模型
response = client.chat.completions.create(
    model='qwen3-max',
    messages=[
        {"role": "system", "content": "你是一个AI助理,回答简洁"},
        {"role": "user", "content": "小明有2条宠物狗"},
        {"role": "assistant", "content": "好的"},
        {"role": "user", "content": "小红有6条宠物狗"},
        {"role": "user", "content": "一共有多少只宠物?"}
    ],
    stream=True # 开启流式输出的功能
)
# 3.处理回复
# print(response.choices[0].message.content)

for chunk in response:
    print(
        chunk.choices[0].delta.content,
        end=" ", # 每一段以空格分隔
        flush=True # 立刻刷新缓冲区
    )
总结:在调用模型时,可以通过message的list内,组织历史消息提供给模型。
PS:当前的历史消息是一次性的,如果是生产系统可以将消息保存到文件、数据库等持久化工具内,需要的时候提取使用(后续学习LangChain库,会学习短期记忆和长期记忆的使用方法。)

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)