边缘计算与AK-NN的车辆健康监测
基于边缘计算和AK‐NN算法的车辆健康监测预测性分析即服务
摘要
智能物流是工业4.0的一部分。随着车辆行业技术的不断发展,机器学习算法被应用于传感器数据,以检测车辆部件的故障。文献中提出了多种用于实时提供服务的车辆健康监测系统。从云端获取的传感器数值通过机器学习算法进行处理,但存在执行延迟和数据中心故障的问题。近年来引入了边缘计算,使得密集型操作在设备边缘而非云端执行。本文提出了一种基于边缘计算的故障预测系统,该系统将利用内部和外部传感器实时预测车辆健康状况。风险详情通过移动应用以通知形式以及终端上的仪表板进行展示。此类系统减少了车辆数据发送与处理之间的延迟。所提出的系统采用名为AK‐NN的ANN与k‐NN分类器集成模型,以提高预测性能。第一步,在雪佛兰汽车OBD数据集上对人工神经网络进行训练和验证。该最佳训练网络报告的误差被k‐最近邻用于误差分布的统计分析。基于人工神经网络、k‐最近邻和AK‐NN三种不同实验分别使用NRMSE、决定系数、交叉熵损失、准确率和ROC指标进行评估。当k = 3时,k‐最近邻模型达到85%准确率,人工神经网络为78%准确率,集成方法达到98.7%。此外,针对84辆车辆,通过分析仪表板在手机上实现预测警报,并基于平均故障间隔时间(MTBF)和平均修复时间(MTTR)等关键绩效指标进行了对比研究,证明系统达到了可用性目标。© 2021爱思唯尔有限公司。保留所有权利。
1. 引言
在当前的车辆行业中,自动化和预测性维护对于车辆及驾驶员的安全至关重要且非常有用。预测性维护是用于计算车辆健康状况以及分析传感器性能以检测潜在故障和缺陷并在其导致实际故障前进行修复的最佳技术。根据高德纳报告[1],预测性维护预计到2022年将增长四倍,市场规模可能达到129亿美元。车辆维护通常按周期或日历进行,或者在需要时进行。另有报告指出[2],18%的车辆存在与使用年限相关的故障,而82%的车辆则出现随机性故障。如果没有适当的车辆健康监测,可能会造成显著的浪费,例如40%的维护成本。尽管最新制造的车辆配备了产生数据的车载传感器,但这些数据并未被用于分析。
基于实时数据的预测性数据分析有助于在车辆部件实际发生故障之前识别潜在故障。智能物流作为工业4.0的一部分,致力于开发定制化的驾驶员辅助系统和预测性维护系统,使车辆部件能够告知在预估的时间范围内可能发生何种维修。
A. 动机
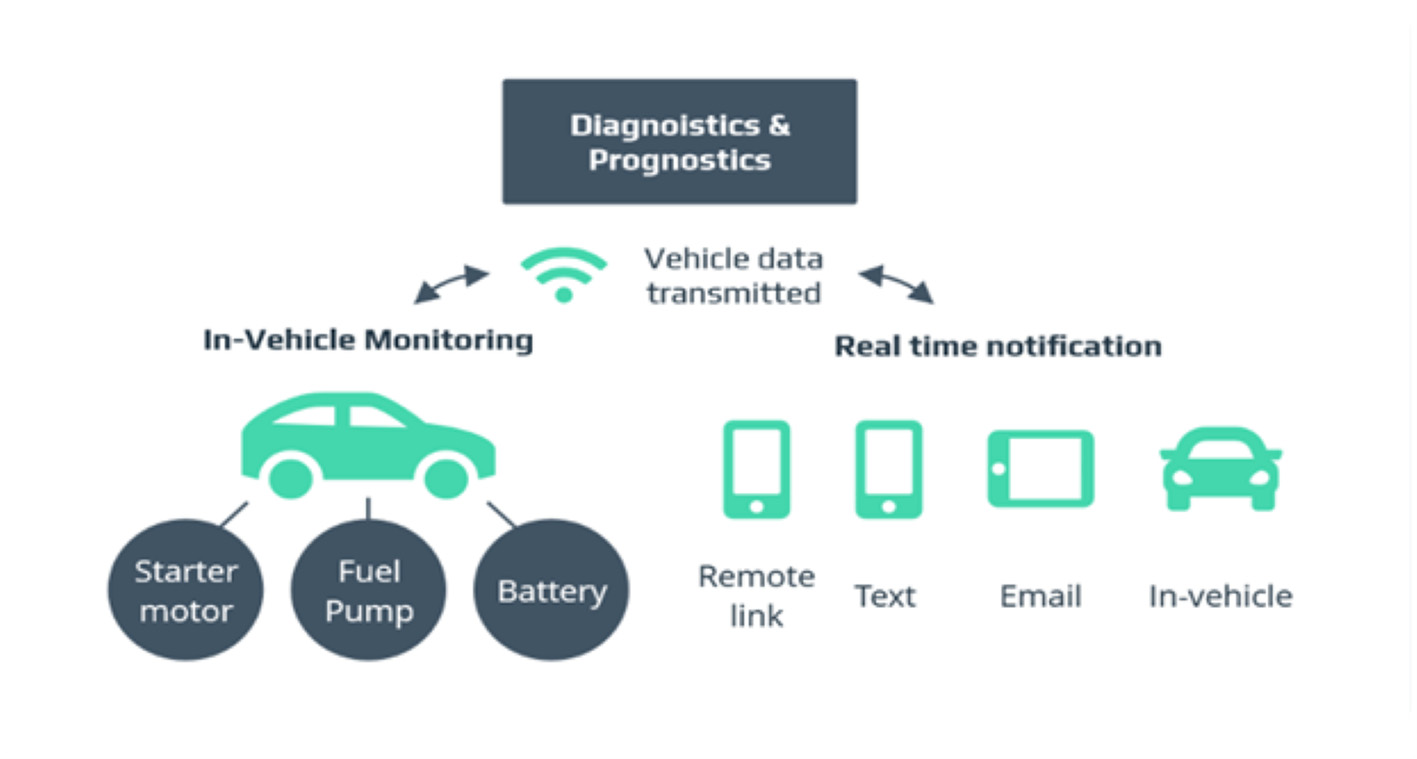
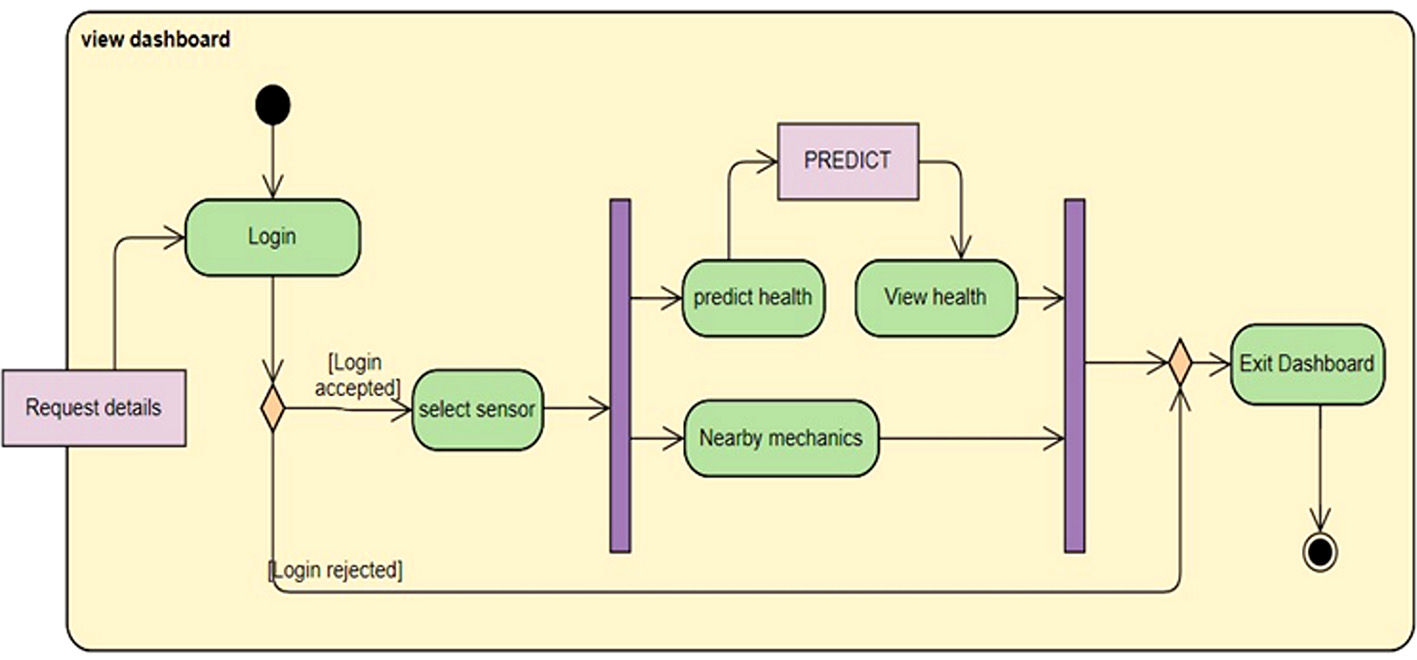
全球汽车行业预计到2030年将达到九万亿美元。由于各种系统故障导致的事故相应增加,同时汽车行业的维护也缩短了车辆寿命并造成经济损失。预测性维护用于解决问题并作为一种成本高效的机制。预测性维护是用于计算车辆健康状况以及分析传感器性能以检测可能的故障和缺陷的最佳技术,以便在它们导致故障之前进行修复。我们需要如图1所示的预测性维护系统。
它可以收集车辆各部分的传感器数据,实时与云端通信并存储数据,评估潜在风险,在需要维修时向驾驶员发出警报,以避免车辆异常停运。
B. 贡献
开发一种自动化系统,该系统使用AK‐NN算法来预测车辆各个子系统的健康状况。该系统可在移动设备上实时监控车辆健康状态,类似于谷歌Android Auto或苹果CarPlay,促进车联网(IoV)的发展。该系统具备平台独立性,能够在任何设备上无损失、无延迟地提供最佳安全性与服务。每个传感器均单独应用预测分析算法,以预测车辆健康状态,并向驾驶员提供辅助信息,预防事故并保障车辆安全。驾驶员可通过移动设备获取车辆健康状态的辅助信息。该应用的安全性达到最佳水平,因其采用谷歌平台及谷歌账户登录机制来访问应用。该应用成本效益高且具备平台独立性。
可以使用任何设备访问,例如工作站、台式计算机、笔记本电脑、平板电脑、智能手机(安卓、iOS)、超便携式电脑和掌上电脑。
C. 组织结构
本文组织如下:第2节描述了关于车辆健康监测和预测性维护的文献综述。第3节描述了提出的框架。结果与讨论在第4节中给出。
2. 文献综述
机器学习算法,如k‐最近邻(k‐NN)在预测多数类方面表现良好,但对噪声敏感,且在处理高维数据时性能不佳。类似地,人工神经网络(ANN)即使在存在噪声或不熟悉数据的情况下也能更好地进行分类。
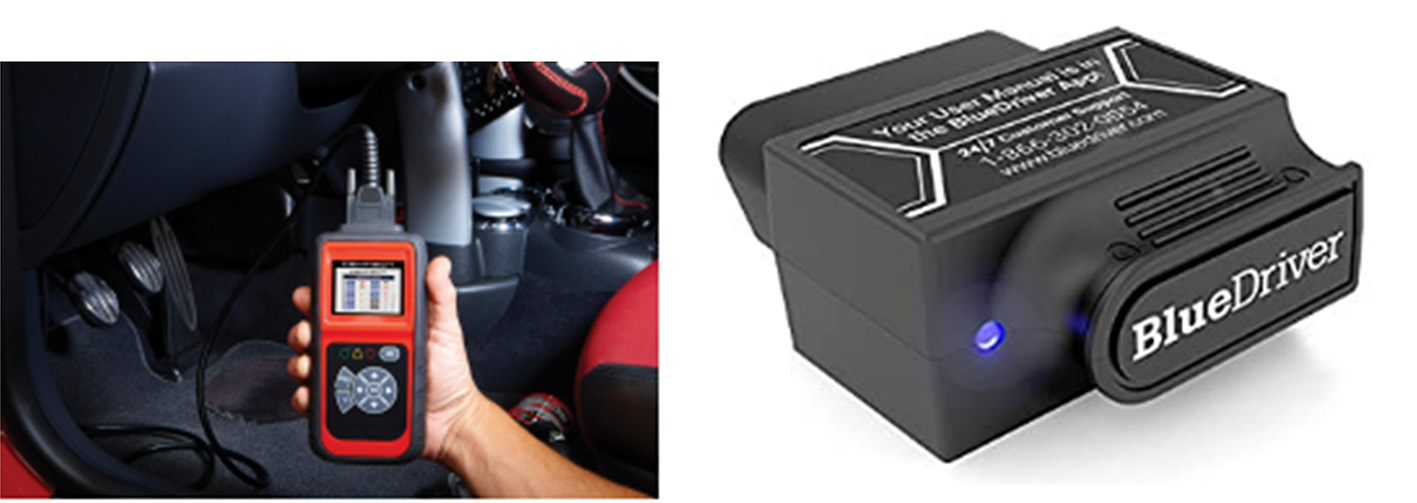
以下图2展示了配备扫描工具的传统车辆诊断方法。这些工具将有助于维修工作。使用此类工具的优点在于它们可通过基于蓝牙的移动设备运行。
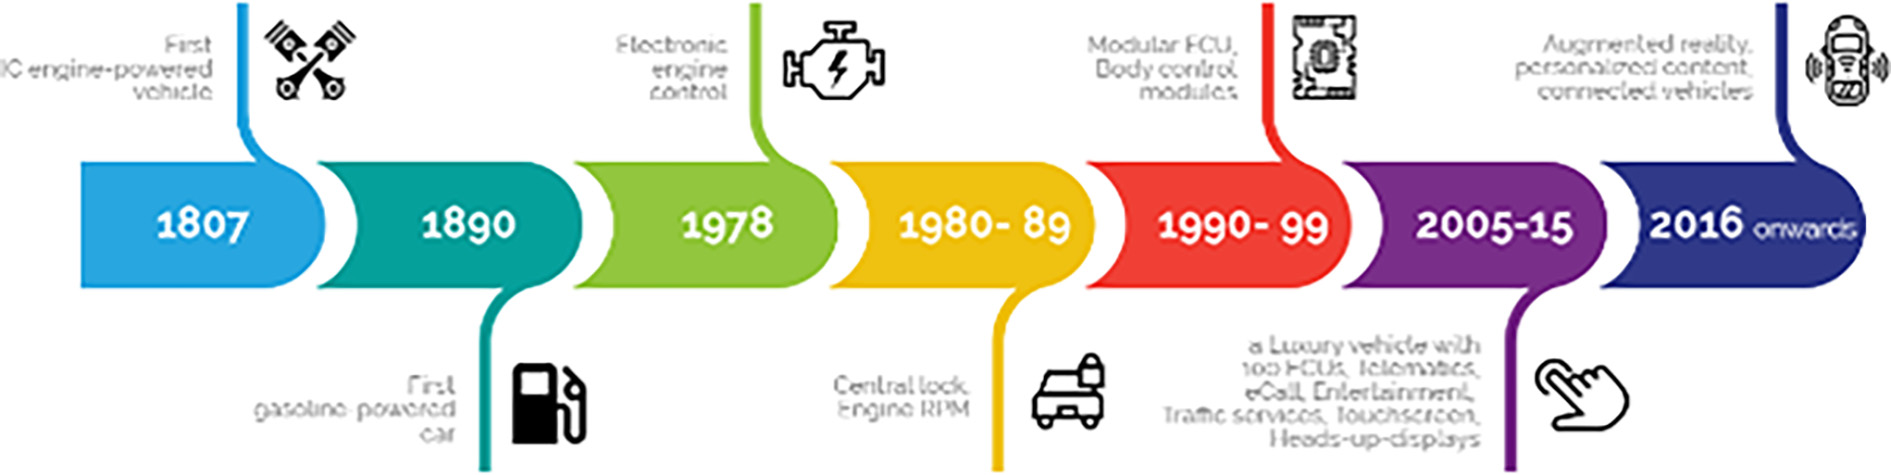
OBDII接口可以插入车辆端口,能够对温度、压力、机油进行实时诊断。Launch X431V +是一种双向诊断工具,可对发动机进行诊断并发送/接收数据。这些工具在诊断车辆某些部件方面表现良好,但可能存在兼容性问题,例如适用于某些智能手机,某些工具可能会在一个屏幕上冻结,柴油/汽油车辆可能出现这种情况。以下图3提到了过去一个世纪汽车工业的发展历程,并指出了边缘计算的重要性。
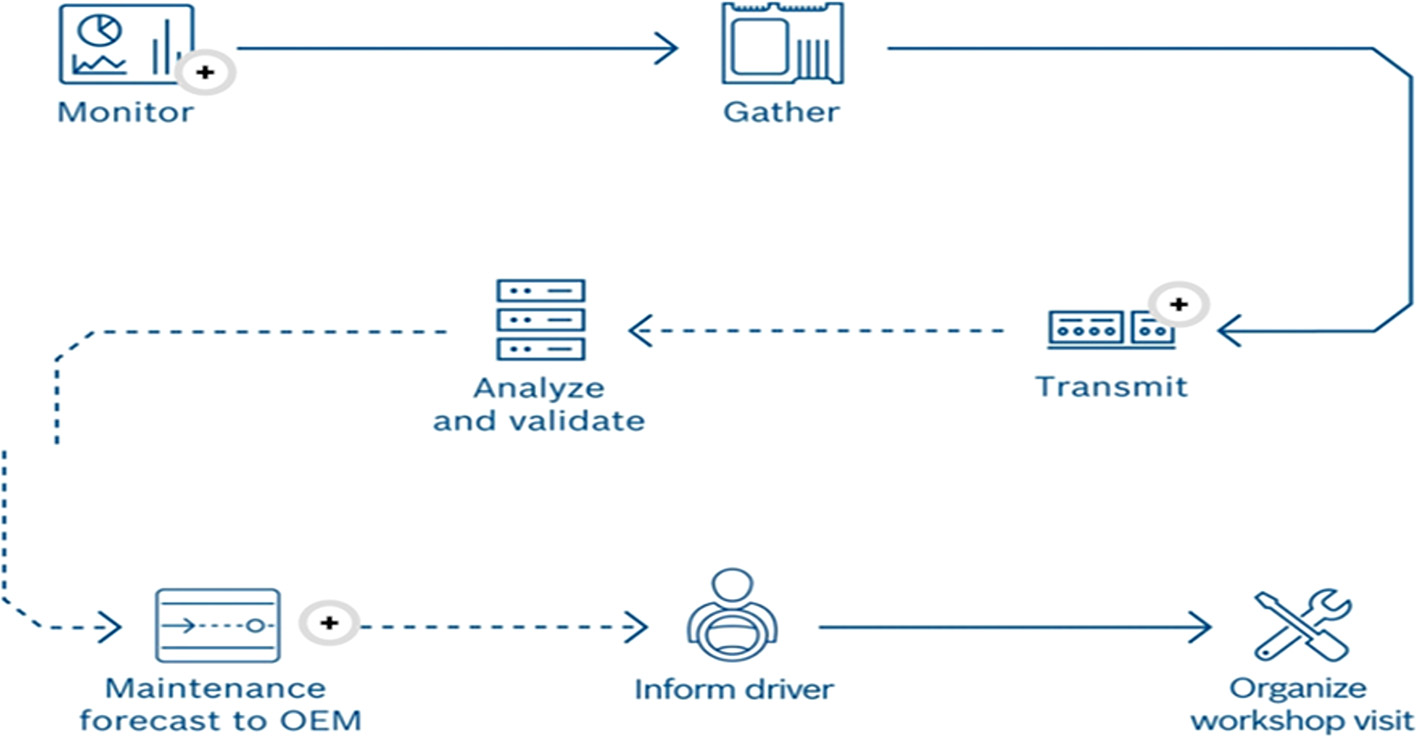
在[4]中报道的研究提出了一种利用四种分类器算法对车辆子系统进行故障预测的故障预测系统。作者使用丰田卡罗拉车型对其系统进行验证,并通过计算ROC来测试分类器的准确率。车载诊断系统在[5]中进行了说明。然而,作者并未明确说明所使用的算法及其有效性。在[6]作者所阐述的报告中,研究了用于预测车辆维护的算法。实验基于AB沃尔沃的数据库开展,以特异性和敏感性作为性能评估指标。在[7]中介绍了使用分层改进模糊支持向量机预测车辆故障的方法,并将其在敏感性和特异性方面的性能与逻辑回归、随机森林和支持向量机等其他算法进行了比较。保修预测在[8]中进行了说明。一些汽车博世等公司[9]拥有预测性诊断软件,可预测车辆故障并生成报告,如图4所示。可以看出,车载单元上存在软件模块,能够确保透明性。
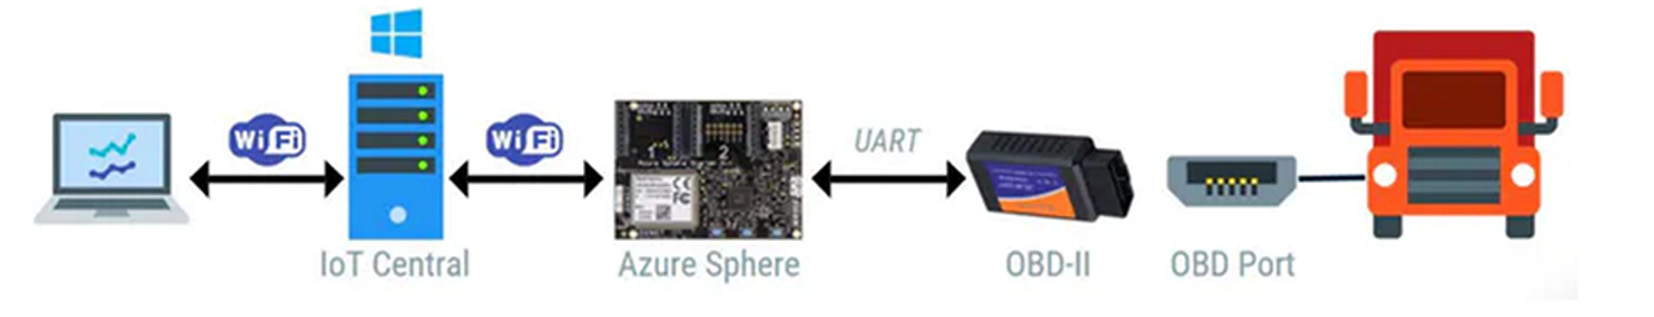
基于物联网的嵌入式系统在[10]中被解释,用于通过温度和机油质量参数检测车辆健康状况。数字孪生系统在[12]中被说明,该系统将获取传感器数据,并使用机器学习算法预测车辆部件缺陷。在[13]中报道了一种使用深度学习的集成系统。他们的系统将从自动驾驶汽车收集传感器数据并使用深度学习进行处理。作者解释说,该系统将通过向驾驶员报告结果来防止车辆碰撞和事故。如[14]所述,收集来自刹车、传动系统、涡轮增压器和中冷器的历史数据,并进行处理以提醒乘客维修成本。在[15]中解释了使用机器学习的车队健康监控。他们认为,他们的系统提供了故障排除和故障隔离能力。Azure Sphere和微软Azure云被用于[16]中以监控车辆健康状况,如图5所示。它仅从车辆读取基本数据,而为了实现良好的预测,我们需要比他们更多的数据。
文献中描述了多种车辆健康监测系统,这些系统基于机器学习、车载物联网数据分析以及基于移动设备的预测分析,但未提出车辆边缘计算。此外,对于所使用数据的质量以及系统的可靠性也未明确说明。
随着智能手机的广泛使用以及5G移动边缘计算技术的发展,智能手机可用于解决预测性维护问题。本文提出了一种基于移动应用的预测分析方法。预测算法在边缘端进行计算,并将结果显示在手机上。这使得车辆更加智能化,无需因故障而停驶。我们所提出的系统类似于[18]通过在车辆边缘处理传感器数据以获得良好的响应时间,并通过使用边缘计算减少云端开销,如图6所示。边缘计算确保了车速、安全性和可靠性。边缘计算在车辆设备上完成所有必要的计算任务,例如数据收集和分析,从而减少了云端与车辆之间的双向数据传输。
3. 所提出的系统
本文提出了一种基于边缘计算的智能系统,用于监控车辆健康状况,该系统能够在车辆部件实际发生风险之前预测其风险,从而替代根据时间或车辆状况将车辆送至服务点的做法。我们开发了一个智能边缘计算系统,该系统聚合多个子系统的传感器数据,并对这些参数进行实时处理,在出现任何偏差时向车主发出警报。该系统针对八个主要子系统提供车辆健康状况的预测,包括发动机负载、压力传感器、转/分钟、发动机冷却液温度传感器、质量空气流量传感器、进气温度、节气门位置和燃油液位。
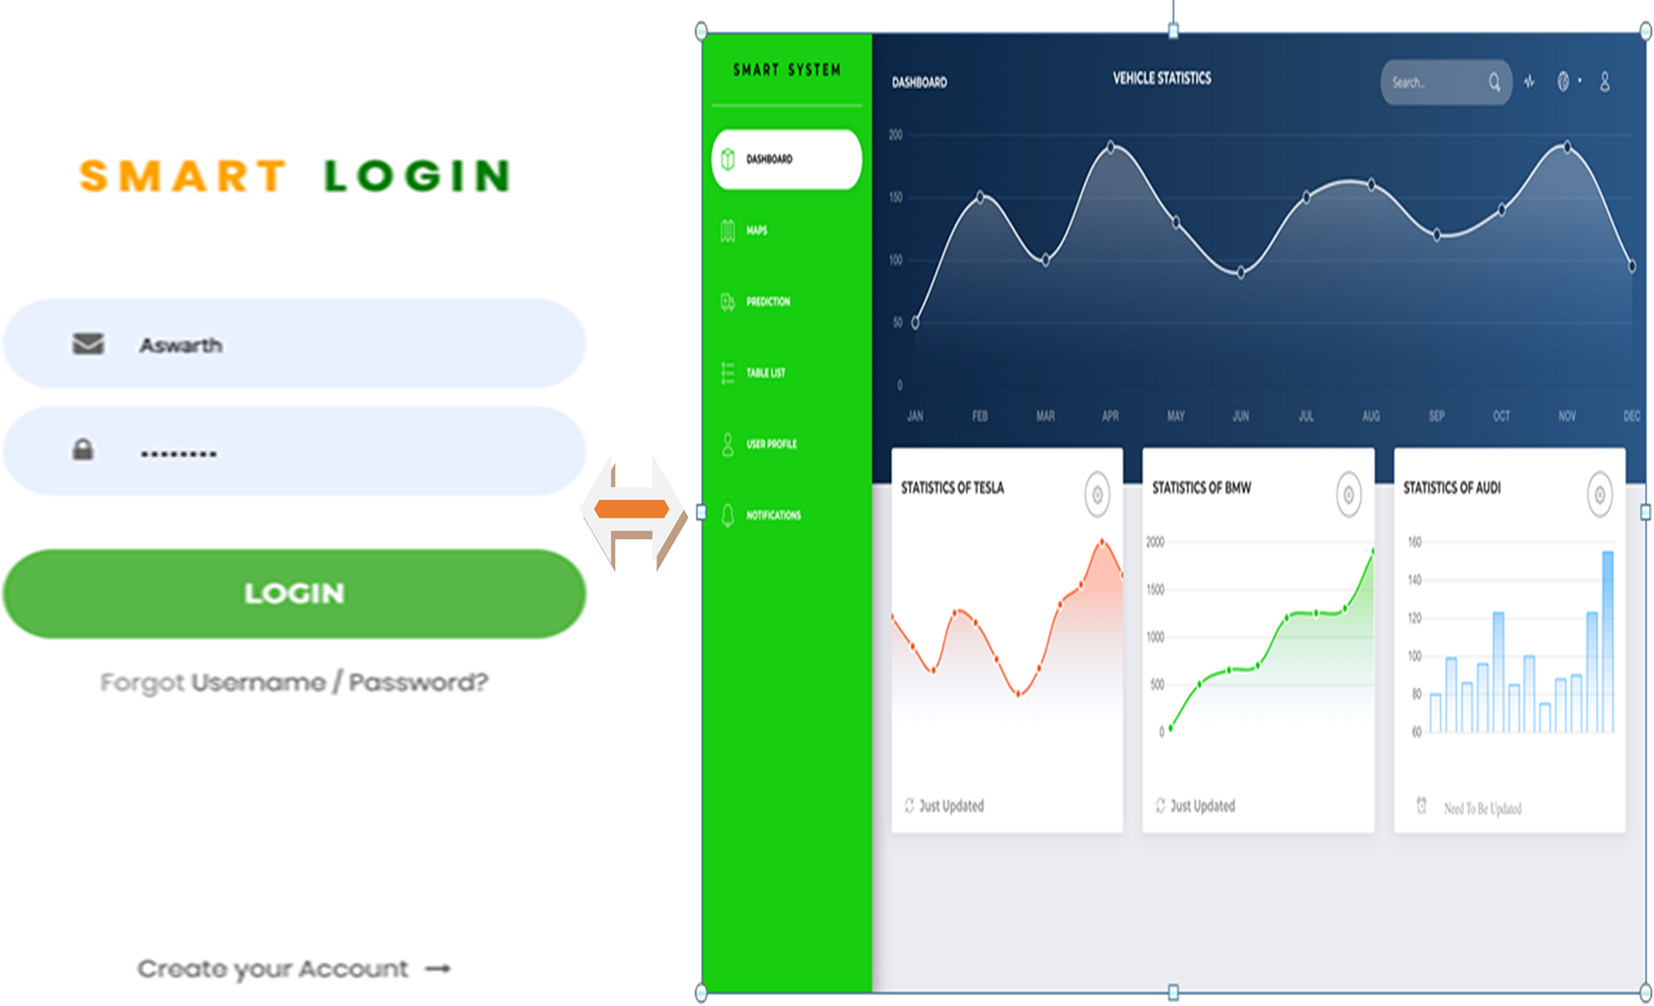
通过云端实现车辆的预测性健康监控。在边缘端采集的这些传感器数值会动态地进行质量处理,进行风险分析,并定期向驾驶员传达。之后,这些数值将存储在云端,部署到Flask应用中,并保存在云平台上以供可视化。
3.1. 架构
以下图7展示了用于车辆健康预测的所提出系统的流程图。
3.2. 方法论
进行了三个实验用于风险预测,即:
- 使用人工神经网络
- 使用k‐最近邻
- 使用ANN和k‐NN集成模型
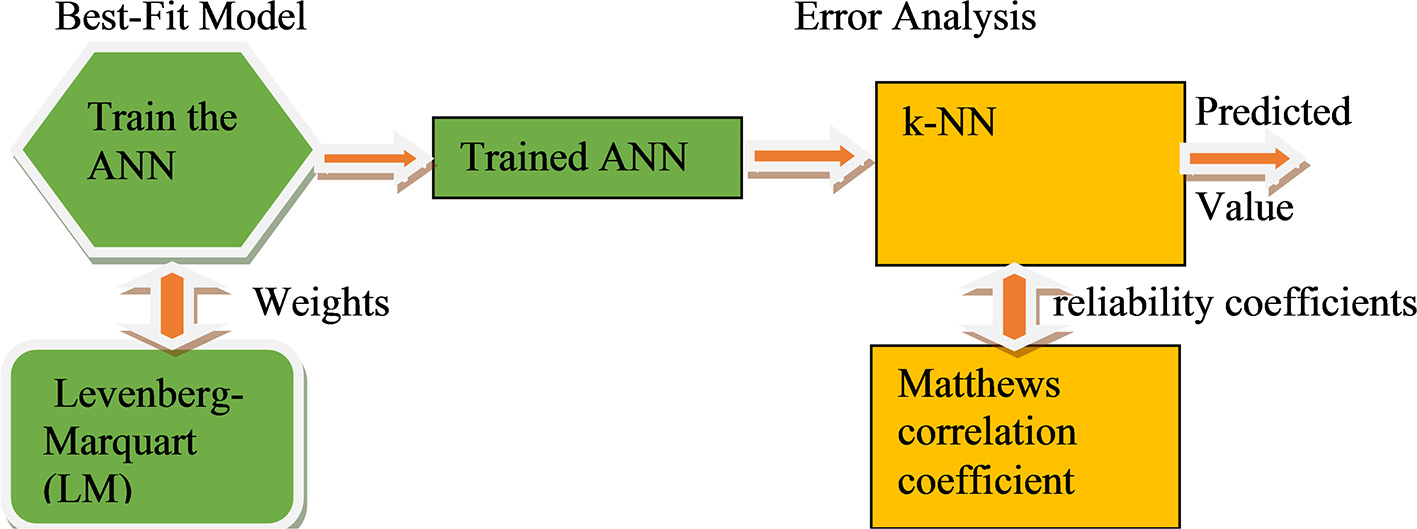
人工神经网络和k‐最近邻被广泛应用于多种预测场景,如洪水预测、信用卡风险、患者疾病预测、入侵检测,并已被证明是成功的。尽管k‐最近邻是用于预测分析的最简单算法,但它不具备自适应性,且其参数必须手动选择。人工神经网络的问题在于,每次遇到新的数据样本时都需要重新训练,这需要耗费计算时间。因此,我们提出一种集成模型,尝试用人工神经网络构建最优拟合模型,并使用k‐最近邻进行预测。以下图8展示了该集成模型的示意图。
3.2.1. 集成模型的方法论
- 在样本数据集上训练人工神经网络并进行验证。
- 该最佳训练网络报告的误差由k‐近邻算法用于误差的统计分析。
- 使用自适应寻找局部最小值的勒文贝格‐马夸特算法(LMA)[19]来计算权重。未使用最速下降算法来计算权重,因为它具有收敛问题。进行了大量测试,以确定需要多少隐藏层以及每层中的神经元数量,从而更好地拟合模型,降低归一化均方根误差和交叉熵损失值。
- 马修斯相关系数 (MCC) 的取值范围为 -1到+1,用作可靠性系数以增强类别预测[20]的可靠性。MCC最初用于二分类,之后通过[24]扩展应用于多分类。
- 如图8所示,一旦k‐最近邻产生较高的马修斯相关系数(MCC)得分,表明预测结果良好,即终止k‐最近邻。
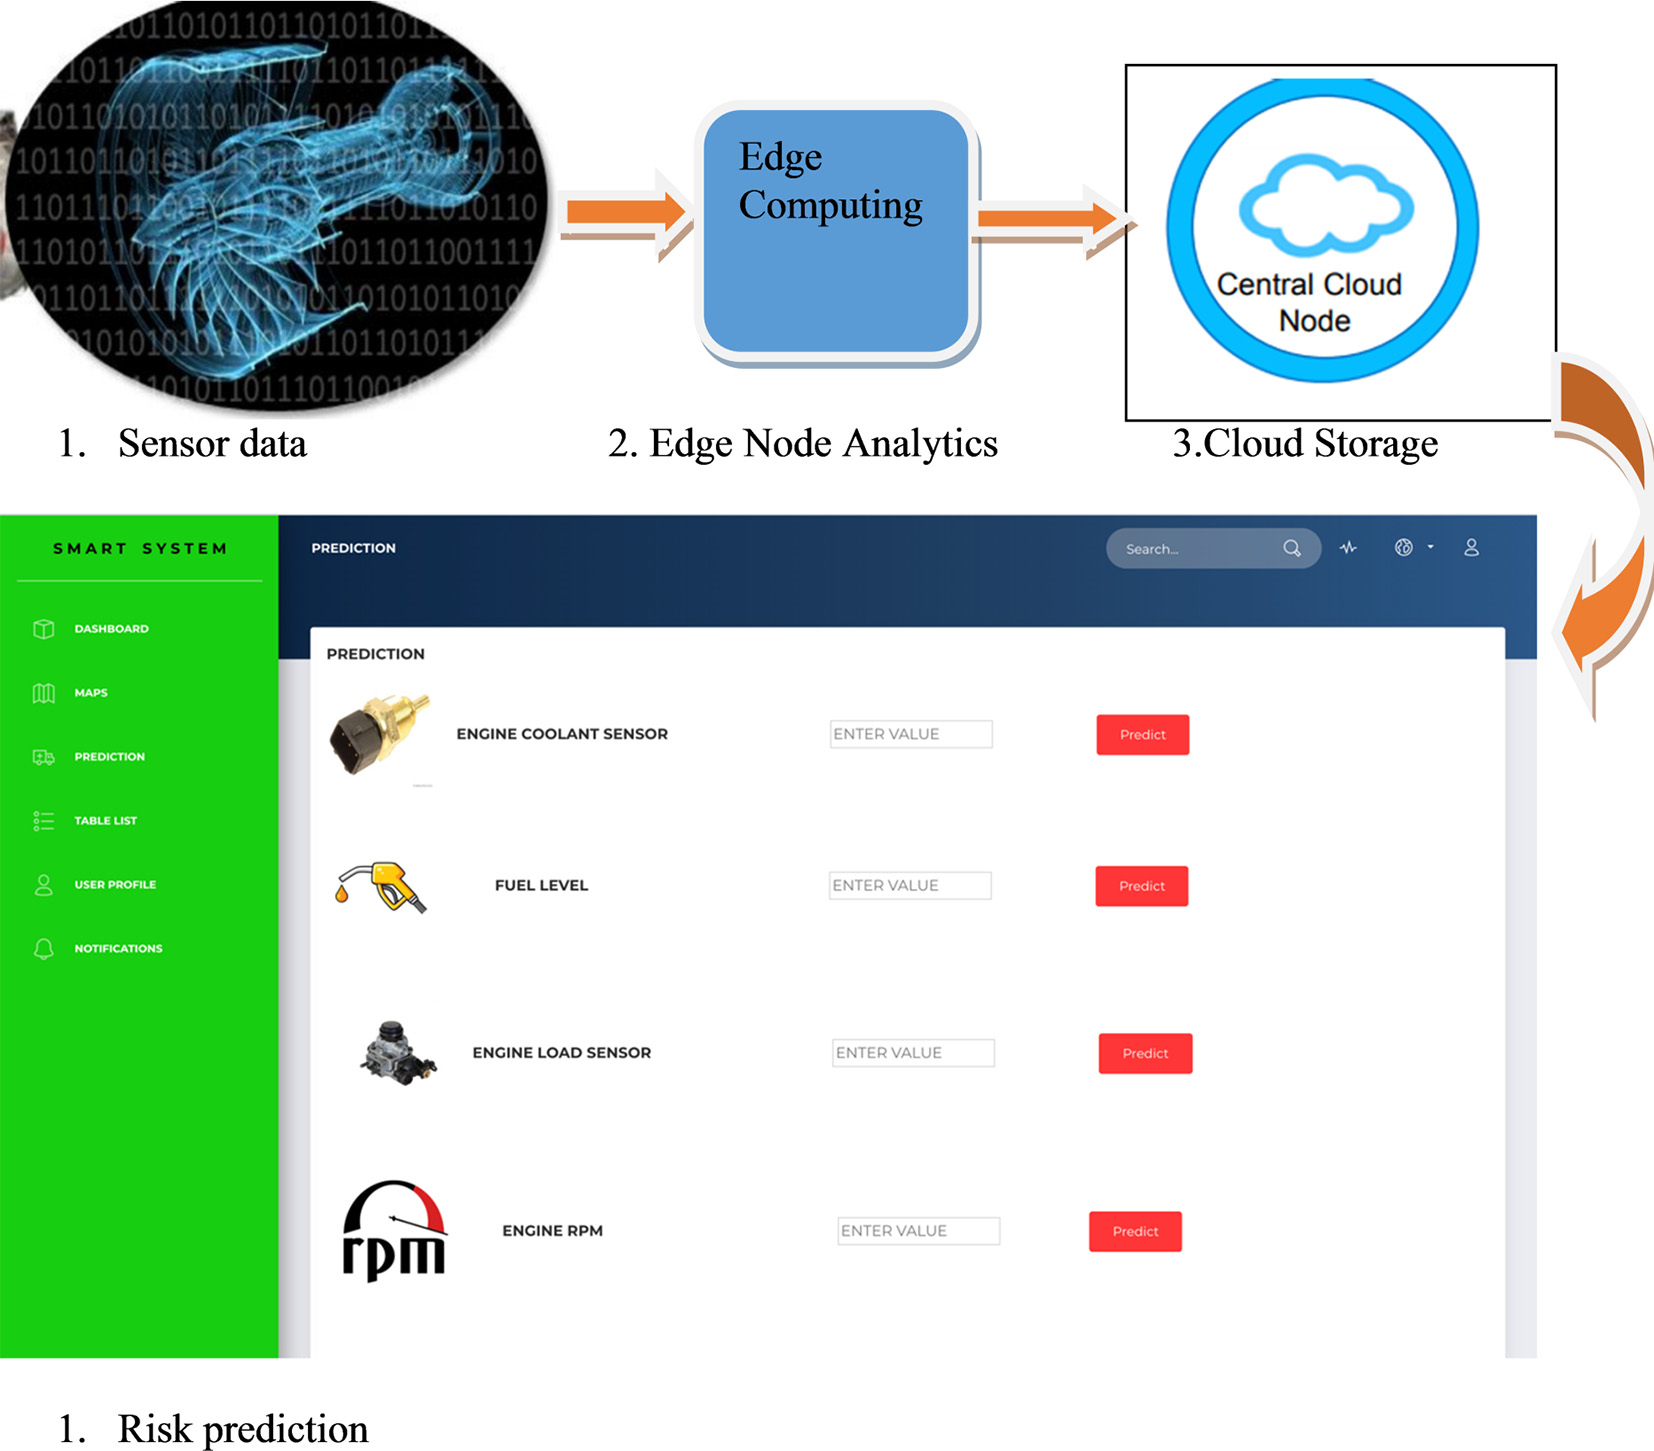
以下图9展示了所提出的系统的图形摘要。
如图9步骤2所示,传感器数据在数据源本地实时接收并处理,无需延迟,而不是在云端处理。经过风险处理后,该数据将存储在云端以进行可视化。
3.3. 算法
3.3.1. 使用最小‐最大归一化的预处理
从不同传感器收集的数据可能不完整、嘈杂且不一致。预处理有助于数据平滑和归一化。采用公式(1)中给出的最小‐最大归一化方法。[21]
$$
\text{normalized value} = \frac{\text{value} - \min}{\max - \min}
$$
其中,value 是属性值,min 是属性的最小值,max 是属性的最大值。
3.3.2. 人工神经网络
使用前馈传播的ANN通过LMA给出的一组权重构建,该权重按公式(2)计算得出。[19]
$$
f(x) = \frac{1}{2} \sum_{j=1}^{m} r_j^2(x)
$$
其中 $ x = (x_1, x_2, …, x_n) $ 是一个向量,$ r_j $ 是残差。
隐藏层中使用ReLU激活函数,分类层中使用Soft-max。
- 读取文件
- 使用最小‐最大归一化进行预处理
- 使用LMA算法估计神经网络的权重
- 设置训练、测试和验证数据集
- 加载人工神经网络模型,并在卷积层设置ReLU激活函数,在分类层设置Softmax,迭代次数为= 100
- 使用交叉熵损失函数评估模型
- 保存模型用于验证
- 从文件加载模型,并在实时数据上进行验证并打印相应的警报信息
3.3.3. k‐最近邻
k‐NN算法用于计算车辆的风险因素,有助于在部件发生故障之前分析其状况。马修斯相关系数(MCC)通过公式(3)计算。[22]
$$
MCC = \frac{TP \times TN - FP \times FN}{\sqrt{(TP + FP)(TP + FN)(TN + FP)(TN + FN)}}
$$
其中,TP、TN、FP、FN来源于混淆矩阵。
该值越接近 +1,构建的模型就越稳健。
- 读取文件
- 使用最小‐最大归一化进行预处理
- 设置训练、测试和验证数据集
- 计算测试样本与训练模型之间的距离
- 获取k近邻并进行预测
- 使用马修斯相关系数(MCC)对可靠性系数进行标准化
- 使用交叉熵损失函数评估模型
- 保存模型以供验证
- 从文件加载模型,并在实时数据上进行验证并打印适当的警报消息
3.4. 数据集收集
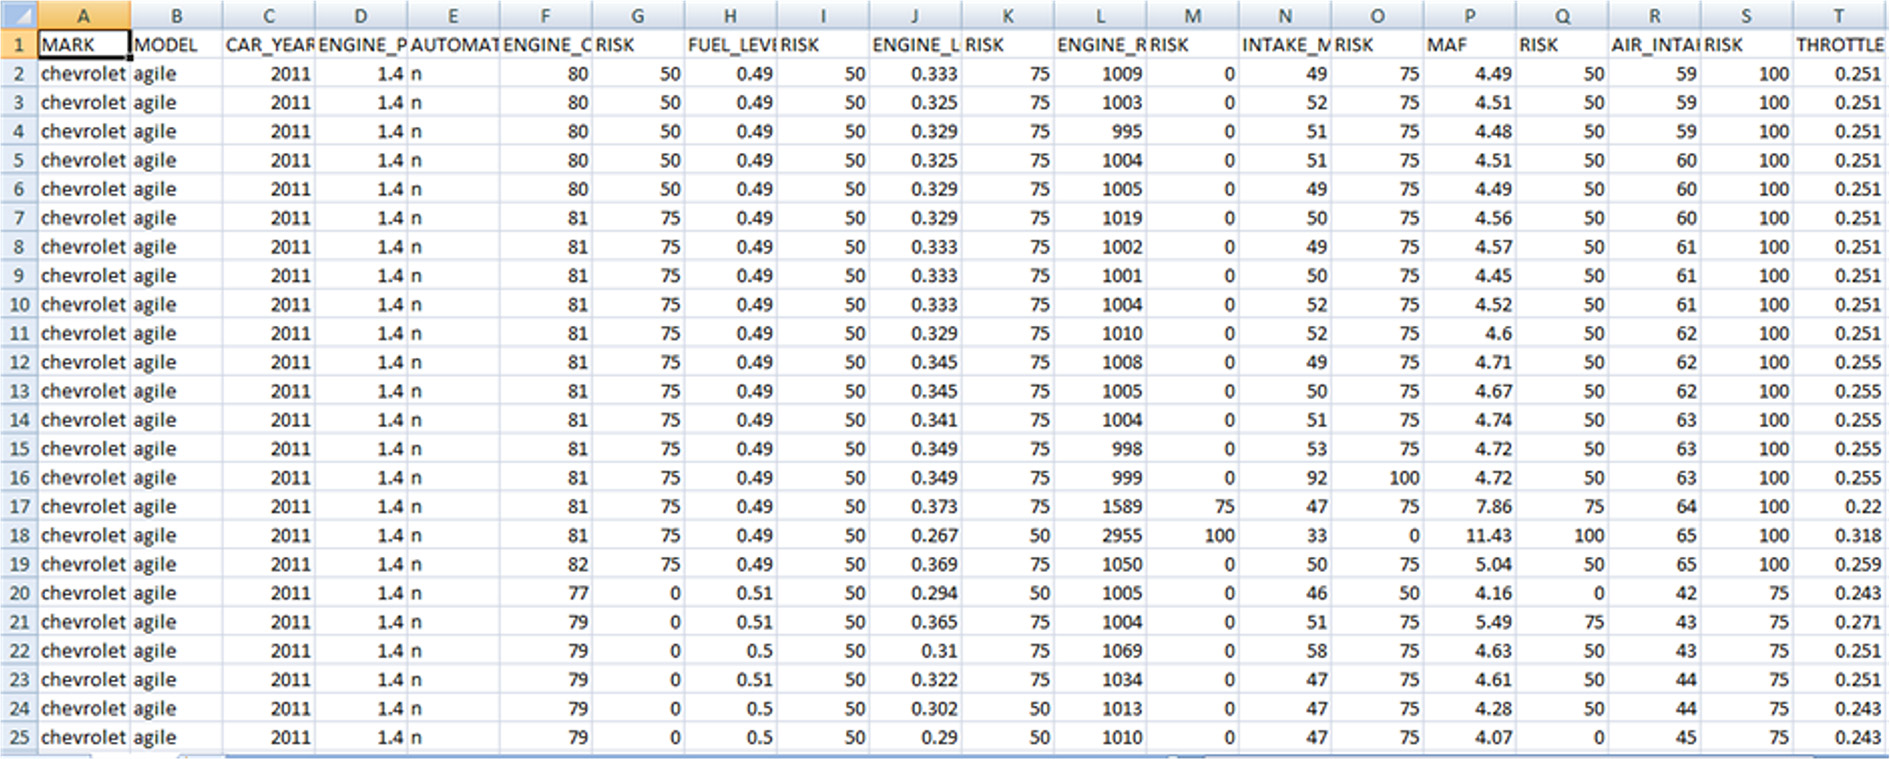
传感器数值存储在 Google Cloud Public Datasets 中,该平台与众多汽车工业有着广泛的合作。实时提供传感器数据,并与数据提供商建立合作。实验所用数据集可在 [27] 获取,如图10所示。该数据集包含33个属性的车载诊断系统II (OBD‐II)传感器数据,例如时间戳;品牌;车型;车辆年份;发动机功率;自动挡;车辆ID;大气压力(Kpa);发动机冷却液温度;燃油液位;发动机负载;环境空气温度;发动机转速;进气歧管压力;空气质量流量;长期燃油修正第2组;燃油类型;空气进气温度;燃油压力;车速;短期燃油修正第2组;短期燃油修正第1组;发动机运行时间;节气门位置;Dtc_Number;Trouble_Codes;Timing_Advance;Equiv_Ratio;Min;Hours;Days_Of_Week;Months;Year,该数据集包含雪佛兰、福特、本田、雷诺、丰田、日产、雪铁龙、标致、大众、菲亚特等多种车辆的上述信息。实验中我们选取了雪佛兰车辆13,617条记录中的8个传感器数值。
谷歌云平台、基于移动设备的应用软件、Flask 类似 Python 3.3、Scipy 1.4.1、Scikit‐learn V 0.21.3、Flask V 1.1.1、Joblib 0.14.1、numpy V 1.18.1、pip V 20.0.2、Jinja2 V 2.11.0、itsdangerous V 1.1.0、Setup tools V 40.8.0、Markup Safe V 1.1.1 被用于实验。
3.5. 性能评估指标
所提出系统的性能通过以下所述的多个指标进行计算:
(i)
混淆矩阵
:用于可视化分类算法性能的表格
(ii)
分类准确率 (CAR)
:基于混淆矩阵进行衡量,如公式 (4) 所示。[23]
$$
\text{accuracy} = \frac{tp + tn}{tp + tn + fp + fn}
$$
(iii)
精确率
:用于衡量所生成结果的相关性,如公式 (5) 所定义。[23]
$$
\text{Precision} = \frac{tp}{tp + fp}
$$
(iv)
召回率
:用于衡量所生成结果的相关性,如公式 (6) 所给出。[23]
$$
\text{Recall} = \frac{tp}{tp + fn}
$$
(v)
F值
如公式(7)所示。[23]
$$
F1 = \frac{2 \times \text{精确率} \times \text{召回率}}{\text{精确率} + \text{召回率}}
$$
(vi)
交叉熵损失函数 H
由公式(8)给出。该值介于 0 和 1 之间。该值越低,所开发的模型越稳健。[25]
$$
H(p, q) = -\sum_x p(x)\log q(x)
$$
(vii)
归一化均方根误差 (NRMSE)
可使用公式 (9) 计算
$$
NRMSE = \sqrt{\frac{\frac{1}{N}\sum_i(d_i - y_i)^2}{\sum_i(d_i)^2}}
$$
(viii)
决定系数(COD)
可以使用公式 (10) 计算。
$$
COD = R^2 = 1 - \frac{\sum_i(x_i - \bar{y})^2}{\sum_i(x_i - \bar{x})^2}
$$
决定系数的取值范围是0到1。
(ix)
可靠性预测指标
(如平均故障间隔时间 MTBF 和平均修复时间 MTTR [26],如公式(11)和(12)中所给出)用于确保所提出系统的可靠性
$$
MTBF = \text{总运行时间} / \text{故障次数} \quad (11)
$$
$$
\text{平均修复时间} = \text{总非计划维护时间} / \text{维修总次数} \quad (12)
$$
首先计算准确率以评估提出模型。使用精确率和召回率等其他方法来评估所提出的系统的性能。同时计算F1分数以找到精确率和召回率之间的平衡。
4. 结果与性能分析
首先计算准确率以评估提出模型。使用精确率和召回率等其他方法来评估所提出系统的性能。同时计算F1分数以找到精确率和召回率之间的平衡。表1展示了k‐最近邻在不同k值下的准确率。表2展示了三个模型在OBD数据集上进行风险预测的准确率。
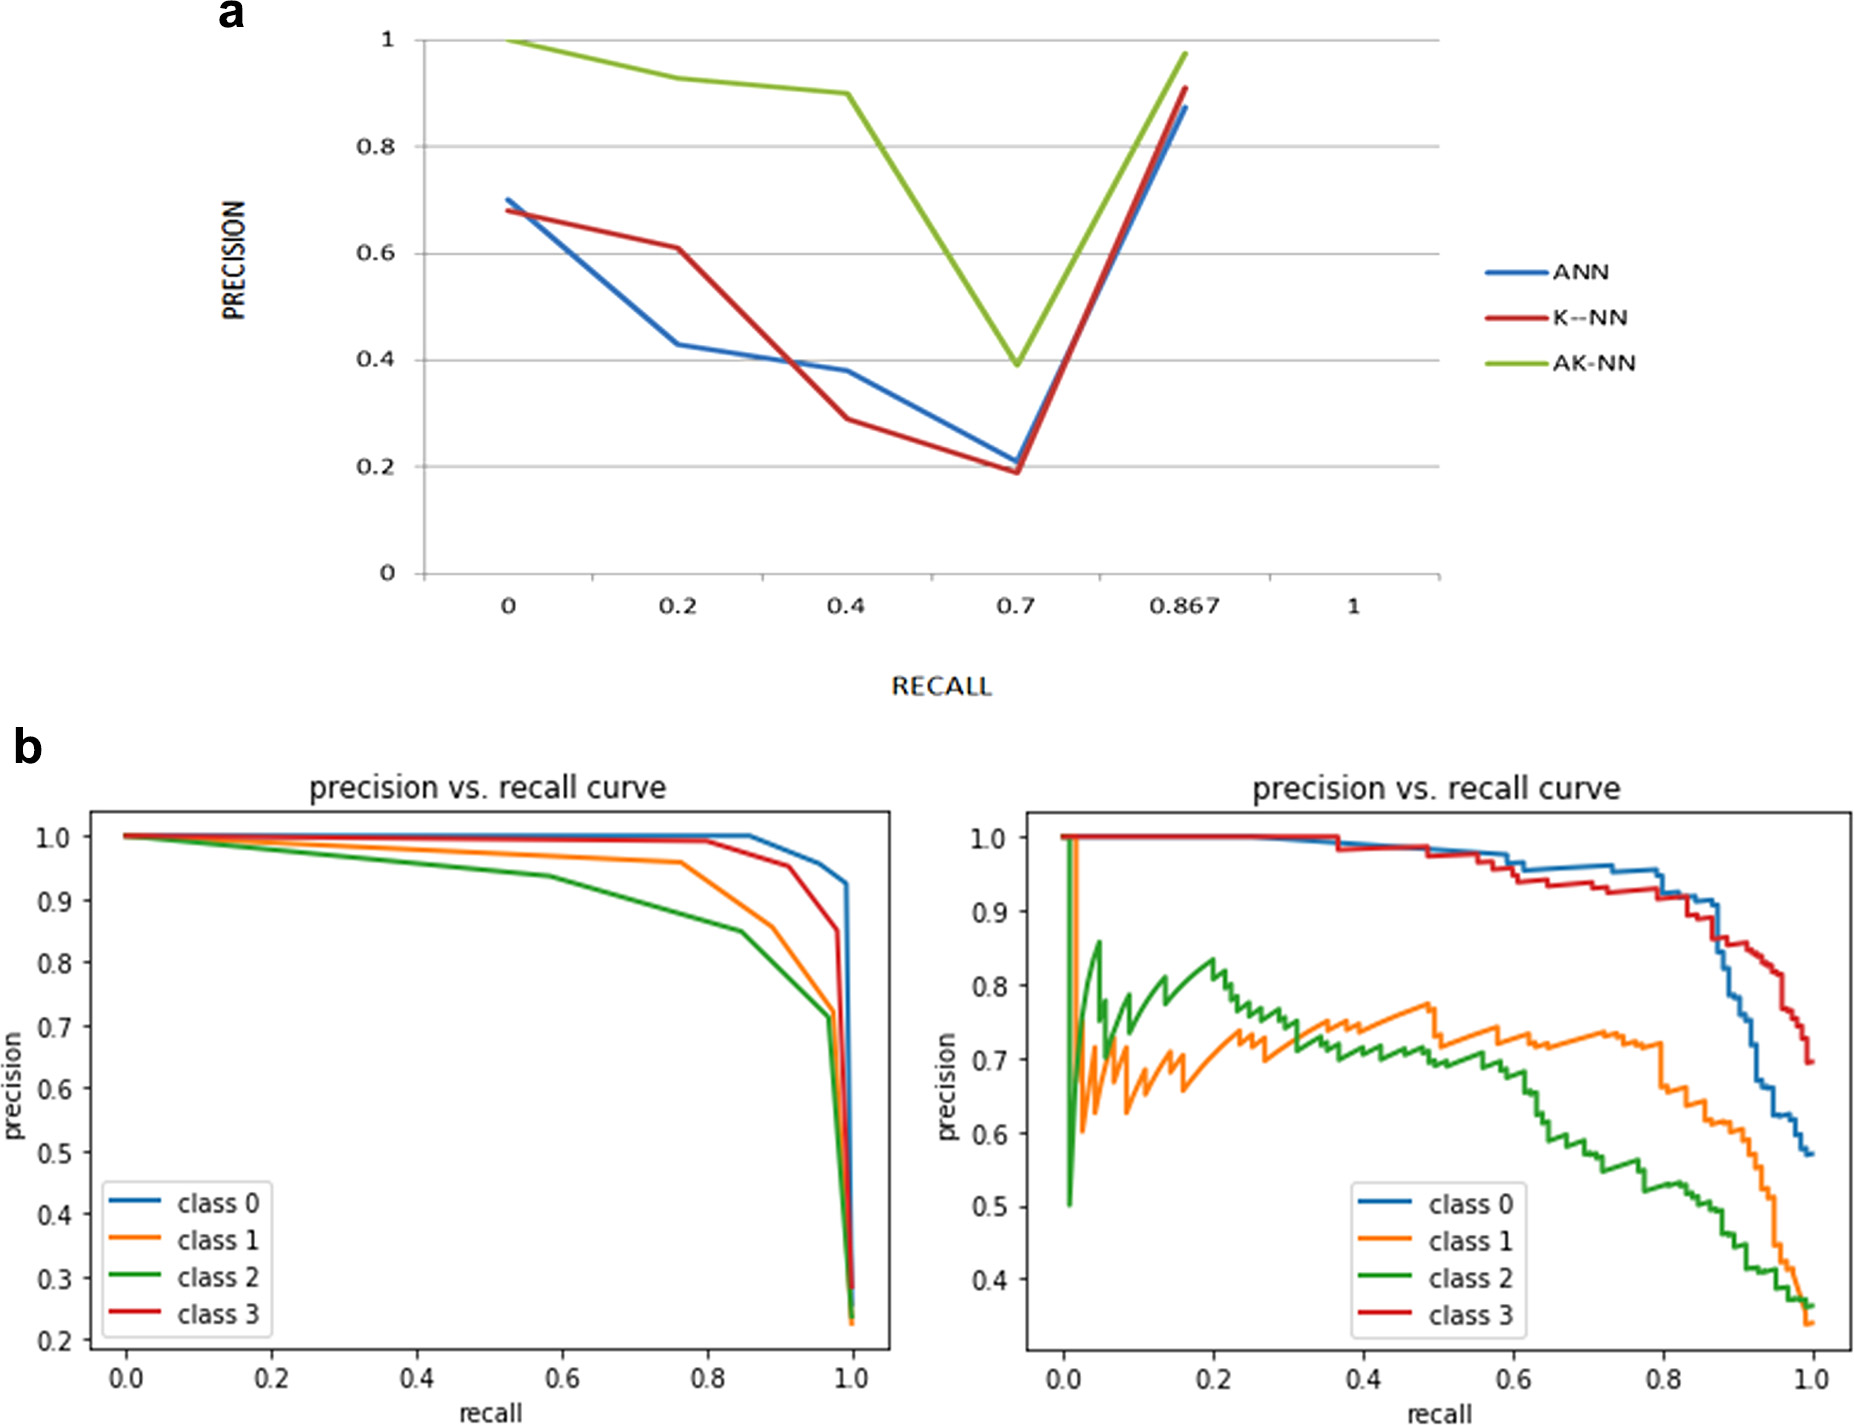
例如,如果我们选择70%的精确率,则人工神经网络的预测中有21%,k‐最近邻的预测中有19%,集成模型的预测中有39%。如果召回率增加到43%,则人工神经网络的精确率下降到20%;召回率增加到61%,则k‐最近邻的精确率下降到20%;召回率增加到93%,则集成模型的精确率下降到20%。图11(a)和(b)展示了三个模型在两个数据集上的精确率‐召回率曲线。
所提出系统的效率还通过使用公式(5)和(6)计算的假阳性率和假阴性率进行评估,如表3以及用于验证提出模型的受试者工作特征(ROC)曲线所示,如图12(a)和(b)所示。如果该曲线更靠近左侧边框或上侧边框,则表明测试准确;若至少更接近45°对角线,则表示模型测试的准确性较低。表4展示了两个数据集和三个模型的误报摘要。
可以看出,与其他两个模型相比,集成模型的误报更少。
以下表5展示了数据集和三个模型的归一化均方根误差和决定系数。可以看出,集成模型的表现优于其他两个模型,其决定系数(COD)为0.93,表明结果中有93%的变异可被解释。两个数据集和三个模型的交叉熵损失函数值如表6所示。这些概率值反映了模型检测给定对象的难易程度(例如,分布在0到1之间以及0–0.5之间)。
以下图13展示了损失与训练轮数关系。学习率为0.1,训练轮数为30。大多数神经网络模型在大约20个训练轮数后接近收敛,在接近30时趋于稳定。
可以看出,随着训练轮数达到30,准确率上升,损失下降,ANN的准确率达到80.53%,k‐NN为90.36%,AK‐NN为97.3%。同时,ANN的损失降至0.03724,k‐NN为0.19760,AK‐NN为0.01547。
通过评估关键绩效指标来检查所提出的集成模型的可靠性。故障数据被收集为两个总体,均值为893,标准差为481。对于某些车辆,由于未观察到故障或仅发生一次故障,出现了除零问题,此类情况在计算中已被剔除。平均而言,MTTR范围从30分钟到2天,MTBF约为3小时,可用性为95%。每个汽车行业的企业需根据具体情况为每辆车设定MTBF和MTTR,并设置如100小时至200小时的阈值,以及85%到95%之间的运行可用性。
| 表1 不同k值下k‐最近邻的准确率 |
|---|
| k |
| 3 |
| 4 |
| 5 |
| 表2 三种模型的准确性 |
|---|
| OBD数据集 |
| 精确率 |
| 召回率 |
| 准确率 |
| F值 |
| 表3 真正率和假正率 |
|---|
| OBD数据集 |
| TPR |
| FPR |
| 表4 OBD数据集的误报 |
|---|
| 序号 |
| 1 |
| 表5 三种模型在NRMSE和COD方面的性能分析 |
|---|
| 数据集 |
| OBD数据集 |
| 表6 交叉熵损失函数 |
|---|
| 数据集 |
| OBD数据集 |
5. 结论与未来工作
实时预测车辆风险是一项重要任务,需要从过去的错误中学习,适应当前场景,并以高准确率预测未来值。所提出的集成模型AK‐NN在单独应用时,相较于人工神经网络和k‐最近邻,能够提供更高的准确率。
一个完美的用户友好型应用程序可部署在每台设备上,帮助在智能手机上无延迟地准确监测车辆状况。在对自动化系统进行各种测试时,由于使用了更加安全的谷歌平台和快速服务器,设备没有漏洞。采用NRMSE和决定系数作为性能评估指标来分析模型。测试结果证明,该组合系统优于神经网络和k‐NN。一个理想的可靠性系统应降低平均修复时间,并提高平均故障间隔时间。
未来工作是研究如何有效处理边缘计算与其他性能参数结合的预测建模。此外,还可以考虑车辆不同部件之间的相关性分析,以确定其对车辆安全分析贡献的程度。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 24
 0
- 0


 已为社区贡献1条内容

所有评论(0)